Reconhecimento de Escrita Manual por IA vs OCR Tradicional: Por Que a Diferença é Maior do que a Maioria das Equipes Espera
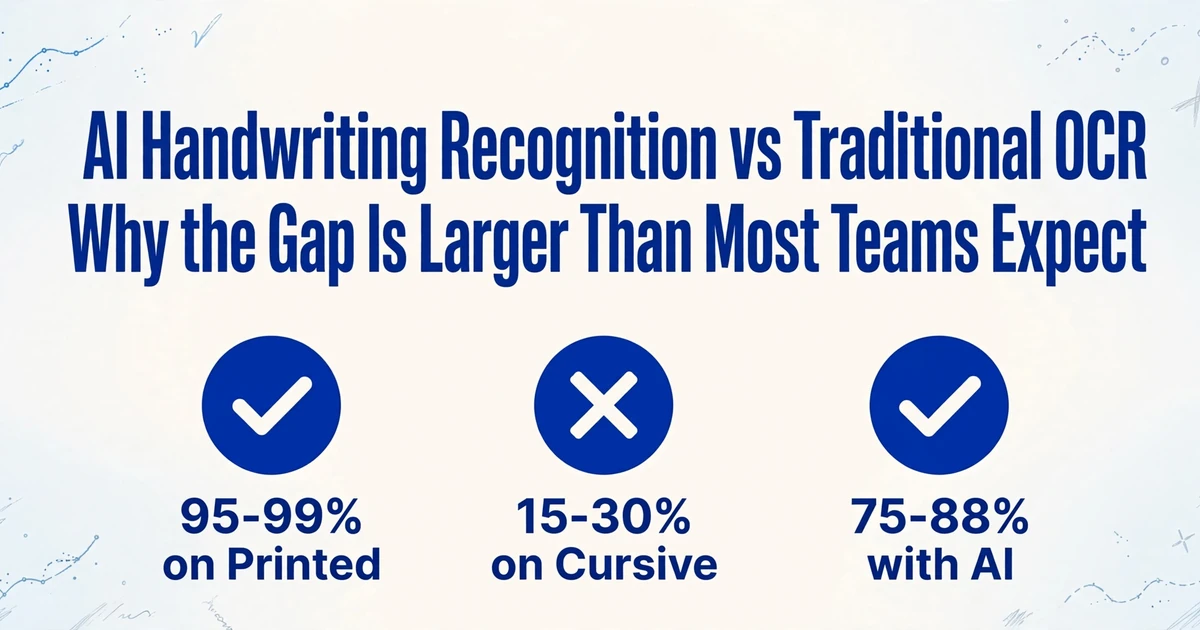
O OCR tradicional falha catastroficamente com escrita manual — o Tesseract atinge 24% de precisão em formulários manuscritos, enquanto a extração por IA chega a 95%+. Aqui está o porquê dessa diferença ser estrutural.
Onde isso se encaixa: esta página é a comparação direta entre IA e OCR tradicional em escrita manual — precisão, velocidade, custo e alucinação. Para uma definição do que é reconhecimento de escrita manual por IA, veja o que é reconhecimento de escrita manual por IA; para números de precisão por tipo de escrita manual, veja a IA consegue ler escrita manual de fotos.
O que o OCR tradicional acerta — e onde ele para
O reconhecimento óptico de caracteres tradicional funciona examinando padrões de pixels na página, comparando-os com formatos de caracteres conhecidos e gerando uma sequência de texto. Para documentos impressos por máquina e limpos, digitalizados a 300 DPI, ele tem bom desempenho — frequentemente superando 95% de precisão de caracteres. Uma fatura recém-impressa, um formulário em PDF, um contrato digitado: essas são as entradas para as quais o OCR foi projetado, e elas continuam sendo seu cenário ideal.
Mas a precisão de caracteres não é o mesmo que precisão de dados. Saber que os caracteres "1.234,56" aparecem em algum lugar da página não diz nada sobre se isso é um total de fatura, uma quantidade ou um número de referência. Essa interpretação ainda exige um humano — ou uma camada de regras que você precisa criar e manter sobre a saída do OCR. Para texto impresso por máquina, essa lacuna é administrável com scripts de pós-processamento e modelos de posição de campo. Para escrita à mão, a lacuna se transforma em um abismo.
A questão fundamental é arquitetural. O OCR tradicional é de baixo para cima: ele lê caracteres individuais primeiro, depois tenta montá-los em palavras e, em seguida, em linhas. Ele não tem noção do que o documento significa. Quando cada caractere é nítido e previsível, isso funciona. Quando os caracteres se conectam, variam de tamanho, inclinam-se de forma imprevisível ou se borram uns nos outros — como acontece com a escrita à mão — a abordagem de baixo para cima colapsa antes de chegar ao nível da palavra.
Os Três Pontos Onde o OCR Tradicional Falha na Escrita à Mão
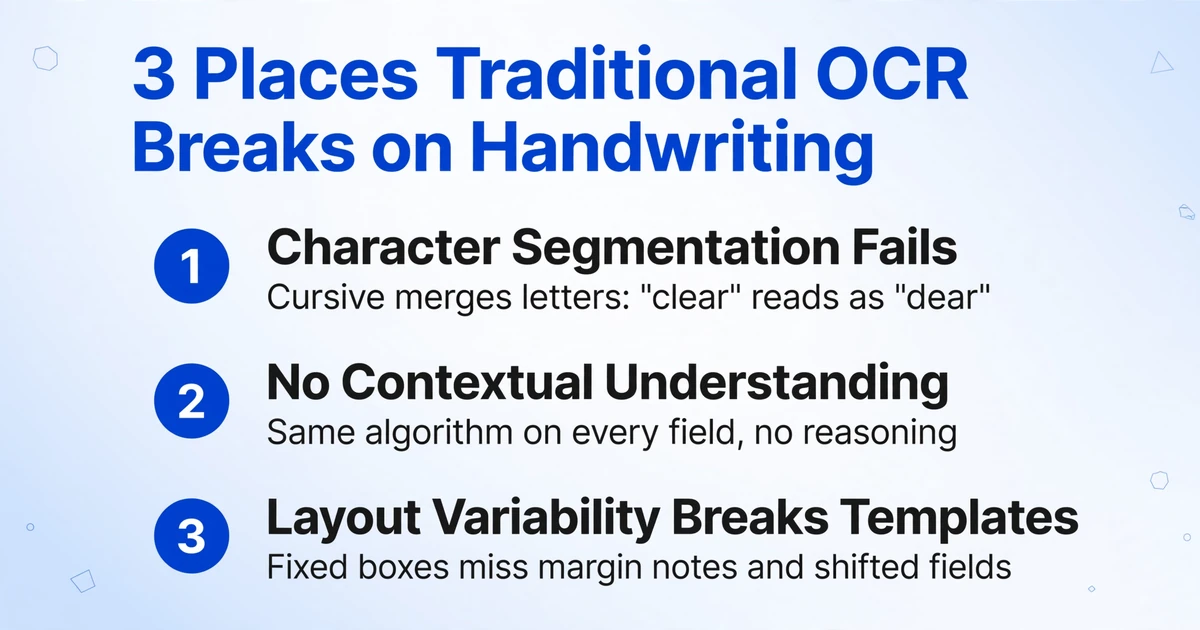
A escrita de cada pessoa é um conjunto de dados único. Espessura do traço, ângulo de inclinação, conexão das letras, desvio da linha de base — tudo isso varia não apenas entre pessoas, mas também na escrita de uma única pessoa em dias diferentes, com canetas e superfícies diferentes. O OCR tradicional encontra três modos específicos de falha que se agravam mutuamente.
A segmentação de caracteres ocorre antes do reconhecimento
O OCR assume que cada caractere ocupa uma caixa delimitadora separável. A escrita cursiva viola completamente essa premissa. Os caracteres se fundem, sem limites claros. O mecanismo ou mescla várias letras em um único bloco (lendo "claro" como "caro") ou divide uma única letra em duas caixas (lendo "m" como "rn"). Benchmarks independentes de implantações em produção mostram que o Tesseract — o mecanismo de OCR open source mais usado — retorna 45–50% de precisão de palavras em escrita cursiva geral. Isso significa que, para cada duas palavras escritas à mão, uma será lida incorretamente. Em um formulário de 50 campos com letra de forma e cursiva misturadas, cerca de 25 campos conterão erros antes de qualquer revisão humana.
Sem compreensão contextual, não há recuperação de erros
Quando um humano lê uma palavra borrada em um formulário de entrega, os campos ao redor — data, endereço, lista de itens — limitam o que aquela mancha pode ser. Um número no campo "Total" não pode ser um nome. Uma data no campo "Data de Nascimento" não pode ser do ano seguinte. O OCR tradicional não tem esse raciocínio. Ele aplica o mesmo algoritmo de correspondência de caracteres a cada posição da página, independentemente do que deveria estar ali. Um "5" borrado em uma coluna de preço é classificado como "S" porque o padrão de pixels é ambíguo — e o mecanismo não tem como sinalizar que "S" não faz sentido em um campo de moeda.
Variabilidade de layout quebra pipelines baseados em modelos
Muitos setups de OCR em produção dependem de modelos: você define coordenadas fixas para cada campo, e o mecanismo lê os caracteres que aparecem nessas caixas. Isso funciona para formulários padronizados de uma única fonte. Falha no momento em que um fornecedor altera o layout do formulário, um campo se desloca meio centímetro, ou alguém escreve uma anotação na margem em vez da caixa designada. Documentos manuscritos amplificam esse problema — escritores frequentemente ultrapassam as caixas, adicionam anotações nas margens ou usam setas para reposicionar informações. Um modelo feito para "Nome: [____________]" não consegue lidar com "Nome: [João S—— veja ID anexo]." A saída do OCR para esse campo será truncada, distorcida ou vazia, e o resto do fluxo de trabalho não tem como saber qual.
Como o Reconhecimento de Escrita por IA Pensa de Forma Diferente
Os Modelos de Linguagem Visual (VLMs) — a classe de IA que inclui modelos como GPT-4o, Claude e Gemini — processam documentos de cima para baixo, e não de baixo para cima. Eles não começam procurando formatos de letras individuais. Eles olham a imagem da página inteira, entendem sua estrutura e propósito, e então decodificam o texto dentro desse contexto. Isso é mais próximo de como um humano lê: você não examina cada traço da caneta isoladamente; você reconhece a palavra "Total" porque espera que um total apareça no rodapé de uma fatura, e interpreta o número ao lado como moeda porque o contexto exige.
A consequência prática é que a extração baseada em VLM lida com ambiguidades como um humano faria — cruzando o que está na página com o que deveria estar na página. Um caractere que parece "5" ou "S" é resolvido como "5" se aparecer em um campo numérico. Uma data escrita como "Jan 5 25" é normalizada para "2025-01-05" porque o modelo entende formatos de data. Essa desambiguação contextual não é uma melhoria menor em relação ao OCR em nível de caractere — é a diferença entre uma saída utilizável e uma saída que exige uma segunda passagem humana.
Na prática, ferramentas construídas com essa abordagem permitem definir a Extração de Colunas Personalizadas: você digita os nomes dos campos desejados — "Número da Fatura", "Data de Vencimento", "Valor Total" — e a IA localiza cada valor em qualquer lugar da página entendendo o que o rótulo do campo significa, não onde ele está. Sem coordenadas de modelo, sem configuração por fornecedor, sem reconfiguração quando o layout de um formulário muda. A mesma definição funciona em diferentes documentos de diferentes fontes porque a IA procura significado, não posição.
Os arquivos são processados com segurança e não são armazenados.
A Lacuna de Precisão: Em Números
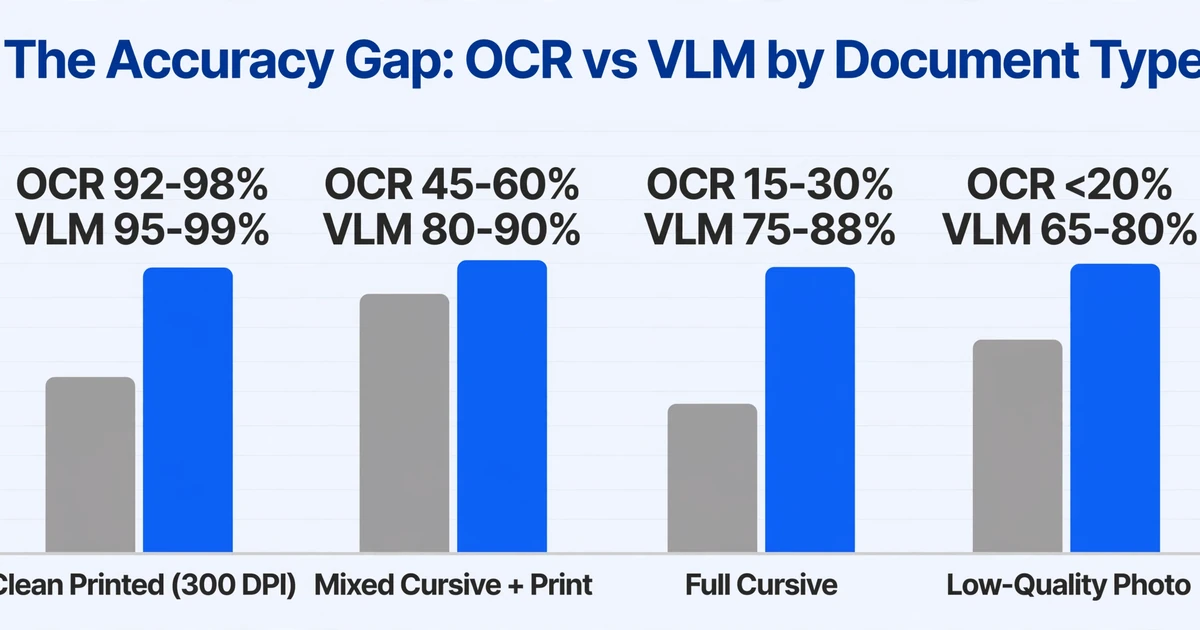
Os números tornam a diferença concreta. Vários benchmarks independentes publicados em 2025–2026 convergem em um padrão consistente: em texto impresso, a lacuna entre OCR tradicional e extração baseada em VLM é estreita (3–7 pontos percentuais). Em escrita manual, ela explode.
| Tipo de Documento | Precisão do OCR Tradicional | Precisão da Extração Baseada em VLM | Lacuna |
|---|---|---|---|
| Texto impresso limpo (300 DPI) | 92–98% | 95–99% | 3–7 pp |
| Escrita manual em letra de forma (caixas delimitadas) | 70–85% | 85–93% | 8–15 pp |
| Mistura de cursiva + letra de forma | 45–60% | 80–90% | 25–35 pp |
| Cursiva completa / escrita manual bagunçada | 15–30% | 75–88% | 50–65 pp |
| Fotos de campo de baixa qualidade (celular, iluminação irregular) | <20% | 65–80% | 45–65 pp |
Duas observações sobre o que está sendo medido. Primeiro, a coluna VLM é precisão em nível de campo — se cada valor extraído cai na coluna correta da sua planilha — não reconhecimento bruto de caracteres. O nível de campo é maior que as taxas brutas de erro de caractere (CER) porque o contexto do documento resolve caracteres ambíguos: um dígito borrado em um campo Total é lido como 5, não como S. Segundo, a coluna de OCR tradicional é reconhecimento bruto nos mesmos documentos — exatamente por isso a lacuna parece tão grande. Para métricas brutas em nível de caractere no benchmark IAM, veja nosso mergulho profundo em como funciona o reconhecimento de escrita manual.
O padrão não é sutil. Na caligrafia mais limpa (letras maiúsculas em caixas delimitadas), a diferença é administrable — o OCR tradicional pode ser "bom o suficiente" com algum pós-processamento. Mas à medida que a caligrafia se degrada — de letras de imprenta a cursiva mista, de caixas delimitadas a campos de forma livre, de páginas escaneadas a fotos de celular — a precisão do OCR tradicional despenca, enquanto a extração baseada em VLM degrada gradualmente. O mesmo benchmark de 2026 testou o motor de caligrafia específico do Google Document AI em cursiva: ~63% de precisão de palavras. Amazon Textract teve um desempeño melhor, com ~89,5% nas mesmas entradas, mas ambos exigiam pipelines de pré-processamento separados para correção de inclinação, aprimoramento de contraste e remoção de ruido — trabalho que os sistemas baseados em VLM realizam em tempo de inferência, sem configuração adicional (Suparse, 2026).
Para um fluxo de trabalho real que processa 100 documentos mistos por semana — metà impressos, metà manuscritos — a diferença acumulada equivale a aproximadamente 4–6 horas por semana de correção manual sob OCR tradicional versus 30–45 minutos sob extração baseada em VLM. Essa diferença não é uma questão de conveniencia. Determina se a automação que incluye caligrafía pode funcionar sem uma etapa dedicada de revisão humana.
Onde a Comparação Fica Complicada: Velocidade, Custo e Alucinação
Se a comparação de precisão fosse toda a história, a decisão seria simples. Mas a extração baseada em VLM vem com três contrapartidas que tornan deshonesta uma recomendación genérica.
Velocidade
O OCR tradicional é rápido — processa uma única página em menos de 2 segundos em hardware comum. VLMs são mais lentos porque realizam raciocínio mais rico. Uma chamada VLM típica para extração em nível de página leva de 5 a 12 segundos, dependendo da complexidade do documento e do tamanho do modelo. Para um lote de 500 páginas, isso é a diferença entre 15 minutos e mais de uma hora. Se seu fluxo de trabalho é sensível a volume e seus documentos são consistentemente texto impresso limpo, o OCR tradicional continua sendo a opção mais rápida — e pode ser tudo o que você precisa.
Custo
O OCR tradicional é barato. O Tesseract é gratuito e de código aberto. APIs de OCR em nuvem cobram aproximadamente US$ 0,001–0,005 por página. A extração baseada em VLM custa mais por página porque o processamento é mais pesado — mas a comparação é enganosa se você parar no preço da API por página. Um usuário do Reddit que processou mais de 150.000 páginas em produção observou que a vantagem de custo por página do OCR tradicional desaparecia quando você considerava o custo da correção manual: "As plataformas de OCR tradicional parecem econômicas (~US$ 0,001–0,005 por página), mas sua baixa precisão em manuscritos (~45–50%) as torna inutilizáveis para fluxos de trabalho empresariais com conteúdo manuscrito significativo. O tempo gasto corrigindo erros manualmente torna o custo real muito maior do que soluções especializadas" (r/computervision, 2025). A equação de custo real é custo de extração por página + custo de correção por erro × taxa de erro. Para documentos impressos, o custo por página domina. Para documentos manuscritos, o custo de correção domina — e é aí que a maior precisão do VLM muda a matemática.
Alucinação
Aqui está o que a maioria dos artigos de comparação ignora: VLMs podem alucinar. Como eles raciocinam sobre o que deveria estar em uma página, ocasionalmente inserem informações que não estão lá — uma data com aparência plausível onde o campo foi deixado em branco, ou um valor adivinhado onde a caligrafia era genuinamente ilegível. O OCR tradicional tem o modo de falha oposto (retorna nada ou lixo), o que torna seus erros mais fáceis de detectar. Uma alucinação de VLM é mais perigosa porque parece correta. A diferença entre a saída do Tesseract confiantemente errada ("OOO OOO") e a saída do VLM confiantemente errada é que a versão do VLM parece dado real — e pode passar pela validação automatizada. Para campos onde erros são caros (valores de pagamento, datas de contrato, dados de conformidade), a pontuação de confiança e a revisão com humano no circuito permanecem necessárias independentemente da tecnologia escolhida (F22 Labs, 2026).
Insight principal: o OCR tradicional falha ao retornar caracteres errados. A extração baseada em VLM pode falhar ao retornar fabricações plausíveis. O primeiro modo de falha é ruidoso, mas detectável. O segundo é silencioso e perigoso. Nenhuma tecnologia elimina a necessidade de validação em campos de alto risco — elas apenas exigem estratégias de validação diferentes.
A Abordagem Híbrida: Quando Usar o Quê
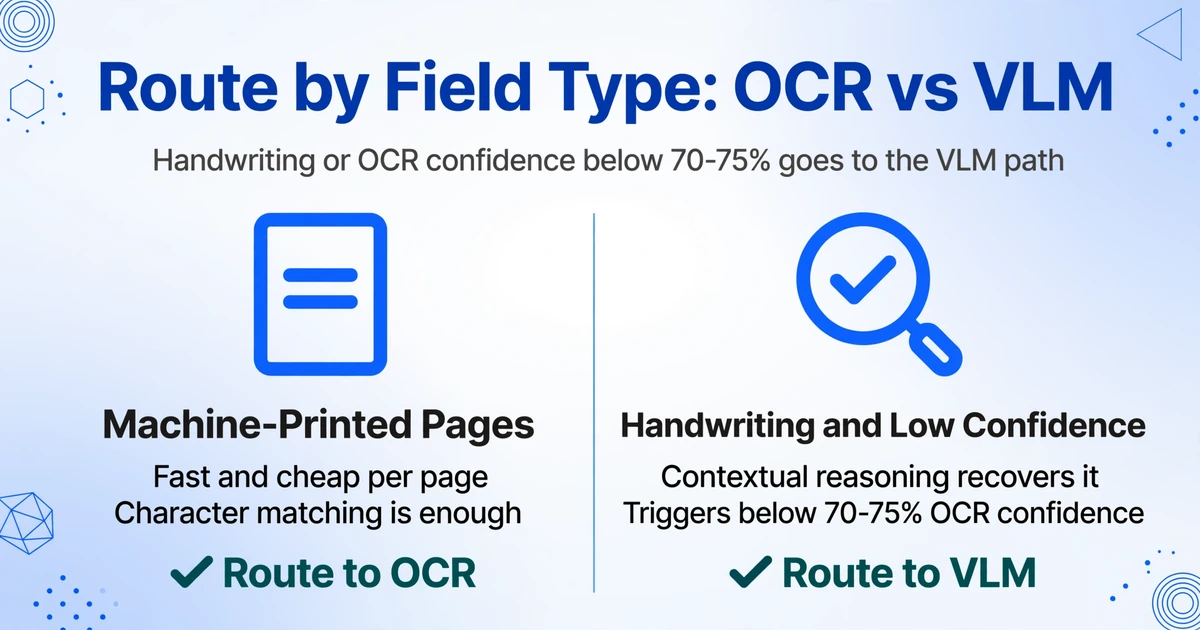
A resposta prática para a maioria das equipes não é "mudar tudo para IA" ou "ficar com OCR". É um pipeline híbrido que roteia cada documento para o mecanismo certo com base em suas características.
Para documentos 100% impressos por máquina, com formatação consistente e digitalizados a 300+ DPI, o OCR tradicional é mais rápido, mais barato e suficiente. A saída pode precisar de pós-processamento de posição de campo, mas a precisão em nível de caractere é alta o suficiente para que as regras de pós-processamento sejam estáveis.
Para documentos que contenham qualquer escrita manual — mesmo um único campo — a estratégia híbrida muda. Use OCR tradicional para as seções impressas e roteie os campos manuscritos para um VLM. Isso captura a vantagem de velocidade do OCR na maior parte da página enquanto usa IA contextual nas partes que o OCR não consegue lidar. A lógica de roteamento é simples: se a confiança do OCR em um campo cair abaixo de um limite (normalmente 70–75%), esse campo é reprocessado pelo caminho VLM. Um piso de contagem de caracteres (mínimo de 40 caracteres por página) atua como um segundo portão para capturar páginas onde o OCR afirma alta confiança em quatro caracteres lidos corretamente, mas perdeu o resto da página inteiramente.
A abordagem de limite também controla custos — você só paga pelo processamento VLM nos campos onde isso faz diferença. Para um fluxo de trabalho onde 30% dos documentos contêm escrita manual e cada documento tem em média 15 campos, isso significa que aproximadamente 5 campos por documento passam pelo caminho VLM, não a página inteira. Em escala, essa diferença importa.
O que isso significa para o seu fluxo de trabalho de documentos
A decisão entre OCR tradicional e reconhecimento de escrita manual por IA não é uma escolha de tecnologia — é uma escolha de design de fluxo de trabalho. Se a sua captação de documentos é 100% impressa e baseada em modelo, o OCR tradicional funciona e continuará funcionando. Se qualquer fração significativa dos seus documentos contém escrita manual — confirmações de entrega com anotações de motoristas, relatórios de inspeção com observações de campo, formulários de admissão médica com assinaturas de pacientes, solicitações financeiras com declarações manuscritas — então um pipeline somente com OCR tradicional está perdendo dados silenciosamente em cada lote.
O erro de cálculo mais comum é presumir que "o OCR resolve isso" porque a página de marketing da ferramenta lista suporte a escrita manual. A diferença entre a capacidade listada e o desempenho no mundo real com os seus documentos reais — não com as amostras de demonstração limpas do fornecedor — é o que determina se a automação funciona ou cria mais trabalho do que economiza. Testar com os seus próprios documentos, especificamente os 10% mais bagunçados da sua captação, é a única maneira de saber qual abordagem — OCR puro, VLM puro ou híbrido — vai se sustentar sob carga de produção.
FAQ
O OCR tradicional consegue ler escrita cursiva?
Sim, mas de forma não confiável. Mesmo com mecanismos baseados em LSTM como o Tesseract 4.x, a precisão em cursiva normalmente fica abaixo de 50% no nível de palavra. Os caracteres em escrita conectada são ambíguos demais para correspondência de padrões de baixo para cima. O OCR tradicional não foi projetado para essa classe de entrada, e nenhuma quantidade de ajuste de parâmetros muda a limitação arquitetural subjacente.
O reconhecimento de escrita manual por IA é preciso o suficiente para substituir a entrada manual de dados?
Para muitos fluxos de trabalho, sim — com ressalvas. Em escrita de letra de forma em campos de formulário restritos, a extração por IA alcança 85–93% de precisão em nível de campo, o que torna a entrada manual a exceção em vez da regra. Em cursiva bagunçada ou fotos de celular degradadas, a precisão cai para 65–80% — ainda uma melhoria dramática em relação aos menos de 20% do OCR tradicional, mas não alta o suficiente para processamento direto sem uma etapa de revisão em campos críticos. O ponto ideal prático é a extração com roteamento baseado em confiança: campos de alta confiança passam automaticamente, campos de baixa confiança são sinalizados para revisão humana. Para uma análise mais aprofundada de como a precisão varia conforme a qualidade da entrada e o design dos campos, consulte o nosso guia de melhoria de precisão.
E a velocidade — a extração com IA é mais lenta que o OCR?
Por página, sim — normalmente de 5 a 12 segundos para extração baseada em VLM, contra menos de 2 segundos para OCR tradicional. Mas a comparação justa inclui o tempo economizado ao não corrigir manualmente erros de OCR em campos manuscritos. Para um lote de 100 páginas com 40% de conteúdo manuscrito, a extração com VLM leva ~10 minutos de processamento + 30 minutos de revisão. O OCR tradicional leva ~3 minutos de processamento + 3 a 5 horas de correção. O tempo total do fluxo de trabalho favorece o VLM para qualquer lote que inclua manuscritos.
Posso usar OCR tradicional e extração com IA no mesmo pipeline?
Sim — e é assim que a maioria das implantações em produção funciona. Use OCR tradicional para páginas impressas por máquina com confiança acima do limite de 75% e um piso mínimo de contagem de caracteres. Encaminhe tudo abaixo desse limite — além de qualquer documento sinalizado como contendo manuscritos — para o caminho VLM. Essa arquitetura híbrida captura os benefícios de custo e velocidade do OCR onde ele funciona, enquanto cobre as lacunas de manuscritos que o OCR não consegue fechar.
As ferramentas de extração com IA alucinam dados que não estão na página?
Podem. Sistemas baseados em VLM às vezes geram dados com aparência plausível para campos que estavam, na verdade, em branco ou ilegíveis. Essa é a diferença mais importante em relação ao modo de falha do OCR tradicional: o OCR tradicional retorna lixo que é obviamente errado; uma alucinação de VLM pode parecer correta e passar pela validação despercebida. Para qualquer campo em que um erro seja caro — valores de pagamento, datas legais, identificadores de pacientes — a pontuação de confiança e a revisão humana continuam necessárias, independentemente da tecnologia de extração que você usar.
O Único Benchmark Que Importa
Benchmarks e tabelas de comparação dizem o que é verdadeiro em média. Eles não dizem o que é verdadeiro para os seus documentos — aqueles com a caligrafia dos seus fornecedores, as abreviações da sua equipe de campo, os seus formulários digitalizados de uma década atrás. A diferença entre OCR tradicional e reconhecimento de manuscritos com IA é medida em pontos percentuais, mas se esses pontos importam depende inteiramente do que acontece quando um campo é lido incorretamente no seu fluxo de trabalho. Um total de fatura lido incorretamente é um erro de pagamento. Um resultado de inspeção lido incorretamente é uma falha de conformidade. Um prontuário de paciente lido incorretamente é uma questão de segurança.
Teste nos seus próprios documentos. Não nos mais limpos — nos oito formulários grampeados com manchas de café e anotações nas margens. São esses que determinam se o seu pipeline de extração funciona ou apenas parece funcionar até que alguém encontre um erro.