O que é reconhecimento de manuscrito por IA?
Como a IA de visão lê a cursiva
O reconhecimento de manuscrito por IA é o uso de modelos de IA de visão para ler e converter texto manuscrito — seja impresso, cursivo ou misto — de uma foto ou digitalização em dados estruturados legíveis por máquina. Diferente do OCR tradicional, criado para comparar fontes impressas limpas com modelos fixos de caracteres, a IA de visão entende a caligrafia como uma pessoa: observando a palavra inteira, o contexto ao redor e o que o documento está tentando comunicar. Em caligrafia de boa qualidade, os modelos modernos de IA alcançam 85–95% de precisão — enquanto o OCR tradicional muitas vezes cai abaixo de 50% no momento em que as letras começam a se conectar.
Principais conclusões
- O reconhecimento de manuscrito por IA não se trata de transformar a cursiva em texto pesquisável — trata-se de extrair campos de dados estruturados de formulários manuscritos diretamente para colunas de planilha.
- O OCR tradicional falha na cursiva não porque é "ruim" com caligrafia, mas porque segmenta caracteres individuais — e letras conectadas tornam o isolamento de caracteres fundamentalmente impossível, quebrando o fluxo logo na primeira etapa.
- O avanço é a leitura semântica: a IA encontra campos entendendo o que eles significam, não onde aparecem, então as mesmas definições de coluna extraem dados de qualquer formulário manuscrito sem treinamento por escritor ou modelos por formato.
O que o reconhecimento de manuscrito por IA realmente é
Vamos esclarecer de imediato a confusão mais comum: o reconhecimento de manuscrito por IA não se trata de reconhecer sua assinatura. Trata-se de ler os campos de dados em um documento manuscrito — o número da fatura que alguém rabiscou no topo de um formulário, a data de entrega que um motorista anotou em um comprovante de entrega (POD), as horas que um encarregado escreveu a lápis em uma folha de ponto de papel. A tecnologia analisa uma foto de um documento manuscrito e responde às mesmas perguntas que você faria a um auxiliar de digitação humano: qual é a data, quem é o fornecedor, quantas unidades, qual é o total?
Essa distinção importa porque a maioria dos recursos que você encontrará sobre "OCR de manuscrito" fala sobre converter páginas de anotações manuscritas em texto editável — um problema de digitalização. Mas a maioria das empresas que lida com documentos manuscritos não tem um problema de digitalização. Elas têm um problema de extração de dados. Uma pilha de 50 notas de entrega manuscritas não é valiosa como 50 arquivos de texto pesquisáveis. É valiosa como uma planilha com colunas para data, destinatário, itens e assinatura — pronta para importar em um sistema de inventário. Esse é o salto do reconhecimento de texto para a extração de dados estruturados, e é o que separa o reconhecimento de manuscrito por IA das ferramentas de OCR de manuscrito da década passada.
Para entender como isso se encaixa no cenário mais amplo da automação de documentos, veja nosso guia sobre o que a extração de documentos por IA realmente faz — o reconhecimento de manuscrito é uma de suas capacidades mais desafiadoras e mais impactantes.
Reconhecimento de manuscrito vs OCR tradicional vs transcrição humana
Se você já tentou usar um aplicativo de digitalização ou o Adobe Acrobat em um formulário manuscrito e recebeu de volta algo sem sentido, você experimentou a incompatibilidade fundamental entre aquilo para o que o OCR tradicional foi criado e o que a escrita à mão exige. As três abordagens produzem resultados radicalmente diferentes a partir do mesmo ponto de partida — uma foto de um documento manuscrito.
| Abordagem | Como funciona | Precisão em cursiva | Saída | Melhor para |
|---|---|---|---|---|
| OCR tradicional | Compara padrões de pixels com modelos de caracteres conhecidos — um caractere por vez | 40–60% | String de texto bruta; falha em letras conectadas | Documentos impressos com fontes limpas e uniformes |
| Reconhecimento de manuscrito por IA | Modelos de visão leem palavras e linhas inteiras de forma holística, usando o contexto ao redor para resolver ambiguidades | 85–95% em escrita legível | Dados estruturados (Excel, CSV, JSON) — cada campo em sua própria coluna | Formulários manuscritos, documentos com impresso e cursiva misturados, relatórios de campo, notas de entrega |
| Transcrição humana | Uma pessoa lê e digita cada campo | ~99% (com erros causados por fadiga) | Qualquer formato em que a pessoa digite | Requisitos de baixo volume e alta precisão, onde o custo não é a restrição principal |
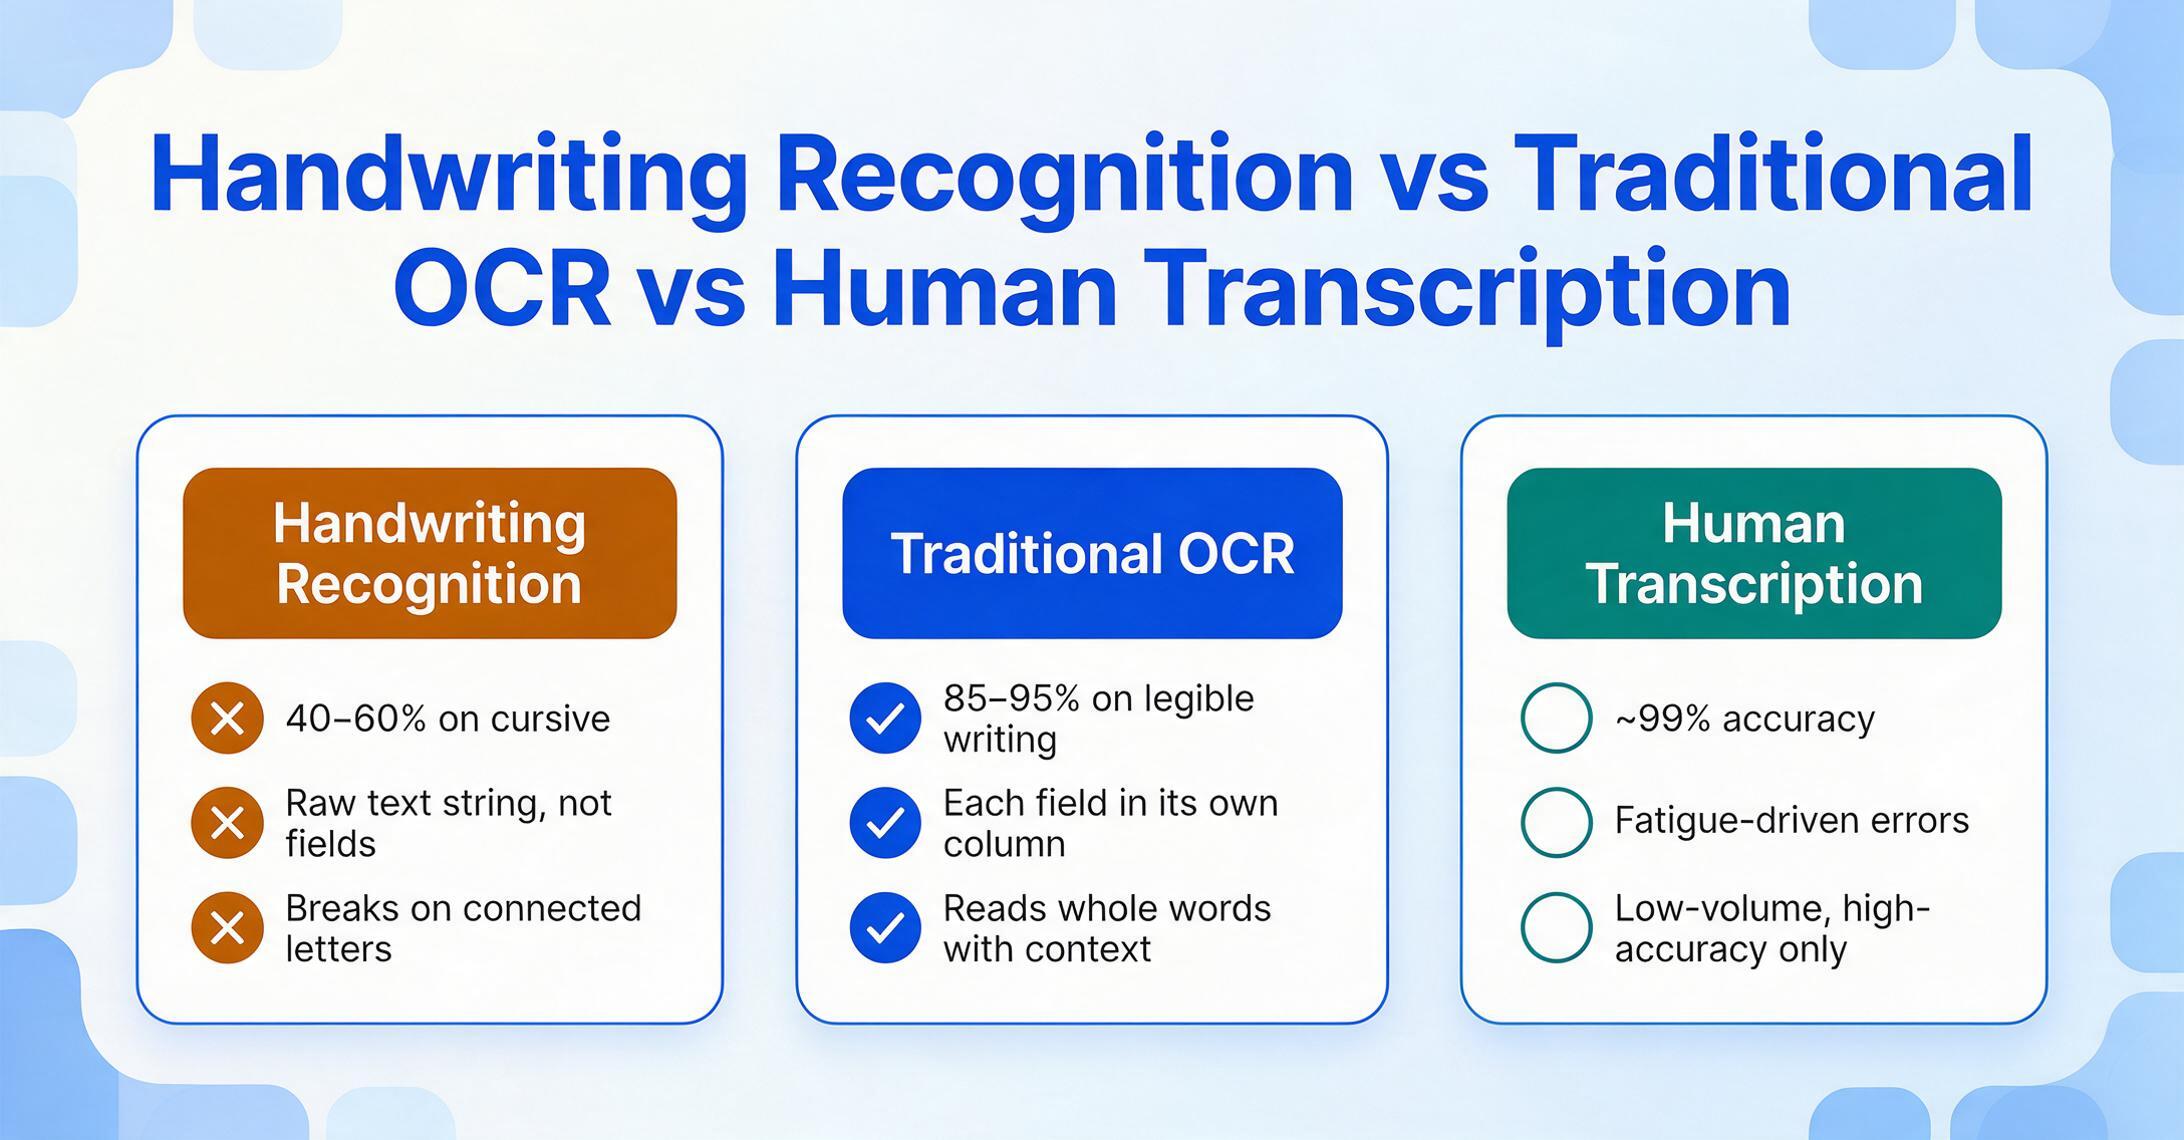
Os números são contundentes. Em um benchmark independente de 14 modelos de IA em 100 amostras de escrita cursiva, os principais modelos de visão-linguagem alcançaram precisão semântica quase perfeita, enquanto os motores de OCR tradicional registraram taxas de erro que tornavam a saída efetivamente inutilizável. Um serviço especializado em manuscrito mediu uma taxa de erro de palavras de 0,9% em escrita limpa — e 95,4% para o Tesseract, um motor de OCR de código aberto amplamente usado, na mesma amostra. Essa é a diferença entre uma correção por página e uma correção por frase.
Esses são números em nível de expectativa — a precisão principal que você pode razoavelmente esperar de cada abordagem em documentos típicos. A precisão é medida de forma diferente dependendo da pergunta que você faz: taxas de erro em nível de caractere (CER/WER) descrevem a transcrição bruta, enquanto a precisão em nível de campo descreve se cada valor cai na coluna correta da planilha. Nosso aprofundamento no mecanismo reporta os números em nível de caractere, e nossa comparação entre IA e OCR tradicional mede a precisão em nível de campo por tipo de documento.
O que impulsiona essa lacuna não é uma melhoria incremental. É uma arquitetura fundamentalmente diferente. O OCR tradicional segmenta uma página em caracteres individuais, compara cada um com uma biblioteca de modelos e remonta os resultados. A escrita cursiva quebra esse fluxo logo na primeira etapa: você não consegue segmentar letras conectadas sem já saber onde uma termina e a próxima começa. É por isso que uma fatura nítida e digitada pode ser escaneada com 99% de precisão, enquanto uma versão manuscrita do mesmo documento cai para 50% — o motor de OCR nunca passou da primeira etapa.
Para números de precisão detalhados por tipo de manuscrito — letras de forma impressas, cursiva organizada, cursiva bagunçada — e o que esses números significam para os seus próprios documentos, veja a IA consegue ler manuscrito com precisão utilizável.
Essa mesma lacuna arquitetural aparece em todos os tipos de documento. Para ver como a extração tradicional baseada em modelo se compara às abordagens com IA em documentos impressos, veja nossa comparação entre reconhecimento de manuscrito por IA e OCR tradicional. E para o desafio específico de extrair dados de formulários manuscritos — onde os riscos são maiores — leia sobre extrair campos específicos de formulários manuscritos.
Como Funciona o Reconhecimento de Manuscrito
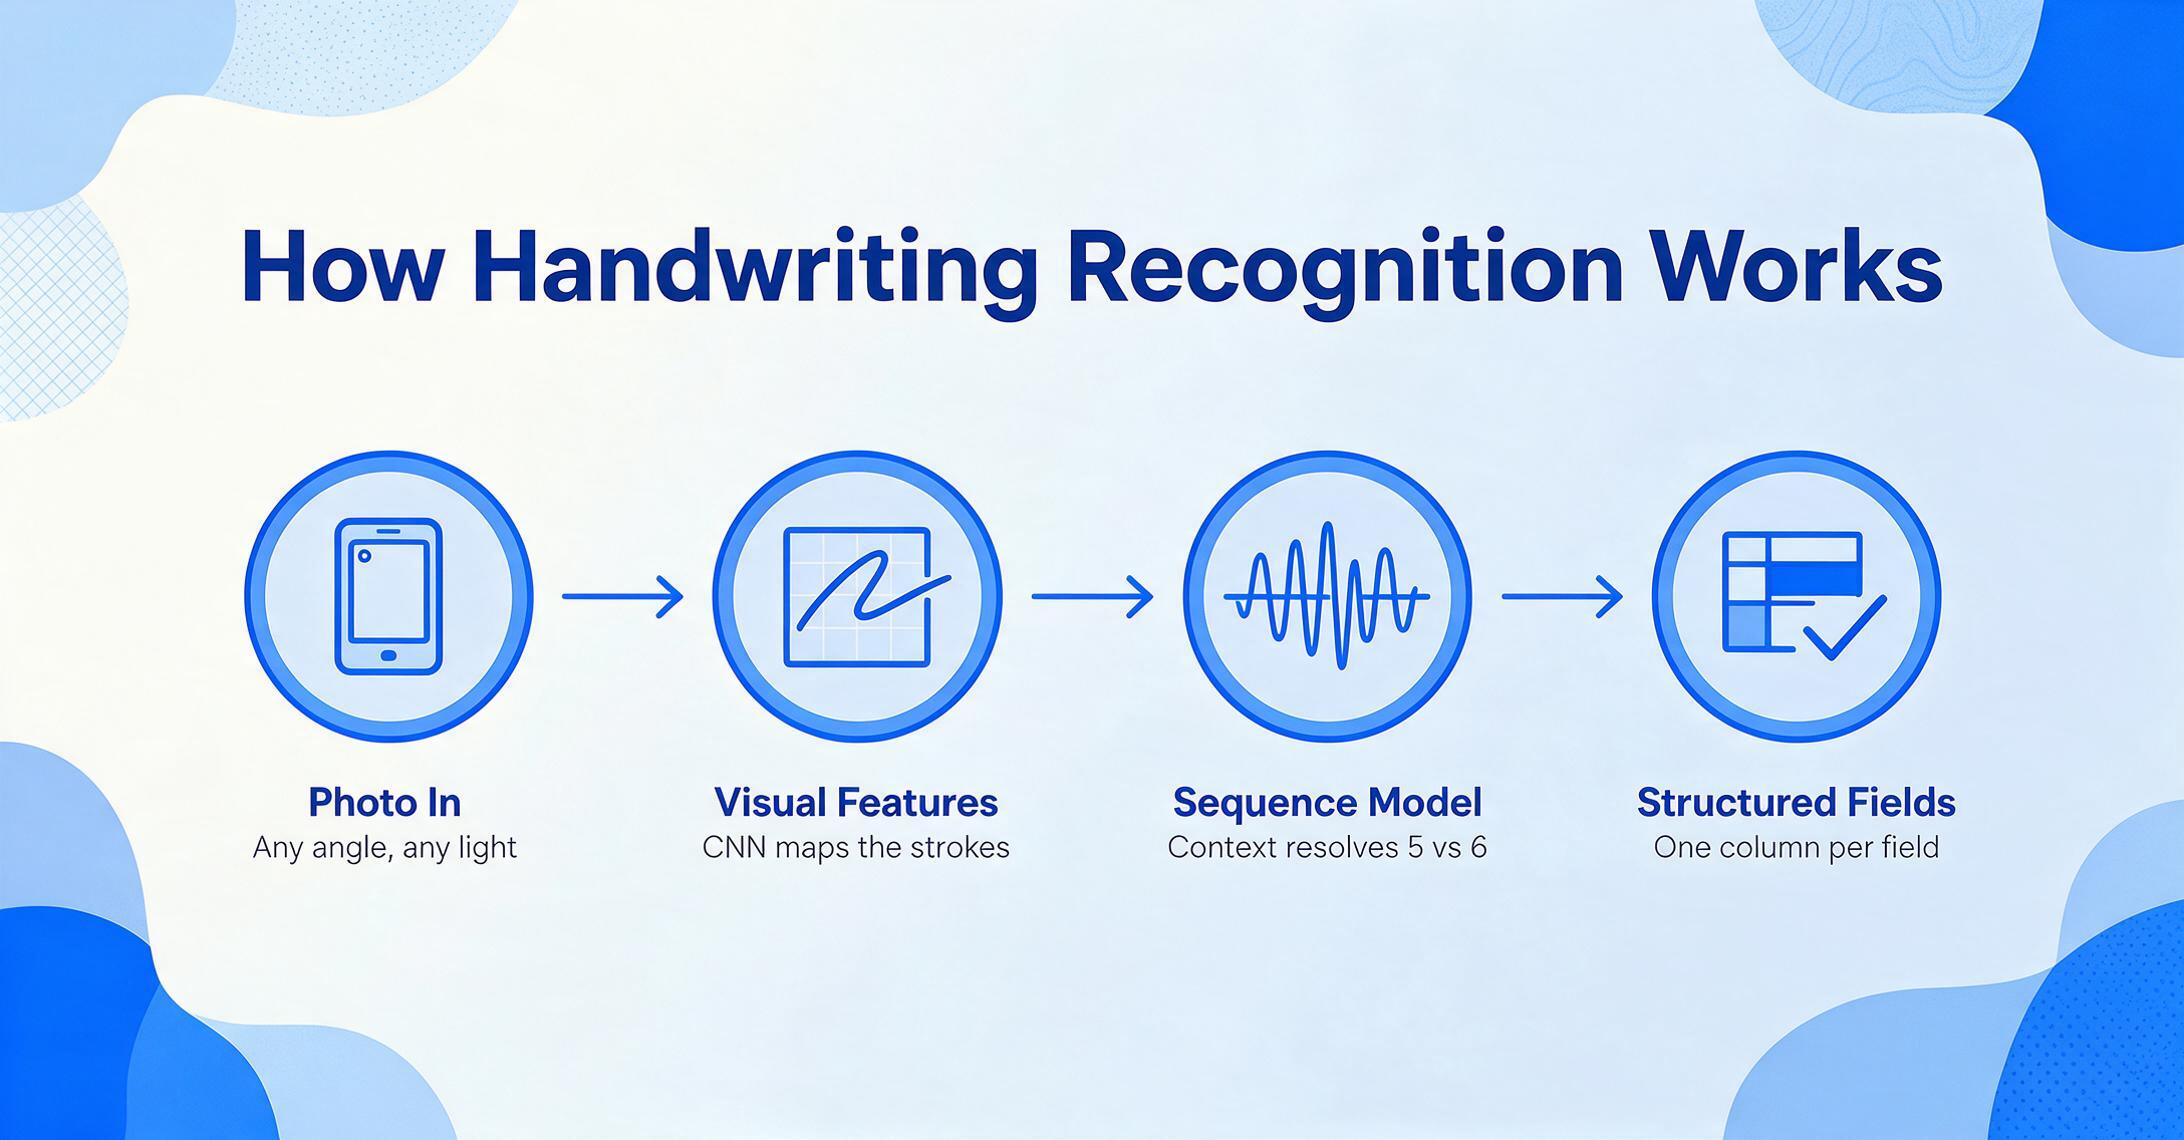
A razão pela qual a IA tem sucesso onde o OCR tradicional falha se resume a uma mudança de estratégia: de segmentação de caracteres para compreensão holística. E essa mudança altera tudo sobre o que é possível.
Esta seção é a visão geral — para um passo a passo da arquitetura subjacente, incluindo exatamente por que a segmentação de caracteres colapsa em letras conectadas e como o contexto resolve dígitos ambíguos como um "5" vs "6" manuscrito, veja nosso aprofundamento sobre como funciona o reconhecimento de manuscrito.
O OCR tradicional trata uma página de manuscrito como um quebra-cabeça: isole cada letra, identifique-a, passe para a próxima. O problema é que o manuscrito não funciona em letras isoladas. Um "r" minúsculo conectado a um "i" parece diferente de um "r" conectado a um "n". Um "qty" escrito às pressas por um médico pode parecer "gty" fora de contexto — mas apenas um deles faz sentido em uma nota de entrega. O OCR tradicional não sabe o que faz sentido. Ele apenas compara formas.
O reconhecimento de manuscrito por IA moderno usa redes neurais convolucionais (CNNs) para extrair características visuais da imagem, depois redes neurais recorrentes (RNNs) ou modelos Transformer para processar essas características como uma sequência — tratando uma linha de manuscrito como um sinal contínuo em vez de uma série de caracteres discretos. É por isso que a abordagem às vezes é chamada de reconhecimento de texto manuscrito (HTR) para distingui-la do OCR: todo o pipeline de reconhecimento foi reconstruído em torno de como o manuscrito realmente se comporta.
Os modelos de visão-linguagem vão além. Em vez de apenas reconhecer caracteres, eles entendem o documento. Quando um campo é rotulado como "Delivery Date" em um formulário e "Date Rec'd" em outro, a IA não precisa que lhe digam que são a mesma coisa — ela lê o rótulo, entende o que significa e localiza o valor manuscrito correspondente em qualquer lugar da página. Esta é a diferença entre uma ferramenta que vê texto e uma ferramenta que lê um documento.
A implicação prática é significativa: o reconhecimento de manuscrito por IA não precisa que você crie um modelo para cada layout de documento, treine-o com amostras da sua caligrafia específica ou configure regras de extração. Você descreve o que quer — "Nome do Remetente", "Data de Envio", "Contagem de Itens" — e a IA encontra cada valor entendendo o que ele significa, independentemente de onde apareça ou de como esteja escrito. Este é o conceito central por trás da Extração de Colunas Personalizadas: você nomeia suas colunas, e a IA as preenche lendo o documento semanticamente em vez de escaneá-lo posicionalmente. Para uma análise mais profunda de como essa tecnologia lida com os cenários de manuscrito mais difíceis, veja nosso artigo sobre modos comuns de falha na extração de manuscrito e como evitá-los.
Quando Você Precisa de Reconhecimento de Manuscrito
A ironia do reconhecimento de manuscrito é que as pessoas que mais precisam dele geralmente estão mais longe de um computador. Trabalhadores de campo preenchem formulários em papel no local. Motoristas de entrega rabiscam assinaturas e quantidades nas docas de carregamento. Inspetores marcam caixas e escrevem anotações em pranchetas em armazéns. Esses documentos se acumulam até que alguém — geralmente um administrador de escritório ou dono de pequeno negócio — enfrente a tarefa de digitar todos esses dados manuscritos em um sistema.
O reconhecimento de manuscrito vale a pena quando pelo menos uma destas condições é verdadeira nos seus documentos:
Quatro Sinais de Que Você Precisa de Reconhecimento de Manuscrito
1. O volume ultrapassa o limite manual. Processar 20+ formulários manuscritos por semana — isso é 80+ por mês — a 3–5 minutos por formulário para entrada manual de dados. Nessa escala, até 85% de precisão da IA com uma rápida verificação humana é drasticamente mais rápido que 100% de entrada manual.
2. A caligrafia vem de várias pessoas. Um escritório de construção pode receber folhas de ponto de uma dúzia de subcontratados diferentes, cada um com caligrafia diferente. Um centro logístico pode processar notas de entrega de motoristas em três turnos. A variabilidade da caligrafia é o problema, e a IA lida com isso melhor que sistemas baseados em modelo que presumem consistência.
3. Os documentos misturam conteúdo impresso e manuscrito. Um formulário de inspeção pré-impresso com observações manuscritas. Uma fatura impressa com assinatura e data manuscritas. Um cartão de leitura de medidor com números de conta impressos e uma leitura manuscrita. O OCR tradicional lê a parte impressa bem e produz lixo para a parte manuscrita — forçando você a lidar com ambas separadamente.
4. Os documentos são sensíveis ao tempo. Confirmações de entrega que precisam acionar atualizações de estoque. Relatórios de inspeção que precisam sinalizar problemas de segurança. Folhas de ponto que precisam chegar à folha de pagamento até sexta-feira. O atraso não é a extração — é a pilha de papel esperando alguém digitar.
Veja como isso se parece nos tipos de documento onde a caligrafia é mais comum:
Notas de entrega manuscritas e comprovantes de entrega (PODs). Um motorista deixa uma remessa, o recebedor assina um comprovante em papel, e esse comprovante volta ao escritório — às vezes dias depois, às vezes com uma mancha de café. Cada hora que esse comprovante fica sem processamento é uma hora em que seu sistema de estoque não sabe que a entrega aconteceu. O reconhecimento de manuscrito por IA pode ler o nome do recebedor, data, itens e quantidades de uma foto tirada no ponto de entrega. Veja nosso aprofundamento sobre extração de notas de entrega manuscritas para departamentos de recebimento.
Folhas de ponto e registros de presença manuscritos. Equipes de construção, técnicos de serviço em campo e trabalhadores de turno na indústria frequentemente preenchem cartões de ponto em papel. Um encarregado pode anotar a lápis as horas de 15 trabalhadores em uma única folha — nomes, datas, horas, códigos de trabalho. Colocar esses dados na folha de pagamento significa que alguém digita cada campo. A IA lê a folha inteira de uma vez, gerando uma linha por trabalhador por dia. Leia mais sobre converter folhas de ponto manuscritas para Excel para folha de pagamento.
Faturas manuscritas. Pequenos fornecedores e subcontratados — o encanador que conserta um vazamento na sua propriedade, o eletricista que faz um pequeno serviço — frequentemente escrevem suas faturas à mão em blocos genéricos. Elas não seguem nenhum formato padrão e são manuscritas, então ferramentas de extração baseadas em modelo não conseguem processá-las. A IA de visão as lê entendendo o que uma fatura é, não como ela se parece. Veja extração de faturas manuscritas para empreiteiros.
Formulários de inspeção e diários de obra manuscritos. Inspeções de segurança, verificações de equipamentos, relatórios diários de construção — quase sempre são preenchidos à mão, no local, com caneta ou lápis. Os formulários são pré-impressos, mas os dados — observações, leituras, marcações, assinaturas — são manuscritos. A IA lê ambas as camadas, extraindo dados estruturados das anotações manuscritas enquanto reconhece os rótulos de campo impressos para contexto. Especificamente para construção, veja extração de diários de obra manuscritos para Excel.
Leituras de medidores manuscritas. Um funcionário da concessionária percorre uma rota, lê medidores e anota números em uma prancheta — às vezes a lápis, às vezes na chuva. Essas leituras precisam se tornar dados de faturamento. A IA lê valores numéricos manuscritos a partir de fotos de cartões de medidor, mesmo quando a qualidade da caligrafia varia de um leitor para outro. Veja converter leituras de medidores para planilhas.
Registros manuscritos antigos. Livros-razão antigos, cartões de inventário de armazém, formulários de admissão de pacientes de antes dos sistemas de EHR — décadas de dados manuscritos que existem apenas em papel. Digitalizá-los não é sobre processamento em tempo real; é sobre desbloquear informações que atualmente são invisíveis. Para livros-razão históricos, veja nosso guia sobre precisão de leitura de livros-razão manuscritos por IA.
Cada um desses tipos de documento tem campos diferentes, layouts diferentes e desafios de caligrafia diferentes. Mas eles compartilham o mesmo gargalo: um humano precisa digitar os dados. O reconhecimento de manuscrito por IA remove esse gargalo — não substituindo o julgamento humano, mas cuidando da transcrição para que o humano só precise verificar.
O que Procurar em uma Ferramenta de Reconhecimento de Manuscrito
Nem todas as ferramentas de reconhecimento de manuscrito resolvem o mesmo problema. Algumas são feitas para converter páginas de anotações manuscritas em texto pesquisável. Outras são feitas para extrair dados estruturados de formulários manuscritos e gerar uma planilha. Se você está avaliando ferramentas, aqui estão os quatro critérios que separam as duas:
1. Saída Estruturada, Não Apenas Texto Reconhecido
Uma ferramenta que gera um bloco de texto dizendo "Date: 12/04/2026 Vendor: Acme Qty: 50" fez OCR de manuscrito, não extração de dados. Você ainda precisa interpretar esse texto, dividi-lo em campos e digitá-lo nas colunas corretas. Uma ferramenta de extração adequada entrega uma planilha onde "12/04/2026" está na coluna Date, "Acme" está na coluna Vendor e "50" está na coluna Quantity — sem nenhuma interpretação manual. Pergunte: a saída vai para colunas estruturadas ou para uma caixa de texto?
2. Reconhecimento sem Modelo
Se uma ferramenta exige que você defina zonas, desenhe caixas ou crie modelos de interpretação para cada formato de documento, ela herda a fraqueza fundamental do OCR tradicional. Documentos manuscritos de fontes diferentes terão layouts diferentes — um comprovante de entrega de um motorista não se parece em nada com o de outro. A ferramenta precisa encontrar os dados entendendo o que eles significam, não comparando posições. Pergunte: se um novo fornecedor enviar um documento manuscrito em um formato que você nunca viu, a ferramenta consegue lidar com ele sem configuração?
3. Tratamento de Impresso e Manuscrito Misturados
Documentos do mundo real raramente são puramente manuscritos. Um formulário de inspeção tem rótulos de campo impressos e observações manuscritas. Um cartão de medição tem um número de conta impresso e uma leitura manuscrita. Um comprovante de entrega tem um cabeçalho de empresa impresso e quantidades manuscritas. A ferramenta precisa lidar com ambos em uma única passagem — não exigir que você os separe ou execute dois fluxos de processamento diferentes. Pergunte: a ferramenta consegue extrair de um formulário que tem rótulos impressos, valores manuscritos e caixas de seleção — tudo em um único upload?
4. Processamento Prioritário em Lote como Recurso Essencial
Se você processa uma página manuscrita por mês, qualquer ferramenta serve. Mas a maioria dos casos de uso de reconhecimento de manuscrito envolve lotes — 30 comprovantes de entrega de uma semana de remessas, 15 folhas de ponto de uma equipe, 50 formulários de inspeção de uma auditoria de site. A ferramenta deve ser feita para processá-los juntos e mesclar os resultados em uma única planilha — não forçar você a fazer upload, extrair e exportar um arquivo por vez. Pergunte: você consegue enviar uma pasta de documentos e receber de volta uma planilha, em vez de cinquenta exportações separadas?
Se você está comparando ferramentas específicas lado a lado, nosso guia das melhores ferramentas de reconhecimento de manuscrito em 2026 percorre o cenário em detalhes. E para uma comparação direta das tecnologias subjacentes, veja reconhecimento de manuscrito por IA vs OCR tradicional.
Perguntas Frequentes
O reconhecimento de manuscrito por IA funciona com letra cursiva?
Sim — e é aqui que a IA supera o OCR tradicional de forma mais dramática. Como os modelos de IA leem palavras e linhas inteiras de forma holística, em vez de segmentar caracteres individuais, eles lidam com letras cursivas conectadas que quebrariam um mecanismo de OCR caractere por caractere. A precisão em cursiva legível normalmente varia de 80–90%, em comparação com 40–60% do OCR tradicional. Quanto mais consistente o estilo de escrita dentro de um documento, maior a precisão.
A IA consegue ler manuscrito de uma foto de celular, ou precisa de um scan adequado?
Fotos de celular funcionam. Os modelos modernos de IA de visão são treinados com imagens do mundo real, não apenas digitalizações limpas, então lidam com fotos em ângulo, iluminação irregular e sombras melhor que o OCR tradicional — que espera documentos planos e com iluminação uniforme. Uma foto nítida tirada com boa luz (sem desfoque de movimento, texto legível a olho humano) normalmente produz resultados próximos aos de uma imagem digitalizada. O benefício prático é significativo: trabalhadores em campo podem fotografar um comprovante de entrega (POD) ou formulário de inspeção no local com o celular, e os dados são extraídos imediatamente — sem necessidade de scanner.
Que qualidade de manuscrito é ruim demais para a IA ler?
Se dois leitores humanos não conseguem concordar sobre o que diz uma palavra manuscrita, é improvável que a IA resolva isso também. O limite prático é a legibilidade: se uma pessoa que não conhece quem escreveu consegue ler 80%+ do texto sem adivinhar, a IA provavelmente terá desempenho na faixa de 85–95%. Cursiva extremamente estilizada, riscos pesados, texto escrito em ângulos acentuados e cópias em papel-carbono onde a terceira ou quarta camada é quase invisível podem derrubar a precisão para abaixo de 70%. Nesses casos, uma etapa de revisão com humano no circuito ainda é necessária para extração de alta confiança — mas ainda é mais rápida que a digitação totalmente manual.
A IA consegue distinguir texto impresso de manuscrito na mesma página?
Sim. Os modelos de IA de visão processam a página inteira como uma imagem visual e conseguem distinguir texto impresso de manuscrito — da mesma forma que você identifica de relance quais partes de um formulário foram pré-impressas e quais foram preenchidas à mão. Isso é essencial para a extração de formulários estruturados: a IA usa os rótulos impressos ("Date:", "Inspector:", "Findings:") como âncoras para entender o que significam os valores manuscritos e, em seguida, extrai esses valores para as colunas corretas.
O reconhecimento de manuscrito funciona com caixas de seleção, marcas de verificação e opções circuladas?
A IA de visão moderna consegue detectar se uma caixa de seleção está marcada, se um círculo está preenchido ou se uma opção está riscada — e gerar o resultado como dados estruturados (por exemplo, "Verificação de Segurança Aprovada: Sim"). Isso vai além do reconhecimento de texto e entra na compreensão visual: a IA vê a caixa de seleção e sua marca como elementos visuais, não como caracteres. A precisão na detecção de caixas de seleção nítidas costuma ser alta (90%+), embora opções muito aglomeradas ou marcas fracas a lápis possam reduzir a confiabilidade. Para um mergulho profundo sobre por que as caixas de seleção continuam sendo a parte mais difícil da extração de formulários — e as cinco formas como até bons modelos erram — veja nosso artigo sobre por que a IA lê formulários manuscritos, mas ainda deixa passar uma caixa marcada.
Posso extrair campos específicos de formulários manuscritos, ou a IA apenas despeja todo o texto?
Você pode extrair campos específicos. Com a Extração de Colunas Personalizadas, você define as colunas que deseja — "Data de Entrega", "Nome do Destinatário", "Quantidade de Itens" — e a IA localiza e extrai apenas esses campos de cada documento. Essa é a diferença entre receber uma parede de texto que você ainda precisa organizar e receber uma planilha em que cada coluna é exatamente o dado que você precisa. A abordagem funciona em diversos tipos de documento: as mesmas colunas podem extrair dados de faturas manuscritas, notas de entrega e formulários de inspeção — porque a IA encontra os campos pelo significado, não pela posição. Para um guia passo a passo, veja extração de colunas personalizadas para documentos manuscritos.
Preciso treinar a IA com amostras da minha caligrafia específica?
Não — os modelos modernos de IA de visão já vêm pré-treinados com milhões de amostras de manuscrito de diferentes estilos, idiomas e tipos de documento. Eles lidam com novos estilos de caligrafia sem qualquer treinamento por escritor ou coleta de amostras. Se sua organização tem um único escritor com um estilo extremamente incomum (escritas históricas, cursiva não latina, taquigrafia muito estilizada), o ajuste fino nessa caligrafia específica pode melhorar a precisão — mas, para a maioria dos casos de uso empresarial com vários escritores preenchendo formulários padrão, o modelo pronto para uso já entrega precisão utilizável sem nenhuma configuração.
A Conclusão
A escrita à mão tem sido a última fronteira teimosa na automação de documentos — aquilo que obrigava uma pessoa a sentar e digitar, não importava quantas outras partes do processo já estivessem digitalizadas. Essa fronteira mudou. O reconhecimento de manuscrito por IA não iguala a precisão humana em todos os documentos, e provavelmente nunca vai igualar nos 5% de escrita mais bagunçada. Mas nos 85–95% dos documentos manuscritos em que a escrita é razoavelmente legível, ele elimina totalmente a etapa de transcrição — transformando "alguém precisa digitar tudo isso" em "alguém precisa conferir o trabalho da IA".
As pessoas que mais se beneficiam não são pesquisadores de IA nem departamentos de TI corporativos. São a gerente de escritório de uma construtora que processa 40 folhas de ponto manuscritas toda segunda-feira. O auxiliar de armazém que recebe comprovantes de entrega (POD) de um grupo rotativo de motoristas. O dono de pequeno negócio cujos fornecedores ainda enviam faturas manuscritas em blocos de papel carbono. Para eles, a questão não é "a IA consegue igualar a precisão humana em todos os documentos". É "a IA consegue lidar com os 90% dos documentos que são claros o suficiente, me liberando para focar nos 10% que precisam de uma análise mais atenta". A resposta, em 2026, é sim.