Qu'est-ce que la reconnaissance d'écriture manuscrite par IA ?
Comment l'IA de vision lit l'écriture cursive
La reconnaissance d'écriture manuscrite par IA consiste à utiliser des modèles d'IA de vision pour lire et convertir le texte manuscrit — qu'il soit imprimé, cursif ou mixte — depuis une photo ou un scan en données structurées exploitables par machine. Contrairement à l'OCR traditionnelle, conçue pour faire correspondre des polices imprimées propres à des modèles de caractères fixes, l'IA de vision comprend l'écriture manuscrite comme le ferait une personne : en regardant le mot entier, le contexte environnant et ce que le document tente de communiquer. Sur une écriture manuscrite de bonne qualité, les modèles d'IA modernes atteignent une précision de 85 à 95 % — là où l'OCR traditionnelle tombe souvent sous les 50 % dès que les lettres commencent à se connecter.
Points clés à retenir
- La reconnaissance d'écriture manuscrite par IA ne consiste pas à transformer la cursive en texte consultable — il s'agit d'extraire des champs de données structurées des formulaires manuscrits directement dans des colonnes de feuille de calcul.
- L'OCR traditionnelle échoue sur la cursive non pas parce qu'elle est « mauvaise » en écriture manuscrite, mais parce qu'elle segmente les caractères individuellement — et les lettres connectées rendent l'isolation des caractères fondamentalement impossible, brisant le pipeline dès la première étape.
- La percée réside dans la lecture sémantique : l'IA trouve les champs en comprenant ce qu'ils signifient, pas où ils apparaissent, de sorte que les mêmes définitions de colonnes extraient des données de n'importe quel formulaire manuscrit sans formation par scripteur ni modèles par format.
Ce qu'est réellement la reconnaissance d'écriture manuscrite par IA
Commençons par dissiper la confusion la plus courante : la reconnaissance d'écriture manuscrite par IA ne consiste pas à reconnaître votre signature. Elle consiste à lire les champs de données d'un document manuscrit — le numéro de facture griffonné en haut d'un formulaire, la date de livraison notée par un conducteur sur un bordereau de livraison, les heures qu'un chef d'équipe a crayonnées sur une feuille de temps papier. La technologie analyse une photo d'un document manuscrit et répond aux mêmes questions que celles que vous poseriez à un employé de saisie de données : quelle est la date, qui est le fournisseur, combien d'unités, quel est le total ?
Cette distinction est importante car la plupart des ressources que vous trouverez sur « l'OCR d'écriture manuscrite » parlent de convertir des pages de notes manuscrites en texte modifiable — un problème de numérisation. Mais la plupart des entreprises confrontées à des documents manuscrits n'ont pas un problème de numérisation. Elles ont un problème d'extraction de données. Une pile de 50 bons de livraison manuscrits n'a pas de valeur en tant que 50 fichiers texte consultables. Elle a de la valeur en tant que feuille de calcul unique avec des colonnes pour la date, le destinataire, les articles et la signature — prête à être importée dans un système d'inventaire. C'est là qu'on passe de la reconnaissance de texte à l'extraction structurée, et c'est ce qui distingue la reconnaissance d'écriture manuscrite par IA des outils d'OCR manuscrit de la dernière décennie.
Pour comprendre comment cela s'inscrit dans le paysage plus large de l'automatisation documentaire, consultez notre guide sur ce que fait réellement l'extraction de documents par IA — la reconnaissance d'écriture manuscrite est l'une de ses capacités les plus difficiles et les plus impactantes.
Reconnaissance d'écriture manuscrite vs OCR traditionnelle vs transcription humaine
Si vous avez déjà essayé d'utiliser une application de numérisation ou Adobe Acrobat sur un formulaire manuscrit et obtenu un charabia, vous avez vécu l'inadéquation fondamentale entre ce pour quoi l'OCR traditionnelle a été conçue et ce qu'exige l'écriture manuscrite. Les trois approches produisent des résultats radicalement différents à partir du même point de départ — une photo d'un document manuscrit.
| Approche | Comment ça fonctionne | Précision sur l'écriture cursive | Résultat | Idéal pour |
|---|---|---|---|---|
| OCR traditionnelle | Compare des motifs de pixels à des modèles de caractères connus — un caractère à la fois | 40–60 % | Chaîne de texte brute ; échoue sur les lettres attachées | Documents imprimés avec des polices propres et uniformes |
| Reconnaissance d'écriture manuscrite par IA | Les modèles de vision lisent des mots et des lignes entiers de manière globale, en utilisant le contexte environnant pour résoudre les ambiguïtés | 85–95 % sur une écriture lisible | Données structurées (Excel, CSV, JSON) — chaque champ dans sa propre colonne | Formulaires manuscrits, documents mixtes imprimés/manuscrits, rapports de terrain, bons de livraison |
| Transcription humaine | Une personne lit et saisit chaque champ | ~99 % (avec des erreurs liées à la fatigue) | Le format dans lequel la personne saisit les données | Volumes faibles, exigences de haute précision où le coût n'est pas la contrainte principale |
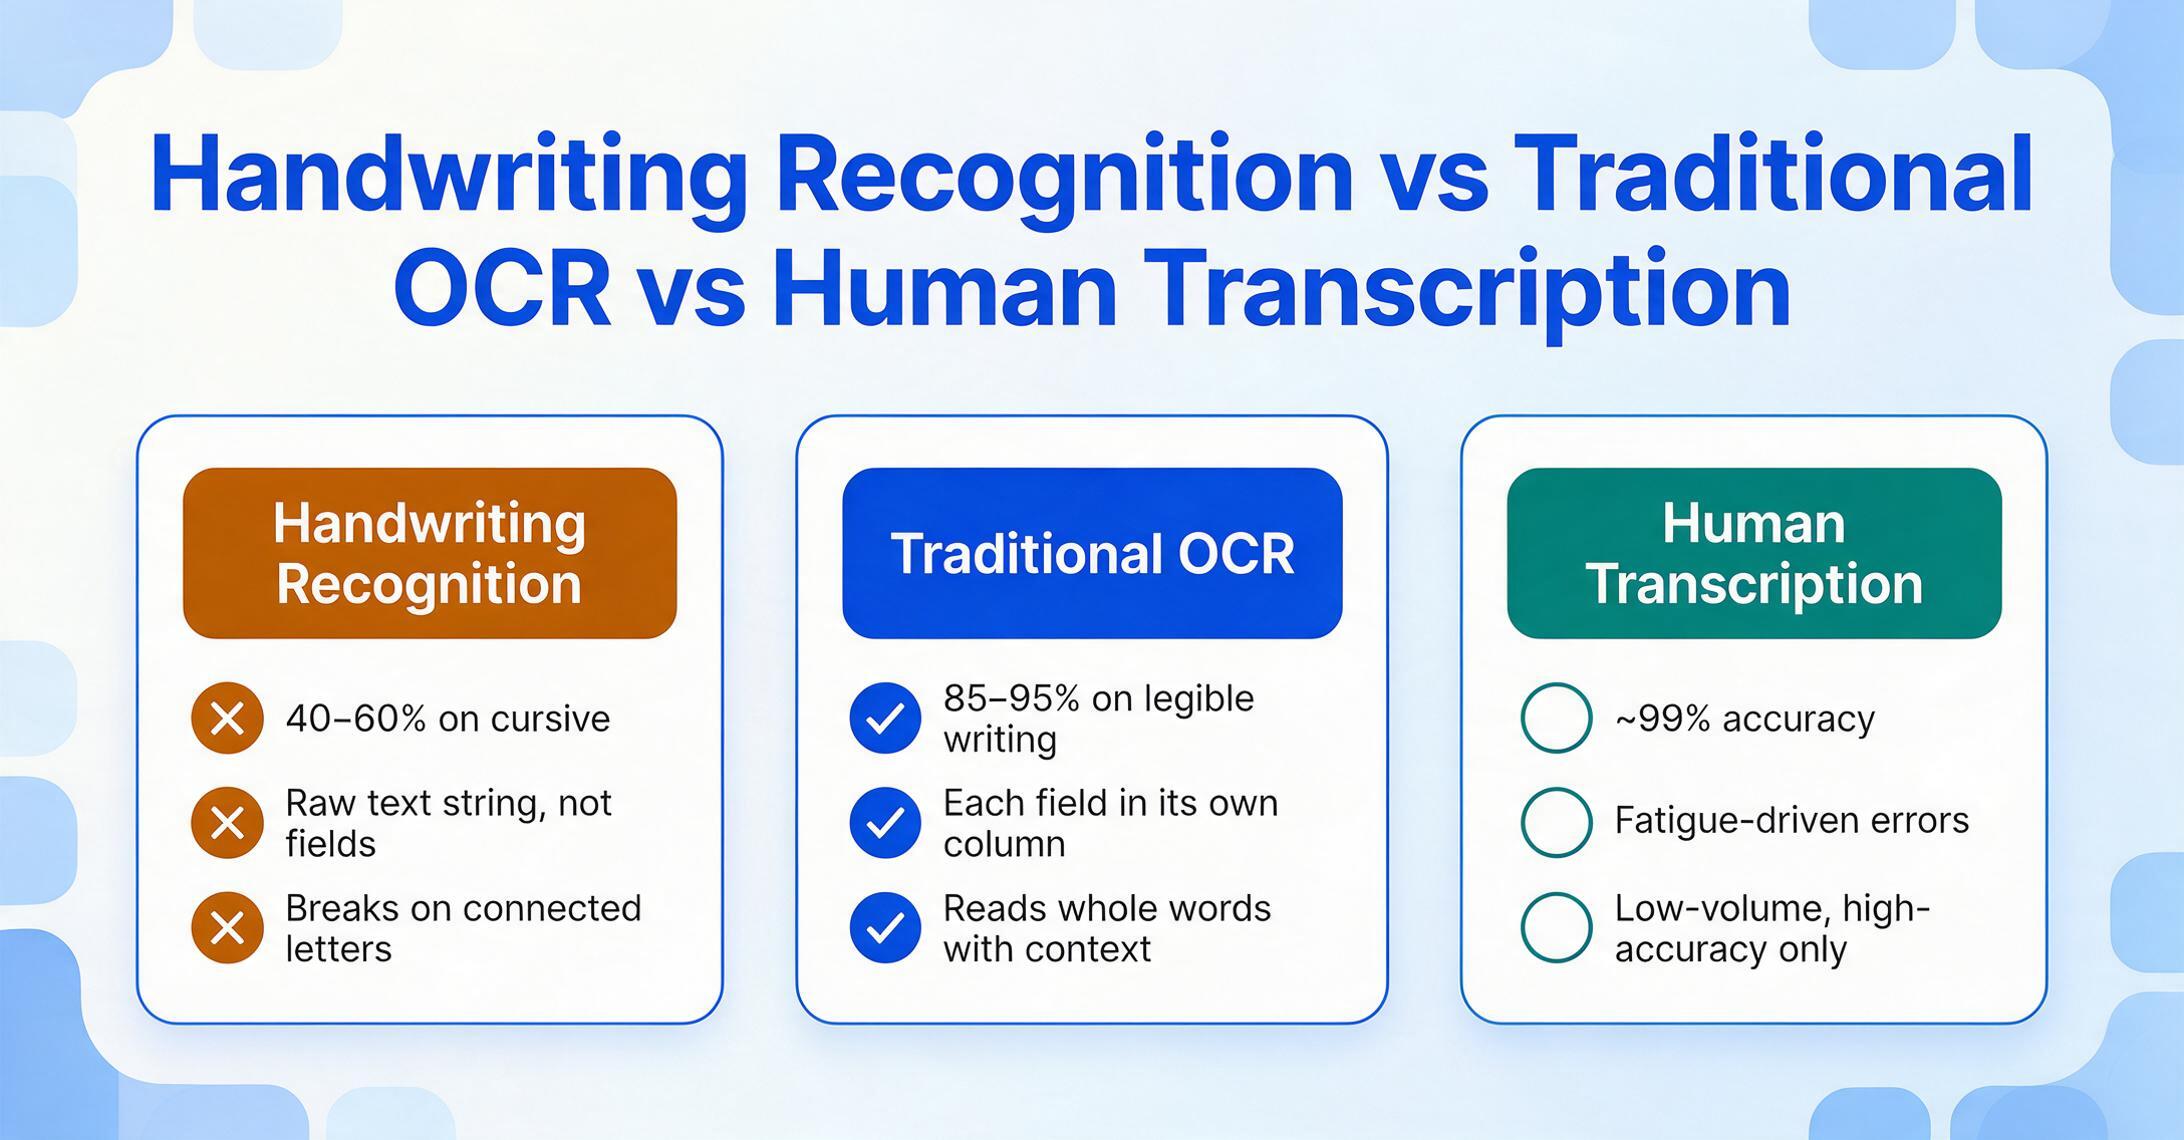
Les chiffres sont sans appel. Dans un benchmark indépendant de 14 modèles d'IA sur 100 échantillons d'écriture cursive, les meilleurs modèles de vision-langage ont atteint une précision sémantique quasi parfaite, tandis que les moteurs d'OCR traditionnelle ont enregistré des taux d'erreur rendant la sortie effectivement inutilisable. Un service spécialisé en écriture manuscrite a mesuré un taux d'erreur mot de 0,9 % sur une écriture propre — et de 95,4 % pour Tesseract, un moteur d'OCR open source largement utilisé, sur le même échantillon. C'est la différence entre une correction par page et une correction par phrase.
Ce sont des chiffres indicatifs — la précision globale que vous pouvez raisonnablement attendre de chaque approche sur des documents typiques. La précision se mesure différemment selon la question posée : les taux d'erreur au niveau du caractère (CER/WER) décrivent la transcription brute, tandis que la précision au niveau du champ décrit si chaque valeur atterrit dans la bonne colonne du tableur. Notre analyse approfondie des mécanismes rapporte les chiffres au niveau du caractère, et notre comparaison entre IA et OCR traditionnelle mesure la précision au niveau du champ par type de document.
Ce qui explique cet écart, ce n'est pas une amélioration progressive. C'est une architecture fondamentalement différente. L'OCR traditionnelle segmente une page en caractères individuels, les fait correspondre à une bibliothèque de modèles, puis reassemble les résultats. L'écriture cursive casse ce pipeline dès la toute première étape : on ne peut pas segmenter des lettres connectées sans déjà savoir où l'une se termine et où la suivante commence. C'est pourquoi une facture dactylographiée nette peut être scannée à 99 % de précision tandis qu'une version manuscrite du même document chute à 50 % — le moteur d'OCR n'a jamais dépassé la première étape.
Pour des chiffres de précision détaillés par type d'écriture manuscrite — lettres capitales imprimées, cursive soignée, cursive brouillonne — et ce que ces chiffres signifient pour vos propres documents, voir l'IA peut-elle lire l'écriture manuscrite avec une précision utilisable.
Ce même écart architectural se retrouve dans tous les types de documents. Pour voir comment l'extraction traditionnelle basée sur des modèles se compare aux approches basées sur l'IA pour les documents imprimés, consultez notre comparaison entre la reconnaissance d'écriture manuscrite par IA et l'OCR traditionnelle. Et pour le défi spécifique de l'extraction de données à partir de formulaires manuscrits — où les enjeux sont les plus élevés — lisez l'extraction de champs spécifiques à partir de formulaires manuscrits.
Comment fonctionne la reconnaissance d'écriture manuscrite
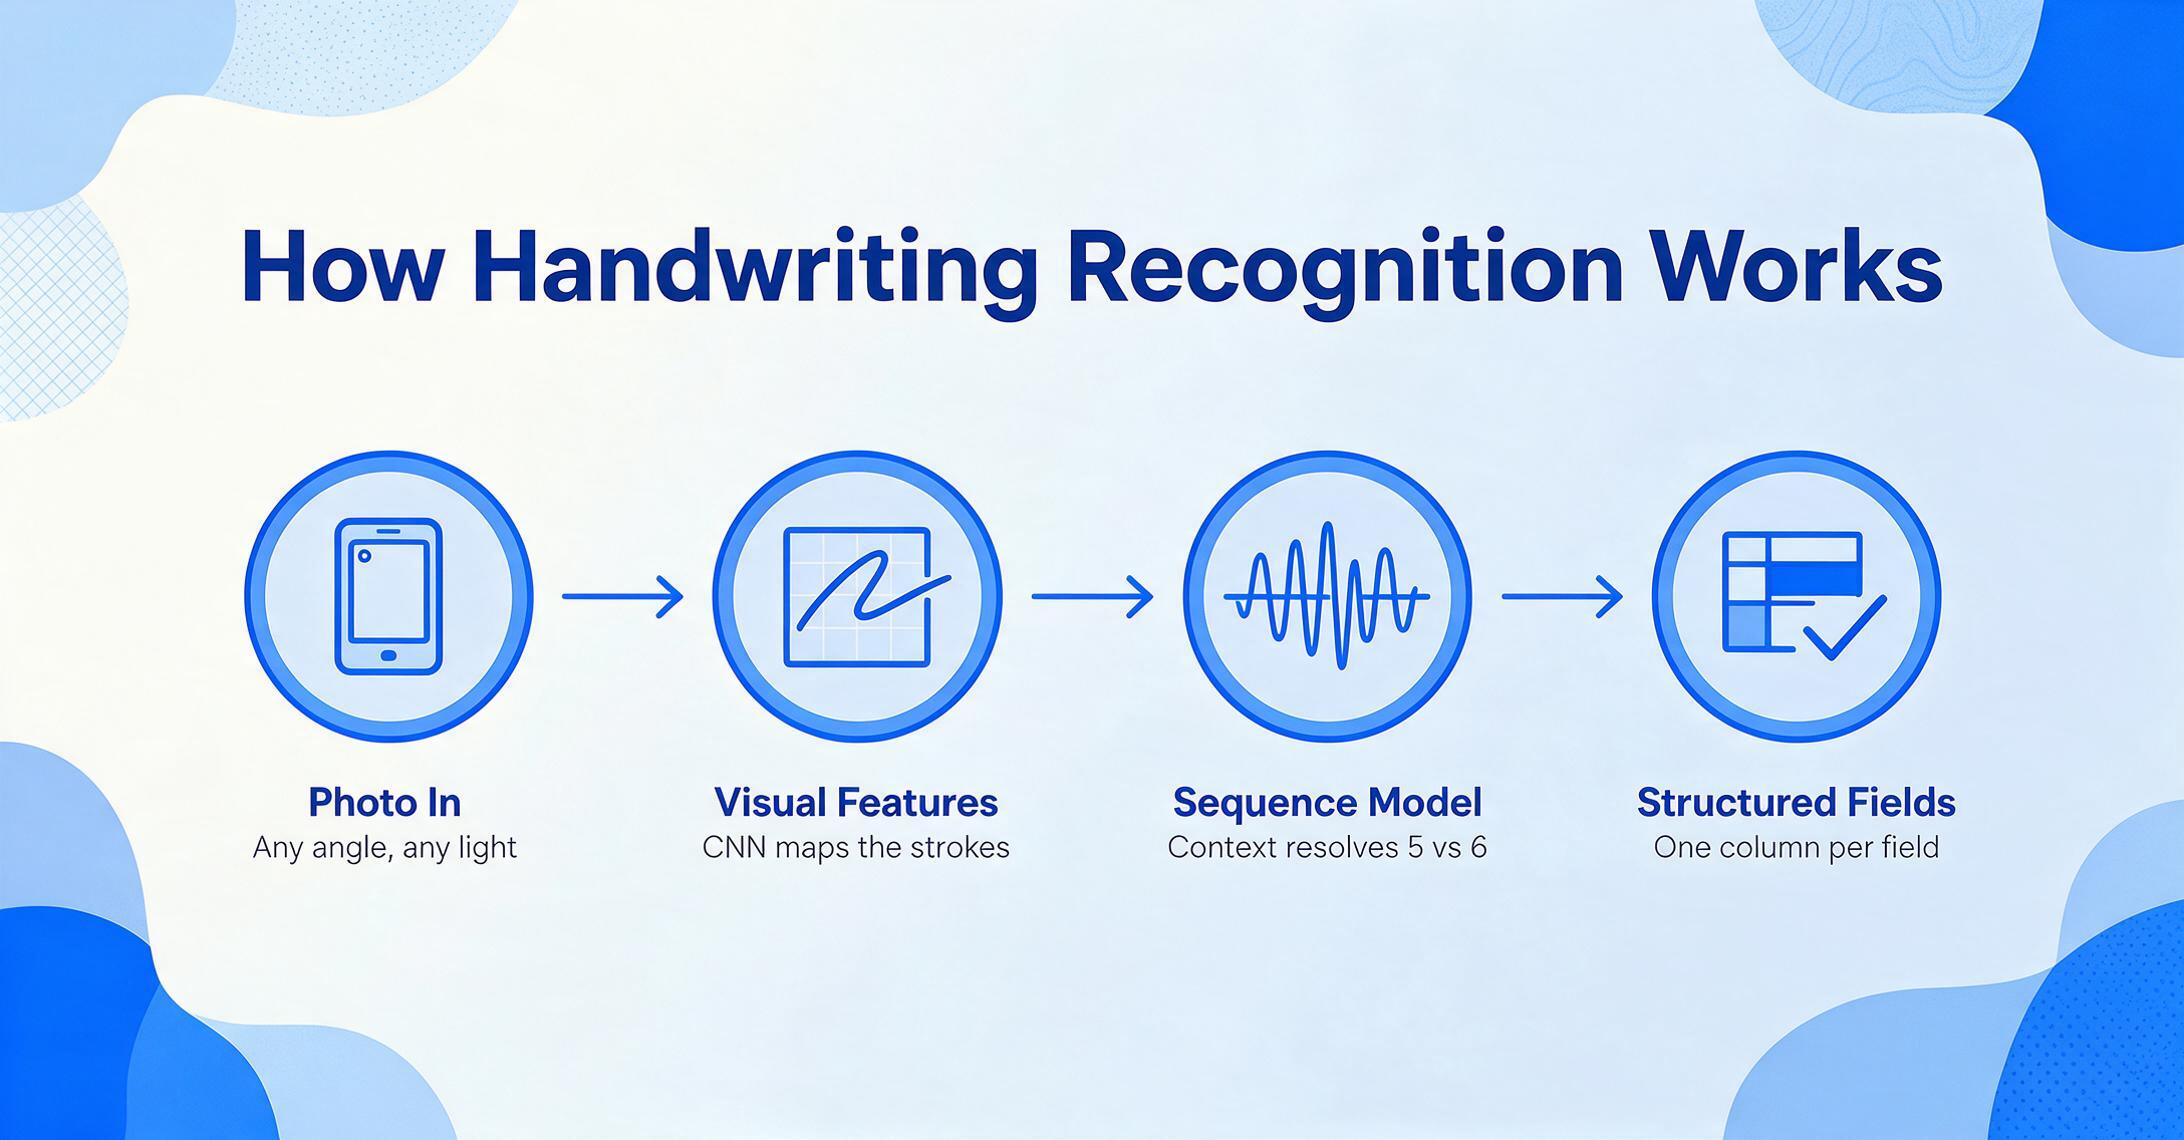
La raison pour laquelle l'IA réussit là où l'OCR traditionnelle échoue tient à un changement de stratégie : passer de la segmentation des caractères à la compréhension holistique. Et ce changement bouleverse tout ce qui est possible.
Cette section est un aperçu — pour une explication pas à pas de l'architecture sous-jacente, y compris pourquoi la segmentation des caractères échoue sur les lettres liées et comment le contexte résout les chiffres ambigus comme un « 5 » ou un « 6 » manuscrit, consultez notre analyse approfondie sur comment fonctionne la reconnaissance d'écriture manuscrite.
L'OCR traditionnelle traite une page d'écriture manuscrite comme un puzzle : isoler chaque lettre, l'identifier, passer à la suivante. Le problème, c'est que l'écriture manuscrite ne fonctionne pas en lettres isolées. Un « r » minuscule relié à un « i » ne ressemble pas à un « r » relié à un « n ». Un « qty » écrit rapidement par un médecin peut ressembler à « gty » hors contexte — mais un seul de ces deux mots a du sens sur un bon de livraison. L'OCR traditionnelle ne sait pas ce qui a du sens. Elle se contente de faire correspondre des formes.
La reconnaissance d'écriture manuscrite par IA moderne utilise des réseaux de neurones convolutifs (CNN) pour extraire les caractéristiques visuelles de l'image, puis des réseaux de neurones récurrents (RNN) ou des modèles Transformer pour traiter ces caractéristiques comme une séquence — traitant une ligne d'écriture manuscrite comme un signal continu plutôt qu'une série de caractères discrets. C'est pourquoi cette approche est parfois appelée reconnaissance de texte manuscrit (HTR) pour la distinguer de l'OCR : tout le pipeline de reconnaissance a été reconstruit autour du comportement réel de l'écriture manuscrite.
Les modèles de vision-langage vont plus loin. Au lieu de simplement reconnaître les caractères, ils comprennent le document. Lorsqu'un champ est étiqueté « Delivery Date » sur un formulaire et « Date Rec'd » sur un autre, l'IA n'a pas besoin qu'on lui dise qu'il s'agit de la même chose — elle lit l'étiquette, comprend ce qu'elle signifie et localise la valeur manuscrite correspondante où qu'elle se trouve sur la page. C'est la différence entre un outil qui voit le texte et un outil qui lit un document.
L'implication pratique est significative : La reconnaissance d'écriture manuscrite par IA ne vous oblige pas à créer un modèle pour chaque mise en page de document, à l'entraîner sur des échantillons de votre écriture spécifique ou à configurer des règles d'extraction. Vous décrivez ce que vous voulez — « Nom de l'expéditeur », « Date d'expédition », « Nombre d'articles » — et l'IA trouve chaque valeur en comprenant ce qu'elle signifie, quel que soit l'endroit où elle apparaît ou la manière dont elle est écrite. C'est le concept central de l'extraction de colonnes personnalisée : vous nommez vos colonnes, et l'IA les remplit en lisant le document de manière sémantique plutôt qu'en le scannant de manière positionnelle. Pour un aperçu plus approfondi de la manière dont cette technologie gère les scénarios d'écriture manuscrite les plus difficiles, consultez notre article sur les modes d'échec courants de l'extraction d'écriture manuscrite et comment les éviter.
Quand vous avez besoin de la reconnaissance d'écriture manuscrite
L'ironie de la reconnaissance d'écriture manuscrite, c'est que ceux qui en ont le plus besoin sont souvent les plus éloignés d'un ordinateur. Les travailleurs de terrain remplissent des formulaires papier sur site. Les livreurs griffonnent des signatures et des quantités sur les quais de chargement. Les inspecteurs cochent des cases et prennent des notes sur des blocs-notes dans les entrepôts. Ces documents s'accumulent jusqu'à ce que quelqu'un — généralement un administrateur de bureau ou un propriétaire de petite entreprise — soit confronté à la tâche de saisir toutes ces données manuscrites dans un système.
La reconnaissance d'écriture manuscrite devient rentable lorsqu'au moins une de ces conditions est vraie pour vos documents :
Quatre signes que vous avez besoin de la reconnaissance d'écriture manuscrite
1. Le volume dépasse le seuil manuel. Traiter 20+ formulaires manuscrits par semaine — soit 80+ par mois — à 3–5 minutes par formulaire pour la saisie manuelle des données. À cette échelle, même une précision IA de 85 % avec une vérification humaine rapide est nettement plus rapide qu'une saisie 100 % manuelle.
2. L'écriture provient de plusieurs personnes. Un bureau de construction peut recevoir des feuilles de temps d'une douzaine de sous-traitants différents, chacun avec une écriture différente. Un centre logistique peut traiter des bons de livraison de conducteurs sur trois équipes. La variabilité de l'écriture est le problème, et l'IA la gère mieux que les systèmes basés sur des modèles qui supposent une cohérence.
3. Les documents mélangent contenu imprimé et manuscrit. Un formulaire d'inspection pré-imprimé avec des observations manuscrites. Une facture imprimée avec une signature et une date manuscrites. Une carte de relevé de compteur avec des numéros de compte imprimés et un relevé manuscrit. L'OCR traditionnelle lit bien la partie imprimée et produit des résultats médiocres pour la partie manuscrite — vous obligeant à traiter les deux séparément.
4. Les documents sont sensibles au facteur temps. Des confirmations de livraison qui doivent déclencher des mises à jour d'inventaire. Des rapports d'inspection qui doivent signaler des problèmes de sécurité. Des feuilles de temps qui doivent arriver à la paie avant vendredi. Le retard ne vient pas de l'extraction — c'est l'accumulation de papier qui attend que quelqu'un le saisisse.
Voici à quoi cela ressemble selon les types de documents où l'écriture manuscrite est la plus courante :
Bons de livraison manuscrits et preuves de livraison (POD). Un conducteur dépose une expédition, le destinataire signe un reçu papier, et ce reçu retourne au bureau — parfois des jours plus tard, parfois avec une tache de café. Chaque heure où ce reçu reste non traité est une heure où votre système d'inventaire ne sait pas que la livraison a eu lieu. La reconnaissance d'écriture manuscrite par IA peut lire le nom du destinataire, la date, les articles et les quantités à partir d'une photo prise au point de livraison. Consultez notre analyse approfondie sur l'extraction de bons de livraison manuscrits pour les services de réception.
Feuilles de temps et registres de présence manuscrits. Les équipes de chantier, les techniciens de maintenance et les travailleurs postés en usine remplissent souvent des cartes de pointage papier. Un contremaître peut noter au crayon les heures de 15 travailleurs sur une seule feuille — noms, dates, heures, codes de tâche. Pour que ces données arrivent à la paie, quelqu'un doit saisir chaque champ. L'IA lit toute la feuille d'un coup, en produisant une ligne par travailleur et par jour. En savoir plus sur la conversion de feuilles de temps manuscrites en Excel pour la paie.
Factures manuscrites. Les petits fournisseurs et sous-traitants — le plombier qui répare une fuite chez vous, l'électricien qui fait un petit chantier — rédigent souvent leurs factures à la main sur des blocs génériques. Ces documents ne suivent aucun format standard et sont manuscrits, donc les outils d'extraction basés sur des modèles ne peuvent pas les traiter. L'IA de vision les lit en comprenant ce qu'est une facture par nature, pas ce à quoi elle ressemble. Voir l'extraction de factures manuscrites pour les entrepreneurs.
Formulaires d'inspection et journaux de chantier manuscrits. Les inspections de sécurité, les vérifications d'équipement, les rapports quotidiens de construction — ces documents sont presque toujours remplis à la main, sur site, au stylo ou au crayon. Les formulaires sont pré-imprimés, mais les données — observations, relevés, cases cochées, signatures — sont manuscrites. L'IA lit les deux couches, extrayant des données structurées des annotations manuscrites tout en reconnaissant les libellés de champs imprimés pour le contexte. Pour la construction en particulier, voir l'extraction de journaux de chantier manuscrits vers Excel.
Relevés de compteurs manuscrits. Un employé des services publics parcourt un itinéraire, relève les compteurs et note les chiffres sur un bloc — parfois au crayon, parfois sous la pluie. Ces relevés doivent devenir des données de facturation. L'IA lit les valeurs numériques manuscrites à partir de photos de cartes de compteurs, même lorsque la qualité de l'écriture varie d'un lecteur à l'autre. Voir la conversion de relevés de compteurs en feuilles de calcul.
Registres manuscrits hérités. Les vieux livres de comptes, les fiches d'inventaire d'entrepôt, les formulaires d'admission de patients antérieurs aux systèmes de dossiers médicaux électroniques — des décennies de données manuscrites qui n'existent que sur papier. Numériser ces documents ne relève pas du traitement en temps réel ; il s'agit de libérer des informations actuellement invisibles. Pour les registres historiques, consultez notre guide sur la précision de la lecture de registres manuscrits par IA.
Chacun de ces types de documents présente des champs, des mises en page et des défis d'écriture manuscrite différents. Mais ils partagent le même goulot d'étranglement : un humain doit saisir les données. La reconnaissance d'écriture manuscrite par IA élimine ce goulot d'étranglement — non pas en remplaçant le jugement humain, mais en prenant en charge la transcription pour que l'humain n'ait plus qu'à vérifier.
Que rechercher dans un outil de reconnaissance d'écriture manuscrite
Tous les outils de reconnaissance d'écriture manuscrite ne résolvent pas le même problème. Certains sont conçus pour convertir des pages de notes manuscrites en texte consultable. D'autres sont conçus pour extraire des données structurées de formulaires manuscrits et les exporter dans un tableur. Si vous comparez des outils, voici les quatre critères qui les distinguent :
1. Sortie structurée, pas seulement du texte reconnu
Un outil qui produit un bloc de texte indiquant « Date : 12/04/2026 Fournisseur : Acme Qté : 50 » a fait de l'OCR manuscrite, pas de l'extraction de données. Vous devez encore analyser ce texte, le diviser en champs et le saisir dans les bonnes colonnes. Un outil d'extraction performant vous donne un tableur où « 12/04/2026 » se trouve dans la colonne Date, « Acme » dans la colonne Fournisseur et « 50 » dans la colonne Quantité — sans aucun analyse manuelle. Demandez-vous : la sortie se retrouve-t-elle dans des colonnes structurées ou dans une zone de texte ?
2. Reconnaissance sans modèle
Si un outil vous oblige à définir des zones, à dessiner des cadres ou à créer des modèles d'analyse pour chaque format de document, il hérite de la faiblesse fondamentale de l'OCR traditionnelle. Les documents manuscrits provenant de différentes sources auront des mises en page différentes — un bon de livraison d'un chauffeur ne ressemble en rien à celui d'un autre. L'outil doit trouver les données en comprenant leur signification, pas en faisant correspondre des positions. Demandez-vous : si un nouveau fournisseur envoie un document manuscrit dans un format que vous n'avez jamais vu, l'outil peut-il le traiter sans configuration ?
3. Gestion des documents mixtes imprimés et manuscrits
Les documents réels sont rarement entièrement manuscrits. Un formulaire d'inspection comporte des étiquettes de champs imprimées et des observations manuscrites. Une carte de compteur comporte un numéro de compte imprimé et une lecture manuscrite. Un bon de livraison comporte un en-tête d'entreprise imprimé et des quantités manuscrites. L'outil doit gérer les deux en une seule passe — sans vous obliger à les séparer ni à exécuter deux pipelines de traitement distincts. Demandez-vous : l'outil peut-il extraire d'un formulaire comportant des étiquettes imprimées, des valeurs manuscrites et des cases à cocher — le tout en un seul téléversement ?
4. Traitement par lots comme fonctionnalité de premier ordre
Si vous traitez une page manuscrite par mois, n'importe quel outil fera l'affaire. Mais la plupart des cas d'utilisation de la reconnaissance d'écriture manuscrite impliquent des lots — 30 bons de livraison pour les expéditions d'une semaine, 15 feuilles de temps pour une équipe, 50 formulaires d'inspection pour un audit de site. L'outil doit être conçu pour les traiter ensemble et fusionner les résultats dans un seul tableur — pas vous forcer à téléverser, extraire et exporter un fichier à la fois. Demandez-vous : pouvez-vous téléverser un dossier de documents et obtenir un seul tableur, plutôt que cinquante exports séparés ?
Si vous comparez des outils spécifiques côte à côte, notre guide des meilleurs outils de reconnaissance d'écriture manuscrite en 2026 passe en revue le paysage en détail. Et pour une comparaison directe des technologies sous-jacentes, consultez la reconnaissance d'écriture manuscrite par IA vs l'OCR traditionnelle.
Questions fréquemment posées
La reconnaissance d'écriture manuscrite par IA fonctionne-t-elle avec l'écriture cursive ?
Oui — et c'est là que l'IA surpasse le plus nettement l'OCR traditionnelle. Comme les modèles d'IA lisent des mots et des lignes entiers de manière holistique plutôt que de segmenter les caractères individuellement, ils gèrent les lettres cursives connectées qui feraient échouer un moteur d'OCR caractère par caractère. La précision sur une cursive lisible se situe généralement entre 80 et 90 %, contre 40 à 60 % pour l'OCR traditionnelle. Plus le style d'écriture est cohérent dans un document, plus la précision est élevée.
L'IA peut-elle lire une écriture manuscrite à partir d'une photo de téléphone, ou faut-il un vrai scan ?
Les photos de téléphone fonctionnent. Les modèles d'IA de vision modernes sont entraînés sur des images réelles, pas seulement des scans propres, donc ils gèrent mieux les photos inclinées, l'éclairage inégal et les ombres que l'OCR traditionnelle — qui attend des documents plats et uniformément éclairés. Une photo claire prise avec un bon éclairage (pas de flou de mouvement, texte lisible à l'œil humain) produit généralement des résultats proches d'une image scannée. L'avantage pratique est considérable : les travailleurs de terrain peuvent photographier un bon de livraison ou un formulaire d'inspection sur place avec leur téléphone, et les données sont extraites immédiatement — aucun scanner nécessaire.
Quelle qualité d'écriture manuscrite est trop mauvaise pour que l'IA la lise ?
Si deux lecteurs humains ne parviennent pas à s'accorder sur ce que dit un mot manuscrit, l'IA ne pourra probablement pas le résoudre non plus. Le seuil pratique est la lisibilité : si une personne qui ne connaît pas le scripteur peut lire 80 % ou plus du texte sans deviner, l'IA atteindra probablement une performance de 85 à 95 %. Une cursive extrêmement stylisée, des ratures importantes, un texte écrit à des angles prononcés et des copies carbone où la troisième ou quatrième couche est à peine visible peuvent faire chuter la précision sous 70 %. Dans ces cas, une étape de révision avec boucle humaine reste nécessaire pour une extraction à haute confiance — mais c'est toujours plus rapide qu'une saisie entièrement manuelle.
L'IA peut-elle distinguer le texte imprimé du texte manuscrit sur la même page ?
Oui. Les modèles d'IA de vision traitent la page entière comme une image visuelle et peuvent distinguer le texte imprimé du texte manuscrit — de la même manière que vous pouvez voir d'un coup d'œil quelles parties d'un formulaire ont été pré-imprimées et lesquelles ont été remplies à la main. C'est essentiel pour l'extraction de formulaires structurés : l'IA utilise les étiquettes imprimées (« Date : », « Inspecteur : », « Constatations : ») comme points d'ancrage pour comprendre ce que signifient les valeurs manuscrites, puis extrait ces valeurs dans les bonnes colonnes.
La reconnaissance d'écriture manuscrite fonctionne-t-elle avec les cases à cocher, les coches et les options entourées ?
L'IA de vision moderne peut détecter si une case est cochée, si un cercle est rempli ou si une option est barrée — et produire le résultat sous forme de données structurées (par exemple, « Contrôle de sécurité réussi : Oui »). Cela va au-delà de la reconnaissance de texte pour entrer dans la compréhension visuelle : l'IA voit la case et sa marque comme des éléments visuels, et non comme des caractères. La précision sur la détection claire des cases est généralement élevée (90 %+), bien que des options très denses ou des marques de crayon faibles puissent réduire la fiabilité. Pour une analyse approfondie de pourquoi les cases à cocher restent la partie la plus difficile de l'extraction de formulaires — et les cinq façons dont même les bons modèles se trompent — consultez notre article sur pourquoi l'IA lit les formulaires manuscrits mais manque encore une case cochée.
Puis-je extraire des champs spécifiques de formulaires manuscrits, ou l'IA se contente-t-elle de déverser tout le texte ?
Vous pouvez extraire des champs spécifiques. Avec l'extraction de colonnes personnalisées, vous définissez les colonnes souhaitées — « Date de livraison », « Nom du destinataire », « Nombre d'articles » — et l'IA localise et extrait uniquement ces champs de chaque document. C'est la différence entre obtenir un mur de texte que vous devez encore trier et obtenir une feuille de calcul où chaque colonne contient exactement les données dont vous avez besoin. L'approche fonctionne sur tous les types de documents : les mêmes colonnes peuvent extraire des données de factures manuscrites, de bons de livraison et de formulaires d'inspection — car l'IA trouve les champs par le sens, et non par la position. Pour un guide étape par étape, consultez l'extraction de colonnes personnalisées pour les documents manuscrits.
Dois-je entraîner l'IA sur des échantillons de mon écriture manuscrite spécifique ?
Non — les modèles d'IA de vision modernes arrivent pré-entraînés sur des millions d'échantillons d'écriture manuscrite couvrant différents styles, langues et types de documents. Ils gèrent de nouveaux styles d'écriture sans aucun entraînement par scripteur ni collecte d'échantillons. Si votre organisation a un scripteur unique avec un style extrêmement inhabituel (écritures historiques, cursive non latine, sténographie très stylisée), un ajustement fin sur cette écriture spécifique peut améliorer la précision — mais pour la plupart des cas d'usage professionnels impliquant plusieurs scripteurs remplissant des formulaires standard, le modèle prêt à l'emploi offre déjà une précision utilisable sans aucune configuration.
En résumé
L'écriture manuscrite a longtemps été la dernière frontière tenace de l'automatisation documentaire — celle qui obligeait un humain à s'asseoir et à taper, quel que soit le nombre d'autres étapes du processus déjà numérisées. Cette frontière a bougé. La reconnaissance d'écriture manuscrite par IA n'égale pas la précision humaine sur chaque document, et il est probable qu'elle ne l'égalera jamais sur les 5 % d'écritures les plus illisibles. Mais sur les 85 à 95 % des documents manuscrits dont l'écriture est raisonnablement lisible, elle élimine entièrement l'étape de transcription — transformant « quelqu'un doit tout taper » en « quelqu'un doit vérifier le travail de l'IA ».
Ceux qui en profitent le plus ne sont pas les chercheurs en IA ni les services informatiques des grandes entreprises. Ce sont la gestionnaire de bureau d'une entreprise de construction qui traite 40 feuilles de temps manuscrites chaque lundi. Le magasinier qui reçoit des confirmations de livraison d'un groupe de chauffeurs en rotation. Le propriétaire de petite entreprise dont les fournisseurs envoient encore des factures manuscrites sur des blocs de papier carbone. Pour eux, la question n'est pas « l'IA peut-elle égaler la précision humaine sur chaque document ? » mais « l'IA peut-elle traiter les 90 % de documents suffisamment clairs, me libérant du temps pour me concentrer sur les 10 % qui nécessitent un examen plus attentif ? » La réponse, en 2026, est oui.