Was ist KI-Handschrifterkennung?
Wie Vision-KI Schreibschrift liest
KI-Handschrifterkennung ist der Einsatz von Vision-KI-Modellen, um handschriftlichen Text – ob Druckschrift, Schreibschrift oder gemischt – aus einem Foto oder Scan zu lesen und in maschinenlesbare strukturierte Daten umzuwandeln. Im Gegensatz zur herkömmlichen OCR, die darauf ausgelegt war, saubere Druckschriften anhand fester Zeichenvorlagen abzugleichen, versteht Vision-KI Handschrift so, wie ein Mensch es tut: durch Betrachtung des gesamten Wortes, des umgebenden Kontexts und der Absicht des Dokuments. Bei gut lesbarer Handschrift erreichen moderne KI-Modelle eine Genauigkeit von 85–95 % – während herkömmliche OCR oft unter 50 % fällt, sobald Buchstaben miteinander verbunden sind.
Die wichtigsten Erkenntnisse
- Bei der KI-Handschrifterkennung geht es nicht darum, Schreibschrift in durchsuchbaren Text umzuwandeln – sondern darum, strukturierte Datenfelder aus handschriftlichen Formularen direkt in Tabellenspalten zu extrahieren.
- Herkömmliche OCR scheitert an Schreibschrift nicht, weil sie „schlecht" in Handschrift wäre, sondern weil sie einzelne Zeichen segmentiert – und bei verbundenen Buchstaben ist die Zeichenisolierung grundsätzlich unmöglich, wodurch die Pipeline bereits im ersten Schritt zusammenbricht.
- Der Durchbruch ist das semantische Lesen: KI findet Felder, indem sie versteht, was sie bedeuten, nicht wo sie erscheinen – so extrahieren dieselben Spaltendefinitionen Daten aus jedem handschriftlichen Formular, ohne Training pro Schreiber oder Vorlagen pro Format.
Was KI-Handschrifterkennung wirklich ist
Lassen Sie uns sofort das häufigste Missverständnis ausräumen: KI-Handschrifterkennung bedeutet nicht, Ihre Unterschrift zu erkennen. Es geht darum, die Datenfelder auf einem handschriftlichen Dokument zu lesen – die Rechnungsnummer, die jemand oben auf ein Formular gekritzelt hat, das Lieferdatum, das ein Fahrer auf einem Zustellnachweis notiert hat, die Stunden, die ein Vorarbeiter in einen Papier-Stundenzettel eingetragen hat. Die Technologie betrachtet ein Foto eines handschriftlichen Dokuments und beantwortet dieselben Fragen, die Sie einem menschlichen Datenerfassungsmitarbeiter stellen würden: Welches Datum steht dort, wer ist der Lieferant, wie viele Einheiten, wie hoch ist die Summe?
Diese Unterscheidung ist wichtig, denn die meisten Ressourcen, die Sie zu „Handschrift-OCR“ finden, behandeln die Umwandlung handschriftlicher Notizen in bearbeitbaren Text – ein Digitalisierungsproblem. Die meisten Unternehmen, die mit handschriftlichen Dokumenten arbeiten, haben jedoch kein Digitalisierungsproblem. Sie haben ein Datenextraktionsproblem. Ein Stapel von 50 handschriftlichen Lieferscheinen ist nicht wertvoll als 50 durchsuchbare Textdateien. Er ist wertvoll als eine Tabellenkalkulation mit Spalten für Datum, Empfänger, Artikel und Unterschrift – bereit für den Import in ein Inventarsystem. Das ist der Sprung von Texterkennung zu strukturierter Extraktion, und genau das unterscheidet KI-Handschrifterkennung von den Handschrift-OCR-Werkzeugen des letzten Jahrzehnts.
Zur Einordnung, wie dies in die breitere Landschaft der Dokumentenautomatisierung passt, finden Sie in unserem Leitfaden zu was KI-Dokumentenextraktion tatsächlich leistet weitere Informationen – Handschrifterkennung ist eine ihrer anspruchsvollsten und wirkungsvollsten Fähigkeiten.
Handschrifterkennung vs. herkömmliche OCR vs. manuelle Transkription
Wenn Sie bereits versucht haben, eine Scanner-App oder Adobe Acrobat auf ein handschriftliches Formular anzuwenden und dabei unlesbaren Unsinn erhalten haben, haben Sie die grundlegende Diskrepanz erlebt, für die herkömmliche OCR gebaut wurde und was Handschrift tatsächlich erfordert. Die drei Ansätze liefern radikal unterschiedliche Ergebnisse bei gleicher Ausgangslage – einem Foto eines handschriftlichen Dokuments.
| Ansatz | Funktionsweise | Genauigkeit bei Schreibschrift | Ausgabe | Am besten geeignet für |
|---|---|---|---|---|
| Herkömmliche OCR | Vergleicht Pixelmuster mit bekannten Zeichenvorlagen – ein Zeichen nach dem anderen | 40–60 % | Roher Textstring; scheitert bei verbundenen Buchstaben | Gedruckte Dokumente mit sauberen, einheitlichen Schriftarten |
| KI-Handschrifterkennung | Vision-Modelle lesen ganze Wörter und Zeilen ganzheitlich und nutzen den umgebenden Kontext zur Auflösung von Mehrdeutigkeiten | 85–95 % bei lesbarer Schrift | Strukturierte Daten (Excel, CSV, JSON) – jedes Feld in einer eigenen Spalte | Handschriftliche Formulare, Dokumente mit gemischter Druck- und Schreibschrift, Feldberichte, Lieferscheine |
| Manuelle Transkription | Eine Person liest und tippt jedes Feld ein | ~99 % (mit ermüdungsbedingten Fehlern) | Jedes Format, in das die Person tippt | Geringe Mengen mit hohen Genauigkeitsanforderungen, bei denen die Kosten nicht das Hauptkriterium sind |
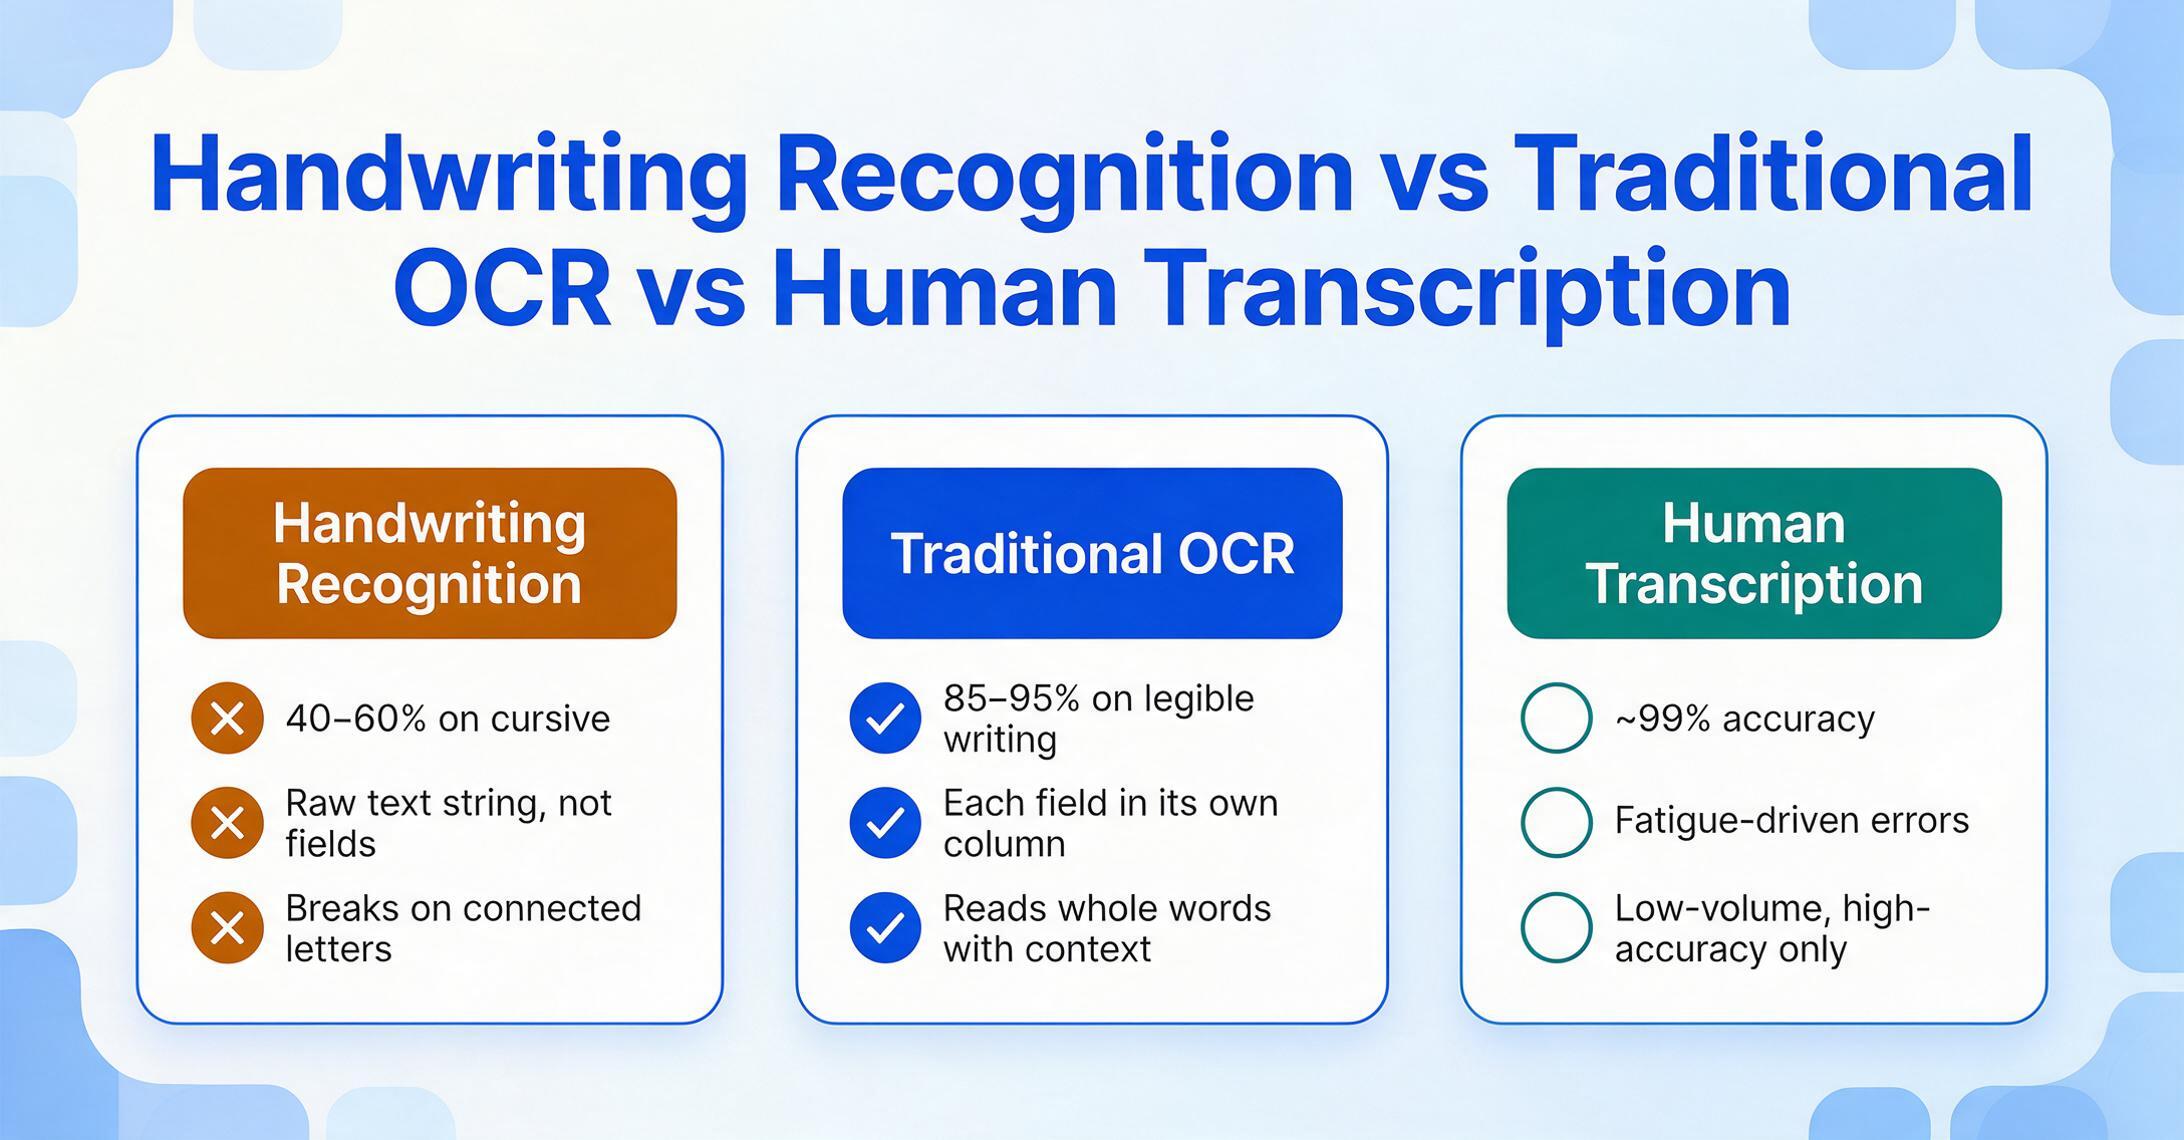
Die Zahlen sind eindeutig. In einem unabhängigen Benchmark von 14 KI-Modellen an 100 Schreibschriftproben erzielten die besten Vision-Sprachmodelle eine nahezu perfekte semantische Genauigkeit, während herkömmliche OCR-Engines Fehlerraten aufwiesen, die die Ausgabe praktisch unbrauchbar machten. Ein spezialisierter Handschriftdienst benchmarkte eine Wortfehlerrate von 0,9 % bei sauberer Handschrift – und 95,4 % für Tesseract, eine weit verbreitete Open-Source-OCR-Engine, auf derselben Stichprobe. Das ist der Unterschied zwischen einer Korrektur pro Seite und einer Korrektur pro Satz.
Dies sind Erwartungswerte – die grundlegende Genauigkeit, die Sie bei typischen Dokumenten von jedem Ansatz vernünftigerweise erwarten können. Die Genauigkeit wird je nach Fragestellung unterschiedlich gemessen: Zeichenfehlerraten (CER/WER) beschreiben das rohe Transkript, während die feldgenaue Extraktion beschreibt, ob jeder Wert in der richtigen Tabellenspalte landet. Unser Mechanismus-Tiefgang berichtet die Zeichenfehlerraten, und unser Vergleich KI vs. herkömmliche OCR misst die feldgenaue Extraktion nach Dokumenttyp.
Was diese Lücke verursacht, ist keine inkrementelle Verbesserung. Es ist eine grundlegend andere Architektur. Herkömmliche OCR segmentiert eine Seite in einzelne Zeichen, gleicht jedes mit einer Vorlagenbibliothek ab und setzt die Ergebnisse wieder zusammen. Schreibschrift unterbricht diese Pipeline bereits im ersten Schritt: Sie können verbundene Buchstaben nicht segmentieren, ohne bereits zu wissen, wo einer endet und der nächste beginnt. Deshalb kann eine gestochen scharfe, getippte Rechnung mit 99 % Genauigkeit gescannt werden, während eine handschriftliche Version desselben Dokuments auf 50 % fällt – die OCR-Engine kam nie über Schritt eins hinaus.
Für Genauigkeitszahlen, aufgeschlüsselt nach Handschrifttyp – Druckschrift, saubere Schreibschrift, unleserliche Schreibschrift – und was diese Zahlen für Ihre eigenen Dokumente bedeuten, siehe kann KI Handschrift mit brauchbarer Genauigkeit lesen.
Diese architektonische Lücke zeigt sich bei jedem Dokumenttyp. Für einen Blick darauf, wie herkömmliche vorlagenbasierte Extraktion im Vergleich zu KI-gestützten Ansätzen bei gedruckten Dokumenten abschneidet, siehe unseren Vergleich von KI-Handschrifterkennung vs. herkömmlicher OCR. Und für die besondere Herausforderung, Daten aus handschriftlichen Formularen zu extrahieren – wo die Einsätze am höchsten sind – lesen Sie über das Extrahieren bestimmter Felder aus handschriftlichen Formularen.
So funktioniert Handschrifterkennung
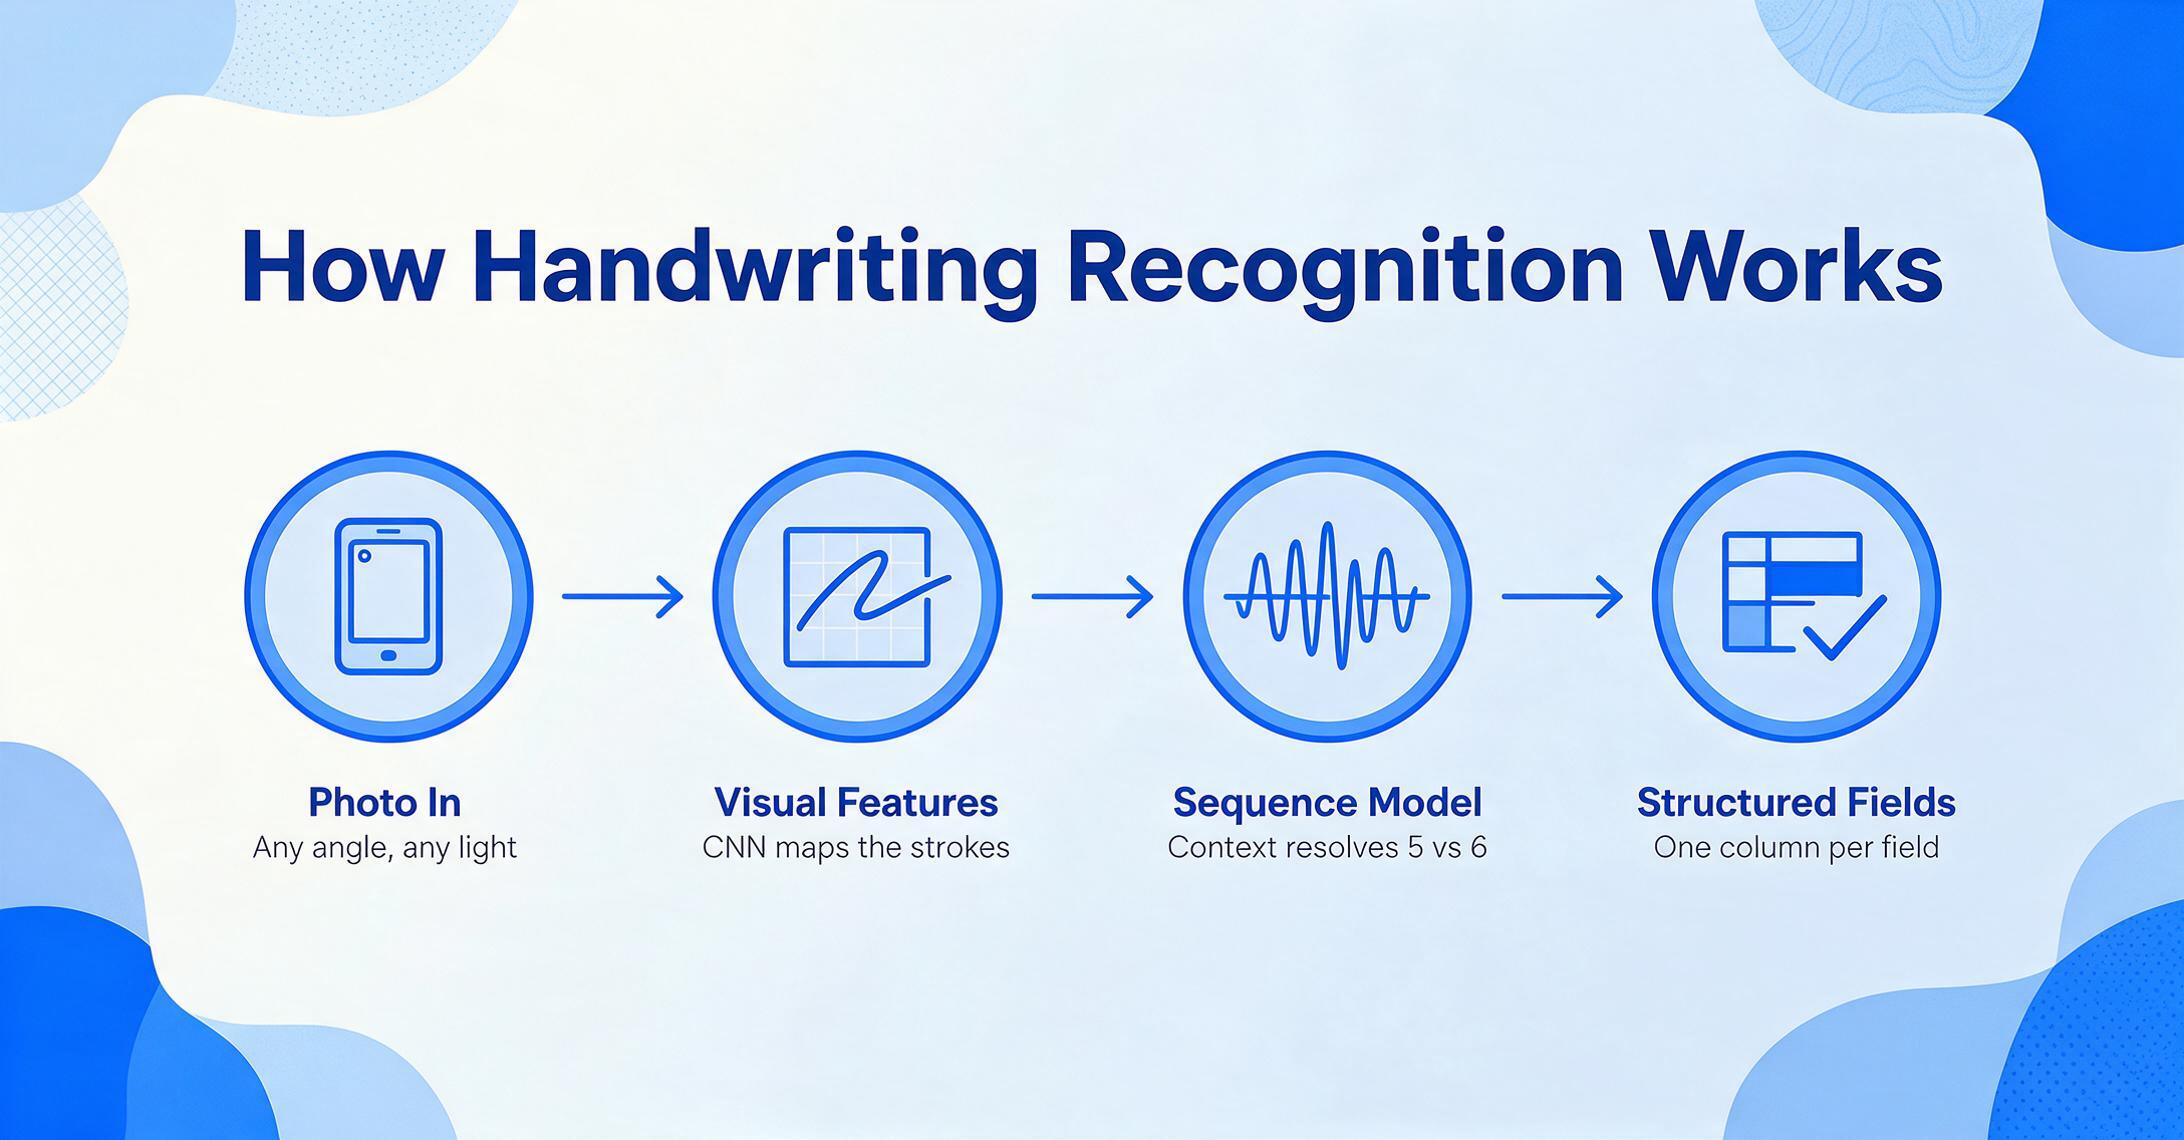
Der Grund, warum KI dort erfolgreich ist, wo herkömmliche OCR scheitert, liegt in einem Strategiewechsel: von der Zeichensegmentierung zur ganzheitlichen Erfassung. Und dieser Wechsel verändert alles, was möglich ist.
Dieser Abschnitt ist die Übersicht — für eine Schritt-für-Schritt-Erläuterung der zugrunde liegenden Architektur, einschließlich der Frage, warum die Zeichensegmentierung bei verbundenen Buchstaben scheitert und wie der Kontext mehrdeutige Ziffern wie eine handschriftliche „5" vs. „6" auflöst, finden Sie in unserem Deep Dive zu So funktioniert Handschrifterkennung.
Herkömmliche OCR behandelt eine Seite mit Handschrift wie ein Puzzle: jeden Buchstaben isolieren, identifizieren, zum nächsten übergehen. Das Problem ist, dass Handschrift nicht in isolierten Buchstaben funktioniert. Ein Kleinbuchstabe „r", der mit einem „i" verbunden ist, sieht anders aus als ein „r", das mit einem „n" verbunden ist. Ein hastig geschriebenes „qty" eines Arztes kann aus dem Zusammenhang gerissen wie „gty" aussehen — aber nur eines davon ergibt auf einem Lieferschein Sinn. Herkömmliche OCR weiß nicht, was Sinn ergibt. Sie gleicht nur Formen ab.
Moderne KI-Handschrifterkennung verwendet Convolutional Neural Networks (CNNs), um visuelle Merkmale aus dem Bild zu extrahieren, und verarbeitet diese Merkmale dann mit Recurrent Neural Networks (RNNs) oder Transformer-Modellen als Sequenz — sie behandelt eine Zeile Handschrift als kontinuierliches Signal und nicht als eine Reihe einzelner Zeichen. Deshalb wird dieser Ansatz manchmal auch Handschrifttexterkennung (HTR) genannt, um ihn von OCR zu unterscheiden: Die gesamte Erkennungspipeline wurde neu aufgebaut, basierend darauf, wie sich Handschrift tatsächlich verhält.
Vision-Language-Modelle gehen noch einen Schritt weiter. Statt nur Zeichen zu erkennen, verstehen sie das Dokument. Wenn ein Feld auf einem Formular mit „Lieferdatum" und auf einem anderen mit „Datum eingegangen" beschriftet ist, muss der KI nicht gesagt werden, dass es sich um dasselbe handelt — sie liest die Beschriftung, versteht ihre Bedeutung und lokalisiert den entsprechenden handschriftlichen Wert an beliebiger Stelle auf der Seite. Das ist der Unterschied zwischen einem Werkzeug, das Text sieht, und einem Werkzeug, das ein Dokument liest.
Die praktische Bedeutung ist erheblich: KI-Handschrifterkennung erfordert nicht, dass Sie für jedes Dokumentlayout eine Vorlage erstellen, sie mit Proben Ihrer spezifischen Handschrift trainieren oder Extraktionsregeln konfigurieren. Sie beschreiben, was Sie möchten — „Absendername", „Versanddatum", „Artikelanzahl" — und die KI findet jeden Wert, indem sie seine Bedeutung versteht, unabhängig davon, wo er erscheint oder wie er geschrieben ist. Dies ist das Kernkonzept hinter der benutzerdefinierten Spaltenextraktion: Sie benennen Ihre Spalten, und die KI füllt sie, indem sie das Dokument semantisch liest, statt es positionsbasiert zu scannen. Für einen tieferen Einblick, wie diese Technologie die schwierigsten Handschriftszenarien bewältigt, lesen Sie unseren Artikel über häufige Fehlermodi bei der Handschriftextraktion und wie Sie diese vermeiden.
Wann Sie Handschrifterkennung benötigen
Die Ironie der Handschrifterkennung besteht darin, dass diejenigen, die sie am dringendsten benötigen, oft am weitesten von einem Computer entfernt sind. Außendienstmitarbeiter füllen vor Ort Papierformulare aus. Zustellfahrer kritzeln Unterschriften und Mengen an Laderampen. Inspektoren setzen Häkchen und machen sich Notizen auf Klemmbrettern in Lagerhäusern. Diese Dokumente sammeln sich an, bis jemand – meist ein Büroadministrator oder ein Kleinunternehmer – vor der Aufgabe steht, all diese handschriftlichen Daten in ein System zu tippen.
Handschrifterkennung lohnt sich, wenn mindestens eine dieser Bedingungen auf Ihre Dokumente zutrifft:
Vier Anzeichen, dass Sie Handschrifterkennung benötigen
1. Das Volumen überschreitet die manuelle Schwelle. Die Verarbeitung von 20+ handschriftlichen Formularen pro Woche – das sind 80+ pro Monat – bei 3–5 Minuten pro Formular für die manuelle Dateneingabe. In diesem Umfang ist selbst eine KI-Genauigkeit von 85 % mit einer schnellen manuellen Stichprobenprüfung dramatisch schneller als eine 100 % manuelle Eingabe.
2. Die Handschrift stammt von mehreren Personen. Ein Bauunternehmen könnte Stundenzettel von einem Dutzend verschiedener Subunternehmer erhalten, jeder mit einer anderen Handschrift. Ein Logistikzentrum könnte Lieferscheine von Fahrern aus drei Schichten verarbeiten. Die Variabilität der Handschrift ist das Problem, und KI geht besser damit um als vorlagenbasierte Systeme, die Konsistenz voraussetzen.
3. Die Dokumente mischen gedruckte und handschriftliche Inhalte. Ein vorgedrucktes Inspektionsformular mit handschriftlichen Beobachtungen. Eine gedruckte Rechnung mit handschriftlicher Unterschrift und Datum. Eine Zählerstandskarte mit gedruckten Kontonummern und einem handschriftlichen Zählerstand. Die herkömmliche OCR liest den gedruckten Teil problemlos und liefert für den handschriftlichen Teil Unsinn – was Sie dazu zwingt, beides getrennt zu behandeln.
4. Die Dokumente sind zeitkritisch. Zustellbestätigungen, die Inventaraktualisierungen auslösen müssen. Inspektionsberichte, die Sicherheitsprobleme kennzeichnen müssen. Stundenzettel, die bis Freitag in der Lohnabrechnung sein müssen. Die Verzögerung entsteht nicht durch die Extraktion – sondern durch den Papierstau, der darauf wartet, dass jemand ihn abtippt.
So sieht das bei den Dokumenttypen aus, bei denen Handschrift am häufigsten vorkommt:
Handschriftliche Lieferscheine und Zustellnachweise (PODs). Ein Fahrer liefert eine Sendung ab, der Empfänger unterschreibt einen Papierbeleg, und dieser Beleg findet seinen Weg zurück ins Büro – manchmal Tage später, manchmal mit einem Kaffeefleck. Jede Stunde, die dieser Beleg unverarbeitet herumliegt, ist eine Stunde, in der Ihr Inventarsystem nicht weiß, dass die Lieferung stattgefunden hat. Die KI-Handschrifterkennung kann Empfängername, Datum, Artikel und Mengen aus einem Foto lesen, das am Ort der Zustellung aufgenommen wurde. Sehen Sie sich unseren ausführlichen Beitrag zur Extraktion handschriftlicher Lieferscheine für Warenannahmeabteilungen an.
Handschriftliche Stundenzettel und Anwesenheitslisten. Baukolonnen, Servicetechniker im Außendienst und Schichtarbeiter in der Fertigung füllen oft Papier-Stundenzettel aus. Ein Vorarbeiter notiert möglicherweise die Stunden für 15 Arbeiter auf einem einzigen Blatt – Namen, Daten, Stunden, Auftragscodes. Um diese Daten in die Lohnabrechnung zu bekommen, muss jemand jedes Feld abtippen. KI liest das gesamte Blatt auf einmal und gibt eine Zeile pro Arbeiter und Tag aus. Lesen Sie mehr über das Konvertieren handschriftlicher Stundenzettel in Excel für die Lohnabrechnung.
Handschriftliche Rechnungen. Kleine Lieferanten und Subunternehmer – der Klempner, der ein Leck in Ihrer Immobilie repariert, der Elektriker, der einen kleinen Auftrag ausführt – schreiben ihre Rechnungen oft von Hand auf Standardformulare. Diese folgen keinem Standardformat und sind handschriftlich, daher können vorlagenbasierte Extraktionstools sie nicht verarbeiten. Vision-KI liest sie, indem sie versteht, was eine Rechnung ist, nicht wie sie aussieht. Siehe Extraktion handschriftlicher Rechnungen für Auftragnehmer.
Handschriftliche Inspektionsformulare und Baustellenprotokolle. Sicherheitsinspektionen, Geräteprüfungen, tägliche Baustellenberichte – diese werden fast immer von Hand vor Ort mit Stift oder Bleistift ausgefüllt. Die Formulare sind vorgedruckt, aber die Daten – Beobachtungen, Messwerte, Häkchen, Unterschriften – sind handschriftlich. KI liest beide Ebenen und extrahiert strukturierte Daten aus den handschriftlichen Anmerkungen, während sie die gedruckten Feldbeschriftungen als Kontext erkennt. Speziell für den Baubereich siehe Extraktion handschriftlicher Baustellenprotokolle in Excel.
Handschriftliche Zählerstände. Ein Versorgungsarbeiter geht eine Route ab, liest Zähler und notiert Zahlen auf einem Klemmbrett – manchmal mit Bleistift, manchmal im Regen. Diese Ablesungen müssen zu Abrechnungsdaten werden. KI liest handschriftliche Zahlenwerte aus Fotos von Zählerkarten, selbst wenn die Handschriftqualität von einem Ableser zum nächsten variiert. Siehe Konvertieren von Zählerständen in Tabellenkalkulationen.
Alte handschriftliche Aufzeichnungen. Alte Hauptbücher, Lagerbestandskarten, Patientenaufnahmefomulare aus der Zeit vor EHR-Systemen – jahrzehntelange handschriftliche Daten, die nur auf Papier existieren. Bei der Digitalisierung geht es nicht um Echtzeitverarbeitung, sondern darum, Informationen zugänglich zu machen, die derzeit unsichtbar sind. Für historische Hauptbücher siehe unseren Leitfaden zur Genauigkeit der KI-Lesung handschriftlicher Hauptbücher.
Jeder dieser Dokumenttypen hat unterschiedliche Felder, unterschiedliche Layouts und unterschiedliche Herausforderungen bei der Handschrift. Aber sie alle haben denselben Engpass: Ein Mensch muss die Daten abtippen. KI-Handschrifterkennung beseitigt diesen Engpass – nicht indem sie menschliches Urteilsvermögen ersetzt, sondern indem sie die Transkription übernimmt, sodass der Mensch nur noch prüfen muss.
Worauf Sie bei einem Handschrifterkennungstool achten sollten
Nicht alle Handschrifterkennungstools lösen dasselbe Problem. Einige wurden entwickelt, um Seiten handschriftlicher Notizen in durchsuchbaren Text umzuwandeln. Andere wurden entwickelt, um strukturierte Daten aus handschriftlichen Formularen zu extrahieren und als Tabellenkalkulation auszugeben. Wenn Sie sich Tools ansehen, sind dies die vier Kriterien, die die beiden unterscheiden:
1. Strukturierte Ausgabe, nicht nur erkannter Text
Ein Tool, das einen Textblock mit „Datum: 12.04.2026 Lieferant: Acme Menge: 50" ausgibt, hat Handschrift-OCR durchgeführt, aber keine Datenextraktion. Sie müssen diesen Text weiterhin parsen, in Felder aufteilen und in die richtigen Spalten eingeben. Ein ordentliches Extraktionstool liefert Ihnen eine Tabellenkalkulation, in der „12.04.2026" in der Datumsspalte, „Acme" in der Lieferantenspalte und „50" in der Mengenspalte steht – ohne manuelles Parsen. Fragen Sie: Landet die Ausgabe in strukturierten Spalten oder in einem Textfeld?
2. Erkennung ohne Vorlage
Wenn ein Tool verlangt, dass Sie Zonen definieren, Boxen zeichnen oder Parsing-Vorlagen für jedes Dokumentformat erstellen, erbt es die grundlegende Schwäche der herkömmlichen OCR. Handschriftliche Dokumente aus verschiedenen Quellen haben unterschiedliche Layouts – ein Lieferschein von einem Fahrer sieht ganz anders aus als ein Lieferschein von einem anderen. Das Tool muss Daten finden, indem es versteht, was sie bedeuten, nicht indem es Positionen abgleicht. Fragen Sie: Wenn ein neuer Lieferant ein handschriftliches Dokument in einem Format sendet, das Sie noch nie gesehen haben, kann das Tool es ohne Einrichtung verarbeiten?
3. Gemischte Verarbeitung von Druck und Handschrift
Reale Dokumente sind selten rein handschriftlich. Ein Inspektionsformular hat gedruckte Feldbeschriftungen und handschriftliche Beobachtungen. Eine Zählerkarte hat eine gedruckte Kontonummer und einen handschriftlichen Zählerstand. Ein Lieferschein hat einen gedruckten Firmenkopf und handschriftliche Mengen. Das Tool muss beides in einem einzigen Durchgang verarbeiten – nicht verlangen, dass Sie sie trennen oder zwei verschiedene Verarbeitungspipelines ausführen. Fragen Sie: Kann das Tool aus einem Formular mit gedruckten Beschriftungen, handschriftlichen Werten und Kontrollkästchen extrahieren – alles in einem Upload?
4. Batch-Verarbeitung als erstklassige Funktion
Wenn Sie eine handschriftliche Seite pro Monat verarbeiten, reicht jedes Tool. Aber die meisten Anwendungsfälle für Handschrifterkennung umfassen Batches – 30 Lieferscheine von einer Woche Lieferungen, 15 Stundenzettel von einem Team, 50 Inspektionsformulare von einem Standortaudit. Das Tool sollte dafür gebaut sein, sie gemeinsam zu verarbeiten und die Ergebnisse in einer einzigen Tabellenkalkulation zusammenzuführen – nicht Sie zwingen, eine Datei nach der anderen hochzuladen, zu extrahieren und zu exportieren. Fragen Sie: Können Sie einen Ordner mit Dokumenten hochladen und eine Tabellenkalkulation zurückbekommen, nicht fünfzig separate Exporte?
Wenn Sie bestimmte Tools direkt vergleichen möchten, führt Sie unser Leitfaden zu den besten Handschrifterkennungstools 2026 detailliert durch die Landschaft. Und für einen direkten Vergleich der zugrunde liegenden Technologien lesen Sie KI-Handschrifterkennung vs. herkömmliche OCR.
Häufig gestellte Fragen
Funktioniert die KI-Handschrifterkennung mit Schreibschrift?
Ja – und genau hier übertrifft KI die herkömmliche OCR am deutlichsten. Da KI-Modelle ganze Wörter und Zeilen ganzheitlich lesen, anstatt einzelne Zeichen zu segmentieren, verarbeiten sie verbundene Schreibschriftbuchstaben, die eine zeichenweise OCR-Engine zum Scheitern bringen würden. Die Genauigkeit bei lesbarer Schreibschrift liegt typischerweise zwischen 80–90 %, verglichen mit 40–60 % bei herkömmlicher OCR. Je konsistenter der Handschriftstil innerhalb eines Dokuments ist, desto höher die Genauigkeit.
Kann KI Handschrift von einem Handyfoto lesen oder braucht sie einen ordentlichen Scan?
Handyfotos funktionieren. Moderne Vision-KI-Modelle werden mit realen Bildern trainiert, nicht nur mit sauberen Scans, und verarbeiten daher schräg aufgenommene Fotos, ungleichmäßige Beleuchtung und Schatten besser als herkömmliche OCR – die flache, gleichmäßig beleuchtete Dokumente erwartet. Ein klares Foto bei gutem Licht (keine Bewegungsunschärfe, Text für das menschliche Auge lesbar) liefert typischerweise Ergebnisse, die einem Scan nahekommen. Der praktische Nutzen ist erheblich: Außendienstmitarbeiter können vor Ort ein Lieferschein- oder Inspektionsformular mit dem Handy fotografieren, und die Daten werden sofort extrahiert – kein Scanner nötig.
Welche Handschriftqualität ist für KI zu schlecht zum Lesen?
Wenn sich zwei menschliche Leser nicht einig sind, was ein handschriftliches Wort sagt, wird KI es wahrscheinlich auch nicht auflösen können. Die praktische Schwelle ist die Lesbarkeit: Wenn eine Person, die den Schreiber nicht kennt, 80 %+ des Textes ohne Raten lesen kann, wird KI wahrscheinlich im Bereich von 85–95 % liegen. Extrem stilisierte Schreibschrift, starke Durchstreichungen, Text in starken Winkeln und Durchschlagkopien, bei denen die dritte oder vierte Schicht kaum sichtbar ist, können die Genauigkeit unter 70 % drücken. In diesen Fällen ist ein Human-in-the-Loop-Prüfschritt für eine sichere Extraktion weiterhin notwendig – aber es ist immer noch schneller als vollständig manuelle Eingabe.
Kann KI auf derselben Seite zwischen gedrucktem und handschriftlichem Text unterscheiden?
Ja. Vision-KI-Modelle verarbeiten die gesamte Seite als visuelles Bild und können gedruckten von handschriftlichem Text unterscheiden – genauso wie Sie auf einen Blick erkennen, welche Teile eines Formulars vorgedruckt und welche von Hand ausgefüllt wurden. Dies ist entscheidend für die Extraktion strukturierter Formulare: Die KI verwendet die gedruckten Beschriftungen („Datum:", „Prüfer:", „Befunde:") als Anker, um zu verstehen, was die handschriftlichen Werte bedeuten, und extrahiert diese Werte dann in die richtigen Spalten.
Funktioniert die Handschrifterkennung mit Kontrollkästchen, Häkchen und eingekreisten Optionen?
Moderne Vision-KI kann erkennen, ob ein Kontrollkästchen angekreuzt, ein Kreis ausgefüllt oder eine Option durchgestrichen ist – und das Ergebnis als strukturierte Daten ausgeben (z. B. „Sicherheitscheck bestanden: Ja"). Das geht über die Texterkennung hinaus in die visuelle Verständnisebene: Die KI betrachtet das Kontrollkästchen und seine Markierung als visuelle Elemente, nicht als Zeichen. Die Genauigkeit bei eindeutiger Kontrollkästchen-Erkennung ist in der Regel hoch (90 %+), obwohl dicht gepackte Optionen oder schwache Bleistiftmarkierungen die Zuverlässigkeit verringern können. Für einen tiefen Einblick, warum Kontrollkästchen der schwierigste Teil der Formular-Extraktion bleiben – und die fünf Arten, wie selbst gute Modelle sie falsch erkennen –, lesen Sie unseren Artikel darüber, warum KI handschriftliche Formulare liest, aber ein angekreuztes Kästchen übersieht.
Kann ich bestimmte Felder aus handschriftlichen Formularen extrahieren, oder gibt die KI einfach den gesamten Text aus?
Sie können bestimmte Felder extrahieren. Mit der benutzerdefinierten Spaltenextraktion definieren Sie die gewünschten Spalten – „Lieferdatum", „Empfängername", „Artikelanzahl" – und die KI lokalisiert und extrahiert aus jedem Dokument nur diese Felder. Das ist der Unterschied zwischen einem Textblock, den Sie selbst durchsortieren müssen, und einer Tabelle, in der jede Spalte genau die Daten enthält, die Sie benötigen. Der Ansatz funktioniert über Dokumenttypen hinweg: Dieselben Spalten können Daten aus handschriftlichen Rechnungen, Lieferscheinen und Inspektionsformularen extrahieren – weil die KI Felder nach Bedeutung findet, nicht nach Position. Eine Schritt-für-Schritt-Anleitung finden Sie unter benutzerdefinierte Spaltenextraktion für handschriftliche Dokumente.
Muss ich die KI mit Proben meiner spezifischen Handschrift trainieren?
Nein – moderne Vision-KI-Modelle kommen bereits vortrainiert mit Millionen von Handschriftproben verschiedener Stile, Sprachen und Dokumenttypen. Sie verarbeiten neue Handschriftstile ohne Training oder Probensammlung pro Schreiber. Wenn Ihre Organisation einen einzelnen Schreiber mit einem äußerst ungewöhnlichen Stil hat (historische Schriften, nicht-lateinische Schreibschrift, stark stilisierte Kurzschrift), kann eine Feinabstimmung auf diese spezifische Handschrift die Genauigkeit verbessern – aber für die meisten geschäftlichen Anwendungsfälle mit mehreren Schreibern, die Standardformulare ausfüllen, liefert das Standardmodell bereits ohne Einrichtung eine brauchbare Genauigkeit.
Das Fazit
Handschrift war die letzte hartnäckige Grenze der Dokumentenautomatisierung – der Grund, warum ein Mensch sich hinsetzen und tippen musste, egal wie viele andere Teile des Prozesses digitalisiert waren. Diese Grenze hat sich verschoben. Die KI-Handschrifterkennung erreicht nicht bei jedem Dokument die Genauigkeit eines Menschen, und das wird sie bei den chaotischsten 5 % der Handschriften wahrscheinlich auch nie tun. Aber bei den 85–95 % der handschriftlichen Dokumente, bei denen die Schrift einigermaßen lesbar ist, entfällt der Übertragungsschritt vollständig – aus „jemand muss das alles abtippen" wird „jemand muss die Arbeit der KI stichprobenartig prüfen".
Diejenigen, die am meisten davon profitieren, sind nicht KI-Forscher oder IT-Abteilungen von Unternehmen. Es sind die Büroleiterin eines Bauunternehmens, die jeden Montag 40 handschriftliche Stundenzettel verarbeitet. Der Lagerist, der Zustellbestätigungen von wechselnden Fahrern erhält. Der Kleinunternehmer, dessen Lieferanten weiterhin handschriftliche Rechnungen auf Durchschreibeblöcken senden. Für sie lautet die Frage nicht „Kann KI bei jedem Dokument die Genauigkeit eines Menschen erreichen?", sondern „Kann KI die 90 % der Dokumente verarbeiten, die klar genug sind, und mir so die Freiheit geben, mich auf die 10 % zu konzentrieren, die genauer geprüft werden müssen?" Die Antwort ist ab 2026: ja.