AI手書き認識とは?
ビジョンAIが筆記体を読み取る仕組み
AI手書き認識とは、ビジョンAIモデルを使用して、手書きテキスト(印刷体・筆記体・混在のいずれも)を写真やスキャンから読み取り、機械可読な構造化データに変換する技術です。固定の文字テンプレートに照合してきれいな印刷フォントを認識するように作られた従来型OCRとは異なり、ビジョンAIは人間と同じように、単語全体、周囲の文脈、文書が伝えようとしている内容を見て手書き文字を理解します。質の高い手書き文字であれば、最新のAIモデルは85〜95%の精度を達成します。一方、従来型OCRは文字がつながり始めた瞬間に50%を下回ることもしばしばです。
要点
- AI手書き認識は、筆記体を検索可能なテキストに変換することではなく、手書きのフォームから構造化データのフィールドを抽出して、スプレッドシートの列に直接取り込むことです。
- 従来型OCRが筆記体で失敗するのは、手書き文字が「苦手」だからではなく、文字を個別に切り分ける方式だからです。つながった文字は文字の切り離しを根本的に不可能にし、最初のステップでパイプラインが停止します。
- 画期的なのは意味的な読み取りです。AIはフィールドがどこにあるかではなく何を意味するかを理解してフィールドを見つけるため、同じ列定義で、書き手ごとの学習やフォーマットごとのテンプレートなしに、あらゆる手書きフォームからデータを抽出できます。
AI手書き認識の正体
最も一般的な誤解をすぐに解消しましょう:AI手書き認識は署名を認識する技術ではありません。手書き文書のデータ項目を読み取る技術です。フォームの上部に走り書きされた請求書番号、配達証明書にドライバーが書き留めた配達日、現場監督が紙のタイムシートに鉛筆で記入した勤務時間——そういったデータを読み取ります。この技術は手書き文書の写真を見て、人間のデータ入力担当者に尋ねるのと同じ質問に答えます:日付はいつか、取引先は誰か、数量はいくつか、合計はいくらか、という具合です。
この違いが重要なのは、世にある「手書きOCR」に関する情報のほとんどが、手書きメモのページを編集可能なテキストに変換する話——つまりデジタル化の問題——を扱っているからです。しかし、手書き文書を扱うほとんどの企業が抱えているのはデジタル化の問題ではありません。彼らが抱えているのはデータ抽出の問題です。手書きの納品書50枚の束は、検索可能なテキストファイル50個としては価値がありません。日付、受取人、品目、署名の列を持つ1つのスプレッドシート——在庫システムにそのままインポートできる形——になって初めて価値が出ます。これがテキスト認識から構造化抽出への飛躍であり、AI手書き認識を過去10年の手書きOCRツールから隔てる点です。
これが文書自動化の全体像にどう位置づくかについては、AI文書抽出が実際にできることのガイドをご覧ください——手書き認識はその中でも最も困難でありながら最も影響力の大きい機能のひとつです。
手書き認識 vs 従来型OCR vs 人間による転写
スキャナーアプリやAdobe Acrobatを手書きフォームに使って、意味不明な文字列が返ってきた経験があるなら、従来型OCRが想定していた用途と手書きが求めるものの間に根本的なミスマッチがあることを実感しているはずです。この3つのアプローチは、同じ出発点——手書き文書の写真——から、まったく異なる結果を生み出します。
| アプローチ | 仕組み | 筆記体の精度 | 出力 | 最適な用途 |
|---|---|---|---|---|
| 従来型OCR | 既知の文字テンプレートと画素パターンを照合——1文字ずつ処理 | 40〜60% | 生のテキスト文字列。連結した文字で破綻する | きれいで均一なフォントの印刷文書 |
| AI手書き認識 | ビジョンモデルが単語と行全体をまとめて読み取り、周囲の文脈を利用して曖昧さを解消 | 読みやすい筆記で85〜95% | 構造化データ(Excel、CSV、JSON)——各項目がそれぞれの列に入る | 手書きフォーム、印刷と筆記が混在する文書、現場報告書、納品書 |
| 人間による転写 | 人が各項目を読んで入力する | 約99%(疲労によるミスあり) | 入力者が打ち込む任意の形式 | 低量・高精度が求められ、コストが最優先でない場合 |
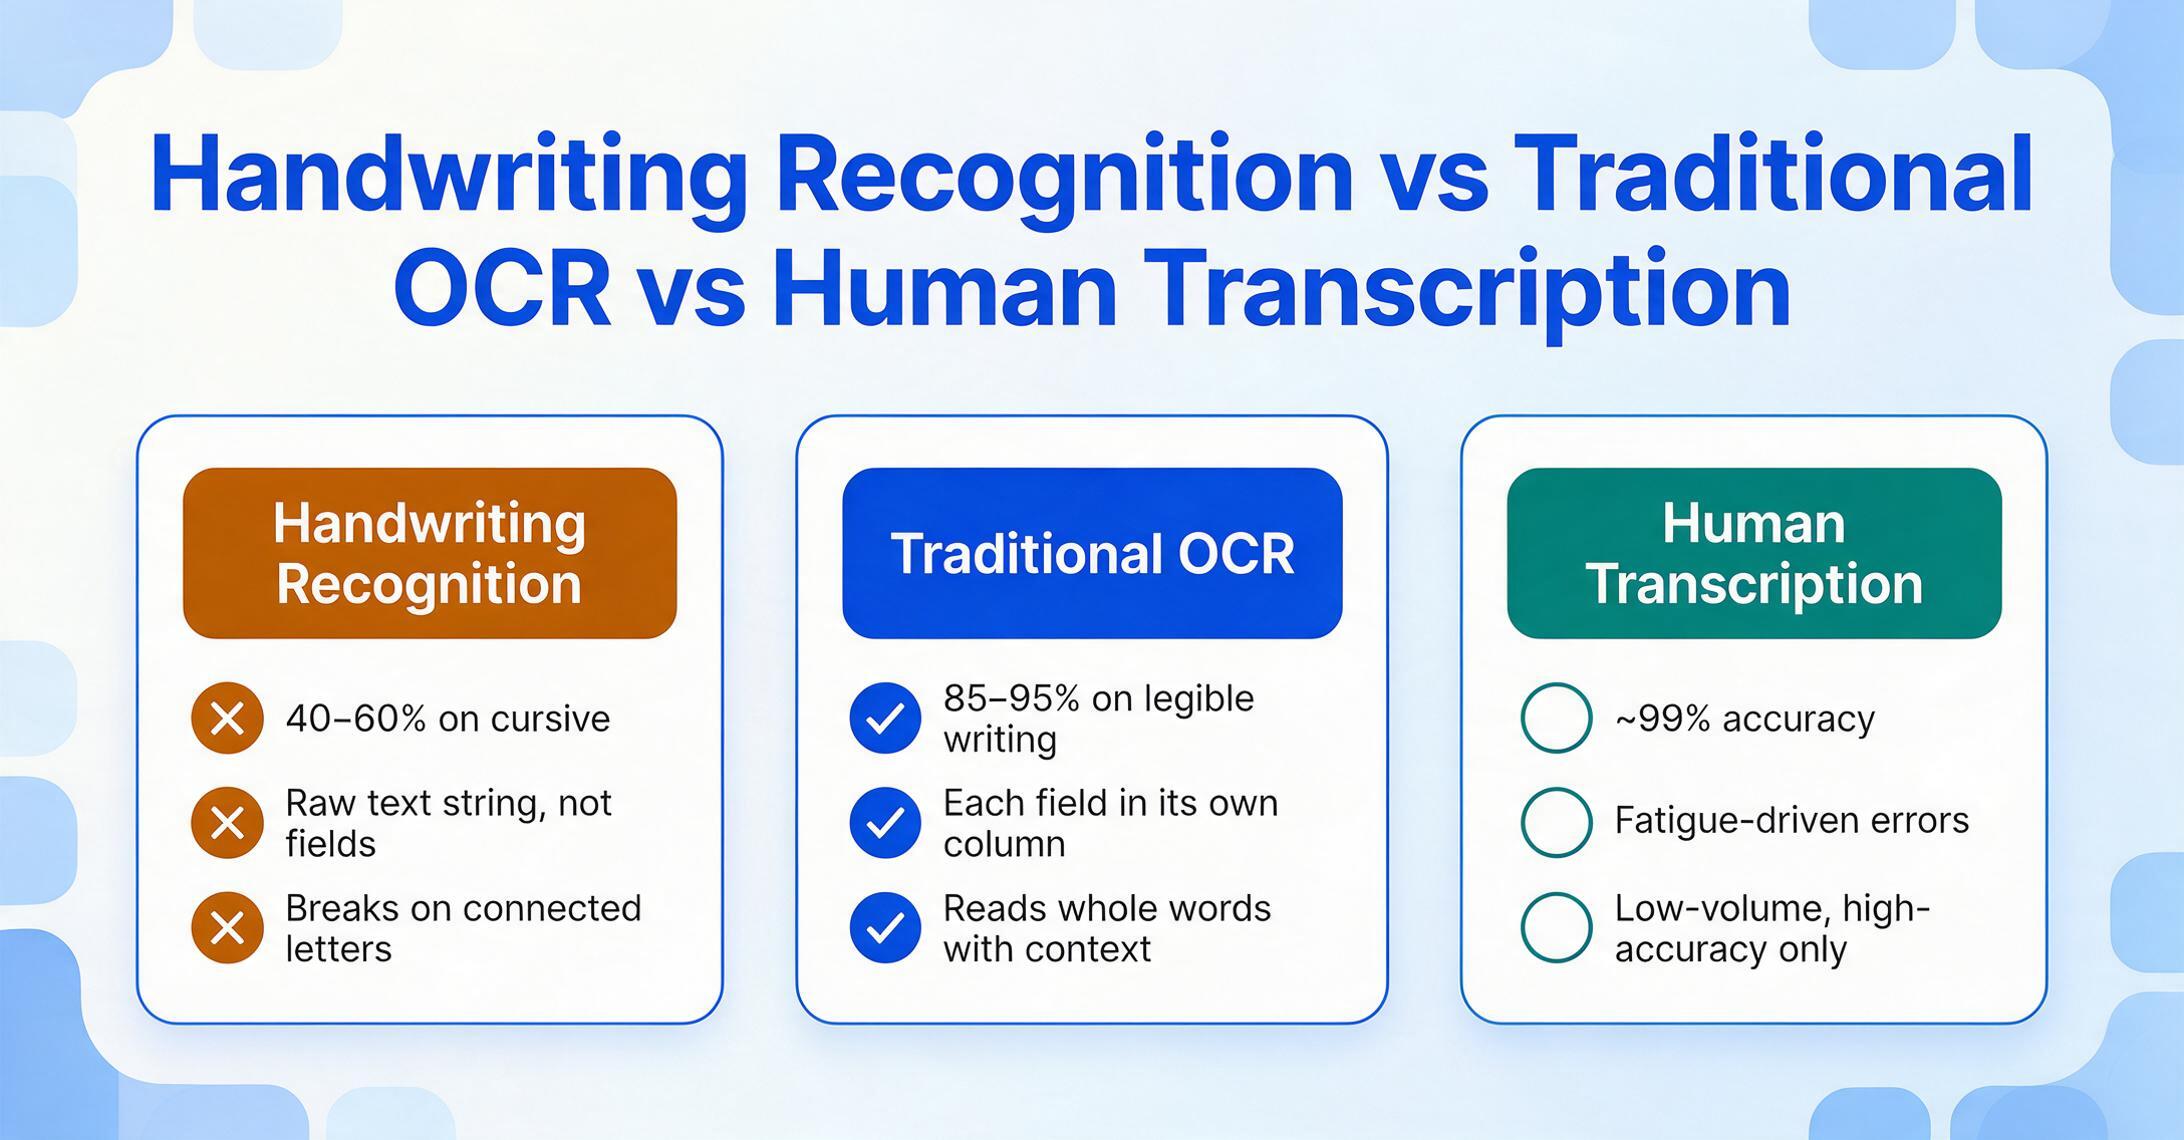
その数字は歴然としています。100件の筆記体サンプルを用いた14のAIモデルの独立ベンチマークでは、トップクラスのビジョン言語モデルがほぼ完璧な意味的精度を達成した一方、従来型OCRエンジンは出力が実質的に使い物にならないレベルのエラー率を記録しました。ある専門の手書き認識サービスは、きれいな手書き文字に対して0.9%の単語誤り率を達成しましたが、同じサンプルで広く使われているオープンソースのOCRエンジンであるTesseractは95.4%でした。これは、1ページあたり1回の修正で済むか、1文あたり1回の修正が必要になるかの違いです。
これらは期待値レベルの数値であり、典型的なドキュメントで各アプローチから合理的に期待できる代表的な精度です。精度の測定方法は、どのような問いを立てるかによって異なります。文字レベルのエラー率(CER/WER)は生の文字起こしを表し、フィールド単位の精度は各値が正しいスプレッドシートの列に格納されるかどうかを表します。当社のメカニズムの詳細解説では文字レベルの数値を報告しており、AIと従来型OCRの比較ではドキュメントタイプ別のフィールド単位の精度を測定しています。
この差を生み出しているのは、漸進的な改善ではありません。それは根本的に異なるアーキテクチャです。従来型OCRはページを個々の文字に分割し、それぞれをテンプレートライブラリと照合して、結果を再結合します。筆記体はこのパイプラインを最初のステップで破綻させます。文字の切れ目がわからなければ、つながった文字を分割することはできないからです。これが、鮮明な印刷された請求書が99%の精度でスキャンされる一方で、同じドキュメントの手書き版が50%に落ちる理由です。OCRエンジンは最初のステップを通過できなかったのです。
手書きの種類別(ブロック体、きれいな筆記体、読みにくい筆記体)の精度数値と、それらの数値がお客様のドキュメントにとって何を意味するかについては、AIは実用的な精度で手書き文字を読めるかをご覧ください。
この同じアーキテクチャ上のギャップは、あらゆるドキュメントタイプにわたって現れます。印刷ドキュメントにおける従来のテンプレートベースの抽出とAIベースのアプローチの比較については、AI手書き認識と従来型OCRの比較をご覧ください。また、最も重要度が高い手書きフォームからのデータ抽出という特定の課題については、手書きフォームからの特定フィールドの抽出をお読みください。
手書き認識の仕組み
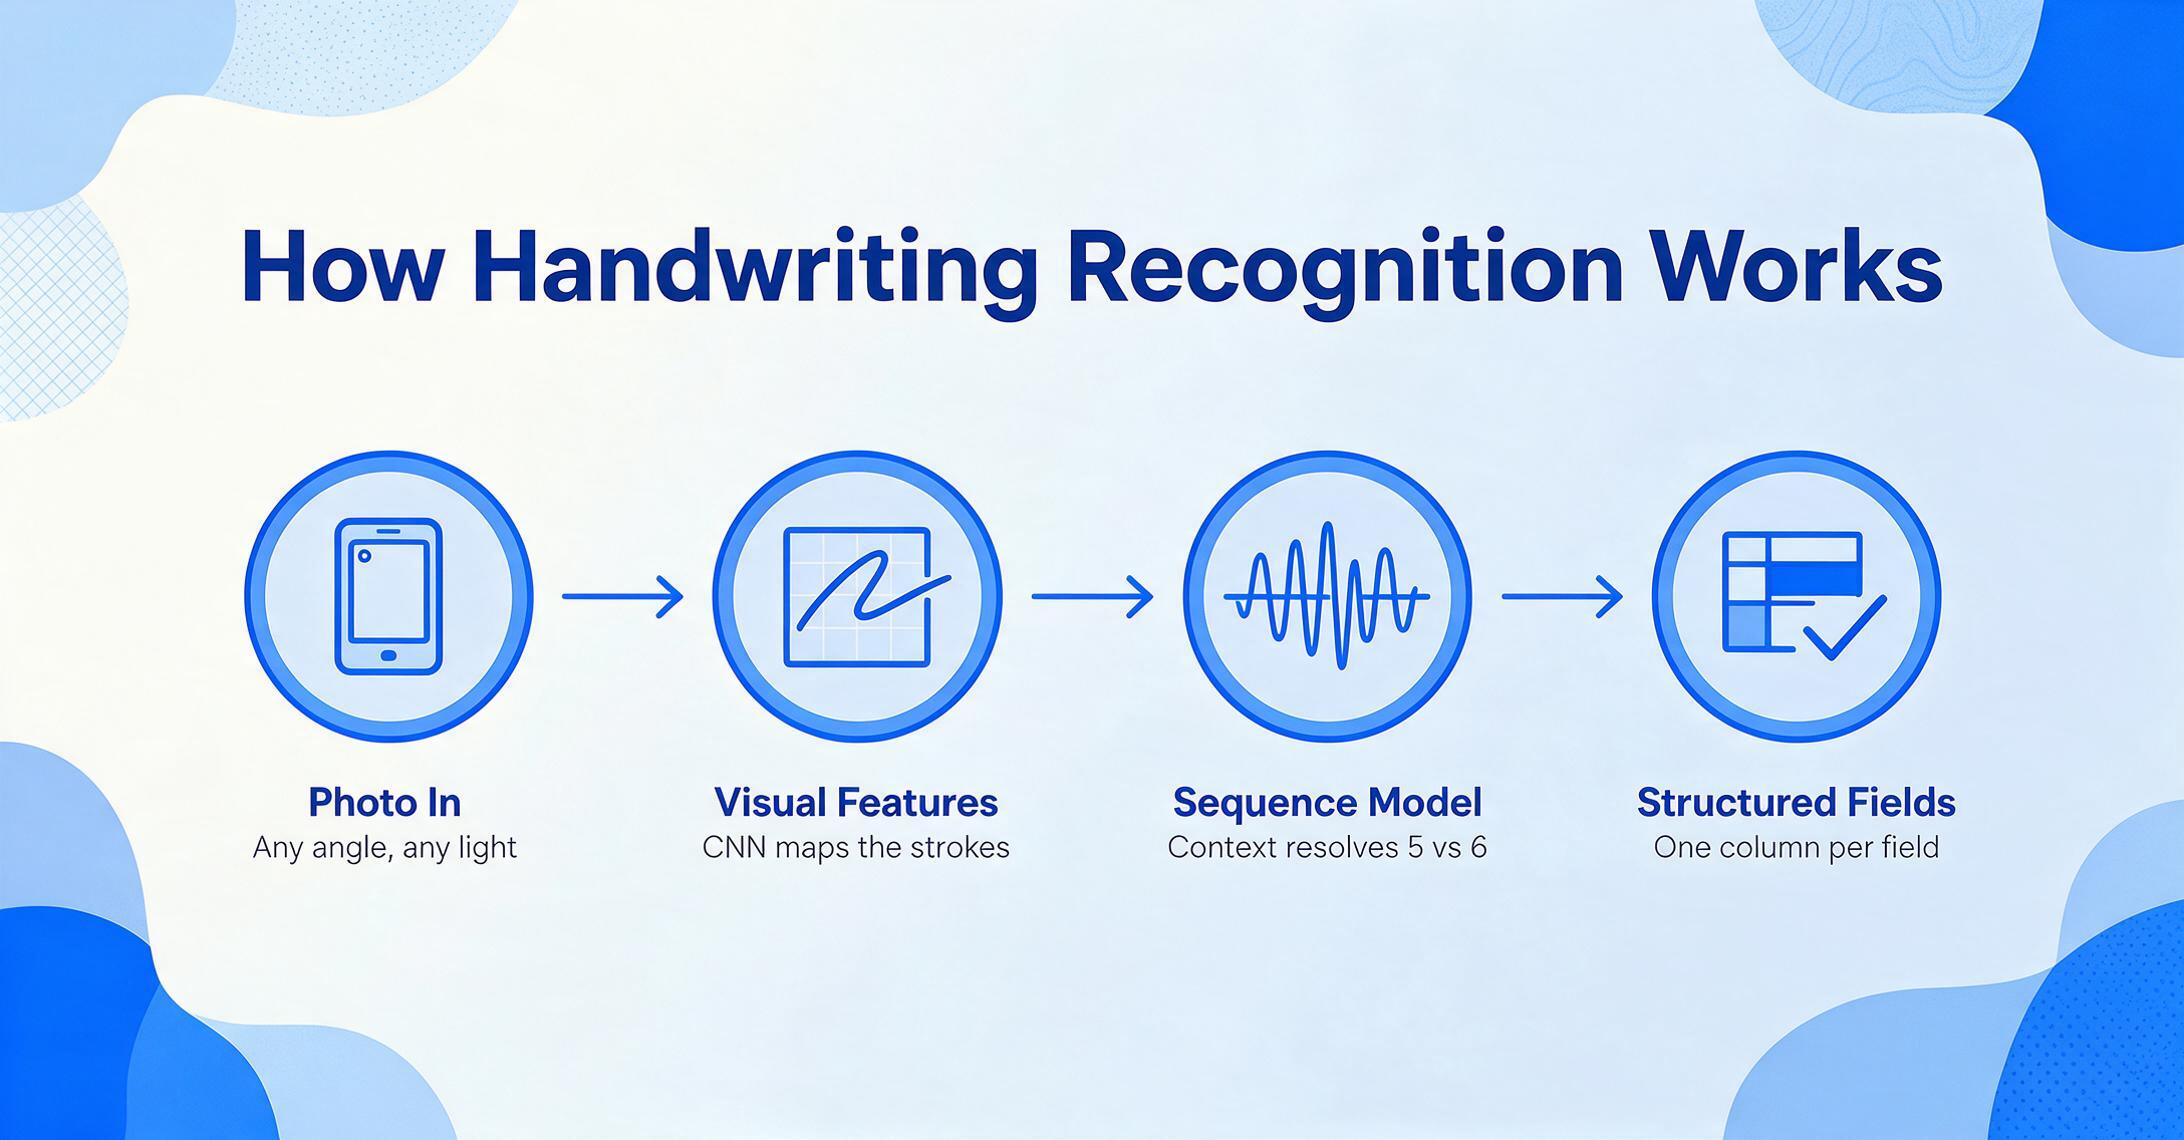
AIが従来型OCRの失敗を克服できる理由は、戦略の転換にあります。文字の切り出しから全体理解への転換です。この転換によって、可能なことのすべてが変わります。
このセクションは概要です。基盤となるアーキテクチャのステップバイステップ解説(文字の切り出しが連結した文字で崩壊する理由や、手書きの「5」と「6」のような曖昧な数字を文脈がどう解決するかを含む)については、手書き認識の仕組みの詳細解説をご覧ください。
従来型OCRは手書きのページをパズルのように扱います。各文字を切り出し、識別し、次へ進む。問題は、手書きが孤立した文字では機能しないことです。小文字の「r」が「i」に連結している場合と「n」に連結している場合では見た目が異なります。医師が急いで書いた「qty」は、文脈がなければ「gty」のように見えるかもしれませんが、配送伝票ではどちらか一方だけが意味を成します。従来型OCRは何が意味を成すのかを知りません。形を照合するだけです。
最新のAI手書き認識は、畳み込みニューラルネットワーク(CNN)を使用して画像から視覚的特徴を抽出し、回帰型ニューラルネットワーク(RNN)またはTransformerモデルを使用してそれらの特徴をシーケンスとして処理します。つまり、手書きの行を個別の文字の連なりではなく、連続した信号として扱います。このため、このアプローチはOCRと区別して手書きテキスト認識(HTR)と呼ばれることがあります。認識パイプライン全体が、手書きの実際の挙動に基づいて再構築されているからです。
ビジョン言語モデルはこれをさらに推し進めます。文字を認識するだけでなく、文書を理解します。あるフォームでは「Delivery Date」、別のフォームでは「Date Rec'd」とラベル付けされている場合、AIはそれらが同じものであると教えられる必要はありません。ラベルを読み、その意味を理解し、対応する手書きの値をページ上のどこからでも特定します。これが、テキストを見るツールと、文書を読むツールの違いです。
実用的な意味は大きいです。AI手書き認識は、文書レイアウトごとにテンプレートを作成したり、特定の手書きのサンプルでトレーニングしたり、抽出ルールを設定したりする必要がありません。「送信者名」「出荷日」「商品数」など、必要なものを指定するだけで、AIは意味を理解して各値を特定します。値がどこに現れても、どのように書かれていても関係ありません。これがカスタム列抽出の核となる概念です。列に名前を付けると、AIが文書を位置的にスキャンするのではなく意味的に読み取って列を埋めます。この技術が最も難しい手書きシナリオにどう対応するかについては、手書き抽出の一般的な失敗モードとその回避方法に関する記事をご覧ください。
手書き認識が必要なケース
手書き認識の皮肉な点は、それを最も必要とする人々が、しばしばコンピューターから最も遠い場所にいることです。現場作業員は現場で紙のフォームに記入します。配達ドライバーは荷降ろし場で署名や数量を走り書きします。検査員は倉庫のクリップボードにチェックを入れたりメモを書いたりします。これらの書類は、誰か——通常はオフィス管理者や中小企業の経営者——が、その手書きデータをすべてシステムに入力するという作業に直面するまで、蓄積され続けます。
手書き認識が価値を持つのは、あなたの書類に以下の条件の少なくとも1つが当てはまる場合です:
手書き認識が必要な4つのサイン
1. 量が手動の閾値を超えている。 週に20枚以上の手書きフォームを処理している——つまり月に80枚以上——1枚あたり3〜5分の手動データ入力が必要です。この規模では、85%のAI精度と簡単な人間によるスポットチェックでも、100%手動入力よりもはるかに高速です。
2. 手書きが複数の人物によるもの。 建設オフィスでは、十数人の異なる下請け業者から、それぞれ異なる手書きのタイムシートを受け取るかもしれません。物流ハブでは、3つのシフトのドライバーからの配達メモを処理するかもしれません。手書きのばらつきこそが問題であり、AIは一貫性を前提とするテンプレートベースのシステムよりもそれをうまく処理します。
3. 書類が印刷物と手書きの内容を混在している。 手書きの観察記録が入った印刷済みの検査フォーム。手書きの署名と日付が入った印刷済みの請求書。印刷された口座番号と手書きの検針値が入ったメーター検針カード。従来型OCRは印刷部分は問題なく読み取りますが、手書き部分はめちゃくちゃな出力になり——両方を別々に処理することを余儀なくされます。
4. 書類が時間に敏感である。 在庫更新をトリガーする必要がある配達確認書。安全上の問題をフラグする必要がある検査報告書。金曜日までに給与計算に間に合わせる必要があるタイムシート。遅延の原因は抽出ではなく——誰かが入力するのを待っている紙の山なのです。
手書きが最も一般的な書類タイプで、これがどのように見えるかを次に示します:
手書きの配達メモと配達証明書(POD)。 ドライバーが荷物を降ろし、受取人が紙の伝票に署名し、その伝票はオフィスに戻ってきます——時には数日後、時にはコーヒーの染み付きで。その伝票が未処理のままの1時間ごとに、あなたの在庫システムは配達が行われたことを知りません。AI手書き認識は、配達時点で撮影された写真から受取人名、日付、品目、数量を読み取ることができます。受付部門向けの手書き配達メモ抽出の詳細をご覧ください。
手書きのタイムシートと勤怠記録。建設現場の作業員、フィールドサービスの技術者、製造業のシフト勤務者は、紙のタイムカードに記入することがよくあります。現場監督が1枚のシートに15人分の労働時間(氏名、日付、時間、ジョブコード)を鉛筆で書き込むこともあります。そのデータを給与計算に反映するには、誰かがすべてのフィールドを手入力する必要があります。AIはシート全体を一度に読み取り、作業者ごと・日ごとの行を出力します。詳細は手書きタイムシートを給与計算用にExcelへ変換する方法をご覧ください。
手書きの請求書。小規模なサプライヤーや下請け業者(あなたの物件の水漏れを修理する配管業者、小さな仕事を請け負う電気技師など)は、一般的なパッドに手書きで請求書を書くことがよくあります。これらは標準的な形式に従っておらず、手書きのため、テンプレートベースの抽出ツールでは対応できません。ビジョンAIは、請求書が「どのように見えるか」ではなく「何であるか」を理解して読み取ります。請負業者向けの手書き請求書抽出をご覧ください。
手書きの点検フォームと現場記録。安全点検、機器チェック、建設現場の日報は、ほぼ常に現場でペンや鉛筆を使って手書きで記入されます。フォームは印刷済みですが、データ(観察結果、測定値、チェックマーク、署名)は手書きです。AIは両方のレイヤーを読み取り、手書きの注記から構造化データを抽出し、印刷されたフィールドラベルを文脈として認識します。建設業界に特化した情報は、手書き現場記録のExcelへの抽出をご覧ください。
手書きのメーター検針値。ライフラインの作業員がルートを巡回し、メーターを読み取り、クリップボードに数字を書き込みます。鉛筆の場合もあれば、雨の中での作業の場合もあります。それらの検針値は請求データになる必要があります。AIは、メーターカードの写真から手書きの数値を読み取ります。読み手によって筆跡の質が異なっても対応できます。メーター検針値のスプレッドシートへの変換をご覧ください。
レガシーな手書き記録。古い元帳、倉庫の在庫カード、EHRシステム導入前の患者受付フォームなど、紙にしか存在しない数十年分の手書きデータがあります。これらのデジタル化はリアルタイム処理の問題ではなく、現在は見えない情報を引き出すことです。歴史的な元帳については、AIによる手書き元帳読み取り精度のガイドをご覧ください。
これらの文書タイプにはそれぞれ異なるフィールド、異なるレイアウト、異なる手書きの課題があります。しかし、共通のボトルネックがあります。それは、人間がデータを入力しなければならないことです。AI手書き認識は、そのボトルネックを取り除きます。人間の判断を置き換えるのではなく、文字起こしを処理することで、人間は検証だけを行えば済むようにします。
手書き認識ツールに求めるべきポイント
すべての手書き認識ツールが同じ問題を解決するわけではありません。手書きノートのページを検索可能なテキストに変換するために作られたものもあれば、手書きフォームから構造化データを抽出してスプレッドシートとして出力するために作られたものもあります。ツールを検討する際、この2つを分ける4つの基準があります。
1. 認識テキストだけでなく、構造化された出力
「日付: 12/04/2026 仕入先: Acme 数量: 50」というテキストブロックを出力するツールは、手書きOCRを行っただけで、データ抽出はしていません。そのテキストを解析し、フィールドに分割し、正しい列に入力する必要がまだあります。適切な抽出ツールは、「12/04/2026」が日付列に、「Acme」が仕入先列に、「50」が数量列に入ったスプレッドシートを、手動での解析なしに提供します。確認すべき点: 出力は構造化された列に格納されますか、それともテキストボックスに格納されますか?
2. テンプレート不要の認識
ツールが各ドキュメント形式に対してゾーンの定義、ボックスの描画、解析テンプレートの作成を要求する場合、従来型OCRの根本的な弱点を受け継いでいます。異なるソースからの手書きドキュメントは異なるレイアウトになります。あるドライバーの納品書は、別のドライバーの納品書とはまったく見た目が異なります。ツールは、位置の一致ではなく、データの意味を理解することでデータを見つける必要があります。確認すべき点: 新しい仕入先から、これまで見たことのない形式の手書きドキュメントが送られてきた場合、ツールはセットアップなしで処理できますか?
3. 印刷と手書きの混在処理
実際のドキュメントが純粋に手書きであることはほとんどありません。点検フォームには印刷されたフィールドラベルと手書きの所見があります。メーターカードには印刷された口座番号と手書きの検針値があります。納品書には印刷された会社ヘッダーと手書きの数量があります。ツールは、これらを分離したり、2つの異なる処理パイプラインを実行したりすることを要求するのではなく、1回のパスで両方を処理する必要があります。確認すべき点: 印刷されたラベル、手書きの値、チェックボックスが混在するフォームを、1回のアップロードで抽出できますか?
4. ファーストクラス機能としてのバッチ処理
月に1ページの手書き文書を処理するだけなら、どのツールでも十分です。しかし、ほとんどの手書き認識のユースケースはバッチ処理を伴います。1週間の出荷分の30枚の納品書、作業員の15枚のタイムシート、現場監査の50枚の点検フォームなどです。ツールは、それらをまとめて処理し、結果を1つのスプレッドシートに統合するように作られているべきです。1ファイルずつアップロード、抽出、エクスポートを強制するものではありません。確認すべき点: ドキュメントのフォルダをアップロードして、50の個別エクスポートではなく、1つのスプレッドシートを取得できますか?
特定のツールを並べて比較する場合は、2026年の最高の手書き認識ツールガイドで詳細に解説しています。また、基盤となるテクノロジーの直接比較については、AI手書き認識と従来型OCRの比較をご覧ください。
よくある質問
AI手書き認識は筆記体に対応していますか?
はい、対応しています。ここがAIが従来型OCRを最も劇的に上回る点です。AIモデルは個々の文字を分割するのではなく、単語や行全体をまとめて読むため、文字単位で解析するOCRエンジンでは対応できない筆記体の連結文字も処理できます。読みやすい筆記体での精度は通常80〜90%で、従来型OCRの40〜60%を上回ります。文書内の手書きスタイルが一貫しているほど、精度は高くなります。
AIはスマートフォンの写真から手書き文字を読み取れますか?それともスキャンが必要ですか?
スマートフォンの写真で問題ありません。最新のビジョンAIモデルは、きれいなスキャン画像だけでなく実際の現場画像で学習しているため、斜めからの撮影や不均一な照明、影にも従来型OCRより強く対応できます。従来型OCRは平らで均一な照明の文書を前提としています。良い光の下で撮影された鮮明な写真(ブレがなく、人間の目で読める状態)は、スキャン画像に近い結果が得られます。実務上のメリットは大きく、現場作業員が配達伝票や点検フォームをスマートフォンで撮影するだけで、データが即座に抽出されます。スキャナーは不要です。
AIが読み取れない手書き文字の品質とはどの程度ですか?
2人の人間の読者が手書きの単語の内容で一致しない場合、AIでも解決できない可能性が高いです。実用的な基準は可読性です。書き手を知らない人が推測なしで80%以上読める場合、AIの精度は85〜95%になる見込みです。極端に装飾された筆記体、激しい取り消し線、極端な角度で書かれた文字、カーボンコピーで3枚目や4枚目がほとんど見えない複写は、精度が70%を下回る可能性があります。このような場合でも、高信頼度の抽出にはヒューマンインザループによる確認ステップが必要ですが、完全な手入力よりは速いです。
AIは同じページ内の印刷文字と手書き文字を区別できますか?
はい、できます。ビジョンAIモデルはページ全体を画像として処理し、印刷文字と手書き文字を区別できます。これは、フォームのどの部分が事前に印刷され、どの部分が手書きで記入されたかを一目で見分けられるのと同じです。これは構造化フォームの抽出において重要です。AIは印刷されたラベル(「日付」「検査者」「所見」など)を手掛かりに手書きの値の意味を理解し、その値を正しい列に抽出します。
手書き認識はチェックボックス、チェックマーク、丸で囲んだ選択肢にも対応していますか?
最新のビジョンAIは、チェックボックスにチェックが入っているか、丸が塗りつぶされているか、選択肢が取り消し線で消されているかを検出し、その結果を構造化データ(例:「安全チェック合格:はい」)として出力できます。これは文字認識を超えた視覚的理解です。AIはチェックボックスとその印を文字ではなく視覚要素として認識します。明確なチェックボックス検出の精度は一般的に高い(90%以上)ですが、選択肢が密集している場合や薄い鉛筆書きの場合は信頼性が低下することがあります。チェックボックスがフォーム抽出においてなぜ最も難しい部分なのか、そして優れたモデルでも間違えやすい5つのパターンについて詳しくは、AIが手書きフォームを読み取ってもチェックボックスの印を見逃す理由に関する記事をご覧ください。
手書きフォームから特定のフィールドを抽出できますか?それともAIはテキストをすべて出力するだけですか?
特定のフィールドを抽出できます。カスタム列抽出を使用すると、必要な列(「配達日」「受取人名」「品目数」など)を定義し、AIが各ドキュメントから該当フィールドのみを特定して抽出します。これは、整理が必要なテキストの塊を得るのではなく、すべての列が必要なデータとして正確に揃ったスプレッドシートを得られるという違いです。このアプローチはドキュメントの種類を問わず機能します。同じ列で手書きの請求書、納品書、点検フォームからデータを抽出できます。AIは位置ではなく意味でフィールドを見つけるからです。ステップバイステップのガイドは、手書きドキュメントのカスタム列抽出をご覧ください。
特定の手書き文字のサンプルでAIをトレーニングする必要がありますか?
いいえ — 最新のビジョンAIモデルは、異なる書体、言語、ドキュメントタイプにわたる数百万の手書きサンプルで事前トレーニングされています。ライターごとのトレーニングやサンプル収集なしで、新しい手書きスタイルを処理します。組織内に極めて特殊な筆記スタイル(歴史的な筆記体、非ラテン文字の筆記体、高度に装飾された速記など)の書き手が1人だけいる場合、その特定の手書きにファインチューニングすることで精度を向上できます。しかし、標準フォームを複数の書き手が記入する一般的な業務用途では、セットアップなしで初期状態のモデルで実用的な精度が得られます。
結論
手書きは文書自動化における最後の難関でした。プロセスの他の部分がどれだけデジタル化されても、人間が座ってタイピングしなければならない部分です。その難関は変わりました。AI手書き認識は、すべての文書で人間の精度に匹敵するわけではなく、最も読みにくい5%の手書きについては今後も匹敵しないでしょう。しかし、読みやすさが十分な85〜95%の手書き文書では、文字起こしのステップを完全に排除し、「誰かがこれを全部タイピングしなければならない」を「誰かがAIの作業をスポットチェックする必要がある」に変えます。
最も恩恵を受けるのは、AI研究者や企業のIT部門ではありません。毎週月曜日に40枚の手書きタイムシートを処理する建設会社のオフィスマネージャー。入れ替わりのあるドライバーから配達確認書を受け取る倉庫係。カーボン複写式の伝票で手書きの請求書を今も送ってくる仕入先を持つ小規模事業主。彼らにとっての問いは「AIはすべての文書で人間の精度に匹敵できるか」ではありません。「AIが十分に読み取れる90%の文書を処理してくれれば、私がより注意深く見る必要がある10%に集中できるか」です。2026年時点での答えは、イエスです。