AI OCR vs OCR tradicional
A lacuna de precisão que você não pode mais ignorar
Em 2023, a lacuna de precisão entre OCR com IA e OCR tradicional era discutível. Em meados de 2026, não é mais. Quando um mecanismo de OCR tradicional processa um lote de faturas de vários fornecedores, a precisão a nível de campo fica rotineiramente entre 60% e 85% — ou seja, 15 a 40 de cada 100 campos precisam de correção humana. Um modelo de visão de IA no mesmo lote: 95% a 99%. A lacuna não é mais sobre "melhor" ou "pior". Ela se tornou um item de custo que aparece em todo fechamento mensal, em toda conciliação de contas a pagar, em toda fila de revisão manual que alguém precisa operar. Este artigo mede essa lacuna com números reais, explica o que mudou e mapeia o ponto em que manter o OCR tradicional custa mais do que mudar.
Principais Conclusões
- A "precisão de 99%" do OCR tradicional mede caracteres, não campos de dados. Em faturas reais de vários fornecedores, a precisão de campos cai para 40–60% — metade dos valores extraídos está errada antes de qualquer pessoa tocá-los.
- A deriva de modelo é a falha mais cara do OCR: quando um fornecedor move um campo, o modelo silenciosamente puxa os dados errados para o seu ERP. Nenhum sinal de erro é disparado. O erro aparece na conciliação, quando custa 10× mais para corrigir.
- A extração com IA lê por significado, não por coordenadas de pixels. Digite os nomes das suas colunas uma vez — "Número da Fatura", "Data de Vencimento" — e o ImageToTable.ai os localiza em qualquer layout instantaneamente. A manutenção de modelos e a deriva silenciosa desaparecem.
O Que o OCR Tradicional Faz — e o Que Nunca Fez
O Reconhecimento Óptico de Caracteres foi projetado para resolver um problema: converter uma imagem de texto em caracteres legíveis por máquina. Uma página digitalizada entra; uma sequência de caracteres sai. Para essa tarefa específica, os mecanismos de OCR modernos têm bom desempenho. O Tesseract 5, o benchmark de código aberto mantido pelo Google, alcança 95% de precisão de caracteres em documentos impressos limpos — comparável a mecanismos comerciais em condições controladas.
Mas precisão de caracteres não é precisão de dados. Saber que os caracteres "1.234,56" aparecem em uma página não diz se isso é um total de fatura, uma quantidade ou um número de referência. O OCR tradicional funciona de baixo para cima: reconhece caracteres individuais, os agrupa em palavras, agrupa palavras em linhas. A saída é um fluxo de texto organizado por ordem de leitura — da esquerda para a direita, de cima para baixo. Ele não tem compreensão do significado de nada disso.
A consequência downstream é que cada variação de layout se torna um problema de análise separado. Um fornecedor que coloca o número da fatura no canto superior direito produz um mapa de coordenadas. Um fornecedor que o coloca abaixo do logotipo produz outro. Mude a fonte, adicione um novo campo, reorganize uma tabela — e a lógica de extração falha silenciosamente. Os sistemas de OCR baseados em modelo tentam resolver isso definindo coordenadas de pixels para cada campo em cada tipo de documento. Isso funciona quando seu conjunto de documentos é fixo e homogêneo. Colapsa quando os documentos variam — o que é a norma para qualquer empresa que recebe faturas, ordens de compra ou recibos de mais de uma fonte.
Os Números de Precisão: O Que os Benchmarks de 2026 Realmente Mostram
A lacuna de precisão não é teórica. Benchmarks independentes agora a quantificam em tipos de documentos e níveis de dificuldade. Aqui está o que os dados dizem em meados de 2026:
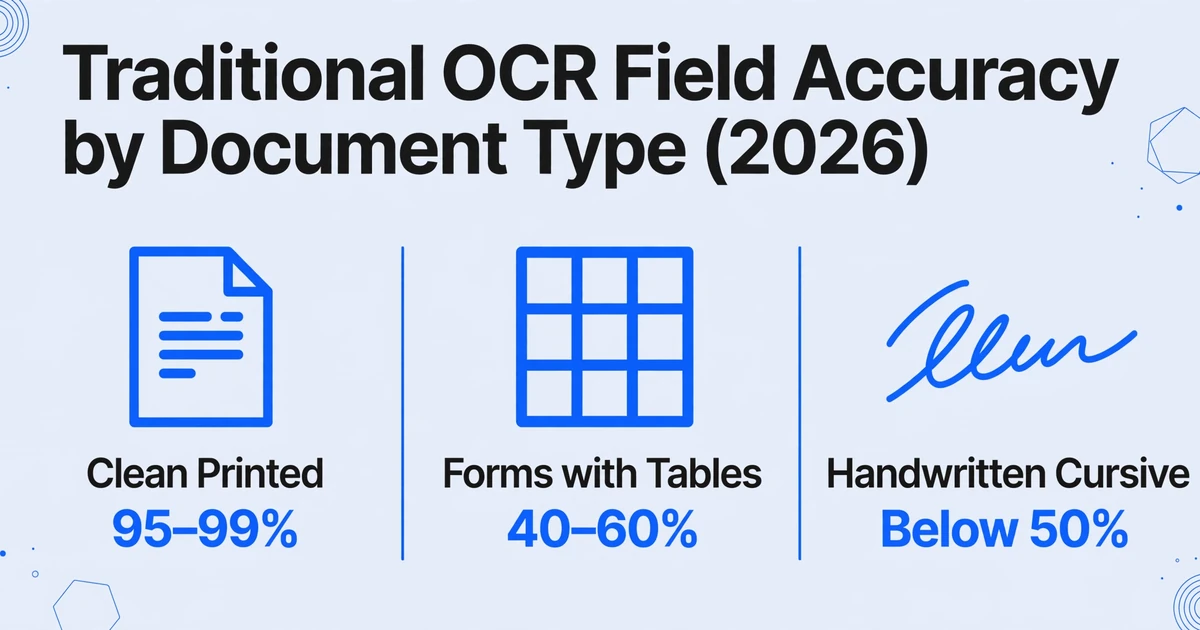
| Tipo de Documento | OCR tradicional | AI OCR (baseado em VLM) | Principal modo de falha do tradicional |
|---|---|---|---|
| Texto impresso limpo, layout fixo | 95–99% | 98–99% | Diferença mínima — ambos têm bom desempenho |
| Formulários com tabelas e colunas mistas | 40–60% | 85–95% | Linhas/colunas mescladas ou perdidas na extração |
| Texto manuscrito (letra de forma) | 50–70% | 85–93% | Variação morfológica dos caracteres impede o reconhecimento de padrões |
| Texto manuscrito (cursivo) | Abaixo de 50% | 75–85% | Caracteres conectados são lidos como glifos únicos |
| Faturas de vários fornecedores (layouts variados) | 60–85% (nível de campo) | 95–98% (nível de campo) | Incompatibilidade de modelo; desvio de coordenadas; variação de rótulos |
Fontes: benchmarks de modelos de IA da Firstsource (2026) para comparações de precisão em documentos complexos; análise Tesseract vs docTR da 47Billion para linhas de base de OCR tradicional; benchmark de OCR de manuscritos da AIMultiple (2026) para índices de manuscritos em ambas as categorias. Todos os números refletem precisão a nível de campo em documentos de nível de produção, não condições de laboratório com digitalizações limpas.
Esses números revelam um padrão. Em documentos limpos e consistentes — um formulário datilografado digitalizado a 300 DPI com campos previsíveis — o OCR tradicional oferece uma precisão difícil de superar pelo seu preço. Mas quando os documentos incluem tabelas, manuscritos, layouts mistos ou variação de formato entre fontes, a queda é acentuada. Um benchmark de 2025 com profissionais de Tesseract em documentos do mundo real encontrou apenas 40–50% de precisão de campo sem pré-processamento pesado — ou seja, mais da metade dos campos extraídos precisava de revisão antes que os dados fossem utilizáveis.
Há uma segunda camada nesses números que a maioria das comparações ignora. Uma precisão de caracteres de 99% — o padrão de marketing do OCR por décadas — não significa que 99% dos dados de que você precisa estão corretos. Se uma página de fatura tem 1.000 caracteres e 10 são lidos incorretamente, a precisão de caracteres é de 99%. Mas se esses 10 caracteres errados caírem dentro de 3 dos 15 campos que importam para você, a precisão a nível de campo cai para 80%. O TDWI documentou exatamente esse cenário: o painel mostra 99%, mas 1 em cada 5 campos de negócios contém um erro. Multiplique isso por 500 faturas e a fila de revisão se torna o gargalo que a ferramenta deveria eliminar.
Onde o OCR tradicional falha sistematicamente — não é "imprecisão", é cegueira estrutural
É tentador descrever as falhas do OCR tradicional como problemas de precisão. É mais preciso chamá-las de pontos cegos estruturais — cenários em que a abordagem de baixo para cima, caractere por caractere, é arquitetonicamente incapaz de produzir uma saída correta, independentemente da qualidade da imagem. Aqui estão os modos de falha que elevam os custos de correção de erros:
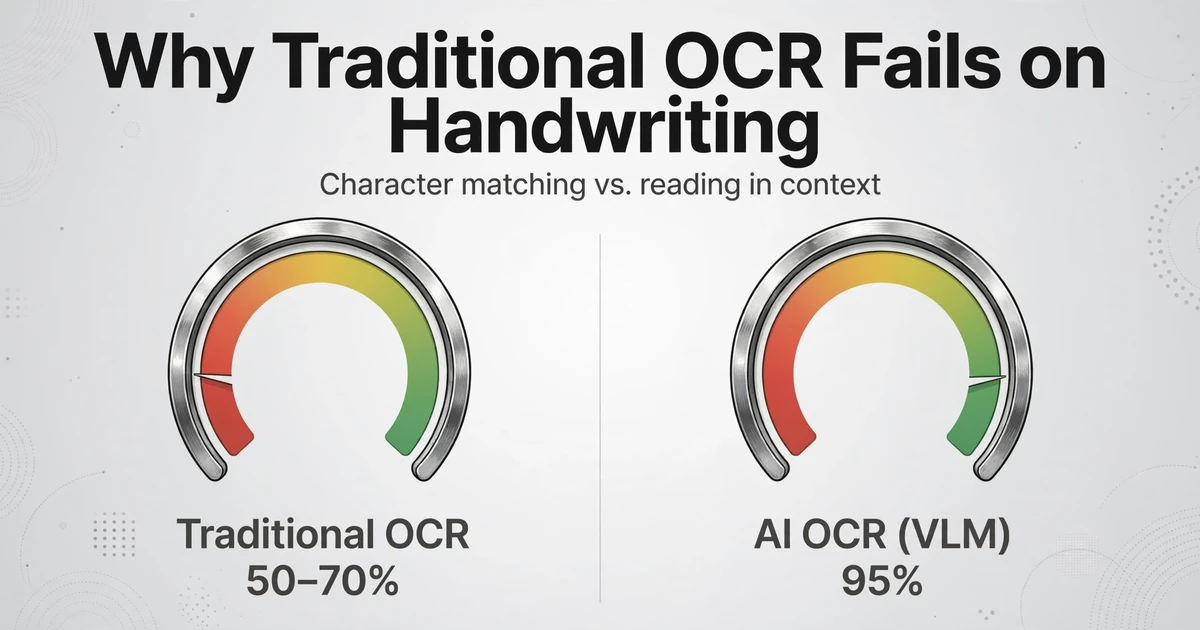
Escrita manual. O OCR tradicional depende da correspondência de formas de caracteres. Um "4" que parece um "9", um "r" cursivo que se conecta à próxima letra, um "7" manuscrito com uma barra transversal que o mecanismo lê como um caractere separado — cada um é uma falha previsível. Benchmarks independentes do Google Cloud Vision, AWS Textract e Azure Document Intelligence mostram precisão de escrita manual entre 50% e 70% para esses sistemas. O GPT-5, um modelo de visão e linguagem, atinge 95% na mesma tarefa ao ler palavras em contexto — desambiguando caracteres com base no que faz sentido em uma frase, não apenas na aparência da forma.
Layouts de múltiplas colunas. O OCR tradicional lê da esquerda para a direita, de cima para baixo. Uma fatura de duas colunas — dados do fornecedor à esquerda, itens de linha à direita no meio da página, uma caixa de total no canto inferior — é lida como um fluxo de texto embaralhado. O mecanismo não tem noção de limites espaciais além de sua grade de coordenadas. Uma análise do Microsoft Q&A de 2025 sobre falhas do OCR tradicional em documentos empresariais identificou o layout de múltiplas colunas como uma das causas mais comuns de dados chegando ao campo errado, com "linhas inteiras puladas" como um sintoma downstream frequente.
Caixas de seleção, carimbos e elementos sobrepostos. Um carimbo "PAGO" sobreposto a um item de linha de fatura torna o texto subjacente invisível para o OCR tradicional. Um formulário de seguro com caixas de seleção para opções "Sim / Não" é lido como caracteres aleatórios próximos a formas geométricas. Um extrato bancário com um logotipo sobrepondo o número da conta — o mecanismo vê ruído, não dados. Esses não são casos isolados. Um único valor de caixa de seleção ausente em um formulário de COI pode paralisar uma aprovação de conformidade inteira.
Baixo contraste e digitalizações degradadas. Recibos de papel térmico desbotam. Fotos de documentos tiradas com celular introduzem sombras e distorção de ângulo. Pedidos de compra enviados por fax chegam com artefatos de compressão que dividem caracteres em fragmentos. Os mecanismos de OCR tradicional degradam drasticamente abaixo de 200 DPI ou com iluminação não uniforme. Os modelos de visão de IA, treinados em bilhões de imagens do mundo real, lidam com essas condições interpretando o contexto visual — um caractere borrado em uma posição de campo conhecida é inferido a partir do que o campo deveria conter, não apenas do que os pixels mostram.
Deriva de modelo. Este é o custo silencioso. Um fornecedor redesenha o layout da fatura — move o número do pedido de compra do canto superior direito para abaixo do endereço de envio. O modelo do OCR tradicional, ainda olhando para as coordenadas antigas, extrai um endereço de rua e o rotula como número do pedido de compra. Nenhum sinal de erro é acionado porque o campo foi encontrado. Os dados fluem para o seu ERP, e a incompatibilidade é descoberta quando alguém concilia o pagamento semanas depois. A deriva de modelo não é um bug — é o comportamento esperado de qualquer sistema que usa coordenadas fixas em vez de compreensão semântica.
Como a IA do OCR Lê de Forma Diferente: A Página Inteira, Não Caracteres Individuais
O OCR com inteligência artificial — mais precisamente chamado de extração por modelo de linguagem visual (VLM) — processa um documento como uma pessoa faria: capturando a página inteira de uma só vez e entendendo o que cada região, rótulo e valor significa. A tecnologia subjacente é um modelo de IA multimodal treinado em bilhões de pares imagem-texto. Quando você fornece um romaneio digitalizado, ele não escaneia da esquerda para a direita procurando formas de caracteres. Ele identifica o tipo de documento, interpreta o layout espacial, lê o texto em contexto e mapeia cada valor para o campo de dados correto com base no significado — não na posição.
A diferença crucial é melhor ilustrada com um exemplo concreto. Considere três strings de texto em uma fatura:
"Data: 15/03/2026"
OCR tradicional vê: seis caracteres "Data" seguidos por dez caracteres "15/03/2026." Ele não sabe se esta é a data de emissão, a data de vencimento ou a data de envio.
"Vencimento: 14/04/2026"
OCR tradicional vê: mais duas palavras e dez caracteres. Ele não consegue conectar isso à "Data" acima ou distinguir uma da outra. Ambas são apenas strings de texto com formato de data.
"Data da Fatura: 15/03/2026"
OCR tradicional vê: mais duas palavras, mesma data. Para o mecanismo, esta é uma terceira string de texto — não relacionada às duas primeiras. Nenhuma conexão semântica é feita.
O OCR com IA vê três campos de dados diferentes. Ele lê os rótulos ("Data", "Vencimento", "Data da Fatura"), entende o que cada um significa no contexto de uma fatura e coloca cada valor na coluna correta da sua planilha. A Data da Fatura vai na coluna Data da Fatura. O Vencimento vai na coluna Vencimento. Mesmo que "Data da Fatura" apareça no cabeçalho, "Vencimento" na seção de condições de pagamento e um "Data" simples em uma linha de item — o modelo desambigua com base no contexto ao redor, não na localização do pixel.
Esse entendimento semântico é o que torna a extração por IA sem modelo — e é essa distinção que separa o moderno software de extração de dados das ferramentas de OCR tradicional. Você não precisa definir coordenadas de pixel para "Número da Fatura" no layout de fatura de cada fornecedor. Você digita os nomes das colunas que deseja extrair — "Número da Fatura", "Data de Vencimento", "Nome do Fornecedor", "Total da Linha" — e a IA localiza cada valor em qualquer lugar da página ao entender o que ele significa. Os nomes das colunas que você digita se tornam os cabeçalhos da sua planilha final. Esse mecanismo é chamado de Extração de Colunas Personalizadas: você descreve o esquema de saída, e a IA mapeia o conteúdo do documento para suas colunas — independentemente de onde o fornecedor colocou cada campo.
Os arquivos são processados com segurança e não são armazenados.
A demonstração acima mostra isso em ação em uma fatura — digite qualquer nome de coluna e veja a IA localizar o valor, independentemente de onde ele esteja na página. Experimente "Número da Fatura", "Data de Vencimento" ou "Nome do Fornecedor". O mesmo mecanismo funciona de forma idêntica em extratos bancários, ordens de compra, recibos e qualquer documento em que as informações estejam em um layout visual, e não em um campo de banco de dados.
Onde o OCR Tradicional Ainda Ganha — e Por Que Isso Importa
Uma comparação que só fala das vantagens da IA é um discurso de vendas, não uma análise. O OCR tradicional tem pontos fortes reais que o tornam a escolha certa em cenários específicos, e reconhecê-los é o que torna o caso da IA crível quando se aplica.
Documentos padronizados em escala massiva. Se você processa um milhão de formulários fiscais W-2 por ano — layout idêntico, texto digitado limpo, campos previsíveis — o OCR tradicional com um único modelo bem mantido oferece precisão quase perfeita a uma fração do custo por documento de qualquer ferramenta de extração de IA. A configuração do modelo é um investimento único que se amortiza em milhões de documentos idênticos. Nessa escala, uma chamada de API de OCR de US$ 0,01 por página versus uma chamada de extração VLM de US$ 0,05 economiza US$ 40.000 por milhão de páginas.
Documentos limpos e simples, sem variação. Um documento de texto de uma página — uma carta digitada, um memorando simples, um extrato bancário limpo com formatação consistente — é um problema resolvido para o OCR tradicional. O Tesseract e mecanismos similares lidam com isso com mais de 99% de precisão e tempos de processamento abaixo de um segundo. Adicionar uma camada de IA aumenta o custo sem agregar valor.
Ambientes com orçamento restrito e entrada homogênea. Uma organização que recebe apenas um formato de fatura de um único fornecedor, sem variação e sem complexidade, pode não precisar de extração por IA. O OCR de código aberto é gratuito. O trabalho para construir um único modelo para um único layout é um custo único medido em horas. Nesse cenário restrito, o custo de assinatura adicional de uma ferramenta de IA é difícil de justificar.
Digitalização de texto para arquivamento e busca. Quando o objetivo é a busca em texto completo — tornar um corpus de documentos históricos pesquisável por palavra-chave — em vez da extração estruturada de dados, o OCR tradicional é a escolha eficiente. Você não precisa saber qual texto é uma data e qual é um nome. Você precisa saber qual texto está na página. O OCR tradicional faz exatamente isso, e o faz bem em escala.
O Ponto de Cruzamento: Quando os Custos de Correção de Erros Excedem os Custos de Assinatura
A decisão econômica entre OCR tradicional e extração por IA é uma função de três variáveis: variedade de documentos, complexidade de documentos e volume de processamento. Quando a variedade e a complexidade são baixas e o volume é extremamente alto, o OCR tradicional vence em custo. Quando a variedade ou a complexidade ultrapassa um limite, a matemática se inverte.
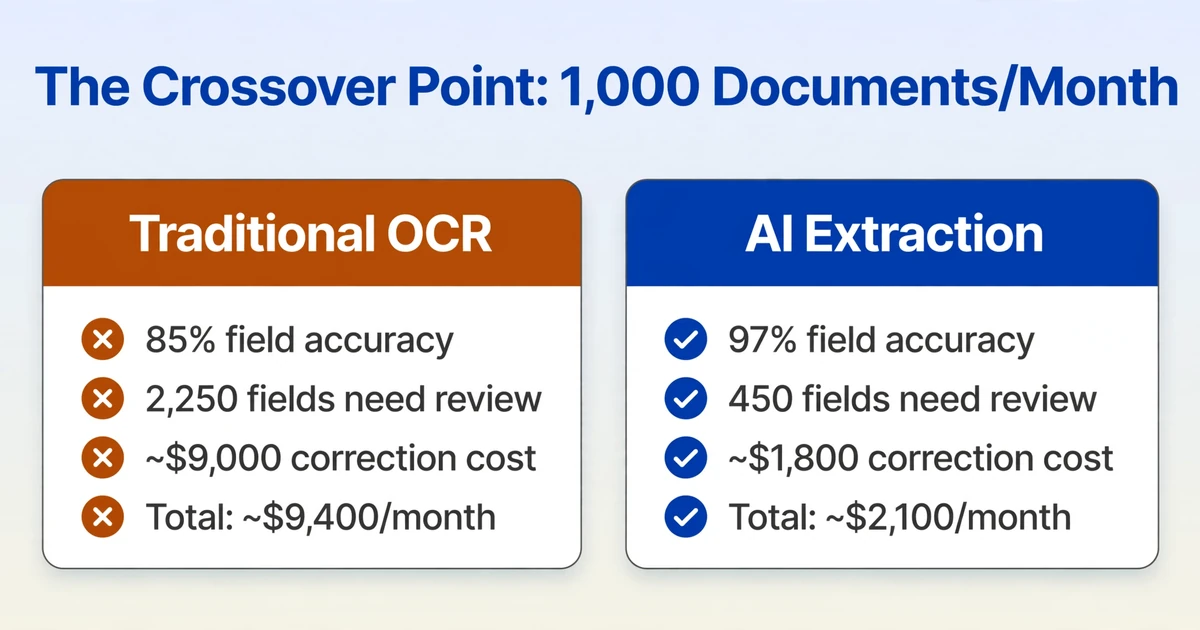
Aqui está a aritmética do ponto de cruzamento em uma escala prática. Suponha uma equipe processando 1.000 documentos por mês. Cada documento tem 15 campos que precisam de extração. A linha de base:
| Cenário | Precisão de Campos | Campos a Revisar / Mês | Custo de Correção* | Custo da Ferramenta | Total Mensal |
|---|---|---|---|---|---|
| OCR tradicional (modelos) | 85% (faturas variadas) | 2.250 campos | ~$9.000 | $200–500 | ~$9.400 |
| Extração por IA | 97% (faturas variadas) | 450 campos | ~$1.800 | $50–300 | ~$2.100 |
* Estimado em $4 por correção de campo (revisão, consulta, redigitação). Fonte: análise de custo de erro de entrada de dados (2026). Os custos reais de mão de obra variam por região e função.
Com 1.000 documentos por mês, 15 campos cada e variação moderada de layout, a diferença de precisão de 12 pontos entre 85% e 97% se traduz em 1.800 campos a menos que precisam de revisão humana — cerca de $7.200 por mês em trabalho de correção evitável. O ponto de cruzamento exato muda com o volume e a complexidade dos documentos, mas o padrão é consistente: quando a precisão a nível de campo cai abaixo de 90%, o custo de corrigir erros supera em muito o custo da ferramenta.
Uma segunda dimensão do ponto de cruzamento é a manutenção de modelos. Quando uma equipe mantém modelos para 50 layouts diferentes de fornecedores e cada fornecedor muda seu layout uma vez a cada 12 a 18 meses, a equipe está continuamente reconstruindo modelos. Um único modelo leva de 30 a 60 minutos para configurar. Se três fornecedores atualizam seu formato de fatura mensalmente, isso representa 1,5 a 3 horas de trabalho com modelos — todos os meses, indefinidamente. A extração por IA elimina isso completamente porque lê pelo significado, não por coordenadas.
A terceira dimensão são os erros que o OCR tradicional simplesmente não detecta. A extração baseada em modelos não sinaliza quando um valor está errado — ela só sinaliza quando um valor está faltando nas coordenadas esperadas. Um número de pedido extraído da posição errada porque o modelo se deslocou não é um "erro" que o sistema detecta. São dados que fluem para o seu ERP e geram um problema de conciliação semanas depois. Esses erros não detectados são os mais caros — o custo médio de correção downstream para um erro de entrada de dados capturado após o processamento é de US$ 50 a US$ 500, contra US$ 3 a US$ 5 para um erro capturado durante a revisão. O deslocamento de modelo gera o tipo caro em escala.
O que muda depois da migração: uma comparação lado a lado
Números abstratos são úteis para a tomada de decisões. Exemplos concretos são úteis para entender o que os números significam na prática. Aqui está o mesmo lote de faturas, duas abordagens de processamento, lado a lado:
| Dimensão | OCR Tradicional | Extração por IA |
|---|---|---|
| Configuração para 20 fornecedores | 20 modelos × 30 min cada = 10 horas | Definir nomes de colunas uma vez = 2 minutos |
| Fornecedor 21 entra | Criar um novo modelo = 30 minutos | Sem alteração. As mesmas colunas funcionam em qualquer layout. |
| Fornecedor 5 redesenha o layout | Dados redirecionados silenciosamente. Descoberto na conciliação. | Campos detectados por significado semântico. Mudança de layout é invisível. |
| Anotação manuscrita na fatura | Ilegível. Campo deixado em branco ou preenchido com caracteres inválidos. | Lida em contexto. "Urgente" manuscrito ao lado de "Prioridade:" vira o valor. |
| Foto de recibo pelo celular | Distorção angular + baixo contraste = saída inutilizável | Contexto visual compensa. Impressão térmica desbotada ainda é legível. |
| Campo de formulário com caixa de seleção | Caracteres aleatórios perto de um quadrado. Verificação manual necessária. | Identifica a opção marcada por saliência visual. "Sim" ou "Não" extraído. |
| 50 faturas, 15 fornecedores, 1 saída | Executar cada fornecedor em seu modelo. Mesclar saídas. Corrigir incompatibilidades. | Enviar todas as 50. Definir nomes de colunas uma vez. Baixar Excel consolidado. |
A linha mais instrutiva é "Fornecedor 5 reformata o layout." Na coluna de OCR tradicional, o erro é invisível — o modelo encontra o texto nas coordenadas esperadas e o retorna, independentemente de ser o texto correto. Na coluna de IA, a mudança de layout é irrelevante, pois a extração é baseada no significado do texto, não em sua posição. Essa única diferença — desvio silencioso do modelo versus extração resiliente a layout — é responsável por mais custos downstream de reconciliação do que qualquer outro fator.
A abordagem híbrida vale a pena ser considerada por equipes que processam uma variedade de tipos de documentos. Muitas organizações que lidam com extração de documentos em escala — conforme observado em comunidades do Reddit como r/mlops e r/fintech — executam pipelines em camadas: OCR tradicional para os tipos de documento de alto volume e padronizados, onde os modelos funcionam de forma confiável, e extração por IA para documentos variáveis, complexos ou manuscritos, onde os custos de manutenção do modelo superam a alternativa. A lógica de roteamento é simples: se um documento corresponde a um modelo conhecido com alta confiança, processe-o via OCR. Se não corresponder, ou se a confiança cair abaixo de um limite, encaminhe-o para extração por IA. Isso captura a vantagem de custo do OCR tradicional onde ele se aplica, evitando a penalidade de correção de erros onde não se aplica.
Perguntas Frequentes
Posso simplesmente usar ChatGPT ou Claude para extrair dados dos meus documentos?
Para um documento por vez, sim — o GPT-5 atinge 95% de precisão em manuscritos e lida bem com documentos de formato misto. Mas chatbots de uso geral não foram projetados para processamento em lote: enviar 50 faturas e obter uma planilha consolidada com colunas consistentes em todos os documentos. Cada documento é uma conversa separada, os nomes das colunas precisam ser reespecificados a cada vez, e não há um mecanismo integrado para mesclar as saídas em um único arquivo estruturado. Para extrações pontuais, chatbots funcionam. Para processamento recorrente de documentos em volume, ferramentas de extração especializadas lidam com o lote, a consistência do esquema e o fluxo de exportação que os chatbots nunca foram projetados para suportar.
Qual é a diferença real de custo por documento entre OCR tradicional e extração por IA?
O OCR tradicional custa aproximadamente $0,01–$0,05 por página em escala (preços de API de provedores de nuvem). A extração por IA custa aproximadamente $0,05–$0,30 por página. A diferença bruta no custo de software é de aproximadamente 3–10×. Mas o custo total de propriedade — incluindo mão de obra de correção de erros, manutenção de modelos e custos de erros a jusante — normalmente inverte a comparação para qualquer fluxo de trabalho que processe mais de ~200 documentos variados por mês. A comparação entre OCR gratuito e extração por IA paga cobre o detalhamento completo do TCO.
O AI OCR funciona em documentos manuscritos?
Sim, e a diferença aqui é maior do que em texto impresso. Os mecanismos de OCR tradicional alcançam 50–70% de precisão em manuscritos. Os modelos de visão e linguagem alcançam 85–95% nos mesmos documentos usando compreensão contextual — o modelo sabe como uma data deve parecer em um determinado campo e usa esse conhecimento para desambiguar caracteres pouco claros. Para escrita cursiva, a diferença aumenta ainda mais: o OCR tradicional cai abaixo de 50%, enquanto a extração baseada em VLM mantém 75–85%. As limitações são reais — caligrafia cursiva muito bagunçada, scripts não latinos com dados de treinamento limitados e escrita em ângulos extremos ainda desafiam todos os sistemas — mas a vantagem relativa da extração por IA em manuscritos é a maior entre todos os tipos de documento.
Em que volume de documentos a extração por IA se torna economicamente viável?
O ponto de equilíbrio depende mais da variedade de documentos do que do volume bruto. Uma equipe processando 100 documentos por mês de 3 fornecedores com layouts fixos pode nunca atingir o ponto de equilíbrio. Uma equipe processando 200 documentos por mês de 20 fornecedores com layouts variados atinge o ponto de equilíbrio imediatamente — só a manutenção de modelos já consome mais horas de trabalho do que os custos da assinatura de IA. Como regra geral: se você mantém modelos para mais de 10 layouts de documentos diferentes, você já passou do ponto de equilíbrio. Veja o panorama de preços de extração de documentos por IA em 2026 para custos atuais de ferramentas em todos os níveis de volume.
Qual precisão devo esperar da extração por IA em produção?
Uma precisão a nível de campo de 95–97% em documentos empresariais variados é uma expectativa realista em produção, com base nos benchmarks atuais de VLM (modelo de visão e linguagem). Em documentos limpos e padronizados, ela chega a 98–99%. Em documentos muito degradados — faxes, recibos de papel térmico, documentos com carimbos sobrepostos ao texto — espere 85–93%. A distinção crítica está entre precisão de caracteres e precisão de campo: uma ferramenta que relata 99% de precisão de caracteres pode entregar apenas 80% de precisão de campo se os caracteres lidos incorretamente caírem em pontos de dados críticos. Sempre meça a precisão a nível de campo — a porcentagem de campos que caíram na coluna correta com o valor correto. Para um mergulho mais profundo no que os números de precisão significam em escala de processamento, veja o guia prático sobre precisão da extração por IA.
O OCR tradicional ainda tem futuro?
Sim, em três papéis. Primeiro, como camada de reconhecimento de texto dentro de pipelines de extração por IA — muitos sistemas baseados em VLM ainda usam OCR como etapa de pré-processamento para documentos com muito texto. Segundo, para processamento de documentos padronizados em alto volume, onde os custos de modelo se amortizam de forma eficiente. Terceiro, para projetos de digitalização de arquivos em que o objetivo é a busca em texto completo, e não a extração de dados estruturados. O OCR tradicional não está obsoleto — seu papel está se reduzindo aos casos de uso específicos em que suas premissas arquiteturais (layouts fixos, texto limpo, saída a nível de caractere) correspondem às características reais do documento.
Por Onde Começar
A lacuna entre OCR tradicional e extração por IA não está diminuindo. Os modelos de visão e linguagem continuam melhorando em documentos complexos — a precisão de 95% em escrita manual do GPT-5 em 2026, ante 85% do GPT-4 em 2025 — enquanto os mecanismos de OCR tradicional vêm refinando a mesma abordagem de correspondência de caracteres há décadas. A lacuna de precisão agora é uma lacuna de custo, e ela aparece em cada fila de revisão manual, em cada reconstrução de modelo, em cada problema de conciliação rastreado até dados silenciosamente direcionados de forma errada.
Há uma maneira simples de ver em qual lado do ponto de cruzamento seus documentos se encontram. Envie uma fatura — de preferência uma que tenha causado problemas ao seu processo atual — para uma ferramenta de extração por IA sem modelo. Digite os nomes dos campos necessários e observe onde os valores caem. Para saber mais sobre como a extração por IA difere do OCR no nível de dados, e não no nível de caracteres, o explicativo sobre entrada de dados por IA versus OCR mostra a diferença na saída com exemplos reais. O custo de fazer este teste é de alguns minutos. O custo de não saber onde sua precisão realmente está se acumula a cada mês.