O que a precisão do OCR
realmente significa? CER vs precisão no nível de campo explicado
Quando um fornecedor de OCR diz "99% de precisão", quase sempre está falando de precisão no nível de caractere em texto limpo, impresso e em inglês — não se o total da sua fatura sairá correto. Essa única estatística aparece rotineiramente em tabelas de comparação de produtos, estudos de caso e páginas de marketing, apresentada como se respondesse à única pergunta que um comprador precisa ver respondida. Não responde. A diferença entre "99% de precisão de caractere" e "dados utilizáveis" é grande o suficiente para que duas ferramentas aleguem 99% e entreguem resultados completamente diferentes no mesmo documento. Entender essa diferença — o que cada métrica de precisão realmente mede, onde ela falha e o que significa para seus documentos específicos — é a diferença entre comprar uma solução e comprar um problema.
Principais conclusões
- A alegação de "99% de precisão" que você vê em toda ferramenta de OCR trata um total de fatura errado da mesma forma que uma nota de rodapé borrada — basta que dois de duzentos caracteres falhem para um pagamento dar errado.
- Esses dois caracteres errados podem inserir silenciosamente o valor em dólar incorreto no seu sistema contábil sem nenhum sinalizador de erro, porque os mecanismos de OCR não sabem quais caracteres custam dinheiro a você.
- A precisão no nível de campo é a única métrica que prevê se seu pipeline de documentos funcionará — e cinco perguntas simples separam os fornecedores que fizeram testes reais daqueles que se escondem atrás de um número de CER.
O que o CER (taxa de erro de caracteres) realmente mede
A taxa de erro de caracteres — ou CER — é a métrica de precisão de OCR mais fundamental. Ela mede quantos caracteres individuais o mecanismo erra: cada substituição (um "O" lido como "0"), cada inserção (um caractere extra adicionado) e cada exclusão (um caractere perdido). A fórmula é simples: a soma dos erros dividida pelo número total de caracteres no texto de referência.
Em um documento impresso padrão — pense em um PDF limpo com uma fonte como Arial ou Times New Roman a 300 DPI — os mecanismos de OCR modernos alcançam consistentemente um CER abaixo de 1%, ou seja, 99% ou mais de precisão de caracteres. Esse é o número que sustenta a alegação de "99% de precisão" que você vê em todo lugar, e é legítimo dentro dessas condições. Benchmarks independentes confirmam isso: o Microsoft Azure Document Intelligence, por exemplo, obteve 96% em texto impresso no AIMultiple OCR Benchmark, com vários modelos ultrapassando o limite de 99% em material impresso limpo. Pesquisas acadêmicas sobre programas de digitalização com OCR há muito estabelecem um CER de 1–2% como referência para um OCR "bom" em texto impresso.
Mas eis o que o número de destaque não diz: o CER mede caracteres individuais. Ele trata cada caractere como igualmente importante. Uma vírgula mal lida em um rodapé recebe o mesmo peso que um dígito mal lido no total de uma fatura. Essa ponderação uniforme é a origem da maior parte da confusão em torno das alegações de precisão. Um sistema pode perder 15 caracteres em uma página de 1.000 caracteres e ainda reportar 98,5% de CER — mas se esses 15 caracteres estiverem concentrados em campos críticos, o resultado é inutilizável para qualquer processo de negócio.
O que o WER (taxa de erro de palavras) captura de forma diferente
O WER (taxa de erro de palavras) sobe um nível: em vez de contar erros individuais de caracteres, ele rastreia quantas palavras inteiras contêm pelo menos um erro. Uma palavra só está correta se cada caractere dela for reconhecido perfeitamente. Isso torna o WER menos granular que o CER, mas mais intuitivo para documentos comerciais, onde um único caractere errado em "12,456.78" torna o valor inteiro não confiável.
Os benchmarks do setor colocam o WER abaixo de 2% para documentos impressos padrão. A métrica importa mais quando o texto extraído alimenta sistemas downstream que operam no nível da palavra — indexação de busca, pipelines de linguagem natural ou correspondência em banco de dados. Se "Pacific Maritime Supplies" for lido como "Pacific Maritimo Supplies", a penalidade de WER é de 33%, mesmo que o impacto no CER seja de apenas dois caracteres entre 26.
O WER é uma ponte entre o reconhecimento bruto de caracteres e a precisão útil para os negócios — mas ainda não informa se um campo específico saiu correto.
Precisão no nível de campo — a métrica que realmente importa para os negócios
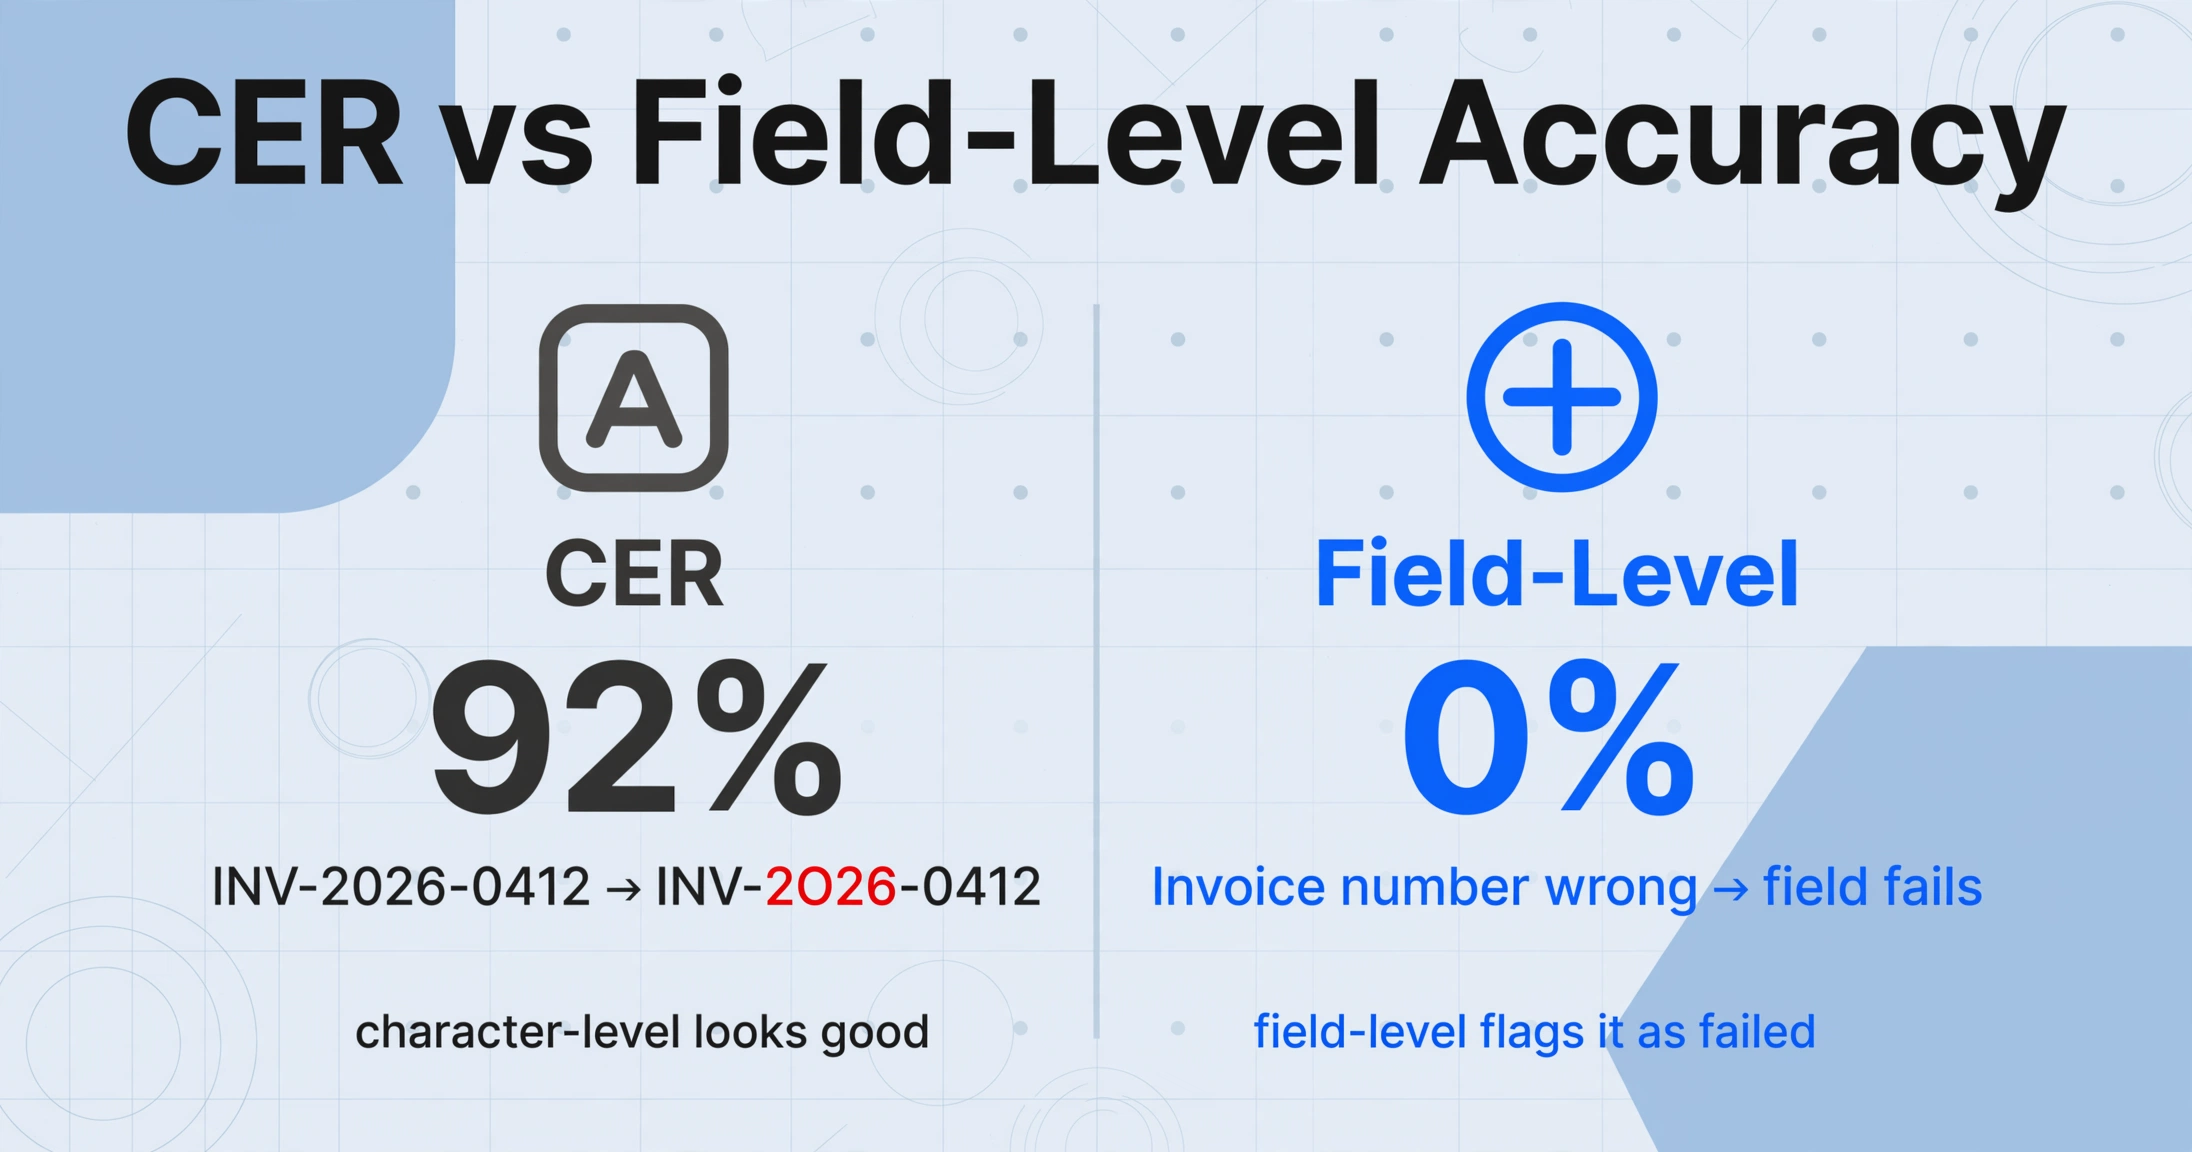
A precisão no nível de campo mede algo fundamentalmente diferente do CER ou do WER: ela pergunta se cada ponto de dado extraído — o número da fatura, o valor total, a data de vencimento — está completamente correto. Um campo está certo ou errado. Não existe crédito parcial. Um número de fatura "INV-2026-0412" lido como "INV-2O26-0412" (letra O maiúscula em vez de zero) pontua 92% no nível de caractere, mas 0% no nível de campo. Para qualquer processo downstream — conciliar um pagamento, reconciliar um total — esse zero é o único número que importa.
Essa é a métrica que determina se o seu pipeline de documentos pode operar sem revisão humana — conhecido como STP (processamento direto). A análise do setor sugere que 99,9% de precisão no nível de campo é o limite prático para viabilizar o STP. Abaixo disso, cada ponto percentual de queda se traduz diretamente em mais tempo de revisão manual, mais falhas de conciliação e mais disputas com fornecedores.
A lacuna entre o CER e a precisão no nível de campo é onde as ferramentas de OCR tradicional ficam aquém e onde a extração baseada em IA se diferencia. Um mecanismo de OCR convencional processa cada caractere da página com a mesma lógica — ele não sabe que "$12,456.78" é o total da fatura e, portanto, merece atenção especial. Um modelo de extração com IA lê o documento semanticamente: identifica o total da fatura como um campo distinto e o valida no contexto. É por isso que a lacuna de precisão entre o OCR com IA e o OCR tradicional é maior no nível de campo — onde o impacto nos negócios é mais alto.
Por que 99% de CER ainda pode significar dados errados: um exemplo concreto
A melhor forma de entender por que a precisão no nível de campo é a única métrica que importa para os negócios é analisar um cenário real.
Considere uma fatura de uma página com 200 caracteres no total — nome e endereço do fornecedor, número da fatura, alguns itens de linha com quantidades e preços, uma linha de subtotal, uma linha de imposto e um total final. O motor de OCR reporta 99% de CER, ou seja, leu 198 de 200 caracteres corretamente.
Dois caracteres estão errados. Isso parece um resultado quase perfeito.
Mas aqui está a pergunta que o CER não responde: quais dois caracteres?
| Cenário | Onde os 2 erros ocorrem | Precisão no nível de campo | Resultado para o negócio |
|---|---|---|---|
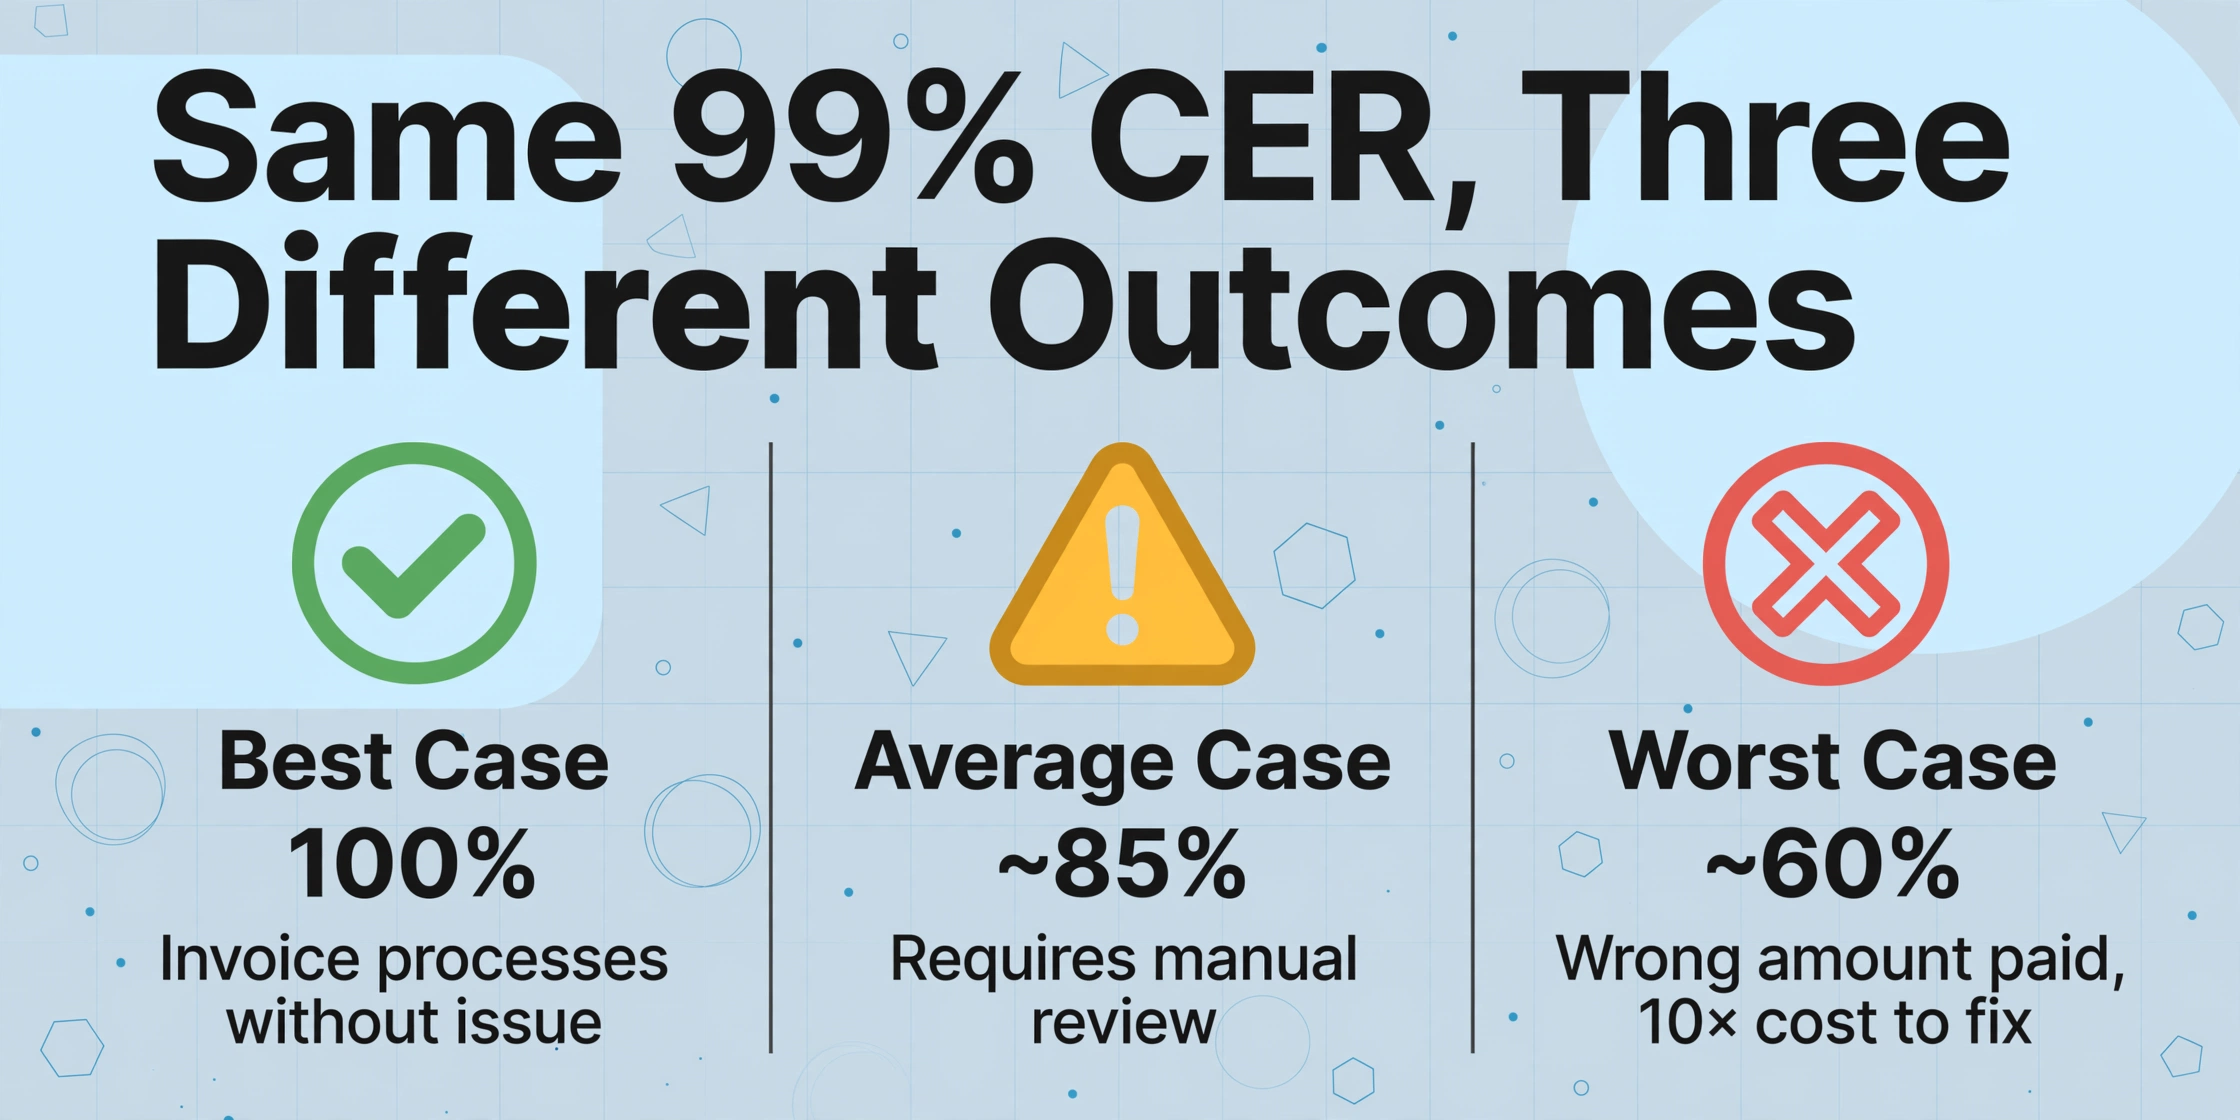
| Melhor caso | Texto do rodapé, número da página | 100% | Todos os campos críticos corretos. A fatura é processada sem problemas. |
| Caso médio | Um dígito no preço do item de linha, um caractere no nome da rua do fornecedor | ~85% | O total do item de linha está errado. Exige revisão manual antes do pagamento. |
| Pior caso | Dois dígitos no total da fatura ($12,456.78 → $12,496.78) | ~60% | Valor pago incorreto. Descoberto na conciliação, com custo 10× maior para corrigir. |
O mesmo CER de 99% produz três resultados de negócio completamente diferentes, dependendo de onde os erros ocorrem. Este não é um caso teórico extremo — é a realidade cotidiana de confiar na precisão no nível de caractere como medida da qualidade da extração. No pior caso, uma ferramenta "99% precisa" por caractere insere silenciosamente um valor em dólar errado no seu sistema contábil, e nenhum alerta de erro é disparado porque o motor de OCR não sabe — não pode saber — que cometeu um erro em um campo crítico.
Como Diferentes Números de Precisão Aparecem na Prática
A precisão varia drasticamente dependendo do tipo de documento e da qualidade da entrada, e os intervalos são amplos o suficiente para tornar afirmações de número único quase sem sentido. Com base em benchmarks independentes e dados do setor, veja como as métricas de precisão mudam nas condições comuns de documentos para sistemas de extração com IA (que superam consistentemente o OCR tradicional em entradas não ideais):
| Condição do documento | Faixa típica de CER | Precisão típica no nível de campo | Por que a precisão cai |
|---|---|---|---|
| PDF digital limpo (texto impresso) | <1% | 98–99% | Degradação mínima — fontes uniformes, alto contraste, sem ruído |
| Digitalização de alta qualidade a 300 DPI | 1–3% | 95–98% | Leves artefatos de binarização, pequena inclinação, variação mínima de fonte |
| Faturas de vários fornecedores (layouts variados) | 2–5% | 85–95% | Variabilidade de formato — o OCR tradicional falha primeiro; a extração com IA resiste melhor |
| Foto de celular em iluminação normal | 5–15% | 70–90% | Distorção de perspectiva, desfoque de movimento, iluminação não uniforme |
| Texto manuscrito (letra de forma em formulários estruturados) | 5–20% | 85–93% | Variação na morfologia dos caracteres — não existem dois escritores que produzam o mesmo "a" ou "7" |
| Cópia carbono desbotada / recibo em papel térmico | 10–25% | 50–75% | Baixo contraste, interferência de fundo, desbotamento do corante com o tempo |
Esses intervalos vêm de várias fontes independentes. O AIMultiple OCR Benchmark constata que os modelos de visão com melhor desempenho alcançam 93–96% em manuscritos, mas caem para 85% em mídia impressa complexa. A análise da LlamaIndex mostra o OCR de código aberto (Tesseract, PaddleOCR) em 88–94%, APIs empresariais (Google, Azure, AWS) em 96–98%, e o processamento de documentos com IA ultrapassando 99% em documentos complexos com ciclos de validação.
O padrão crucial: a diferença entre CER e a precisão no nível de campo aumenta conforme a qualidade do documento se degrada. Em um PDF limpo, as duas métricas quase convergem. Em uma foto de celular de um recibo desbotado, a precisão no nível de campo pode ficar 15–20 pontos abaixo do CER. Uma entrada ruim não distribui seus erros de forma uniforme — ela os concentra em regiões que carregam dados críticos (totais, datas, nomes de fornecedores).
Como Ler uma Alegação de Precisão de Fornecedor: O Framework de 5 Perguntas
Todo fornecedor de OCR e extração de documentos publica números de precisão. As cinco perguntas a seguir separam alegações de marketing de informação significativa. Se um fornecedor não puder ou não quiser respondê-las de forma transparente, presuma que a faixa de precisão do pior caso se aplica aos seus documentos.
Qual métrica você está reportando?
Se a resposta for "precisão de caracteres" ou "CER", insista no número no nível de campo. Se eles não acompanham a precisão no nível de campo, não testaram no caso de uso que importa para o seu negócio. Fornecedores que reportam precisão no nível de campo o fazem com destaque — os que se escondem atrás do CER geralmente têm algo a esconder.
Qual tipo de documento foi testado?
99% em texto impresso limpo em A4 é um produto diferente de 99% em faturas de vários fornecedores ou formulários manuscritos. Peça as categorias exatas de documentos e os tamanhos das amostras. Um conjunto de teste de 500 documentos quase idênticos não diz nada sobre o desempenho no mundo real.
Qual foi a qualidade da entrada?
Todos os documentos foram digitalizados a 300 DPI? Fotos de celular ou faxes foram incluídos? Uma ferramenta testada apenas em digitalizações perfeitas não terá o mesmo desempenho nos documentos que seus funcionários realmente produzem.
Quantas variações de documentos foram testadas?
100 faturas de 100 fornecedores diferentes é exponencialmente mais difícil do que 100 de um único fornecedor. A precisão em documentos homogêneos não é preditiva da precisão em fluxos de documentos mistos que a maioria das empresas realmente processa.
Qual foi a sua tolerância a erros?
Foi dado crédito parcial para campos que estavam "suficientemente próximos"? Ou foi correspondência exata estrita? A diferença pode inflar a precisão reportada em 5–10 pontos, mudando completamente como a ferramenta parece no papel versus como ela se comporta na prática.
Perguntas Frequentes
Uma precisão de OCR de 99% é boa?
Depende inteiramente do que está sendo medido. Uma precisão de 99% no nível de caractere em texto impresso limpo é o padrão atual do setor e geralmente é considerada boa para esse contexto restrito. Mas uma precisão de 99% no nível de campo — em que cada dado crítico (número da fatura, total, data) é extraído perfeitamente — é significativamente mais difícil de alcançar, especialmente em documentos de formatos mistos. Para fluxos de trabalho empresariais, a precisão no nível de campo é o número que importa, e a diferença entre as duas pode ser de 10 a 20 pontos percentuais em documentos do mundo real.
O que é um bom CER para OCR?
Os benchmarks do setor, baseados em décadas de pesquisa e prática em OCR, classificam o CER da seguinte forma: uma boa precisão de OCR é um CER de 1–2% (98–99% de precisão), a média é de 2–10% e a ruim é acima de 10%. Para texto impresso em documentos limpos, os mecanismos modernos alcançam consistentemente um CER abaixo de 1%. Para escrita à mão, um CER de até 20% ainda pode ser considerado aceitável, dependendo do estilo de escrita e da estrutura do documento — por isso a precisão no nível de caractere, sozinha, diz muito pouco sobre se uma ferramenta funcionará para o seu caso de uso específico.
Por que a precisão do OCR cai em documentos digitalizados?
A digitalização introduz artefatos que degradam o reconhecimento: erros de limiar de binarização (em que o mecanismo erra ao decidir se um pixel é texto ou fundo), inclinação por alimentação imperfeita e artefatos de compressão do pipeline de processamento de imagem do scanner. À medida que o DPI cai abaixo de 200, as bordas dos caracteres tornam-se cada vez mais ambíguas — um "c" e um "e" começam a parecer idênticos, e traços finos como a barra transversal de um "t" desaparecem por completo. Esses não são problemas do mecanismo de OCR; são problemas de qualidade da entrada que nenhuma melhoria algorítmica consegue compensar totalmente.
Qual é a diferença entre precisão de OCR e precisão de extração?
A precisão de OCR mede quão bem o mecanismo converte pixels de imagem em caracteres de texto. A precisão de extração mede se o sistema identifica, extrai e estrutura corretamente os dados certos de um documento. Uma ferramenta pode ter precisão de OCR perfeita — lendo cada caractere corretamente — e ainda falhar na extração se rotular incorretamente o total da fatura como subtotal, ou não conseguir associar um item de linha ao seu preço. Essa distinção é a diferença central entre OCR tradicional e extração de documentos com IA, e é por isso que avaliar uma ferramenta pela precisão de extração, e não pela precisão de OCR, é essencial para qualquer processo de negócio que dependa de dados estruturados.
A extração com IA pode alcançar 100% de precisão?
Nenhuma ferramenta pode alegar com responsabilidade 100% de precisão em documentos do mundo real. Mesmo os melhores modelos de visão e linguagem ocasionalmente leem incorretamente caracteres ambíguos, encontram layouts fora de sua distribuição de treinamento ou têm dificuldade com entradas severamente degradadas. A meta realista para sistemas de extração com IA é precisão no nível de campo de 99%+ em tipos de documentos bem definidos com entradas de qualidade, combinada com pontuação de confiança e roteamento de exceções — sinalizando a fração de documentos em que o modelo está incerto e enviando-os para revisão humana. Essa abordagem híbrida (extração automatizada + humano no circuito para exceções) é a melhor prática do setor para alcançar um processamento de documentos genuinamente confiável em escala.