OCR精度の実際の意味とは?
文字誤り率とフィールドレベル精度の違いを解説
OCRベンダーが「精度99%」と言うとき、それはほとんどの場合、きれいに印刷された英語テキストに対する文字レベル精度のことを指しており、請求書の合計金額が正しく出力されるかどうかを指しているわけではありません。その1つの数値は、製品比較表、ケーススタディ、マーケティングページに頻繁に登場し、あたかも購入者が唯一答えを得たい問いに答えているかのように提示されます。しかし、実際には答えていません。「文字精度99%」と「使えるデータ」の間には大きな隔たりがあり、同じ文書に対して2つのツールがどちらも99%を謳いながら、まったく異なる結果を出すこともあり得ます。この隔たりを理解すること——各精度指標が実際に何を測定しているのか、どこで機能しなくなるのか、そしてあなたの具体的な文書にとって何を意味するのか——こそが、解決策を買うことと問題を買うことの違いなのです。
重要なポイント
- どのOCRツールでも見かける「精度99%」という主張は、請求書の合計金額の誤りを、かすれた脚注と同じように扱います。200文字のうち2文字が誤るだけで、支払い処理が間違うことがあるのです。
- その2文字の誤りは、エラーフラグを一切立てずに、誤った金額を会計システムへ静かに送り込みます。OCRエンジンは、どの文字が金額に影響するのかを知らないからです。
- 文書パイプラインが機能するかどうかを予測できる唯一の指標は、フィールドレベル精度です。そして、実際のテストを行ってきたベンダーと、文字誤り率の数字の背後に隠れるベンダーを見分けるのは、5つの簡単な質問です。
CER(文字誤り率)が実際に測定するもの
文字誤り率(CER)は、最も基本的なOCR精度の指標です。エンジンが誤る個々の文字数を測定します。置換(「O」が「0」と読まれる)、挿入(余分な文字が追加される)、削除(文字が欠落する)のすべてが含まれます。計算式は単純で、誤りの合計を正解テキストの総文字数で割ったものです。
標準的な印刷文書(ArialやTimes New Romanなどのフォントを使用したクリーンなPDFを300 DPIで考えてください)では、最新のOCRエンジンは一貫して1%未満のCERを達成しており、99%以上の文字精度を意味します。これは、あちこちで見かける「99%の精度」という主張の根拠となる数字であり、その条件下では正当です。独立したベンチマークもこれを裏付けています。例えば、Microsoft Azure Document Intelligenceは、AIMultiple OCRベンチマークで印刷テキストに対して96%を記録し、クリーンな印刷物では複数のモデルが99%の閾値を超えています。OCRデジタル化プログラムに関する学術研究では、印刷テキストに対する「良好な」OCRの基準として、長らくCER 1〜2%が確立されています。
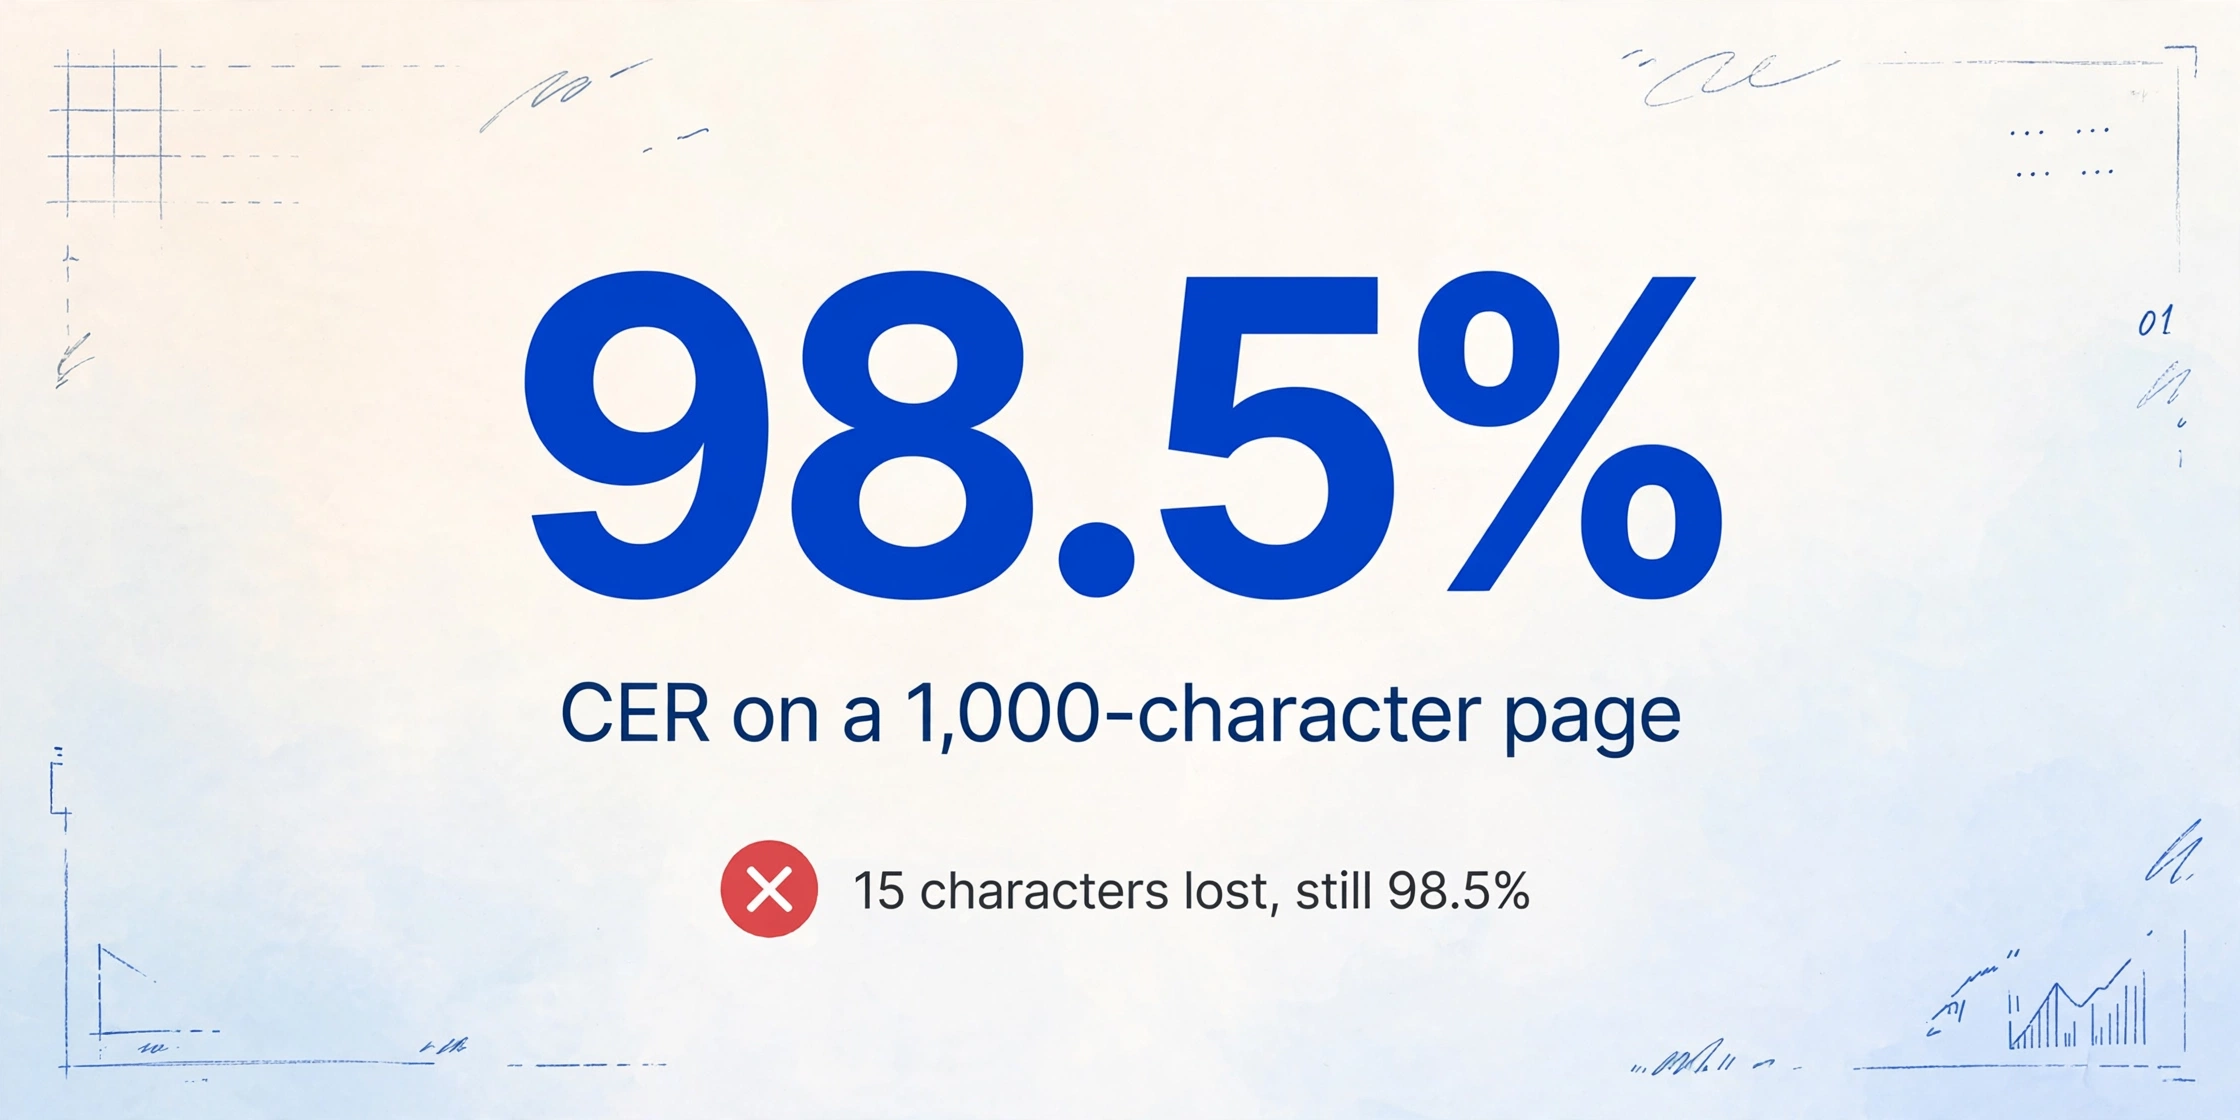
しかし、この見出しの数字が教えてくれないことがあります。CERは単一の文字を測定します。すべての文字を同等に重要視します。フッターの誤読されたカンマは、請求書の合計金額の誤読された数字と同じ重みを持ちます。このフラットな重み付けが、精度に関する主張の混乱の主な原因です。システムが1,000文字のページで15文字を失っても、98.5%のCERを報告できます。しかし、その15文字が重要なフィールドに集中している場合、その出力はビジネスプロセスには使用できません。
WER(単語誤り率)が捉える違い
単語誤り率は一段階上の指標です。個々の文字の誤りを数える代わりに、少なくとも1つの誤りを含む単語全体の数を追跡します。単語が正しいとみなされるのは、その中のすべての文字が完璧に認識された場合のみです。これにより、WERはCERよりも粒度は粗いものの、「12,456.78」の中の1文字の誤りが値全体を信頼できないものにするビジネス文書にとっては、より直感的です。
業界ベンチマークでは、標準的な印刷文書のWERは2%未満とされています。この指標が最も重要になるのは、抽出されたテキストが検索インデックス、自然言語パイプライン、データベース照合など、単語レベルで動作する下流システムに渡される場合です。「Pacific Maritime Supplies」が「Pacific Maritimo Supplies」と読み取られた場合、CERへの影響は26文字中の2文字だけでも、WERのペナルティは33%になります。
WERは、生の文字認識とビジネス上有用な精度の間の橋渡しですが、それでも特定のフィールドが正しく抽出されたかどうかは教えてくれません。
フィールドレベル精度 — ビジネスにとって実際に重要な指標
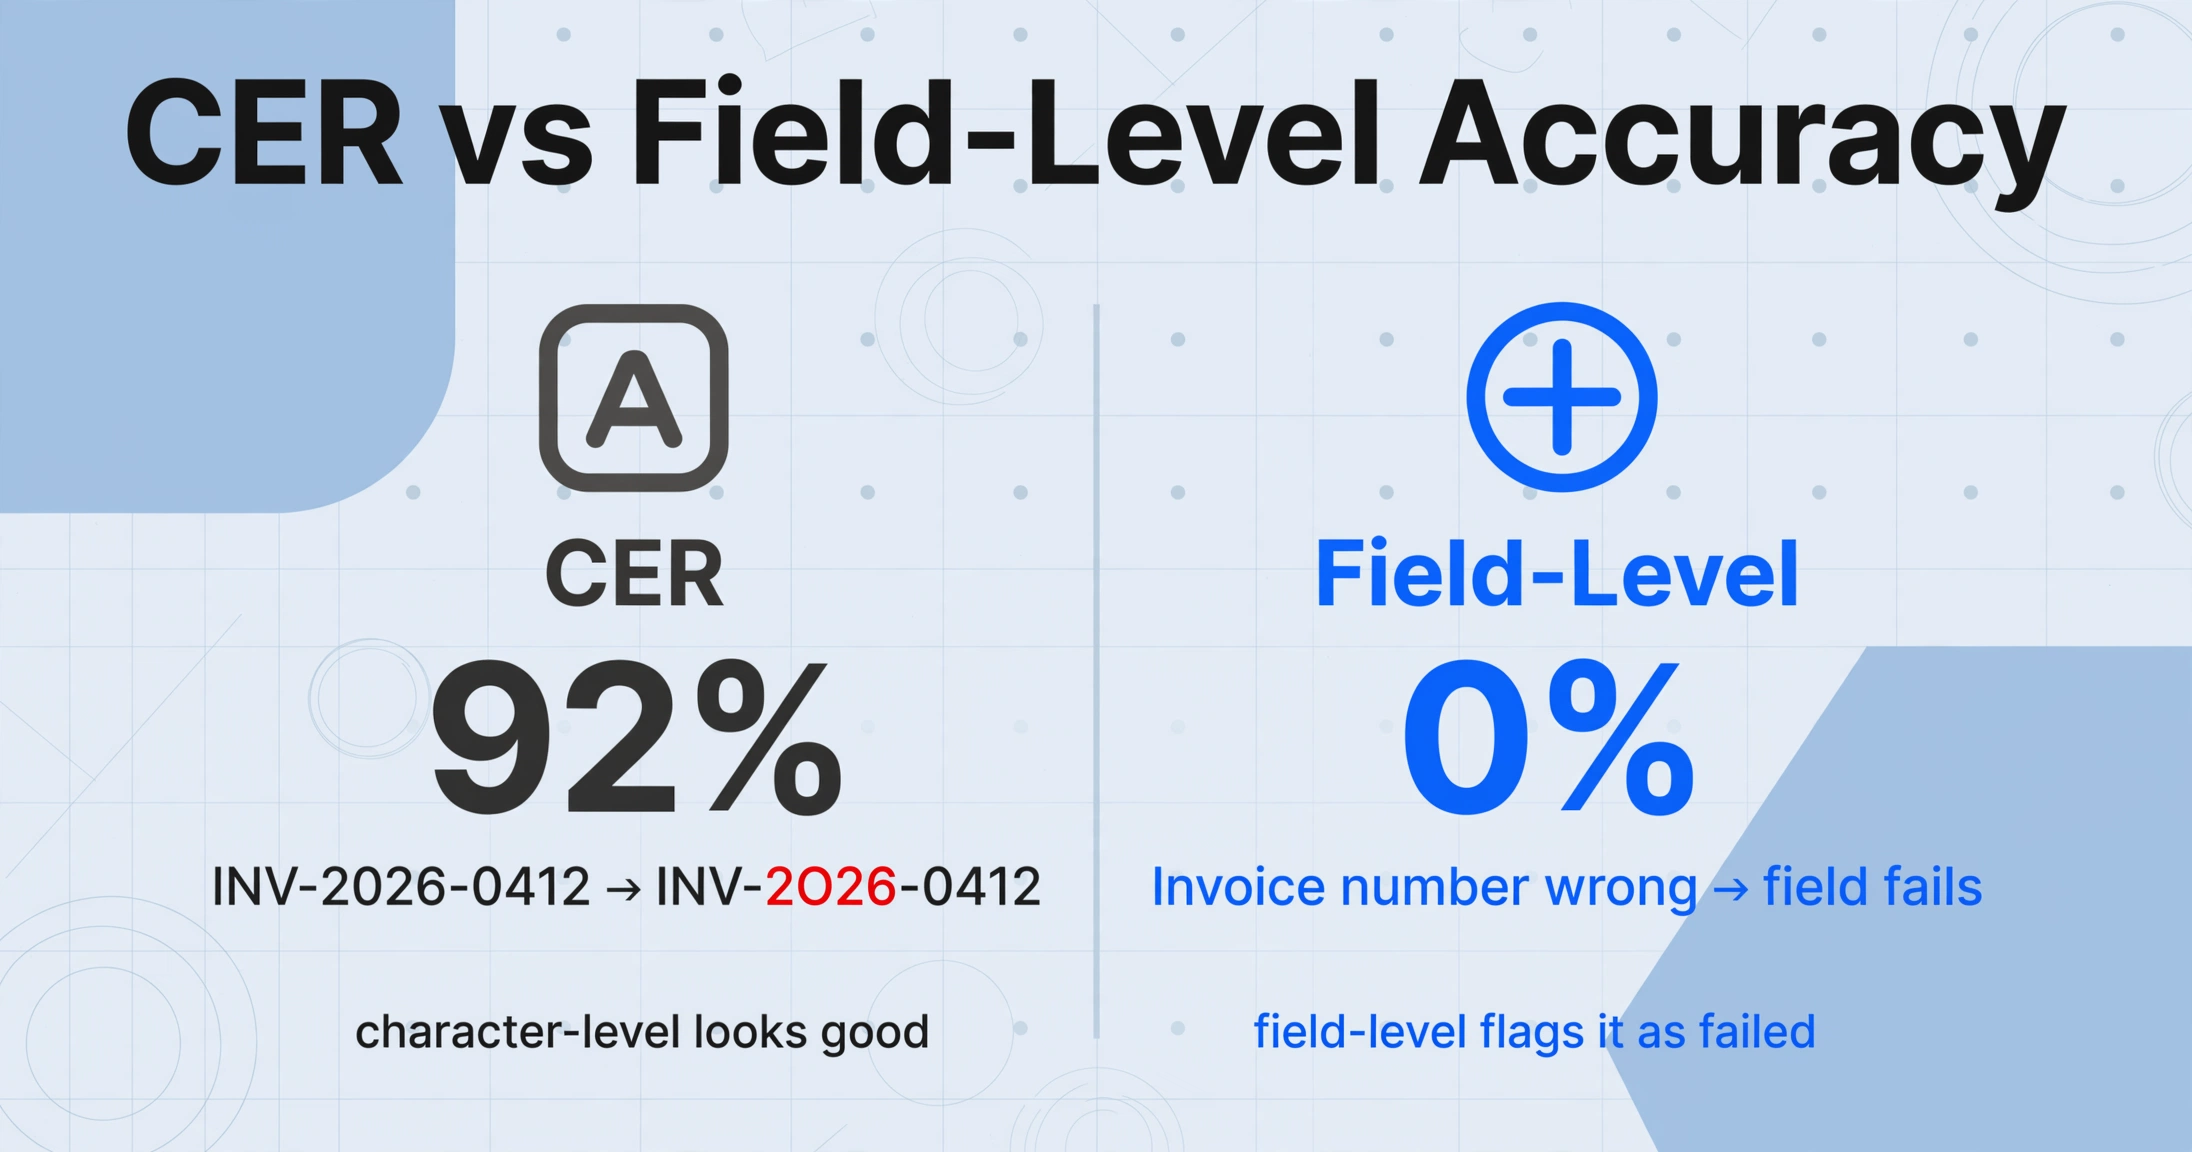
フィールドレベル精度は、CERやWERとは根本的に異なるものを測定します。抽出された各データポイント(請求書番号、合計金額、支払期日)が完全に正しいかどうかを問うものです。フィールドは正しいか間違っているかのどちらかであり、部分点は存在しません。請求書番号「INV-2026-0412」が「INV-2O26-0412」(ゼロの代わりに大文字のO)と読み取られた場合、文字レベルでは92%でも、フィールドレベルでは0%です。支払い照合や合計の突き合わせなど、あらゆる下流プロセスにとって、この0%こそが唯一重要となる数字です。
この指標こそが、ドキュメントパイプラインが人手によるレビューなしで稼働できるかどうか、すなわちSTP(ストレートスルー処理)を決定づけます。業界分析によると、99.9%のフィールドレベル精度がSTPを可能にする実用的な閾値です。それを下回ると、1パーセントポイントの低下がそのまま手作業によるレビュー時間の増加、照合エラーの増加、ベンダーとの紛争の増加につながります。
CERとフィールドレベル精度のギャップこそ、従来のOCRツールが及ばず、AIベースの抽出が差別化を図る領域です。従来のOCRエンジンは、ページ上のすべての文字を同じロジックで処理するため、「$12,456.78」が請求書の合計金額であり、特別な注意が必要であることを認識しません。一方、AI抽出モデルは文書を意味的に読み取ります。請求書の合計金額を明確なフィールドとして識別し、文脈の中で検証します。これが、AI OCRと従来のOCRの精度ギャップが、ビジネスへの影響が最も大きいフィールドレベルで最大になる理由です。
文字誤り率99%でもデータが間違っている理由:具体例
フィールドレベル精度がビジネスにとって唯一重要な指標である理由を理解するには、実際のシナリオを検討するのが最善の方法です。
合計200文字の1ページの請求書を考えてみましょう。ベンダー名と住所、請求書番号、数量と価格を含むいくつかの明細項目、小計行、税行、最終合計があります。OCRエンジンは文字誤り率99%を報告しており、つまり200文字中198文字を正しく読み取ったことになります。
2文字が間違っています。ほぼ完璧な結果のように聞こえます。
しかし、文字誤り率が答えない質問があります:どの2文字でしょうか?
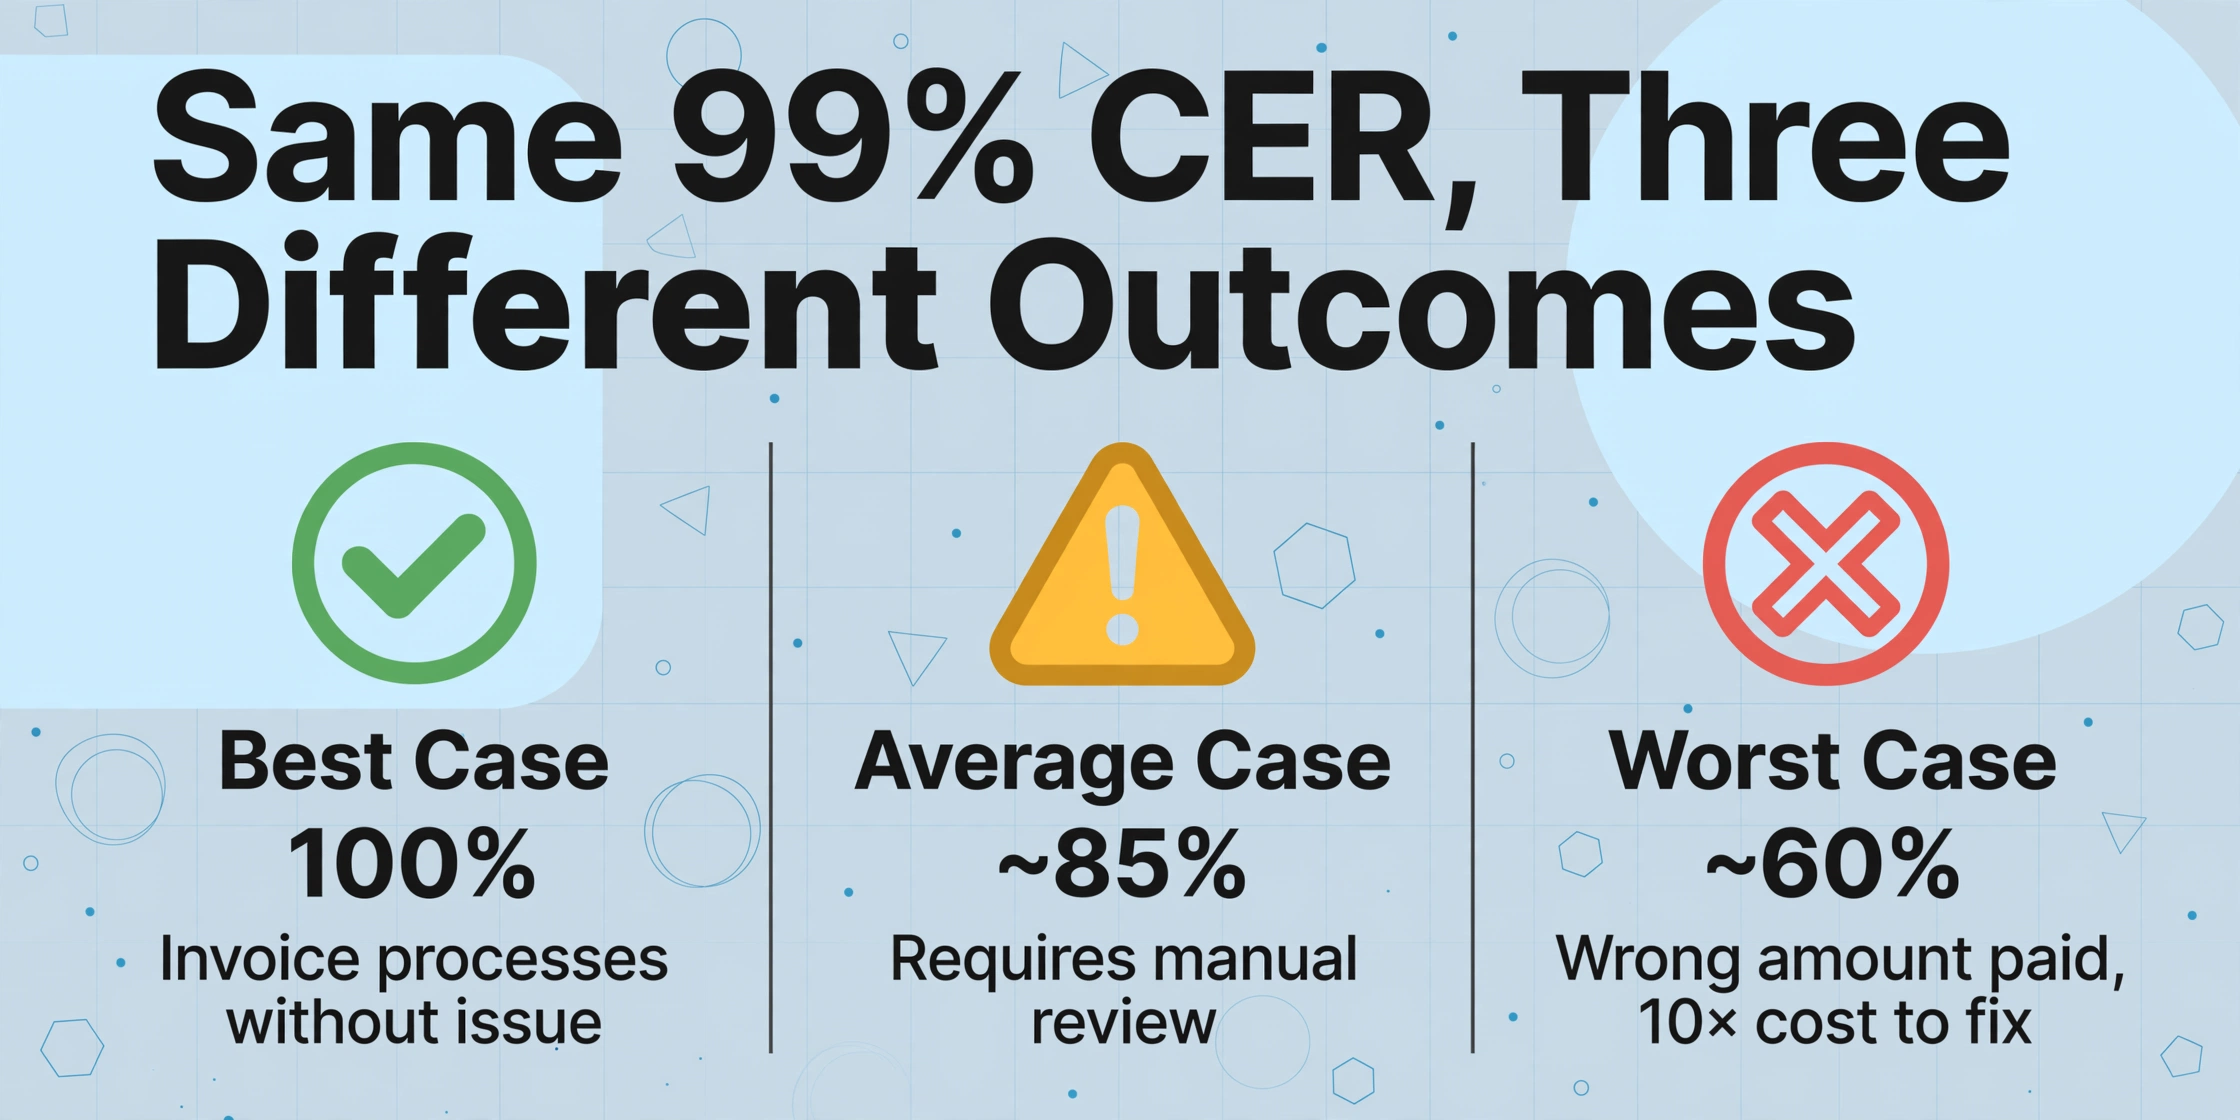
| シナリオ | 2つのエラーの発生箇所 | フィールドレベル精度 | ビジネスへの影響 |
|---|---|---|---|
| 最良のケース | フッターテキスト、ページ番号 | 100% | すべての重要フィールドが正確。請求書は問題なく処理される。 |
| 平均的なケース | 明細項目の価格の1桁、ベンダーの番地の1文字 | 約85% | 明細項目の合計がずれる。支払い前に手動レビューが必要。 |
| 最悪のケース | 請求書合計の2桁($12,456.78 → $12,496.78) | 約60% | 誤った金額が支払われる。照合時に発覚し、修正コストは10倍。 |
同じ文字誤り率99%でも、エラーがどこに発生するかによって、ビジネスへの影響は3つのまったく異なる結果を生み出します。これは理論上の極端なケースではなく、抽出品質の尺度として文字レベル精度に依存することの日常的な現実です。最悪のケースでは、「文字単位で99%正確」なツールが、誤った金額を黙って会計システムに送り込みます。OCRエンジンは重要なフィールドで間違いを犯したことを知らない(知ることはできない)ため、エラーフラグは発動しません。
実際の精度数値の違いとは
精度は文書の種類や入力品質によって大きく異なり、その範囲は広いため、単一の数値で示すことはほぼ意味がありません。独立したベンチマークや業界データに基づくと、AIベースの抽出システム(非理想的な入力において従来のOCRを一貫して上回る性能を発揮)では、一般的な文書条件によって精度指標は次のように変化します:
| 文書の状態 | 一般的なCER範囲 | 一般的なフィールドレベル精度 | 精度が低下する理由 |
|---|---|---|---|
| クリーンなデジタルPDF(印刷テキスト) | <1% | 98–99% | 劣化が最小限 — 均一なフォント、高コントラスト、ノイズなし |
| 高品質300 DPIスキャン | 1–3% | 95–98% | 軽度の2値化アーティファクト、わずかな傾き、軽微なフォントのばらつき |
| 複数ベンダーの請求書(多様なレイアウト) | 2–5% | 85–95% | フォーマットのばらつき — 従来のOCRは最初に失敗し、AI抽出はより耐性がある |
| 通常の照明下でのスマホ撮影 | 5–15% | 70–90% | 透視歪み、モーションブラー、不均一な照明 |
| 手書きテキスト(構造化フォーム内のブロック体) | 5–20% | 85–93% | 文字の形態的ばらつき — 同じ「a」や「7」を書く人はいない |
| 色あせたカーボンコピー/感熱紙レシート | 10–25% | 50–75% | 低コントラスト、背景干渉、経年による染料の退色 |
これらの範囲は複数の独立した情報源に基づいています。AIMultiple OCRベンチマークでは、最高性能のビジョンモデルが手書きで93–96%を達成する一方、複雑な印刷メディアでは85%に低下することが示されています。LlamaIndexの分析では、オープンソースのOCR(Tesseract、PaddleOCR)は88–94%、エンタープライズAPI(Google、Azure、AWS)は96–98%、AI搭載の文書処理は検証ループにより複雑な文書で99%を超えることが示されています。
重要なパターン:文書品質が低下するにつれて、CERとフィールドレベル精度の差は広がる。クリーンなPDFでは、この2つの指標はほぼ一致する。色あせたレシートのスマホ写真では、フィールドレベル精度はCERより15〜20ポイント低くなることがある。質の悪い入力はエラーを均等に分散させず、重要なデータ(合計、日付、仕入先名)を含む領域に集中させる。
ベンダーの精度主張の読み方:5つの質問フレームワーク
すべてのOCRおよび文書抽出ベンダーは精度数値を公表している。以下の5つの質問は、マーケティング上の主張と意味のある情報を区別する。ベンダーがこれらに透明に答えられない、または答えようとしない場合、最悪の精度範囲が自社の文書に適用されると想定すべきだ。
報告している指標は何か?
答えが「文字精度」または「CER」の場合は、フィールドレベル精度を求めること。フィールドレベル精度を追跡していない場合、ビジネスにとって重要なユースケースでテストしていないことになる。フィールドレベル精度を報告するベンダーはそれを目立つように示す。CERの背後に隠れるベンダーは、通常何かを隠している。
テストされた文書タイプは何か?
クリーンなA4印刷テキストでの99%は、複数ベンダーの請求書や手書きフォームでの99%とは異なる製品だ。正確な文書カテゴリとサンプルサイズを尋ねること。500件のほぼ同一の文書からなるテストセットは、実際のパフォーマンスについて何も教えてくれない。
入力品質はどうだったか?
すべての文書が300 DPIでスキャンされたか?スマホ写真やFAXは含まれていたか?完璧なスキャンでのみテストされたツールは、従業員が実際に作成する文書では同じパフォーマンスを発揮しない。
テストされた文書バリエーションはいくつか?
100社のベンダーからの100件の請求書は、1社からの100件よりも指数関数的に難しい。均質な文書での精度は、ほとんどの企業が実際に処理する混合文書ストリームでの精度を予測しない。
エラー許容度はどうだったか?
「ほぼ正しい」フィールドに部分点が与えられたか?それとも厳密な完全一致だったか?その差により、報告される精度が5〜10ポイント膨らみ、ツールが紙面上でどう見えるかと実際のパフォーマンスが完全に変わってしまう。
よくある質問
OCR精度99%は良いのでしょうか?
何を測定しているかによって完全に異なります。きれいな印刷テキストに対する99%の文字レベル精度は、現在の業界標準であり、その限定的な文脈では一般的に良いとされています。しかし、99%のフィールドレベル精度(請求書番号、合計金額、日付など、すべての重要なデータポイントが完璧に抽出されること)は、特に混在フォーマットの文書では達成がはるかに困難です。ビジネスワークフローにとって重要なのはフィールドレベル精度であり、実際の文書では両者の差は10〜20ポイントにもなり得ます。
OCRの良いCER(文字誤り率)とは?
数十年にわたるOCR研究と実践から得られた業界ベンチマークでは、CERは次のように分類されます:優れたOCR精度はCER 1〜2%(精度98〜99%)、平均は2〜10%、不良は10%超です。きれいな文書の印刷テキストでは、最新のエンジンは一貫してCER 1%未満を達成します。手書きの場合、筆跡や文書構造によってはCER 20%でも許容できると見なされることがあります。そのため、文字レベル精度だけでは、特定のユースケースでツールが機能するかどうかはほとんどわかりません。
スキャン文書でOCR精度が低下するのはなぜですか?
スキャンにより、認識を低下させるアーティファクトが発生します:二値化しきい値エラー(ピクセルがテキストか背景かをエンジンが誤判定する)、不完全な給紙によるスキュー、スキャナーの画像処理パイプラインによる圧縮アーティファクトなどです。DPIが200を下回ると、文字のエッジがますます曖昧になり、「c」と「e」が同一に見え始め、「t」の横棒のような細いストロークは完全に消えてしまいます。これらはOCRエンジンの問題ではなく、入力品質の問題であり、アルゴリズムの改善だけでは完全に補うことはできません。
OCR精度と抽出精度の違いは何ですか?
OCR精度は、エンジンが画像のピクセルをテキスト文字に変換する精度を測定します。抽出精度は、システムがドキュメントから正しいデータを識別、抽出、構造化できるかどうかを測定します。ツールが完璧なOCR精度を持っていても——すべての文字を正しく読み取っても——請求書の合計を小計と誤ってラベル付けしたり、明細項目をその価格と関連付けられなかったりすると、抽出に失敗する可能性があります。この違いが、従来のOCRとAI文書抽出の核心的な違いであり、構造化データに依存するあらゆるビジネスプロセスにとって、OCR精度ではなく抽出精度でツールを評価することが不可欠な理由です。
AI抽出は100%の精度を達成できますか?
実際のドキュメントに対して100%の精度を責任を持って主張できるツールはありません。最高のビジョン言語モデルでも、曖昧な文字を誤読したり、トレーニング分布外のレイアウトに遭遇したり、著しく劣化した入力に苦戦したりすることがあります。AI抽出システムの現実的な目標は、明確に定義されたドキュメントタイプと高品質な入力に対して99%以上のフィールドレベル精度を達成し、信頼スコアリングと例外ルーティング(モデルが不確かなドキュメントの割合をフラグ付けし、人間によるレビューに送る)を組み合わせることです。このハイブリッドアプローチ(自動抽出+例外に対するヒューマンインザループ)は、大規模で真に信頼性の高いドキュメント処理を実現するための業界のベストプラクティスです。