Que signifie réellement la précision OCR
CER vs niveau des champs expliqué
Quand un fournisseur d'OCR annonce « 99 % de précision », il parle presque toujours de la précision au niveau des caractères sur du texte anglais propre et imprimé — pas de savoir si le total de votre facture sera correct. Cette statistique unique apparaît systématiquement dans les tableaux comparatifs, les études de cas et les pages marketing, présentée comme si elle répondait à la seule question qu'un acheteur doit se poser. Ce n'est pas le cas. L'écart entre « 99 % de précision au niveau des caractères » et « des données exploitables » est suffisamment large pour que deux outils puissent tous deux revendiquer 99 % et donner des résultats radicalement différents sur le même document. Comprendre cet écart — ce que chaque métrique de précision mesure réellement, où elle échoue, et ce qu'elle signifie pour vos documents spécifiques — fait la différence entre acheter une solution et acheter un problème.
Points clés à retenir
- L'affirmation « 99 % de précision » que vous voyez sur chaque outil OCR traite un total de facture erroné comme une note de bas de page tachée — seuls deux caractères sur deux cents doivent échouer pour qu'un paiement soit erroné.
- Ces deux caractères erronés peuvent silencieusement pousser le mauvais montant en dollars dans votre système comptable sans aucun signal d'erreur, car les moteurs OCR ne savent pas quels caractères vous coûtent de l'argent.
- La précision au niveau des champs est la seule métrique qui prédit si votre pipeline documentaire fonctionnera — et cinq questions simples distinguent les fournisseurs qui ont fait de vrais tests de ceux qui se cachent derrière un chiffre CER.
Ce que mesure réellement le CER (taux d'erreur de caractères)
Le taux d'erreur de caractères — ou CER — est la métrique d'accuracy OCR la plus fondamentale. Il mesure combien de caractères individuels le moteur se trompe : chaque substitution (un « O » lu comme un « 0 »), chaque insertion (un caractère ajouté en trop) et chaque suppression (un caractère manquant). La formule est simple : la somme des erreurs divisée par le nombre total de caractères dans la vérité terrain.
Sur un document imprimé standard — pensez à un PDF propre avec une police comme Arial ou Times New Roman à 300 DPI — les moteurs OCR modernes atteignent systématiquement un CER inférieur à 1 %, soit une précision de caractères de 99 % ou plus. C'est ce chiffre qui alimente l'affirmation « précision de 99 % » que vous voyez partout, et il est légitime dans ces limites. Des benchmarks indépendants le confirment : Microsoft Azure Document Intelligence, par exemple, a obtenu 96 % sur du texte imprimé dans le benchmark OCR AIMultiple, plusieurs modèles dépassant le seuil de 99 % sur des documents imprimés propres. La recherche académique sur les programmes de numérisation OCR a depuis longtemps établi un CER de 1 à 2 % comme référence pour un OCR « de qualité » sur du texte imprimé.
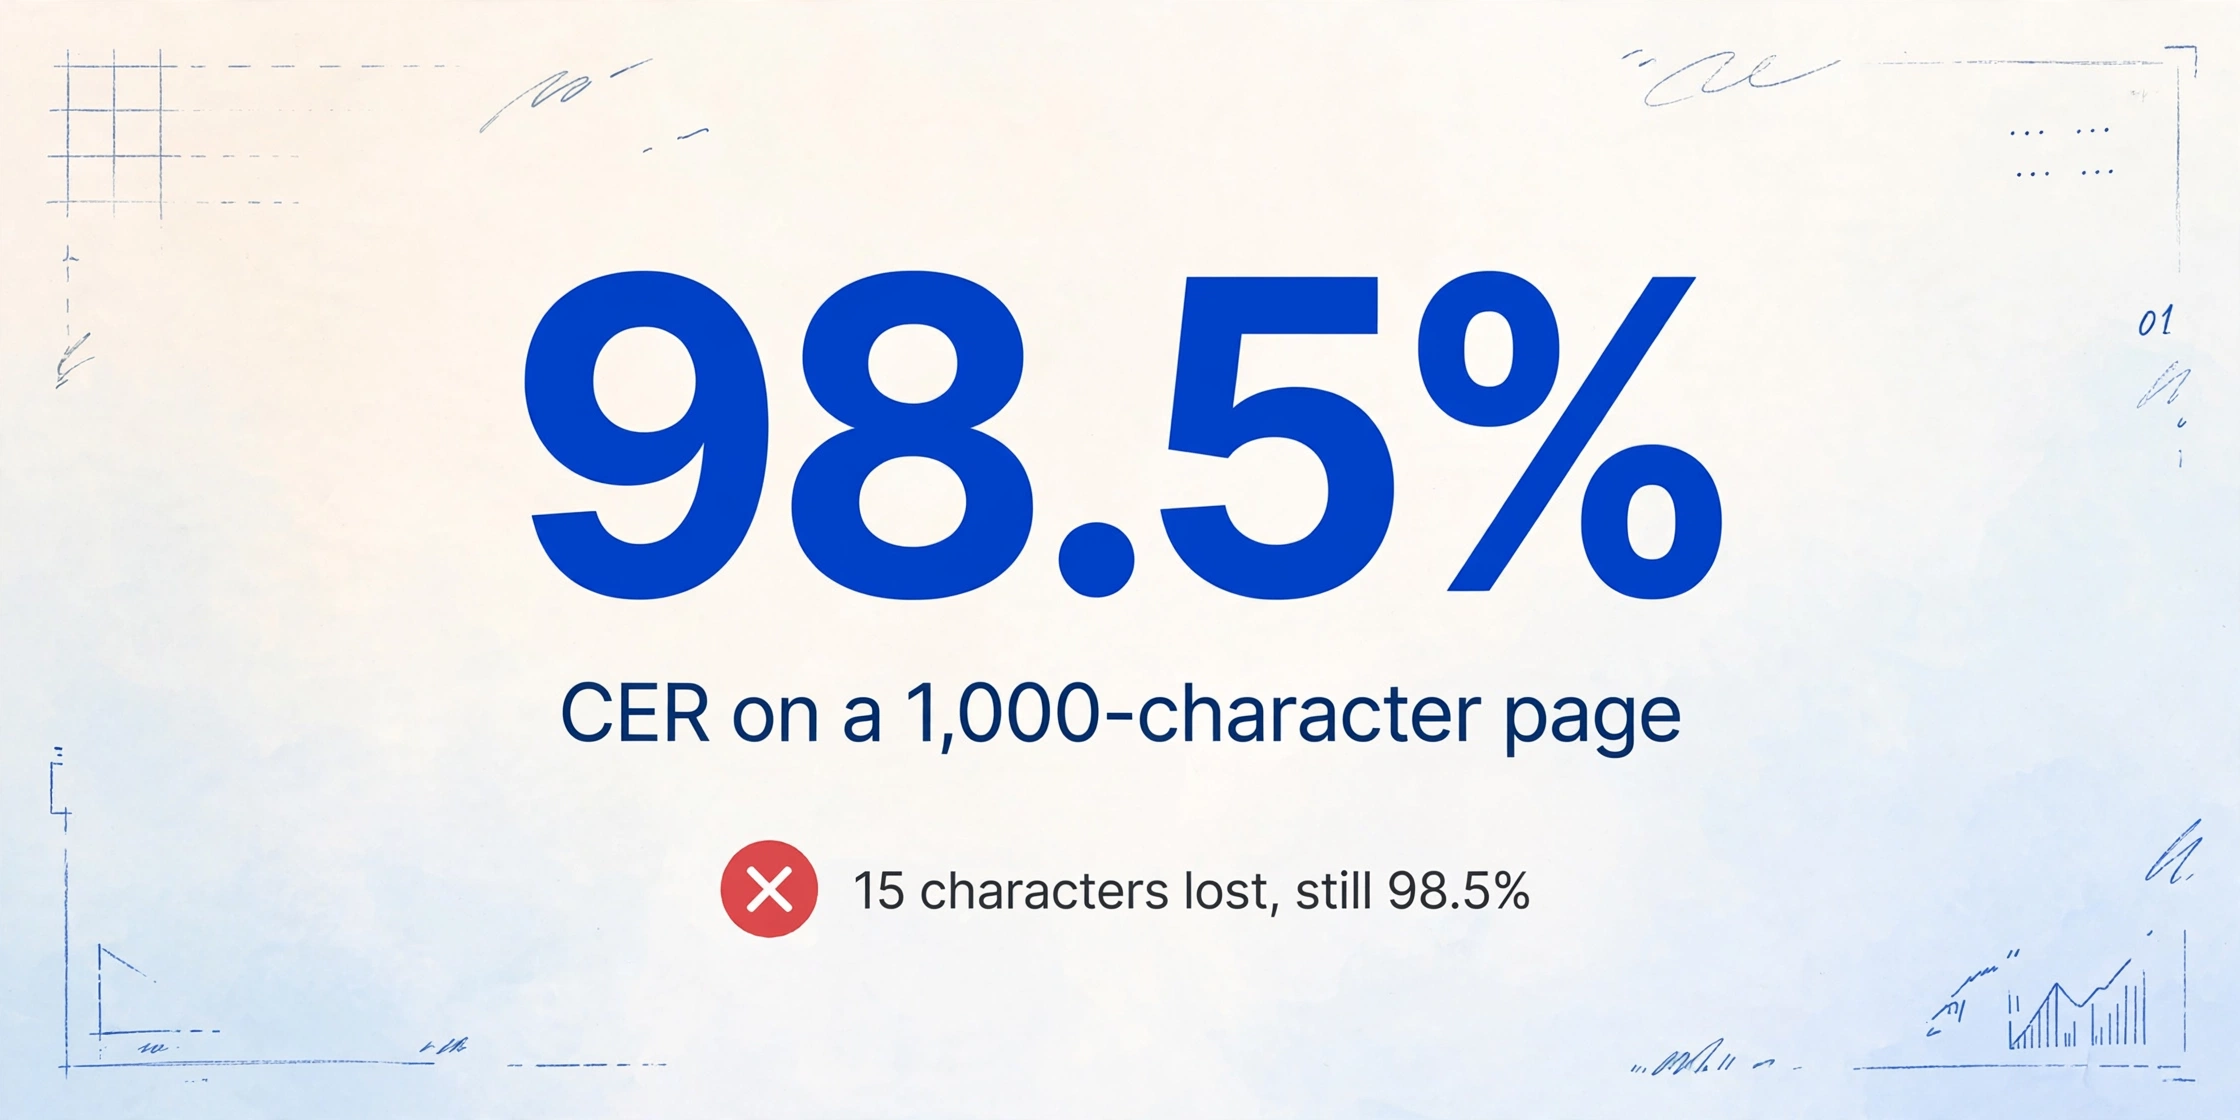
Mais voici ce que le chiffre principal ne vous dit pas : le CER mesure des caractères individuels. Il traite chaque caractère comme également important. Une virgule mal lue dans un pied de page a le même poids qu'un chiffre mal lu dans un total de facture. Cette pondération uniforme est la source de la plupart des confusions autour des affirmations de précision. Un système peut perdre 15 caractères sur une page de 1 000 caractères et afficher quand même un CER de 98,5 % — mais si ces 15 caractères sont concentrés dans des champs critiques, le résultat est inutilisable pour tout processus métier.
Ce que le WER (Word Error Rate) mesure différemment
Le Word Error Rate monte d'un cran : au lieu de compter les erreurs caractère par caractère, il suit combien de mots entiers contiennent au moins une erreur. Un mot n'est correct que si chaque caractère qui le compose est reconnu parfaitement. Cela rend le WER moins granulaire que le CER, mais plus intuitif pour les documents professionnels, où un seul caractère erroné dans « 12 456,78 $ » rend la valeur entière peu fiable.
Les références du secteur placent le WER sous la barre des 2 % pour les documents imprimés standard. Cette métrique importe surtout lorsque le texte extrait alimente des systèmes en aval qui opèrent au niveau du mot — indexation de recherche, pipelines de traitement du langage naturel ou correspondance de bases de données. Si « Pacific Maritime Supplies » est lu comme « Pacific Maritimo Supplies », la pénalité WER est de 33 %, même si l'impact CER ne représente que deux caractères sur 26.
Le WER fait le pont entre la reconnaissance brute des caractères et une précision utile à l'entreprise — mais il ne vous dit toujours pas si un champ spécifique a été correctement extrait.
Précision au niveau du champ — la métrique qui compte vraiment pour les entreprises
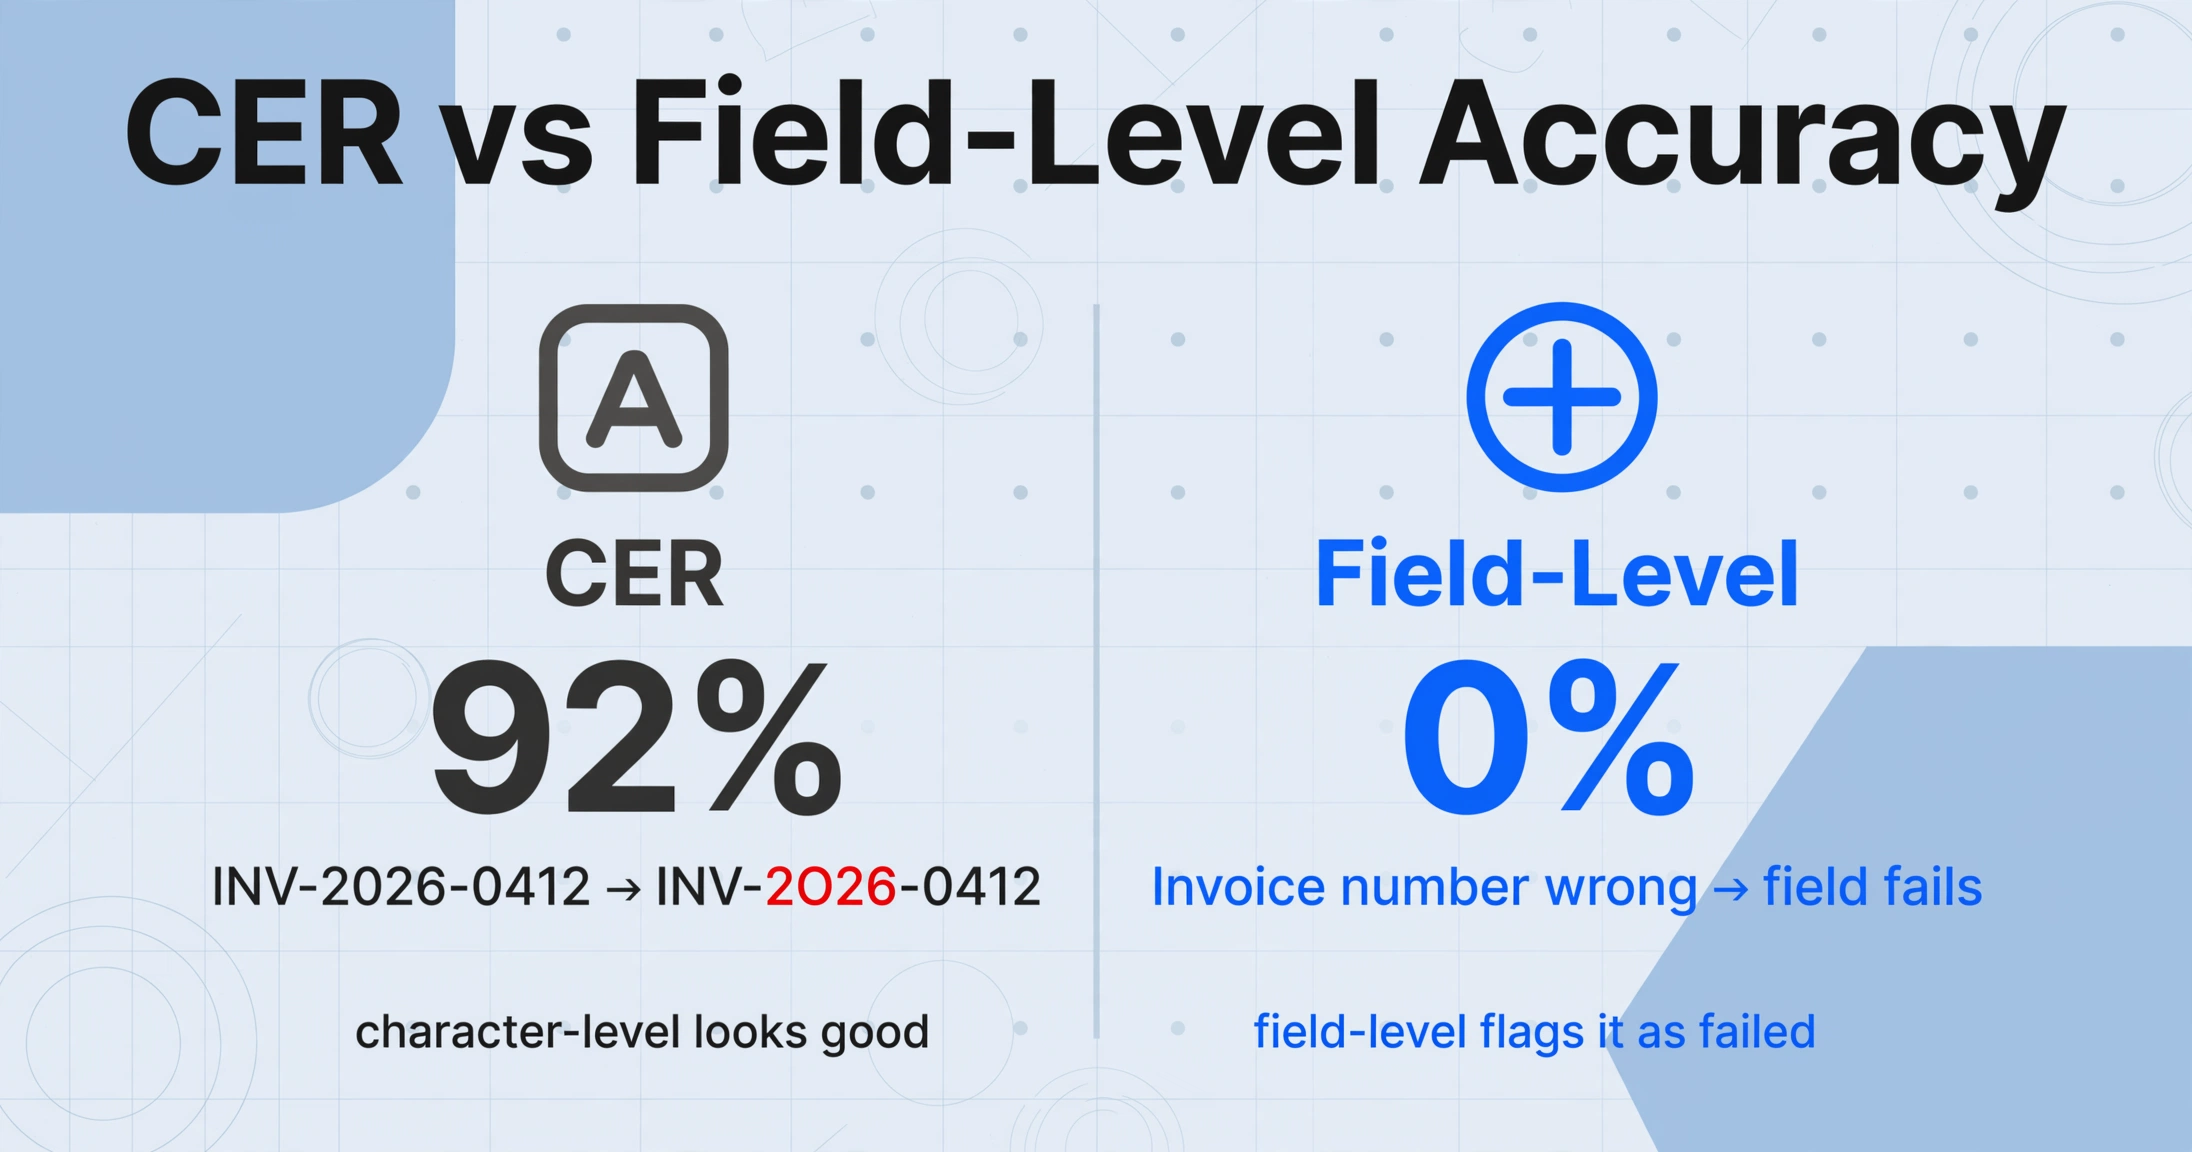
La précision au niveau du champ mesure quelque chose de fondamentalement différent du CER ou du WER : elle vérifie si chaque donnée extraite — le numéro de facture, le montant total, la date d'échéance — est entièrement correcte. Un champ est soit juste, soit faux. Il n'existe pas de crédit partiel. Un numéro de facture « INV-2026-0412 » lu comme « INV-2O26-0412 » (O majuscule au lieu de zéro) obtient 92 % au niveau des caractères, mais 0 % au niveau du champ. Pour tout processus en aval — rapprocher un paiement, réconcilier un total — ce zéro est le seul chiffre qui compte.
C'est la métrique qui détermine si votre pipeline documentaire peut fonctionner sans intervention humaine — ce qu'on appelle le traitement direct (STP). Les analyses du secteur suggèrent qu'une précision de 99,9 % au niveau du champ est le seuil pratique pour activer le STP. En dessous, chaque point de pourcentage perdu se traduit directement par davantage de temps de relecture manuelle, davantage d'échecs de rapprochement et davantage de litiges fournisseurs.
L'écart entre le CER et la précision au niveau du champ est précisément là où les outils OCR traditionnels montrent leurs limites et où l'extraction basée sur l'IA se démarque. Un moteur OCR conventionnel traite chaque caractère de la page avec la même logique — il ne sait pas que « 12 456,78 $ » est le total de la facture et mérite donc une attention particulière. Un modèle d'extraction IA lit le document sémantiquement : il identifie le total de la facture comme un champ distinct et le valide dans son contexte. C'est pourquoi l'écart de précision entre l'OCR IA et l'OCR traditionnel est le plus important au niveau du champ — là où l'impact sur l'activité est le plus élevé.
Pourquoi un CER de 99 % peut encore signifier des données erronées : un exemple concret
La meilleure façon de comprendre pourquoi la précision au niveau des champs est la seule mesure qui compte pour les entreprises est de parcourir un scénario réel.
Prenons une facture d'une page avec 200 caractères au total — nom et adresse du fournisseur, numéro de facture, quelques lignes d'articles avec quantités et prix, une ligne de sous-total, une ligne de taxe et un total final. Le moteur OCR rapporte un CER de 99 %, ce qui signifie qu'il a lu correctement 198 caractères sur 200.
Deux caractères sont erronés. Cela semble être un résultat quasi parfait.
Mais voici la question à laquelle le CER ne répond pas : quels deux caractères ?
| Scénario | Où se situent les 2 erreurs | Précision au niveau des champs | Impact sur l'activité |
|---|---|---|---|
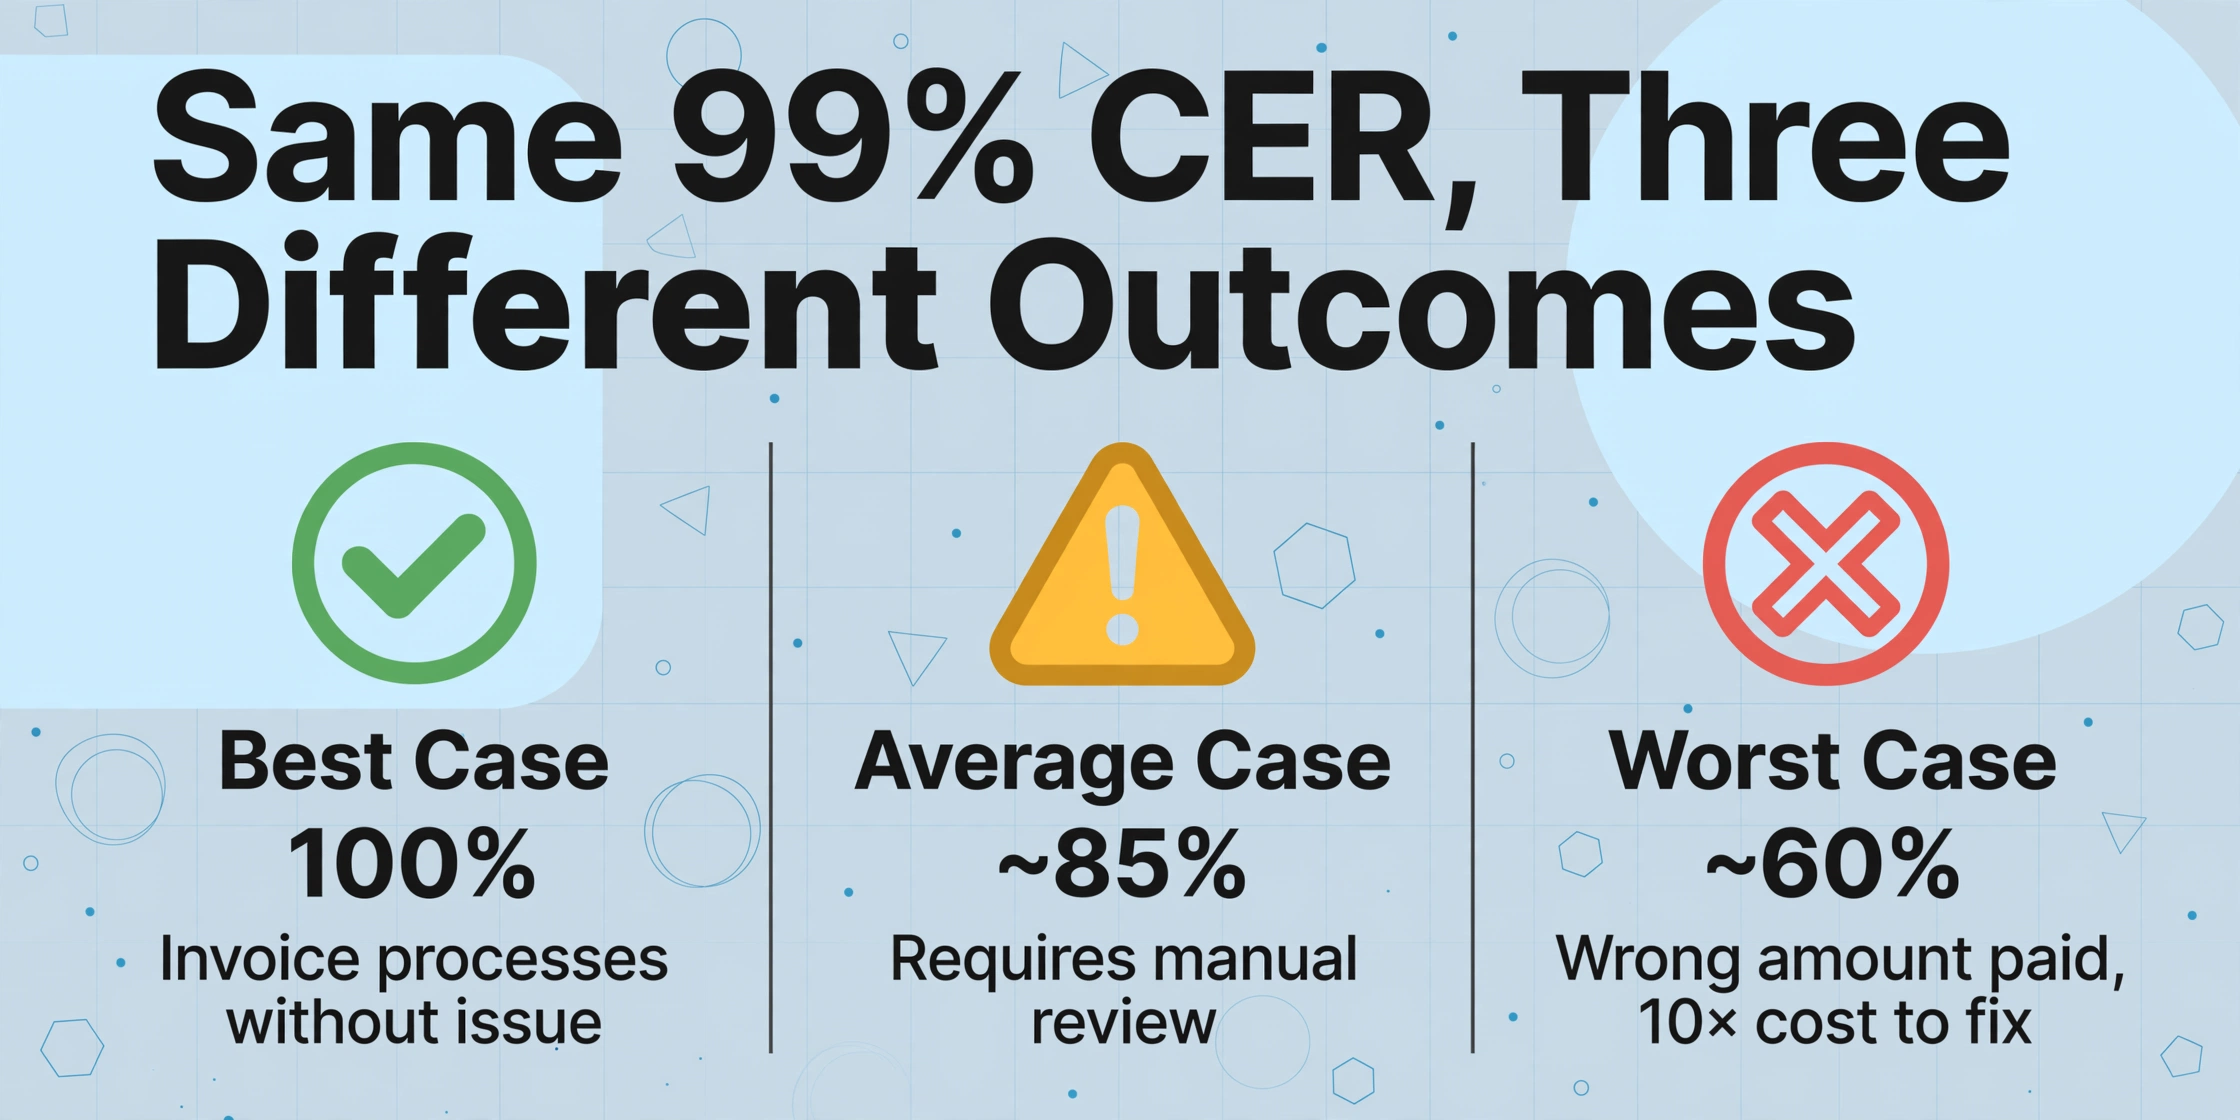
| Cas optimal | Texte de pied de page, numéro de page | 100 % | Tous les champs critiques sont corrects. La facture est traitée sans problème. |
| Cas moyen | Un chiffre dans le prix d'une ligne, un caractère dans le nom de la rue du fournisseur | ~85 % | Le total de la ligne est incorrect. Une vérification manuelle est requise avant le paiement. |
| Cas défavorable | Deux chiffres dans le total de la facture (12 456,78 $ → 12 496,78 $) | ~60 % | Mauvais montant payé. Découvert lors du rapprochement, coût de correction 10× supérieur. |
Le même CER de 99 % produit trois résultats d'activité complètement différents selon où se situent les erreurs. Ce n'est pas un cas limite théorique — c'est la réalité quotidienne de ceux qui s'appuient sur la précision au niveau des caractères comme mesure de la qualité d'extraction. Dans le pire des cas, un outil « précis à 99 % » au niveau des caractères pousse silencieusement un montant erroné dans votre système comptable, et aucun signal d'erreur ne se déclenche, car le moteur OCR ne sait pas — ne peut pas savoir — qu'il a commis une erreur sur un champ critique.
À quoi ressemblent les différents niveaux de précision en pratique
La précision varie considérablement selon le type de document et la qualité de l'entrée, et les fourchettes sont suffisamment larges pour rendre les affirmations à chiffre unique presque dénuées de sens. En s'appuyant sur des benchmarks indépendants et des données sectorielles, voici comment les indicateurs de précision évoluent selon les conditions courantes de documents pour les systèmes d'extraction basés sur l'IA (qui surpassent systématiquement l'OCR traditionnel sur les entrées non idéales) :
| Condition du document | Fourchette CER typique | Précision typique au niveau des champs | Pourquoi la précision diminue |
|---|---|---|---|
| PDF numérique propre (texte imprimé) | <1% | 98–99% | Dégradation minimale — polices uniformes, contraste élevé, aucun bruit |
| Numérisation haute qualité à 300 DPI | 1–3% | 95–98% | Légers artefacts de binarisation, inclinaison légère, variations mineures de police |
| Factures multi-fournisseurs (mises en page variées) | 2–5% | 85–95% | Variabilité du format — l'OCR traditionnel échoue en premier ; l'extraction par IA tient mieux |
| Photo de téléphone en éclairage normal | 5–15% | 70–90% | Distorsion de perspective, flou de mouvement, éclairage non uniforme |
| Texte manuscrit (écriture en capitales dans des formulaires structurés) | 5–20% | 85–93% | Variabilité de la morphologie des caractères — aucun scripteur ne produit le même « a » ou « 7 » |
| Copie carbone délavée / reçu en papier thermique | 10–25% | 50–75% | Faible contraste, interférence de l'arrière-plan, décoloration de l'encre avec le temps |
Ces fourchettes proviennent de plusieurs sources indépendantes. Le benchmark OCR d'AIMultiple constate que les meilleurs modèles de vision atteignent 93–96 % sur l'écriture manuscrite mais chutent à 85 % sur les documents imprimés complexes. L'analyse de LlamaIndex montre que l'OCR open source (Tesseract, PaddleOCR) se situe entre 88 et 94 %, les API d'entreprise (Google, Azure, AWS) entre 96 et 98 %, et le traitement de documents par IA dépasse 99 % sur les documents complexes avec des boucles de validation.
Le schéma crucial : l'écart entre le CER et la précision au niveau des champs se creuse à mesure que la qualité des documents se dégrade. Sur un PDF propre, les deux mesures convergent presque. Sur une photo de téléphone d'un reçu délavé, la précision au niveau des champs peut être de 15 à 20 points inférieure au CER. Une mauvaise entrée ne répartit pas ses erreurs de manière uniforme — elle les concentre dans les zones qui contiennent des données critiques (totaux, dates, noms de fournisseurs).
Comment lire une revendication de précision d'un fournisseur : le cadre des 5 questions
Chaque fournisseur d'OCR et d'extraction de documents publie des chiffres de précision. Les cinq questions suivantes séparent les arguments marketing des informations utiles. Si un fournisseur ne peut pas ou ne veut pas y répondre de manière transparente, supposez que la plage de précision la plus défavorable s'applique à vos documents.
Quelle mesure rapportez-vous ?
Si la réponse est « précision des caractères » ou « CER », demandez le chiffre au niveau des champs. S'ils ne suivent pas la précision au niveau des champs, ils n'ont pas testé le cas d'usage qui compte pour votre entreprise. Les fournisseurs qui rapportent la précision au niveau des champs le font de manière visible — ceux qui se cachent derrière le CER ont généralement quelque chose à cacher.
Quel type de document a été testé ?
99 % sur du texte imprimé A4 propre est un produit différent de 99 % sur des factures multi-fournisseurs ou des formulaires manuscrits. Demandez les catégories exactes de documents et les tailles d'échantillons. Un ensemble de test de 500 documents quasi identiques ne vous dit rien sur les performances réelles.
Quelle était la qualité de l'entrée ?
Tous les documents ont-ils été numérisés à 300 DPI ? Des photos de téléphone ou des fax ont-ils été inclus ? Un outil testé uniquement sur des scans parfaits ne fonctionnera pas de la même manière sur les documents que vos employés produisent réellement.
Combien de variations de documents ont été testées ?
100 factures provenant de 100 fournisseurs différents sont exponentiellement plus difficiles que 100 provenant d'un seul fournisseur. La précision sur des documents homogènes n'est pas prédictive de la précision sur les flux de documents mixtes que la plupart des entreprises traitent réellement.
Quelle était votre tolérance d'erreur ?
Un crédit partiel était-il accordé pour les champs « assez proches » ? Ou s'agissait-il d'une correspondance exacte stricte ? La différence peut gonfler la précision rapportée de 5 à 10 points, changeant complètement l'image de l'outil sur le papier par rapport à ses performances réelles.
Questions fréquemment posées
Une précision OCR de 99 % est-elle bonne ?
Tout dépend de ce qui est mesuré. Une précision de 99 % au niveau des caractères sur du texte imprimé propre est la norme actuelle du secteur et est généralement considérée comme bonne dans ce contexte restreint. Mais une précision de 99 % au niveau des champs — où chaque donnée critique (numéro de facture, total, date) est extraite parfaitement — est nettement plus difficile à atteindre, surtout sur des documents aux formats variés. Pour les flux de travail professionnels, c'est la précision au niveau des champs qui compte, et l'écart entre les deux peut être de 10 à 20 points de pourcentage sur des documents réels.
Quel est un bon CER pour l'OCR ?
Les références du secteur, issues de décennies de recherche et de pratique en OCR, classent le CER comme suit : une bonne précision OCR correspond à un CER de 1 à 2 % (98–99 % de précision), une précision moyenne de 2 à 10 %, et une mauvaise précision au-dessus de 10 %. Pour du texte imprimé sur des documents propres, les moteurs modernes atteignent régulièrement un CER inférieur à 1 %. Pour l'écriture manuscrite, un CER pouvant atteindre 20 % peut encore être considéré comme acceptable selon le style d'écriture et la structure du document — c'est pourquoi la précision au niveau des caractères seule vous en dit très peu sur l'efficacité d'un outil pour votre cas d'usage spécifique.
Pourquoi la précision OCR diminue-t-elle sur les documents scannés ?
La numérisation introduit des artefacts qui dégradent la reconnaissance : des erreurs de seuil de binarisation (lorsque le moteur se trompe en décidant si un pixel est du texte ou de l'arrière-plan), une inclinaison due à un chargement imparfait, et des artefacts de compression issus du pipeline de traitement d'image du scanner. Lorsque le DPI descend sous 200, les contours des caractères deviennent de plus en plus ambigus — un « c » et un « e » commencent à se ressembler, et les traits fins comme la barre d'un « t » disparaissent complètement. Ce ne sont pas des problèmes du moteur OCR ; ce sont des problèmes de qualité d'entrée qu'aucune amélioration algorithmique ne peut entièrement compenser.
Quelle est la différence entre la précision de l'OCR et la précision de l'extraction ?
La précision de l'OCR mesure la capacité du moteur à convertir les pixels de l'image en caractères textuels. La précision de l'extraction mesure si le système identifie, extrait et structure correctement les bonnes données d'un document. Un outil peut avoir une précision OCR parfaite — lire chaque caractère correctement — et échouer quand même à l'extraction s'il confond le total de la facture avec un sous-total, ou s'il n'associe pas un article à son prix. Cette distinction est la différence fondamentale entre l'OCR et l'extraction de documents par IA, et c'est pourquoi évaluer un outil sur la précision de l'extraction plutôt que sur la précision de l'OCR est essentiel pour tout processus métier qui dépend de données structurées.
L'extraction par IA peut-elle atteindre une précision de 100 % ?
Aucun outil ne peut raisonnablement prétendre à une précision de 100 % sur des documents réels. Même les meilleurs modèles vision-langage lisent parfois mal des caractères ambigus, rencontrent des mises en page hors de leur distribution d'entraînement, ou peinent avec des entrées fortement dégradées. L'objectif réaliste pour les systèmes d'extraction par IA est une précision au niveau des champs de 99 %+ sur des types de documents bien définis avec des entrées de qualité, combinée à un score de confiance et un routage des exceptions — signalant la fraction de documents où le modèle est incertain et les envoyant pour révision humaine. Cette approche hybride (extraction automatisée + intervention humaine pour les exceptions) est la meilleure pratique du secteur pour obtenir un traitement documentaire réellement fiable à grande échelle.