Was bedeutet OCR-Genauigkeit
wirklich? CER vs. Feldgenauigkeit erklärt
Wenn ein OCR-Anbieter „99 % Genauigkeit" angibt, meint er damit fast immer die Genauigkeit auf Zeichenebene bei sauberem, gedrucktem englischem Text – nicht, ob Ihre Rechnungssumme am Ende stimmt. Diese einzelne Kennzahl taucht regelmäßig in Produktvergleichstabellen, Fallstudien und Marketingseiten auf, präsentiert als ob sie die einzige Frage beantwortet, die ein Käufer beantwortet haben möchte. Das tut sie nicht. Die Kluft zwischen „99 % Zeichengenauigkeit" und „brauchbaren Daten" ist so groß, dass zwei Tools beide 99 % behaupten und dennoch bei demselben Dokument völlig unterschiedliche Ergebnisse liefern können. Diese Kluft zu verstehen – was jede Genauigkeitsmetrik tatsächlich misst, wo sie versagt und was sie für Ihre spezifischen Dokumente bedeutet – ist der Unterschied zwischen dem Kauf einer Lösung und dem Kauf eines Problems.
Wichtigste Erkenntnisse
- Die „99 % Genauigkeit"-Behauptung, die Sie bei jedem OCR-Tool sehen, behandelt eine falsche Rechnungssumme genauso wie eine verschmierte Fußnote – nur zwei von zweihundert Zeichen müssen fehlschlagen, damit eine Zahlung schiefgeht.
- Diese zwei falschen Zeichen können stillschweigend den falschen Dollarbetrag in Ihr Buchhaltungssystem einschleusen, ohne Fehlerflags, weil OCR-Engines nicht wissen, welche Zeichen Sie Geld kosten.
- Feldgenauigkeit ist die einzige Metrik, die vorhersagt, ob Ihre Dokumenten-Pipeline funktioniert – und fünf einfache Fragen trennen Anbieter, die echte Tests durchgeführt haben, von denen, die sich hinter einer CER-Zahl verstecken.
Was die CER (Character Error Rate) tatsächlich misst
Die Character Error Rate – kurz CER – ist die grundlegendste OCR-Genauigkeitsmetrik. Sie misst, wie viele einzelne Zeichen die Engine falsch erkennt: jede Substitution (ein „O" als „0" gelesen), jede Insertion (ein zusätzlich eingefügtes Zeichen) und jede Deletion (ein übersehenes Zeichen). Die Formel ist einfach: die Summe der Fehler geteilt durch die Gesamtzahl der Zeichen im Ground Truth.
Bei einem standardmäßig gedruckten Dokument – etwa einer sauberen PDF-Datei mit einer Schrift wie Arial oder Times New Roman bei 300 DPI – erreichen moderne OCR-Engines durchgängig eine CER unter 1 %, also eine Zeichengenauigkeit von 99 % oder besser. Diese Zahl steckt hinter der überall zitierten Behauptung „99 % Genauigkeit", und sie ist unter diesen Bedingungen legitim. Unabhängige Benchmarks bestätigen das: Microsoft Azure Document Intelligence beispielsweise erzielte im AIMultiple OCR-Benchmark 96 % bei gedrucktem Text, wobei mehrere Modelle bei sauberem Druckmaterial die 99-%-Schwelle überschreiten. Die akademische Forschung zu OCR-Digitalisierungsprogrammen hat seit langem eine CER von 1–2 % als Maßstab für „gute" OCR bei gedrucktem Text etabliert.
Aber das, was die Schlagzeilenzahl nicht verrät, ist Folgendes: Die CER misst einzelne Zeichen. Sie behandelt jedes Zeichen als gleich wichtig. Ein falsch gelesenes Komma in der Fußzeile wiegt genauso schwer wie eine falsch gelesene Ziffer in einer Rechnungssumme. Diese gleichmäßige Gewichtung ist die Hauptquelle der Verwirrung um Genauigkeitsangaben. Ein System kann 15 Zeichen auf einer Seite mit 1.000 Zeichen verlieren und dennoch eine CER von 98,5 % melden – doch wenn diese 15 Zeichen in kritischen Feldern konzentriert sind, ist die Ausgabe für jeden Geschäftsprozess unbrauchbar.
Was WER (Word Error Rate) anders erfasst
Die Word Error Rate geht eine Ebene höher: Statt einzelner Zeichenfehler wird erfasst, wie viele ganze Wörter mindestens einen Fehler enthalten. Ein Wort ist nur dann korrekt, wenn jedes Zeichen darin fehlerfrei erkannt wurde. Dadurch ist WER weniger granular als CER, aber intuitiver für Geschäftsdokumente, bei denen ein einziges falsches Zeichen in „12.456,78" den gesamten Wert unbrauchbar macht.
Branchen-Benchmarks setzen WER für standardmäßige gedruckte Dokumente unter 2 % an. Die Kennzahl ist dann am wichtigsten, wenn extrahierter Text in nachgelagerte Systeme fließt, die auf Wortebene arbeiten – Suchindizierung, NLP-Pipelines oder Datenbankabgleich. Wird „Pacific Maritime Supplies" als „Pacific Maritimo Supplies" gelesen, beträgt die WER-Strafe 33 %, obwohl die CER-Auswirkung nur zwei von 26 Zeichen betrifft.
WER ist eine Brücke zwischen roher Zeichenerkennung und geschäftlich nutzbarer Genauigkeit – sagt aber immer noch nicht aus, ob ein bestimmtes Feld korrekt extrahiert wurde.
Feldgenauigkeit – die Kennzahl, die für Unternehmen wirklich zählt
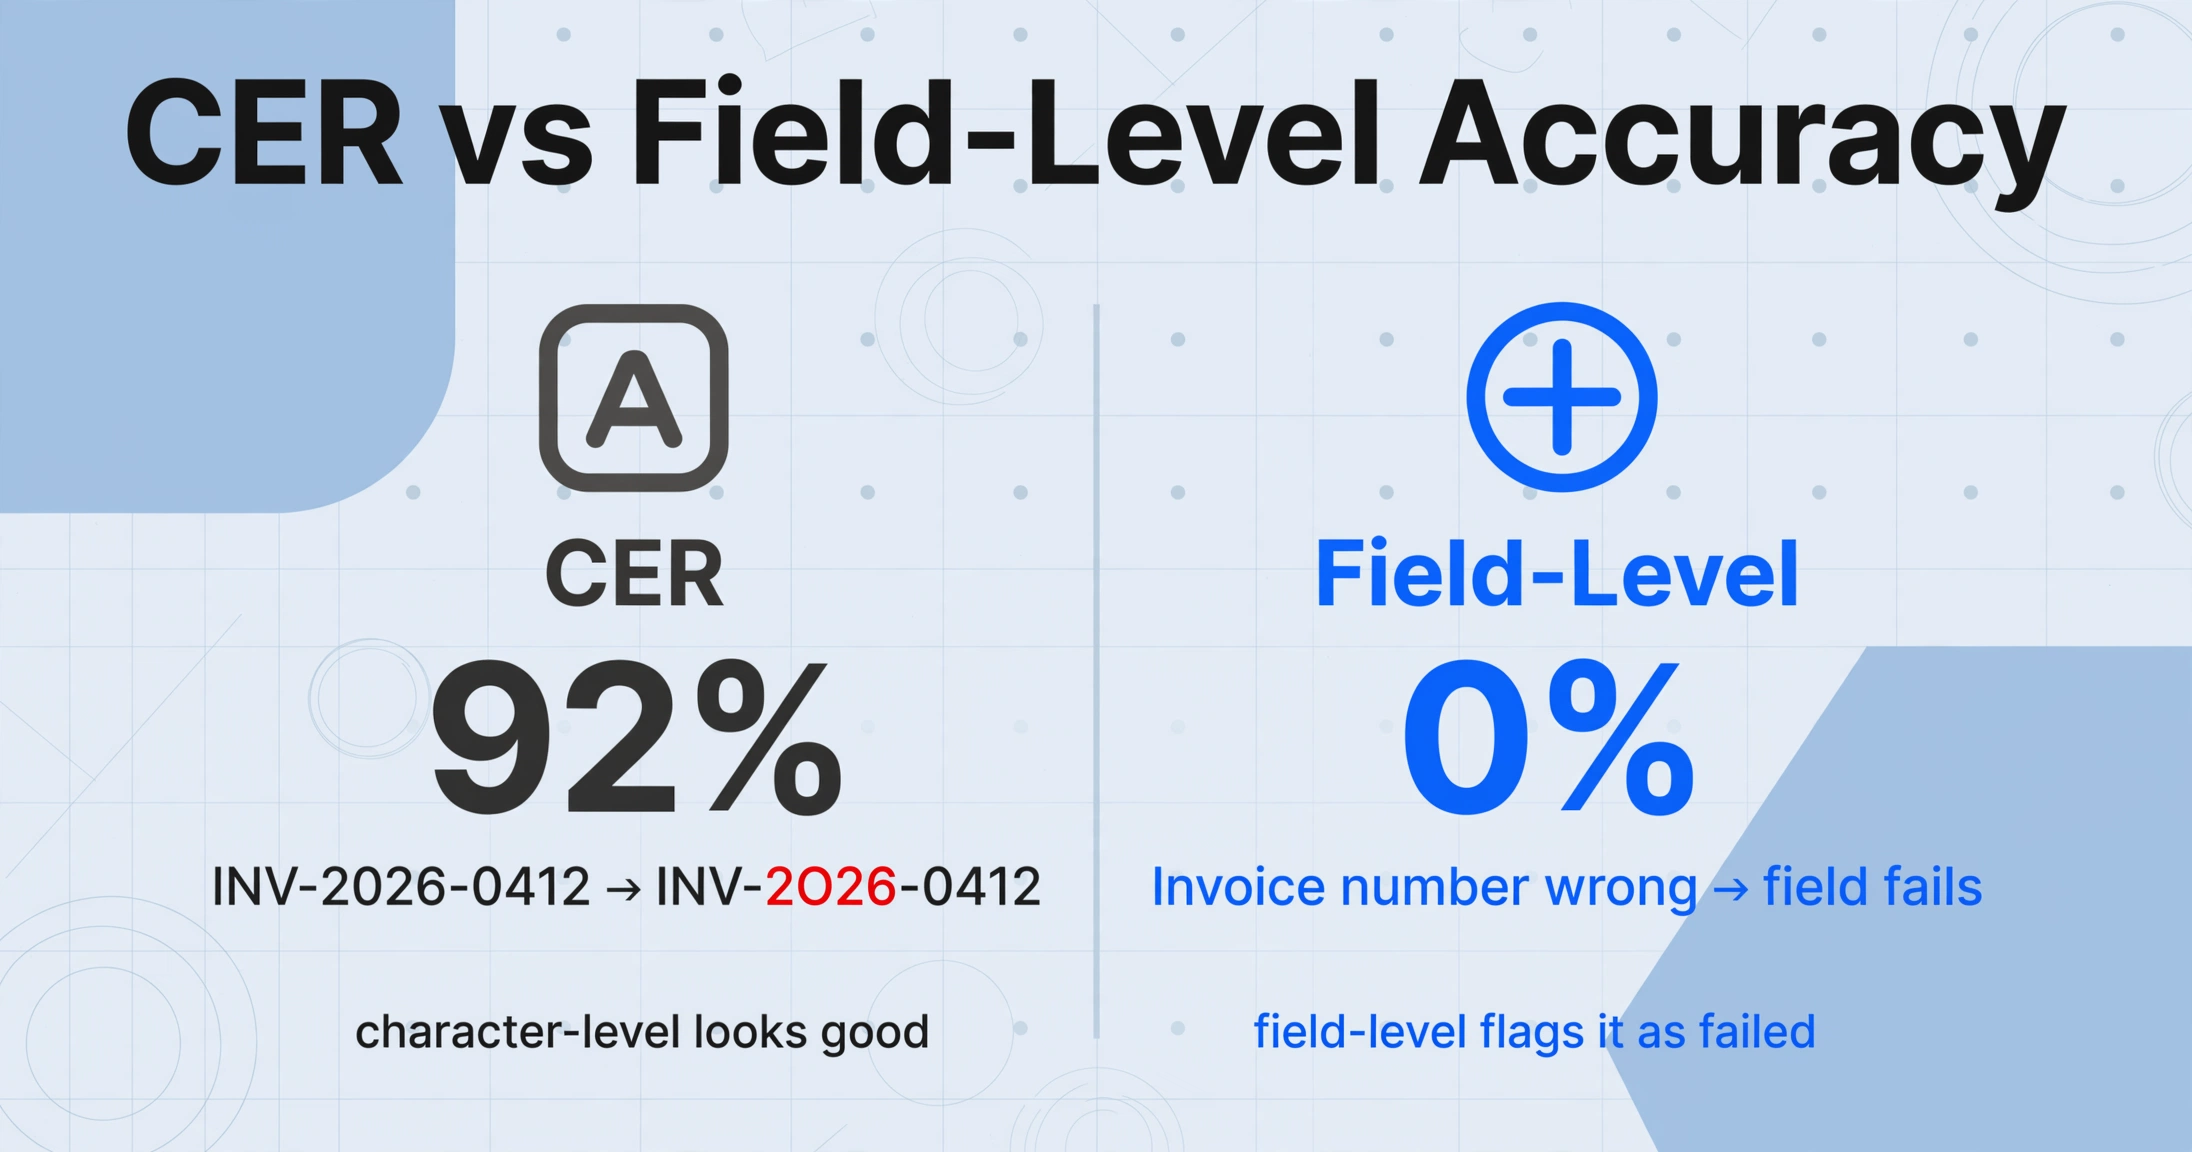
Die Feldgenauigkeit misst etwas grundlegend anderes als CER oder WER: Sie fragt, ob jeder extrahierte Datenpunkt – die Rechnungsnummer, der Gesamtbetrag, das Fälligkeitsdatum – vollständig korrekt ist. Ein Feld ist entweder richtig oder falsch. Teilpunkte gibt es nicht. Eine Rechnungsnummer „INV-2026-0412", die als „INV-2O26-0412" gelesen wird (großes O statt Null), erreicht auf Zeichenebene 92 %, auf Feldebene jedoch 0 %. Für jeden nachgelagerten Prozess – Zahlungsabgleich, Saldenabstimmung – zählt nur diese Null.
Diese Kennzahl entscheidet, ob Ihre Dokumenten-Pipeline ohne menschliche Prüfung laufen kann – bekannt als Straight-Through Processing (STP). Branchenanalysen deuten darauf hin, dass 99,9 % Feldgenauigkeit die praktische Schwelle für STP ist. Darunter führt jeder Prozentpunkt Verlust direkt zu mehr manueller Prüfzeit, mehr Abstimmungsfehlern und mehr Lieferantenstreitigkeiten.
Die Lücke zwischen CER und Feldgenauigkeit ist der Punkt, an dem herkömmliche OCR-Tools versagen und wo sich KI-basierte Extraktion differenziert. Eine herkömmliche OCR-Engine verarbeitet jedes Zeichen auf der Seite mit derselben Logik – sie weiß nicht, dass „$12.456,78" der Rechnungsgesamtbetrag ist und daher besondere Aufmerksamkeit verdient. Ein KI-Extraktionsmodell liest das Dokument semantisch: Es identifiziert den Rechnungsgesamtbetrag als eigenes Feld und validiert ihn im Kontext. Deshalb ist die Genauigkeitslücke zwischen AI-OCR und herkömmlicher OCR auf Feldebene am größten – dort, wo die geschäftliche Auswirkung am höchsten ist.
Warum 99 % CER trotzdem falsche Daten bedeuten können: Ein konkretes Beispiel
Der beste Weg zu verstehen, warum die Feldgenauigkeit die einzige Kennzahl ist, die für Unternehmen zählt, ist ein reales Szenario durchzuspielen.
Betrachten Sie eine einseitige Rechnung mit insgesamt 200 Zeichen – Name und Adresse des Lieferanten, Rechnungsnummer, einige Positionszeilen mit Mengen und Preisen, eine Zwischensummenzeile, eine Steuerzeile und eine Endsumme. Die OCR-Engine meldet 99 % CER, d. h. sie hat 198 von 200 Zeichen korrekt gelesen.
Zwei Zeichen sind falsch. Das klingt nach einem nahezu perfekten Ergebnis.
Aber hier ist die Frage, die CER nicht beantwortet: welche zwei Zeichen?
| Szenario | Wo die 2 Fehler auftreten | Feldgenauigkeit | Geschäftsergebnis |
|---|---|---|---|
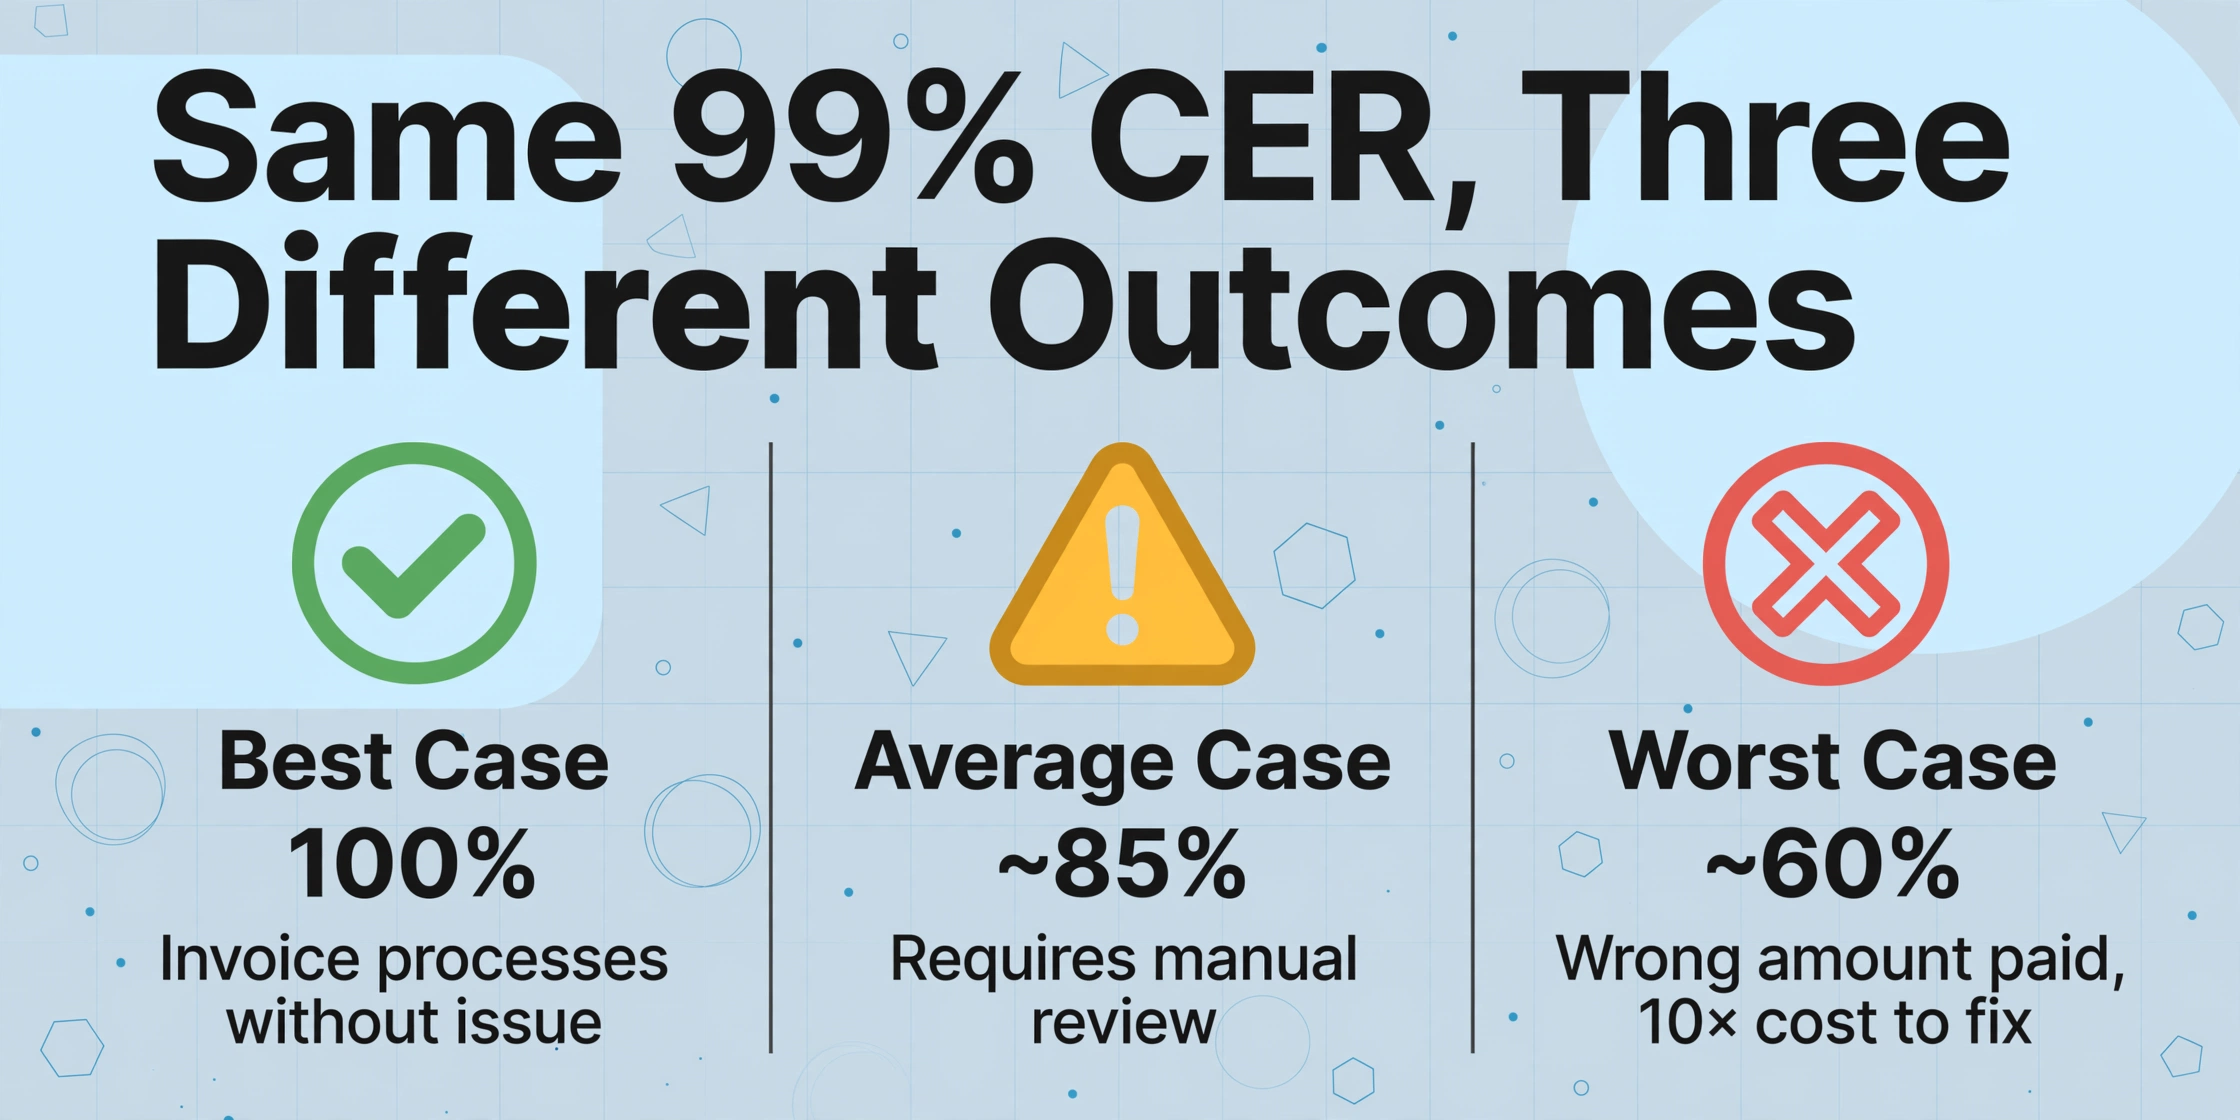
| Bester Fall | Fußzeilentext, Seitenzahl | 100 % | Alle kritischen Felder korrekt. Rechnung wird ohne Probleme verarbeitet. |
| Durchschnittlicher Fall | Eine Ziffer im Positionspreis, ein Zeichen im Straßennamen des Lieferanten | ~85 % | Positionssumme ist falsch. Erfordert manuelle Prüfung vor der Zahlung. |
| Schlechtester Fall | Zwei Ziffern in der Rechnungssumme ($12.456,78 → $12,496,78) | ~60 % | Falscher Betrag gezahlt. Beim Abgleich entdeckt, 10× höhere Korrekturkosten. |
Dieselbe CER von 99 % führt zu drei völlig unterschiedlichen Geschäftsergebnissen, je nachdem, wo die Fehler auftreten. Das ist kein theoretischer Randfall – es ist der Alltag, wenn man sich auf die Zeichengenauigkeit als Maß für die Extraktionsqualität verlässt. Im schlechtesten Fall schiebt ein Tool, das auf Zeichenebene „zu 99 % genau" ist, stillschweigend einen falschen Dollar-Betrag in Ihr Buchhaltungssystem, und es wird kein Fehlerflag ausgelöst, weil die OCR-Engine nicht weiß – nicht wissen kann –, dass sie bei einem kritischen Feld einen Fehler gemacht hat.
Wie sich verschiedene Genauigkeitswerte in der Praxis darstellen
Die Genauigkeit variiert stark je nach Dokumenttyp und Eingabequalität, und die Spannen sind so breit, dass einzelne Zahlenangaben nahezu bedeutungslos sind. Basierend auf unabhängigen Benchmarks und Branchendaten zeigen wir hier, wie sich Genauigkeitskennzahlen bei AI-basierten Extraktionssystemen (die bei nicht idealen Eingaben durchweg besser abschneiden als herkömmliche OCR) über gängige Dokumentbedingungen hinweg verändern:
| Dokumentzustand | Typische CER-Spanne | Typische Feldgenauigkeit | Warum die Genauigkeit sinkt |
|---|---|---|---|
| Sauberes digitales PDF (gedruckter Text) | <1% | 98–99% | Minimale Beeinträchtigung – einheitliche Schriftarten, hoher Kontrast, kein Rauschen |
| Hochwertiger Scan mit 300 DPI | 1–3% | 95–98% | Leichte Binarisierungsartefakte, geringe Schräglage, minimale Schriftvariation |
| Rechnungen von verschiedenen Anbietern (unterschiedliche Layouts) | 2–5% | 85–95% | Formatvielfalt – herkömmliche OCR versagt zuerst; AI-Extraktion hält besser stand |
| Handyfoto bei normaler Beleuchtung | 5–15% | 70–90% | Perspektivverzerrung, Bewegungsunschärfe, ungleichmäßige Beleuchtung |
| Handschriftlicher Text (Blockschrift in strukturierten Formularen) | 5–20% | 85–93% | Variation der Zeichenmorphologie – keine zwei Schreiber erzeugen dasselbe „a" oder „7" |
| Verblasste Durchschrift / Thermorollenbon | 10–25% | 50–75% | Geringer Kontrast, Hintergrundstörungen, mit der Zeit verblassende Farbe |
Diese Spannen stammen aus mehreren unabhängigen Quellen. Der AIMultiple OCR-Benchmark stellt fest, dass die besten visuellen Modelle bei Handschrift 93–96 % erreichen, bei komplexen gedruckten Medien jedoch auf 85 % fallen. Die Analyse von LlamaIndex zeigt, dass Open-Source-OCR (Tesseract, PaddleOCR) bei 88–94 % liegt, Unternehmens-APIs (Google, Azure, AWS) bei 96–98 % und KI-gestützte Dokumentenverarbeitung bei komplexen Dokumenten mit Validierungsschleifen über 99 % erreicht.
Das entscheidende Muster: Die Kluft zwischen CER und Feldgenauigkeit vergrößert sich, wenn die Dokumentqualität nachlässt. Bei einem sauberen PDF konvergieren die beiden Metriken nahezu. Bei einem Handyfoto eines verblassten Belegs kann die Feldgenauigkeit 15–20 Punkte unter dem CER liegen. Eine schlechte Eingabe verteilt ihre Fehler nicht gleichmäßig – sie bündelt sie in Bereichen mit kritischen Daten (Summen, Daten, Lieferantennamen).
So lesen Sie eine Genauigkeitsangabe eines Anbieters: Das 5-Fragen-Framework
Jeder OCR- und Dokumentextraktionsanbieter veröffentlicht Genauigkeitszahlen. Die folgenden fünf Fragen trennen Marketingaussagen von aussagekräftigen Informationen. Wenn ein Anbieter sie nicht transparent beantworten kann oder will, gehen Sie vom schlechtesten Genauigkeitsbereich für Ihre Dokumente aus.
Welche Metrik melden Sie?
Wenn die Antwort „Zeichengenauigkeit“ oder „CER“ lautet, fragen Sie nach der Zahl auf Feldebene nach. Wenn sie keine Feldgenauigkeit verfolgen, haben sie nicht für den Anwendungsfall getestet, der für Ihr Unternehmen relevant ist. Anbieter, die Feldgenauigkeit melden, tun dies prominent – diejenigen, die sich hinter CER verstecken, haben meist etwas zu verbergen.
Welcher Dokumenttyp wurde getestet?
99 % bei sauberem A4-Text ist ein anderes Produkt als 99 % bei Rechnungen mehrerer Anbieter oder handschriftlichen Formularen. Fragen Sie nach den genauen Dokumentkategorien und Stichprobengrößen. Ein Testsatz von 500 nahezu identischen Dokumenten sagt nichts über die Leistung in der Praxis aus.
Wie war die Eingabequalität?
Wurden alle Dokumente mit 300 DPI gescannt? Waren Handyfotos oder Faxe enthalten? Ein Tool, das nur mit perfekten Scans getestet wurde, wird bei den Dokumenten, die Ihre Mitarbeiter tatsächlich erstellen, nicht dieselbe Leistung erbringen.
Wie viele Dokumentvarianten wurden getestet?
100 Rechnungen von 100 verschiedenen Anbietern sind exponentiell schwieriger als 100 von einem Anbieter. Die Genauigkeit bei homogenen Dokumenten ist nicht aussagekräftig für die Genauigkeit bei den gemischten Dokumentströmen, die die meisten Unternehmen tatsächlich verarbeiten.
Wie war Ihre Fehlertoleranz?
Wurden Teilpunkte für Felder vergeben, die „nahe genug“ waren? Oder galt ein strenger exakter Abgleich? Der Unterschied kann die gemeldete Genauigkeit um 5–10 Punkte erhöhen und das Bild des Tools auf dem Papier völlig von seiner tatsächlichen Leistung in der Praxis unterscheiden.
Häufig gestellte Fragen
Ist eine OCR-Genauigkeit von 99 % gut?
Das hängt vollständig davon ab, was gemessen wird. Eine 99%ige Zeichengenauigkeit bei sauberem gedrucktem Text ist der aktuelle Industriestandard und gilt in diesem engen Kontext allgemein als gut. Aber eine 99%ige Feldgenauigkeit – bei der jeder kritische Datenpunkt (Rechnungsnummer, Gesamtsumme, Datum) perfekt extrahiert wird – ist deutlich schwerer zu erreichen, insbesondere bei Dokumenten mit gemischten Formaten. Für Geschäftsworkflows ist die Feldgenauigkeit die Kennzahl, die zählt, und die Lücke zwischen beiden kann bei realen Dokumenten 10–20 Prozentpunkte betragen.
Was ist ein guter CER für OCR?
Branchen-Benchmarks, die auf jahrzehntelanger OCR-Forschung und -Praxis basieren, klassifizieren den CER wie folgt: Gute OCR-Genauigkeit bedeutet einen CER von 1–2 % (98–99 % genau), durchschnittlich sind 2–10 %, und schlecht ist alles über 10 %. Bei gedrucktem Text auf sauberen Dokumenten erreichen moderne Engines durchgängig einen CER unter 1 %. Bei Handschrift kann ein CER von bis zu 20 % je nach Schreibstil und Dokumentstruktur immer noch als akzeptabel gelten – weshalb die Zeichengenauigkeit allein nur sehr wenig darüber aussagt, ob ein Tool für Ihren spezifischen Anwendungsfall geeignet ist.
Warum sinkt die OCR-Genauigkeit bei gescannten Dokumenten?
Das Scannen erzeugt Artefakte, die die Erkennung beeinträchtigen: Binarisierungsschwellenfehler (wenn der Engine falsch rät, ob ein Pixel Text oder Hintergrund ist), Schräglage durch ungleichmäßigen Einzug und Komprimierungsartefakte aus der Bildverarbeitungspipeline des Scanners. Sinkt die DPI unter 200, werden Zeichenkanten zunehmend mehrdeutig – ein „c“ und ein „e“ beginnen identisch auszusehen, und dünne Striche wie der Querbalken eines „t“ verschwinden vollständig. Dies sind keine Probleme des OCR-Engines, sondern Probleme der Eingabequalität, die durch keine noch so große algorithmische Verbesserung vollständig kompensiert werden können.
Was ist der Unterschied zwischen OCR-Genauigkeit und Extraktionsgenauigkeit?
Die OCR-Genauigkeit misst, wie gut die Engine Bildpixel in Textzeichen umwandelt. Die Extraktionsgenauigkeit misst, ob das System die richtigen Daten aus einem Dokument korrekt identifiziert, extrahiert und strukturiert. Ein Tool kann eine perfekte OCR-Genauigkeit aufweisen – jedes Zeichen korrekt lesen – und dennoch bei der Extraktion scheitern, wenn es die Rechnungssumme als Zwischensumme falsch beschriftet oder einen Positionsposten nicht seinem Preis zuordnet. Dieser Unterschied ist der Kernunterschied zwischen herkömmlicher OCR und KI-Dokumentenextraktion, und genau deshalb ist es für jeden Geschäftsprozess, der von strukturierten Daten abhängt, unerlässlich, ein Tool anhand der Extraktionsgenauigkeit statt der OCR-Genauigkeit zu bewerten.
Kann KI-Extraktion 100 % Genauigkeit erreichen?
Kein Tool kann verantwortungsvoll 100 % Genauigkeit bei realen Dokumenten beanspruchen. Selbst die besten Vision-Language-Modelle lesen gelegentlich mehrdeutige Zeichen falsch, stoßen auf Layouts außerhalb ihrer Trainingsverteilung oder haben Probleme mit stark beeinträchtigten Eingaben. Das realistische Ziel für KI-Extraktionssysteme ist eine Feldgenauigkeit von 99 %+ bei klar definierten Dokumenttypen mit qualitativ hochwertigen Eingaben, kombiniert mit Konfidenzbewertung und Ausnahmerouting – wobei der Anteil der Dokumente markiert wird, bei denen das Modell unsicher ist, und diese zur menschlichen Überprüfung weitergeleitet werden. Dieser hybride Ansatz (automatisierte Extraktion + Mensch-im-Loop für Ausnahmen) ist die branchenübliche Best Practice für zuverlässige Dokumentenverarbeitung in großem Maßstab.