¿Qué significa realmente la precisión del OCR?
CER vs. nivel de campo explicado
Cuando un proveedor de OCR dice "precisión del 99%", casi siempre se refiere a la precisión a nivel de caracteres en texto en inglés limpio e impreso, no a si el total de su factura saldrá correcto. Esa única estadística aparece habitualmente en tablas comparativas de productos, casos de éxito y páginas de marketing, presentada como si respondiera la única pregunta que un comprador necesita responder. No es así. La brecha entre "99% de precisión de caracteres" y "datos utilizables" es tan amplia que dos herramientas pueden afirmar ambas el 99% y ofrecer resultados muy diferentes en el mismo documento. Entender esa brecha — qué mide realmente cada métrica de precisión, dónde falla y qué significa para sus documentos específicos — es la diferencia entre comprar una solución y comprar un problema.
Conclusiones clave
- La afirmación de "precisión del 99%" que ve en cada herramienta de OCR trata un total de factura incorrecto igual que una nota al pie manchada: solo dos de cada doscientos caracteres necesitan fallar para que un pago salga mal.
- Esos dos caracteres incorrectos pueden introducir silenciosamente el monto equivocado en su sistema contable sin ninguna bandera de error, porque los motores de OCR no saben qué caracteres le cuestan dinero.
- La precisión a nivel de campo es la única métrica que predice si su flujo de documentos funcionará — y cinco preguntas simples separan a los proveedores que han hecho pruebas reales de quienes se esconden detrás de un número de CER.
Qué mide realmente la CER (tasa de error de caracteres)
La tasa de error de caracteres — o CER — es la métrica de precisión de OCR más fundamental. Mide cuántos caracteres individuales el motor interpreta incorrectamente: cada sustitución (una "O" leída como "0"), cada inserción (un carácter adicional agregado) y cada eliminación (un carácter omitido). La fórmula es sencilla: la suma de errores dividida entre el número total de caracteres en la verdad fundamental.
En un documento impreso estándar — piense en un PDF limpio con una fuente como Arial o Times New Roman a 300 DPI — los motores de OCR modernos logran consistentemente una CER inferior al 1%, lo que significa una precisión de caracteres del 99% o mejor. Este es el número que respalda la afirmación de "99% de precisión" que ve en todas partes, y es legítimo dentro de esas restricciones. Los puntos de referencia independientes lo confirman: Microsoft Azure Document Intelligence, por ejemplo, obtuvo un 96% en texto impreso en el AIMultiple OCR Benchmark, con varios modelos superando el umbral del 99% en material impreso limpio. La investigación académica sobre programas de digitalización por OCR ha establecido desde hace tiempo una CER del 1–2% como el punto de referencia para un OCR "bueno" en texto impreso.
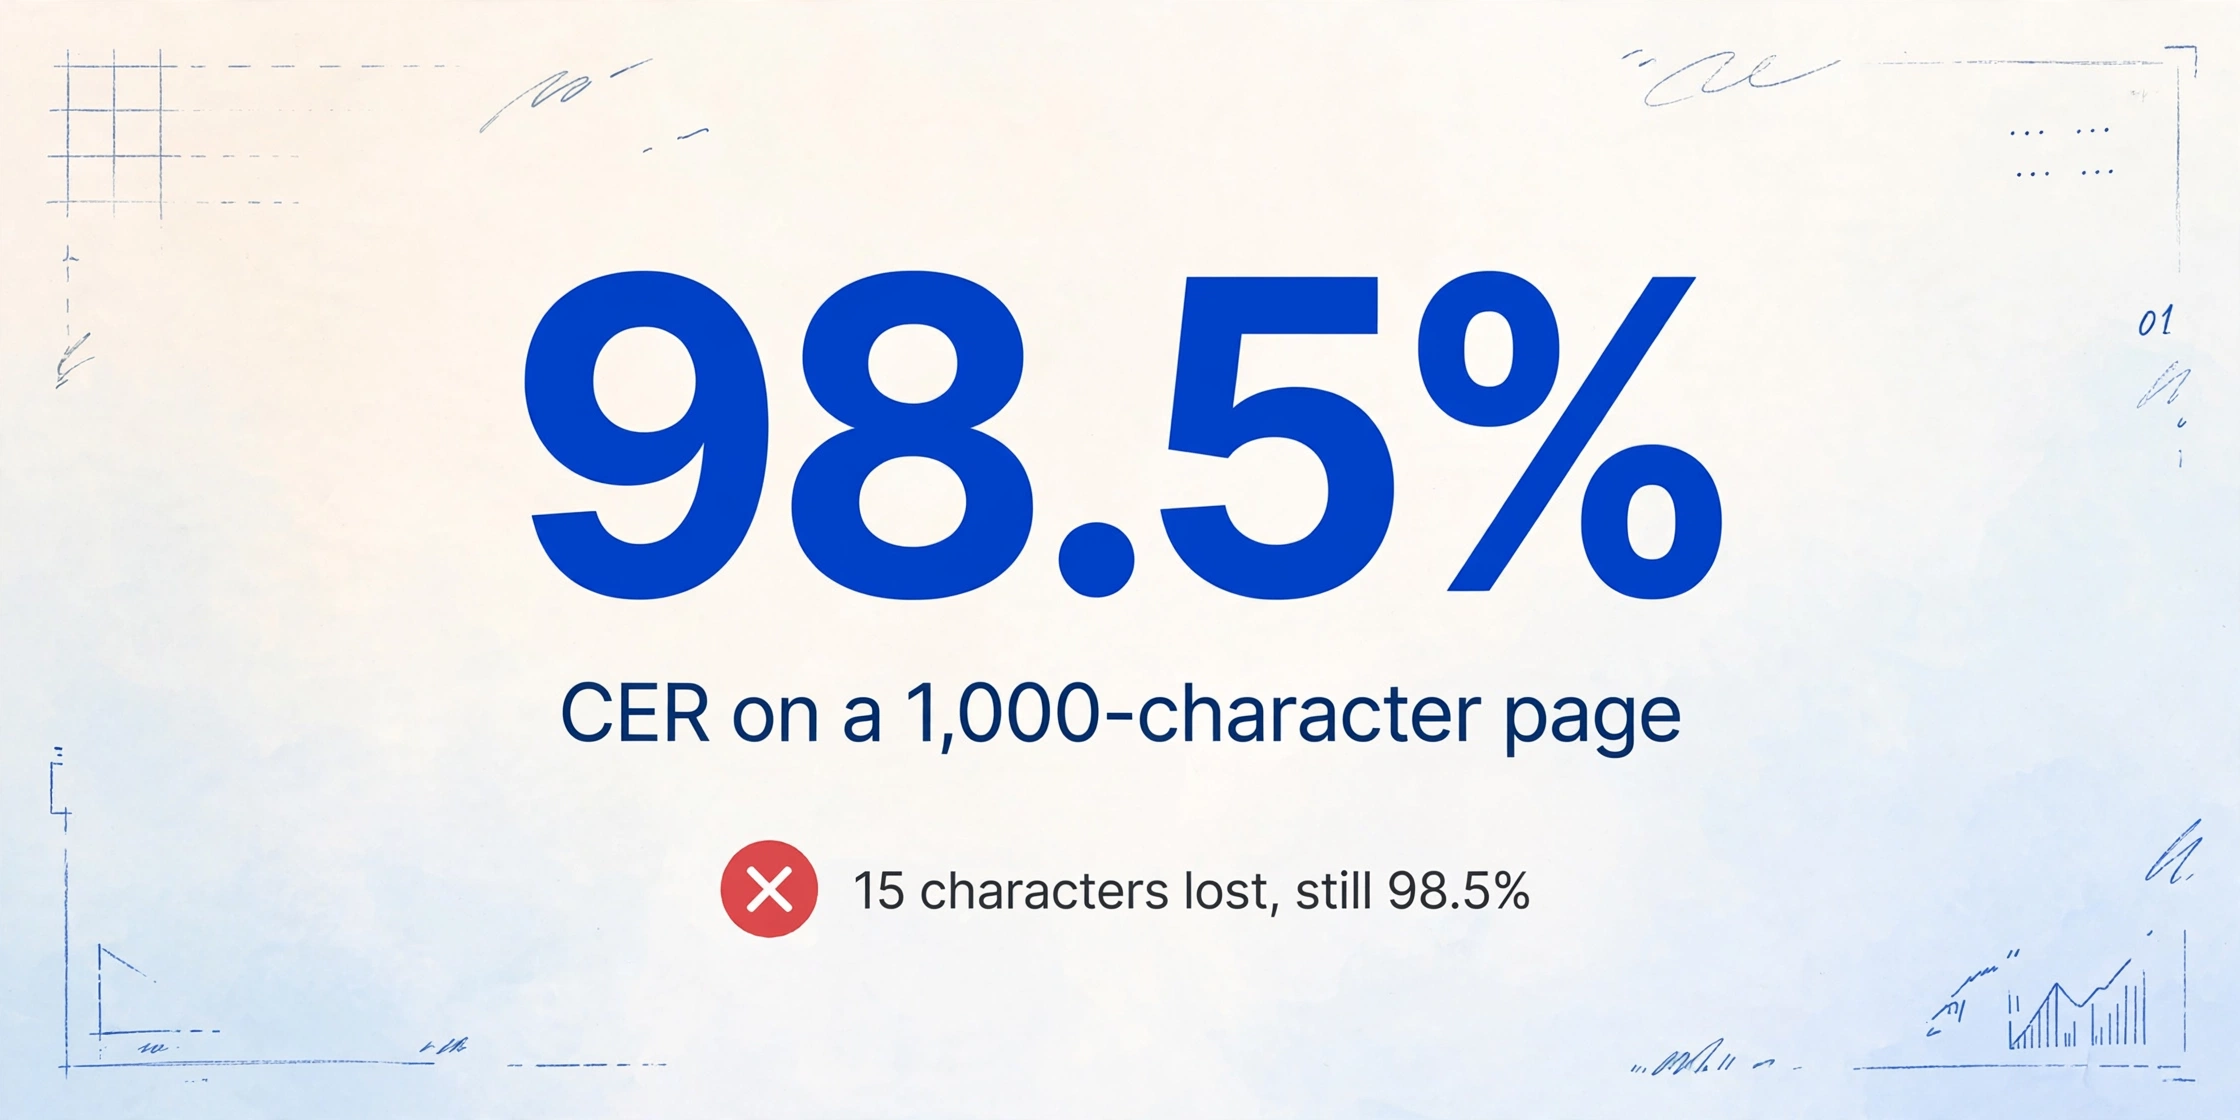
Pero esto es lo que el número principal no le dice: la CER mide caracteres individuales. Trata cada carácter como igualmente importante. Una coma mal leída en un pie de página tiene el mismo peso que un dígito mal leído en el total de una factura. Esta ponderación plana es la fuente de la mayor parte de la confusión en torno a las afirmaciones de precisión. Un sistema puede perder 15 caracteres en una página de 1.000 caracteres y aún así reportar una CER del 98,5% — pero si esos 15 caracteres se concentran en campos críticos, el resultado es inutilizable para cualquier proceso empresarial.
Lo que captura el WER (tasa de error de palabras) de manera diferente
La tasa de error de palabras sube un nivel: en lugar de contar errores de caracteres individuales, rastrea cuántas palabras completas contienen al menos un error. Una palabra es correcta solo si cada carácter en ella se reconoce perfectamente. Esto hace que el WER sea menos granular que el CER, pero más intuitivo para documentos comerciales, donde un solo carácter incorrecto en "12,456.78" hace que todo el valor no sea confiable.
Los puntos de referencia de la industria sitúan el WER por debajo del 2% para documentos impresos estándar. La métrica importa más cuando el texto extraído alimenta sistemas posteriores que operan a nivel de palabra: indexación de búsqueda, pipelines de lenguaje natural o coincidencia de bases de datos. Si "Pacific Maritime Supplies" se lee como "Pacific Maritimo Supplies", la penalización del WER es del 33%, aunque el impacto en el CER sea solo de dos caracteres de 26.
El WER es un puente entre el reconocimiento de caracteres en bruto y la precisión útil para el negocio, pero aún no le dice si un campo específico salió correctamente.
Precisión a nivel de campo: la métrica que realmente importa para el negocio
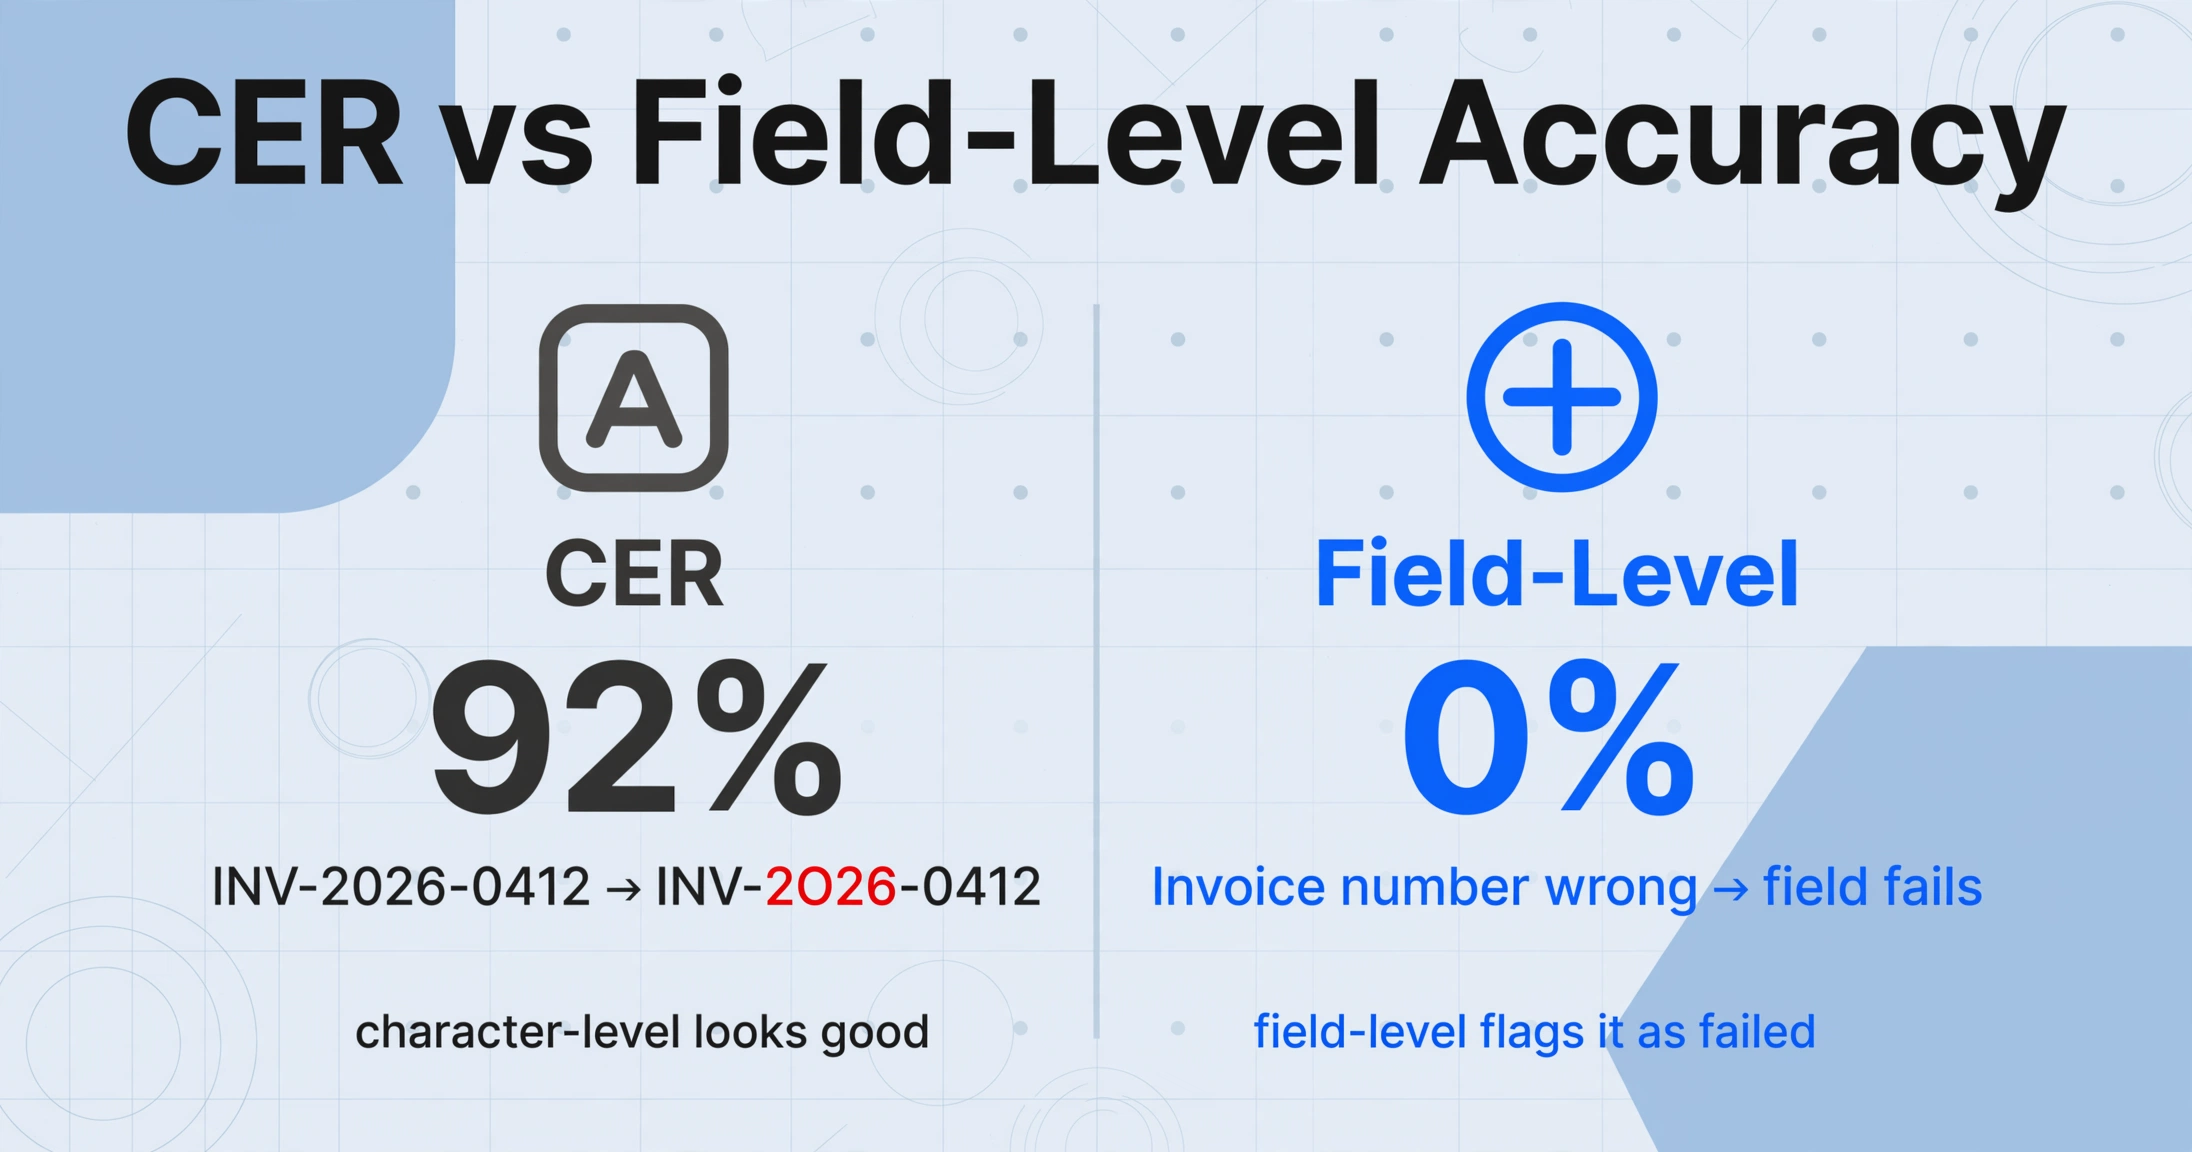
La precisión a nivel de campo mide algo fundamentalmente diferente del CER o el WER: pregunta si cada dato extraído — el número de factura, el monto total, la fecha de vencimiento — es completamente correcto. Un campo es correcto o incorrecto. No existe crédito parcial. Un número de factura "INV-2026-0412" leído como "INV-2O26-0412" (O mayúscula en lugar de cero) obtiene un 92% a nivel de carácter, pero un 0% a nivel de campo. Para cualquier proceso posterior — cotejar un pago, conciliar un total — ese cero es el único número que importa.
Esta es la métrica que determina si su pipeline de documentos puede funcionar sin revisión humana — conocido como STP (procesamiento directo). El análisis de la industria sugiere que una precisión a nivel de campo del 99.9% es el umbral práctico para habilitar el STP. Por debajo de eso, cada punto porcentual de caída se traduce directamente en más tiempo de revisión manual, más fallos de conciliación y más disputas con proveedores.
La brecha entre el CER y la precisión a nivel de campo es donde las herramientas de OCR tradicionales se quedan cortas y donde la extracción basada en IA se diferencia. Un motor de OCR convencional procesa cada carácter de la página con la misma lógica — no sabe que "$12,456.78" es el total de la factura y por lo tanto merece atención especial. Un modelo de extracción con IA lee el documento semánticamente: identifica el total de la factura como un campo distinto y lo valida en contexto. Esta es la razón por la que la brecha de precisión entre el OCR con IA y el OCR tradicional es mayor a nivel de campo — donde el impacto comercial es más alto.
Por qué un 99% de CER puede significar datos incorrectos: un ejemplo concreto
La mejor manera de entender por qué la precisión a nivel de campo es la única métrica que importa para las empresas es trabajar con un escenario real.
Considere una factura de una sola página con 200 caracteres en total: nombre y dirección del proveedor, número de factura, algunas líneas de artículos con cantidades y precios, una línea de subtotal, una línea de impuestos y un total final. El motor de OCR informa un 99% de CER, lo que significa que leyó 198 de 200 caracteres correctamente.
Dos caracteres son incorrectos. Eso suena como un resultado casi perfecto.
Pero esta es la pregunta que el CER no responde: ¿cuáles dos caracteres?
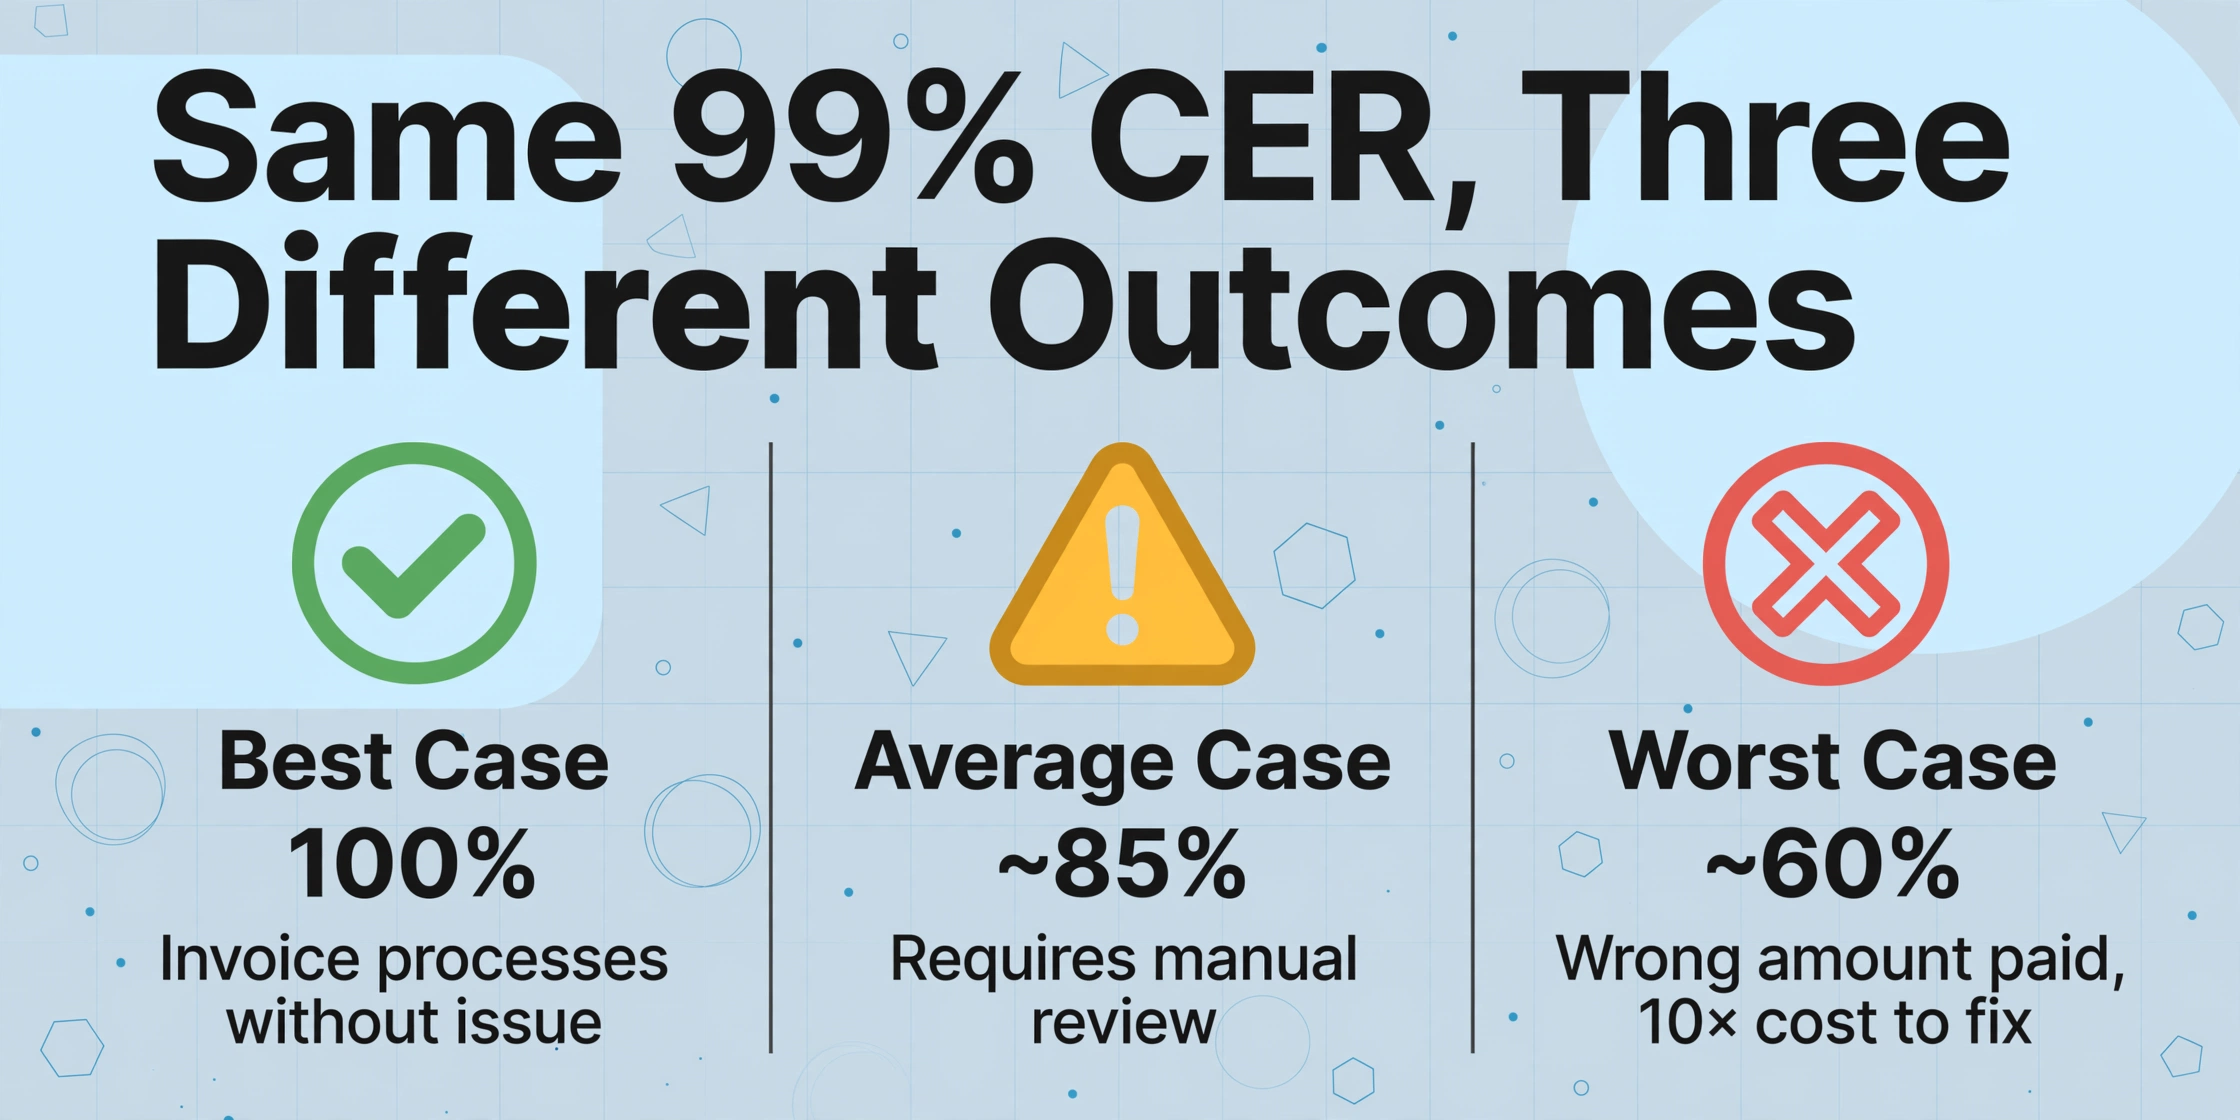
| Escenario | Dónde caen los 2 errores | Precisión a nivel de campo | Resultado empresarial |
|---|---|---|---|
| Mejor caso | Texto de pie de página, número de página | 100% | Todos los campos críticos son correctos. La factura se procesa sin problemas. |
| Caso promedio | Un dígito en el precio del artículo, un carácter en el nombre de la calle del proveedor | ~85% | El total del artículo es incorrecto. Requiere revisión manual antes del pago. |
| Peor caso | Dos dígitos en el total de la factura ($12,456.78 → $12,496.78) | ~60% | Se paga un monto incorrecto. Se descubre en la conciliación, con un costo 10× mayor para corregirlo. |
El mismo 99% de CER produce tres resultados empresariales completamente diferentes según dónde caen los errores. Esto no es un caso límite teórico: es la realidad cotidiana de depender de la precisión a nivel de carácter como medida de la calidad de extracción. En el peor caso, una herramienta "99% precisa" a nivel de carácter introduce silenciosamente una cifra incorrecta en su sistema contable, y no se activa ninguna alerta de error porque el motor de OCR no sabe — no puede saber — que cometió un error en un campo crítico.
Cómo se ven en la práctica los distintos valores de precisión
La precisión varía drásticamente según el tipo de documento y la calidad de entrada, y los rangos son lo bastante amplios como para que las afirmaciones de un solo número carezcan casi de significado. Basándose en evaluaciones comparativas independientes y datos del sector, así es como cambian las métricas de precisión en las condiciones documentales más comunes para los sistemas de extracción basados en IA (que superan sistemáticamente al OCR tradicional en entradas no ideales):
| Estado del documento | Rango típico de CER | Precisión típica a nivel de campo | Por qué baja la precisión |
|---|---|---|---|
| PDF digital limpio (texto impreso) | <1% | 98–99% | Degradación mínima: fuentes uniformes, alto contraste, sin ruido |
| Escaneo de alta calidad a 300 DPI | 1–3% | 95–98% | Artefactos leves de binarización, ligera inclinación, variación menor de fuente |
| Facturas de varios proveedores (diseños variados) | 2–5% | 85–95% | Variabilidad de formato: el OCR tradicional falla primero; la extracción con IA resiste mejor |
| Foto con teléfono con iluminación normal | 5–15% | 70–90% | Distorsión de perspectiva, desenfoque de movimiento, iluminación no uniforme |
| Texto manuscrito (letra de imprenta en formularios estructurados) | 5–20% | 85–93% | Variación morfológica de caracteres: no hay dos personas que escriban la misma "a" o "7" |
| Copia carbón desvaída / recibo en papel térmico | 10–25% | 50–75% | Bajo contraste, interferencia de fondo, desvanecimiento del tinte con el tiempo |
Estos rangos provienen de múltiples fuentes independientes. El AIMultiple OCR Benchmark constata que los mejores modelos de visión alcanzan un 93–96% en escritura a mano, pero bajan al 85% en material impreso complejo. El análisis de LlamaIndex muestra que el OCR de código abierto (Tesseract, PaddleOCR) se sitúa en el 88–94%, las API empresariales (Google, Azure, AWS) en el 96–98%, y el procesamiento de documentos con IA supera el 99% en documentos complejos con bucles de validación.
El patrón crucial: la brecha entre CER y la precisión a nivel de campo se amplía a medida que la calidad del documento se degrada. En un PDF limpio, las dos métricas casi convergen. En una foto de teléfono de un recibo descolorido, la precisión a nivel de campo puede estar 15–20 puntos por debajo del CER. Una entrada deficiente no distribuye sus errores de manera uniforme: los concentra en regiones que contienen datos críticos (totales, fechas, nombres de proveedores).
Cómo interpretar una afirmación de precisión de un proveedor: el marco de las 5 preguntas
Todo proveedor de OCR y extracción de documentos publica cifras de precisión. Las siguientes cinco preguntas separan las afirmaciones de marketing de la información significativa. Si un proveedor no puede o no quiere responderlas con transparencia, asuma que el rango de precisión en el peor de los casos se aplica a sus documentos.
¿Qué métrica está reportando?
Si la respuesta es "precisión de caracteres" o "CER", insista en obtener la cifra a nivel de campo. Si no realizan un seguimiento de la precisión a nivel de campo, no han probado el caso de uso que importa para su negocio. Los proveedores que reportan precisión a nivel de campo lo hacen de manera destacada; quienes se esconden detrás del CER generalmente tienen algo que ocultar.
¿Qué tipo de documento se probó?
Un 99% en texto impreso A4 limpio es un producto diferente de un 99% en facturas de múltiples proveedores o formularios manuscritos. Pida las categorías exactas de documentos y los tamaños de muestra. Un conjunto de prueba de 500 documentos casi idénticos no le dice nada sobre el rendimiento en el mundo real.
¿Cuál fue la calidad de entrada?
¿Se escanearon todos los documentos a 300 DPI? ¿Se incluyeron fotos de teléfono o faxes? Una herramienta probada solo con escaneos perfectos no funcionará igual con los documentos que sus empleados realmente producen.
¿Cuántas variaciones de documentos se probaron?
100 facturas de 100 proveedores diferentes es exponencialmente más difícil que 100 de un solo proveedor. La precisión en documentos homogéneos no es predictiva de la precisión en los flujos de documentos mixtos que la mayoría de las empresas realmente procesan.
¿Cuál fue su tolerancia al error?
¿Se otorgó crédito parcial por campos que estaban "lo suficientemente cerca"? ¿O fue una coincidencia exacta estricta? La diferencia puede inflar la precisión reportada en 5–10 puntos, cambiando por completo cómo se ve la herramienta en el papel frente a cómo se desempeña en la práctica.
Preguntas Frecuentes
¿Es buena una precisión de OCR del 99%?
Depende por completo de qué se esté midiendo. Una precisión del 99% a nivel de carácter en texto impreso limpio es el estándar actual de la industria y generalmente se considera buena en ese contexto limitado. Pero una precisión del 99% a nivel de campo — donde cada dato crítico (número de factura, total, fecha) se extrae perfectamente — es significativamente más difícil de lograr, especialmente en documentos de formato mixto. Para flujos de trabajo empresariales, la precisión a nivel de campo es la cifra que importa, y la brecha entre ambas puede ser de 10 a 20 puntos porcentuales en documentos del mundo real.
¿Qué es un buen CER para OCR?
Los puntos de referencia de la industria, derivados de décadas de investigación y práctica en OCR, clasifican el CER de la siguiente manera: una buena precisión de OCR es un CER del 1–2% (98–99% de precisión), el promedio es del 2–10%, y el deficiente es superior al 10%. Para texto impreso en documentos limpios, los motores modernos logran consistentemente un CER inferior al 1%. Para escritura a mano, un CER de hasta el 20% aún puede considerarse aceptable dependiendo del estilo de escritura y la estructura del documento — razón por la cual la precisión a nivel de carácter por sí sola dice muy poco sobre si una herramienta funcionará para su caso de uso específico.
¿Por qué disminuye la precisión del OCR en documentos escaneados?
El escaneo introduce artefactos que degradan el reconocimiento: errores de umbral de binarización (donde el motor adivina incorrectamente si un píxel es texto o fondo), inclinación por alimentación imperfecta y artefactos de compresión del proceso de procesamiento de imágenes del escáner. A medida que el DPI baja de 200, los bordes de los caracteres se vuelven cada vez más ambiguos — una "c" y una "e" comienzan a verse idénticas, y los trazos finos como la barra transversal de una "t" desaparecen por completo. Estos no son problemas del motor de OCR; son problemas de calidad de entrada que ninguna mejora algorítmica puede compensar por completo.
¿Cuál es la diferencia entre la precisión del OCR y la precisión de la extracción?
La precisión del OCR mide qué tan bien convierte el motor los píxeles de la imagen en caracteres de texto. La precisión de la extracción mide si el sistema identifica, extrae y estructura correctamente los datos correctos de un documento. Una herramienta puede tener una precisión de OCR perfecta — leyendo cada carácter correctamente — y aun así fallar en la extracción si etiqueta mal el total de la factura como subtotal, o no logra asociar una partida con su precio. Esta distinción es la diferencia central entre el OCR tradicional y la extracción de documentos con IA, y es por eso que evaluar una herramienta según la precisión de la extracción en lugar de la precisión del OCR es esencial para cualquier proceso empresarial que dependa de datos estructurados.
¿Puede la extracción con IA lograr una precisión del 100%?
Ninguna herramienta puede afirmar responsablemente una precisión del 100% en documentos del mundo real. Incluso los mejores modelos de visión y lenguaje ocasionalmente leen mal caracteres ambiguos, se encuentran con diseños fuera de su distribución de entrenamiento, o tienen dificultades con entradas severamente degradadas. El objetivo realista para los sistemas de extracción con IA es una precisión a nivel de campo del 99%+ en tipos de documentos bien definidos con entradas de calidad, combinada con puntuación de confianza y enrutamiento de excepciones — señalando la fracción de documentos donde el modelo no está seguro y enviándolos para revisión humana. Este enfoque híbrido (extracción automatizada + intervención humana para excepciones) es la mejor práctica de la industria para lograr un procesamiento de documentos genuinamente confiable a escala.