AI OCRと従来のOCR
もはや無視できない精度の差
2023年には、AI搭載OCRと従来のOCRの精度の差は議論の余地がありました。2026年半ばまでには、その議論は不要になります。従来のOCRエンジンが複数ベンダーの請求書バッチを処理する場合、フィールドレベルの精度は通常60%から85%の範囲に留まり、100フィールド中15〜40は人の修正が必要です。同じバッチに対するAIビジョンモデルでは、95%から99%に達します。この差はもはや「良い」「悪い」の問題ではありません。毎月の締め処理、買掛金の照合、誰かが対応しなければならない手動レビューのキューに、コスト項目として現れるのです。この記事では、実際の数値でその差を測定し、何が変わったのかを説明し、従来のOCRを使い続けることが切り替えよりもコストがかかるポイントを明らかにします。
重要なポイント
- 従来のOCRの「99%の精度」は文字を測定したものであり、データフィールドを測定したものではありません。実際の複数ベンダーの請求書では、フィールド精度は40〜60%に低下します。つまり、誰も触れる前に抽出値の半分が間違っていることになります。
- テンプレートドリフトは、最もコストのかかるOCR障害です。ベンダーがフィールドを移動すると、テンプレートは静かに誤ったデータをERPに取り込みます。エラーフラグは発生しません。そのミスは照合時に表面化し、修正には10倍のコストがかかります。
- AI抽出はピクセル座標ではなく意味で読み取ります。列名を一度入力するだけで(「請求書番号」「支払期日」など)、ImageToTable.aiはあらゆるレイアウトで即座にそれらを特定します。テンプレートのメンテナンスと静かなドリフトはなくなります。
従来のOCRができること、そしてこれまで一度もできなかったこと
光学文字認識(OCR)は、画像内のテキストを機械可読な文字に変換するという、ひとつの課題を解決するために設計されました。スキャンしたページを入力すると、文字列が出力されます。この限定的なタスクにおいて、最新のOCRエンジンは高い性能を発揮します。Googleが保守するオープンソースのベンチマークであるTesseract 5は、クリーンな印刷ドキュメントで95%の文字精度を達成しており、管理された条件下では商用エンジンに匹敵します。
しかし、文字精度はデータ精度ではありません。「1,234.56」という文字がページ上にあると認識できても、それが請求書の合計なのか、数量なのか、参照番号なのかはわかりません。従来のOCRはボトムアップ方式で動作します。個々の文字を認識し、単語にまとめ、単語をラインにグループ化します。出力は、左から右、上から下という読み順に整理されたテキストストリームです。それが何を意味するのかを理解することはありません。
その結果、レイアウトが変わるたびに、別の解析問題が発生します。請求書番号を右上隅に配置するベンダーもいれば、ロゴの下に配置するベンダーもいます。フォントを変更したり、新しいフィールドを追加したり、テーブルを並べ替えたりすると、抽出ロジックは静かに壊れます。テンプレートベースのOCRシステムは、ドキュメントタイプごとに各フィールドのピクセル座標を定義することで、この問題を解決しようとします。これは、ドキュメントセットが固定され均一な場合に機能します。しかし、複数の取引先から請求書、発注書、領収書を受け取る企業にとっては当たり前のことですが、ドキュメントが多様になると機能しなくなります。
精度の数字:2026年のベンチマークが実際に示すもの
精度のギャップは理論上の話ではありません。独立したベンチマークが、ドキュメントタイプと難易度別にその差を数値化しています。2026年半ば時点でのデータは次のとおりです:
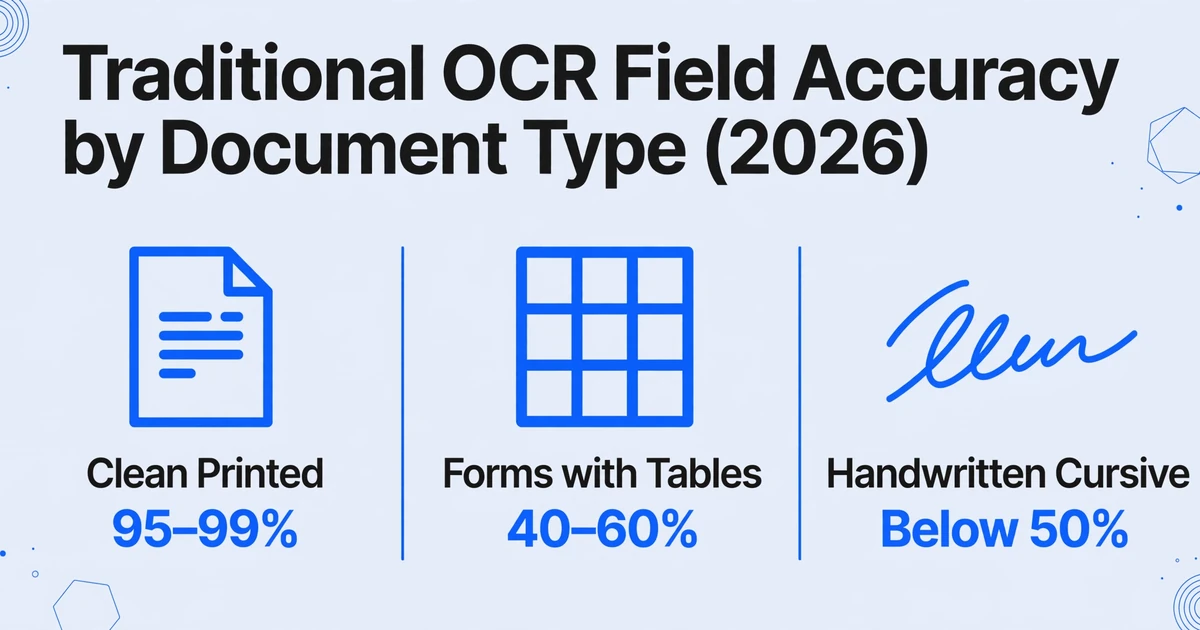
| ドキュメントタイプ | 従来のOCR | AI OCR(VLMベース) | 従来のOCRの主な失敗モード |
|---|---|---|---|
| クリーンな印刷テキスト、固定レイアウト | 95〜99% | 98〜99% | 差は最小限 — 両方とも良好に機能 |
| 表と複数列を含むフォーム | 40〜60% | 85〜95% | 抽出時に行・列が結合または消失 |
| 手書きテキスト(ブロック体) | 50〜70% | 85〜93% | 文字形状のばらつきがパターンマッチングを妨げる |
| 手書きテキスト(筆記体) | 50%未満 | 75〜85% | 連結文字が単一のグリフとして認識される |
| 複数ベンダーの請求書(多様なレイアウト) | 60〜85%(フィールドレベル) | 95〜98%(フィールドレベル) | テンプレート不一致、座標ドリフト、ラベル表記のばらつき |
出典:複雑なドキュメントの精度比較はFirstsource AIモデルベンチマーク(2026年)、従来のOCRベースラインは47Billion Tesseract vs docTR分析、両カテゴリの手書き文字数値はAIMultiple手書きOCRベンチマーク(2026年)。すべての数値はクリーンなスキャンの実験室条件ではなく、本番グレードのドキュメントにおけるフィールドレベルの精度を反映しています。
これらの数値はあるパターンを浮き彫りにします。クリーンで一貫性のあるドキュメント — 300 DPIでスキャンされ、予測可能なフィールドを持つタイプ打ちフォーム — では、従来のOCRはその価格帯で打ち負かしがたい精度を提供します。しかし、ドキュメントに表、手書き、混在レイアウト、またはソース間のフォーマットのばらつきが含まれる瞬間、精度は急落します。2025年のTesseract実務者ベンチマーク(実世界のドキュメント対象)では、重い前処理なしではフィールド精度がわずか40〜50%で、抽出されたフィールドの半分以上がデータ使用前にレビューを必要とすることを意味しました。
これらの数値には、ほとんどの比較が見逃す第二の層があります。99%の文字精度 — 数十年にわたるOCRマーケティングの標準的な主張 — は、必要なデータの99%が正しいことを意味しません。請求書ページに1,000文字あり、10文字が誤読された場合、文字精度は99%です。しかし、その10文字の誤りが、関心のある15フィールドのうち3つに該当する場合、フィールドレベルの精度は80%に低下します。TDWIはこの正確なシナリオを記録しています:ダッシュボードは99%と表示するが、ビジネスフィールドの5つに1つにエラーが含まれています。これを500枚の請求書に掛け合わせると、レビュー待ち行列が、ツールが排除するはずだったボトルネックになります。
従来のOCRが体系的に失敗する理由 — 「不正確」ではなく、構造的に盲目であること
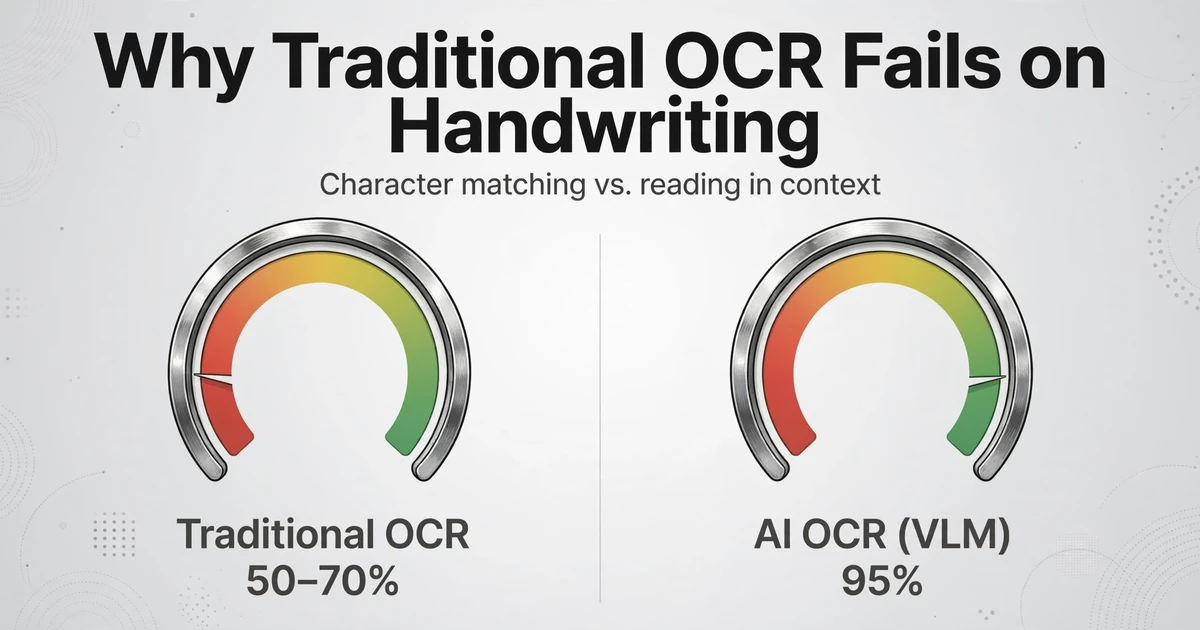
従来のOCRの失敗を「精度の問題」と表現するのは魅力的ですが、より正確には「構造的な盲点」と呼ぶべきです。つまり、ボトムアップの文字単位アプローチでは、画像品質に関係なく正しい出力を構造的に生成できないシナリオのことです。ここでは、エラー修正コストを押し上げる失敗モードを紹介します。
手書き文字。 従来のOCRは文字の形状マッチングに依存しています。「4」が「9」に見える場合、筆記体の「r」が次の文字につながる場合、横棒のある手書きの「7」をエンジンが別の文字として読む場合 — これらはすべて予測可能な失敗です。Google Cloud Vision、AWS Textract、Azure Document Intelligenceを対象とした独立したベンチマークでは、これらのシステムの手書き文字精度は50%から70%の範囲です。視覚言語モデルであるGPT-5は、文脈の中で単語を読むことで同じタスクで95%に達します — 形状だけでなく、文の中で意味が通るかどうかに基づいて文字を曖昧さを解消します。
複数列レイアウト。 従来のOCRは左から右、上から下へ読み取ります。2列の請求書 — 左にベンダー情報、ページの半分ほど下の右側に明細項目、下隅に合計ボックス — は、1つの混ざったテキストストリームとして読み取られます。エンジンには、座標グリッド以外の空間的境界の概念がありません。2025年のMicrosoftのQ&A分析では、ビジネス文書における従来のOCRの失敗の最も一般的な原因の1つとして複数列レイアウトが特定され、「行全体がスキップされる」ことが頻繁な下流症状として挙げられています。
チェックボックス、スタンプ、オーバーレイ要素。 請求書の明細項目に「PAID」スタンプが重なると、従来のOCRでは下のテキストが見えなくなります。「はい/いいえ」のチェックボックスがある保険フォームは、幾何学的形状の近くのランダムな文字として読み取られます。ロゴが口座番号に重なっている銀行取引明細書 — エンジンはデータではなくノイズを見ます。これらはエッジケースではありません。COIフォームのチェックボックス値が1つ欠落するだけで、コンプライアンス承認全体が停止する可能性があります。
低コントラストと劣化したスキャン。 感熱紙のレシートは色あせます。書類のスマートフォン写真は影や角度の歪みをもたらします。FAXされた発注書には、文字を断片に分割する圧縮アーティファクトが含まれます。従来のOCRエンジンは、200 DPI未満または不均一な照明で急激に性能が低下します。何億もの実世界の画像でトレーニングされたAI視覚モデルは、視覚的文脈を解釈することでこれらの条件を処理します — 既知のフィールド位置にあるぼやけた文字は、ピクセルが示すものだけでなく、フィールドが含むべきものから推論されます。
テンプレートドリフト。 これは静かなコストです。サプライヤーが請求書のレイアウトを再設計した場合 — PO番号を右上から配送先住所の下に移動したとします。古い座標をまだ見ている従来のOCRテンプレートは、住所を抽出してPO番号とラベル付けします。フィールドが見つかったため、エラーフラグは発生しません。データはERPに流れ込み、不一致が発見されるのは、数週間後に誰かが支払いを照合するときです。テンプレートドリフトはバグではありません — 固定座標を意味的理解の代わりに使用するシステムの予想される動作です。
AI OCRの読み取り方の違い:文字単位ではなく、ページ全体を理解する
AI搭載OCR — より正確には視覚言語モデル(VLM)抽出と呼ばれる技術 — は、人間と同じように文書を処理します。つまり、ページ全体を一度に取り込み、各領域、ラベル、値の意味を理解します。その基盤技術は、数十億の画像とテキストのペアで学習したマルチモーダルAIモデルです。スキャンされた納品書を与えられても、文字の形を探して左から右へスキャンすることはありません。文書の種類を識別し、空間レイアウトを解析し、文脈に沿ってテキストを読み取り、位置ではなく意味に基づいて各値を正しいデータフィールドにマッピングします。
この決定的な違いは、具体的な例で示すのが最もわかりやすいでしょう。請求書に次の3つのテキスト文字列があるとします。
「日付: 2026/03/15」
従来のOCRの認識:6文字の「日付」の後に10文字の「2026/03/15」が続く。これが発行日なのか、支払期日なのか、出荷日なのかは判断できない。
「支払期日: 2026/04/14」
従来のOCRの認識:さらに2つの単語と10文字。これを上の「日付」と関連付けたり、両者を区別したりすることはできない。どちらも日付形式の単なるテキスト文字列に過ぎない。
「請求日: 2026/03/15」
従来のOCRの認識:さらに2つの単語、同じ日付。エンジンにとっては、最初の2つとは無関係な3つ目のテキスト文字列。意味的な関連付けは一切行われない。
AI OCRは3つの異なるデータフィールドとして認識します。ラベル(「日付」「支払期日」「請求日」)を読み取り、請求書の文脈におけるそれぞれの意味を理解し、各値をスプレッドシートの正しい列に配置します。請求日は請求日の列に、支払期日は支払期日の列に入ります。「請求日」がヘッダーに、「支払期日」が支払条件セクションに、単なる「日付」が明細行にある場合でも、モデルはピクセルの位置ではなく、周囲の文脈に基づいて曖昧さを解消します。
この意味理解こそが、AI抽出をテンプレート不要にしている理由であり、最新のデータ抽出ソフトウェアと従来のOCRツールを区別する点です。ベンダーごとの請求書レイアウトで「請求書番号」のピクセル座標を定義する必要はありません。抽出したい列名(「請求書番号」「支払期日」「ベンダー名」「明細合計」)を入力するだけで、AIがその意味を理解してページ上のどこからでも各値を特定します。入力した列名が最終的なスプレッドシートのヘッダーになります。この仕組みをカスタム列抽出と呼びます。出力スキーマを記述すると、AIがベンダーが各フィールドを配置した場所に関係なく、ドキュメントの内容を列にマッピングします。
ファイルは安全に処理され、保存されることはありません。
上のデモは、請求書での動作を示しています。任意の列名を入力すると、ページ上のどこに値があってもAIが特定する様子を確認できます。「請求書番号」「支払期日」「ベンダー名」などをお試しください。同じ仕組みは、銀行明細書、発注書、領収書、そして情報がデータベースのフィールドではなく視覚的なレイアウトに存在するあらゆるドキュメントで同様に機能します。
従来型OCRが依然として優位な領域——その重要性
AIの利点だけを語る比較は、分析ではなく営業トークです。従来型OCRには特定のシナリオで正しい選択となる真の強みがあり、それを認めることでこそ、AIが適用可能な場合の主張に信頼性が生まれます。
標準化された文書の大量処理。 毎年100万枚のW-2税務フォームを処理する場合——同一レイアウト、鮮明な活字、予測可能なフィールド——適切に管理されたテンプレートを用いた従来型OCRは、AI抽出ツールの文書単価を大幅に下回るコストでほぼ完璧な精度を実現します。テンプレート設定は一度きりの投資で、数百万枚の同一文書にわたって償却されます。この規模では、1ページあたり0.01ドルのOCR API呼び出しと0.05ドルのVLM抽出呼び出しの差は、100万ページあたり4万ドルの節約になります。
バリエーションのないクリーンでシンプルな文書。 1ページのテキスト文書——タイプされた手紙、簡単なメモ、一貫したフォーマットの銀行取引明細書——は、従来型OCRにとって解決済みの問題です。Tesseractなどのエンジンは、99%以上の精度とサブ秒の処理時間でこれらを処理します。AIレイヤーを追加すると、価値を追加せずにコストが増加します。
予算制約があり、入力が均一な環境。 1つの取引先から1つの請求書フォーマットのみを受け取り、バリエーションも複雑性もない組織は、AI抽出を必要としない可能性があります。オープンソースのOCRは無料です。単一レイアウトのための単一テンプレートを構築する労力は、数時間で計測される一度きりのコストです。この限定的なシナリオでは、AIツールの追加サブスクリプションコストを正当化するのは困難です。
検索のためのアーカイブテキストのデジタル化。 目的が構造化データ抽出ではなく、全文検索——歴史的文書のコーパスをキーワードで検索可能にすること——である場合、従来型OCRが効率的な選択肢です。どのテキストが日付でどれが名前かを知る必要はありません。ページ上にどのテキストがあるかを知る必要があるだけです。従来型OCRはまさにそれを、大規模に、かつ優れた性能で実現します。
クロスオーバーポイント:エラー修正コストがサブスクリプションコストを上回る時
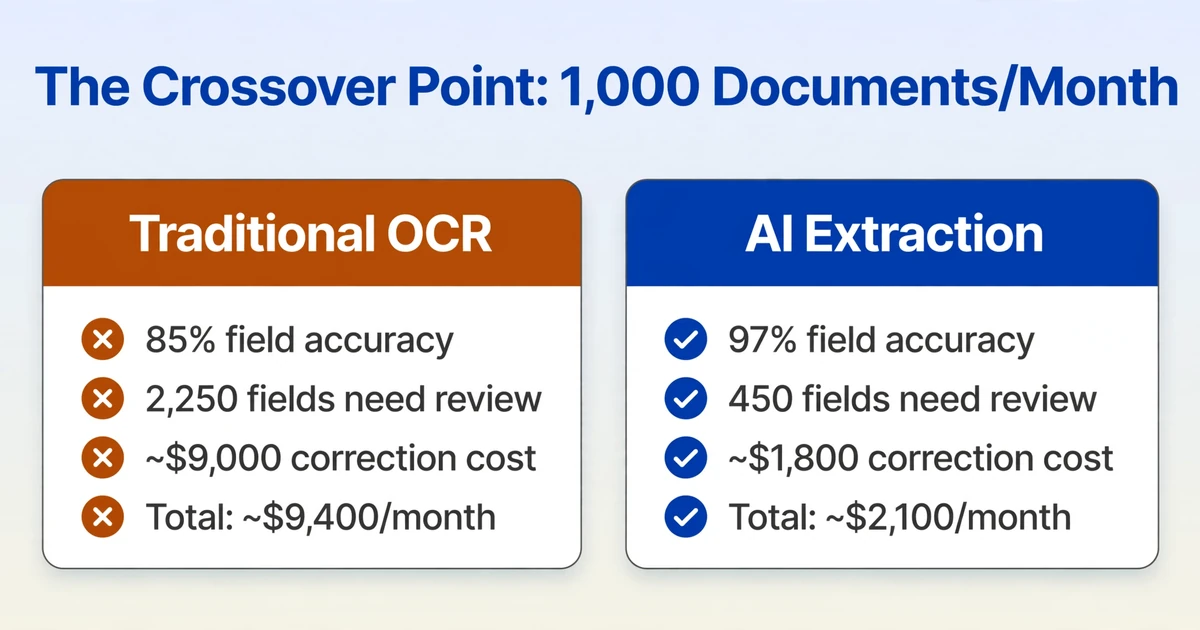
従来のOCRとAI抽出の間の経済的判断は、ドキュメントの多様性、複雑性、処理量という3つの変数に依存します。多様性と複雑性が低く、処理量が極めて多い場合、従来のOCRがコスト面で優位です。多様性または複雑性が閾値を超えると、計算は逆転します。
実用的な規模でのクロスオーバーの計算を示します。月間1,000ドキュメントを処理するチームを想定します。各ドキュメントには15フィールドの抽出が必要です。基準は以下の通りです:
| シナリオ | フィールド精度 | 月間確認が必要なフィールド数 | 修正コスト* | ツールコスト | 月間合計 |
|---|---|---|---|---|---|
| 従来のOCR(テンプレート) | 85%(多様な請求書) | 2,250フィールド | 約$9,000 | $200–500 | 約$9,400 |
| AI抽出 | 97%(多様な請求書) | 450フィールド | 約$1,800 | $50–300 | 約$2,100 |
* フィールド修正1件あたり$4(確認、照合、再入力)で試算。出典:データ入力エラーコスト分析(2026年)。実際の人件費は地域や役割によって異なります。
月間1,000ドキュメント、各15フィールド、中程度のレイアウトのばらつきの場合、85%と97%の間の12ポイントの精度差は、人間による確認が必要なフィールドを1,800件減らすことになり、月間約$7,200の回避可能な修正作業コストに相当します。正確なクロスオーバーポイントは処理量とドキュメントの複雑性によって変わりますが、パターンは一貫しています:フィールドレベルの精度が90%を下回ると、エラー修正のコストがツールのコストをはるかに上回ります。
クロスオーバーのもう一つの側面はテンプレートメンテナンスです。チームが50種類の異なるベンダーレイアウト用のテンプレートを維持し、各ベンダーが12〜18ヶ月ごとにレイアウトを変更する場合、チームは継続的にテンプレートを再構築することになります。1つのテンプレートの設定には30〜60分かかります。3つのベンダーが毎月請求書フォーマットを更新する場合、毎月1.5〜3時間のテンプレート作業が無期限に発生します。AI抽出は意味に基づいて読み取るため座標に依存せず、これを完全に排除します。
第三の次元は、従来のOCRではまったく検出できないエラーです。テンプレートベースの抽出では、値が間違っていてもフラグは立ちません。期待される座標から値が欠落している場合のみフラグが立ちます。テンプレートがずれて誤った位置からPO番号が抽出されても、システムが検出する「エラー」にはなりません。そのデータはERPに流れ込み、数週間後に照合の問題を引き起こします。これらの未検出エラーは最もコストがかかる種類です。処理後に発見されたデータ入力エラーの平均的な下流修正コストは50~500ドルであるのに対し、レビュー中に発見されたエラーは3~5ドルです。テンプレートのずれは、この高コストなエラーを大規模に生み出します。
切り替えた後の変化:比較表
抽象的な数字は意思決定に役立ちます。具体的な例は、その数字が実際に何を意味するかを理解するのに役立ちます。同じ請求書バッチを、2つの処理アプローチで比較します。
| 項目 | 従来のOCR(テンプレート方式) | AI抽出 |
|---|---|---|
| 20社の取引先設定 | 20テンプレート × 各30分 = 10時間 | 列名を一度定義 = 2分 |
| 21社目の取引先追加 | 新しいテンプレート作成 = 30分 | 変更不要。同じ列名がどのレイアウトでも機能。 |
| 5社目の取引先がレイアウト変更 | データが静かに誤った場所へ。照合時に発覚。 | 意味に基づきフィールド検出。レイアウト変更は影響なし。 |
| 請求書の手書きメモ | 判読不可。フィールドが空白か、ゴミ文字で埋まる。 | 文脈で読取可能。「Priority:」横の筆記体「rush」が値に。 |
| スマホ撮影のレシート | 角度歪み+低コントラスト=使い物にならない出力 | 視覚的文脈で補正。かすれた感熱紙も読取可能。 |
| チェックボックス形式の項目 | 四角の近くにランダムな文字。手動確認必須。 | 視覚的顕著性でチェックされた選択肢を識別。「はい」か「いいえ」を抽出。 |
| 50枚の請求書、15社の取引先、1つの出力 | 各取引先をテンプレートで処理。出力を統合。不一致を修正。 | 50枚すべてをアップロード。列名を一度定義。統合Excelをダウンロード。 |
最も参考になる例は「ベンダー5がレイアウトを再設計」の行です。従来のOCRでは、エラーは目に見えません。テンプレートは期待された座標にあるテキストを、それが正しいテキストかどうかに関わらず返します。AIの列では、レイアウトの変更は無関係です。抽出がテキストの位置ではなく意味に基づいているからです。この唯一の違い——静的なテンプレートのずれと、レイアウトに影響されない抽出——が、後続の照合コストにおいて他のどの要因よりも大きな差を生みます。
ハイブリッドアプローチは、複数の文書タイプを処理するチームにとって検討に値します。大規模な文書抽出を行う多くの組織——r/mlopsやr/fintechなどのRedditコミュニティで観察されるように——階層型パイプラインを運用しています。テンプレートが確実に機能する高頻度・標準化された文書タイプには従来のOCRを、テンプレートのメンテナンスコストが代替手段を上回る可変・複雑・手書き文書にはAI抽出を使用します。ルーティングのロジックはシンプルです。文書が既知のテンプレートと高い信頼度で一致すればOCRで処理し、一致しない場合や信頼度が閾値を下回った場合はAI抽出に回します。これにより、従来のOCRのコスト優位性を活かしつつ、適用できない場面でのエラー修正コストを回避できます。
よくある質問
ChatGPTやClaudeをそのまま文書データ抽出に使えますか?
1回限りの文書であれば、はい。GPT-5は手書き文字に対して95%の精度を達成し、複合フォーマットの文書も適切に処理します。しかし、汎用チャットボットはバッチ処理向けに設計されていません。50枚の請求書をアップロードし、全文書にわたって一貫した列を持つ1つの統合スプレッドシートを得る、といった処理です。文書ごとに個別の会話が必要で、列名を毎回指定し直さなければならず、出力を1つの構造化ファイルに統合する仕組みも組み込まれていません。1回限りの抽出にはチャットボットで十分ですが、定期的な大量文書処理には、専用の抽出ツールがバッチ処理、スキーマの一貫性、エクスポートワークフローを提供します。これらはチャットボットがサポートするようには設計されていない機能です。
従来のOCRとAI抽出では、ドキュメント1件あたりの実際のコストにどれだけの差がありますか?
従来のOCRは、スケール時のAPI価格で1ページあたり約$0.01〜$0.05です。AI抽出は1ページあたり約$0.05〜$0.30です。ソフトウェアの直接コスト差はおよそ3〜10倍です。しかし、エラー修正の労力、テンプレートのメンテナンス、下流でのエラーコストを含む総所有コスト(TCO)を考慮すると、月に約200件以上の多様なドキュメントを処理するワークフローでは、通常、比較結果が逆転します。無料のOCRと有料のAI抽出の比較では、TCOの全内訳を詳しく説明しています。
AI OCRは手書きのドキュメントでも機能しますか?
はい、機能します。そして、ここでの差は印刷テキストよりも大きくなります。従来のOCRエンジンは手書き文字で50〜70%の精度です。視覚言語モデルは、文脈理解を使用することで、同じドキュメントで85〜95%に達します。モデルは、特定のフィールドで日付がどのように見えるべきかを知っており、その知識を使って不明瞭な文字を判別します。筆記体の手書き文字では、その差はさらに広がります。従来のOCRは50%を下回る一方、VLMベースの抽出は75〜85%を維持します。限界は確かにあります。非常に読みにくい筆記体、トレーニングデータが限られた非ラテン文字、極端な角度の手書き文字は、依然としてすべてのシステムにとって困難です。しかし、手書き文字におけるAI抽出の相対的な優位性は、あらゆるドキュメントタイプの中で最大です。
AI抽出は、どのくらいのドキュメント量からコスト効率が良くなりますか?
その分岐点は、単純な量よりもドキュメントの多様性に依存します。固定レイアウトの3社のベンダーから月に100件のドキュメントを処理するチームは、分岐点を超えないかもしれません。しかし、多様なレイアウトの20社のベンダーから月に200件のドキュメントを処理するチームは、すぐに分岐点を超えます。テンプレートのメンテナンスだけで、AIサブスクリプションのコストよりも多くの労働時間を消費するからです。経験則として、10種類以上の異なるドキュメントレイアウトのテンプレートを維持しているなら、すでに分岐点を超えています。あらゆるボリューム層における現在のツールコストについては、2026年のAIドキュメント抽出価格動向をご覧ください。
本番環境でのAI抽出で期待できる精度はどのくらいですか?
多様なビジネス文書におけるフィールドレベルの精度95〜97%は、現在のVLM(視覚言語モデル)ベンチマークに基づく現実的な本番環境での期待値です。クリーンで標準化された文書では98〜99%に達します。ファックス、感熱紙レシート、スタンプが文字に重なった文書など、劣化が激しい文書では85〜93%を期待してください。重要なのは文字精度とフィールド精度の違いです。文字精度99%を報告するツールでも、誤読した文字が重要なデータポイントに該当する場合、フィールド精度は80%しかない可能性があります。常にフィールドレベルで精度を測定してください。つまり、正しい列に正しい値で格納されたフィールドの割合です。処理規模での精度数値の意味について詳しくは、AI抽出精度の実践ガイドをご覧ください。
従来のOCRに将来性はありますか?
はい、3つの役割があります。第一に、AI抽出パイプライン内のテキスト認識レイヤーとしてです。多くのVLMベースのシステムは、テキスト中心の文書の前処理ステップとして依然としてOCRを使用しています。第二に、テンプレートコストが効率的に償却される大量の標準化文書処理です。第三に、構造化データ抽出ではなく全文検索を目的としたアーカイブのデジタル化プロジェクトです。従来のOCRは時代遅れではありません。その役割は、そのアーキテクチャ上の前提(固定レイアウト、クリーンなテキスト、文字レベル出力)が実際の文書特性と一致する特定のユースケースに縮小しているのです。
どこから始めるか
従来のOCRとAI抽出のギャップは縮まっていません。視覚言語モデルは複雑な文書で改善を続けており、GPT-5の2026年の手書き文字精度95%は、2025年のGPT-4の85%から向上しています。一方、従来のOCRエンジンは数十年にわたり同じ文字照合アプローチを改良してきました。精度のギャップは今やコストのギャップとなり、手動レビューの待ち行列、テンプレートの再構築、静かに誤った方向に送られたデータに起因する照合の問題など、あらゆる場面で顕在化しています。
あなたの文書がクロスオーバーポイントのどちら側にあるかを確認する簡単な方法があります。現在のプロセスで問題を起こした請求書を、テンプレート不要のAI抽出ツールにアップロードしてください。必要なフィールド名を入力し、値がどこに格納されるかを確認します。AI抽出が文字レベルではなくデータレベルでOCRとどう異なるかについては、AIデータ入力とOCRの比較解説で実際の例を用いて出力の違いを説明しています。このテストを実行するコストは数分です。実際の精度を知らないまま放置するコストは、毎月積み重なっていきます。