AI OCR vs OCR tradicional
La brecha de precisión que ya no puede ignorar
En 2023, la brecha de precisión entre el OCR impulsado por IA y el OCR tradicional era debatible. A mediados de 2026, ya no lo es. Cuando un motor de OCR tradicional procesa un lote de facturas de múltiples proveedores, la precisión a nivel de campo suele situarse entre el 60% y el 85%, lo que significa que entre 15 y 40 de cada 100 campos necesitan corrección humana. Un modelo de visión de IA en el mismo lote: 95% a 99%. La brecha ya no se trata de "mejor" o "peor". Se ha convertido en una partida de coste que aparece en cada cierre mensual, en cada conciliación de cuentas por pagar, en cada cola de revisión manual que alguien tiene que dotar de personal. Este artículo mide esa brecha con números reales, explica qué ha cambiado y señala el punto en el que seguir con el OCR tradicional cuesta más que cambiar.
Conclusiones clave
- La "precisión del 99%" del OCR tradicional mide caracteres, no campos de datos. En facturas reales de múltiples proveedores, la precisión de campos cae al 40–60%: la mitad de los valores extraídos son incorrectos antes de que nadie los toque.
- La deriva de plantilla es el fallo más costoso del OCR: cuando un proveedor mueve un campo, la plantilla extrae silenciosamente el dato incorrecto a su ERP. No se activa ninguna alerta de error. El error sale a la luz en la conciliación, cuando corregirlo cuesta 10 veces más.
- La extracción con IA lee por significado, no por coordenadas de píxeles. Escriba los nombres de sus columnas una sola vez — "Número de factura", "Fecha de vencimiento" — e ImageToTable.ai los localiza en cualquier diseño al instante. El mantenimiento de plantillas y la deriva silenciosa desaparecen.
Qué hace el OCR tradicional — y lo que nunca ha hecho
El reconocimiento óptico de caracteres fue diseñado para resolver un problema: convertir una imagen de texto en caracteres legibles por máquina. Una página escaneada entra; una cadena de caracteres sale. Para esa tarea específica, los motores de OCR modernos funcionan bien. Tesseract 5, el estándar de código abierto mantenido por Google, alcanza un 95% de precisión de caracteres en documentos impresos limpios, comparable a los motores comerciales en condiciones controladas.
Pero la precisión de caracteres no es precisión de datos. Saber que los caracteres "1,234.56" aparecen en una página no le indica si se trata de un total de factura, una cantidad o un número de referencia. El OCR tradicional funciona de abajo hacia arriba: reconoce caracteres individuales, los agrupa en palabras y organiza las palabras en líneas. El resultado es un flujo de texto ordenado según el orden de lectura: de izquierda a derecha, de arriba a abajo. No tiene comprensión alguna de lo que significa.
La consecuencia posterior es que cada variación de diseño se convierte en un problema de análisis separado. Un proveedor que coloca el número de factura en la esquina superior derecha produce un mapa de coordenadas. Otro que lo coloca debajo del logotipo produce otro. Cambie la fuente, añada un nuevo campo, reorganice una tabla — y la lógica de extracción falla silenciosamente. Los sistemas de OCR basados en plantillas intentan resolver esto definiendo coordenadas de píxeles para cada campo en cada tipo de documento. Esto funciona cuando su conjunto de documentos es fijo y homogéneo. Se derrumba cuando los documentos varían, que es la norma para cualquier empresa que recibe facturas, órdenes de compra o recibos de más de una fuente.
Las cifras de precisión: qué muestran realmente los benchmarks de 2026
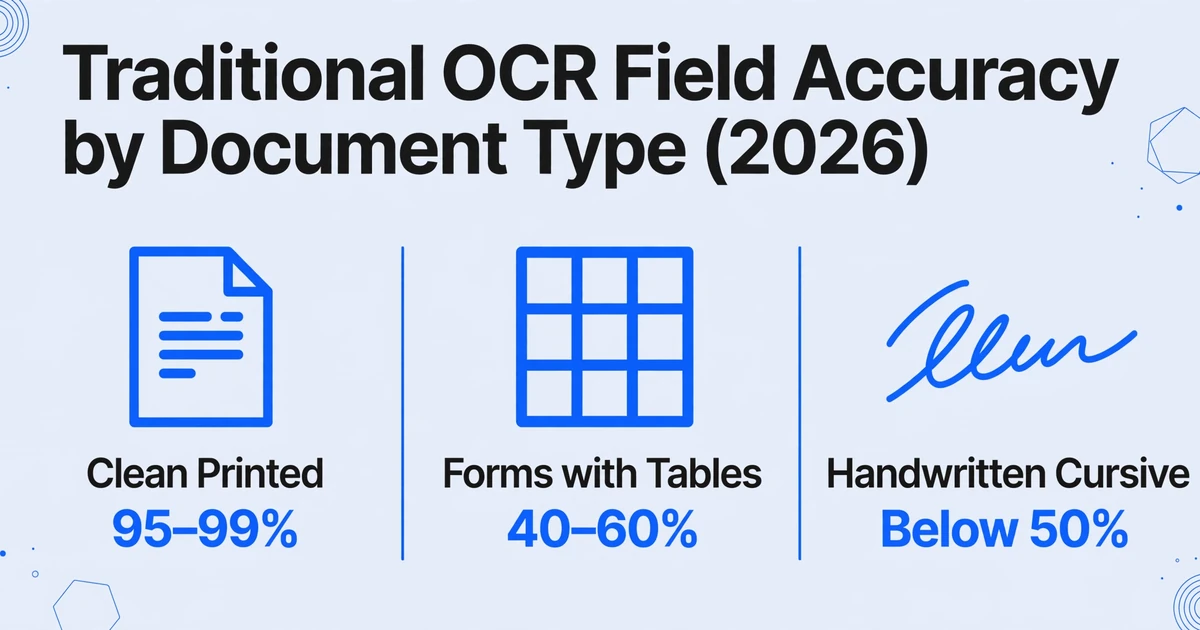
La brecha de precisión no es teórica. Los benchmarks independientes ahora la cuantifican según el tipo de documento y el nivel de dificultad. Esto es lo que dicen los datos a mediados de 2026:
| Tipo de documento | OCR tradicional | AI OCR (basado en VLM) | Modo de fallo clave para el tradicional |
|---|---|---|---|
| Texto impreso limpio, formato fijo | 95–99% | 98–99% | Diferencia mínima: ambos funcionan bien |
| Formularios con tablas y columnas mixtas | 40–60% | 85–95% | Filas/columnas fusionadas o perdidas en la extracción |
| Texto manuscrito (letra de imprenta) | 50–70% | 85–93% | La variación morfológica de caracteres supera el reconocimiento de patrones |
| Texto manuscrito (cursiva) | Menos del 50% | 75–85% | Los caracteres conectados se leen como glifos únicos |
| Facturas de múltiples proveedores (formatos variados) | 60–85% (a nivel de campo) | 95–98% (a nivel de campo) | Desajuste de plantilla; deriva de coordenadas; variación en etiquetas |
Fuentes: benchmarks del modelo de IA de Firstsource (2026) para comparaciones de precisión en documentos complejos; análisis Tesseract vs. docTR de 47Billion para líneas base de OCR tradicional; benchmark de OCR de escritura a mano de AIMultiple (2026) para cifras de escritura a mano en ambas categorías. Todos los números reflejan la precisión a nivel de campo en documentos de grado de producción, no condiciones de laboratorio con escaneos limpios.
Estos números revelan un patrón. En documentos limpios y consistentes — un formulario mecanografiado escaneado a 300 DPI con campos predecibles — el OCR tradicional ofrece una precisión difícil de superar por su precio. Pero en cuanto los documentos incluyen tablas, escritura a mano, formatos mixtos o variación de formatos entre fuentes, la caída es pronunciada. Un benchmark práctico de Tesseract de 2025 sobre documentos del mundo real encontró solo un 40–50% de precisión de campo sin un preprocesamiento intensivo — lo que significa que más de la mitad de los campos extraídos requerían revisión antes de que los datos fueran utilizables.
Hay una segunda capa en estos números que la mayoría de las comparaciones pasan por alto. Una cifra de precisión de caracteres del 99% — el reclamo de marketing estándar del OCR durante décadas — no significa que el 99% de los datos que necesita sea correcto. Si una página de factura tiene 1,000 caracteres y 10 se leen mal, la precisión de caracteres es del 99%. Pero si esos 10 caracteres incorrectos caen dentro de 3 de los 15 campos que le interesan, la precisión a nivel de campo cae al 80%. TDWI documentó este escenario exacto: el panel indica 99%, pero 1 de cada 5 campos comerciales contiene un error. Multiplique esto en 500 facturas y la cola de revisión se convierte en el cuello de botella que la herramienta debía eliminar.
Donde el OCR tradicional falla sistemáticamente: no es «inexactitud», es ceguera estructural
Es tentador describir los fallos del OCR tradicional como problemas de precisión. Es más preciso llamarlos puntos ciegos estructurales: escenarios donde el enfoque ascendente, carácter por carácter, es arquitectónicamente incapaz de producir una salida correcta, independientemente de la calidad de la imagen. Estos son los modos de fallo que elevan los costos de corrección de errores:
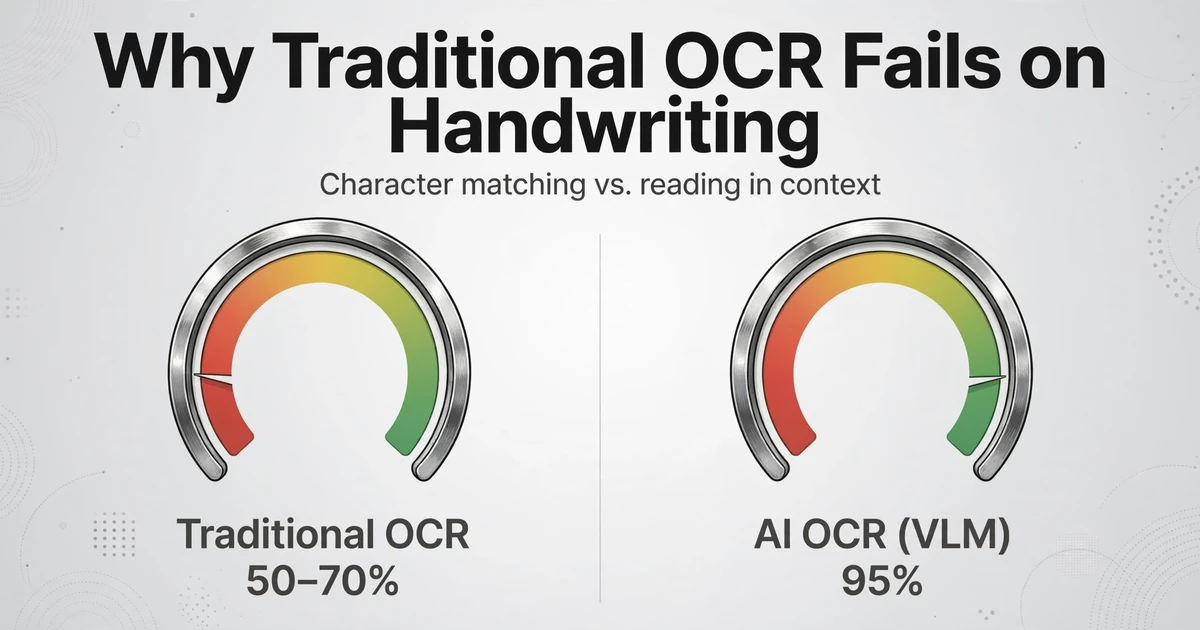
Escritura a mano. El OCR tradicional se basa en la coincidencia de formas de caracteres. Un «4» que parece un «9», una «r» cursiva que se conecta con la siguiente letra, un «7» manuscrito con una barra transversal que el motor lee como un carácter separado: cada uno es un fallo predecible. Evaluaciones comparativas independientes de Google Cloud Vision, AWS Textract y Azure Document Intelligence muestran una precisión de escritura a mano de entre el 50% y el 70% para estos sistemas. GPT-5, un modelo de visión y lenguaje, alcanza el 95% en la misma tarea al leer palabras en contexto: desambiguando caracteres según lo que tiene sentido en una oración, no solo según la forma que tienen.
Diseños de varias columnas. El OCR tradicional lee de izquierda a derecha, de arriba a abajo. Una factura de dos columnas —datos del proveedor a la izquierda, partidas a la derecha a mitad de página, un cuadro de total en la esquina inferior— se lee como un flujo de texto desordenado. El motor no tiene concepto de límites espaciales más allá de su cuadrícula de coordenadas. Un análisis de Microsoft Q&A de 2025 sobre fallos del OCR tradicional en documentos comerciales identificó el diseño de varias columnas como una de las causas más comunes de que los datos lleguen al campo equivocado, con «filas enteras omitidas» como síntoma descendente frecuente.
Casillas de verificación, sellos y elementos superpuestos. Un sello de «PAGADO» superpuesto en una partida de factura hace que el texto subyacente sea invisible para el OCR tradicional. Un formulario de seguro con casillas de verificación para opciones de «Sí / No» se lee como caracteres aleatorios cerca de formas geométricas. Un extracto bancario con un logotipo que se superpone al número de cuenta: el motor ve ruido, no datos. Estos no son casos extremos. Un solo valor de casilla de verificación faltante en un formulario de COI puede detener por completo una aprobación de cumplimiento.
Bajo contraste y escaneos degradados. Los recibos de papel térmico se desvanecen. Las fotos de documentos tomadas con el teléfono introducen sombras y distorsión de ángulo. Las órdenes de compra enviadas por fax llegan con artefactos de compresión que dividen los caracteres en fragmentos. Los motores de OCR tradicional se degradan notablemente por debajo de 200 DPI o con iluminación no uniforme. Los modelos de visión de IA, entrenados con miles de millones de imágenes del mundo real, manejan estas condiciones interpretando el contexto visual: un carácter borroso en una posición de campo conocida se infiere de lo que se supone que contiene el campo, no solo de lo que muestran los píxeles.
Deriva de plantilla. Este es el costo silencioso. Un proveedor rediseña el diseño de su factura: mueve el número de orden de compra de la esquina superior derecha a debajo de la dirección de envío. La plantilla de OCR tradicional, que aún mira las coordenadas antiguas, extrae una dirección postal y la etiqueta como número de orden de compra. No se activa ninguna alerta de error porque el campo se encontró. Los datos fluyen a su ERP, y el desajuste se descubre cuando alguien concilia el pago semanas después. La deriva de plantilla no es un error: es el comportamiento esperado de cualquier sistema que usa coordenadas fijas en lugar de comprensión semántica.
Cómo la IA OCR lee de forma diferente: la página completa, no caracteres individuales
La OCR impulsada por IA —más precisamente llamada extracción con modelo de lenguaje y visión (VLM)— procesa un documento como lo haría una persona: captando la página completa de una vez y entendiendo qué significa cada región, etiqueta y valor. La tecnología subyacente es un modelo de IA multimodal entrenado con miles de millones de pares imagen-texto. Cuando le das un albarán escaneado, no escanea de izquierda a derecha buscando formas de caracteres. Identifica el tipo de documento, analiza la disposición espacial, lee el texto en contexto y asigna cada valor al campo de datos correcto según su significado, no su posición.
La diferencia crucial se ilustra mejor con un ejemplo concreto. Considera tres cadenas de texto en una factura:
"Fecha: 15/03/2026"
La OCR tradicional ve: seis caracteres "Fecha" seguidos de diez caracteres "15/03/2026". No sabe si es la fecha de emisión, la fecha de vencimiento o la fecha de envío.
"Fecha de vencimiento: 14/04/2026"
La OCR tradicional ve: dos palabras más y diez caracteres más. No puede relacionarlo con "Fecha" de arriba ni distinguir una de otra. Ambas son solo cadenas de texto con formato de fecha.
"Fecha de factura: 15/03/2026"
La OCR tradicional ve: dos palabras más, misma fecha. Para el motor, esta es una tercera cadena de texto, sin relación con las dos primeras. No se establece ninguna conexión semántica.
La IA OCR ve tres campos de datos diferentes. Lee las etiquetas ("Fecha", "Fecha de vencimiento", "Fecha de factura"), entiende qué significa cada una en el contexto de una factura y coloca cada valor en la columna correcta de tu hoja de cálculo. La Fecha de factura va en la columna Fecha de factura. La Fecha de vencimiento va en la columna Fecha de vencimiento. Incluso si "Fecha de factura" aparece en el encabezado, "Fecha de vencimiento" en la sección de condiciones de pago y una "Fecha" simple en una fila de línea de pedido, el modelo desambigua según el contexto circundante, no la ubicación de los píxeles.
Esta comprensión semántica es lo que hace que la extracción con IA sea sin plantilla — y es la distinción que separa el software moderno de extracción de datos de las herramientas de OCR tradicionales. No necesita definir coordenadas de píxeles para "Número de Factura" en el diseño de factura de cada proveedor. Usted escribe los nombres de las columnas que desea extraer — "Número de Factura", "Fecha de Vencimiento", "Nombre del Proveedor", "Total de Línea" — y la IA localiza cada valor en cualquier parte de la página al comprender su significado. Los nombres de las columnas que escribe se convierten en los encabezados de su hoja de cálculo final. Este mecanismo se denomina Extracción de Columnas Personalizadas: usted describe el esquema de salida y la IA asigna el contenido del documento a sus columnas, independientemente de dónde haya colocado el proveedor cada campo.
Los archivos se procesan de forma segura y no se almacenan.
La demostración anterior muestra esto en acción en una factura: escriba cualquier nombre de columna y observe cómo la IA localiza el valor sin importar dónde se encuentre en la página. Pruebe con "Número de Factura", "Fecha de Vencimiento" o "Nombre del Proveedor". El mismo mecanismo funciona de manera idéntica en extractos bancarios, órdenes de compra, recibos y cualquier documento donde la información reside en un diseño visual en lugar de un campo de base de datos.
Donde la OCR tradicional aún gana — y por qué importa
Una comparación que solo habla de las ventajas de la IA es un discurso de ventas, no un análisis. La OCR tradicional tiene fortalezas reales que la convierten en la opción correcta en escenarios específicos, y reconocerlas es lo que hace creíble el caso de la IA cuando aplica.
Documentos estandarizados a gran escala. Si procesas un millón de formularios W-2 al año — diseño idéntico, texto mecanografiado limpio, campos predecibles — la OCR tradicional con una sola plantilla bien mantenida ofrece una precisión casi perfecta a una fracción del costo por documento de cualquier herramienta de extracción con IA. La configuración de la plantilla es una inversión única que se amortiza en millones de documentos idénticos. A esa escala, una llamada API de OCR de $0.01 por página frente a una llamada de extracción VLM de $0.05 ahorra $40,000 por millón de páginas.
Documentos limpios y simples sin variación. Un documento de texto de una sola página — una carta mecanografiada, un memo simple, un extracto bancario limpio con formato consistente — es un problema resuelto para la OCR tradicional. Tesseract y motores similares los manejan con más del 99% de precisión y tiempos de procesamiento de menos de un segundo. Agregar una capa de IA añade costo sin agregar valor.
Entornos con presupuesto limitado y entrada homogénea. Una organización que recibe solo un formato de factura de un solo proveedor, sin variación ni complejidad, puede no necesitar extracción con IA. La OCR de código abierto es gratuita. El trabajo de crear una sola plantilla para un solo diseño es un costo único que se mide en horas. En este escenario limitado, el costo adicional de suscripción de una herramienta de IA es difícil de justificar.
Digitalización de texto de archivo para búsqueda. Cuando el objetivo es la búsqueda de texto completo — hacer que un corpus de documentos históricos sea buscable por palabra clave — en lugar de la extracción de datos estructurados, la OCR tradicional es la opción eficiente. No necesitas saber qué texto es una fecha y cuál es un nombre. Necesitas saber qué texto está en la página. La OCR tradicional hace exactamente eso, y lo hace bien a escala.
El punto de cruce: cuando los costos de corrección de errores superan los costos de suscripción
La decisión económica entre el OCR tradicional y la extracción con IA es función de tres variables: la variedad de documentos, la complejidad de los documentos y el volumen de procesamiento. Cuando la variedad y la complejidad son bajas y el volumen es extremadamente alto, el OCR tradicional gana en costo. Cuando la variedad o la complejidad superan un umbral, las matemáticas se invierten.
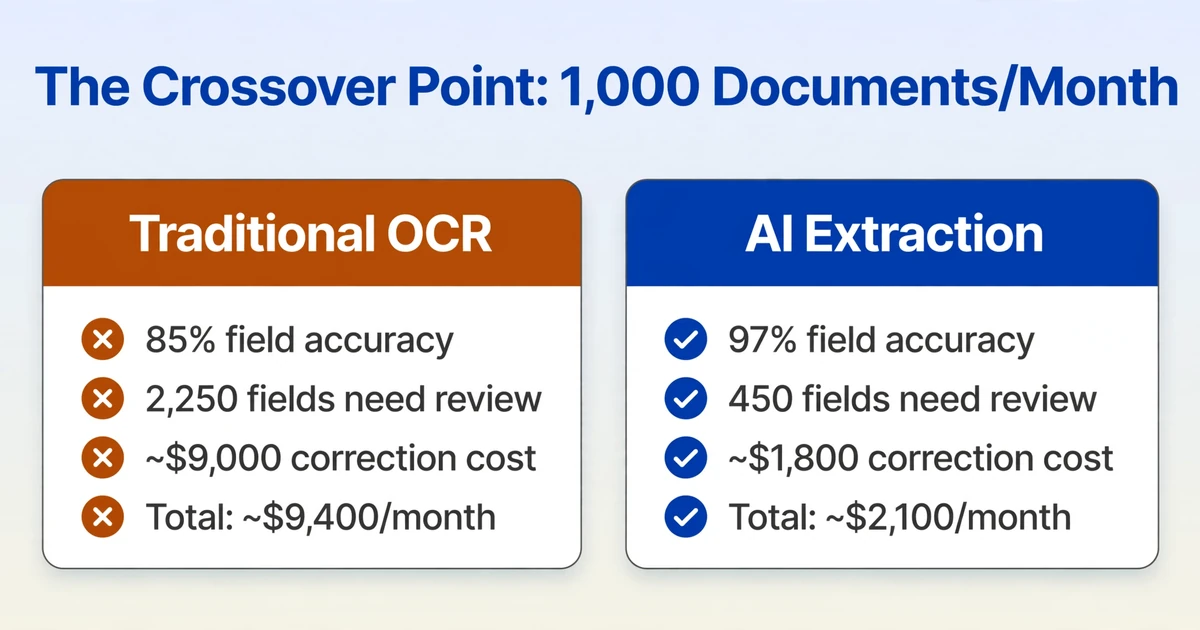
Aquí está la aritmética del punto de cruce a una escala práctica. Supongamos un equipo que procesa 1000 documentos al mes. Cada documento tiene 15 campos que requieren extracción. La línea de base:
| Escenario | Precisión de campos | Campos que requieren revisión / mes | Costo de corrección* | Costo de la herramienta | Total mensual |
|---|---|---|---|---|---|
| OCR tradicional (plantillas) | 85 % (facturas variadas) | 2250 campos | ~$9000 | $200–500 | ~$9400 |
| Extracción con IA | 97 % (facturas variadas) | 450 campos | ~$1800 | $50–300 | ~$2100 |
* Estimado en $4 por corrección de campo (revisión, consulta, reingreso). Fuente: análisis de costos de errores de entrada de datos (2026). Los costos laborales reales varían según la región y el rol.
Con 1000 documentos al mes, 15 campos cada uno y una variación moderada del diseño, la diferencia de precisión de 12 puntos entre el 85 % y el 97 % se traduce en 1800 campos menos que requieren revisión humana, aproximadamente $7200 al mes en mano de obra de corrección evitable. El punto de cruce exacto cambia con el volumen y la complejidad de los documentos, pero el patrón es consistente: cuando la precisión a nivel de campo cae por debajo del 90 %, el costo de corregir errores supera con creces el costo de la herramienta.
Una segunda dimensión del punto de cruce es el mantenimiento de plantillas. Cuando un equipo mantiene plantillas para 50 diseños de proveedores diferentes y cada proveedor cambia su diseño una vez cada 12 a 18 meses, el equipo está reconstruyendo plantillas continuamente. Una sola plantilla tarda de 30 a 60 minutos en configurarse. Si tres proveedores actualizan su formato de factura mensualmente, eso supone de 1,5 a 3 horas de trabajo de plantilla, todos los meses, indefinidamente. La extracción con IA elimina esto por completo porque lee por significado, no por coordenadas.
La tercera dimensión son los errores que el OCR tradicional no detecta en absoluto. La extracción basada en plantillas no señala cuándo un valor es incorrecto; solo lo hace cuando falta un valor en las coordenadas esperadas. Un número de orden de compra extraído de la posición incorrecta porque la plantilla se desvió no es un "error" que el sistema detecte. Son datos que fluyen a tu ERP y generan un problema de conciliación semanas después. Estos errores no detectados son los más costosos: el costo promedio de corrección posterior para un error de ingreso de datos detectado después del procesamiento es de $50–$500, frente a $3–$5 por un error detectado durante la revisión. La desviación de plantillas genera el tipo costoso a gran escala.
Qué Cambia al Migrar: Comparación Lado a Lado
Los números abstractos son útiles para tomar decisiones. Los ejemplos concretos ayudan a entender qué significan en la práctica. Aquí está el mismo lote de facturas, dos enfoques de procesamiento, lado a lado:
| Dimensión | OCR Tradicional (Con Plantillas) | Extracción con IA |
|---|---|---|
| Configuración para 20 proveedores | 20 plantillas × 30 min cada una = 10 horas | Definir nombres de columnas una vez = 2 minutos |
| Se incorpora el proveedor 21 | Crear nueva plantilla = 30 minutos | Sin cambios. Las mismas columnas funcionan en cualquier diseño. |
| El proveedor 5 rediseña su formato | Datos redirigidos en silencio. Detectado en conciliación. | Campos detectados por significado semántico. El cambio de diseño es invisible. |
| Nota manuscrita en la factura | Ilegible. Campo vacío o lleno de caracteres basura. | Leída en contexto. La cursiva "urgente" junto a "Prioridad:" se convierte en el valor. |
| Foto de recibo con celular | Distorsión angular + bajo contraste = salida inútil | El contexto visual compensa. La impresión térmica desvanecida sigue siendo legible. |
| Campo de formulario con casillas | Caracteres aleatorios cerca de un cuadrado. Requiere verificación manual. | Identifica la opción marcada por relevancia visual. Extrae "Sí" o "No". |
| 50 facturas, 15 proveedores, 1 salida | Ejecutar cada proveedor con su plantilla. Unir salidas. Corregir desajustes. | Subir las 50. Definir nombres de columnas una vez. Descargar Excel consolidado. |
La fila más ilustrativa es "El proveedor 5 rediseña el diseño". En la columna de OCR tradicional, el error es invisible: la plantilla encuentra el texto en las coordenadas esperadas y lo devuelve, sin importar si es el texto correcto. En la columna de IA, el cambio de diseño es irrelevante porque la extracción se basa en lo que significa el texto, no en dónde está. Esta única diferencia — desviación silenciosa de la plantilla frente a extracción resistente al diseño — genera más costos de conciliación posteriores que cualquier otro factor.
El enfoque híbrido vale la pena considerarlo para equipos que procesan una mezcla de tipos de documentos. Muchas organizaciones que manejan extracción de documentos a gran escala — como se observa en comunidades de Reddit como r/mlops y r/fintech — ejecutan pipelines en capas: OCR tradicional para los tipos de documentos estandarizados y de alto volumen donde las plantillas funcionan de manera confiable, y extracción con IA para los documentos variables, complejos o manuscritos donde los costos de mantenimiento de plantillas superan la alternativa. La lógica de enrutamiento es simple: si un documento coincide con una plantilla conocida con alta confianza, procéselo mediante OCR. Si no es así, o si la confianza cae por debajo de un umbral, envíelo a extracción con IA. Esto captura la ventaja de costo del OCR tradicional donde aplica, evitando la penalización por corrección de errores donde no.
Preguntas frecuentes
¿Puedo simplemente usar ChatGPT o Claude para extraer datos de mis documentos?
Para un documento a la vez, sí — GPT-5 alcanza un 95% de precisión en escritura a mano y maneja bien documentos de formato mixto. Pero los chatbots de propósito general no están diseñados para el procesamiento por lotes: subir 50 facturas y obtener una hoja de cálculo consolidada con columnas consistentes en todos los documentos. Cada documento es una conversación separada, los nombres de las columnas deben reespecificarse cada vez y no existe un mecanismo integrado para fusionar las salidas en un único archivo estructurado. Para extracciones puntuales, los chatbots funcionan. Para el procesamiento recurrente de documentos a gran escala, las herramientas de extracción especializadas manejan el lote, la consistencia del esquema y el flujo de trabajo de exportación que los chatbots nunca fueron diseñados para soportar.
¿Cuál es la diferencia real de costo por documento entre el OCR tradicional y la extracción con IA?
El OCR tradicional cuesta aproximadamente $0.01–$0.05 por página a escala (precios de API de proveedores de nube). La extracción con IA cuesta aproximadamente $0.05–$0.30 por página. La brecha de costo de software puro es de aproximadamente 3–10×. Pero el costo total de propiedad — incluyendo mano de obra de corrección de errores, mantenimiento de plantillas y costos de errores posteriores — normalmente invierte la comparación para cualquier flujo de trabajo que procese más de ~200 documentos variados al mes. La comparación entre OCR gratuito y extracción con IA de pago cubre el desglose completo del TCO.
¿Funciona el AI OCR en documentos manuscritos?
Sí, y la brecha aquí es mayor que en texto impreso. Los motores de OCR tradicional logran una precisión del 50–70% en escritura a mano. Los modelos de visión y lenguaje alcanzan el 85–95% en los mismos documentos mediante el uso de comprensión contextual: el modelo sabe cómo debería verse una fecha en un campo determinado y usa ese conocimiento para desambiguar caracteres poco claros. Para escritura cursiva, la brecha se amplía aún más: el OCR tradicional cae por debajo del 50%, mientras que la extracción basada en VLM mantiene el 75–85%. Las limitaciones son reales — cursiva muy desordenada, escrituras no latinas con datos de entrenamiento limitados y escritura a mano en ángulos extremos siguen desafiando a todos los sistemas — pero la ventaja relativa de la extracción con IA en escritura a mano es la mayor entre todos los tipos de documentos.
¿A partir de qué volumen de documentos la extracción con IA se vuelve rentable?
El punto de equilibrio depende más de la variedad de documentos que del volumen bruto. Un equipo que procesa 100 documentos al mes de 3 proveedores con diseños fijos puede que nunca llegue al punto de equilibrio. Un equipo que procesa 200 documentos al mes de 20 proveedores con diseños variados llega al punto de equilibrio de inmediato: solo el mantenimiento de plantillas consume más horas de trabajo que el costo de la suscripción de IA. Como regla general: si mantiene plantillas para más de 10 diseños de documentos diferentes, ya ha superado el punto de equilibrio. Consulte el panorama de precios de extracción de documentos con IA 2026 para conocer los costos actuales de las herramientas en cada nivel de volumen.
¿Qué precisión debo esperar de la extracción con IA en producción?
Una precisión a nivel de campo del 95–97 % en documentos empresariales variados es una expectativa de producción realista según los puntos de referencia actuales de VLM (modelo de visión y lenguaje). En documentos limpios y estandarizados, alcanza el 98–99 %. En documentos muy degradados —faxes, recibos en papel térmico, documentos con sellos superpuestos al texto—, espere un 85–93 %. La distinción crítica está entre la precisión de caracteres y la precisión a nivel de campo: una herramienta que reporta un 99 % de precisión de caracteres puede ofrecer solo un 80 % de precisión a nivel de campo si los caracteres mal leídos afectan puntos de datos críticos. Mida siempre la precisión a nivel de campo: el porcentaje de campos que llegaron a la columna correcta con el valor correcto. Para un análisis más profundo de qué significan las cifras de precisión a escala de procesamiento, consulte la guía práctica sobre la precisión de la extracción con IA.
¿El OCR tradicional todavía tiene futuro?
Sí, en tres funciones. Primero, como capa de reconocimiento de texto dentro de los flujos de extracción con IA: muchos sistemas basados en VLM todavía usan OCR como paso de preprocesamiento para documentos con mucho texto. Segundo, para el procesamiento estandarizado de documentos de gran volumen donde los costos de plantilla se amortizan de manera eficiente. Tercero, para proyectos de digitalización de archivos donde el objetivo es la búsqueda de texto completo en lugar de la extracción de datos estructurados. El OCR tradicional no está obsoleto: su papel se está reduciendo a los casos de uso específicos donde sus supuestos arquitectónicos (diseños fijos, texto limpio, salida a nivel de caracteres) coinciden con las características reales del documento.
Por dónde empezar
La brecha entre el OCR tradicional y la extracción con IA no se está reduciendo. Los modelos de visión y lenguaje continúan mejorando en documentos complejos: la precisión del 95 % en escritura a mano de GPT-5 en 2026 supera el 85 % de GPT-4 en 2025—, mientras que los motores de OCR tradicional han estado refinando el mismo enfoque de coincidencia de caracteres durante décadas. La brecha de precisión ahora es una brecha de costos, y se manifiesta en cada cola de revisión manual, en cada reconstrucción de plantilla, en cada problema de conciliación atribuible a datos redirigidos silenciosamente.
Hay una manera sencilla de ver en qué lado del punto de cruce se encuentran sus documentos. Suba una factura —preferiblemente una que haya causado problemas a su proceso actual— a una herramienta de extracción con IA sin plantilla. Escriba los nombres de los campos que necesita y observe dónde se ubican los valores. Para más información sobre cómo la extracción con IA difiere del OCR a nivel de datos, no de caracteres, el explicador sobre la entrada de datos con IA frente al OCR analiza la diferencia en los resultados con ejemplos reales. El costo de realizar esta prueba es de unos minutos. El costo de no saber dónde está realmente su precisión se acumula cada mes.