Reconocimiento de escritura a mano con IA vs OCR tradicional: por qué la brecha es mayor de lo que la mayoría de los equipos espera
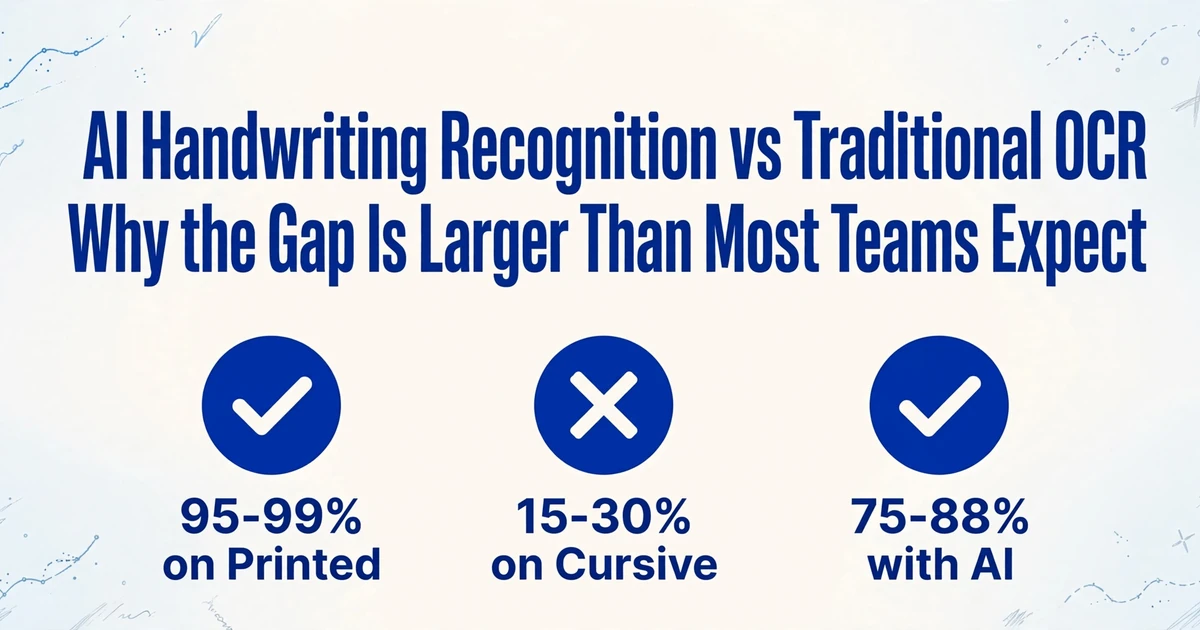
El OCR tradicional falla catastróficamente con la escritura a mano: Tesseract alcanza un 24% de precisión en formularios manuscritos, mientras que la extracción con IA supera el 95%. Aquí está el porqué de que la brecha sea estructural.
Dónde encaja esto: esta página es la comparación directa entre IA y OCR tradicional en escritura a mano: precisión, velocidad, costo y alucinación. Para una definición de qué es el reconocimiento de escritura a mano con IA, consulte qué es el reconocimiento de escritura a mano con IA; para cifras de precisión por tipo de escritura, consulte ¿puede la IA leer escritura a mano en fotos?.
Lo que el OCR tradicional hace bien — y dónde se detiene
El reconocimiento óptico de caracteres tradicional funciona examinando patrones de píxeles en una página, comparándolos con formas de caracteres conocidas y generando una cadena de texto. Para documentos impresos por máquina y escaneados a 300 DPI, funciona bien — a menudo superando el 95% de precisión de caracteres. Una factura recién impresa, un formulario PDF, un contrato mecanografiado: estos son los insumos para los que fue diseñado el OCR, y siguen siendo su mejor escenario.
Pero la precisión a nivel de carácter no es lo mismo que la precisión de datos. Saber que los caracteres "1,234.56" aparecen en algún lugar de una página no le dice nada sobre si eso es un total de factura, una cantidad o un número de referencia. Esa interpretación aún requiere un humano — o una capa de reglas que usted debe crear y mantener sobre la salida del OCR. Para texto impreso por máquina, esta brecha es manejable con scripts de posprocesamiento y plantillas de posición de campo. Para escritura a mano, la brecha se convierte en un abismo.
El problema fundamental es arquitectónico. El OCR tradicional es ascendente: primero lee caracteres individuales, luego intenta ensamblarlos en palabras y luego en líneas. No tiene concepto de de qué trata el documento realmente. Cuando cada carácter es nítido y predecible, esto funciona. Cuando los caracteres se conectan, varían en tamaño, se inclinan de forma impredecible o se emborronan entre sí — como ocurre con la escritura a mano — el enfoque ascendente colapsa antes de llegar al nivel de la palabra.
Los tres puntos donde el OCR tradicional falla con la escritura a mano
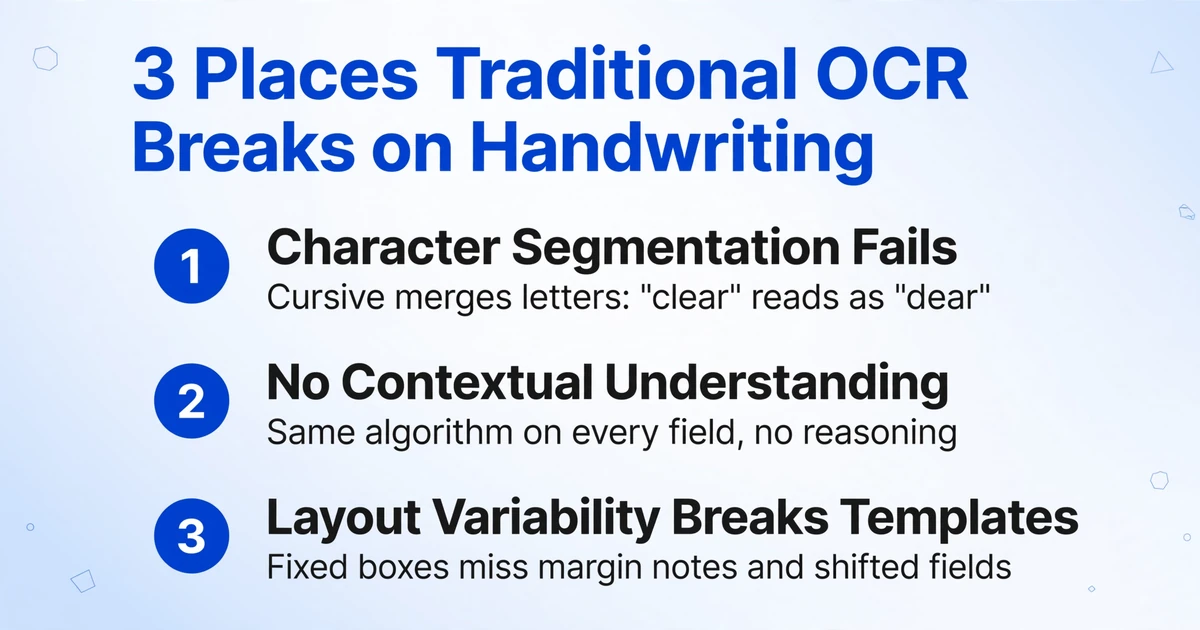
La escritura a mano de cada persona es un conjunto de datos único. El grosor del trazo, el ángulo de inclinación, la conexión de letras, la deriva de la línea base — todo esto varía no solo entre personas, sino dentro de la escritura de una misma persona en diferentes días, bolígrafos y superficies. El OCR tradicional encuentra tres modos de fallo específicos que se agravan entre sí.
La segmentación de caracteres ocurre antes de que comience el reconocimiento
El OCR asume que cada carácter ocupa un cuadro delimitador separable. La escritura cursiva viola esta suposición por completo. Los caracteres se fusionan sin un límite claro. El motor fusiona varias letras en una sola mancha (leyendo "claro" como "caro") o divide una letra en dos cuadros (leyendo "m" como "rn"). Evaluaciones independientes de implementaciones en producción muestran que Tesseract — el motor OCR de código abierto más utilizado — obtiene entre un 45 y 50 % de precisión por palabra en escritura cursiva general. Esto significa que de cada dos palabras escritas en cursiva, una se leerá mal. En un formulario de 50 campos con imprenta y cursiva mezcladas, aproximadamente 25 campos contendrán errores antes de cualquier revisión humana.
Sin comprensión contextual no hay recuperación de errores
Cuando una persona lee una palabra borrosa en un formulario de entrega, los campos circundantes — fecha, dirección, lista de artículos — limitan lo que esa mancha podría ser razonablemente. Un número en un campo "Total" no puede ser un nombre. Una fecha en un campo "Fecha de nacimiento" no puede ser del año próximo. El OCR tradicional carece de este razonamiento. Aplica el mismo algoritmo de coincidencia de caracteres a cada posición de la página sin importar lo que debería haber allí. Un "5" borroso en una columna de precios se clasifica como "S" porque el patrón de píxeles es ambiguo — y el motor no tiene forma de señalar que "S" no tiene sentido en un campo de moneda.
La variabilidad del diseño rompe los procesos basados en plantillas
Muchas configuraciones de OCR en producción dependen de plantillas: se definen coordenadas fijas para cada campo y el motor lee los caracteres que aparecen en esos cuadros. Esto funciona para formularios estandarizados de una sola fuente. Falla en cuanto un proveedor cambia el diseño del formulario, un campo se desplaza medio centímetro, o alguien escribe una nota en el margen en lugar del cuadro designado. Los documentos manuscritos amplifican este problema: los escritores suelen desbordar los cuadros, añadir anotaciones en los márgenes o usar flechas para reubicar información. Una plantilla diseñada para "Nombre: [____________]" no puede manejar "Nombre: [Juan S—— ver ID adjunto]". La salida del OCR para ese campo será truncada, distorsionada o vacía, y el resto del flujo de trabajo no tiene forma de saberlo.
Cómo piensa de manera diferente el reconocimiento de escritura a mano con IA
Los Modelos de Lenguaje Visual (VLM, por sus siglas en inglés) — la clase de IA que incluye modelos como GPT-4o, Claude y Gemini — procesan documentos de arriba hacia abajo en lugar de abajo hacia arriba. No comienzan buscando formas de letras individuales. Observan la imagen completa de la página, comprenden su estructura y propósito, y luego decodifican el texto dentro de ese contexto. Esto se acerca más a cómo lee un humano: no examinas cada trazo de lápiz de forma aislada; reconoces la palabra "Total" porque esperas que aparezca un total al final de una factura, e interpretas el número junto a ella como moneda porque el contexto lo exige.
La consecuencia práctica es que la extracción basada en VLM maneja la ambigüedad como lo haría un humano — cotejando lo que está en la página con lo que debería estar en la página. Un carácter que parece "5" o "S" se resuelve como "5" si aparece en un campo numérico. Una fecha escrita como "Ene 5 25" se normaliza a "2025-01-05" porque el modelo comprende los formatos de fecha. Esta desambiguación contextual no es una mejora menor sobre el OCR a nivel de carácter — es la diferencia entre una salida utilizable y una salida que requiere una segunda revisión humana.
En la práctica, las herramientas construidas con este enfoque te permiten definir Extracción de Columnas Personalizadas: escribes los nombres de los campos que deseas — "Número de Factura", "Fecha de Vencimiento", "Monto Total" — y la IA localiza cada valor en cualquier parte de la página al comprender qué significa la etiqueta del campo, no dónde se encuentra. Sin coordenadas de plantilla, sin configuración por proveedor, sin reconfiguración cuando cambia el diseño de un formulario. La misma definición funciona en diferentes documentos de diferentes fuentes porque la IA busca significado, no posición.
Los archivos se procesan de forma segura y no se almacenan.
La brecha de precisión: en cifras
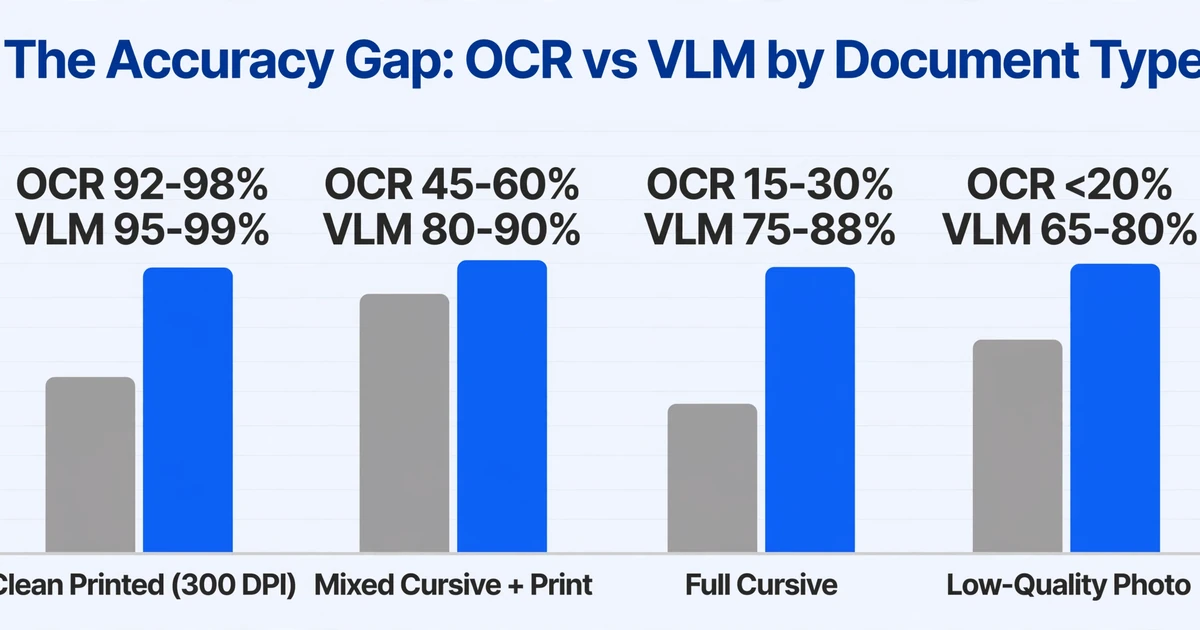
Las cifras hacen tangible la diferencia. Múltiples evaluaciones independientes publicadas en 2025–2026 convergen en un patrón consistente: en texto impreso, la brecha entre el OCR tradicional y la extracción basada en VLM es estrecha (3–7 puntos porcentuales). En escritura a mano, se dispara.
| Tipo de documento | Precisión del OCR tradicional | Precisión de la extracción basada en VLM | Brecha |
|---|---|---|---|
| Texto impreso limpio (300 DPI) | 92–98% | 95–99% | 3–7 pp |
| Escritura a mano en mayúsculas (casillas delimitadas) | 70–85% | 85–93% | 8–15 pp |
| Cursiva mixta + imprenta | 45–60% | 80–90% | 25–35 pp |
| Cursiva completa / escritura a mano desordenada | 15–30% | 75–88% | 50–65 pp |
| Fotos de campo de baja calidad (teléfono, iluminación desigual) | <20% | 65–80% | 45–65 pp |
Dos notas sobre lo que se está midiendo. Primero, la columna de VLM es precisión a nivel de campo — si cada valor extraído aterriza en la columna correcta de su hoja de cálculo — no reconocimiento de caracteres en bruto. El nivel de campo supera la tasa de error de caracteres (CER) en bruto porque el contexto del documento resuelve caracteres ambiguos: un dígito manchado en un campo de Total se lee como un 5, no como una S. Segundo, la columna de OCR tradicional es reconocimiento en bruto sobre los mismos documentos — que es exactamente la razón por la que la brecha parece tan grande. Para métricas en bruto a nivel de carácter en el punto de referencia IAM, consulte nuestro análisis detallado sobre cómo funciona el reconocimiento de escritura a mano.
El patrón no es sutil. Con la escritura más limpia (mayúsculas en casillas delimitadas), la brecha es manejable: el OCR tradicional podría ser «suficientemente bueno» con algo de posprocesamiento. Pero a medida que la escritura se degrada — de letras de molde a cursiva mixta, de casillas delimitadas a campos de formato libre, de páginas escaneadas a fotos de teléfono — la precisión del OCR tradicional se desploma, mientras que la extracción basada en VLM se degrada gradualmente. El mismo punto de referencia de 2026 probó el motor especializado en escritura a mano de Google Document AI con cursiva: ~63% de precisión de palabras. Amazon Textract obtuvo mejores resultados, con ~89.5% en las mismas entradas, pero ambos requirieron canalizaciones de preprocesamiento separadas para la corrección de sesgo, mejora de contraste y eliminación de ruido — trabajo que los sistemas basados en VLM manejan en el momento de la inferencia sin configuración adicional (Suparse, 2026).
Para un flujo de trabajo del mundo real que procesa 100 documentos mixtos por semana — la mitad impresos, la mitad escritos a mano — la diferencia acumulativa equivale a aproximadamente 4 a 6 horas por semana de corrección manual con OCR tradicional frente a 30 a 45 minutos con extracción basada en VLM. Esa brecha no se trata de conveniencia. Determina si la automatización que incluye escritura a mano puede funcionar sin un paso de revisión humana dedicado.
Donde la Comparación se Vuelve Compleja: Velocidad, Costo y Alucinación
Si la comparación de precisión fuera toda la historia, la decisión sería simple. Pero la extracción basada en VLM conlleva tres desventajas que hacen que una recomendación general sea deshonesta.
Velocidad
El OCR tradicional es rápido: procesa una página en menos de 2 segundos en hardware estándar. Los VLM son más lentos porque realizan un razonamiento más complejo. Una llamada típica de VLM para extracción a nivel de página tarda de 5 a 12 segundos, según la complejidad del documento y el tamaño del modelo. Para un lote de 500 páginas, eso supone la diferencia entre 15 minutos y más de una hora. Si su flujo de trabajo es sensible al volumen y sus documentos son texto impreso limpio y uniforme, el OCR tradicional sigue siendo la opción más rápida, y quizá todo lo que necesite.
Costo
El OCR tradicional es económico. Tesseract es gratuito y de código abierto. Las API de OCR en la nube cobran aproximadamente $0.001–0.005 por página. La extracción basada en VLM cuesta más por página porque el cómputo es más pesado, pero la comparación resulta engañosa si se detiene en el precio por página de la API. Un usuario de Reddit que procesó más de 150 000 páginas en producción señaló que la ventaja de costo por página del OCR tradicional se desvanecía al incluir el costo de la corrección manual: «Las plataformas de OCR tradicional parecen rentables (~$0.001–0.005 por página), pero su baja precisión con escritura a mano (~45–50 %) las hace inutilizables para flujos de trabajo empresariales con contenido manuscrito significativo. El tiempo dedicado a corregir errores manualmente eleva el costo real muy por encima de las soluciones especializadas» (r/computervision, 2025). La ecuación de costo real es: costo de extracción por página + costo de corrección por error × tasa de error. Para documentos impresos, el costo por página domina. Para documentos manuscritos, domina el costo de corrección, y ahí es donde la mayor precisión del VLM cambia las cifras.
Alucinación
Esto es lo que omiten la mayoría de los artículos comparativos: los VLM pueden alucinar. Como razonan sobre lo que debería haber en una página, ocasionalmente insertan información que no existe: una fecha de apariencia plausible donde el campo estaba vacío, o un monto adivinado donde la escritura era realmente ilegible. El OCR tradicional tiene el modo de fallo opuesto (no devuelve nada o devuelve basura), lo que hace que sus errores sean más fáciles de detectar. Una alucinación de VLM es más peligrosa porque parece correcta. La diferencia entre una salida de Tesseract errónea con seguridad ("OOO OOO") y una salida de VLM errónea con seguridad es que la versión del VLM se lee como datos reales y puede pasar desapercibida en la validación automatizada. Para campos donde los errores son costosos (montos de pago, fechas de contrato, datos de cumplimiento), la puntuación de confianza y la revisión con humano en el circuito siguen siendo necesarias independientemente de la tecnología que elija (F22 Labs, 2026).
Idea clave: el OCR tradicional falla al devolver caracteres incorrectos. La extracción basada en VLM puede fallar al devolver fabricaciones creíbles. El primer modo de fallo es ruidoso pero detectable. El segundo es silencioso y peligroso. Ninguna tecnología elimina la necesidad de validación en campos de alto riesgo; solo requieren estrategias de validación diferentes.
El Enfoque Híbrido: Cuándo Usar Cada Uno
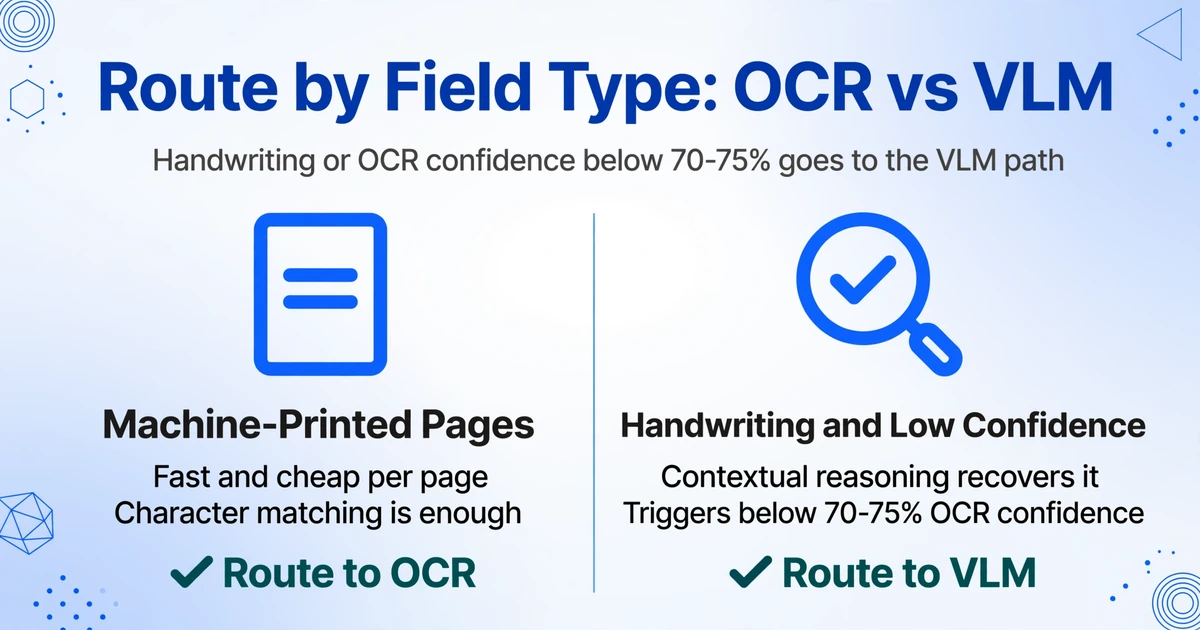
La respuesta práctica para la mayoría de los equipos no es "cambiar todo a IA" o "quedarse con OCR". Es una canalización híbrida que enruta cada documento al motor correcto según sus características.
Para documentos que son 100% impresos por máquina, con formato consistente y escaneados a 300+ DPI, el OCR tradicional es más rápido, más económico y suficiente. La salida puede necesitar post-procesamiento de posición de campo, pero la precisión a nivel de carácter es lo suficientemente alta como para que las reglas de post-procesamiento sean estables.
Para documentos que contienen cualquier escritura a mano — incluso un solo campo — la estrategia híbrida cambia. Use OCR tradicional para las secciones impresas y enrute los campos escritos a mano a un VLM. Esto captura la ventaja de velocidad del OCR en la mayor parte de la página mientras usa IA contextual en las partes que el OCR no puede manejar. La lógica de enrutamiento es simple: si la confianza del OCR en un campo cae por debajo de un umbral (típicamente 70–75%), ese campo se vuelve a procesar a través de la ruta VLM. Un mínimo de conteo de caracteres (mínimo 40 caracteres por página) actúa como una segunda puerta para detectar páginas donde el OCR afirma alta confianza en cuatro caracteres leídos correctamente pero se perdió el resto de la página por completo.
El enfoque de umbral también controla los costos — solo paga por el procesamiento VLM en los campos donde marca la diferencia. Para un flujo de trabajo donde el 30% de los documentos contienen escritura a mano y cada documento promedia 15 campos, esto significa que aproximadamente 5 campos por documento pasan por la ruta VLM, no toda la página. A escala, esa diferencia importa.
Qué significa esto para su flujo de trabajo con documentos
La decisión entre el OCR tradicional y el reconocimiento de escritura a mano con IA no es una elección tecnológica, sino una decisión de diseño del flujo de trabajo. Si su proceso de recepción de documentos es 100 % impreso y basado en plantillas, el OCR tradicional funciona y seguirá funcionando. Si una fracción significativa de sus documentos contiene escritura a mano — confirmaciones de entrega con notas del conductor, informes de inspección con observaciones de campo, formularios de admisión médica con firmas de pacientes, solicitudes financieras con declaraciones manuscritas —, un proceso basado únicamente en OCR tradicional está perdiendo datos silenciosamente en cada lote.
El error de cálculo más común es asumir que «el OCR lo maneja» porque la página de marketing de la herramienta menciona soporte para escritura a mano. La brecha entre la capacidad anunciada y el rendimiento real con sus documentos — no con las muestras de demostración depuradas del proveedor — es lo que determina si la automatización funciona o genera más trabajo del que ahorra. Probar con sus propios documentos, específicamente con el 10 % más desordenado de su recepción, es la única manera de saber qué enfoque — OCR puro, VLM puro o híbrido — resistirá bajo carga de producción.
Preguntas frecuentes
¿Puede el OCR tradicional leer escritura cursiva en absoluto?
Sí, pero de forma poco fiable. Incluso con motores basados en LSTM como Tesseract 4.x, la precisión con cursiva suele caer por debajo del 50 % a nivel de palabra. Los caracteres de la escritura enlazada son demasiado ambiguos para el reconocimiento de patrones ascendente. El OCR tradicional no fue diseñado para esta clase de entrada, y ningún ajuste de parámetros cambia la limitación arquitectónica subyacente.
¿Es el reconocimiento de escritura a mano con IA lo bastante preciso para reemplazar la entrada manual de datos?
Para muchos flujos de trabajo, sí, con salvedades. Con escritura en letra de imprenta en campos de formulario restringidos, la extracción con IA alcanza una precisión a nivel de campo del 85–93 %, lo que convierte la entrada manual en la excepción y no en la regla. Con cursiva desordenada o fotos de teléfono degradadas, la precisión cae al 65–80 % — una mejora drástica frente al sub-20 % del OCR tradicional, pero no suficiente para un procesamiento directo sin un paso de revisión en campos críticos. El punto óptimo práctico es la extracción con enrutamiento basado en confianza: los campos de alta confianza fluyen automáticamente, mientras que los de baja confianza se marcan para revisión humana. Para un análisis más profundo de cómo varía la precisión según la calidad de entrada y el diseño de campos, consulte nuestra guía de mejora de precisión.
¿Y la velocidad? ¿La extracción con IA es más lenta que el OCR?
Por página, sí — normalmente de 5 a 12 segundos para la extracción basada en VLM frente a menos de 2 segundos para el OCR tradicional. Pero la comparación justa incluye el tiempo ahorrado al no corregir manualmente los errores del OCR en campos manuscritos. Para un lote de 100 páginas con un 40% de contenido manuscrito, la extracción con VLM toma ~10 minutos de procesamiento + 30 minutos de revisión. El OCR tradicional toma ~3 minutos de procesamiento + 3 a 5 horas de corrección. El tiempo total del flujo de trabajo favorece al VLM en cualquier lote que incluya escritura a mano.
¿Puedo usar tanto el OCR tradicional como la extracción con IA en el mismo flujo de trabajo?
Sí — y así es como se ven la mayoría de los despliegues de producción. Use el OCR tradicional para páginas impresas por máquina con una confianza superior al umbral del 75% y un mínimo de recuento de caracteres. Enrute todo lo que esté por debajo de ese umbral — además de cualquier documento marcado como manuscrito — a través de la ruta VLM. Esta arquitectura híbrida captura los beneficios de costo y velocidad del OCR donde funciona, mientras cubre los vacíos de escritura a mano que el OCR no puede cerrar.
¿Las herramientas de extracción con IA alucinan datos que no están en la página?
Pueden hacerlo. Los sistemas basados en VLM a veces generan datos que parecen plausibles para campos que en realidad estaban en blanco o eran ilegibles. Esta es la diferencia más importante con el modo de fallo del OCR tradicional: el OCR tradicional devuelve basura que es obviamente incorrecta; una alucinación de VLM puede parecer correcta y pasar por la validación sin ser detectada. Para cualquier campo donde un error sea costoso — montos de pago, fechas legales, identificadores de pacientes — la puntuación de confianza y la revisión humana siguen siendo necesarias, independientemente de la tecnología de extracción que use.
El Único Punto de Referencia Que Importa
Los puntos de referencia y las tablas comparativas le dicen lo que es cierto en promedio. No le dicen lo que es cierto para sus documentos — los que tienen la escritura a mano de sus proveedores, las abreviaturas de su personal de campo, sus formularios escaneados de hace una década. La brecha entre el OCR tradicional y el reconocimiento de escritura a mano con IA se mide en puntos porcentuales, pero si esos puntos importan depende por completo de lo que sucede cuando un campo se lee incorrectamente en su flujo de trabajo. Un total de factura mal leído es un error de pago. Un resultado de inspección mal leído es un fallo de cumplimiento. Un registro de paciente mal leído es un problema de seguridad.
Pruebe con sus propios documentos. No con los más limpios — los ocho formularios grapados con manchas de café y notas al margen. Esos son los que determinan si su canalización de extracción funciona o solo parece que funciona hasta que alguien detecta un error.