AI手書き文字認識 vs 従来型OCR:その差が多くのチームの想定より大きい理由
従来型OCRは手書き文字で壊滅的な失敗をします。Tesseractは手書きフォームで24%の精度しか出せないのに対し、AI抽出は95%以上に達します。その差が構造的なものである理由を解説します。
この記事の位置づけ:このページは、手書き文字におけるAIと従来型OCRの直接比較です。精度、速度、コスト、ハルシネーションを扱います。AI手書き文字認識の定義については、AI手書き文字認識とはをご覧ください。手書き文字の種類別の精度数値については、AIは写真から手書き文字を読めるかをご覧ください。
従来型OCRが得意なこと — そして限界
従来の光学文字認識(OCR)は、ページ上のピクセルパターンを調べ、既知の文字形状と照合し、テキスト文字列を出力することで機能します。300 DPIでスキャンされたきれいな活字文書では、95%を超える文字精度を達成することも多く、良好な性能を発揮します。印刷したばかりの請求書、PDFフォーム、タイプされた契約書 — これらはOCRが想定して設計された入力であり、今もなお最良のケースです。
しかし、文字精度はデータ精度と同じではありません。「1,234.56」という文字がページのどこかに存在することを知っても、それが請求書の合計なのか、数量なのか、参照番号なのかはわかりません。その解釈には依然として人間 — またはOCR出力の上に構築・維持しなければならないルール層 — が必要です。活字テキストの場合、このギャップは後処理スクリプトとフィールド位置テンプレートで管理可能です。しかし手書きの場合、そのギャップは深い溝へと広がります。
根本的な問題はアーキテクチャにあります。従来型OCRはボトムアップ方式です。まず個々の文字を読み取り、次に単語へ、そして行へと組み立てていきます。文書が何について書かれているかという概念は持ち合わせていません。すべての文字が明瞭で予測可能であれば機能します。しかし、文字がつながったり、サイズがばらついたり、傾きが不規則だったり、互いににじんだりする場合 — 手書きではよくあることですが — ボトムアップ方式は単語レベルに到達する前に崩壊します。
従来型OCRが手書きで破綻する3つのポイント
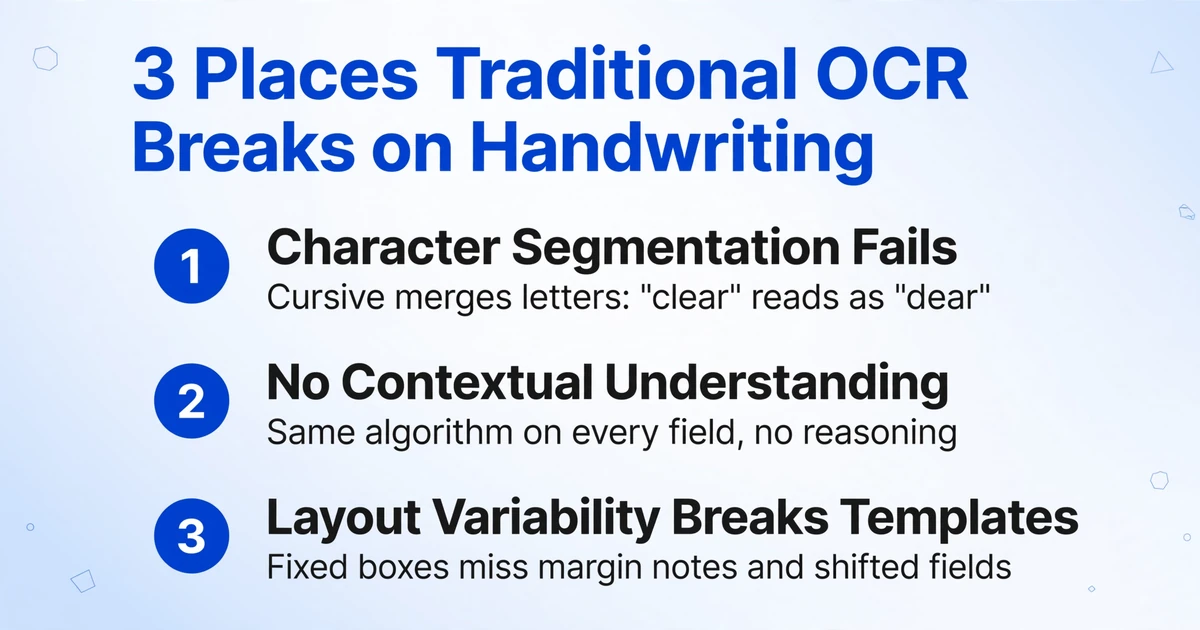
一人ひとりの手書きは独自のデータセットです。線の太さ、傾斜角、文字のつながり、ベースラインのずれ — これらは人によって異なるだけでなく、同じ人の筆跡でも、日、ペン、筆記面によって変化します。従来型OCRは、互いに増幅し合う3つの特定の失敗モードに直面します。
文字認識の前に、文字の分割が行われる
OCRは各文字が分離可能なバウンディングボックスを占めると仮定します。しかし、筆記体はこの仮定を完全に覆します。文字は明確な境界なく連続します。エンジンは複数の文字を1つの塊に結合して("clear"を"dear"と読む)、または1つの文字を2つのボックスに分割して("m"を"rn"と読む)しまいます。本番環境での独立したベンチマークによると、最も広く使われているオープンソースOCRエンジンであるTesseractの一般的な筆記体に対する単語精度は45~50%です。つまり、筆記体で書かれた単語2つにつき1つは誤読されることになります。活字と筆記体が混在する50項目のフォームでは、人間による確認が始まる前に、約25項目にエラーが含まれることになります。
文脈理解がないため、エラー回復は不可能
人間が配送伝票の汚れた単語を読むとき、周囲のフィールド(日付、住所、品目リスト)が、その汚れが何であるかの可能性を絞り込みます。「合計」フィールドの数字が名前であるはずがなく、「生年月日」フィールドの日付が来年であるはずもありません。従来のOCRにはこのような推論機能はまったくありません。ページ上のすべての位置に、そこに何があるべきかに関係なく、同じ文字マッチングアルゴリズムを適用します。価格欄の汚れた「5」は、ピクセルパターンが曖昧なため「S」と分類されます。しかし、エンジンには通貨フィールドで「S」が意味をなさないことを指摘する方法がありません。
レイアウトのばらつきがテンプレート依存のパイプラインを破綻させる
多くの実運用OCRシステムはテンプレートに依存しています。各フィールドの固定座標を定義し、エンジンはそのボックス内の文字を読み取ります。これは単一ソースの標準化されたフォームでは機能します。しかし、サプライヤーがフォームのレイアウトを変更したり、フィールドが数ミリずれたり、誰かが指定されたボックスではなく余白にメモを書いたりすると、機能しなくなります。手書き文書はこの問題を増幅します。書き手は頻繁にボックスからはみ出して書き、余白に注釈を追加し、矢印を使って情報の位置を変更します。「名前:[____________]」用に作られたテンプレートは、「名前:[山田太—— 身分証添付参照]」を処理できません。そのフィールドのOCR出力は、切り捨てられるか、文字化けするか、空になるかのいずれかであり、後続のワークフローはそのどれであるかを知る方法がありません。
AI手書き文字認識の思考プロセス
ビジョンランゲージモデル(VLM)— GPT-4o、Claude、Geminiなどのモデルを含むAIのクラス — は、ドキュメントをボトムアップではなくトップダウンで処理します。個々の文字の形を探すことから始めるのではありません。ページ画像全体を見て、その構造と目的を理解し、その文脈の中でテキストを解読します。これは人間の読み方に近いものです。ペンのストロークを個別に調べるのではなく、請求書の下部に合計が表示されることを期待するから「合計」という単語を認識し、文脈がそれを要求するから隣の数字を通貨として解釈します。
実際的な結果として、VLMベースの抽出は、ページ上にあるものとページ上にあるべきものを照合することで、人間と同じように曖昧さを処理します。「5」か「S」のどちらにも見える文字は、数値フィールドに表示されていれば「5」に解決されます。「Jan 5 25」と書かれた日付は、モデルが日付形式を理解しているため「2025-01-05」に正規化されます。この文脈による曖昧さの解消は、文字レベルのOCRに対する小さな改善ではありません。それは、そのまま使える出力と、人間による2回目の確認が必要な出力との違いです。
実際には、このアプローチに基づいて構築されたツールでは、カスタム列抽出を定義できます。「請求書番号」「支払期日」「合計金額」など、必要なフィールド名を入力するだけで、AIはフィールドラベルの意味を理解して、ページ上のどこにある値でも特定します。テンプレートの座標も、ベンダーごとの設定も、フォームのレイアウトが変わったときの再設定も不要です。AIは位置ではなく意味を探しているため、同じ定義が異なるソースの異なるドキュメント間で機能します。
ファイルは安全に処理され、保存されません。
数字で見る精度ギャップ
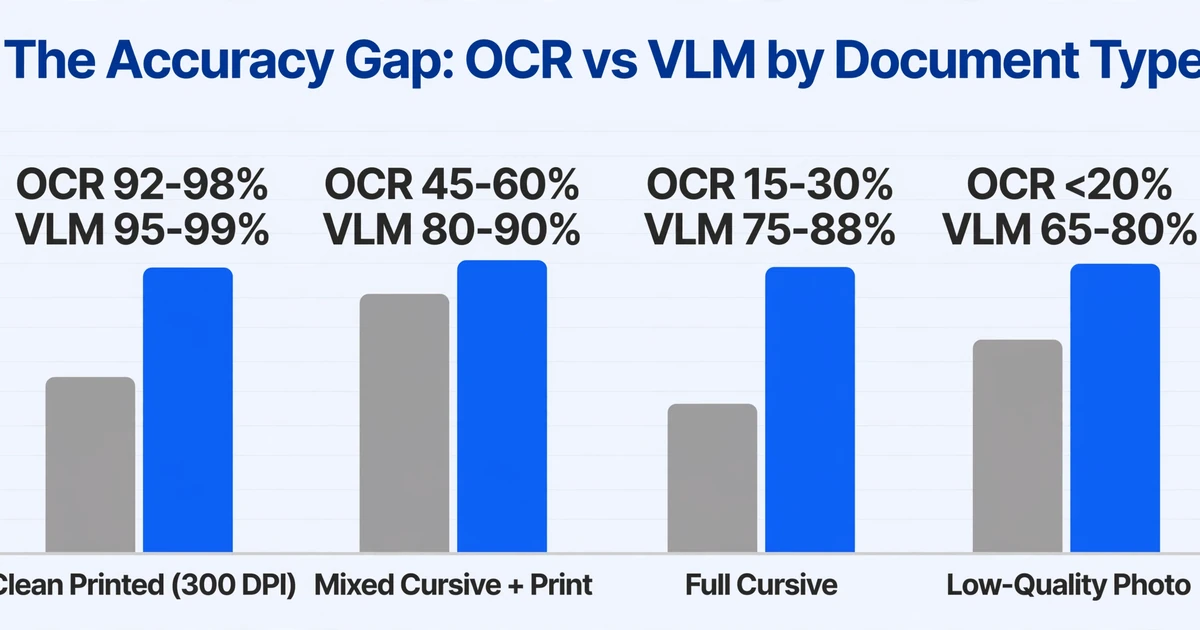
数字は違いを具体的にします。2025年から2026年に発表された複数の独立したベンチマークは、一貫したパターンに収束しています。印刷テキストでは、従来型OCRとVLMベースの抽出の差はわずか(3〜7ポイント)です。手書きでは、その差は急拡大します。
| 文書タイプ | 従来型OCRの精度 | VLMベースの抽出精度 | 差 |
|---|---|---|---|
| 鮮明な印刷テキスト(300 DPI) | 92–98% | 95–99% | 3〜7ポイント |
| ブロック体の手書き(枠線付き) | 70–85% | 85–93% | 8〜15ポイント |
| 筆記体とブロック体の混在 | 45–60% | 80–90% | 25〜35ポイント |
| 完全な筆記体・乱雑な手書き | 15–30% | 75–88% | 50〜65ポイント |
| 低品質の現場写真(スマホ、不均一な照明) | <20% | 65–80% | 45〜65ポイント |
測定内容に関する2つの注意点があります。まず、VLMの列はフィールドレベルの精度です。つまり、抽出された各値がスプレッドシートの正しい列に入るかどうかであり、生の文字認識ではありません。フィールドレベルは、文書の文脈があいまいな文字を解決するため、生の文字誤り率(CER)よりも高くなります。たとえば、合計フィールドの汚れた数字は「S」ではなく「5」として読み取られます。次に、従来型OCRの列は、同じ文書に対する生の認識結果です。これが、差がこれほど大きく見える理由です。IAMベンチマークの生の文字レベル指標については、手書き文字認識の仕組みに関する詳細な解説をご覧ください。
パターンは明確です。最も読みやすい手書き文字(枠内のブロック体)では、その差は許容範囲です。従来型OCRは後処理を加えれば「十分」かもしれません。しかし、手書き文字が劣化するにつれて — ブロック体から混在筆記体へ、枠付きフィールドから自由形式フィールドへ、スキャン文書からスマホ写真へ — 従来型OCRの精度は急落する一方、VLMベースの抽出は緩やかに低下するだけです。同じ2026年のベンチマークでは、Google Document AIの手書き文字専用エンジンを筆記体でテストしたところ、単語精度は約63%でした。Amazon Textractは同じ入力で約89.5%と良好でしたが、両方ともスキュー補正、コントラスト強調、ノイズ除去のための個別の前処理パイプラインが必要でした。VLMベースのシステムは推論時に追加設定なしでこれらを処理します(Suparse、2026年)。
週に100件の混合文書(半分は印刷、半分は手書き)を処理する実際のワークフローでは、累積差は従来型OCRで週に約4〜6時間の手動修正が必要なのに対し、VLMベースの抽出では30〜45分ですみます。 この差は利便性の問題ではありません。手書き文字を含む自動化が専任の人間によるレビューステップなしで実行できるかどうかを左右します。
比較が複雑になる理由:速度、コスト、ハルシネーション
精度の比較だけが全てなら、判断は簡単でしょう。しかし、VLMベースの抽出には3つのトレードオフがあり、画一的な推奨は不誠実になります。
速度
従来型OCRは高速で、一般的なハードウェアで1ページを2秒未満で処理できます。VLMはより高度な推論を行うため、処理が遅くなります。ページ単位の抽出における一般的なVLM呼び出しは、文書の複雑さとモデルサイズに応じて5〜12秒かかります。500ページのバッチの場合、15分と1時間以上の違いになります。ワークフローが量に敏感で、文書が一貫して鮮明な印刷テキストである場合は、従来型OCRが引き続き高速な選択肢であり、おそらくそれだけで十分です。
コスト
従来型OCRは安価です。Tesseractは無料のオープンソースです。クラウドOCR APIは1ページあたり約0.001〜0.005ドルかかります。VLMベースの抽出は計算負荷が高いため1ページあたりのコストが高くなりますが、1ページあたりのAPI価格だけで比較すると誤解を招きます。本番環境で15万ページ以上を処理したRedditユーザーは、手動修正のコストを考慮すると、従来型OCRのページ単価の優位性は消えると指摘しています。「従来型OCRプラットフォームは費用対効果が高いように見えますが(1ページあたり約0.001〜0.005ドル)、手書き文字の精度が低い(約45〜50%)ため、手書きコンテンツが多いビジネスワークフローでは使用できません。エラーを手動で修正する時間により、実際のコストは専門ソリューションよりもはるかに高くなります」(r/computervision, 2025)。実際のコスト計算式は、ページあたりの抽出コスト+エラーあたりの修正コスト×エラー率です。印刷文書ではページあたりのコストが支配的です。手書き文書では修正コストが支配的であり、ここでVLMの高い精度が計算を変えます。
ハルシネーション
ここで、ほとんどの比較記事が見落としている点をお伝えします。VLMはハルシネーションを起こす可能性があります。ページ上にあるべきものを推論するため、実際には存在しない情報を挿入することがあります。フィールドが空白だったのに、もっともらしい日付が入っていたり、手書きが本当に判読不能だったのに、推測された金額が入っていたりします。従来型OCRは逆の失敗モード(何も返さない、または無意味な出力)であり、そのためエラーを検出しやすくなっています。VLMのハルシネーションは、正しく見えるため、より危険です。Tesseractの堂々たる誤出力(「OOO OOO」)とVLMの堂々たる誤出力の違いは、VLM版が実際のデータのように読めてしまい、自動検証をすり抜ける可能性があることです。エラーが高くつくフィールド(支払い金額、契約日、コンプライアンスデータ)では、どのテクノロジーを選択しても、信頼度スコアリングとヒューマンインザループによるレビューが引き続き必要です(F22 Labs, 2026)。
重要なポイント: 従来型OCRは誤った文字を返すことで失敗します。VLMベースの抽出は、信憑性のある捏造を返すことで失敗することがあります。前者の失敗モードはノイズが多いものの検出可能です。後者は静かで危険です。どちらのテクノロジーも、重要度の高いフィールドでの検証の必要性をなくすものではありません。異なる検証戦略が必要になるだけです。
ハイブリッドアプローチ:何をいつ使うか
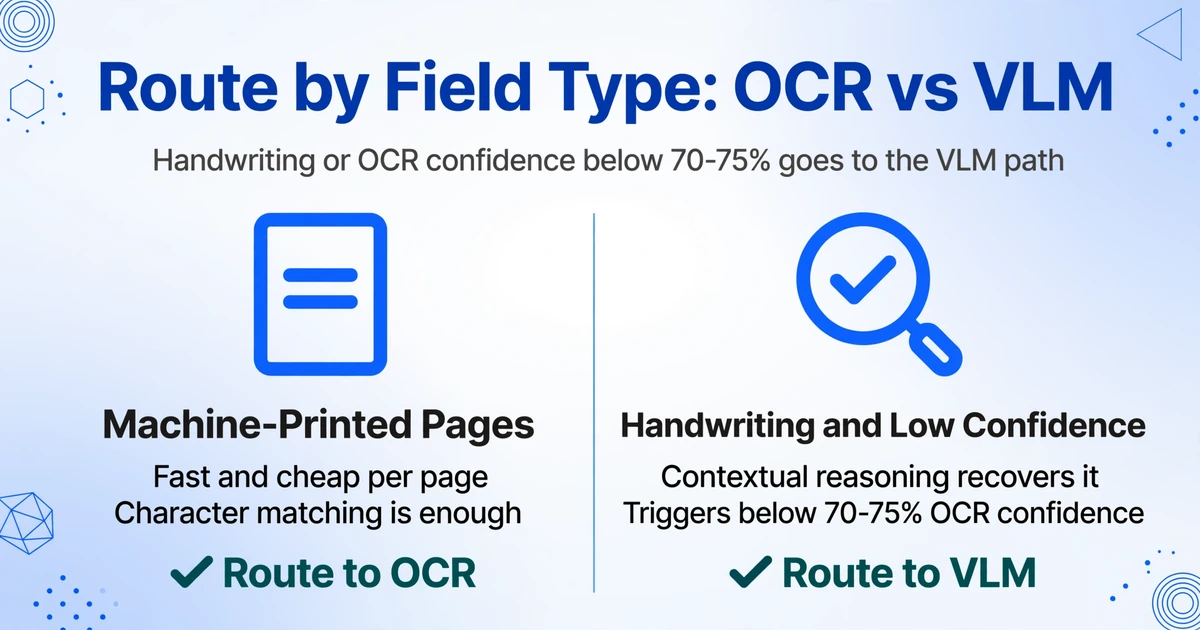
ほとんどのチームにとっての実用的な答えは、「すべてをAIに切り替える」でも「OCRに固執する」でもありません。それは、各ドキュメントをその特性に基づいて適切なエンジンに振り分けるハイブリッドパイプラインです。
100%機械印字で、フォーマットが一貫しており、300DPI以上でスキャンされたドキュメントの場合、従来型OCRの方が高速で低コスト、かつ十分です。出力にはフィールド位置の後処理が必要になるかもしれませんが、文字レベルの精度が十分に高いため、後処理ルールは安定しています。
手書きが1フィールドでも含まれるドキュメントの場合、ハイブリッド戦略に切り替わります。印字部分には従来型OCRを使用し、手書きフィールドはVLMに振り分けます。これにより、ページの大部分ではOCRの速度メリットを活かしつつ、OCRが処理できない部分では文脈を考慮したAIを活用できます。振り分けロジックはシンプルです:フィールドのOCR信頼度がしきい値(通常70〜75%)を下回った場合、そのフィールドはVLMパスで再処理されます。文字数下限(ページあたり最低40文字)が2つ目のゲートとして機能し、OCRが4文字だけ正しく読み取って高い信頼度を示したものの、ページの残り全体を見逃したケースを検出します。
しきい値アプローチはコストも制御します。効果のあるフィールドにのみVLM処理の費用を支払うことになります。ドキュメントの30%に手書きが含まれ、各ドキュメントに平均15フィールドあるワークフローの場合、ページ全体ではなく、ドキュメントあたりおよそ5フィールドがVLMパスを通過することになります。大規模になれば、その差は重要です。
ドキュメントワークフローへの影響
従来型OCRとAI手書き文字認識のどちらを選ぶかは、技術の選択ではなく、ワークフロー設計の選択です。ドキュメントの取り込みが100%印刷物かつ定型フォーマットであれば、従来型OCRで十分であり、今後も機能し続けるでしょう。しかし、ドキュメントの一定割合に手書きが含まれる場合——配達確認書のドライバー備考、点検報告書の現場所見、患者の署名がある医療問診票、手書きの申告書を含む金融申請書——従来型OCRのみのパイプラインでは、すべてのバッチで静かにデータが失われています。
最も多い誤算は、ツールのマーケティングページに手書き対応と記載されているため、「OCRで対応できる」と想定してしまうことです。 記載された機能と、実際のドキュメント——ベンダーの整えられたデモサンプルではなく——に対する実運用でのパフォーマンスの差こそが、自動化が機能するか、あるいは節約以上に作業を増やすかを左右します。実際のドキュメント、特に取り込みの中で最も状態の悪い10%を使ってテストすることが、純粋なOCR、純粋なVLM、またはハイブリッドのどのアプローチが本番環境の負荷に耐えられるかを知る唯一の方法です。
FAQ
従来型OCRは筆記体をまったく読めないのでしょうか?
読めますが、信頼性は低いです。Tesseract 4.xのようなLSTMベースのエンジンでも、筆記体の単語レベルの精度は通常50%を下回ります。つながった文字は、ボトムアップのパターンマッチングには曖昧すぎます。従来型OCRはこの入力クラス向けに設計されておらず、パラメータ調整をいくら行っても、根本的なアーキテクチャ上の限界は変わりません。
AI手書き文字認識は、手動データ入力を置き換えられるほど正確なのでしょうか?
多くのワークフローでは、条件付きで「はい」と言えます。制約のあるフォーム欄のブロック体の手書きでは、AI抽出は85〜93%のフィールドレベルの精度を達成し、手動入力は例外となります。読みにくい筆記体や画質の劣化したスマホ写真では、精度は65〜80%に低下します——それでも従来型OCRの20%未満からは大幅に改善されていますが、重要なフィールドでレビューステップなしの完全自動処理を行うには十分ではありません。実用的な最適解は、信頼度ベースのルーティングを備えた抽出です。信頼度の高いフィールドは自動的に処理され、信頼度の低いフィールドは人間のレビュー用にフラグが立てられます。入力品質とフィールド設計による精度の違いについて詳しくは、精度向上ガイドをご覧ください。
速度について — AI抽出はOCRより遅いのですか?
1ページあたりでは、はい — VLMベースの抽出は通常5〜12秒かかるのに対し、従来型OCRは2秒未満です。しかし、手書きフィールドのOCRエラーを手動で修正する手間を省けることを含めると、公平な比較になります。手書きコンテンツが40%含まれる100ページのバッチの場合、VLM抽出は処理時間約10分+レビュー30分です。従来型OCRは処理時間約3分+修正に3〜5時間かかります。手書きを含むバッチでは、総作業時間はVLMが有利です。
同じパイプラインで従来型OCRとAI抽出の両方を使えますか?
はい — そして、これがほとんどの本番環境での導入例です。信頼度が75%のしきい値以上で、最小文字数の基準を満たす機械印字ページには従来型OCRを使用します。そのしきい値未満のものや、手書きを含むと判定されたドキュメントはすべてVLM経路にルーティングします。このハイブリッドパイプラインは、OCRが機能する箇所ではコストと速度の利点を活かしつつ、OCRでは対応できない手書きのギャップをカバーします。
AI抽出ツールはページにないデータをハルシネーションすることがありますか?
起こり得ます。VLMベースのシステムは、実際には空白または判読不能だったフィールドに対して、もっともらしいデータを生成することがあります。これは従来型OCRの失敗モードとの最も重要な違いです。従来型OCRは明らかに間違ったガベージを返しますが、VLMのハルシネーションは正しく見え、検証をすり抜ける可能性があります。支払い金額、法的な日付、患者IDなど、エラーが高コストになるフィールドでは、どの抽出技術を使用する場合でも、信頼度スコアリングと人的レビューが引き続き必要です。
唯一重要なベンチマーク
ベンチマークや比較表は、平均的な真実を教えてくれます。しかし、あなたのドキュメントにとっての真実は教えてくれません — 取引先の手書き、現場スタッフの略語、10年前のスキャンフォームなどです。従来型OCRとAI手書き認識の差はパーセンテージポイントで測定されますが、そのポイントが重要かどうかは、ワークフローでフィールドが誤って読み取られたときに何が起こるかに完全に依存します。誤読された請求書の合計は支払いエラーです。誤読された検査結果はコンプライアンス違反です。誤読された患者記録は安全上の問題です。
自分のドキュメントでテストしてください。最もきれいなものではなく、コーヒーの染みと余白のメモが付いた、ホチキス留めされた8枚のフォームです。 それらこそが、抽出パイプラインが機能するか、それとも誰かがエラーに気づくまで機能しているように見えるだけかを決定づけるものです。