AI手書き文字抽出の精度を向上させる方法:入力品質、フィールド設計、期待できる結果
手書き文字抽出の精度を高める5つの実践的なテクニック:照明、レイアウト、フィールド命名、バッチ一貫性、そして信頼度フラグ付きレビューを受け入れるタイミングについて解説します。
「精度」が実際に意味するもの
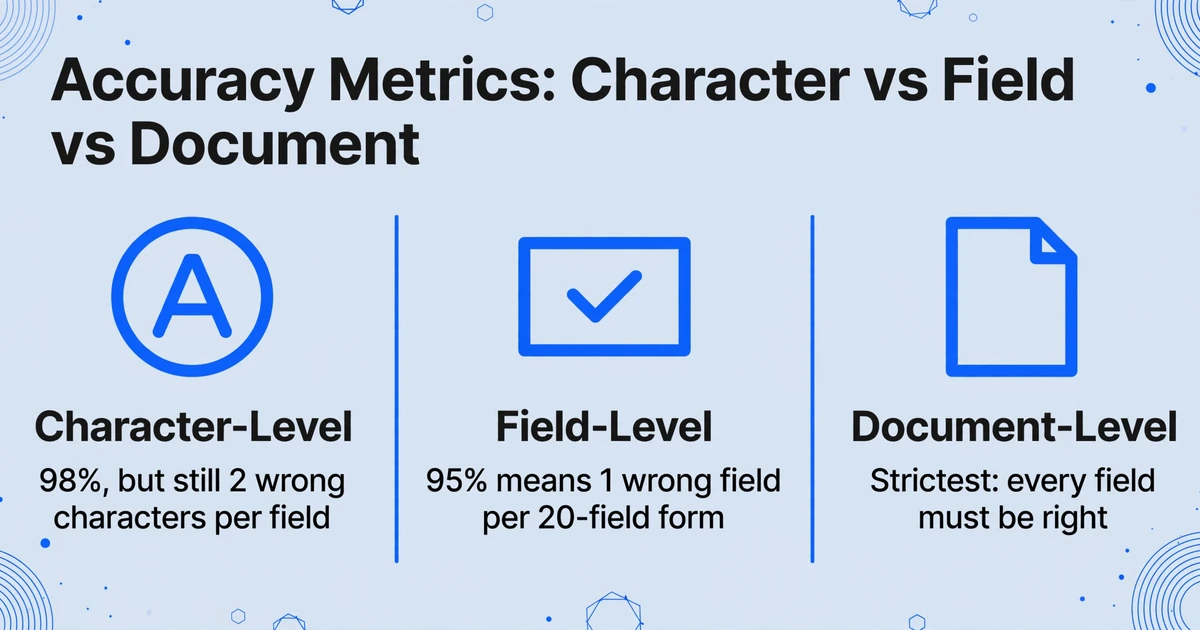
精度を向上させる前に、どの精度を測定しているのかを把握する必要があります。この用語はベンダーのベンチマークで条件を明示せずに使われることが多く、同じパーセンテージでも、何を数えているかによって意味がまったく異なります。
文字レベルの精度は、正しく読み取れた個々の文字の割合を測定します。請求書番号の1文字の誤読 — 「INV-4829」が「INV-4820」になる — は、文字エラー1件ですが、フィールド全体の失敗1件でもあります。文字精度は98%と聞こえは良いですが、100フィールドのドキュメントでは、その2%のエラー率はフィールドあたり平均2文字の誤りを意味します。従来のOCRベンダーが文字精度を報告するのは、数字が大きく見えるからです。
フィールドレベルの精度は、完全なデータフィールドが正しく抽出された割合を測定します。フィールドは正しいか間違っているかのどちらかです — 請求書番号が一致するかしないか、日付が有効か無効かです。これはビジネスワークフローにとって重要な指標です。抽出されたデータが手動修正なしで使用できるかどうかに直接結びつくからです。20フィールドのフォームでフィールドレベルの精度が95%の場合、平均してフォーム1件につき1フィールドが誤りになります — そして、その誤ったフィールドが、フォームを自動処理できるか、人間のレビューが必要かを決定づけます。
ドキュメントレベルの精度は、すべてのフィールドが正しく抽出されたドキュメントの割合を測定します。これは最も厳しい指標であり、フィールド数に最も敏感です。フィールド精度が95%でも、20フィールドのドキュメントが完全に抽出される確率はわずか36%です(0.95²⁰ ≈ 0.36)。ドキュメントレベルの精度は、人間のレビューなしでそのまま処理できるドキュメントがどれだけあるかを把握するのに役立ちます — しかし、ほとんどのベンダーは、システムが正常に機能していても数字が低く見えるため、これを報告しません。
経験則:ベンダーが「精度99%」と言ったら、「何に対する99%か?」と尋ねてください。文字精度が99%でも、ドキュメントあたり複数の誤ったフィールドが発生する可能性があります。フィールド精度が99%は本当に素晴らしいですが、手書き文字では稀です。手書き文字でドキュメント精度が99%は、現在の技術では達成不可能です — そして、それに反する主張は、ご自身の最悪のケースのドキュメントで検証するべきです。
レイヤー1 — 入力品質:精度を測定可能な差で動かす変数
抽出精度に最も影響する変数はAIモデルの中にはありません。ドキュメントがモデルに届くまでの方法にあります。複数の独立したベンチマークが、影響度順に同じ4つの要因に収束しています。
解像度:300 DPIを下回る50 DPIごとに、およそ3〜5ポイントの精度低下
解像度は、抽出精度において単一で最も大きな制御可能な要因です。300 DPIでは、手書きの文字「6」は、モデルが「8」や「0」と形状を区別できる十分なピクセル数を占めます。150 DPI(ファックスや古いスキャンアーカイブで一般的)では、同じ文字のピクセル密度は半分になり、「6」と「8」の違いは曖昧な塊に潰れてしまいます。精度の低下は線形ではありません。300から250 DPIへの低下は3〜4ポイントのコストです。200から150 DPIへの低下は6〜8ポイントです。150 DPI未満では、手書きのストロークはそもそもより細く、よりばらつきがあるため、手書き文字の精度は印刷テキストよりも速く劣化します。
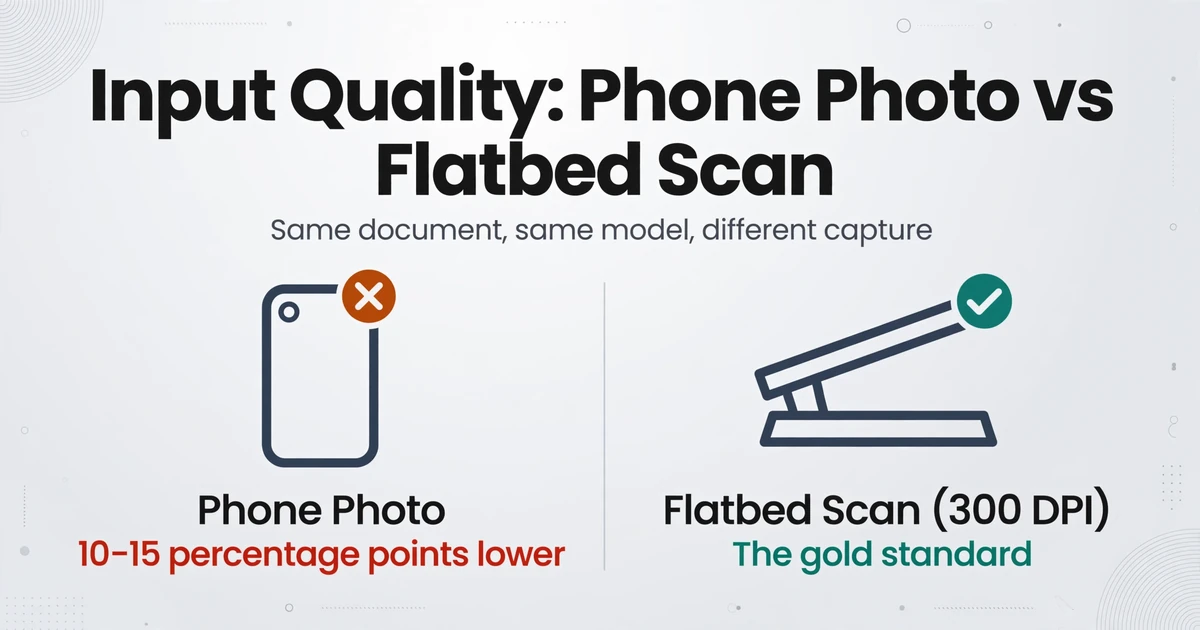
照明と傾き:スマホ撮影はフラットベッドスキャンと比較して10〜15ポイントの精度低下
同じ解像度の同じドキュメントでも、キャプチャ方法によって抽出結果は異なります。均一な照明での300 DPIのフラットベッドスキャンがゴールドスタンダードです。同じドキュメントのスマホ撮影(たとえ十分な解像度であっても)は、傾き、不均一な照明、影、JPEG圧縮アーティファクトをもたらします。これらのそれぞれが、文字認識を独立して劣化させます。2026年のBusinesswaretechベンチマークはこのパターンを確認しました:同一モデル、同一ドキュメント、異なるキャプチャ方法で10ポイントの低下です。AIは同じコンテンツを読んでいましたが、写真が十分な曖昧さをもたらし、10フィールドに1つを失う結果となりました。
背景ノイズと用紙の欠陥
シミ、折り目、ページ裏面からの透け、手書き文字の背後にある印刷された罫線などは、モデルが実際のテキストと区別しなければならない視覚的な干渉を生み出します。手書きの数字にコーヒーのシミがかかると、シミが上部ループの隙間を覆ってしまうため、「3」が「8」と読み取られることがあります。医療用問診票や政府の申請書によく見られる、印刷されたフォームのラベルと手書きの記入が重なるケースは、従来のOCRを完全に混乱させ、モデルが重なり合うテキストの流れを分離する必要があるため、VLMの精度を5〜8ポイント低下させます。
混合コンテンツ:印刷ラベル+手書き記入+スタンプ
抽出にとって最も難しい文書クラスは、純粋な手書き文字ではありません。印刷されたフォームのラベル、手書きの記入、スタンプ、署名が同じ視覚空間に共存する混合コンテンツ文書です。モデルは、どのテキストがどのフィールドに属するかを判断し、装飾的な要素を無視し、手書きの値を対応する印刷ラベルに正しく関連付ける必要があります。150,000ページ以上を処理したRedditのプロダクションユーザーは、専用の手書き文字ソリューションが汎用ツールよりも優れていたのは、単独の文字認識だけでなく、この関連付けの問題に特化して最適化されていたからだと指摘しています (r/computervision, 2025)。
レイヤー2 — フィールド設計:列名がキャリブレーションである理由
ほとんどの精度に関する議論では、抽出エンジンをブラックボックスとして扱います。文書を入れるとデータが出てきて、できることは入力を改善することだけだと考えられています。しかし、AIベースの抽出、特にフィールドを定義してAIがフィールドの意味を理解してそれらを特定するカスタム列抽出を使用するシステムでは、列の名前の付け方が精度に直接影響します。これは、ほとんどのチームがスキップしているキャリブレーションのステップです。
列名の設定:意味の正確さが抽出精度を左右する
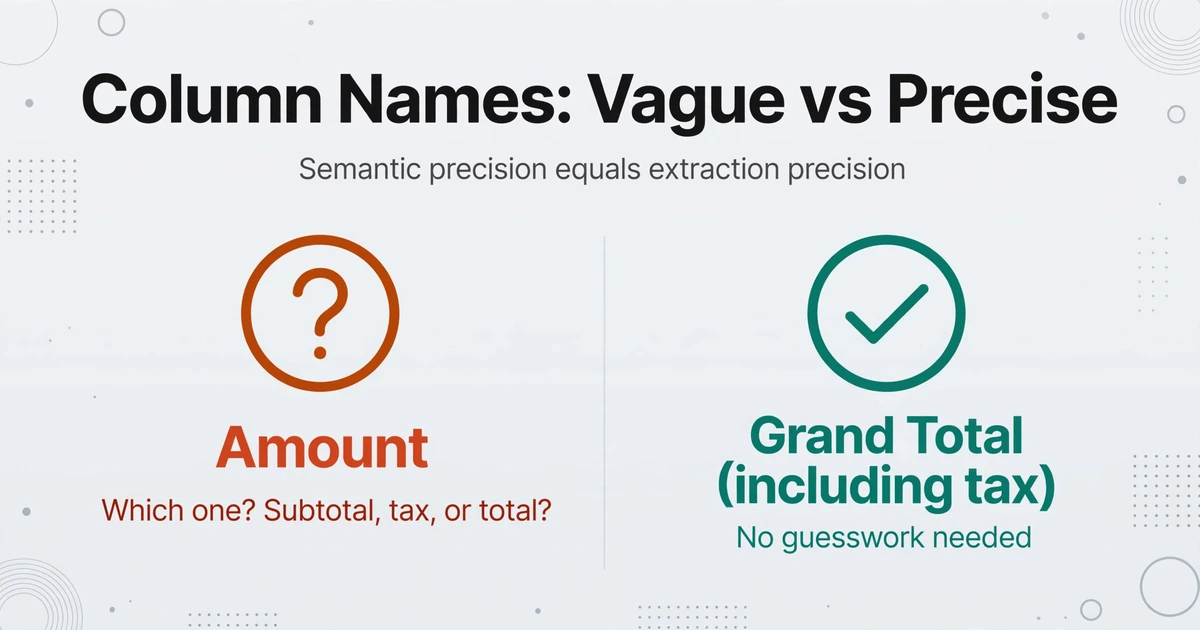
「日付」のような列名を入力すると、AIは請求書日付、期日、納品日、署名日など、ページ上のどの日付を指すのか推測する必要があります。この曖昧さが、誤った値を選択する可能性を生みます。「請求書日付」という列名はその曖昧さを排除します。「請求書発行日(YYYY-MM-DD)」とすればさらに明確になり、期待する出力形式もAIに伝わるため、抽出後の正規化エラーが減少します。これは優れたデータベーススキーマ設計と同じ原則です。つまり、名前は、新しい人が見ても何のフィールドか迷わずに理解できるほど具体的であるべきです。
これは手書き文書に多い数値フィールドで特に重要です。「金額」は、手書きの請求書において小計、税額、割引額、または総計のいずれかになり得ます。そしてAIは、フィールド名以外の文脈的な制約がない場合、推測に頼ることになります。「総計(税込)」とすれば、推測の余地はなくなります。その改善効果は決して微々たるものではありません。社内テストでは、曖昧な列名を意味的に正確なものに変更したところ、類似した数値フィールドが複数存在する文書(まさに手書き文書でエラーが発生しやすいシナリオ)において、フィールドレベルの精度が5~12パーセントポイント向上しました。
推論列:異なる精度の期待値を設定する
一部の抽出システムは推論列をサポートしています。これは、文書に明示的に記載されていない値をAIが判断するフィールドです。例えば、「カテゴリ(選択肢:食事/交通/オフィス/その他)」という列名は、レシートの内容を読み取り、適切なカテゴリを推論するようAIに指示します。たとえ「カテゴリ」がレシートに印刷されたフィールドでなくてもです。これは非常に有用な機能ですが、直接抽出とは異なる精度の特性を持ちます。
直接抽出の精度は、モデルのテキスト読み取り能力に依存します。推論列の精度は、モデルのテキスト読み取り能力とそれに基づく推論能力に依存します。これは2段階の認知プロセスであり、それぞれに失敗の可能性があります。明確な選択肢(3~5個の明確なカテゴリ)がある分類タスクの場合、精度は通常80~90%です。自由形式の推論(「患者の状態を一文で要約してください」)の場合、「正しさ」が主観的になるため、精度のベンチマークは難しくなります。実用的なルールとしては、明確に定義されたカテゴリを持つ分類タスクに推論列を使用し、直接抽出フィールドよりも高い頻度でスポットチェックを行って出力を検証することです。
ファイルは安全に処理され、保存されません。
レイヤー3 — 検証: 信頼度しきい値と人的レビュー
入力品質が最適で、カラム設計が正確であっても、すべてのフィールドがすべての文書で正しく抽出されるとは限りません。精度向上の第3のレイヤーは、抽出をより良くすることではなく、エラーが下流のシステムに入る前に検出することです。
信頼度スコアリング:低信頼度フィールドをレビューに回す
最新のAI抽出システムは、各フィールドに信頼度スコア(0から1の間の数値で、モデル自身が抽出結果の正しさをどの程度確信しているかを表す)を割り当てます。最も効果的な本番環境での導入では、これらのスコアを合否のゲートではなく、ルーティングロジックとして使用します。エラーが高コストになるフィールド(支払金額、契約日、患者ID)には、高い信頼度しきい値(0.90以上)を設定します。そのしきい値を下回るものはすべて、人間によるレビューキューに回します。エラーが不便ではあるものの致命的ではないフィールド(ベンダー名、参照番号、品目説明)には、中程度のしきい値(0.70〜0.85)を設定します。これらは、完全な人間によるレビューではなく、自動検証チェック(形式検証、範囲チェック)を通過させます。
本番環境での経験から得られる重要な洞察は、信頼度スコアはフィールドタイプ間で均等に調整されているわけではないということです。日付フィールドの信頼度スコア0.85は、自由形式のメモフィールドの0.85よりも信頼性が高くなります。これは、日付には制約された形式があり、モデルの不確実性が軽減されるためです。キャリブレーション演習(100〜200件のサンプルドキュメントで信頼度スコアと実際の正しさを比較する)を実施することで、全フィールドにわたる単一のグローバルなしきい値よりも優れた、フィールドタイプ固有のしきい値を得ることができます。
ビジネスルールを第二の安全網として
自動検証ルールは、信頼度スコアリングが見逃すエラーを捕捉します。「2025-13-45」と読める日付フィールドは、信頼度が高い(文字が明確である)ものの、有効な日付ではありません。明細項目の合計と一致しない合計金額は、各数値がどれだけ明確に読み取られたかに関係なく、内部的に不整合です。手書き文書は、文字の曖昧さによってもっともらしく見えるが誤った値が作成されるため、これらのエラーが特に発生しやすくなります。ビジネスルール(日付の妥当性、範囲チェック、フィールド間の整合性、必須フィールドの存在)は、抽出後、データがシステムに入る前の自動化されたセカンドパスとして機能します。これらは、文字レベルの読み取りでは正しく見えるが、論理的な検証に失敗するエラーを捕捉します。
精度の限界:どのツールでも解決できないこと
入力品質、フィールド設計、検証で達成できることには限界があります。それを正直に認めることで、ツールを責め、ツールを乗り換え、同じ限界がどこにでも存在することを発見するという悪循環を防ぐことができます。
本当に判読不能な手書き文字には、技術的な解決策はありません。 人間の読者が手書きの単語の内容を判断できない場合(筆圧が強すぎて潰れている、インクが薄れている、文字が交差しているなど)、AIモデルも同じ曖昧さに直面します。違いは、AIは推測し、時にはもっともらしく推測するのに対し、人間はそのフィールドを「判読不能」とマークすることです。これは、私たちのAIと従来のOCRの比較で議論した幻覚リスクです。モデルの文脈推論は通常は利点ですが、本当に曖昧な入力に対してもっともらしいデータを補完する場合には、欠点になります。信頼度スコアとレビューステップだけが唯一の防御策です。
手書きスタイルの多様性には、どのトレーニングデータセットもカバーできないロングテールが存在します。 ラテンアルファベットの筆記体でトレーニングされたモデルは、トレーニングデータに含まれる一般的な書き方を処理できます。しかし、高度に様式化された個人用の略記法、非標準の略語、左利きの傾斜パターン、印刷テキストに重ねて書かれた文字には苦労します。これらのエッジケースでの精度低下はバグではなく、すべての現在のモデルに見られる分布の変化です。モデルが設計された文書での95%の精度は、トレーニング分布の端にある文書では70%になる可能性があります。どの文書がこのロングテールに該当するか——通常は最も古く、最も不規則な受付文書の10〜15%——を認識することで、自動パイプラインで静かに失敗させるのではなく、直接手動処理に回すことができます。
フィールド間の依存関係は、フロンティアの問題です。 手書きフォームに、条件に応じて追加フィールドを表示するチェックボックスがある場合——「はい」にチェックを入れてから詳細を記入する——チェックボックスを見逃すと、複数の依存フィールドも見逃すことになります。これは文字の誤認識よりも高レベルの障害モードです。広範な条件ロジックを持つフォーム(医療問診、保険申請、政府の資格審査フォーム)では、この構造的な精度の側面が個々の文字精度よりも重要になることが多く、ベンダーのベンチマークでは最も議論されていません。実用的な対策は、抽出カラムセットを設計して条件トリガーフィールド(「既往症の有無」)を明示的にキャプチャし、依存フィールドがトリガーが存在する場合にのみ入力されることを検証することです。このチェックボックスカスケードの失敗は、私たちの手書き文書抽出が失敗する8つのパターンの分類のうちの1つです。
よくある質問
手書き文字認識の精度を上げるために、最も効果的な方法は何ですか?
入力品質を向上させることです。最低300 DPIでスキャンし、可能であればスマートフォンのカメラではなくフラットベッドスキャナーを使用し、テキスト領域に影がかからないよう均一な照明を確保してください。この一手間(スマホ撮影から適切に照明を当てたスキャンへの変更)だけで、パイプラインの他の変数に一切触れずに、精度を10~15%向上させることができます。
手書き文書で99%の精度は期待できますか?
フィールドレベルでは、すべての手書きスタイルにおいては期待できません。最適な入力品質で、定型フォームのブロック体手書き文字であれば、90~95%のフィールド精度が達成可能です。混合筆記体や劣化した文書では、75~88%を想定してください。一般的な手書き文字に対して99%のフィールド精度を謳う人には、「どの指標の99%で、誰の文書で、どのような条件下ですか?」と尋ねるべきです。最も状態の悪い10%の自社文書でテストするよう要求しましょう。その数字が通用するかどうかは、それらの文書で決まります。
エラーの原因が入力品質なのか、AIモデルなのかを判断するにはどうすればよいですか?
同じ文書を2回抽出にかけてください。1回は元の入力で、もう1回はクリーニング版(300 DPIで再スキャン、傾き補正、コントラスト調整済み)で行います。精度が向上すれば、元の入力品質がボトルネックでした。精度が変わらなければ、ボトルネックはモデルの手書き認識能力か、フィールド設計(曖昧な列名、制約のないフィールド定義)のいずれかです。この差分テストにより、5分以内に変数を特定できます。
前処理ソフトウェアは実際に効果があるのでしょうか、それとも過大評価されていますか?
前処理が文書の種類に合っていれば効果があります。傾き補正、コントラスト強調、ノイズ低減はすべて、AIエンジンが読み取りを開始する前に認識を向上させます。その効果は測定可能です。中程度の品質問題(わずかな傾き、低コントラスト、背景ノイズ)がある文書では、前処理によって精度を5~8%回復できます。しかし、前処理は画像に存在しない情報を復元することはできません。つまり、撮影されなかった解像度を生み出すことはできません。150 DPIでスキャンしたものを300 DPIのように前処理しても、パフォーマンスは150 DPIスキャンのままです。
より重要なのは、カラムの修正ですか、それとも入力品質の改善ですか?
入力品質が先、カラムはその次です。300 DPIの鮮明なスキャンで不適切なカラム名でも、ぼやけたスマホ写真で完璧なカラム名よりも精度よく抽出できます。ただし、入力品質が許容レベルに達したら、カラム名の最適化はコストゼロで最も効果の高い改善です。「日付」を「請求書発行日(YYYY-MM-DD)」に変更するだけで、これまで各バッチで一定割合のフィールドが誤った日付を抽出していた曖昧さを解消できます。この修正は10秒で完了し、今後処理するすべてのドキュメントに適用されます。
現在の立ち位置がわかるテスト
ベンチマークやブログ記事の精度パーセンテージは、平均的な可能性を理解するのに役立ちます。しかし、あなたのチームの手書き文字、現場スタッフの略語、10年前のスキャンフォームを含む、あなたのドキュメントで何が起こるかを理解するのには役立ちません。重要なのは、自社ドキュメントでの差分テストだけです。抽出を実行し、フィールドレベルの精度を測定し、1つの変数(入力品質またはカラム設計)を改善して、再度実行します。2つの数値の差が、どのレイヤーがボトルネックか、そして実際にどれだけの精度を回復できるかを示します。