Comment améliorer les résultats d'extraction d'écriture manuscrite par IA : qualité des entrées, conception des champs et attentes
Cinq techniques pratiques pour améliorer la précision de l'extraction d'écriture manuscrite : éclairage, mise en page, nommage des champs, cohérence des lots et savoir quand accepter une vérification signalée par le score de confiance.
Ce que « précision » signifie réellement
Avant de pouvoir améliorer la précision, vous devez savoir quelle précision vous mesurez. Le terme est utilisé dans les benchmarks des fournisseurs sans qualification, et le même pourcentage signifie des choses complètement différentes selon ce qui est compté.
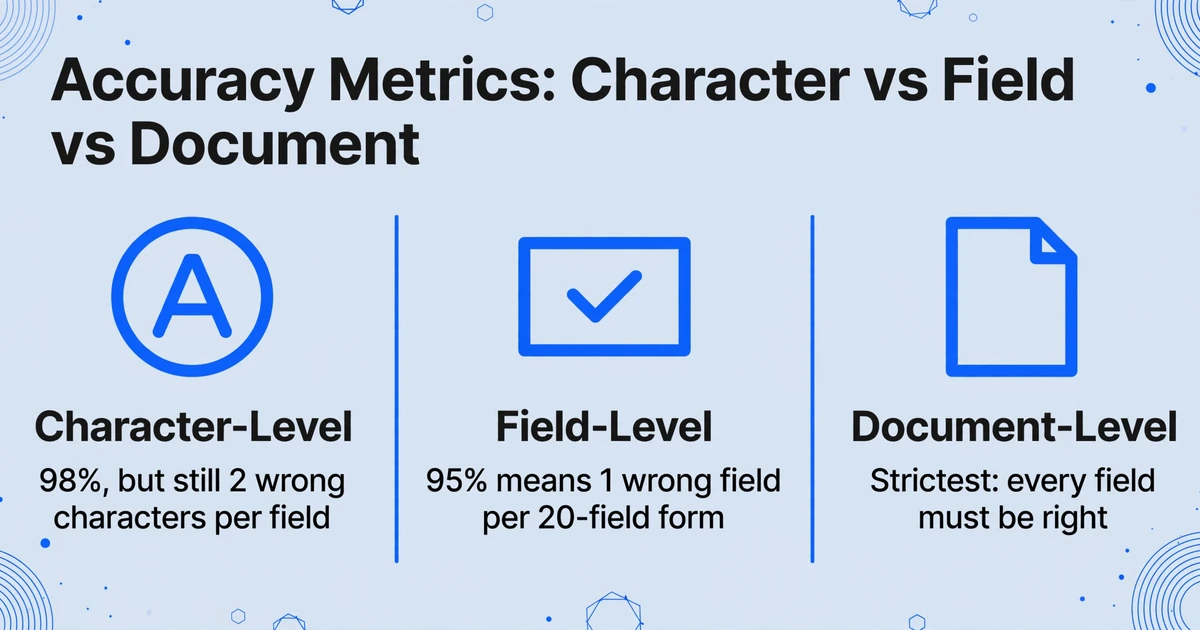
La précision au niveau des caractères mesure le pourcentage de caractères individuels lus correctement. Un seul caractère mal lu dans un numéro de facture — « INV-4829 » devenant « INV-4820 » — représente une erreur de caractère mais un échec complet du champ. La précision des caractères semble impressionnante à 98 %, mais sur un document de 100 champs, ce taux d'erreur de 2 % se traduit en moyenne par deux caractères incorrects par champ. Les fournisseurs d'OCR traditionnels rapportent la précision des caractères parce que c'est le nombre le plus élevé.
La précision au niveau des champs mesure le pourcentage de champs de données complets extraits correctement. Un champ est soit correct, soit incorrect — le numéro de facture correspond ou non, la date est valide ou non. C'est la métrique qui compte pour les flux de travail métier car elle correspond directement à la possibilité d'utiliser les données extraites sans correction manuelle. Un taux de précision au niveau des champs de 95 % sur un formulaire de 20 champs signifie qu'en moyenne, un champ par formulaire sera incorrect — et ce champ incorrect détermine si le formulaire peut être traité automatiquement ou nécessite une revue humaine.
La précision au niveau du document mesure le pourcentage de documents où tous les champs ont été extraits correctement. C'est la métrique la plus stricte et celle qui est la plus sensible au nombre de champs. Même avec une précision de champ de 95 %, un document de 20 champs n'a que 36 % de chances d'être parfaitement extrait (0,95²⁰ ≈ 0,36). La précision au niveau du document est utile pour comprendre combien de documents peuvent passer directement sans aucune revue humaine — mais la plupart des fournisseurs ne la rapportent pas car le nombre semble faible même lorsque le système fonctionne bien.
La règle empirique : lorsqu'un fournisseur annonce « 99 % de précision », demandez « 99 % de quoi ? » Une précision des caractères de 99 % peut encore signifier plusieurs champs incorrects par document. Une précision des champs de 99 % est réellement impressionnante mais rare sur l'écriture manuscrite. Une précision du document de 99 % sur l'écriture manuscrite n'est pas réalisable avec la technologie actuelle — et toute affirmation contraire devrait être testée sur vos propres documents les plus difficiles.
Couche 1 — Qualité de l'entrée : les variables qui font varier la précision de manière mesurable
Les variables qui affectent le plus la précision de l'extraction ne se trouvent pas dans le modèle d'IA. Elles se trouvent dans la manière dont le document parvient au modèle. Plusieurs benchmarks indépendants convergent vers les quatre mêmes facteurs, classés par impact.
Résolution : chaque tranche de 50 DPI sous 300 coûte environ 3 à 5 points de pourcentage
La résolution est le facteur contrôlable le plus important dans la précision de l'extraction. À 300 DPI, un caractère manuscrit « 6 » occupe suffisamment de pixels pour que le modèle puisse distinguer sa forme d'un « 8 » ou d'un « 0 ». À 150 DPI — courant pour les télécopies et les archives numérisées plus anciennes — ce même caractère a une densité de pixels réduite de moitié, et la différence entre « 6 » et « 8 » s'effondre en une tache ambiguë. La baisse de précision n'est pas linéaire. Passer de 300 à 250 DPI coûte 3 à 4 points de pourcentage. Passer de 200 à 150 DPI en coûte 6 à 8. Sous 150 DPI, la précision sur l'écriture manuscrite se dégrade plus vite que sur le texte imprimé, car les traits manuscrits sont plus fins et plus variables dès le départ.
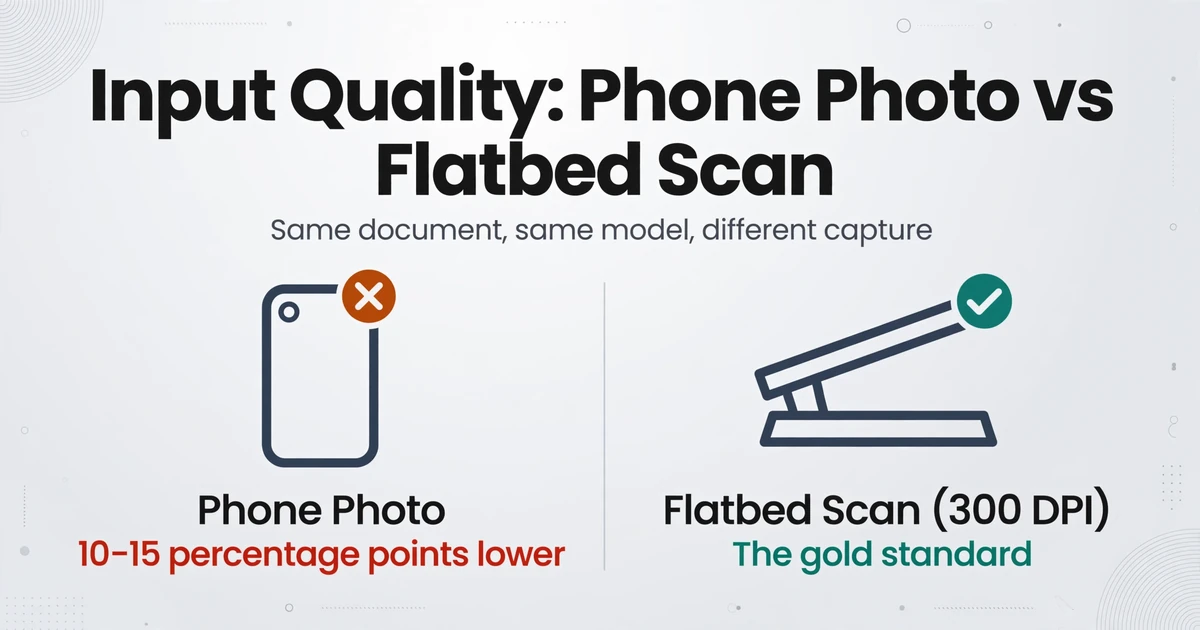
Éclairage et inclinaison : les photos de téléphone coûtent 10 à 15 points de pourcentage par rapport aux scans à plat
Le même document à la même résolution produira des résultats d'extraction différents selon la manière dont il a été capturé. Un scan à plat à 300 DPI avec un éclairage uniforme est la référence absolue. Une photo de téléphone du même document — même à résolution adéquate — introduit de l'inclinaison, un éclairage inégal, des ombres et des artefacts de compression JPEG. Chacun de ces éléments dégrade la reconnaissance des caractères indépendamment. Le benchmark Businesswaretech 2026 a confirmé ce schéma : modèle identique, document identique, méthode de capture différente — une baisse de 10 points de pourcentage. L'IA lisait le même contenu ; la photo a introduit suffisamment d'ambiguïté pour perdre un champ sur dix.
Bruit de fond et défauts du papier
Taches, plis, transparence depuis le verso de la page et grilles imprimées derrière des écritures manuscrites — ces éléments créent une interférence visuelle que le modèle doit distinguer du texte réel. Une tache de café traversant un chiffre manuscrit peut faire lire un « 3 » comme un « 8 », car la tache masque l'espace dans la boucle supérieure. Les étiquettes imprimées du formulaire qui chevauchent les écritures manuscrites — courantes sur les formulaires médicaux d'admission et les demandes gouvernementales — perturbent entièrement l'OCR traditionnel et réduisent la précision du VLM de 5 à 8 points de pourcentage, car le modèle doit séparer des flux de texte superposés.
Contenu mixte : étiquettes imprimées + valeurs manuscrites + tampons
La catégorie de documents la plus difficile à extraire n'est pas l'écriture manuscrite pure. Ce sont les documents à contenu mixte, où les étiquettes imprimées du formulaire, les écritures manuscrites, les tampons et les signatures coexistent dans le même espace visuel. Le modèle doit déterminer quel texte appartient à quel champ, ignorer les éléments décoratifs et attribuer correctement les valeurs manuscrites à leurs étiquettes imprimées. Un utilisateur de production sur Reddit, ayant traité plus de 150 000 pages, a noté que les solutions spécialisées en écriture manuscrite surpassaient les outils généralistes précisément parce qu'elles étaient optimisées pour ce problème d'attribution — et non seulement pour la reconnaissance de caractères isolée (r/computervision, 2025).
Couche 2 — Conception des champs : pourquoi les noms de colonnes sont un calibrage
La plupart des discussions sur la précision traitent le moteur d'extraction comme une boîte noire : les documents entrent, les données sortent, et la seule chose que l'on peut faire est d'améliorer l'entrée. Mais avec l'extraction basée sur l'IA — en particulier les systèmes qui utilisent l'Extraction de colonnes personnalisées, où vous définissez les champs souhaités et où l'IA les localise en comprenant la sémantique des champs — la façon dont vous nommez vos colonnes influence directement la précision. C'est une étape de calibrage que la plupart des équipes négligent.
Nommage des colonnes : précision sémantique = précision d'extraction
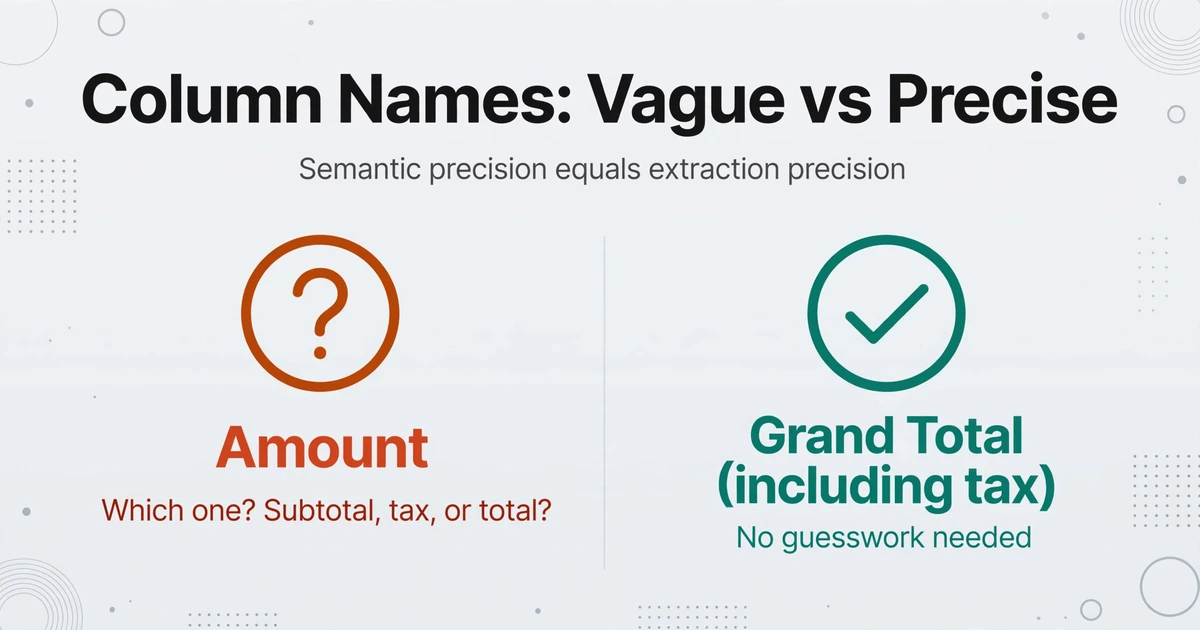
Lorsque vous saisissez un nom de colonne comme « Date », l'IA doit deviner quelle date de la page vous voulez — date de facture, date d'échéance, date de livraison, date de signature. Chaque ambiguïté introduit un risque de sélectionner la mauvaise valeur. Une colonne nommée « Date de facture » supprime cette ambiguïté. Une colonne nommée « Date d'émission de la facture (AAAA-MM-JJ) » la supprime davantage et indique aussi à l'IA le format de sortie attendu, réduisant les erreurs de normalisation post-extraction. Le principe est le même que celui qui régit la bonne conception de schéma de base de données : les noms doivent être suffisamment spécifiques pour qu'une nouvelle personne qui les lit sache exactement ce qui va dans le champ sans avoir à demander.
Ceci est particulièrement important pour les champs numériques courants dans les documents manuscrits. « Montant » pourrait être un sous-total, un montant de taxe, une remise ou un total général sur une facture manuscrite — et l'IA, manquant de contraintes contextuelles au-delà du nom du champ, devinera. « Total général (TTC) » supprime les conjectures. L'amélioration n'est pas marginale. Lors de tests internes, le renommage de colonnes ambiguës en noms sémantiquement précis a amélioré la précision au niveau du champ de 5 à 12 points de pourcentage sur des documents comportant plusieurs champs numériques d'apparence similaire — le scénario exact où les documents manuscrits sont les plus sujets aux erreurs.
Colonnes inférées : définir différentes attentes de précision
Certains systèmes d'extraction prennent en charge les colonnes inférées : des champs où l'IA détermine une valeur non explicitement écrite sur le document. Par exemple, une colonne nommée « Catégorie (options : Repas/Transport/Bureau/Autre) » demande à l'IA de lire le contenu du reçu et d'en déduire la catégorie correcte — même si « Catégorie » n'est pas un champ imprimé sur le reçu. C'est une capacité vraiment utile, mais elle fonctionne sur une courbe de précision différente de celle de l'extraction directe.
La précision de l'extraction directe dépend de la capacité du modèle à lire le texte. La précision des colonnes inférées dépend de la capacité du modèle à lire le texte et à raisonner à son sujet — un processus cognitif en deux étapes avec deux points de défaillance potentiels. Pour l'inférence catégorielle avec des options claires (3 à 5 catégories distinctes), la précision atteint généralement 80 à 90 %. Pour l'inférence ouverte (« Résumez l'état du patient en une phrase »), la précision devient plus difficile à évaluer car « correct » est subjectif. La règle pratique : utilisez les colonnes inférées pour les tâches de classification avec des catégories bien définies ; vérifiez leur résultat par un contrôle ponctuel à un taux plus élevé que pour les champs d'extraction directe.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Couche 3 — Validation : seuils de confiance et vérification humaine
Même avec une qualité d'entrée optimale et une conception de colonnes précise, tous les champs ne seront pas extraits correctement sur chaque document. La troisième couche d'amélioration de la précision ne consiste pas à améliorer l'extraction — elle consiste à détecter les erreurs avant qu'elles n'entrent dans les systèmes en aval.
Score de confiance : orienter les champs à faible confiance vers une vérification
Les systèmes modernes d'extraction par IA attribuent des scores de confiance à chaque champ — un nombre entre 0 et 1 qui représente l'estimation par le modèle de la probabilité que l'extraction soit correcte. Les déploiements de production les plus efficaces utilisent ces scores comme logique d'acheminement, et non comme critères de réussite ou d'échec. Définissez un seuil de confiance élevé (0,90+) pour les champs où les erreurs coûtent cher — montants de paiement, dates de contrat, identifiants de patient. Acheminez tout ce qui est en dessous de ce seuil vers une file de vérification humaine. Définissez un seuil modéré (0,70–0,85) pour les champs où les erreurs sont gênantes mais pas catastrophiques — noms de fournisseurs, numéros de référence, descriptions d'articles. Laissez passer ceux-ci avec des contrôles de validation automatisés (vérification du format, contrôle de plage) plutôt qu'une vérification humaine complète.
L'enseignement clé de l'expérience en production est que les scores de confiance ne sont pas calibrés de manière égale selon les types de champs. Un score de confiance de 0,85 sur un champ de date est plus fiable que 0,85 sur un champ de note en texte libre, car les dates ont un format contraint qui réduit l'incertitude du modèle. Réaliser un exercice de calibration — comparer les scores de confiance à l'exactitude réelle sur 100 à 200 documents échantillons — permet d'obtenir des seuils spécifiques au type de champ qui surpassent un seuil global unique appliqué à tous les champs.
Les règles métier comme second filet de sécurité
Les règles de validation automatisées détectent les erreurs que le score de confiance ne repère pas. Un champ de date indiquant « 2025-13-45 » présente une confiance élevée (les caractères sont clairs) mais ne constitue pas une date valide. Un total qui ne correspond pas à la somme de ses lignes est incohérent en interne, quelle que soit la clarté de lecture de chaque nombre. Les documents manuscrits sont particulièrement sensibles à ces erreurs, car l'ambiguïté des caractères crée des valeurs plausibles mais incorrectes. Les règles métier — validité des dates, contrôles de plage, cohérence entre les champs, présence des champs obligatoires — servent de second passage automatisé après l'extraction, mais avant que les données n'entrent dans votre système. Elles détectent les erreurs qui semblent correctes pour un lecteur au niveau des caractères, mais qui échouent à la validation logique.
Le plafond de précision : ce qu'aucun outil ne peut corriger
Il existe une limite à ce que la qualité des entrées, la conception des champs et la validation peuvent accomplir — et en être conscient évite le cycle consistant à blâmer l'outil, à changer d'outil, puis à découvrir que le même plafond existe partout.
Une écriture manuscrite véritablement illisible n'a aucune solution technologique. Si un lecteur humain ne peut pas déterminer ce que dit un mot manuscrit — parce que les traits sont trop comprimés, que l'encre a pâli ou que l'écriture se croise — un modèle d'IA est confronté à la même ambiguïté. La différence est que l'IA devinera, et devinera parfois de manière plausible, là où un humain marquera le champ comme illisible. C'est le risque d'hallucination évoqué dans notre comparaison entre l'IA et l'OCR traditionnel : le raisonnement contextuel du modèle, généralement un atout, devient un inconvénient lorsqu'il comble avec des données plausibles une entrée réellement ambiguë. Le score de confiance et une étape de vérification sont les seules défenses.
La variété des styles d'écriture manuscrite présente une longue traîne qu'aucun ensemble de données d'entraînement ne couvre. Un modèle entraîné sur l'écriture cursive en alphabet latin gère les styles d'écriture courants représentés dans ses données d'entraînement. Il aura du mal avec les abréviations personnelles très stylisées, les abréviations non standard, les inclinaisons de gauchers et l'écriture superposée à du texte imprimé. La baisse de précision sur ces cas limites n'est pas un bug — c'est un changement de distribution que tous les modèles actuels présentent. Un taux de précision de 95 % sur les documents pour lesquels le modèle a été conçu peut tomber à 70 % sur les documents situés à la limite de sa distribution d'entraînement. Identifier lesquels de vos documents relèvent de cette longue traîne — généralement les 10 à 15 % les plus anciens et les plus irréguliers de votre flux — vous permet de les orienter directement vers un traitement manuel plutôt que de les laisser échouer silencieusement dans votre pipeline automatisé.
Les dépendances entre champs restent un problème de pointe. Si un formulaire manuscrit comporte une case à cocher qui révèle conditionnellement des champs supplémentaires — cochez « Oui » pour des antécédents, puis remplissez les détails — le fait de manquer la case à cocher entraîne l'omission de plusieurs champs dépendants. C'est un mode de défaillance de niveau supérieur à la mauvaise reconnaissance des caractères. Pour les formulaires comportant une logique conditionnelle étendue (admission médicale, demandes d'assurance, formulaires d'éligibilité gouvernementaux), cette dimension de précision structurelle importe souvent plus que la précision individuelle des caractères — et c'est la moins discutée dans les benchmarks des fournisseurs. L'atténuation pratique consiste à concevoir votre ensemble de colonnes d'extraction pour capturer explicitement les champs déclencheurs conditionnels (« Antécédents existants ? ») et à valider que les champs dépendants ne sont renseignés que lorsque le déclencheur est présent. Cette défaillance en cascade liée aux cases à cocher est l'un des huit modèles de notre taxonomie des causes d'échec de l'extraction de documents manuscrits.
FAQ
Quelle est la meilleure chose à faire pour améliorer la précision de l'extraction manuscrite ?
Améliorez la qualité d'entrée. Numérisez à 300 DPI minimum, utilisez de préférence un scanner à plat plutôt qu'un appareil photo, et assurez un éclairage uniforme sans ombres sur la zone de texte. Ce seul changement — passer de photos de téléphone à des numérisations bien éclairées — peut améliorer la précision de 10 à 15 points de pourcentage sans toucher à aucune autre variable.
Puis-je espérer une précision de 99 % sur des documents manuscrits ?
Pas au niveau du champ, et pas pour tous les styles d'écriture. Sur une écriture en lettres moulées dans des champs de formulaire contraints avec une qualité d'entrée optimale, une précision de 90 à 95 % par champ est atteignable. Sur une écriture cursive mixte ou des documents dégradés, attendez-vous à 75–88 %. Quiconque revendique 99 % de précision sur l'écriture manuscrite générale devrait se voir demander : « 99 % de quelle métrique, sur quels documents, et dans quelles conditions ? » Exigez de tester sur les 10 % les plus difficiles de vos propres documents — ce sont eux qui déterminent si le chiffre tient.
Comment savoir si une erreur vient de la qualité de mon entrée ou du modèle IA ?
Exécutez deux fois l'extraction du même document — une fois avec l'entrée d'origine et une fois avec une version nettoyée (re-numérisée à 300 DPI, redressée, contraste ajusté). Si la précision s'améliore, la qualité d'entrée d'origine était le goulot d'étranglement. Si elle reste identique, le problème vient soit de la capacité du modèle à traiter l'écriture manuscrite, soit de la conception du champ (noms de colonnes ambigus, définitions de champ non contraintes). Ce test différentiel isole la variable en moins de 5 minutes.
Les logiciels de prétraitement aident-ils vraiment, ou sont-ils surestimés ?
Ils aident lorsque le prétraitement est adapté au type de document. Le redressement, l'amélioration du contraste et la réduction du bruit améliorent tous la reconnaissance avant que le moteur IA ne commence à lire. L'impact est mesurable : le prétraitement peut récupérer 5 à 8 points de pourcentage de précision sur des documents présentant des problèmes de qualité modérés (légère inclinaison, faible contraste, bruit de fond). Mais le prétraitement ne peut pas récupérer des informations qui ne sont pas dans l'image — il ne peut pas créer une résolution qui n'a pas été capturée. Une numérisation à 150 DPI prétraitée pour ressembler à 300 DPI fonctionnera toujours comme une numérisation à 150 DPI.
Qu'est-ce qui est le plus important — corriger mes colonnes ou corriger la qualité de mes entrées ?
La qualité des entrées d'abord, les colonnes ensuite. Un nom de colonne mal conçu sur un scan propre à 300 DPI donnera toujours une meilleure extraction qu'un nom de colonne parfait sur une photo floue prise au téléphone. Mais une fois la qualité des entrées à un niveau acceptable, l'optimisation des noms de colonnes est l'amélioration au meilleur rapport qualité-prix, qui ne coûte rien à mettre en œuvre. Renommez « Date » en « Date d'émission de la facture (AAAA-MM-JJ) » et vous aurez éliminé une ambiguïté qui, auparavant, faisait extraire la mauvaise date à un certain pourcentage de champs à chaque lot. La correction prend 10 secondes et s'applique à chaque document que vous traiterez à l'avenir.
Le test qui vous dit où vous en êtes
Les pourcentages de précision dans les benchmarks et les articles de blog sont utiles pour comprendre ce qui est possible en moyenne. Ils sont inutiles pour comprendre ce qui se passera avec vos documents — ceux avec l'écriture manuscrite de votre équipe, les abréviations de votre personnel de terrain, vos formulaires scannés vieux de dix ans. Le seul benchmark qui compte est un test différentiel sur vos propres documents : lancez l'extraction, mesurez la précision au niveau des champs, améliorez une variable (qualité des entrées ou conception des colonnes), relancez. L'écart entre les deux chiffres vous indique quelle couche est votre goulot d'étranglement — et combien de précision vous pouvez réellement récupérer.