So verbessern Sie die KI-Handschriftextraktion: Eingabequalität, Feldgestaltung und was Sie erwarten können
Fünf praktische Techniken zur Verbesserung der Handschriftextraktionsgenauigkeit: Beleuchtung, Layout, Feldbenennung, Batch-Konsistenz und das Wissen, wann Sie eine mit Konfidenzwert markierte Überprüfung akzeptieren sollten.
Was „Genauigkeit" tatsächlich bedeutet
Bevor Sie die Genauigkeit verbessern können, müssen Sie wissen, welche Genauigkeit Sie messen. Der Begriff wird in Anbieter-Benchmarks ohne nähere Erläuterung verwendet, und derselbe Prozentsatz bedeutet je nachdem, was gezählt wird, etwas völlig anderes.
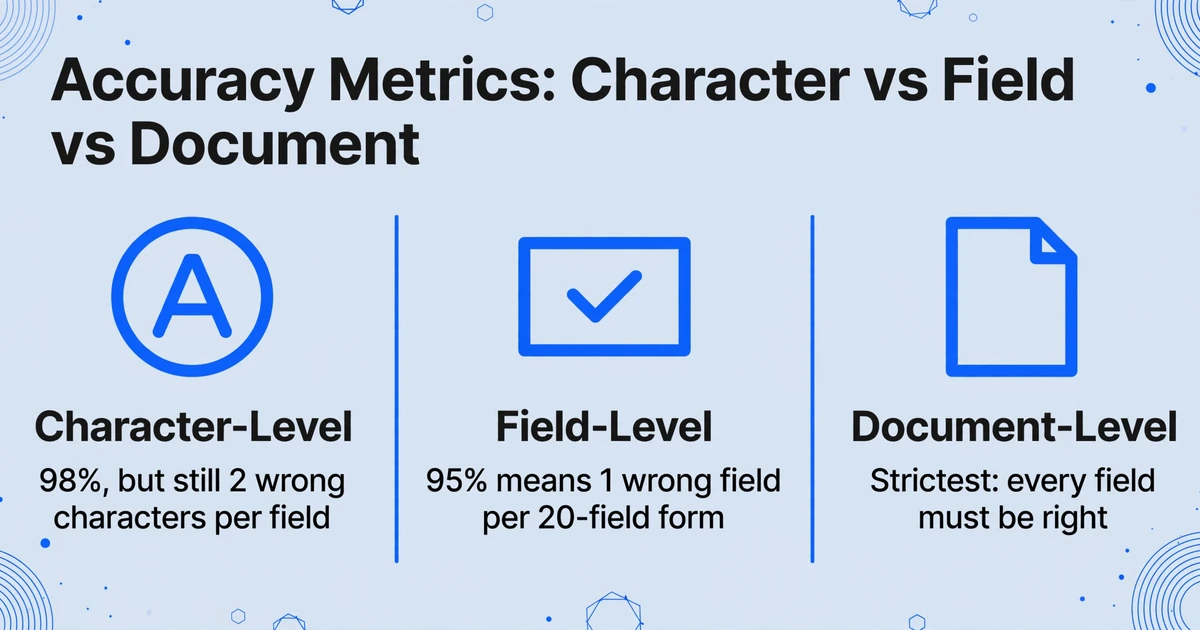
Zeichengenauigkeit misst den Prozentsatz der korrekt gelesenen einzelnen Zeichen. Ein einziges falsch gelesenes Zeichen in einer Rechnungsnummer – „INV-4829" wird zu „INV-4820" – stellt einen Zeichenfehler, aber einen vollständigen Feldausfall dar. Die Zeichengenauigkeit klingt mit 98 % beeindruckend, aber bei einem Dokument mit 100 Feldern bedeutet diese Fehlerquote von 2 % durchschnittlich zwei falsche Zeichen pro Feld. Traditionelle OCR-Anbieter berichten die Zeichengenauigkeit, weil sie die höhere Zahl ist.
Feldgenauigkeit misst den Prozentsatz der vollständig korrekt extrahierten Datenfelder. Ein Feld ist entweder richtig oder falsch – die Rechnungsnummer stimmt überein oder nicht, das Datum ist gültig oder nicht. Dies ist die Kennzahl, die für Geschäftsworkflows entscheidend ist, da sie direkt widerspiegelt, ob die extrahierten Daten ohne manuelle Korrektur verwendet werden können. Eine Feldgenauigkeit von 95 % bei einem Formular mit 20 Feldern bedeutet, dass im Durchschnitt ein Feld pro Formular falsch sein wird – und dieses falsche Feld entscheidet darüber, ob das Formular automatisch verarbeitet werden kann oder eine menschliche Überprüfung benötigt.
Dokumentgenauigkeit misst den Prozentsatz der Dokumente, bei denen jedes Feld korrekt extrahiert wurde. Dies ist die strengste Kennzahl und diejenige, die am empfindlichsten auf die Anzahl der Felder reagiert. Selbst bei einer Feldgenauigkeit von 95 % hat ein Dokument mit 20 Feldern nur eine Chance von 36 %, perfekt extrahiert zu werden (0,95²⁰ ≈ 0,36). Die Dokumentgenauigkeit ist nützlich, um zu verstehen, wie viele Dokumente ohne menschliche Überprüfung durchlaufen können – aber die meisten Anbieter berichten sie nicht, weil die Zahl niedrig aussieht, selbst wenn das System gut funktioniert.
Die Faustregel: Wenn ein Anbieter „99 % Genauigkeit" angibt, fragen Sie: „99 % wovon?" Eine Zeichengenauigkeit von 99 % kann immer noch mehrere falsche Felder pro Dokument bedeuten. Eine Feldgenauigkeit von 99 % ist wirklich beeindruckend, aber bei Handschrift selten. Eine Dokumentgenauigkeit von 99 % bei Handschrift ist mit der aktuellen Technologie nicht erreichbar – und jede gegenteilige Behauptung sollte anhand Ihrer eigenen schwierigsten Dokumente getestet werden.
Ebene 1 — Eingabequalität: Die Variablen, die die Genauigkeit um messbare Größenordnungen beeinflussen
Die Variablen, die die Extraktionsgenauigkeit am stärksten beeinflussen, liegen nicht im KI-Modell. Sie liegen darin, wie das Dokument das Modell erreicht. Mehrere unabhängige Benchmarks kommen bei denselben vier Faktoren zu denselben Ergebnissen, sortiert nach ihrer Auswirkung.
Auflösung: Jede 50 DPI unter 300 kosten etwa 3–5 Prozentpunkte
Die Auflösung ist der größte kontrollierbare Faktor für die Extraktionsgenauigkeit. Bei 300 DPI belegt ein handschriftliches Zeichen „6" genügend Pixel, damit das Modell seine Form von einer „8" oder einer „0" unterscheiden kann. Bei 150 DPI — üblich bei Faxen und älteren gescannten Archiven — hat dasselbe Zeichen nur die halbe Pixeldichte, und der Unterschied zwischen „6" und „8" verschwimmt zu einem uneindeutigen Fleck. Der Genauigkeitsabfall ist nicht linear. Der Wechsel von 300 auf 250 DPI kostet 3–4 Prozentpunkte. Der Wechsel von 200 auf 150 DPI kostet 6–8. Unter 150 DPI verschlechtert sich die Genauigkeit bei Handschrift schneller als bei gedrucktem Text, da handschriftliche Striche von vornherein dünner und variabler sind.
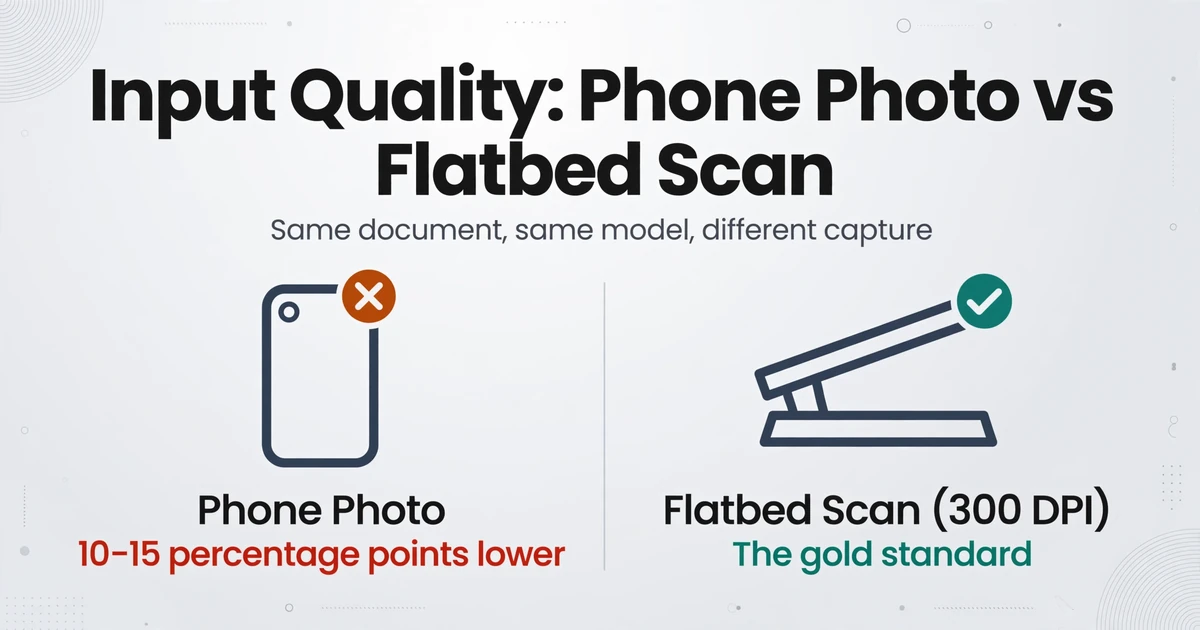
Beleuchtung und Schräglage: Handyfotos kosten 10–15 Prozentpunkte gegenüber Flachbettscans
Dasselbe Dokument in derselben Auflösung führt je nach Erfassungsmethode zu unterschiedlichen Extraktionsergebnissen. Ein Flachbettscan bei 300 DPI mit gleichmäßiger Beleuchtung ist der Goldstandard. Ein Handyfoto desselben Dokuments — selbst bei ausreichender Auflösung — führt zu Schräglage, ungleichmäßiger Beleuchtung, Schatten und JPEG-Komprimierungsartefakten. Jeder dieser Faktoren beeinträchtigt die Zeichenerkennung unabhängig voneinander. Der Businesswaretech-Benchmark von 2026 bestätigte dieses Muster: identisches Modell, identisches Dokument, andere Erfassungsmethode — ein Abfall von 10 Prozentpunkten. Die KI las denselben Inhalt; das Foto führte genug Uneindeutigkeit ein, um eines von zehn Feldern zu verlieren.
Hintergrundgeräusche und Papierfehler
Flecken, Knicke, Durchscheinen von der Rückseite der Seite sowie gedruckte Rasterlinien hinter handschriftlichen Einträgen – all das erzeugt visuelle Störungen, die das Modell von tatsächlichem Text unterscheiden muss. Ein Kaffeefleck, der eine handschriftliche Zahl kreuzt, kann dazu führen, dass eine „3" als „8" gelesen wird, weil der Fleck die Lücke in der oberen Schleife abdeckt. Gedruckte Formularbeschriftungen, die sich mit handschriftlichen Einträgen überlappen – häufig bei medizinischen Aufnahmeformularen und behördlichen Anträgen – verwirren herkömmliche OCR vollständig und reduzieren die VLM-Genauigkeit um 5–8 Prozentpunkte, da das Modell überlagerte Textströme trennen muss.
Gemischte Inhalte: gedruckte Beschriftungen + handschriftliche Werte + Stempel
Die schwierigste Dokumentklasse für die Extraktion ist nicht reine Handschrift. Es sind Dokumente mit gemischten Inhalten, bei denen gedruckte Formularbeschriftungen, handschriftliche Einträge, Stempel und Unterschriften im selben visuellen Raum koexistieren. Das Modell muss bestimmen, welcher Text zu welchem Feld gehört, dekorative Elemente ignorieren und handschriftliche Werte korrekt ihren gedruckten Beschriftungen zuordnen. Ein Produktions-Reddit-Nutzer, der über 150.000+ Seiten verarbeitet hat, stellte fest, dass spezialisierte Handschriftlösungen allgemeine Werkzeuge übertrafen, gerade weil sie für dieses Zuordnungsproblem optimiert waren – nicht nur für die Zeichenerkennung in Isolation (r/computervision, 2025).
Ebene 2 – Felddesign: Warum Spaltennamen eine Kalibrierung sind
Die meisten Diskussionen über Genauigkeit behandeln die Extraktions-Engine als Blackbox: Dokumente gehen hinein, Daten kommen heraus, und die einzige Möglichkeit besteht darin, die Eingabe zu verbessern. Doch bei KI-basierter Extraktion – insbesondere bei Systemen, die Benutzerdefinierte Spaltenextraktion verwenden, bei denen Sie die gewünschten Felder definieren und die KI sie durch Verständnis der Feldsemantik lokalisiert – beeinflusst die Benennung Ihrer Spalten direkt die Genauigkeit. Dies ist ein Kalibrierungsschritt, den die meisten Teams überspringen.
Spaltenbenennung: Semantische Präzision = Extraktionspräzision
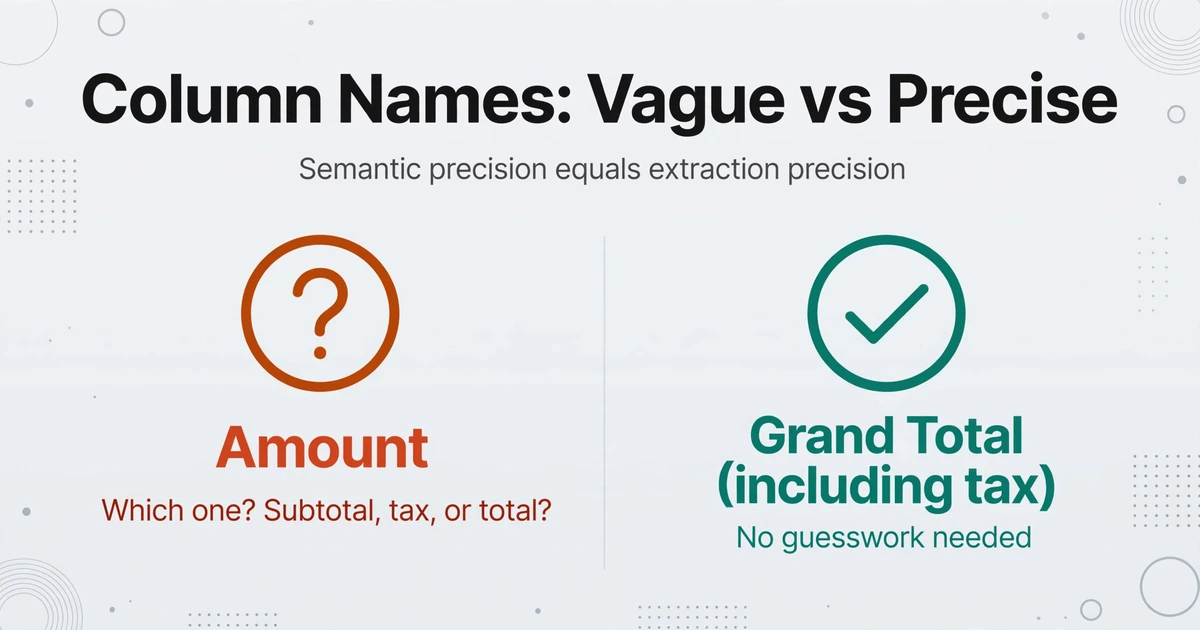
Wenn Sie einen Spaltennamen wie „Datum“ eingeben, muss die KI raten, welches Datum auf der Seite gemeint ist – Rechnungsdatum, Fälligkeitsdatum, Lieferdatum, Unterschriftsdatum. Jede Unklarheit erhöht die Wahrscheinlichkeit, den falschen Wert auszuwählen. Ein Spaltenname wie „Rechnungsdatum“ beseitigt diese Unklarheit. Ein Spaltenname wie „Rechnungsausstellungsdatum (JJJJ-MM-TT)“ beseitigt sie noch weiter und teilt der KI auch das erwartete Ausgabeformat mit, wodurch Normalisierungsfehler nach der Extraktion reduziert werden. Das Prinzip ist dasselbe wie bei gutem Datenbankdesign: Namen sollten so spezifisch sein, dass eine neue Person beim Lesen genau weiß, was in das Feld gehört, ohne nachfragen zu müssen.
Dies ist besonders wichtig für numerische Felder, die in handschriftlichen Dokumenten häufig vorkommen. „Betrag“ könnte eine Zwischensumme, ein Steuerbetrag, ein Rabatt oder eine Gesamtsumme auf einer handschriftlichen Rechnung sein – und die KI, der außer dem Feldnamen keine kontextuellen Einschränkungen vorliegen, wird raten. „Gesamtsumme (inkl. MwSt.)“ beseitigt das Rätselraten. Die Verbesserung ist nicht marginal. In internen Tests verbesserte die Umbenennung mehrdeutiger Spalten in semantisch präzise Bezeichnungen die Feldgenauigkeit um 5–12 Prozentpunkte bei Dokumenten mit mehreren ähnlich aussehenden numerischen Feldern – genau dem Szenario, in dem handschriftliche Dokumente am fehleranfälligsten sind.
Abgeleitete Spalten: Unterschiedliche Genauigkeitserwartungen setzen
Manche Extraktionssysteme unterstützen abgeleitete Spalten: Felder, in denen die KI einen Wert ermittelt, der nicht explizit auf dem Dokument steht. Beispielsweise weist eine Spalte mit dem Namen „Kategorie (Optionen: Mahlzeiten/Transport/Büro/Sonstiges)“ die KI an, den Beleginhalt zu lesen und die richtige Kategorie abzuleiten – obwohl „Kategorie“ kein gedrucktes Feld auf dem Beleg ist. Dies ist eine wirklich nützliche Funktion, aber sie arbeitet auf einer anderen Genauigkeitskurve als die direkte Extraktion.
Die Genauigkeit der direkten Extraktion hängt von der Fähigkeit des Modells ab, Text zu lesen. Die Genauigkeit abgeleiteter Spalten hängt von der Fähigkeit des Modells ab, Text zu lesen und darüber zu schlussfolgern – ein zweistufiger kognitiver Prozess mit zwei potenziellen Fehlerquellen. Bei kategorialen Schlussfolgerungen mit klaren Optionen (3–5 verschiedene Kategorien) liegt die Genauigkeit typischerweise bei 80–90 %. Bei offenen Schlussfolgerungen („Fassen Sie den Zustand des Patienten in einem Satz zusammen“) wird die Genauigkeit schwer zu messen, da „richtig“ subjektiv ist. Die praktische Regel: Verwenden Sie abgeleitete Spalten für Klassifizierungsaufgaben mit klar definierten Kategorien; überprüfen Sie deren Ausgabe stichprobenartig mit einer höheren Rate als bei direkten Extraktionsfeldern.
Dateien werden sicher verarbeitet und nicht gespeichert.
Ebene 3 – Validierung: Konfidenzschwellen und menschliche Prüfung
Selbst bei optimaler Eingabequalität und präzisem Spaltendesign werden nicht alle Felder auf jedem Dokument korrekt extrahiert. Die dritte Ebene der Genauigkeitsverbesserung zielt nicht darauf ab, die Extraktion zu verbessern – sondern darauf, Fehler zu erkennen, bevor sie in nachgelagerte Systeme gelangen.
Konfidenzbewertung: Felder mit niedriger Konfidenz zur Überprüfung weiterleiten
Moderne KI-Extraktionssysteme weisen einzelnen Feldern Konfidenzwerte zu – eine Zahl zwischen 0 und 1, die die eigene Einschätzung des Modells darüber darstellt, wie wahrscheinlich die Extraktion korrekt ist. Die effektivsten Produktionsumgebungen nutzen diese Werte als Routing-Logik, nicht als Bestehen/Nichtbestehen-Kriterien. Legen Sie einen hohen Konfidenzschwellenwert (0,90+) für Felder fest, bei denen Fehler teuer sind – Zahlungsbeträge, Vertragsdaten, Patientenidentifikatoren. Leiten Sie alles unterhalb dieses Schwellenwerts an eine Warteschlange zur menschlichen Überprüfung weiter. Legen Sie einen moderaten Schwellenwert (0,70–0,85) für Felder fest, bei denen Fehler ungünstig, aber nicht katastrophal sind – Lieferantennamen, Referenznummern, Artikelbeschreibungen. Lassen Sie diese mit automatisierten Validierungsprüfungen (Formatprüfung, Bereichsprüfung) durchlaufen, anstatt einer vollständigen menschlichen Überprüfung.
Die wichtigste Erkenntnis aus der Produktionserfahrung ist, dass Konfidenzwerte nicht über alle Feldtypen hinweg gleich kalibriert sind. Ein Konfidenzwert von 0,85 bei einem Datumsfeld ist zuverlässiger als 0,85 bei einem Freitext-Notizfeld, da Daten ein eingeschränktes Format haben, das die Unsicherheit des Modells reduziert. Eine Kalibrierungsübung – der Vergleich von Konfidenzwerten mit der tatsächlichen Korrektheit anhand von 100–200 Beispieldokumenten – liefert feldtypspezifische Schwellenwerte, die einen einzelnen globalen Schwellenwert für alle Felder übertreffen.
Geschäftsregeln als zweites Sicherheitsnetz
Automatisierte Validierungsregeln fangen Fehler ab, die die Konfidenzbewertung übersieht. Ein Datumsfeld, das „2025-13-45" anzeigt, hat eine hohe Konfidenz (die Zeichen sind klar), ist aber kein gültiges Datum. Eine Summe, die nicht mit der Summe ihrer Positionen übereinstimmt, ist intern inkonsistent, unabhängig davon, wie klar jede Zahl gelesen wurde. Handschriftliche Dokumente sind besonders anfällig für solche Fehler, da Zeichenmehrdeutigkeit plausibel aussehende, aber falsche Werte erzeugt. Geschäftsregeln – Datumsgültigkeit, Bereichsprüfungen, feldübergreifende Konsistenz, Vorhandensein erforderlicher Felder – dienen als automatisierter zweiter Durchgang nach der Extraktion, aber bevor Daten in Ihr System gelangen. Sie fangen Fehler ab, die für einen Leser auf Zeichenebene korrekt aussehen, aber die logische Validierung nicht bestehen.
Die Genauigkeitsgrenze: Was kein Tool beheben kann
Es gibt eine Untergrenze für das, was Eingabequalität, Feldgestaltung und Validierung erreichen können – und sich das ehrlich einzugestehen, verhindert den Kreislauf aus Schuldzuweisungen an das Tool, Tool-Wechsel und der Entdeckung, dass dieselbe Grenze überall existiert.
Für wirklich unleserliche Handschrift gibt es keine technologische Lösung. Wenn ein menschlicher Leser nicht ermitteln kann, was ein handschriftliches Wort sagt – weil die Striche zu stark komprimiert sind, die Tinte verblasst ist oder sich die Schrift selbst überschneidet –, steht ein KI-Modell vor derselben Mehrdeutigkeit. Der Unterschied besteht darin, dass die KI raten wird – und manchmal plausibel raten –, während ein Mensch das Feld als unlesbar markieren würde. Dies ist das Halluzinationsrisiko, das wir in unserem Vergleich von KI und traditioneller OCR diskutieren: Die kontextuelle Argumentation des Modells, normalerweise ein Vorteil, wird zum Nachteil, wenn es plausible Daten für wirklich mehrdeutige Eingaben ergänzt. Konfidenzwerte und ein Prüfschritt sind die einzigen Verteidigungsmaßnahmen.
Die Vielfalt der Handschriftstile hat einen langen Schwanz, den kein Trainingsdatensatz abdeckt. Ein Modell, das auf lateinischer Schreibschrift trainiert wurde, beherrscht die gängigen Schreibstile aus seinen Trainingsdaten. Es wird mit stark stilisierten persönlichen Abkürzungen, nicht standardisierten Kürzeln, linksschrägen Schriftmustern und Schrift, die auf gedruckten Text übergelagert ist, Schwierigkeiten haben. Der Genauigkeitsabfall bei diesen Randfällen ist kein Fehler – es ist eine Verteilungsverschiebung, die jedes aktuelle Modell aufweist. Eine Genauigkeit von 95 % bei den Dokumenten, für die das Modell entwickelt wurde, kann auf 70 % bei Dokumenten am Rand seiner Trainingsverteilung sinken. Wenn Sie erkennen, welche Ihrer Dokumente in diesen langen Schwanz fallen – in der Regel die ältesten, unregelmäßigsten 10–15 % Ihres Eingangs –, können Sie sie direkt der manuellen Verarbeitung zuführen, anstatt sie still in Ihrer automatisierten Pipeline scheitern zu lassen.
Übergreifende Feldabhängigkeiten bleiben ein Grenzproblem. Wenn ein handschriftliches Formular ein Kontrollkästchen enthält, das bedingt zusätzliche Felder einblendet – "Ja" bei früheren Erkrankungen ankreuzen, dann Details ausfüllen –, führt das Übersehen des Kontrollkästchens zu Folgefehlern bei mehreren abhängigen Feldern. Dies ist eine höherstufige Fehlerart als die Zeichenverkennung. Bei Formularen mit umfangreicher bedingter Logik (Gesundheitsfragebögen, Versicherungsanträge, staatliche Antragsformulare) ist diese strukturelle Genauigkeitsdimension oft wichtiger als die einzelne Zeichengenauigkeit – und sie wird in den Benchmarks der Anbieter am wenigsten thematisiert. Die praktische Abhilfe besteht darin, Ihr Extraktionsspaltenset so zu gestalten, dass die Trigger-Felder explizit erfasst werden (z. B. „Vorerkrankungen vorhanden?"), und zu validieren, dass abhängige Felder nur befüllt werden, wenn der Trigger vorhanden ist. Dieses Versagen bei Kontrollkästchen-Kaskaden ist eines der acht Muster in unserer Taxonomie der Fehlschläge bei der Extraktion handschriftlicher Dokumente.
FAQ
Was ist der wichtigste Hebel für bessere Handschrifterkennung?
Verbessern Sie die Eingabequalität. Scannen Sie mit mindestens 300 DPI, nutzen Sie nach Möglichkeit Flachbettscanner statt Handykameras und sorgen Sie für gleichmäßige Ausleuchtung ohne Schatten auf dem Text. Allein dieser Wechsel – von Handyfotos zu sauber ausgeleuchteten Scans – kann die Genauigkeit um 10–15 Prozentpunkte steigern, ohne dass Sie andere Parameter Ihrer Pipeline ändern müssen.
Kann ich bei handschriftlichen Dokumenten 99 % Genauigkeit erwarten?
Nicht auf Feldebene und nicht über alle Handschriftstile hinweg. Bei Blockschrift in klar definierten Formularfeldern mit optimaler Eingabequalität sind 90–95 % Feldgenauigkeit erreichbar. Bei gemischter Schreibschrift oder minderwertigen Dokumenten sind 75–88 % realistisch. Wer pauschal 99 % Feldgenauigkeit bei Handschrift verspricht, sollte gefragt werden: „99 % welcher Metrik, auf wessen Dokumenten, unter welchen Bedingungen?“ Bestehen Sie auf einem Test mit den chaotischsten 10 % Ihrer eigenen Dokumente – daran zeigt sich, ob die Zahl hält.
Woran erkenne ich, ob ein Fehler an der Eingabequalität oder am KI-Modell liegt?
Führen Sie die Extraktion zweimal mit demselben Dokument durch – einmal mit dem Original und einmal mit einer bereinigten Version (erneut gescannt mit 300 DPI, entzerrt, kontrastoptimiert). Verbessert sich die Genauigkeit, war die ursprüngliche Eingabequalität der Engpass. Bleibt sie gleich, liegt der Engpass entweder an der Handschriftfähigkeit des Modells oder am Felddesign (mehrdeutige Spaltennamen, zu weit gefasste Felddefinitionen). Dieser Differenztest isoliert die Ursache in unter 5 Minuten.
Hilft Vorverarbeitungssoftware wirklich oder ist sie überbewertet?
Sie hilft, wenn die Vorverarbeitung auf den Dokumententyp abgestimmt ist. Entzerrung, Kontrastverstärkung und Rauschunterdrückung verbessern die Erkennung, bevor die KI überhaupt zu lesen beginnt. Der Effekt ist messbar: Bei Dokumenten mit moderaten Qualitätsmängeln (leichte Schräglage, geringer Kontrast, Hintergrundrauschen) kann die Vorverarbeitung 5–8 Prozentpunkte Genauigkeit zurückgewinnen. Sie kann jedoch keine Informationen aus dem Bild zaubern, die nicht vorhanden sind – aus einem 150-DPI-Scan wird auch nach Vorverarbeitung kein 300-DPI-Scan.
Was ist wichtiger – meine Spalten zu korrigieren oder meine Eingabequalität zu verbessern?
Zuerst die Eingabequalität, dann die Spalten. Ein schlecht benannter Spaltenname auf einem sauberen 300-DPI-Scan extrahiert immer noch besser als ein perfekt benannter Spaltenname auf einem unscharfen Handyfoto. Sobald die Eingabequalität jedoch ein akzeptables Mindestniveau erreicht hat, ist die Optimierung der Spaltennamen die Verbesserung mit dem höchsten Nutzen, die nichts kostet. Benennen Sie „Datum" in „Rechnungsausstellungsdatum (JJJJ-MM-TT)" um, und Sie haben eine Mehrdeutigkeit beseitigt, die zuvor bei jedem Batch dazu führte, dass ein bestimmter Prozentsatz der Felder das falsche Datum extrahierte. Die Korrektur dauert 10 Sekunden und gilt für jedes Dokument, das Sie künftig verarbeiten.
Der Test, der Ihnen zeigt, wo Sie stehen
Genauigkeitsprozentsätze in Benchmarks und Blogbeiträgen sind nützlich, um zu verstehen, was im Durchschnitt möglich ist. Sie sind nutzlos, um zu verstehen, was mit Ihren Dokumenten passiert – mit der Handschrift Ihres Teams, den Abkürzungen Ihres Außendienstes, Ihren jahrzehntealten gescannten Formularen. Der einzige Benchmark, der zählt, ist ein Differenztest mit Ihren eigenen Dokumenten: Führen Sie die Extraktion durch, messen Sie die Feldgenauigkeit, verbessern Sie eine Variable (Eingabequalität oder Spaltendesign), führen Sie sie erneut durch. Die Lücke zwischen den beiden Zahlen zeigt Ihnen, welche Ebene Ihr Engpass ist – und wie viel Genauigkeit Sie tatsächlich zurückgewinnen können.