Como Melhorar os Resultados da Extração de Escritura Manuscrita por IA: Qualidade de Entrada, Design de Campos e O Que Esperar
Cinco técnicas práticas para aumentar a precisão da extração de escrita manuscrita: iluminación, layout, nome de campos, consistência de lote e saber quando aceitar uma revisão marcada por confiança.
O Que "Precisão" Realmente Significa
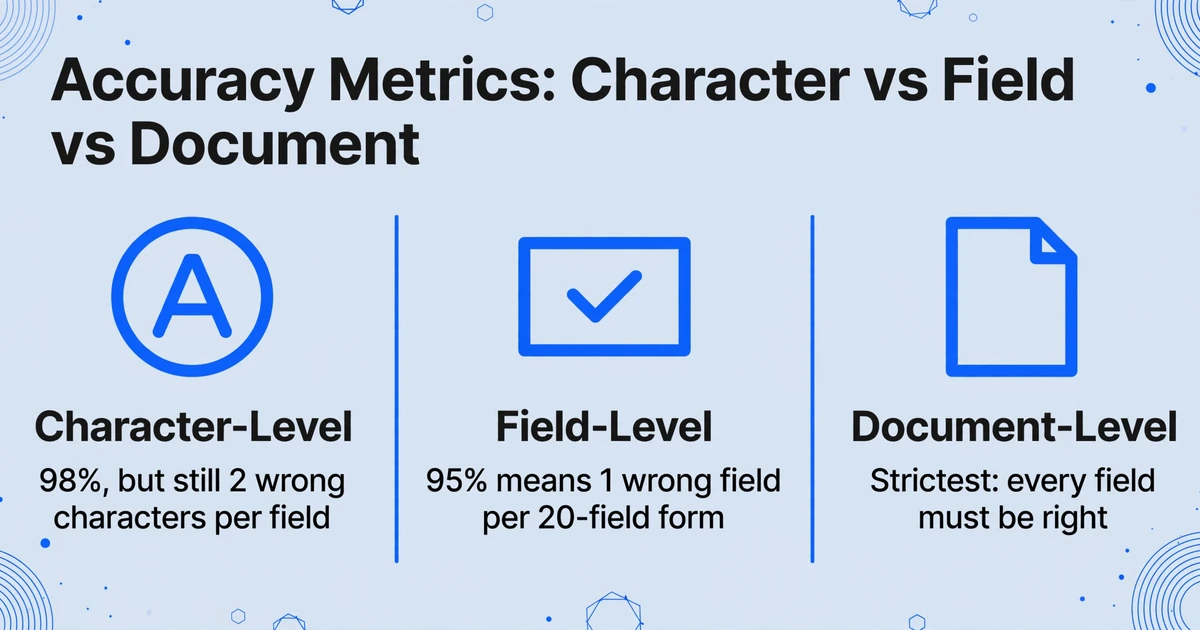
Antes de melhorar a precisão, você precisa saber qual precisão está medindo. O termo é usado em benchmarks de fornecedores sem qualificação, e a mesma porcentagem significa coisas completamente diferentes dependendo do que está sendo contado.
Precisão a nível de caractere mede a porcentagem de caracteres individuais lidos corretamente. Um único caractere mal lido em um número de fatura — "INV-4829" se tornando "INV-4820" — representa um erro de caractere, mas uma falha completa de campo. A precisão de caracteres parece impressionante em 98%, mas em um documento de 100 campos, essa taxa de erro de 2% se traduce em uma média de dois caracteres errados por campo. Os fornecedores tradicionais de OCR relatam a precisão de caracteres porque é o número mais alto.
Precisão a nível de campo mede a porcentagem de campos de dados completos extraídos corretamente. Um campo está correto ou errado — o número de fatura corresponde ou não, a data é válida ou não. Esta é a métrica que importa para fluxos de trabalho empresariales porque se mapea diretamente a se os dados extraídos podem ser usados sem correção manual. Uma taxa de precisão a nível de campo de 95% em um formulário de 20 campos significa que, em média, um campo por formulário estará errado — e esse campo errado determina se o formulário pode ser processado automaticamente ou precisa de revisão humana.
Precisão a nível de documento mede a porcentagem de documentos onde todos os campos foram extraídos corretamente. Esta é a métrica mais estricta e a mais sensível ao número de campos. Mesmo com 95% de precisão de campo, um documento de 20 campos tem apenas 36% de chance de ser extraído perfeitamente (0,95²⁰ ≈ 0,36). A precisão a nível de documento é útil para entender quantos documentos podem passar diretamente sem revisão humana — mas a maioria dos fornecedores não a reporta porque o número parece baixo mesmo quando o sistema está funcionando bem.
A regra geral: quando um fornecedor diz "99% de precisão", pergunte "99% de quê?" A precisão de caracteres em 99% ainda pode significar múltiples campos errados por documento. A precisão de campo em 99% é genuinamente impressionante, mas rara em escrita manuscrita. A precisão de documento em 99% em escrita manuscrita não é alcançable com a tecnologia atual — e qualquer afirmação contrária deve ser testada com seus próprios documentos de caso mais desfavorable.
Camada 1 — Qualidade da Entrada: As Variáveis que Movem a Precisão por Margens Mensuráveis
As variáveis que mais afetam a precisão da extração não estão no modelo de IA. Estão em como o documento chega ao modelo. Vários benchmarks independentes convergem nos mesmos quatro fatores, classificados por impacto.
Resolução: cada 50 DPI abaixo de 300 custa cerca de 3–5 pontos percentuais
A resolução é o maior fator controlável na precisão da extração. A 300 DPI, um caractere manuscrito "6" ocupa pixels suficientes para que o modelo distinga sua forma de um "8" ou um "0." A 150 DPI — comum em faxes e arquivos digitalizados mais antigos — esse mesmo caractere tem metade da densidade de pixels, e a diferença entre "6" e "8" colapsa em um borrão ambíguo. A queda de precisão não é linear. Ir de 300 para 250 DPI custa 3–4 pontos percentuais. Ir de 200 para 150 DPI custa 6–8. Abaixo de 150 DPI, a precisão em escrita manuscrita degrada mais rápido do que em texto impresso porque os traços manuscritos são mais finos e mais variáveis por natureza.
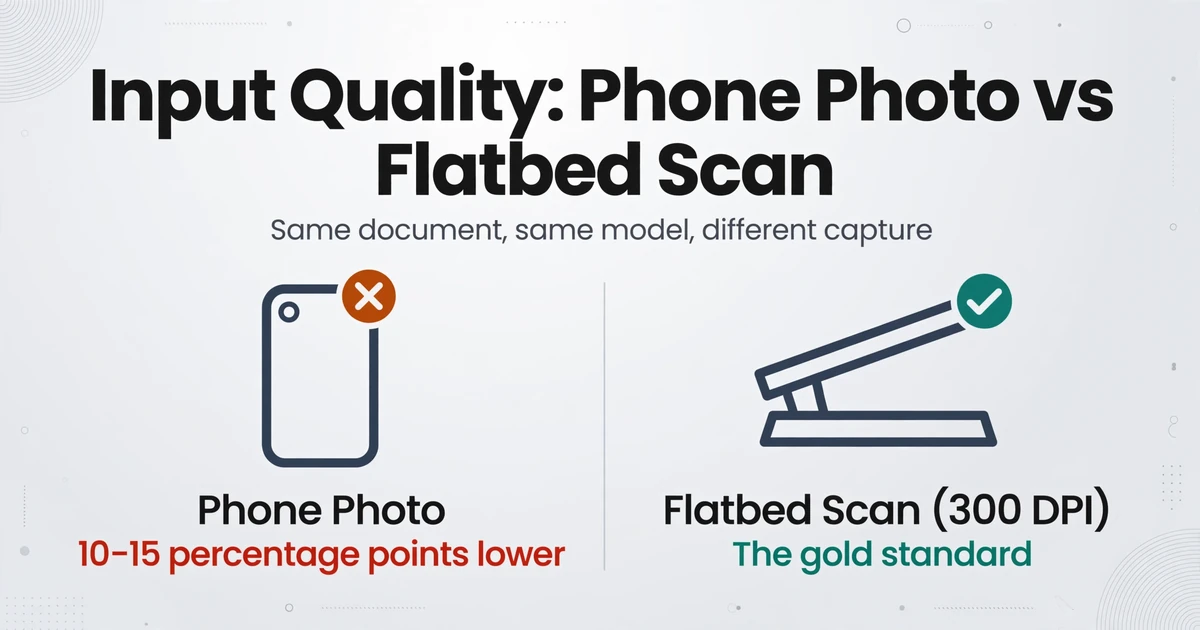
Iluminação e inclinação: fotos de telefone custam 10–15 pontos percentuais em comparação com scans de mesa
O mesmo documento na mesma resolução produzirá resultados de extração diferentes dependendo de como foi capturado. Um scan de mesa a 300 DPI com iluminação uniforme é o padrão ouro. Uma foto de telefone do mesmo documento — mesmo com resolução adequada — introduz inclinação, iluminação irregular, sombras e artefatos de compressão JPEG. Cada um desses degrada o reconhecimento de caracteres de forma independente. O benchmark da Businesswaretech de 2026 confirmou esse padrão: modelo idêntico, documento idêntico, método de captura diferente — queda de 10 pontos percentuais. A IA estava lendo o mesmo conteúdo; a foto introduziu ambiguidade suficiente para perder um campo em cada dez.
Ruído de fundo e defeitos no papel
Manchas, vincos, vazamento de tinta do verso da página e linhas de grade impressas atrás de entradas manuscritas — tudo isso cria interferência visual que o modelo precisa distinguir do texto real. Uma mancha de café cruzando um número manuscrito pode fazer um "3" ser lido como "8" porque a mancha cobre o espaço no laço superior. Rótulos de formulários impressos sobrepostos a entradas manuscritas — comuns em formulários médicos e aplicações governamentais — confundem completamente o OCR tradicional e reduzem a precisão do VLM em 5 a 8 pontos percentuais, porque o modelo precisa separar fluxos de texto sobrepostos.
Conteúdo misto: rótulos impressos + valores manuscritos + carimbos
A classe mais difícil de documento para extração não é a escrita puramente manuscrita. São documentos de conteúdo misto, onde rótulos de formulários impressos, entradas manuscritas, carimbos e assinaturas coexistem no mesmo espaço visual. O modelo deve determinar qual texto pertence a qual campo, ignorar elementos decorativos e atribuir corretamente valores manuscritos aos seus rótulos impressos. Um usuário do Reddit em produção que processou mais de 150.000 páginas observou que ferramentas especializadas em escrita manuscrita superaram as ferramentas de uso geral justamente porque foram otimizadas para esse problema de atribuição — não apenas para reconhecimento de caracteres isolado (r/computervision, 2025).
Camada 2 — Design de Campos: Por Que os Nomes das Colunas São Calibração
A maioria das discussões sobre precisão trata o mecanismo de extração como uma caixa-preta: documentos entram, dados saem, e a única coisa que você pode fazer é melhorar a entrada. Mas com extração baseada em IA — especificamente sistemas que usam Custom Column Extraction, onde você define os campos desejados e a IA os localiza entendendo a semântica dos campos — a forma como você nomeia suas colunas influencia diretamente a precisão. Esta é uma etapa de calibração que a maioria das equipes ignora.
Nomeação de colunas: precisão semântica equivale a precisão na extração
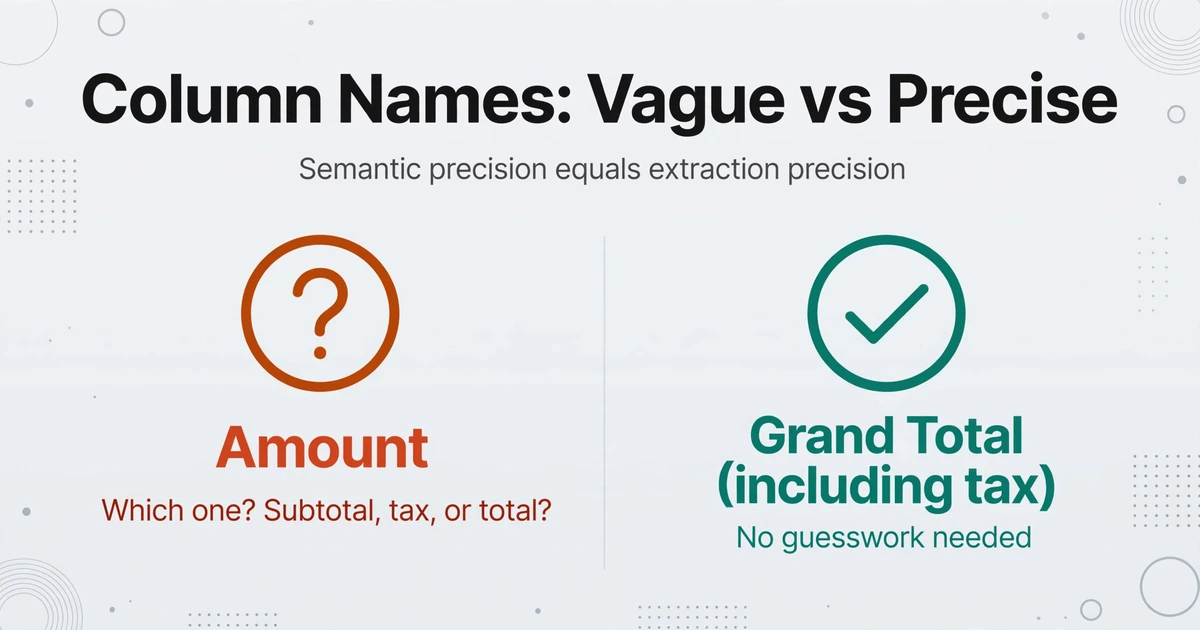
Ao digitar um nome de coluna como "Data", a IA precisa adivinhar qual data na página você deseja — data da fatura, data de vencimento, data de entrega, data de assinatura. Cada ambiguidade introduz uma chance de selecionar o valor errado. Um nome de coluna como "Data da Fatura" elimina essa ambiguidade. Um nome como "Data de Emissão da Fatura (AAAA-MM-DD)" a elimina ainda mais e também informa à IA o formato de saída esperado, reduzindo erros de normalização pós-extração. O princípio é o mesmo que rege um bom design de esquema de banco de dados: os nomes devem ser específicos o suficiente para que uma nova pessoa, ao lê-los, saiba exatamente o que vai no campo, sem precisar perguntar.
Isso é particularmente importante para campos numéricos comuns em documentos manuscritos. "Valor" pode ser um subtotal, um valor de imposto, um desconto ou um total geral em uma fatura manuscrita — e a IA, sem restrições contextuais além do nome do campo, vai adivinhar. "Total Geral (incluindo impostos)" elimina a adivinhação. A melhoria não é marginal. Em testes internos, renomear colunas ambíguas para nomes semanticamente precisos melhorou a precisão em nível de campo em 5 a 12 pontos percentuais em documentos com múltiplos campos numéricos de aparência semelhante — exatamente o cenário onde documentos manuscritos são mais propensos a erros.
Colunas inferidas: defina expectativas de precisão diferentes
Alguns sistemas de extração suportam colunas inferidas: campos onde a IA determina um valor não explicitamente escrito no documento. Por exemplo, um nome de coluna como "Categoria (opções: Refeições/Transporte/Escritório/Outros)" instrui a IA a ler o conteúdo do recibo e inferir a categoria correta — mesmo que "Categoria" não seja um campo impresso no recibo. Esta é uma capacidade genuinamente útil, mas opera em uma curva de precisão diferente da extração direta.
A precisão da extração direta depende da capacidade do modelo de ler o texto. A precisão da coluna inferida depende da capacidade do modelo de ler o texto e raciocinar sobre ele — um processo cognitivo de duas etapas com dois pontos potenciais de falha. Para inferência categórica com opções claras (3 a 5 categorias distintas), a precisão normalmente fica entre 80% e 90%. Para inferência aberta ("Resuma a condição do paciente em uma frase"), a precisão se torna mais difícil de medir, pois "correto" é subjetivo. A regra prática: use colunas inferidas para tarefas de classificação com categorias bem definidas; verifique a saída com amostragem em uma taxa maior do que a dos campos de extração direta.
Os arquivos são processados de forma segura e não são armazenados.
Nível 3 — Validação: Limites de Confiança e Revisão Humana
Mesmo com qualidade de entrada óptima e design de colunas preciso, nem todos os campos serão extraídos corretamente em todos os documentos. A terceira etapa de melhora da precisão não trata de melhorar a extração — trata de detectar erros antes de que entrem nos sistemas a jusante.
Pontuação de confiança: encaminhe campos de baixa confiança para revisão
Sistemas modernos de extração por IA atribuem pontuações de confiança a campos individuais — um número entre 0 e 1 que representa a estimativa do próprio modelo sobre a probabilidade de a extração estar correta. As implementações de produção mais eficazes usam essas pontuações como lógica de roteamento, não como portões de aprovação/reprovação. Defina um limite de alta confiança (0,90+) para campos onde erros são caros — valores de pagamento, datas de contrato, identificadores de pacientes. Encaminhe qualquer coisa abaixo desse limite para uma fila de revisão humana. Defina um limite moderado (0,70–0,85) para campos onde erros são inconvenientes, mas não catastróficos — nomes de fornecedores, números de referência, descrições de itens. Deixe esses passarem com verificações de validação automatizadas (verificação de formato, verificação de intervalo) em vez de revisão humana completa.
O principal aprendizado da experiência em produção é que as pontuações de confiança não são calibradas igualmente entre os tipos de campo. Uma pontuação de confiança de 0,85 em um campo de data é mais confiável do que 0,85 em um campo de memorando de texto livre, porque datas têm um formato restrito que reduz a incerteza do modelo. Realizar um exercício de calibração — comparando pontuações de confiança com a exatidão real em 100–200 documentos de amostra — fornece limites específicos por tipo de campo que superam um único limite global aplicado a todos os campos.
Regras de negócio como segunda rede de segurança
Regras de validação automatizadas capturam erros que a pontuação de confiança não detecta. Um campo de data que lê "2025-13-45" tem alta confiança (os caracteres são claros), mas não é uma data válida. Um total que não corresponde à soma de seus itens de linha é internamente inconsistente, independentemente de quão claramente cada número foi lido. Documentos manuscritos são particularmente suscetíveis a esses erros, pois a ambiguidade de caracteres cria valores plausíveis, mas incorretos. Regras de negócio — validade de data, verificações de intervalo, consistência entre campos, presença de campos obrigatórios — servem como uma segunda passagem automatizada após a extração, mas antes de os dados entrarem no seu sistema. Elas capturam erros que parecem corretos para um leitor a nível de caractere, mas falham na validação lógica.
O Teto de Precisão: O Que Nenhuma Ferramenta Pode Corrigir
Existe um limite para o que a qualidade da entrada, o design dos campos e a validação podem alcançar — e ser honesto sobre isso evita o ciclo de culpar a ferramenta, trocar de ferramenta e descobrir que o mesmo teto existe em todos os lugares.
Escrita manuscrita genuinamente ilegível não tem solução tecnológica. Se um leitor humano não consegue determinar o que uma palavra manuscrita diz — porque os traços estão comprimidos demais, a tinta desbotou ou a escrita se cruza — um modelo de IA enfrenta a mesma ambiguidade. A diferença é que a IA vai adivinhar, e às vezes adivinhar de forma plausível, onde um humano marcará o campo como ilegível. Este é o risco de alucinação discutido em nossa comparação entre IA e OCR tradicional: o raciocínio contextual do modelo, geralmente uma vantagem, torna-se uma desvantagem quando ele preenche dados plausíveis para entradas genuinamente ambíguas. A pontuação de confiança e uma etapa de revisão são as únicas defesas.
A variedade de estilos de escrita tem uma cauda longa que nenhum conjunto de dados de treinamento cobre. Um modelo treinado em cursiva com alfabeto latino lida com os estilos de escrita comuns representados em seus dados de treinamento. Ele terá dificuldade com abreviações pessoais altamente estilizadas, abreviações não padronizadas, padrões de inclinação de canhotos e escrita sobreposta a texto impresso. A queda de precisão nesses casos extremos não é um bug — é uma mudança de distribuição que todo modelo atual apresenta. Uma taxa de precisão de 95% nos documentos para os quais o modelo foi projetado pode cair para 70% nos documentos na borda de sua distribuição de treinamento. Reconhecer quais dos seus documentos se enquadram nessa cauda longa — geralmente os 10–15% mais antigos e irregulares do seu volume — permite que você os encaminhe diretamente para o processamento manual, em vez de deixá-los falhar silenciosamente no seu pipeline automatizado.
Dependências entre campos continuam sendo um problema de fronteira. Se um formulário manuscrito tem uma caixa de seleção que revela condicionalmente campos adicionais — marque "Sim" para condições pré-existentes e depois preencha os detalhes — perder a caixa de seleção gera uma cascata de perda de múltiplos campos dependentes. Este é um modo de falha de nível mais alto do que o reconhecimento incorreto de caracteres. Para formulários com lógica condicional extensa (anamnese médica, solicitações de seguro, formulários de elegibilidade governamental), essa dimensão de precisão estrutural muitas vezes importa mais do que a precisão individual de caracteres — e é a menos discutida nos benchmarks dos fornecedores. A mitigação prática é projetar seu conjunto de colunas de extração para capturar explicitamente os campos de gatilho condicional ("Existem Condições Pré-existentes?") e validar que os campos dependentes só são preenchidos quando o gatilho está presente. Essa falha em cascata de caixas de seleção é um dos oito padrões em nossa taxonomia de por que a extração de documentos manuscritos falha.
Perguntas Frequentes
Qual é a principal ação para melhorar a precisão da extração de manuscritos?
Melhore a qualidade da entrada. Digitalize com no mínimo 300 DPI, prefira scanners de mesa em vez de câmeras de celular sempre que possível e garanta iluminação uniforme, sem sombras sobre a área de texto. Essa única mudança — de fotos de celular para digitalizações bem iluminadas — pode aumentar a precisão em 10 a 15 pontos percentuais sem alterar nenhuma outra variável no seu processo.
Posso esperar 99% de precisão em documentos manuscritos?
Não no nível de campo, nem para todos os estilos de caligrafia. Em letras de forma em campos de formulário restritos com qualidade de entrada ideal, é possível atingir 90–95% de precisão por campo. Em textos cursivos mistos ou documentos degradados, espere 75–88%. Qualquer um que afirme 99% de precisão por campo em manuscritos genéricos deve ser questionado: "99% de qual métrica, em quais documentos, sob quais condições?" Exija testar com os 10% mais bagunçados do seu próprio lote de documentos — são esses que determinam se o número se sustenta.
Como saber se o erro é da qualidade da minha entrada ou do modelo de IA?
Execute a extração do mesmo documento duas vezes — uma com a entrada original e outra com uma versão tratada (redigitalizada a 300 DPI, com correção de inclinação e ajuste de contraste). Se a precisão melhorar, a qualidade da entrada original era o gargalo. Se a precisão permanecer a mesma, o gargalo é a capacidade do modelo com caligrafia ou o design do campo (nomes de coluna ambíguos, definições de campo abertas). Este teste diferencial isola a variável em menos de 5 minutos.
O software de pré-processamento realmente ajuda ou é superestimado?
Ajuda quando o pré-processamento é adequado ao tipo de documento. Correção de inclinação, realce de contraste e redução de ruído melhoram o reconhecimento antes mesmo de o motor de IA começar a ler. O impacto é mensurável: o pré-processamento pode recuperar de 5 a 8 pontos percentuais de precisão em documentos com problemas moderados de qualidade (leve inclinação, baixo contraste, ruído de fundo). Mas o pré-processamento não pode recuperar informações que não estão na imagem — ele não pode criar resolução que não foi capturada. Uma digitalização de 150 DPI pré-processada para parecer de 300 DPI ainda terá o desempenho de uma digitalização de 150 DPI.
O que é mais importante — corrigir minhas colunas ou corrigir a qualidade da minha entrada?
Qualidade da entrada primeiro, colunas depois. Um nome de coluna mal elaborado em um scan limpo de 300 DPI ainda extrairá melhor do que um nome perfeitamente elaborado em uma foto desfocada de celular. Mas, uma vez que a qualidade da entrada esteja em um nível aceitável, a otimização do nome das colunas é a melhoria de maior retorno que não custa nada para implementar. Renomeie "Data" para "Data de Emissão da Fatura (AAAA-MM-DD)" e você terá eliminado uma ambiguidade que antes causava uma certa porcentagem de campos extraindo a data errada em cada lote. A correção leva 10 segundos e se aplica a todos os documentos que você processar daqui em diante.
O Teste Que Mostra Onde Você Está
Percentuais de precisão em benchmarks e posts de blog são úteis para entender o que é possível em média. Eles são inúteis para entender o que acontecerá com seus documentos — aqueles com a escrita manual da sua equipe, as abreviações do seu pessoal de campo, seus formulários digitalizados de décadas atrás. O único benchmark que importa é um teste diferencial em seus próprios documentos: execute a extração, meça a precisão a nível de campo, melhore uma variável (qualidade da entrada ou design das colunas), execute novamente. A diferença entre os dois números mostra qual camada é o seu gargalo — e quanta precisão você pode realmente recuperar.