Cómo mejorar los resultados de extracción de escritura manuscrita por IA: calidad de entrada, diseño de campos y qué esperar
Cinco técnicas prácticas para mejorar la precisión de la extracción de escritura manuscrita: iluminación, diseño, nombres de campos, consistencia de lotes y saber cuándo aceptar una revisión marcada por confianza.
Qué significa realmente "precisión"
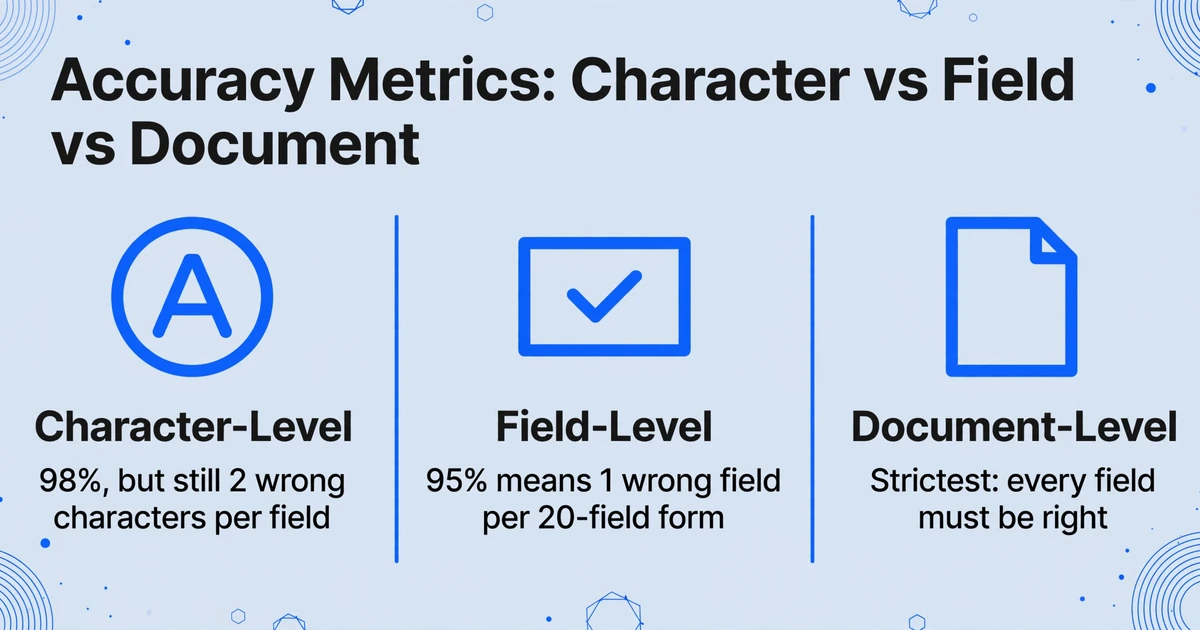
Antes de poder mejorar la precisión, debe saber qué precisión está midiendo. El término se usa sin matices en los puntos de referencia de los proveedores, y el mismo porcentaje significa cosas completamente diferentes según lo que se cuente.
La precisión a nivel de carácter mide el porcentaje de caracteres individuales leídos correctamente. Un solo carácter mal leído en un número de factura — "INV-4829" que se convierte en "INV-4820" — representa un error de carácter, pero un fallo completo de campo. La precisión de caracteres suena impresionante al 98%, pero en un documento de 100 campos, esa tasa de error del 2% se traduce en un promedio de dos caracteres incorrectos por campo. Los proveedores tradicionales de OCR informan la precisión de caracteres porque es el número más alto.
La precisión a nivel de campo mide el porcentaje de campos de datos completos extraídos correctamente. Un campo es correcto o incorrecto: el número de factura coincide o no, la fecha es válida o no lo es. Esta es la métrica que importa para los flujos de trabajo empresariales porque se relaciona directamente con si los datos extraídos pueden usarse sin corrección manual. Una tasa de precisión a nivel de campo del 95% en un formulario de 20 campos significa que, en promedio, un campo por formulario será incorrecto — y ese campo incorrecto determina si el formulario puede procesarse automáticamente o necesita revisión humana.
La precisión a nivel de documento mide el porcentaje de documentos en los que todos los campos se extrajeron correctamente. Esta es la métrica más estricta y la más sensible al número de campos. Incluso con una precisión de campo del 95%, un documento de 20 campos tiene solo un 36% de probabilidad de extraerse perfectamente (0.95²⁰ ≈ 0.36). La precisión a nivel de documento es útil para comprender cuántos documentos pueden pasar directamente sin revisión humana — pero la mayoría de los proveedores no la informan porque el número parece bajo incluso cuando el sistema funciona bien.
La regla general: cuando un proveedor dice "99% de precisión", pregunte "¿99% de qué?". Una precisión de caracteres del 99% aún puede significar múltiples campos incorrectos por documento. Una precisión de campo del 99% es genuinamente impresionante pero rara en escritura manuscrita. Una precisión de documento del 99% en escritura manuscrita no es alcanzable con la tecnología actual — y cualquier afirmación en contrario debe probarse con sus propios documentos más difíciles.
Capa 1 — Calidad de entrada: las variables que mueven la precisión en márgenes medibles
Las variables que más afectan la precisión de la extracción no están en el modelo de IA. Están en cómo el documento llega al modelo. Múltiples evaluaciones independientes coinciden en los mismos cuatro factores, ordenados por impacto.
Resolución: cada 50 DPI por debajo de 300 cuesta aproximadamente 3–5 puntos porcentuales
La resolución es el factor controlable más importante en la precisión de la extracción. A 300 DPI, un carácter manuscrito "6" ocupa suficientes píxeles para que el modelo pueda distinguir su forma de un "8" o un "0." A 150 DPI — común en faxes y archivos escaneados antiguos — ese mismo carácter tiene la mitad de densidad de píxeles, y la diferencia entre "6" y "8" se colapsa en una mancha ambigua. La caída de precisión no es lineal. Pasar de 300 a 250 DPI cuesta 3–4 puntos porcentuales. Pasar de 200 a 150 DPI cuesta 6–8. Por debajo de 150 DPI, la precisión en escritura manuscrita se degrada más rápido que en texto impreso porque los trazos manuscritos son más finos y más variables de por sí.
Iluminación e inclinación: las fotos de teléfono cuestan 10–15 puntos porcentuales frente a los escaneos planos
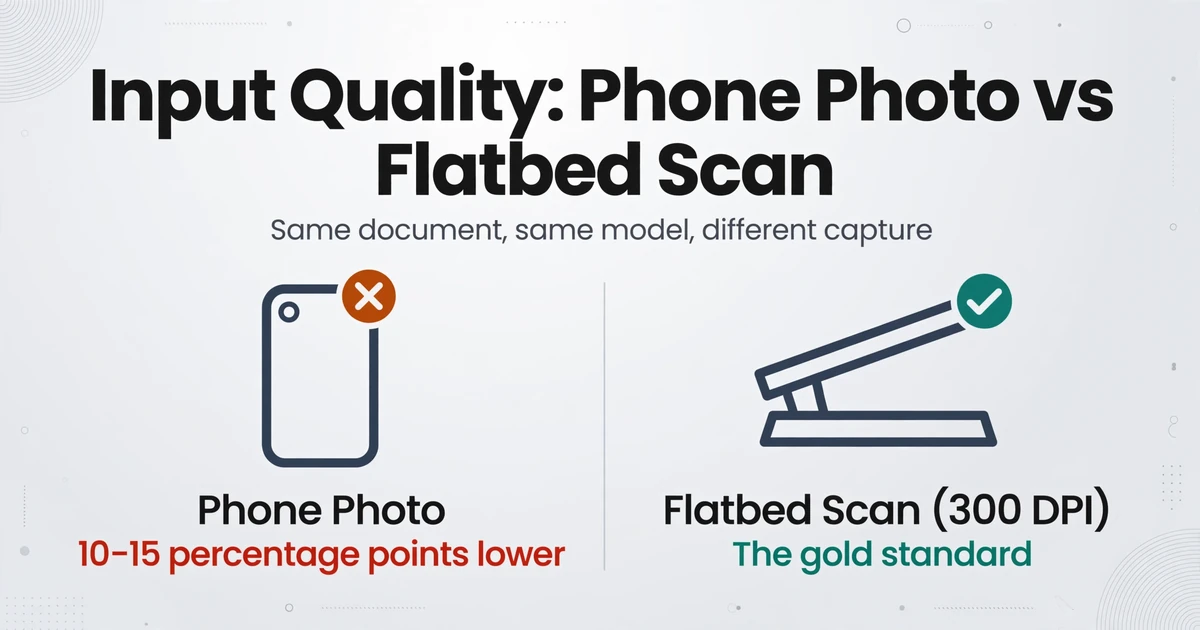
El mismo documento a la misma resolución producirá resultados de extracción diferentes según cómo se capturó. Un escaneo plano a 300 DPI con iluminación uniforme es el estándar de oro. Una foto de teléfono del mismo documento — incluso con resolución adecuada — introduce inclinación, iluminación desigual, sombras y artefactos de compresión JPEG. Cada uno de estos degrada el reconocimiento de caracteres de forma independiente. La evaluación de Businesswaretech de 2026 confirmó este patrón: modelo idéntico, documento idéntico, método de captura diferente — caída de 10 puntos porcentuales. La IA estaba leyendo el mismo contenido; la foto introdujo suficiente ambigüedad como para perder un campo de cada diez.
Ruido de fondo y defectos del papel
Manchas, pliegues, traspaso de tinta del reverso de la página y líneas de cuadrícula impresas detrás de las entradas manuscritas: todo esto crea interferencia visual que el modelo debe distinguir del texto real. Una mancha de café que cruza un número manuscrito puede hacer que un "3" se lea como "8" porque la mancha cubre el hueco del bucle superior. Las etiquetas impresas del formulario que se superponen con las entradas manuscritas — algo común en formularios médicos de admisión y solicitudes gubernamentales — confunden por completo al OCR tradicional y reducen la precisión del VLM en 5 a 8 puntos porcentuales, porque el modelo debe separar flujos de texto superpuestos.
Contenido mixto: etiquetas impresas + valores manuscritos + sellos
La clase de documento más difícil para la extracción no es la escritura manuscrita pura. Son los documentos de contenido mixto, donde las etiquetas impresas del formulario, las entradas manuscritas, los sellos y las firmas coexisten en el mismo espacio visual. El modelo debe determinar qué texto pertenece a cada campo, ignorar los elementos decorativos y atribuir correctamente los valores manuscritos a sus etiquetas impresas. Un usuario de producción en Reddit que procesó más de 150 000 páginas señaló que las soluciones especializadas en escritura manuscrita superaron a las herramientas de propósito general precisamente porque estaban optimizadas para este problema de atribución — no solo para el reconocimiento de caracteres de forma aislada (r/computervision, 2025).
Capa 2 — Diseño de campos: por qué los nombres de las columnas son calibración
La mayoría de las discusiones sobre precisión tratan el motor de extracción como una caja negra: los documentos entran, los datos salen, y lo único que se puede hacer es mejorar la entrada. Pero con la extracción basada en IA — específicamente sistemas que usan Extracción de Columnas Personalizadas, donde usted define los campos que desea y la IA los localiza comprendiendo la semántica de los campos — la forma en que nombra sus columnas influye directamente en la precisión. Este es un paso de calibración que la mayoría de los equipos omiten.
Nombres de columna: precisión semántica equivale a precisión en la extracción
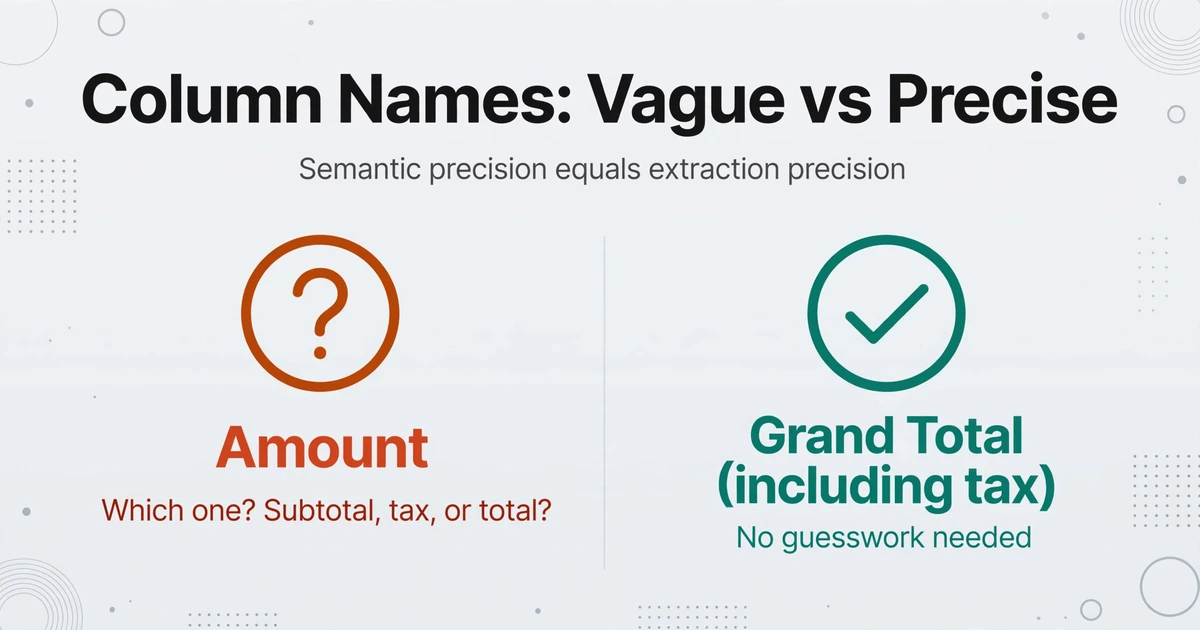
Al escribir un nombre de columna como "Fecha", la IA debe adivinar qué fecha de la página quieres — fecha de factura, vencimiento, entrega o firma. Cada ambigüedad introduce la posibilidad de seleccionar el valor incorrecto. Un nombre de columna como "Fecha de Factura" elimina esa ambigüedad. "Fecha de Emisión de Factura (AAAA-MM-DD)" la elimina aún más y también le indica a la IA el formato de salida esperado, reduciendo errores de normalización posteriores a la extracción. El principio es el mismo que rige el buen diseño de esquemas de bases de datos: los nombres deben ser lo suficientemente específicos para que una nueva persona que los lea sepa exactamente qué va en el campo sin preguntar.
Esto es particularmente importante para campos numéricos comunes en documentos manuscritos. "Monto" podría ser un subtotal, un impuesto, un descuento o un total general en una factura manuscrita — y la IA, al carecer de restricciones contextuales más allá del nombre del campo, adivinará. "Total General (incluye impuesto)" elimina las conjeturas. La mejora no es marginal. En pruebas internas, renombrar columnas ambiguas a nombres semánticamente precisos mejoró la precisión a nivel de campo entre 5 y 12 puntos porcentuales en documentos con múltiples campos numéricos de aspecto similar — el escenario exacto donde los documentos manuscritos son más propensos a errores.
Columnas inferidas: establece expectativas de precisión diferentes
Algunos sistemas de extracción admiten columnas inferidas: campos donde la IA determina un valor no escrito explícitamente en el documento. Por ejemplo, una columna llamada "Categoría (opciones: Comidas/Transporte/Oficina/Otros)" indica a la IA que lea el contenido del recibo e infiera la categoría correcta — aunque "Categoría" no sea un campo impreso en el recibo. Esta es una capacidad realmente útil, pero opera en una curva de precisión diferente a la de la extracción directa.
La precisión de la extracción directa depende de la capacidad del modelo para leer texto. La precisión de las columnas inferidas depende de la capacidad del modelo para leer texto y razonar sobre él — un proceso cognitivo de dos pasos con dos puntos potenciales de fallo. Para inferencia categórica con opciones claras (3–5 categorías distintas), la precisión suele oscilar entre 80 y 90%. Para inferencia abierta ("Resume la condición del paciente en una oración"), la precisión se vuelve más difícil de medir porque "correcto" es subjetivo. La regla práctica: usa columnas inferidas para tareas de clasificación con categorías bien definidas; verifica sus resultados con muestreos aleatorios a una tasa más alta que los campos de extracción directa.
Los archivos se procesan de forma segura y no se almacenan.
Capa 3 — Validación: Umbrales de confianza y revisión humana
Incluso con una calidad de entrada óptima y un diseño de columnas preciso, no todos los campos se extraerán correctamente en todos los documentos. La tercera capa de mejora de precisión no consiste en mejorar la extracción, sino en detectar errores antes de que ingresen a los sistemas posteriores.
Puntuación de confianza: envíe los campos de baja confianza a revisión
Los sistemas modernos de extracción por IA asignan puntuaciones de confianza a campos individuales — un número entre 0 y 1 que representa la estimación del propio modelo sobre la probabilidad de que la extracción sea correcta. Las implementaciones de producción más eficaces utilizan estas puntuaciones como lógica de enrutamiento, no como criterios de aprobación o rechazo. Establezca un umbral de alta confianza (0.90+) para campos donde los errores son costosos — montos de pago, fechas de contratos, identificadores de pacientes. Enrute todo lo que esté por debajo de ese umbral a una cola de revisión humana. Establezca un umbral moderado (0.70–0.85) para campos donde los errores son inconvenientes pero no catastróficos — nombres de proveedores, números de referencia, descripciones de artículos. Permita que esos pasen con verificaciones de validación automatizadas (verificación de formato, comprobación de rangos) en lugar de una revisión humana completa.
La conclusión clave de la experiencia en producción es que las puntuaciones de confianza no están calibradas de manera uniforme entre tipos de campos. Una puntuación de confianza de 0.85 en un campo de fecha es más fiable que 0.85 en un campo de memo de texto libre porque las fechas tienen un formato restringido que reduce la incertidumbre del modelo. Realizar un ejercicio de calibración — comparar las puntuaciones de confianza con la corrección real en 100–200 documentos de muestra — le brinda umbrales específicos por tipo de campo que superan a un umbral global único aplicado a todos los campos.
Reglas de negocio como segunda red de seguridad
Las reglas de validación automatizadas detectan errores que la puntuación de confianza no capta. Un campo de fecha que dice "2025-13-45" tiene alta confianza (los caracteres son claros) pero no es una fecha válida. Un total que no coincide con la suma de sus partidas es internamente inconsistente, independientemente de cuán claramente se haya leído cada número. Los documentos manuscritos son particularmente susceptibles a estos errores porque la ambigüedad de los caracteres crea valores que parecen plausibles pero son incorrectos. Las reglas de negocio — validez de fechas, comprobaciones de rangos, consistencia entre campos, presencia de campos obligatorios — funcionan como una segunda pasada automatizada después de la extracción, pero antes de que los datos ingresen a su sistema. Detectan errores que parecen correctos para un lector a nivel de carácter, pero que fallan la validación lógica.
El Límite de Precisión: Lo Que Ninguna Herramienta Puede Solucionar
Existe un límite en lo que la calidad de entrada, el diseño de campos y la validación pueden lograr — y ser honesto al respecto evita el ciclo de culpar a la herramienta, cambiar de herramienta y descubrir que el mismo límite existe en todas partes.
La escritura manuscrita genuinamente ilegible no tiene solución tecnológica. Si un lector humano no puede determinar qué dice una palabra manuscrita — porque los trazos están demasiado comprimidos, la tinta se ha desvanecido o la escritura se cruza sobre sí misma — un modelo de IA enfrenta la misma ambigüedad. La diferencia es que la IA adivinará, y a veces adivinará de manera plausible, donde un humano marcará el campo como ilegible. Este es el riesgo de alucinación discutido en nuestra comparación de IA y OCR tradicional: el razonamiento contextual del modelo, generalmente una ventaja, se convierte en una desventaja cuando completa datos plausibles para entrada genuinamente ambigua. La puntuación de confianza y un paso de revisión son las únicas defensas.
La variedad de estilos de escritura tiene una cola larga que ningún conjunto de datos de entrenamiento cubre. Un modelo entrenado en cursiva de alfabeto latino maneja los estilos de escritura comunes representados en sus datos de entrenamiento. Tendrá dificultades con abreviaturas personales altamente estilizadas, abreviaturas no estándar, patrones de inclinación para zurdos y escritura superpuesta sobre texto impreso. La caída de precisión en estos casos extremos no es un error — es un cambio de distribución que exhibe todo modelo actual. Una tasa de precisión del 95% en los documentos para los que fue diseñado el modelo puede convertirse en 70% en los documentos en el borde de su distribución de entrenamiento. Reconocer cuáles de sus documentos caen en esta cola larga — generalmente el 10–15% más antiguo e irregular de su ingreso — le permite enrutarlos directamente al procesamiento manual en lugar de dejarlos fallar silenciosamente en su canalización automatizada.
Las dependencias entre campos siguen siendo un problema fronterizo. Si un formulario manuscrito tiene una casilla que revela condicionalmente campos adicionales — marque "Sí" para condiciones previas, luego complete los detalles — omitir la casilla provoca en cascada la omisión de múltiples campos dependientes. Este es un modo de falla de nivel superior al reconocimiento erróneo de caracteres. Para formularios con lógica condicional extensa (admisiones médicas, solicitudes de seguros, formularios de elegibilidad gubernamental), esta dimensión de precisión estructural a menudo importa más que la precisión de caracteres individuales — y es la menos discutida en los puntos de referencia de los proveedores. La mitigación práctica es diseñar su conjunto de columnas de extracción para capturar explícitamente los campos de activación condicional ("¿Existen Condiciones Previas?") y validar que los campos dependientes solo se completen cuando el activador esté presente. Esta falla en cascada de casillas es uno de los ocho patrones en nuestra taxonomía de por qué falla la extracción de documentos manuscritos.
Preguntas frecuentes
¿Qué es lo más importante que puedo hacer para mejorar la precisión de la extracción de escritura a mano?
Mejorar la calidad de entrada. Escanee a un mínimo de 300 DPI, use escáneres planos en lugar de cámaras de teléfono cuando sea posible, y asegure una iluminación uniforme sin sombras que crucen el área de texto. Este único cambio — pasar de fotos de teléfono a escaneos bien iluminados — puede mejorar la precisión en 10–15 puntos porcentuales sin tocar ninguna otra variable en su flujo de trabajo.
¿Puedo esperar una precisión del 99% en documentos escritos a mano?
No a nivel de campo, y no en todos los estilos de escritura. En escritura en letra de imprenta en campos de formulario restringidos con calidad de entrada óptima, se puede lograr una precisión de campo del 90–95%. En escritura cursiva mixta o documentos degradados, espere un 75–88%. Cualquiera que afirme un 99% de precisión de campo en escritura a mano general debería ser preguntado: "¿99% de qué métrica, en los documentos de quién, y bajo qué condiciones?" Exija probar contra el 10% más desordenado de su propia entrada de documentos — esos son los que determinan si el número se sostiene.
¿Cómo sé si un error se debe a mi calidad de entrada o al modelo de IA?
Ejecute el mismo documento a través de la extracción dos veces: una con la entrada original y otra con una versión limpiada (reescaneada a 300 DPI, enderezada, con contraste ajustado). Si la precisión mejora, la calidad de entrada original era el cuello de botella. Si la precisión se mantiene igual, el cuello de botella es la capacidad del modelo para escritura a mano o el diseño del campo (nombres de columna ambiguos, definiciones de campo no restringidas). Esta prueba diferencial aísla la variable en menos de 5 minutos.
¿El software de preprocesamiento realmente ayuda o es sobrevalorado?
Ayuda cuando el preprocesamiento está adaptado al tipo de documento. Enderezar, mejorar el contraste y reducir el ruido mejoran el reconocimiento antes de que el motor de IA comience a leer. El impacto es medible: el preprocesamiento puede recuperar 5–8 puntos porcentuales de precisión en documentos con problemas de calidad moderados (ligera inclinación, bajo contraste, ruido de fondo). Pero el preprocesamiento no puede recuperar información que no está en la imagen — no puede crear resolución que no fue capturada. Un escaneo a 150 DPI preprocesado para verse como 300 DPI seguirá funcionando como un escaneo a 150 DPI.
¿Qué es más importante: corregir mis columnas o corregir la calidad de mi entrada?
Primero la calidad de la entrada, después las columnas. Un nombre de columna mal diseñado en un escaneo limpio de 300 DPI se extraerá mejor que una columna perfectamente nombrada en una foto borrosa tomada con el teléfono. Pero una vez que la calidad de la entrada alcanza un nivel aceptable, la optimización del nombre de las columnas es la mejora de mayor retorno que no cuesta nada implementar. Cambie "Fecha" por "Fecha de Emisión de la Factura (AAAA-MM-DD)" y habrá eliminado una ambigüedad que antes causaba que un cierto porcentaje de campos extrajera la fecha incorrecta en cada lote. La corrección toma 10 segundos y se aplica a todos los documentos que procese de aquí en adelante.
La Prueba Que Le Dice Dónde Se Encuentra
Los porcentajes de precisión en los puntos de referencia y publicaciones de blog son útiles para entender lo que es posible en promedio. Son inútiles para entender lo que sucederá con sus documentos: aquellos con la escritura manuscrita de su equipo, las abreviaturas de su personal de campo, sus formularios escaneados de hace una década. El único punto de referencia que importa es una prueba diferencial en sus propios documentos: ejecute la extracción, mida la precisión a nivel de campo, mejore una variable (calidad de la entrada o diseño de columnas) y vuelva a ejecutarla. La diferencia entre los dos números le indica cuál capa es su cuello de botella y cuánta precisión puede recuperar realmente.