Reconnaissance de l'écriture manuscrite par IA vs OCR traditionnelle : pourquoi l'écart est plus grand que ce que la plupart des équipes attendent
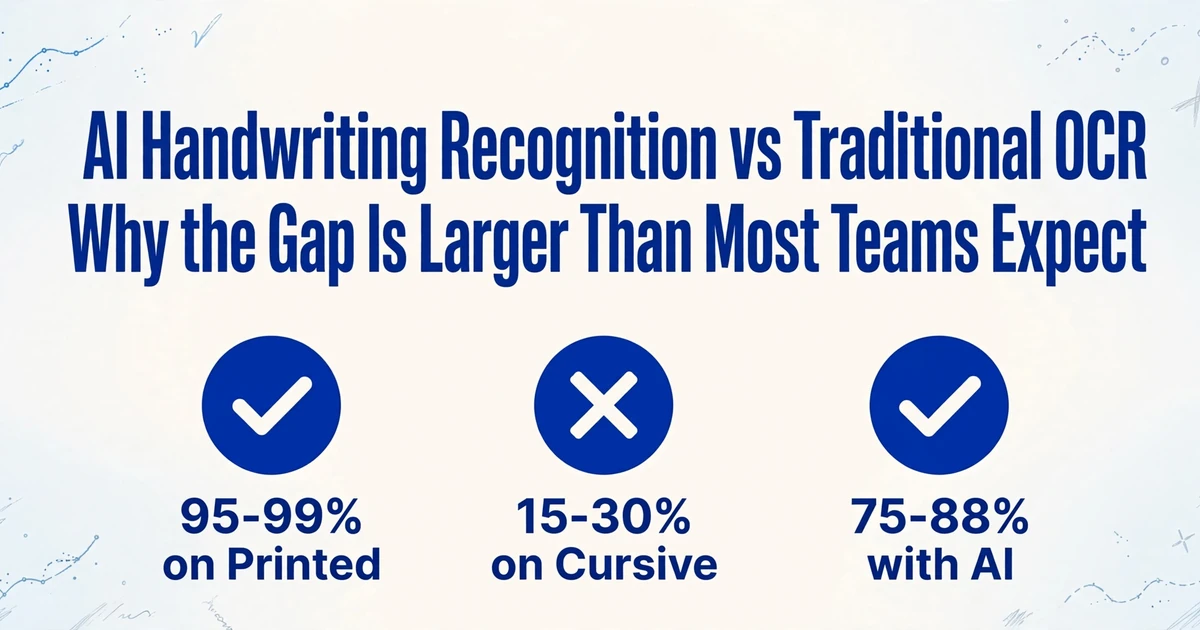
L'OCR traditionnelle échoue de manière catastrophique sur l'écriture manuscrite — Tesseract atteint 24 % de précision sur les formulaires manuscrits tandis que l'extraction par IA atteint 95 % et plus. Voici pourquoi cet écart est structurel.
Où cela s'inscrit : cette page est la comparaison directe entre l'IA et l'OCR traditionnelle sur l'écriture manuscrite — précision, vitesse, coût et hallucination. Pour une définition de ce qu'est la reconnaissance de l'écriture manuscrite par IA, voir ce qu'est la reconnaissance de l'écriture manuscrite par IA ; pour les chiffres de précision par type d'écriture manuscrite, voir l'IA peut-elle lire l'écriture manuscrite à partir de photos.
Ce que l'OCR traditionnelle fait bien — et où elle s'arrête
L'OCR (reconnaissance optique de caractères) traditionnelle fonctionne en examinant les motifs de pixels sur une page, en les comparant à des formes de caractères connues, et en produisant une chaîne de texte. Pour des documents imprimés propres, numérisés à 300 DPI, elle donne de bons résultats — dépassant souvent 95 % de précision au niveau des caractères. Une facture fraîchement imprimée, un formulaire PDF, un contrat dactylographié : ce sont les entrées pour lesquelles l'OCR a été conçue, et elles restent son scénario idéal.
Mais la précision au niveau des caractères n'est pas la même chose que la précision des données. Savoir que les caractères « 1 234,56 » apparaissent quelque part sur une page ne vous dit rien sur le fait qu'il s'agit d'un total de facture, d'une quantité ou d'un numéro de référence. Cette interprétation nécessite toujours un humain — ou une couche de règles que vous devez créer et maintenir par-dessus la sortie de l'OCR. Pour du texte imprimé, cet écart est gérable avec des scripts de post-traitement et des modèles de position de champ. Pour l'écriture manuscrite, l'écart se creuse en un gouffre.
Le problème fondamental est architectural. L'OCR traditionnelle est ascendante : elle lit d'abord les caractères individuels, puis tente de les assembler en mots, puis en lignes. Elle n'a aucune notion de ce que le document signifie. Lorsque chaque caractère est net et prévisible, cela fonctionne. Lorsque les caractères se connectent, varient en taille, s'inclinent de manière imprévisible ou se brouillent les uns dans les autres — comme le fait l'écriture manuscrite — l'approche ascendante s'effondre avant même d'atteindre le niveau du mot.
Les trois endroits où l'OCR traditionnelle échoue sur l'écriture manuscrite
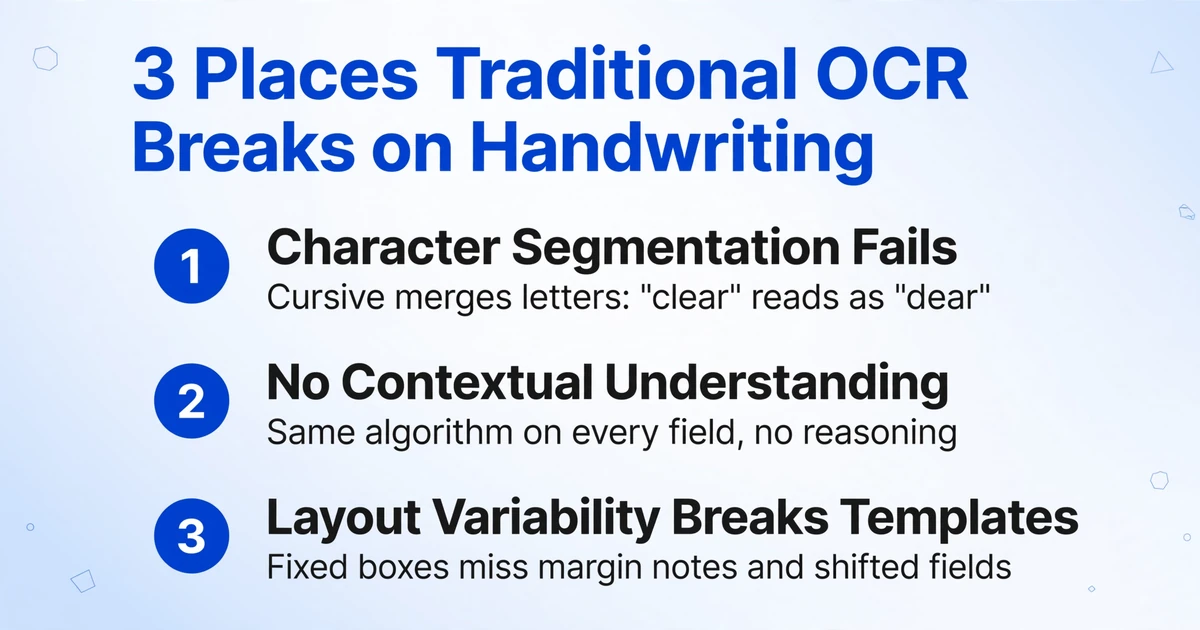
L'écriture manuscrite de chaque personne est un ensemble de données unique. Largeur du trait, angle d'inclinaison, connexion des lettres, dérive de la ligne de base — ces éléments varient non seulement d'une personne à l'autre, mais aussi au sein de l'écriture d'une même personne selon les jours, les stylos et les surfaces. L'OCR traditionnelle rencontre trois modes de défaillance spécifiques qui se cumulent.
La segmentation des caractères échoue avant même la reconnaissance
L'OCR suppose que chaque caractère occupe une boîte délimitée distincte. L'écriture cursive viole totalement cette hypothèse. Les lettres s'enchaînent sans séparation nette. Le moteur fusionne alors plusieurs lettres en un seul bloc (lisant « clair » comme « cher ») ou divise une lettre en deux boîtes (lisant « m » comme « rn »). Des benchmarks indépendants issus de déploiements en production montrent que Tesseract — le moteur OCR open source le plus utilisé — atteint une précision de 45 à 50 % sur l'écriture cursive générale. Cela signifie que pour deux mots manuscrits, un sera mal lu. Pour un formulaire de 50 champs mêlant écriture imprimée et cursive, environ 25 champs contiendront des erreurs avant toute relecture humaine.
Aucune compréhension contextuelle signifie zéro récupération d'erreur
Quand un humain lit un mot maculé sur un bon de livraison, les champs environnants — date, adresse, liste d'articles — limitent ce que ce mot pourrait raisonnablement être. Un nombre dans un champ « Total » ne peut pas être un nom. Une date dans un champ « Date de naissance » ne peut pas être l'année prochaine. L'OCR traditionnel n'a aucun de ces raisonnements. Il applique le même algorithme de correspondance de caractères à chaque position de la page, indépendamment de ce qui devrait s'y trouver. Un « 5 » brouillé dans une colonne de prix est classé comme « S » car le motif de pixels est ambigu — et le moteur n'a aucun moyen de signaler que « S » n'a pas de sens dans un champ monétaire.
La variabilité de la mise en page brise les pipelines basés sur des modèles
De nombreuses configurations OCR en production reposent sur des modèles : vous définissez des coordonnées fixes pour chaque champ, et le moteur lit les caractères apparaissant dans ces boîtes. Cela fonctionne pour des formulaires standardisés provenant d'une source unique. Cela échoue dès qu'un fournisseur modifie la disposition de son formulaire, qu'un champ se décale d'un centimètre, ou que quelqu'un écrit une note dans la marge au lieu de la case prévue. Les documents manuscrits amplifient ce problème — les rédacteurs débordent régulièrement des cases, ajoutent des annotations dans les marges, ou utilisent des flèches pour repositionner les informations. Un modèle conçu pour « Nom : [____________] » ne peut pas gérer « Nom : [Jean D—— voir pièce jointe] ». La sortie OCR pour ce champ sera soit tronquée, soit brouillée, soit vide, et le reste du flux de travail n'a aucun moyen de savoir lequel.
Comment la reconnaissance d'écriture manuscrite par IA pense différemment
Les modèles de langage visuels (VLM) — la classe d'IA qui inclut des modèles comme GPT-4o, Claude et Gemini — traitent les documents de haut en bas plutôt que de bas en haut. Ils ne commencent pas par chercher des formes de lettres individuelles. Ils regardent l'image de la page entière, comprennent sa structure et son objectif, puis décodent le texte dans ce contexte. C'est plus proche de la façon dont un humain lit : vous n'examinez pas chaque trait de stylo isolément ; vous reconnaissez le mot « Total » parce que vous vous attendez à ce qu'un total apparaisse en bas d'une facture, et vous interprétez le nombre à côté comme une devise parce que le contexte l'exige.
La conséquence pratique est que l'extraction basée sur les VLM gère l'ambiguïté comme le ferait un humain — en recoupant ce qui se trouve sur la page avec ce qui devrait s'y trouver. Un caractère qui ressemble à « 5 » ou « S » est résolu en « 5 » s'il apparaît dans un champ numérique. Une date écrite « Jan 5 25 » est normalisée en « 2025-01-05 » parce que le modèle comprend les formats de date. Cette désambiguïsation contextuelle n'est pas une amélioration mineure par rapport à l'OCR au niveau des caractères — c'est la différence entre un résultat utilisable et un résultat qui nécessite une seconde passe humaine.
En pratique, les outils construits sur cette approche vous permettent de définir une Extraction de colonnes personnalisées : vous saisissez les noms de champs souhaités — « Numéro de facture », « Date d'échéance », « Montant total » — et l'IA localise chaque valeur n'importe où sur la page en comprenant ce que signifie le libellé du champ, et non où il se trouve. Pas de coordonnées de modèle, pas de configuration par fournisseur, pas de reconfiguration lorsque la mise en page d'un formulaire change. La même définition fonctionne sur différents documents provenant de différentes sources parce que l'IA cherche le sens, pas la position.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
L'écart de précision : en chiffres
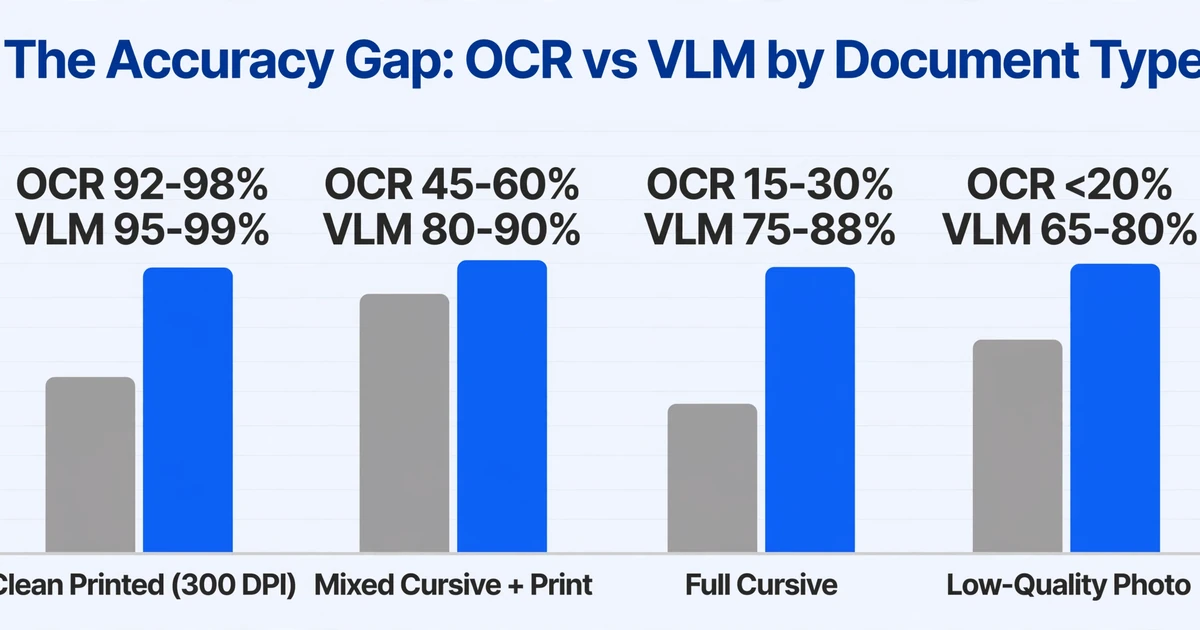
Les chiffres rendent la différence concrète. Plusieurs benchmarks indépendants publiés en 2025–2026 convergent vers un schéma cohérent : sur du texte imprimé, l'écart entre l'OCR traditionnelle et l'extraction basée sur les VLM est étroit (3–7 points de pourcentage). Sur l'écriture manuscrite, il explose.
| Type de document | Précision de l'OCR traditionnelle | Précision de l'extraction basée sur les VLM | Écart |
|---|---|---|---|
| Texte imprimé net (300 DPI) | 92–98 % | 95–99 % | 3–7 pp |
| Écriture manuscrite en capitales (cases contraintes) | 70–85 % | 85–93 % | 8–15 pp |
| Cursive mixte + imprimé | 45–60 % | 80–90 % | 25–35 pp |
| Cursive complète / écriture manuscrite désordonnée | 15–30 % | 75–88 % | 50–65 pp |
| Photos de terrain de faible qualité (téléphone, éclairage inégal) | <20 % | 65–80 % | 45–65 pp |
Deux remarques sur ce qui est mesuré. Premièrement, la colonne VLM mesure la précision au niveau du champ — c'est-à-dire si chaque valeur extraite atterrit dans la bonne colonne de votre feuille de calcul — et non la reconnaissance brute des caractères. La précision au niveau du champ est plus élevée que le taux d'erreur brut sur les caractères (CER), car le contexte du document résout les caractères ambigus : un chiffre maculé dans un champ Total est lu comme un 5, pas comme un S. Deuxièmement, la colonne OCR traditionnelle mesure la reconnaissance brute sur les mêmes documents — c'est précisément pour cela que l'écart paraît aussi important. Pour les métriques brutes au niveau des caractères sur le benchmark IAM, consultez notre analyse approfondie sur comment fonctionne la reconnaissance de l'écriture manuscrite.
Le schéma n'est pas subtil. Sur l'écriture manuscrite la plus propre (majuscules dans des cases délimitées), l'écart est gérable — l'OCR traditionnelle peut être « suffisante » avec un certain post-traitement. Mais à mesure que l'écriture se dégrade — des majuscules à la cursive mixte, des cases délimitées aux champs libres, des pages scannées aux photos de téléphone — la précision de l'OCR traditionnelle chute brutalement tandis que l'extraction basée sur les VLM se dégrade progressivement. Le même benchmark de 2026 a testé le moteur d'écriture manuscrite de Google Document AI sur la cursive : ~63 % de précision au niveau des mots. Amazon Textract a fait mieux avec ~89,5 % sur les mêmes entrées, mais les deux nécessitaient des pipelines de prétraitement séparés pour la correction d'inclinaison, l'amélioration du contraste et la suppression du bruit — un travail que les systèmes basés sur les VLM gèrent au moment de l'inférence, sans configuration supplémentaire (Suparse, 2026).
Pour un flux de travail réel traitant 100 documents mixtes par semaine — moitié imprimés, moitié manuscrits — la différence cumulée représente environ 4 à 6 heures par semaine de correction manuelle avec l'OCR traditionnelle, contre 30 à 45 minutes avec l'extraction basée sur les VLM. Cet écart ne relève pas du confort. Il détermine si l'automatisation incluant l'écriture manuscrite peut fonctionner sans étape dédiée de relecture humaine.
Là où la comparaison se complique : vitesse, coût et hallucination
Si la comparaison de précision était toute l'histoire, la décision serait simple. Mais l'extraction basée sur les VLM comporte trois compromis qui rendent une recommandation générale malhonnête.
Vitesse
L'OCR traditionnelle est rapide — elle traite une page en moins de 2 secondes sur du matériel standard. Les VLM sont plus lentes car elles effectuent un raisonnement plus riche. Un appel VLM typique pour l'extraction au niveau de la page prend 5 à 12 secondes selon la complexité du document et la taille du modèle. Pour un lot de 500 pages, cela représente la différence entre 15 minutes et plus d'une heure. Si votre flux de travail est sensible au volume et que vos documents sont systématiquement du texte imprimé propre, l'OCR traditionnelle reste l'option la plus rapide — et peut être tout ce dont vous avez besoin.
Coût
L'OCR traditionnelle est peu coûteuse. Tesseract est gratuit et open-source. Les API d'OCR cloud facturent environ 0,001 à 0,005 $ par page. L'extraction basée sur les VLM coûte plus cher par page car le calcul est plus lourd — mais la comparaison est trompeuse si l'on s'arrête au prix unitaire de l'API. Un utilisateur de Reddit qui a traité plus de 150 000 pages en production a noté que l'avantage de coût par page de l'OCR traditionnelle s'évaporait lorsqu'on prenait en compte le coût de la correction manuelle : « Les plateformes d'OCR traditionnelle semblent rentables (~0,001 à 0,005 $ par page), mais leur mauvaise précision sur l'écriture manuscrite (~45 à 50 %) les rend inutilisables pour les flux de travail professionnels comportant un contenu manuscrit important. Le temps passé à corriger manuellement les erreurs rend le coût réel bien plus élevé que celui des solutions spécialisées » (r/computervision, 2025). La véritable équation de coût est : coût d'extraction par page + coût de correction par erreur × taux d'erreur. Pour les documents imprimés, le coût par page domine. Pour les documents manuscrits, le coût de correction domine — et c'est là que la précision supérieure des VLM change la donne.
Hallucination
Voici ce que la plupart des articles comparatifs omettent : les VLM peuvent halluciner. Parce qu'elles raisonnent sur ce qui devrait se trouver sur une page, elles insèrent parfois des informations qui n'y sont pas — une date plausible là où le champ était laissé vide, ou un montant deviné là où l'écriture était réellement illisible. L'OCR traditionnelle a le mode de défaillance opposé (elle ne renvoie rien ou du charabia), ce qui rend ses erreurs plus faciles à détecter. Une hallucination de VLM est plus dangereuse car elle semble correcte. La différence entre une sortie Tesseract faussement confiante (« OOO OOO ») et une sortie VLM faussement confiante est que la version VLM se lit comme de vraies données — et peut passer au travers de la validation automatisée. Pour les champs où les erreurs coûtent cher (montants de paiement, dates de contrat, données de conformité), le score de confiance et l'intervention humaine restent nécessaires quelle que soit la technologie choisie (F22 Labs, 2026).
Point clé : l'OCR traditionnelle échoue en renvoyant des caractères erronés. L'extraction basée sur les VLM peut échouer en renvoyant des fabrications crédibles. Le premier mode de défaillance est bruyant mais détectable. Le second est silencieux et dangereux. Aucune technologie n'élimine le besoin de validation sur les champs à enjeux élevés — elles nécessitent simplement des stratégies de validation différentes.
L'approche hybride : quand utiliser quoi
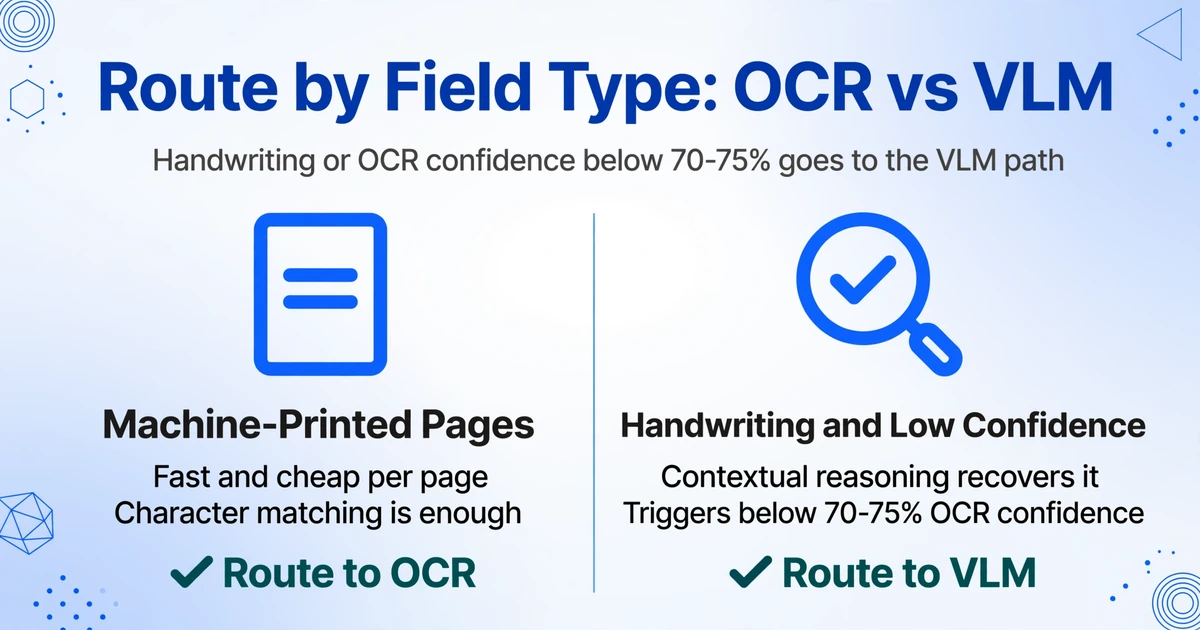
La réponse pratique pour la plupart des équipes n'est pas « tout passer à l'IA » ou « rester avec l'OCR ». C'est un pipeline hybride qui route chaque document vers le bon moteur en fonction de ses caractéristiques.
Pour les documents 100 % imprimés par machine, au format cohérent et scannés à 300+ DPI, l'OCR traditionnelle est plus rapide, moins chère et suffisante. La sortie peut nécessiter un post-traitement au niveau de la position des champs, mais la précision au niveau des caractères est suffisamment élevée pour que les règles de post-traitement soient stables.
Pour les documents contenant de l'écriture manuscrite — même un seul champ — la stratégie hybride change. Utilisez l'OCR traditionnelle pour les sections imprimées et routez les champs manuscrits vers un VLM. Cela capture l'avantage de vitesse de l'OCR sur la majeure partie de la page tout en utilisant l'IA contextuelle sur les parties que l'OCR ne peut pas gérer. La logique de routage est simple : si la confiance de l'OCR sur un champ tombe sous un seuil (généralement 70–75 %), ce champ est retraité via le chemin VLM. Un plancher de nombre de caractères (minimum 40 caractères par page) sert de deuxième garde-fou pour détecter les pages où l'OCR affirme une confiance élevée sur quatre caractères correctement lus mais a manqué le reste de la page entièrement.
L'approche par seuil contrôle également les coûts — vous ne payez pour le traitement VLM que sur les champs où cela fait une différence. Pour un flux de travail où 30 % des documents contiennent de l'écriture manuscrite et où chaque document compte en moyenne 15 champs, cela signifie qu'environ 5 champs par document passent par le chemin VLM, et non la page entière. À grande échelle, cette différence compte.
Ce que cela signifie pour votre flux de travail documentaire
Le choix entre l'OCR traditionnelle et la reconnaissance d'écriture manuscrite par IA n'est pas une question de technologie — c'est une question de conception de flux de travail. Si votre traitement de documents est 100 % imprimé et basé sur des modèles, l'OCR traditionnelle fonctionne et continuera de fonctionner. Si une part significative de vos documents contient de l'écriture manuscrite — accusés de livraison avec notes du chauffeur, rapports d'inspection avec observations de terrain, formulaires médicaux avec signatures de patients, demandes financières avec déclarations manuscrites — alors un pipeline basé uniquement sur l'OCR traditionnelle perd silencieusement des données à chaque lot.
L'erreur de calcul la plus courante consiste à supposer que « l'OCR gère cela » parce que la page marketing de l'outil mentionne la prise en charge de l'écriture manuscrite. L'écart entre la capacité annoncée et les performances réelles sur vos documents — et non sur les échantillons de démonstration nettoyés du fournisseur — détermine si l'automatisation fonctionne ou crée plus de travail qu'elle n'en économise. Tester avec vos propres documents, en particulier les 10 % les plus complexes de votre flux d'entrée, est la seule façon de savoir quelle approche — OCR pure, VLM pure ou hybride — tiendra sous charge de production.
FAQ
L'OCR traditionnelle peut-elle lire l'écriture cursive ?
Oui, mais de manière peu fiable. Même avec des moteurs basés sur LSTM comme Tesseract 4.x, la précision de la cursive tombe généralement sous les 50 % au niveau du mot. Les caractères d'une écriture liée sont trop ambigus pour une correspondance de motifs ascendante. L'OCR traditionnelle n'a pas été conçue pour cette classe d'entrée, et aucun réglage de paramètres ne change la limitation architecturale sous-jacente.
La reconnaissance d'écriture manuscrite par IA est-elle assez précise pour remplacer la saisie manuelle des données ?
Pour de nombreux flux de travail, oui — avec des réserves. Sur l'écriture en lettres moulées dans des champs de formulaire contraints, l'extraction par IA atteint une précision au niveau du champ de 85 à 93 %, ce qui fait de la saisie manuelle l'exception plutôt que la règle. Sur une cursive difficile ou des photos de téléphone dégradées, la précision chute à 65–80 % — toujours une amélioration spectaculaire par rapport aux moins de 20 % de l'OCR traditionnelle, mais pas assez élevée pour un traitement direct sans étape de vérification sur les champs critiques. Le point idéal pratique est l'extraction avec un routage basé sur le score de confiance : les champs à haute confiance passent automatiquement, les champs à faible confiance sont signalés pour une intervention humaine. Pour un aperçu plus approfondi de la variation de la précision selon la qualité d'entrée et la conception des champs, consultez notre guide d'amélioration de la précision.
Qu'en est-il de la vitesse — l'extraction par IA est-elle plus lente que l'OCR ?
Par page, oui — généralement 5 à 12 secondes pour l'extraction basée sur les VLM contre moins de 2 secondes pour l'OCR traditionnelle. Mais la comparaison équitable inclut le temps gagné en évitant de corriger manuellement les erreurs d'OCR sur les champs manuscrits. Pour un lot de 100 pages avec 40 % de contenu manuscrit, l'extraction par VLM prend environ 10 minutes de traitement + 30 minutes de relecture. L'OCR traditionnelle prend environ 3 minutes de traitement + 3 à 5 heures de correction. Le temps de travail total favorise les VLM pour tout lot contenant de l'écriture manuscrite.
Puis-je utiliser à la fois l'OCR traditionnelle et l'extraction par IA dans le même pipeline ?
Oui — et c'est ce à quoi ressemblent la plupart des déploiements en production. Utilisez l'OCR traditionnelle pour les pages imprimées par machine avec un score de confiance supérieur à 75 % et un nombre minimal de caractères. Acheminez tout ce qui est en dessous de ce seuil — ainsi que tout document signalé comme contenant de l'écriture manuscrite — vers le chemin VLM. Cette architecture hybride capture les avantages de coût et de vitesse de l'OCR là où elle fonctionne, tout en couvrant les lacunes de l'écriture manuscrite que l'OCR ne peut pas combler.
Les outils d'extraction par IA hallucinent-ils des données qui ne figurent pas sur la page ?
Ils le peuvent. Les systèmes basés sur les VLM génèrent parfois des données d'apparence plausible pour des champs qui étaient en réalité vides ou illisibles. C'est la différence la plus importante par rapport au mode de défaillance de l'OCR traditionnelle : l'OCR traditionnelle renvoie des données incohérentes qui sont manifestement erronées ; une hallucination de VLM peut sembler correcte et passer la validation sans être remarquée. Pour tout champ où une erreur est coûteuse — montants de paiement, dates légales, identifiants de patients — le score de confiance et la relecture humaine restent nécessaires, quelle que soit la technologie d'extraction utilisée.
Le seul critère qui compte
Les critères de référence et les tableaux comparatifs vous disent ce qui est vrai en moyenne. Ils ne vous disent pas ce qui est vrai pour vos documents — ceux avec l'écriture manuscrite de vos fournisseurs, les abréviations de votre personnel de terrain, vos formulaires numérisés vieux de dix ans. L'écart entre l'OCR traditionnelle et la reconnaissance de l'écriture manuscrite par IA se mesure en points de pourcentage, mais l'importance de ces points dépend entièrement de ce qui se passe lorsqu'un champ est mal lu dans votre flux de travail. Un total de facture mal lu est une erreur de paiement. Un résultat d'inspection mal lu est un manquement à la conformité. Un dossier patient mal lu est un problème de sécurité.
Testez sur vos propres documents. Pas les plus propres — les huit formulaires agrafés ensemble avec des taches de café et des notes en marge. Ce sont ceux-là qui déterminent si votre pipeline d'extraction fonctionne ou s'il semble simplement fonctionner jusqu'à ce que quelqu'un attrape une erreur.