AI OCR vs OCR traditionnel
L'écart de précision que vous ne pouvez plus ignorer
En 2023, l'écart de précision entre l'OCR alimenté par l'IA et l'OCR traditionnel était discutable. À la mi-2026, il ne l'est plus. Lorsqu'un moteur d'OCR traditionnel traite un lot de factures multi-fournisseurs, la précision au niveau des champs se situe régulièrement entre 60 % et 85 % — ce qui signifie que 15 à 40 champs sur 100 nécessitent une correction humaine. Un modèle de vision IA sur le même lot : 95 % à 99 %. L'écart ne concerne plus « mieux » ou « moins bien ». Il est devenu un poste de coût qui apparaît à chaque clôture mensuelle, à chaque rapprochement de comptes fournisseurs, à chaque file de relecture manuelle qu'il faut doter en personnel. Cet article mesure cet écart avec des chiffres réels, explique ce qui a changé, et identifie le point où rester avec l'OCR traditionnel coûte plus cher que de changer.
Points clés à retenir
- La « précision de 99 % » de l'OCR traditionnel mesure les caractères, pas les champs de données. Sur de vraies factures multi-fournisseurs, la précision des champs chute à 40–60 % — la moitié de vos valeurs extraites sont fausses avant même que quiconque n'y touche.
- La dérive de modèle est l'échec d'OCR le plus coûteux : lorsqu'un fournisseur déplace un champ, le modèle extrait silencieusement les mauvaises données dans votre ERP. Aucun drapeau d'erreur ne se déclenche. L'erreur apparaît au rapprochement, où elle coûte 10× plus cher à corriger.
- L'extraction par IA lit par le sens, pas par coordonnées de pixels. Saisissez vos noms de colonnes une seule fois — « Numéro de facture », « Date d'échéance » — et ImageToTable.ai les localise sur n'importe quelle mise en page instantanément. La maintenance des modèles et la dérive silencieuse disparaissent.
Ce que fait l'OCR traditionnel — et ce qu'il n'a jamais fait
La reconnaissance optique de caractères a été conçue pour résoudre un problème : convertir une image de texte en caractères lisibles par machine. Une page scannée entre ; une chaîne de caractères sort. Pour cette tâche étroite, les moteurs OCR modernes performent bien. Tesseract 5, la référence open source maintenue par Google, atteint 95 % de précision des caractères sur des documents imprimés propres — comparable aux moteurs commerciaux dans des conditions contrôlées.
Mais la précision des caractères n'est pas la précision des données. Savoir que les caractères « 1 234,56 » apparaissent sur une page ne vous dit pas s'il s'agit d'un total de facture, d'une quantité ou d'un numéro de référence. L'OCR traditionnel fonctionne de bas en haut : reconnaître les caractères individuels, les assembler en mots, regrouper les mots en lignes. Le résultat est un flux de texte organisé par ordre de lecture — de gauche à droite, de haut en bas. Il n'a aucune compréhension de ce que tout cela signifie.
La conséquence en aval est que chaque variation de mise en page devient un problème d'analyse distinct. Un fournisseur qui place le numéro de facture dans le coin supérieur droit produit une carte de coordonnées. Un fournisseur qui le place sous le logo en produit une autre. Changez la police, ajoutez un nouveau champ, réorganisez un tableau — et la logique d'extraction se brise silencieusement. Les systèmes OCR basés sur des modèles tentent de résoudre ce problème en définissant des coordonnées de pixels pour chaque champ sur chaque type de document. Cela fonctionne lorsque votre ensemble de documents est fixe et homogène. Cela s'effondre lorsque les documents varient — ce qui est la norme pour toute entreprise recevant des factures, des bons de commande ou des reçus de plus d'une source.
Les chiffres de précision : ce que montrent réellement les benchmarks de 2026
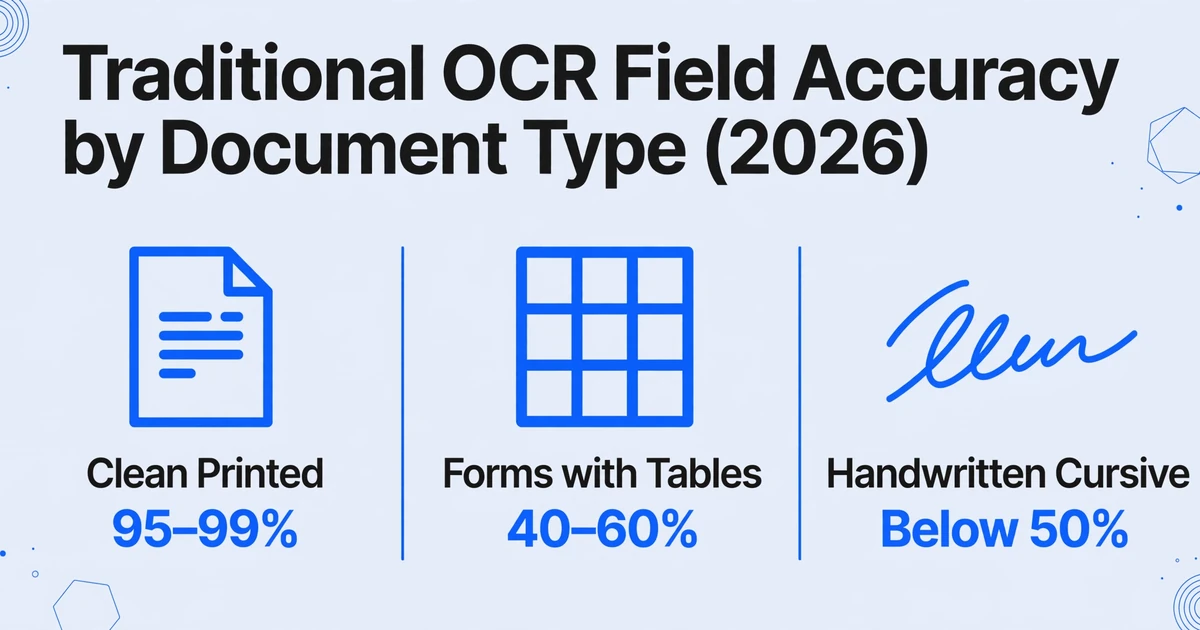
L'écart de précision n'est pas théorique. Des benchmarks indépendants le quantifient désormais à travers les types de documents et les niveaux de difficulté. Voici ce que disent les données à la mi-2026 :
| Type de document | OCR traditionnel | AI OCR (basé sur VLM) | Principal mode de défaillance de l'OCR traditionnel |
|---|---|---|---|
| Texte imprimé propre, mise en page fixe | 95–99 % | 98–99 % | Écart minimal — les deux fonctionnent bien |
| Formulaires avec tableaux et colonnes mixtes | 40–60 % | 85–95 % | Lignes/colonnes fusionnées ou perdues lors de l'extraction |
| Texte manuscrit (écriture en capitales) | 50–70 % | 85–93 % | La variation morphologique des caractères défie la reconnaissance de motifs |
| Texte manuscrit (cursif) | Moins de 50 % | 75–85 % | Les caractères liés sont lus comme des glyphes uniques |
| Factures multi-fournisseurs (mises en page variées) | 60–85 % (au niveau des champs) | 95–98 % (au niveau des champs) | Inadéquation du modèle ; dérive des coordonnées ; variation des libellés |
Sources : benchmarks des modèles IA Firstsource (2026) pour les comparaisons de précision sur documents complexes ; analyse Tesseract vs docTR de 47Billion pour les références OCR traditionnel ; benchmark OCR manuscrit AIMultiple (2026) pour les chiffres d'écriture manuscrite dans les deux catégories. Tous les chiffres reflètent la précision au niveau des champs sur des documents de qualité production, et non des conditions de laboratoire avec des scans propres.
Ces chiffres révèlent un schéma. Sur des documents propres et cohérents — un formulaire dactylographié scanné à 300 DPI avec des champs prévisibles — l'OCR traditionnel offre une précision difficile à battre à son niveau de prix. Mais dès que les documents incluent des tableaux, de l'écriture manuscrite, des mises en page mixtes ou des variations de format entre sources, la chute est brutale. Un benchmark Tesseract de 2025 sur des documents réels a constaté seulement 40–50 % de précision au niveau des champs sans prétraitement intensif — ce qui signifie que plus de la moitié des champs extraits nécessitaient une vérification avant que les données ne soient exploitables.
Il y a une deuxième couche dans ces chiffres que la plupart des comparaisons ignorent. Un taux de précision des caractères de 99 % — la revendication marketing standard de l'OCR depuis des décennies — ne signifie pas que 99 % des données dont vous avez besoin sont correctes. Si une page de facture contient 1 000 caractères et que 10 sont mal lus, la précision des caractères est de 99 %. Mais si ces 10 caractères erronés se trouvent dans 3 des 15 champs qui vous intéressent, la précision au niveau des champs chute à 80 %. Le TDWI a documenté exactement ce scénario : le tableau de bord affiche 99 %, mais 1 champ métier sur 5 contient une erreur. Multipliez cela par 500 factures et la file de vérification devient le goulot d'étranglement que l'outil était censé éliminer.
Là où l'OCR traditionnel échoue systématiquement — non pas « inexact », mais structurellement aveugle
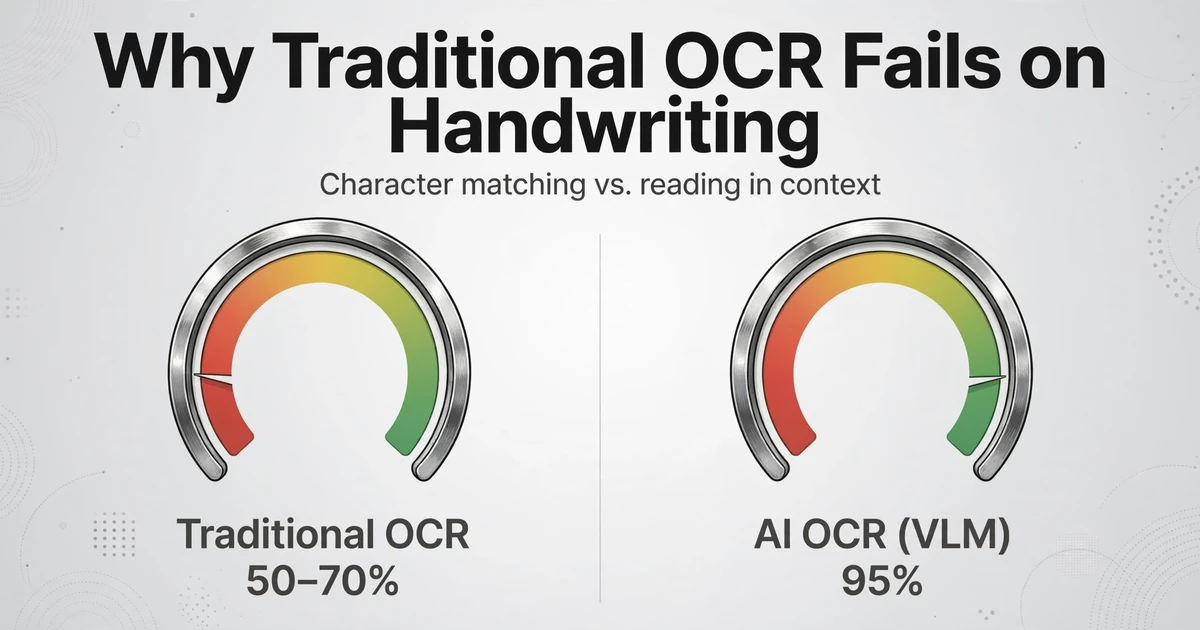
Il est tentant de décrire les échecs de l'OCR traditionnel comme des problèmes de précision. Il est plus précis de les appeler des angles morts structurels — des scénarios où l'approche ascendante, caractère par caractère, est architecturalement incapable de produire un résultat correct, quelle que soit la qualité de l'image. Voici les modes de défaillance qui font grimper les coûts de correction des erreurs :
Écriture manuscrite. L'OCR traditionnel repose sur la correspondance des formes de caractères. Un « 4 » qui ressemble à un « 9 », un « r » cursif qui se connecte à la lettre suivante, un « 7 » manuscrit avec une barre transversale que le moteur lit comme un caractère séparé — chacun est un échec prévisible. Des benchmarks indépendants sur Google Cloud Vision, AWS Textract et Azure Document Intelligence montrent une précision de l'écriture manuscrite entre 50 % et 70 % pour ces systèmes. GPT-5, un VLM (modèle vision-langage), atteint 95 % sur la même tâche en lisant les mots dans leur contexte — en désambiguïsant les caractères en fonction de ce qui a du sens dans une phrase, et non seulement de ce à quoi ressemble la forme.
Mises en page multi-colonnes. L'OCR traditionnel lit de gauche à droite, de haut en bas. Une facture à deux colonnes — les coordonnées du fournisseur à gauche, les lignes d'articles à droite à mi-page, un encadré total dans le coin inférieur — est lue comme un flux de texte confus. Le moteur n'a aucun concept de limites spatiales au-delà de sa grille de coordonnées. Une analyse Microsoft Q&A de 2025 sur les échecs de l'OCR traditionnel dans les documents professionnels a identifié la mise en page multi-colonnes comme l'une des causes les plus courantes de données atterrissant dans le mauvais champ, avec « des lignes entières sautées » comme symptôme aval fréquent.
Cases à cocher, tampons et éléments superposés. Un tampon « PAYÉ » superposé sur une ligne d'article de facture rend le texte sous-jacent invisible pour l'OCR traditionnel. Un formulaire d'assurance avec des cases à cocher pour les options « Oui / Non » est lu comme des caractères aléatoires près de formes géométriques. Un relevé bancaire avec un logo chevauchant le numéro de compte — le moteur voit du bruit, pas des données. Ce ne sont pas des cas limites. Une seule valeur de case à cocher manquante sur un formulaire COI peut bloquer toute une approbation de conformité.
Faible contraste et scans dégradés. Les reçus en papier thermique s'estompent. Les photos de documents prises au téléphone introduisent des ombres et des distorsions d'angle. Les bons de commande faxés arrivent avec des artefacts de compression qui fragmentent les caractères. Les moteurs d'OCR traditionnels se dégradent nettement en dessous de 200 DPI ou avec un éclairage non uniforme. Les modèles de vision IA, entraînés sur des milliards d'images réelles, gèrent ces conditions en interprétant le contexte visuel — un caractère taché dans une position de champ connue est inféré à partir de ce que le champ est censé contenir, et non seulement de ce que montrent les pixels.
Dérive de modèle. C'est le coût silencieux. Un fournisseur redessine sa mise en page de facture — déplace le numéro de bon de commande du coin supérieur droit vers sous l'adresse de livraison. Le modèle d'OCR traditionnel, qui regarde toujours les anciennes coordonnées, extrait une adresse postale et l'étiquette comme numéro de bon de commande. Aucun drapeau d'erreur ne se déclenche car le champ a été trouvé. Les données circulent dans votre ERP, et l'inadéquation est découverte lorsque quelqu'un rapproche le paiement des semaines plus tard. La dérive de modèle n'est pas un bug — c'est le comportement attendu de tout système qui utilise des coordonnées fixes au lieu d'une compréhension sémantique.
Comment l'IA OCR lit différemment : la page entière, pas des caractères isolés
L'OCR alimenté par l'IA — plus précisément appelé extraction par modèle de langage visuel (VLM) — traite un document comme le ferait une personne : en prenant la page entière d'un coup et en comprenant ce que chaque zone, étiquette et valeur signifie. La technologie sous-jacente est un modèle d'IA multimodal entraîné sur des milliards de paires image-texte. Lorsque vous lui donnez un bordereau d'expédition scanné, il ne scanne pas de gauche à droite à la recherche de formes de caractères. Il identifie le type de document, analyse la disposition spatiale, lit le texte en contexte et associe chaque valeur au champ de données correct en fonction du sens — et non de la position.
La différence cruciale est mieux illustrée par un exemple concret. Considérez trois chaînes de texte sur une facture :
« Date : 15/03/2026 »
L'OCR traditionnel voit : six caractères « Date » suivis de dix caractères « 15/03/2026 ». Il ne sait pas s'il s'agit de la date d'émission, de la date d'échéance ou de la date d'expédition.
« Date d'échéance : 14/04/2026 »
L'OCR traditionnel voit : deux mots de plus et dix caractères de plus. Il ne peut pas relier cela à « Date » ci-dessus ni distinguer l'un de l'autre. Les deux ne sont que des chaînes de texte avec un format de date.
« Date de facture : 15/03/2026 »
L'OCR traditionnel voit : deux mots de plus, même date. Pour le moteur, c'est une troisième chaîne de texte — sans lien avec les deux premières. Aucune connexion sémantique n'est établie.
L'IA OCR voit trois champs de données différents. Elle lit les étiquettes (« Date », « Date d'échéance », « Date de facture »), comprend ce que chacune signifie dans le contexte d'une facture et place chaque valeur dans la colonne correcte de votre feuille de calcul. La Date de facture va dans la colonne Date de facture. La Date d'échéance va dans la colonne Date d'échéance. Même si « Date de facture » apparaît dans l'en-tête, « Date d'échéance » dans la section des conditions de paiement et un simple « Date » dans une ligne d'article — le modèle désambiguïse en fonction du contexte environnant, et non de l'emplacement des pixels.
Cette compréhension sémantique est ce qui rend l'extraction par IA sans modèle — et c'est la distinction qui sépare les logiciels d'extraction de données modernes des outils OCR traditionnels. Vous n'avez pas besoin de définir des coordonnées de pixels pour « Numéro de facture » sur chaque mise en page de facture fournisseur. Vous saisissez les noms de colonnes à extraire — « Numéro de facture », « Date d'échéance », « Nom du fournisseur », « Total ligne » — et l'IA localise chaque valeur n'importe où sur la page en comprenant ce qu'elle signifie. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre feuille de calcul finale. Ce mécanisme s'appelle Extraction de colonnes personnalisées : vous décrivez le schéma de sortie, et l'IA fait correspondre le contenu du document à vos colonnes — quel que soit l'endroit où le fournisseur a placé chaque champ.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
La démo ci-dessus montre ce mécanisme en action sur une facture — saisissez n'importe quel nom de colonne et regardez l'IA localiser la valeur, quel que soit l'endroit où elle se trouve sur la page. Essayez « Numéro de facture », « Date d'échéance » ou « Nom du fournisseur ». Le même mécanisme fonctionne à l'identique sur les relevés bancaires, les bons de commande, les reçus et tout document où l'information vit dans une mise en page visuelle plutôt que dans un champ de base de données.
Là où l'OCR traditionnel reste gagnant — et pourquoi c'est important
Une comparaison qui ne parle que des avantages de l'IA est un argumentaire commercial, pas une analyse. L'OCR traditionnel a de réelles forces qui en font le bon choix dans certains scénarios, et les reconnaître rend le cas de l'IA crédible quand il s'applique.
Documents standardisés à très grande échelle. Si vous traitez un million de formulaires fiscaux W-2 par an — mise en page identique, texte tapé propre, champs prévisibles — un OCR traditionnel avec un seul modèle bien maintenu offre une précision quasi parfaite pour une fraction du coût par document de tout outil d'extraction par IA. La configuration du modèle est un investissement unique qui s'amortit sur des millions de documents identiques. À cette échelle, un appel API OCR à 0,01 $ par page contre un appel d'extraction VLM à 0,05 $ permet d'économiser 40 000 $ par million de pages.
Documents propres et simples, sans variation. Un document texte d'une seule page — une lettre tapée, une simple note, un relevé bancaire propre avec une mise en forme cohérente — est un problème résolu pour l'OCR traditionnel. Tesseract et les moteurs similaires les traitent avec une précision supérieure à 99 % et des temps de traitement inférieurs à la seconde. Ajouter une couche d'IA augmente le coût sans apporter de valeur.
Environnements à budget limité avec des entrées homogènes. Une organisation qui ne reçoit qu'un seul format de facture d'un seul fournisseur, sans variation ni complexité, n'a peut-être pas besoin d'extraction par IA. L'OCR open source est gratuit. Le travail pour créer un modèle unique pour une mise en page unique est un coût unique mesuré en heures. Dans ce scénario restreint, le coût d'abonnement supplémentaire d'un outil d'IA est difficile à justifier.
Numérisation de textes d'archives pour la recherche. Lorsque l'objectif est la recherche en texte intégral — rendre un corpus de documents historiques consultable par mot-clé — plutôt que l'extraction de données structurées, l'OCR traditionnel est le choix efficace. Vous n'avez pas besoin de savoir quel texte est une date et lequel est un nom. Vous avez besoin de savoir quel texte se trouve sur la page. L'OCR traditionnel fait exactement cela, et le fait bien à grande échelle.
Le point de bascule : quand les coûts de correction dépassent les coûts d'abonnement
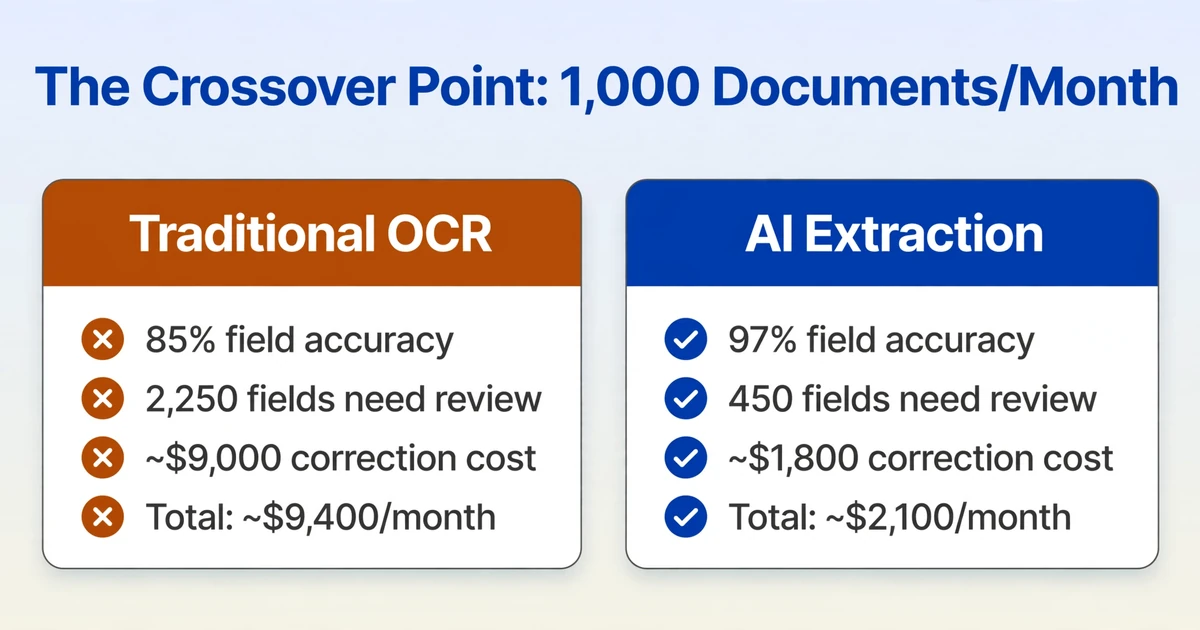
La décision économique entre l'OCR traditionnel et l'extraction par IA dépend de trois variables : la variété des documents, leur complexité et le volume de traitement. Lorsque la variété et la complexité sont faibles et le volume très élevé, l'OCR traditionnel l'emporte sur le coût. Lorsque la variété ou la complexité dépasse un seuil, le calcul s'inverse.
Voici l'arithmétique du point de bascule à une échelle pratique. Supposons une équipe traitant 1 000 documents par mois. Chaque document comporte 15 champs à extraire. La base de référence :
| Scénario | Précision des champs | Champs à vérifier / mois | Coût de correction* | Coût de l'outil | Total mensuel |
|---|---|---|---|---|---|
| OCR traditionnel (modèles) | 85 % (factures variées) | 2 250 champs | ~9 000 $ | 200–500 $ | ~9 400 $ |
| Extraction par IA | 97 % (factures variées) | 450 champs | ~1 800 $ | 50–300 $ | ~2 100 $ |
* Estimation à 4 $ par correction de champ (vérification, recherche, ressaisie). Source : analyse des coûts d'erreur de saisie (2026). Les coûts réels de main-d'œuvre varient selon la région et le poste.
Avec 1 000 documents par mois, 15 champs chacun et une variation de mise en page modérée, la différence de précision de 12 points entre 85 % et 97 % se traduit par 1 800 champs en moins à vérifier manuellement — soit environ 7 200 $ par mois de travail de correction évitable. Le point de bascule exact varie selon le volume et la complexité des documents, mais le schéma est constant : lorsque la précision au niveau des champs tombe sous 90 %, le coût de correction des erreurs éclipse le coût de l'outil.
Une deuxième dimension du point de bascule est la maintenance des modèles. Lorsqu'une équipe maintient des modèles pour 50 mises en page de fournisseurs différentes et que chaque fournisseur modifie sa mise en page tous les 12 à 18 mois, l'équipe reconstruit en permanence des modèles. La configuration d'un seul modèle prend 30 à 60 minutes. Si trois fournisseurs mettent à jour leur format de facture chaque mois, cela représente 1,5 à 3 heures de travail sur les modèles — chaque mois, indéfiniment. L'extraction par IA élimine cela entièrement, car elle lit par le sens, et non par les coordonnées.
La troisième dimension, ce sont les erreurs que l'OCR traditionnel ne détecte pas du tout. L'extraction par modèle ne signale pas une valeur erronée — elle ne signale que l'absence d'une valeur aux coordonnées attendues. Un numéro de commande extrait au mauvais endroit parce que le modèle a dérivé n'est pas une « erreur » détectée par le système. C'est une donnée qui entre dans votre ERP et génère un problème de rapprochement des semaines plus tard. Ces erreurs non détectées sont les plus coûteuses — le coût moyen de correction en aval pour une erreur de saisie détectée après traitement est de 50 à 500 $, contre 3 à 5 $ pour une erreur détectée lors de la relecture. La dérive des modèles produit ce type d'erreurs coûteuses à grande échelle.
Ce qui change après la migration : comparaison côte à côte
Les chiffres abstraits aident à décider. Les exemples concrets aident à comprendre ce qu'ils signifient en pratique. Voici le même lot de factures, deux approches de traitement, côte à côte :
| Dimension | OCR traditionnel (avec modèle) | Extraction par IA |
|---|---|---|
| Configuration pour 20 fournisseurs | 20 modèles × 30 min chacun = 10 heures | Définir les noms de colonnes une fois = 2 minutes |
| Arrivée du fournisseur 21 | Créer un nouveau modèle = 30 minutes | Aucun changement. Les mêmes colonnes fonctionnent sur toute mise en page. |
| Le fournisseur 5 change sa mise en page | Données mal dirigées en silence. Découvert au rapprochement. | Champs détectés par le sens sémantique. Le changement de mise en page est invisible. |
| Note manuscrite sur la facture | Illisible. Champ laissé vide ou rempli de caractères parasites. | Lue en contexte. Le « urgent » manuscrit à côté de « Priorité : » devient la valeur. |
| Photo de reçu prise avec un téléphone | Distorsion d'angle + faible contraste = résultat inutilisable | Le contexte visuel compense. L'impression thermique délavée reste lisible. |
| Case à cocher dans un formulaire | Caractères aléatoires près d'un carré. Vérification manuelle requise. | Identifie l'option cochée par saillance visuelle. « Oui » ou « Non » extrait. |
| 50 factures, 15 fournisseurs, 1 fichier de sortie | Exécuter chaque fournisseur via son modèle. Fusionner les sorties. Corriger les incohérences. | Télécharger les 50. Définir les noms de colonnes une fois. Télécharger le fichier Excel consolidé. |
La ligne la plus instructive est « Le fournisseur 5 repense la mise en page ». Dans la colonne OCR traditionnel, l'erreur est invisible : le modèle trouve le texte aux coordonnées attendues et le renvoie, qu'il s'agisse ou non du bon texte. Dans la colonne IA, le changement de mise en page est sans importance car l'extraction repose sur le sens du texte, et non sur son emplacement. Cette seule différence — dérive silencieuse du modèle contre extraction résiliente à la mise en page — est responsable de plus de coûts de rapprochement en aval que tout autre facteur.
L'approche hybride mérite d'être envisagée par les équipes qui traitent un mélange de types de documents. De nombreuses organisations gérant l'extraction de documents à grande échelle — comme observé dans les communautés Reddit r/mlops et r/fintech — utilisent des pipelines en couches : OCR traditionnel pour les types de documents standardisés à volume élevé où les modèles fonctionnent de manière fiable, et extraction par IA pour les documents variables, complexes ou manuscrits où les coûts de maintenance des modèles dépassent l'alternative. La logique d'orientation est simple : si un document correspond à un modèle connu avec une grande confiance, traitez-le par OCR. Sinon, ou si la confiance tombe sous un seuil, orientez-le vers l'extraction par IA. Cela permet de capter l'avantage de coût de l'OCR traditionnel là où il s'applique, tout en évitant la pénalité de correction d'erreur là où ce n'est pas le cas.
FAQ
Puis-je simplement utiliser ChatGPT ou Claude pour extraire des données de mes documents ?
Pour un document à la fois, oui — GPT-5 atteint 95 % de précision sur l'écriture manuscrite et gère bien les documents aux formats variés. Mais les chatbots généralistes ne sont pas conçus pour le traitement par lots : télécharger 50 factures et obtenir un seul tableau consolidé avec des colonnes cohérentes pour tous les documents. Chaque document est une conversation séparée, les noms de colonnes doivent être précisés à chaque fois, et il n'existe aucun mécanisme intégré pour fusionner les sorties en un seul fichier structuré. Pour des extractions ponctuelles, les chatbots fonctionnent. Pour un traitement récurrent de documents en volume, les outils d'extraction spécialisés gèrent le lot, la cohérence du schéma et le flux d'exportation que les chatbots n'ont jamais été conçus pour prendre en charge.
Quelle est la différence de coût réel par document entre l'OCR traditionnel et l'extraction par IA ?
L'OCR traditionnel coûte environ 0,01 à 0,05 $ par page à grande échelle (tarification API des fournisseurs cloud). L'extraction par IA coûte environ 0,05 à 0,30 $ par page. L'écart de coût logiciel brut est d'environ 3 à 10 fois. Mais le coût total de possession — incluant la main-d'œuvre de correction des erreurs, la maintenance des modèles et les coûts d'erreurs en aval — inverse généralement la comparaison pour tout flux de travail traitant plus de 200 documents variés par mois. La comparaison entre l'OCR gratuit et l'extraction par IA payante couvre la ventilation complète du coût total de possession.
L'AI OCR fonctionne-t-il sur les documents manuscrits ?
Oui, et l'écart est ici plus important que sur le texte imprimé. Les moteurs d'OCR traditionnels atteignent une précision de 50 à 70 % sur l'écriture manuscrite. Les VLM (modèles vision-langage) atteignent 85 à 95 % sur les mêmes documents en utilisant la compréhension contextuelle — le modèle sait à quoi une date devrait ressembler dans un champ donné et utilise cette connaissance pour lever l'ambiguïté des caractères peu clairs. Pour l'écriture cursive, l'écart se creuse davantage : l'OCR traditionnel tombe sous les 50 %, tandis que l'extraction basée sur VLM maintient 75 à 85 %. Les limites sont réelles — une cursive très désordonnée, des écritures non latines avec des données d'entraînement limitées et une écriture manuscrite à des angles extrêmes défient encore tous les systèmes — mais l'avantage relatif de l'extraction par IA sur l'écriture manuscrite est le plus grand parmi tous les types de documents.
À partir de quel volume de documents l'extraction par IA devient-elle rentable ?
Le point de bascule dépend davantage de la variété des documents que du volume brut. Une équipe traitant 100 documents par mois provenant de 3 fournisseurs avec des mises en page fixes peut ne jamais atteindre ce point. Une équipe traitant 200 documents par mois provenant de 20 fournisseurs avec des mises en page variées l'atteint immédiatement — la maintenance des modèles à elle seule consomme plus d'heures de travail que le coût de l'abonnement à l'IA. En règle générale : si vous maintenez des modèles pour plus de 10 mises en page de documents différentes, vous avez déjà dépassé le point de bascule. Consultez le paysage tarifaire de l'extraction de documents par IA en 2026 pour connaître les coûts actuels des outils à chaque niveau de volume.
Quelle précision dois-je attendre de l'extraction IA en production ?
Une précision au niveau des champs de 95 à 97 % sur des documents professionnels variés est une attente réaliste en production, selon les benchmarks actuels des VLM (modèles vision-langage). Sur des documents propres et standardisés, elle atteint 98 à 99 %. Sur des documents fortement dégradés — fax, reçus en papier thermique, documents avec tampons superposés au texte — attendez-vous à 85 à 93 %. La distinction cruciale se situe entre la précision des caractères et la précision au niveau des champs : un outil annonçant 99 % de précision des caractères peut n'offrir que 80 % de précision au niveau des champs si les caractères mal lus touchent des points de données critiques. Mesurez toujours la précision au niveau des champs — le pourcentage de champs qui ont atterri dans la bonne colonne avec la bonne valeur. Pour une analyse approfondie de ce que signifient les chiffres de précision à l'échelle du traitement, consultez le guide pratique sur la précision de l'extraction IA.
L'OCR traditionnel a-t-il encore un avenir ?
Oui, dans trois rôles. Premièrement, comme couche de reconnaissance de texte au sein des pipelines d'extraction IA — de nombreux systèmes basés sur les VLM utilisent encore l'OCR comme étape de prétraitement pour les documents riches en texte. Deuxièmement, pour le traitement à grand volume de documents standardisés où les coûts de modèles s'amortissent efficacement. Troisièmement, pour les projets de numérisation d'archives où l'objectif est la recherche en texte intégral plutôt que l'extraction de données structurées. L'OCR traditionnel n'est pas obsolète — son rôle se réduit aux cas d'usage spécifiques où ses hypothèses architecturales (mises en page fixes, texte propre, sortie au niveau des caractères) correspondent aux caractéristiques réelles des documents.
Par où commencer
L'écart entre l'OCR traditionnel et l'extraction IA ne se réduit pas. Les modèles vision-langage continuent de s'améliorer sur les documents complexes — la précision d'écriture manuscrite de 95 % de GPT-5 en 2026, contre 85 % pour GPT-4 en 2025 — tandis que les moteurs d'OCR traditionnels affinent la même approche de correspondance de caractères depuis des décennies. L'écart de précision est désormais un écart de coût, et il se manifeste dans chaque file d'attente de vérification manuelle, chaque reconstruction de modèle, chaque problème de rapprochement attribué à des données silencieusement mal orientées.
Il existe un moyen simple de déterminer de quel côté du point de bascule se trouvent vos documents. Téléversez une facture — de préférence une qui a posé problème à votre processus actuel — dans un outil d'extraction IA sans modèle. Saisissez les noms des champs dont vous avez besoin et observez où les valeurs atterrissent. Pour en savoir plus sur la différence entre l'extraction IA et l'OCR au niveau des données plutôt qu'au niveau des caractères, l'explication sur la saisie de données IA par rapport à l'OCR détaille la différence de sortie avec des exemples concrets. Le coût de ce test est de quelques minutes. Le coût de ne pas savoir où se situe réellement votre précision s'accroît chaque mois.