Guia de Solução de Problemas de Extração de Documentos:
Combine seu Sintoma com a Solução Certa
Sua extração de documentos funcionou ontem. Hoje, metade dos arquivos está ausente, os números estão errados e a caligrafia voltou como ilegível. Antes de culpar a ferramenta, que é o que todo mundo faz primeiro, aqui está uma estrutura de diagnóstico que combina seu sintoma com a solução certa em menos de dois minutos.
Principais Conclusões
- Sua ferramenta de extração provavelmente não está quebrada. O que parece um defeito de software geralmente é um de onze modos de falha específicos e diagnosticáveis, desde tipos de PDF incompatíveis até erros de mapeamento de campos, e cada um tem uma solução documentada em vez de um ticket de desenvolvimento.
- O sintoma que você vê indica qual estágio do pipeline falhou. Células em branco significam Estágio 3 (estrutura de saída). Texto ilegível significa Estágio 2 (processamento). Arquivos ausentes significam Estágio 1 (upload). Saber o estágio reduz o leque de soluções e elimina suposições.
- A extração baseada em modelo tem um teto de falha embutido que nenhum ajuste pode elevar. Se sua ferramenta precisa de modelos por fornecedor e você recebe documentos em mais de três layouts diferentes, a arquitetura em si é o gargalo, não sua configuração. A extração sem modelo elimina toda essa classe de falhas por design.
Mapa de Sintomas para Artigos: O Que Você Vê, Para Onde Ir
Problemas de extração de documentos raramente se anunciam com códigos de erro claros. O que você recebe é um sintoma, seja números errados, linhas ausentes ou arquivos que desaparecem, e você precisa fazer engenharia reversa da causa. A tabela abaixo mapeia os onze sintomas de extração mais comuns para sua causa provável e um artigo dedicado que explica a solução passo a passo.
Encontre o que corresponde à sua situação, clique e pule as dicas genéricas que não se aplicam ao seu problema.
| Se você observa este sintoma... | Causa provável | Consulte este guía |
|---|---|---|
| "A escrita à mano voltou como caracteres aleatórios ou em branco" | Resolução da imagem muito baixa para o estilo de escrita, ou letra cursiva/manuscrita que excede o que o modelo consegue segmentar | A escrita à mano não é lida? Causas e soluções |
| "Os números estão errados: totais alterados, datas invertidas" | Ambiguidade na nomeação de campos (dois campos de data, vários valores em dólares), ou o modelo de extração mapeou valores à coluna incorreta | Números extraídos errados? Erros de design de campos |
| "A tabela voltou com células vazias e colunas desalinhadas" | Células mescladas, linhas divididas ou bordas de tabela irregulares confundieron o algoritmo de detección de grade | Corrigir extração de tabelas: células mescladas e alineación |
| "Metade dos meus arquivos do lote não apareceram nos resultados" | Falha de upload, interrupção do pipeline de processamento ou filtro na etapa de mesclagem que eliminó arquivos silenciosamente | Extração em lote perdeu arquivos: modos de falha |
| "A precisão cae notoriamente em documentos não ingleses" | A densidade de scripts e as diferenças de conjuntos de caracteres (CJK, árabe, latino acentuado) sobrecargan o motor OCR além de sua distribuição de treinamento | Queda de precisão na extração multilíngue |
| "Mesmo estilo de escrita à mano, precisão diferente entre arquivos" | O reconhecimento de escrita à mano tem níveis de variância inerentes: cursiva leve em papel de alto contraste funciona, enquanto caneta esferográfica pesada em papel jornal não | Modos de falha na extração de escrita à mano |
| "Dois PDFs de aspecto idéntico producen resultados diferentes" | Um é um PDF digital com texto embebido; o outro é um PDF escaneado só com imagem. A ferramenta os processa por pipelines completamente diferentes | Extracción de texto PDF vs. só imagem |
| "Como sei se os resultados que obtive são realmente corretos?" | Não há um fluxo de verificação implementado; falta um método consistente para verificar a qualidade da extração antes de usar os dados | Verificar resultados de extração: guía de verificação pontual |
| "Faltan decimais, vírgulas e símbolos de moeda" | Símbolos sub-pixel (puntos, vírgulas, marcas de centavos) caen abaixo do tamaño mínimo de recurso que o OCR considera significativo | Extracción sem símbolos decimais e de moeda |
| "O OCR falha completamente em fundos coloridos ou degradados" | Contraste texto-fundo reduzido e interferência de marcas de água confundem a detección de bordes de caracteres, especialmente em zonas de baixo contraste | OCR falha em fundos coloridos e marcas de água |
| "Algo completamente diferente, e não corresponde a nenhuno destos" | Causa desconocida ou compuesta; o problema pode abarcar múltiples causas raíz ou derivar de um caso límite não coberto acima | Puede a IA ler documentos borrosos? (verificação de capacidade) |
Como usar esta tabela: Examine a columna de sintomas para encontrar a que corresponde ao que você está vendo. Se nenhuna se ajusta perfeitamente, escolha a más próxima e comece por aí, e o artigo ajudará a reduzir as opções. Se dois sintomas se aplican, comece pelo que bloquea más seu fluxo de trabalho.
Fluxograma de Diagnóstico: Rastreie o Ponto de Falha
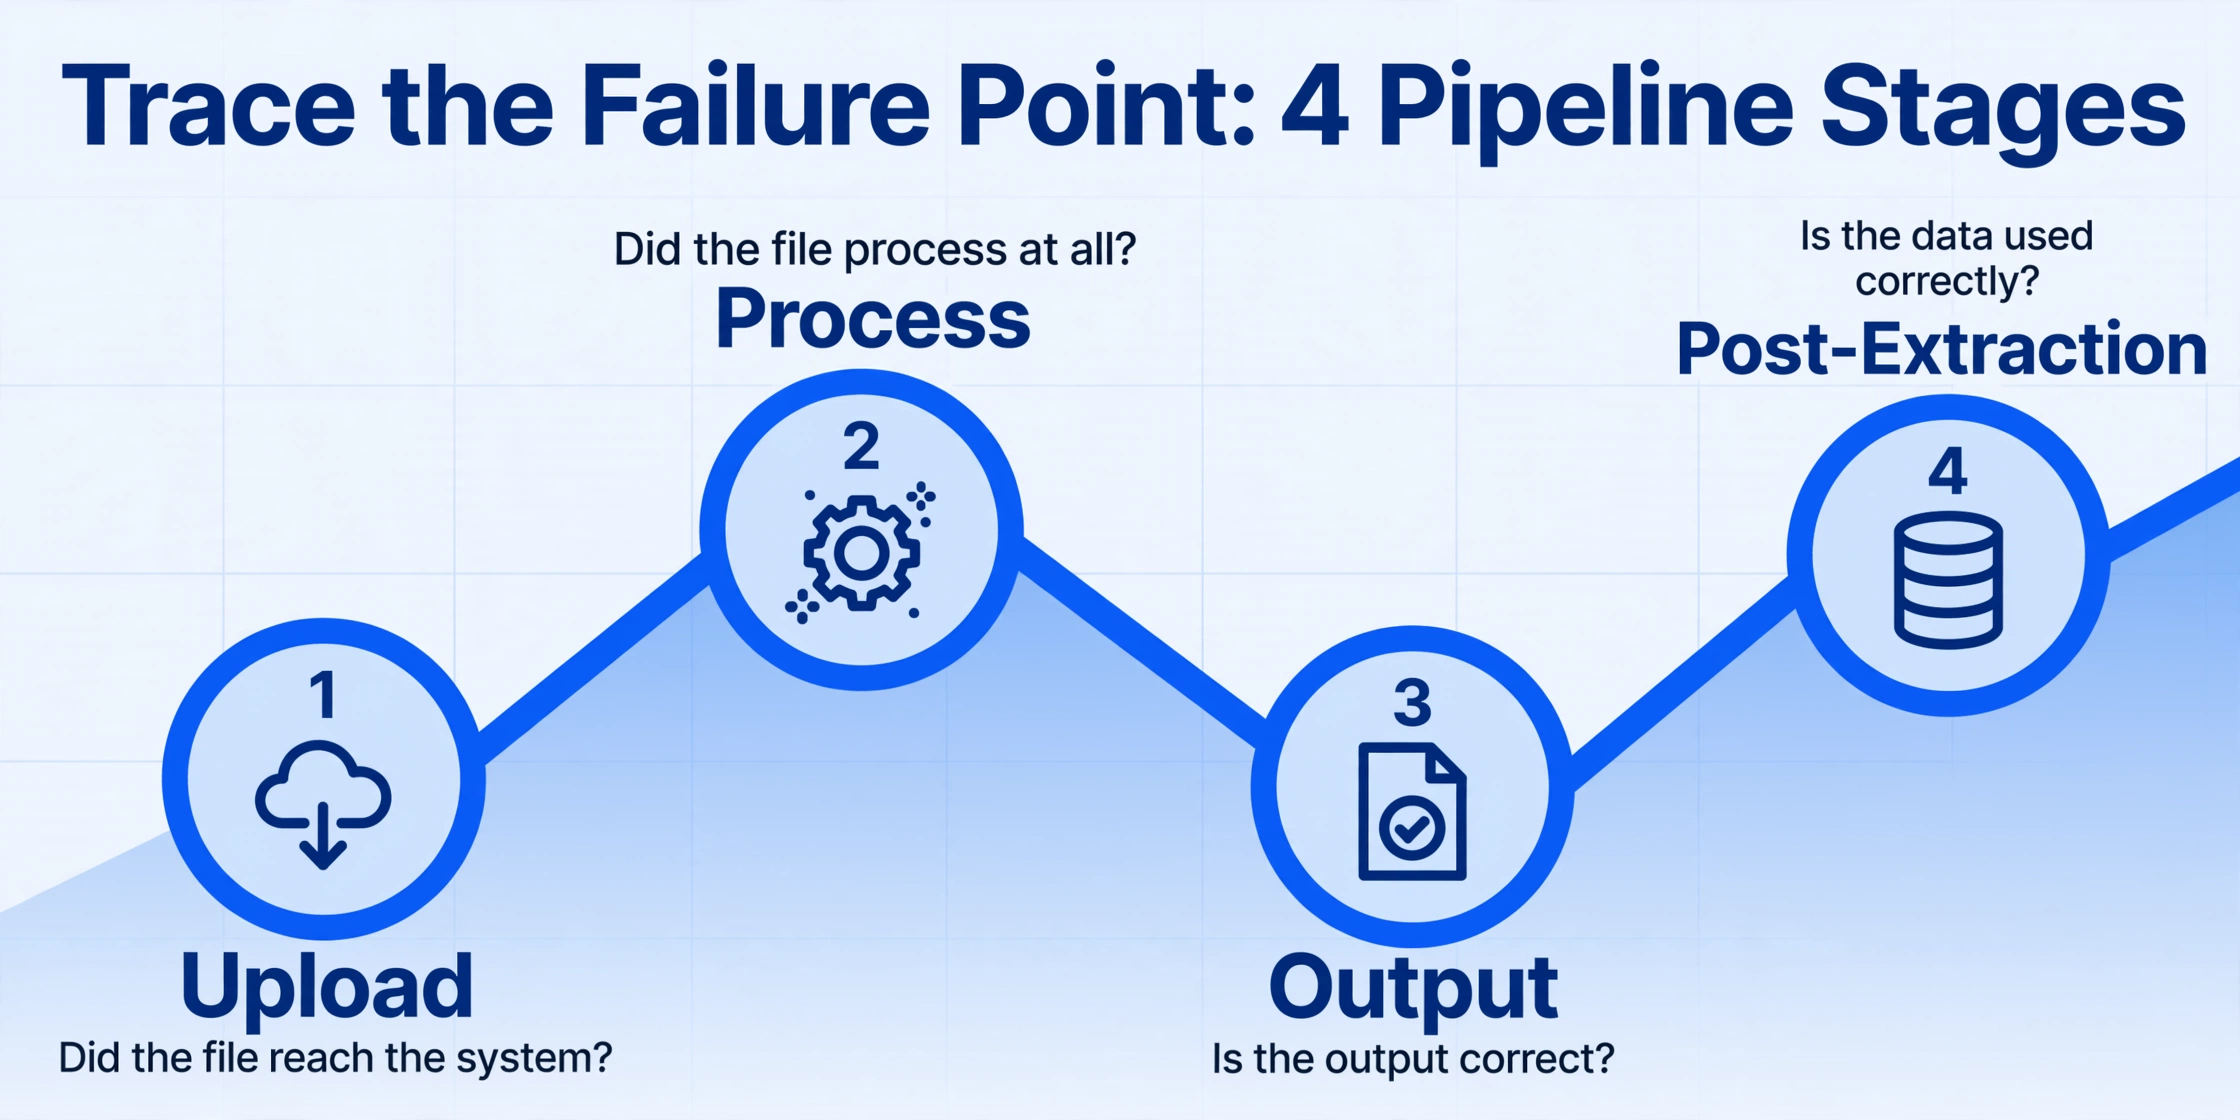
Se a tabela acima mostra o destino, este fluxograma mostra o caminho. É uma árvore de decisão baseada em texto projetada para fazer uma coisa: dizer onde no pipeline seu problema está antes de você tentar corrigi-lo. O pipeline de extração tem quatro estágios (upload, processamento, saída e pós-extração), e cada estágio tem seu próprio perfil de falha. Encontre o seu.
Estágio 1: O arquivo chegou ao sistema?
Comece aqui. Se o arquivo não foi enviado, nada mais importa.
- O arquivo não apareceu na lista de upload? → Tempo limite do navegador, limite de tamanho de arquivo excedido ou formato não suportado. Verifique sua fila de upload para erros. Se você está processando em lotes, consulte o artigo sobre arquivos ausentes.
- O arquivo apareceu, mas mostra status "erro" ou "falhou"? → O sistema recebeu o arquivo, mas não conseguiu decodificá-lo. Isso é um documento corrompido ou um formato de imagem que o pipeline não consegue ler. PDFs protegidos por senha são suportados, então um arquivo bloqueado não é automaticamente uma causa perdida; se um continuar falhando neste estágio apesar de estar intacto, reexporte-o e tente novamente.
- O arquivo apareceu e mostra "pendente", mas nunca processa? → Congestionamento da fila ou limite de processamento atingido. Se você está em um plano de upload simultâneo, aguarde os trabalhos ativos terminarem ou verifique os limites do seu plano.
Estágio 2: O arquivo processou de fato?
Arquivo enviado e mostra "concluído", mas a saída está errada. Agora você está na zona de qualidade de extração.
- Resultados retornados, mas completamente vazios? → O documento pode ser apenas imagem em um formato que o modelo não suporta totalmente (certos PDFs de múltiplas camadas ou codificação de imagem incomum). Tente converter para PNG ou JPG primeiro.
- Resultados retornados, mas o texto está ilegível? → Esta é a falha clássica de OCR. O mecanismo leu os caracteres, mas não conseguiu montá-los em texto significativo. Vá para a tabela de sintomas e verifique artigos sobre caligrafia, contraste ou idioma.
- Resultados retornados, mas os dados estão mapeados para as colunas erradas? → Este não é um problema de OCR; é um problema de design de campo. Os dados foram extraídos corretamente, mas atribuídos ao campo de saída errado. Veja o artigo sobre design de campo.
Etapa 3: A estrutura da saída está intacta?
O processamento foi concluído sem erros, mas os dados não são utilizáveis na forma atual.
- As tabelas têm células vazias ou linhas deslocadas? → O mecanismo de extração detectou a estrutura da tabela incorretamente. Células mescladas, bordas irregulares e cabeçalhos de coluna ausentes são as três principais causas. Consulte o guia de correção de células mescladas.
- Faltam pontos decimais, vírgulas ou símbolos de moeda? → Pequenos sinais de pontuação estão sendo filtrados como ruído de imagem. O mecanismo de extração precisa de uma entrada de maior contraste, ou os símbolos estão abaixo do limite de detecção. Consulte o artigo sobre símbolos ausentes.
- Fundos coloridos ou com gradiente tornam o texto ilegível? → O baixo contraste entre texto e fundo quebra a detecção de bordas. Isso é especialmente comum em documentos com marca d'água e formulários coloridos digitalizados. Consulte o guia de fundos coloridos.
Etapa 4: O resultado é consistente entre os arquivos?
A extração de um único arquivo parece correta. Os resultados em lote revelam o problema.
- PDFs aparentemente idênticos dão resultados diferentes? → Verifique se um é um PDF digital (com camada de texto) e o outro é digitalizado (somente imagem). Eles passam por pipelines diferentes. Consulte o artigo de comparação de PDFs.
- Alguns arquivos do lote foram processados corretamente, outros falharam silenciosamente? → Falhas no pipeline em lote raramente são aleatórias. Os arquivos com falha compartilham uma característica: formato específico, número de páginas ou qualidade de imagem. Consulte o artigo sobre falhas em lote.
- A mesma caligrafia é lida com precisão em um arquivo e mal em outro? → O reconhecimento de caligrafia tem desempenho variável dependendo da pressão da caneta, textura do papel e instrumento de escrita. Consulte modos de falha de caligrafia.
- Os números parecem plausíveis, mas você não pode ter certeza de que estão corretos? → Valores incorretos sobrevivem a todas as etapas acima se ninguém os verificar novamente. Isso é um problema de verificação, não de reconhecimento. Uma camada de revisão com destaque da localização da fonte resolve isso: clique em qualquer célula extraída e sua origem é destacada no documento original, fazendo com que um número errado apareça em segundos, em vez de após uma releitura completa. Ative o Auto-annotate após o processamento e os destaques já estarão esperando quando você abrir os resultados. Consulte o guia de verificação.
Quando Todas as Correções Falham: A Arquitetura da Ferramenta Pode Ser o Limite
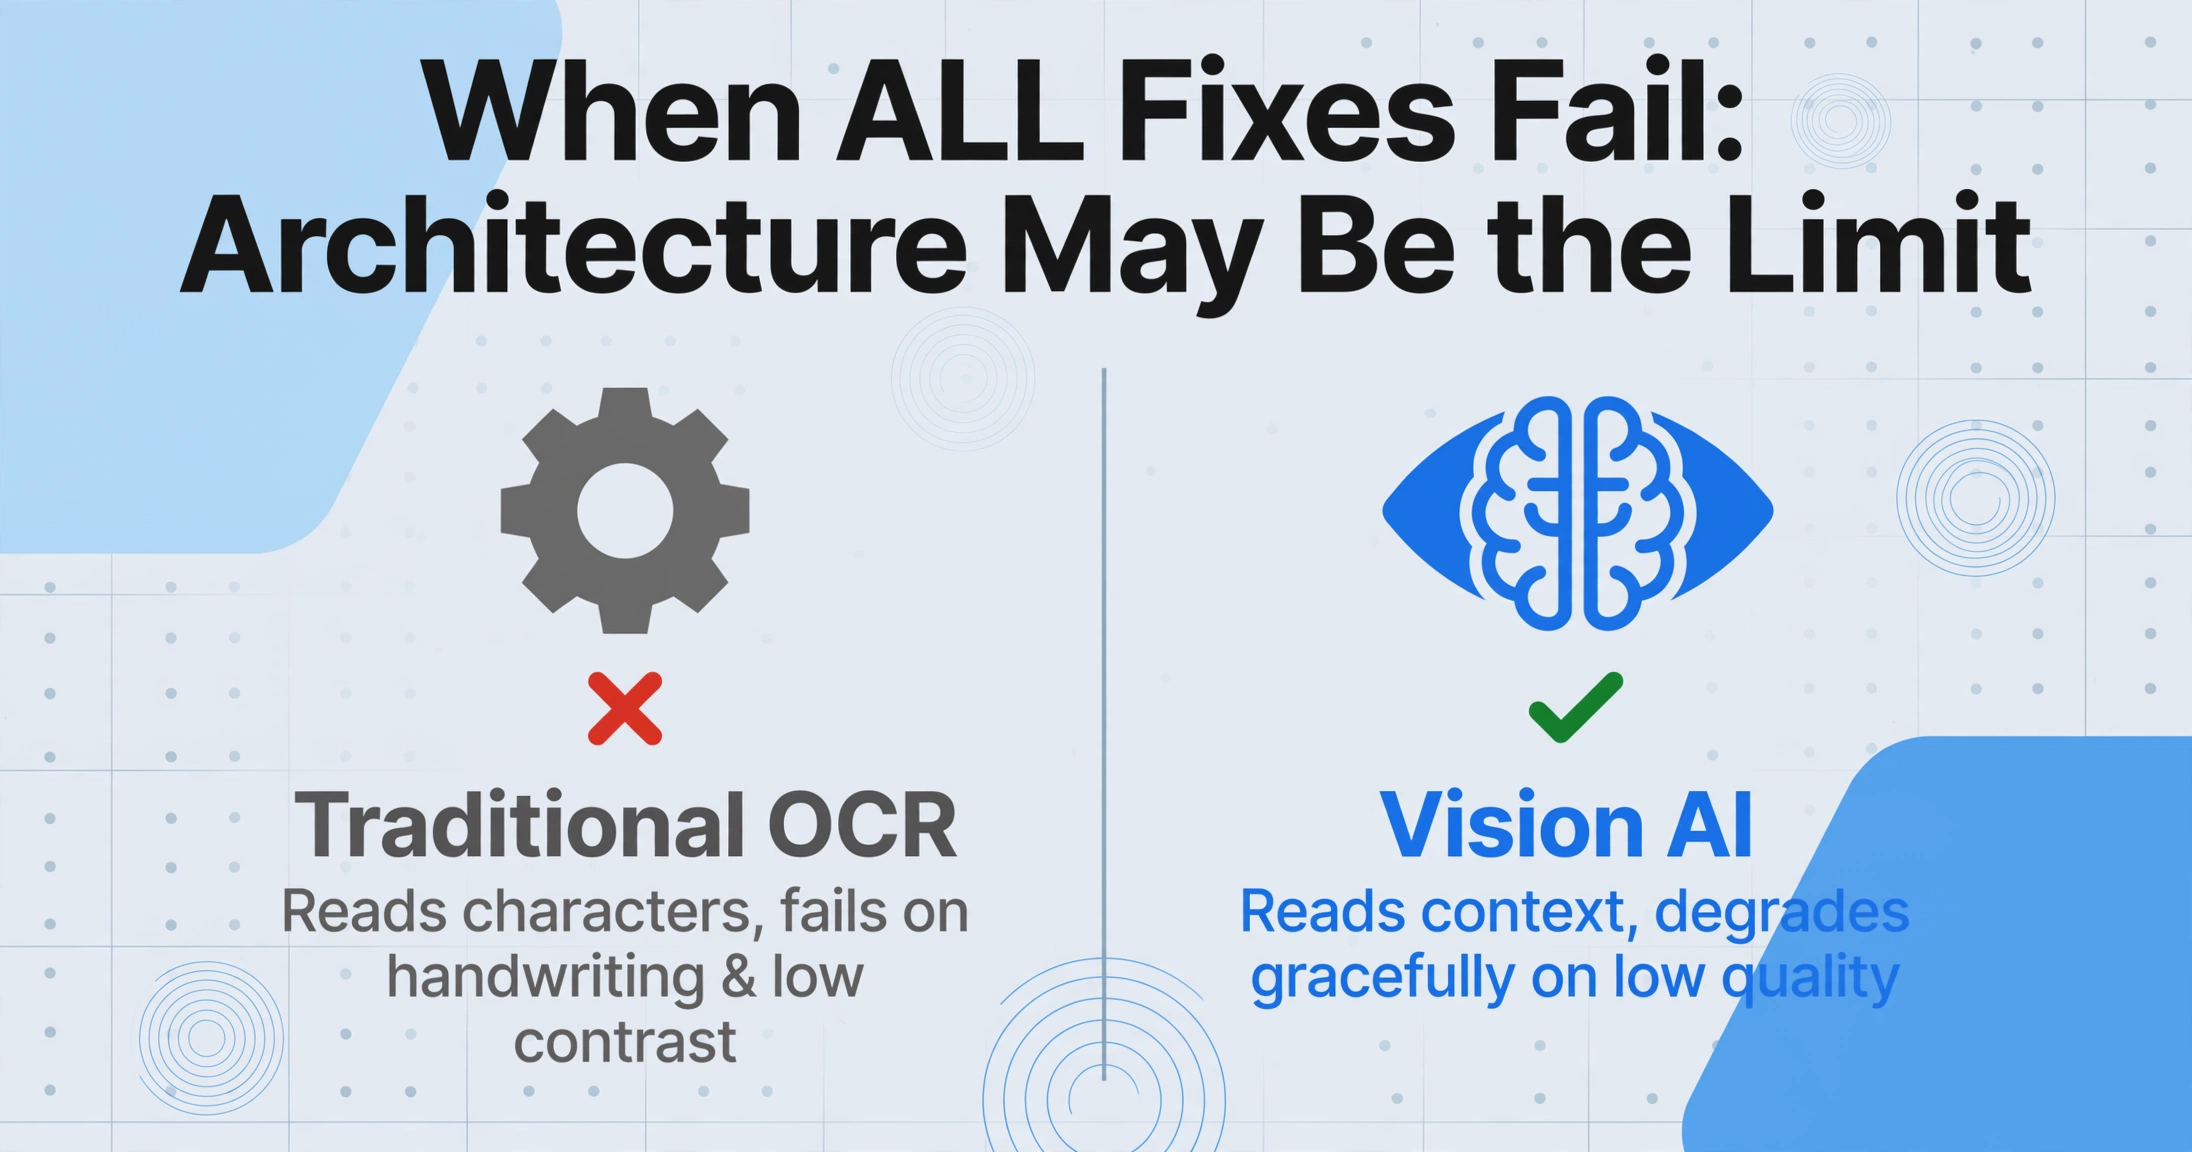
Se você passou pelo artigo relevante, aplicou a correção recomendada e o problema persiste, é hora de considerar que a questão não é como você está usando a ferramenta, mas o que a ferramenta é fundamentalmente. Diferentes arquiteturas de extração têm diferentes tetos de falha.
Ferramentas tradicionais baseadas em OCR, incluindo Tesseract, APIs de OCR em nuvem e extratores baseados em modelo, compartilham uma limitação comum: elas leem caracteres sem entender o contexto do documento. Essa arquitetura falha de forma previsível em manuscritos, layouts de baixo contraste, texto riscado e documentos com formatação complexa. Quando o problema é a arquitetura, nenhuma quantidade de pré-processamento ou ajuste de parâmetros fechará a lacuna. Você precisa de uma abordagem diferente.
Os modelos de Vision AI, que é a abordagem usada pelo ImageToTable.ai, processam documentos de forma diferente. Eles não dependem de segmentação de caracteres e correspondência de modelos. Em vez disso, interpretam o documento de forma holística: lendo contexto, layout e relações entre campos da mesma forma que um leitor humano faria. Isso significa que eles degradam graciosamente em entradas de baixa qualidade (a precisão cai gradualmente em vez de colapsar) e lidam com variação de formato sem manutenção de modelo.
Se sua ferramenta de extração depende de modelos fixos, exige configuração por fornecedor ou usa OCR zonal (extraindo dados de retângulos predefinidos na página), e você está atingindo um teto, considere testar uma ferramenta baseada em Vision AI em seus documentos reais para ver se a mudança de arquitetura resolve suas falhas recorrentes.
Verificação rápida da realidade: Se sua ferramenta exige modelos ou treinamento para cada formato de documento, e seus documentos vêm em mais de três layouts diferentes, o gargalo é a arquitetura da ferramenta, não sua configuração. A extração sem modelo elimina toda essa classe de falhas por design.
Perguntas Frequentes
Por que minha ferramenta de extração lê texto claro incorretamente?
Claro para o olho humano e claro para um mecanismo de OCR são padrões diferentes. Um documento que parece perfeitamente legível para você pode ter características sutis que degradam a segmentação de caracteres, como contraste ligeiramente baixo, pequenos artefatos de compressão ou fontes com espaçamento apertado entre letras. Ferramentas modernas de IA de visão lidam melhor com esses casos porque entendem o contexto em vez de depender apenas da forma dos caracteres, mas nenhuma ferramenta tem precisão perfeita em todos os documentos.
O pré-processamento de documentos pode resolver a maioria dos problemas de extração?
O pré-processamento (correção de inclinação, ajuste de contraste, aumento de DPI) resolve um subconjunto significativo de falhas relacionadas à qualidade da imagem, aproximadamente aquelas decorrentes de uma captura deficiente da fonte. Ele não resolve problemas causados por limites de arquitetura da ferramenta, erros de design de campos ou estilos de caligrafia que o modelo não consegue interpretar. Uma boa regra prática: se o pré-processamento não resolver o problema em duas tentativas, a causa raiz provavelmente está em outro lugar, e você deve passar para a tabela de diagnóstico acima.
Por que obtenho resultados diferentes ao executar o mesmo documento duas vezes?
A maioria das ferramentas de extração é determinística: a mesma entrada produz a mesma saída. Se você observar variação, três causas são possíveis. Primeiro, o arquivo pode ter sido recompactado ou re-salvo entre execuções, alterando a entrada no nível de pixel. Segundo, alguns modelos de IA incorporam amostragem probabilística que pode produzir pequena variação na saída em campos ambíguos. Terceiro, o processamento em lote pode introduzir condições de concorrência em que os arquivos são processados em ordem diferente, expondo estados de fila distintos. Execute exatamente o mesmo arquivo três vezes. Se duas de três coincidirem, a variação está dentro da tolerância esperada.
Minha ferramenta de extração funciona bem em faturas, mas falha em recibos. Por quê?
Faturas são normalmente documentos estruturados, com posições de campo consistentes e alta qualidade de impressão. Recibos são frequentemente impressões térmicas de baixa resolução, dobradas, amassadas ou desbotadas — o pior cenário para qualquer sistema de extração. Além disso, os formatos de recibo variam enormemente entre comerciantes, tornando abordagens baseadas em modelo particularmente frágeis. Se sua ferramenta exige modelos, a lacuna com recibos é previsível. Ferramentas sem modelo lidam melhor com recibos, mas ainda enfrentam limites de precisão em papel térmico extremamente desbotado.
Quanto tempo devo gastar solucionando problemas antes de mudar de abordagem?
Um orçamento razoável de solução de problemas: 15 a 30 minutos por problema recorrente. Se você não conseguir resolver um modo de falha específico dentro desse prazo usando as correções recomendadas, o problema provavelmente é arquitetural, e não de configuração. O custo de continuar tentando solucionar (tempo gasto, fluxos de trabalho atrasados, reinserção de dados) rapidamente excede o custo de testar uma abordagem de extração diferente em uma amostra dos seus documentos reais.
A precisão da extração varia conforme o idioma do documento?
Sim, de forma mensurável. Os mecanismos de OCR são treinados predominantemente em documentos em inglês com escrita latina. O desempenho em documentos em outros idiomas é menor logo de início, especialmente para escritas CJK (chinês, japonês, coreano) com alta densidade de caracteres, escritas árabes com formas de letras conectadas e escritas latinas acentuadas. Os modelos de IA de visão reduzem essa diferença porque leem caracteres em contexto, em vez de corresponder a formas de glifos isoladas, mas a diferença não desaparece completamente. Consulte o artigo sobre extração em vários idiomas para obter benchmarks específicos e estratégias de mitigação.
Existe uma forma de validar a precisão da extração sem verificar manualmente cada arquivo?
Sim. A verificação estatística por amostragem — verificando uma amostra aleatória de 5 a 10% de cada lote em relação aos documentos originais — detecta erros sistemáticos com alta confiança. Além disso, regras de validação em nível de campo (por exemplo, "os valores das faturas devem ser números positivos" ou "as datas devem estar no ano fiscal atual") podem sinalizar automaticamente valores atípicos para revisão humana. Para valores individuais suspeitos, o destaque da origem no modo de revisão é a verificação mais rápida: clique em qualquer célula extraída e sua origem será destacada no documento original, permitindo que você confirme ou rejeite em segundos. O guia de verificação de extração fornece um fluxo de trabalho completo para criar uma rotina de amostragem que acompanha seu volume.
Ainda não sabe o que está causando seu problema de extração? Envie um documento de exemplo e veja como uma ferramenta de extração de IA sem modelo lida com ele, sem necessidade de cadastro.
Diagnosticar seu Problema de ExtraçãoOs arquivos são processados com segurança e não são armazenados.