Guía de Solución de Problemas de Extracción de Documentos:
Relacione su Síntoma con la Solución Correcta
Su extracción de documentos funcionaba ayer. Hoy, la mitad de los archivos faltan, los números están incorrectos y la caligrafía se convirtió en texto ilegible. Antes de culpar a la herramienta, que es lo que todos hacen primero, aquí tiene un marco de diagnóstico que relaciona su síntoma con la solución correcta en menos de dos minutos.
Conclusiones Clave
- Su herramienta de extracción probablemente no está averiada. Lo que parece un defecto de software suele ser uno de once modos de fallo específicos y diagnosticables, desde tipos de PDF incompatibles hasta errores de mapeo de campos, y cada uno tiene una solución documentada en lugar de un ticket de desarrollo.
- El síntoma que ve le indica qué etapa del proceso falló. Las celdas en blanco significan Etapa 3 (estructura de salida). El texto ilegible significa Etapa 2 (procesamiento). Los archivos faltantes significan Etapa 1 (carga). Conocer la etapa reduce las opciones de solución y elimina las conjeturas.
- La extracción basada en plantillas tiene un límite de fallo incorporado que ningún ajuste puede superar. Si su herramienta necesita plantillas por proveedor y usted recibe documentos en más de tres diseños diferentes, la arquitectura en sí es el cuello de botella, no su configuración. La extracción sin plantilla elimina toda esa clase de fallos por diseño.
Mapa de Síntomas a Artículos: Lo Que Ve, A Dónde Ir
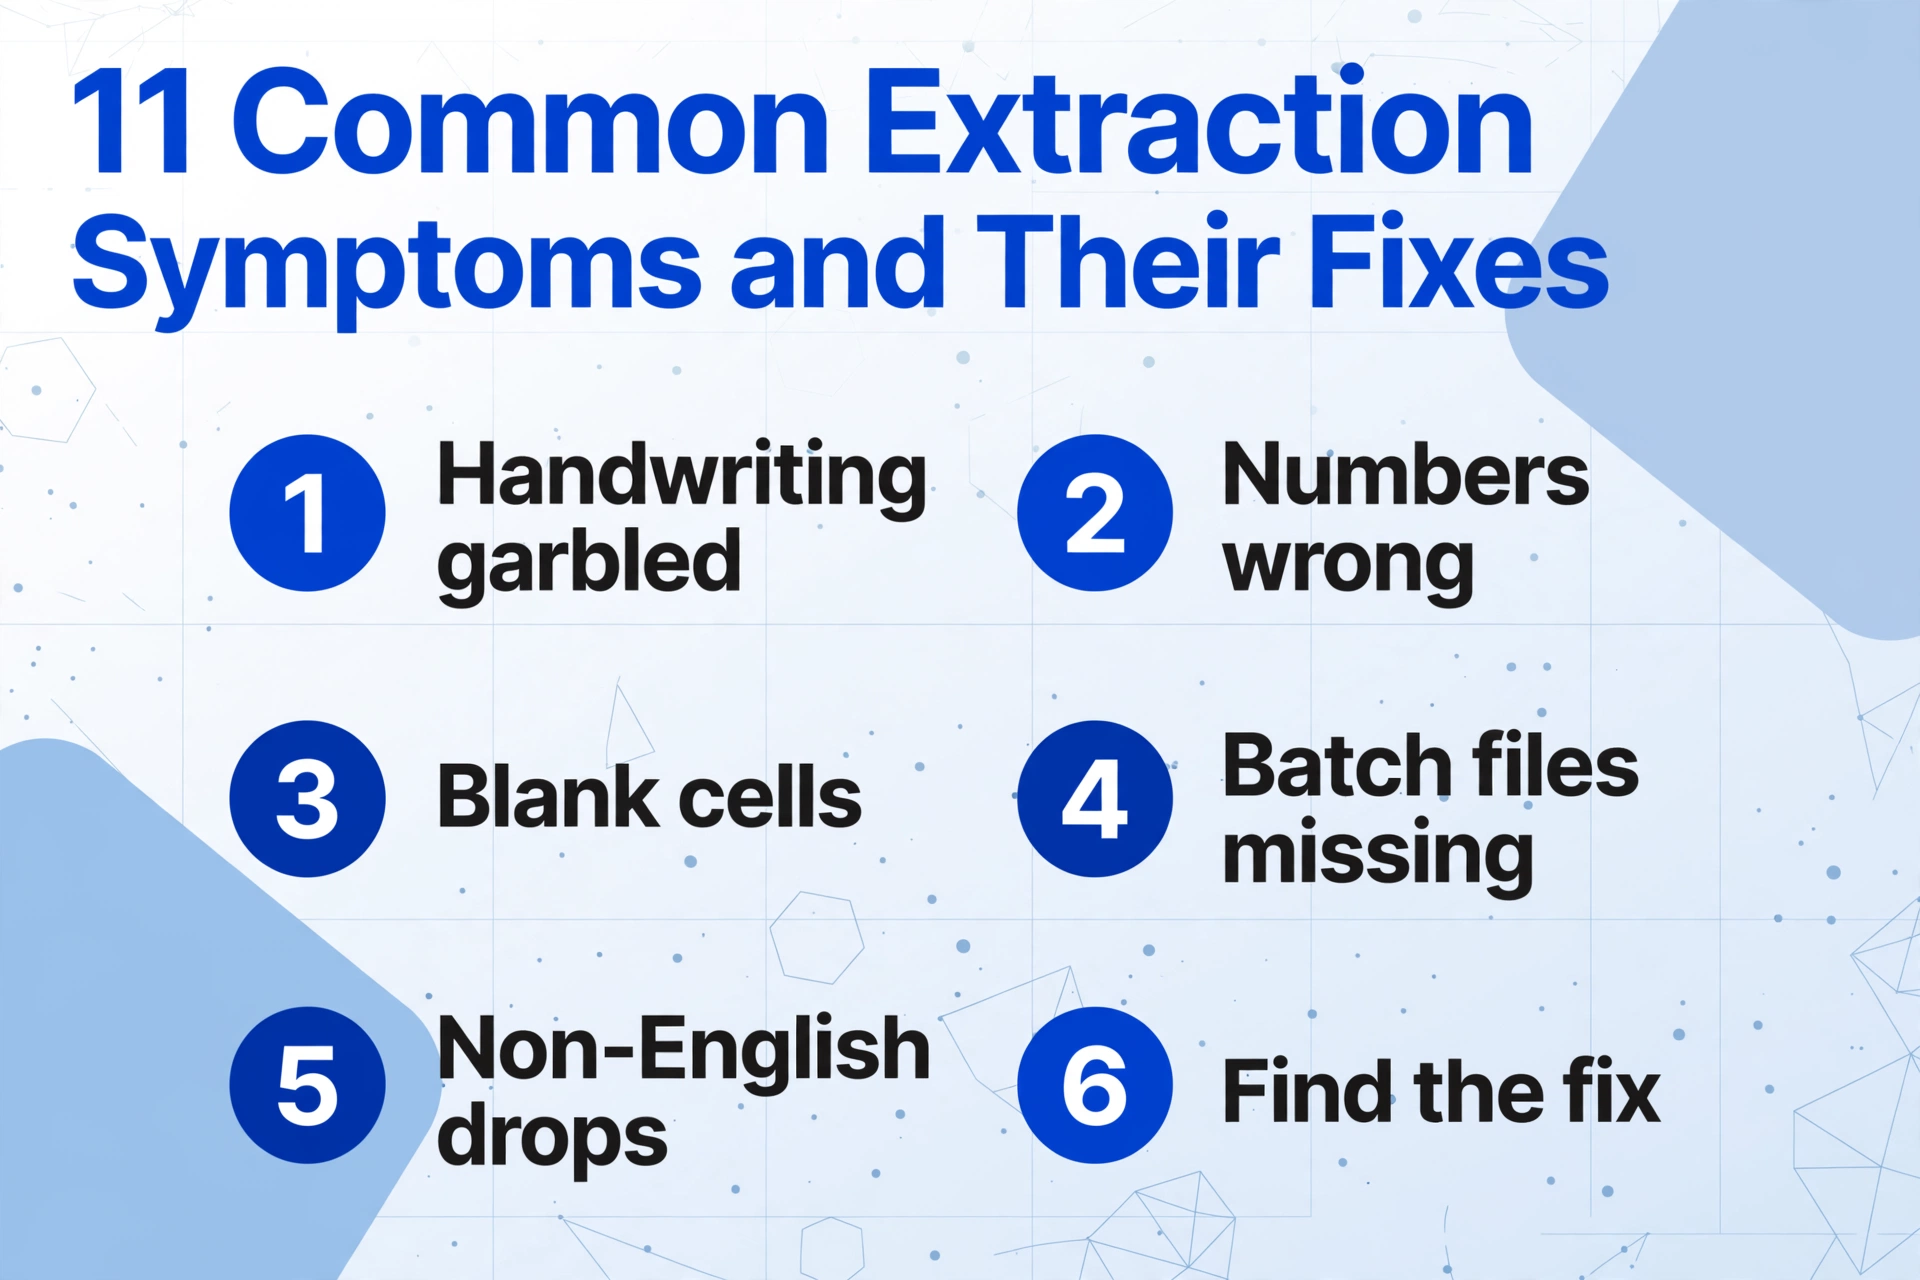
Los problemas de extracción de documentos rara vez se anuncian con códigos de error claros. Lo que obtiene es un síntoma, ya sean números incorrectos, filas faltantes o archivos que desaparecen, y tiene que aplicar ingeniería inversa a la causa. La tabla a continuación asigna los once síntomas de extracción más comunes a su causa raíz probable y a un artículo dedicado que explica la solución paso a paso.
Encuentre lo que coincide con su situación, haga clic y omita los consejos generales que no se aplican a su problema.
| Si ve este síntoma... | Causa probable | Consulte esta guía |
|---|---|---|
| "La escritura a mano se convirtió en caracteres aleatorios o en blanco" | La resolución de la imagen es demasiado baja para el estilo de escritura, o la letra cursiva supera lo que el modelo puede segmentar | ¿La escritura a mano no se lee? Causas y soluciones |
| "Los números están mal: totales desplazados, fechas invertidas" | Ambigüedad en el nombre de los campos (dos campos de fecha, múltiples montos en dólares), o el modelo de extracción asignó valores a la columna incorrecta | ¿Números extraídos incorrectos? Errores de diseño de campos |
| "La tabla devolvió celdas vacías y columnas desalineadas" | Celdas combinadas, filas divididas o bordes de tabla irregulares rompieron el algoritmo de detección de cuadrícula | Corregir extracción de tablas: celdas combinadas y alineación |
| "La mitad de mis archivos del lote no aparecieron en los resultados" | Fallo en la carga, pérdida en el pipeline de procesamiento o filtrado en la etapa de fusión que eliminó archivos silenciosamente | Extracción por lotes con archivos faltantes: modos de fallo |
| "La precisión baja notablemente en documentos que no están en inglés" | La densidad de escritura y las diferencias en el conjunto de caracteres (CJK, árabe, latín con acentos) someten al motor OCR a un esfuerzo más allá de su distribución de entrenamiento | Caídas de precisión en extracción multilingüe |
| "Mismo estilo de escritura a mano, diferente precisión entre archivos" | El reconocimiento de escritura a mano tiene niveles de variación inherentes: la cursiva ligera en papel de alto contraste funciona, mientras que la bolígrafo grueso en papel prensa no | Modos de fallo en extracción de escritura a mano |
| "Dos PDF de aspecto idéntico producen resultados diferentes" | Uno es un PDF digital con texto incrustado; el otro es un PDF escaneado solo con imagen. La herramienta los procesa mediante pipelines completamente diferentes | Extracción de texto en PDF vs. solo imagen |
| "¿Cómo sé si los resultados que obtuve son realmente correctos?" | No hay un flujo de verificación establecido; carece de un método consistente para comprobar la calidad de la extracción antes de usar los datos | Verificar resultados de extracción: guía de comprobación |
| "Faltan decimales, comas y símbolos de moneda" | Los símbolos de subpíxel (puntos, comas, marcas de centavos) quedan por debajo del tamaño mínimo de característica que el OCR considera significativo | Extracción sin decimales ni símbolos de moneda |
| "El OCR falla por completo en fondos de color o degradados" | El contraste reducido entre texto y fondo y la interferencia de marcas de agua confunden la detección de bordes de caracteres, especialmente en zonas de bajo contraste | El OCR falla en fondos de color y marcas de agua |
| "Algo completamente distinto, y no coincide con ninguno de estos" | Fallo desconocido o compuesto; el problema puede abarcar múltiples causas raíz o derivarse de un caso límite no cubierto anteriormente | ¿Puede la IA leer documentos borrosos? (verificación de capacidad) |
Cómo usar esta tabla: Revise la columna de síntomas para encontrar la que coincida con lo que está viendo. Si ninguna encaja perfectamente, elija la más cercana y comience allí; el artículo le ayudará a acotar. Si dos síntomas aplican, comience con el que más bloquee su flujo de trabajo.
Diagrama de diagnóstico: localice el punto de fallo
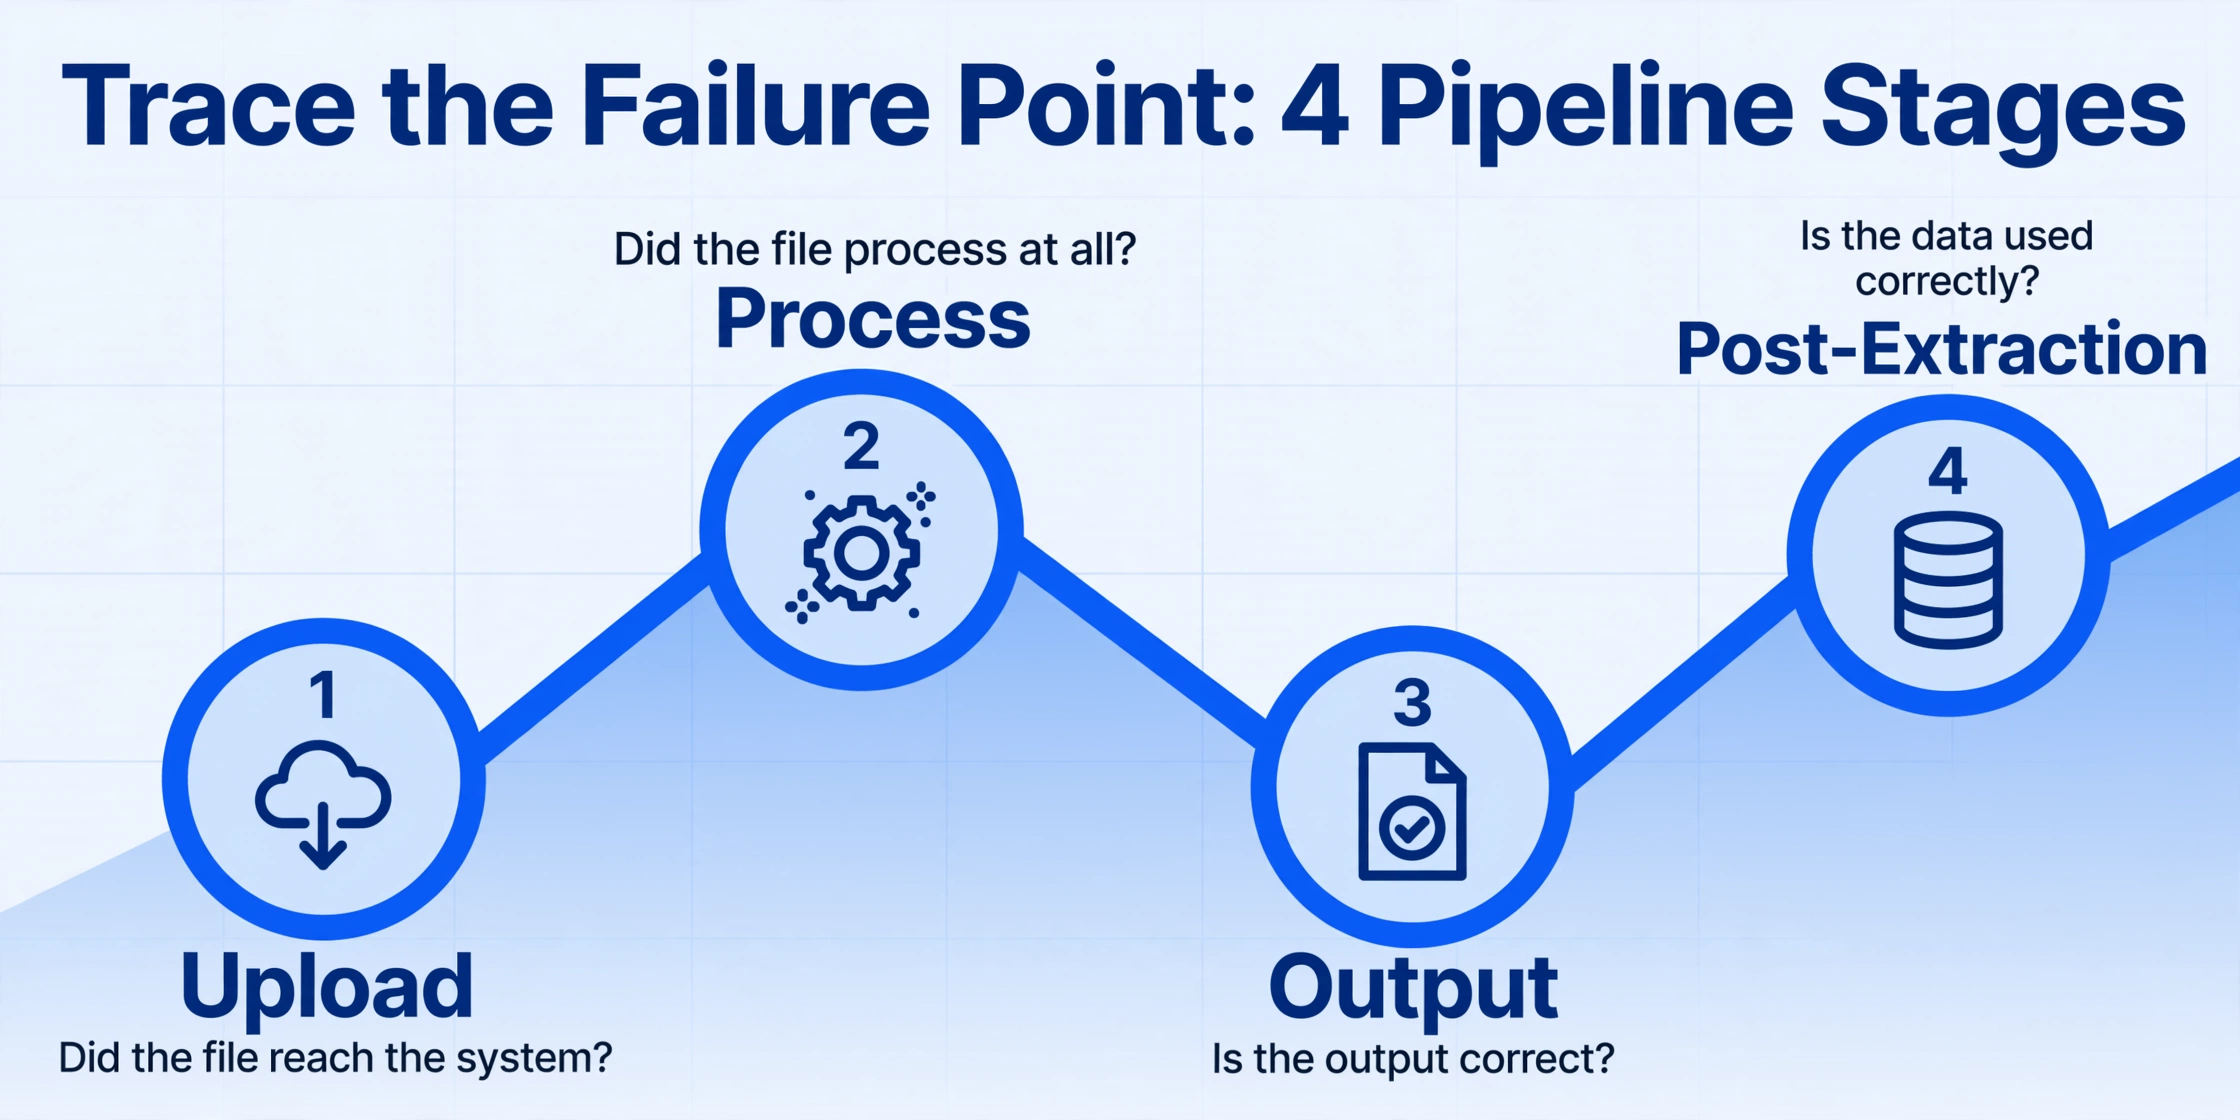
Si la tabla anterior le indica el destino, este diagrama de flujo le muestra la ruta. Es un árbol de decisión basado en texto diseñado para una sola cosa: indicarle dónde se encuentra su problema en el proceso antes de intentar solucionarlo. El proceso de extracción tiene cuatro etapas (carga, procesamiento, salida y postextracción), y cada una tiene su propio perfil de fallo. Localice el suyo.
Etapa 1: ¿Llegó el archivo al sistema?
Comience aquí. Si el archivo no se cargó, nada más importa.
- ¿El archivo no aparece en la lista de carga? → Tiempo de espera del navegador agotado, límite de tamaño de archivo superado o formato no compatible. Revise su cola de carga para ver si hay errores. Si procesa por lotes, consulte el artículo sobre archivos faltantes.
- ¿El archivo aparece pero muestra estado «error» o «fallido»? → El sistema recibió el archivo pero no pudo decodificarlo. Se trata de un documento dañado o de un formato de imagen que el proceso no puede leer. Los PDF protegidos con contraseña son compatibles, así que un archivo bloqueado no es necesariamente un caso perdido; si uno sigue fallando en esta etapa a pesar de estar intacto, vuelva a exportarlo e inténtelo de nuevo.
- ¿El archivo aparece y muestra «pendiente» pero nunca se procesa? → Congestión en la cola o límite de procesamiento alcanzado. Si tiene un plan de carga simultánea, espere a que los trabajos activos se completen o revise los límites de su plan.
Etapa 2: ¿Se procesó el archivo?
El archivo se cargó y muestra «completado», pero la salida es incorrecta. Ahora se encuentra en la zona de calidad de extracción.
- ¿Se obtuvieron resultados pero completamente vacíos? → El documento puede ser solo de imagen en un formato que el modelo no admite por completo (ciertos PDF de varias capas o codificaciones de imagen inusuales). Pruebe a convertirlo a PNG o JPG primero.
- ¿Se obtuvieron resultados pero el texto está distorsionado? → Este es el fallo clásico de OCR. El motor leyó los caracteres pero no pudo ensamblarlos en texto significativo. Consulte la tabla de síntomas y revise los artículos sobre escritura manual, contraste o idioma.
- ¿Se obtuvieron resultados pero los datos se asignaron a columnas incorrectas? → Esto no es un problema de OCR; es un problema de diseño de campos. Los datos se extrajeron correctamente pero se asignaron al campo de salida equivocado. Consulte el artículo sobre diseño de campos.
Etapa 3: ¿La estructura de salida está intacta?
El procesamiento se completó sin errores, pero los datos no son utilizables en su forma actual.
- ¿Las tablas tienen celdas vacías o filas desplazadas? → El motor de extracción detectó la estructura de la tabla incorrectamente. Las celdas combinadas, los bordes irregulares y los encabezados de columna faltantes son las tres causas principales. Consulte la guía para corregir celdas combinadas.
- ¿Faltan puntos decimales, comas o símbolos de moneda? → Los signos de puntuación pequeños se filtran como ruido de imagen. El motor de extracción necesita una entrada de mayor contraste o los símbolos están por debajo del umbral de detección. Consulte el artículo sobre símbolos faltantes.
- ¿Los fondos de color o degradados hacen que el texto sea ilegible? → El bajo contraste entre el texto y el fondo rompe la detección de bordes. Esto es particularmente común con documentos con marcas de agua y formularios de colores escaneados. Consulte la guía de fondos de colores.
Etapa 4: ¿El resultado es consistente entre archivos?
La extracción de un solo archivo se ve bien. Los resultados del lote revelan el problema.
- ¿PDFs de apariencia idéntica dan resultados diferentes? → Verifique si uno es un PDF digital (con capa de texto) y el otro es escaneado (solo imagen). Pasan por diferentes procesos. Consulte el artículo de comparación de PDFs.
- ¿Algunos archivos del lote se procesaron bien y otros fallaron silenciosamente? → Las fallas en el proceso por lotes rara vez son aleatorias. Los archivos que fallan comparten una característica: formato particular, número de páginas o calidad de imagen. Consulte el artículo sobre fallas en el lote.
- ¿La misma escritura se lee con precisión en un archivo y mal en otro? → El reconocimiento de escritura manual tiene un rendimiento variable según la presión del bolígrafo, la textura del papel y el instrumento de escritura. Consulte los modos de falla del reconocimiento de escritura.
- ¿Los números parecen plausibles, pero no puede estar seguro de que sean correctos? → Los valores incorrectos sobreviven a todas las etapas anteriores si nadie los vuelve a verificar. Esto es un problema de verificación, no de reconocimiento. Una capa de revisión con resaltado de ubicación de origen lo resuelve: haga clic en cualquier celda extraída y su origen se resalta en el documento original, de modo que un número incorrecto aparece en segundos en lugar de después de una relectura completa. Active Auto-annotate después del procesamiento y los resaltados ya estarán esperando cuando abra los resultados. Consulte la guía de verificación.
Cuando TODOS los arreglos fallan: la arquitectura de la herramienta puede ser el límite
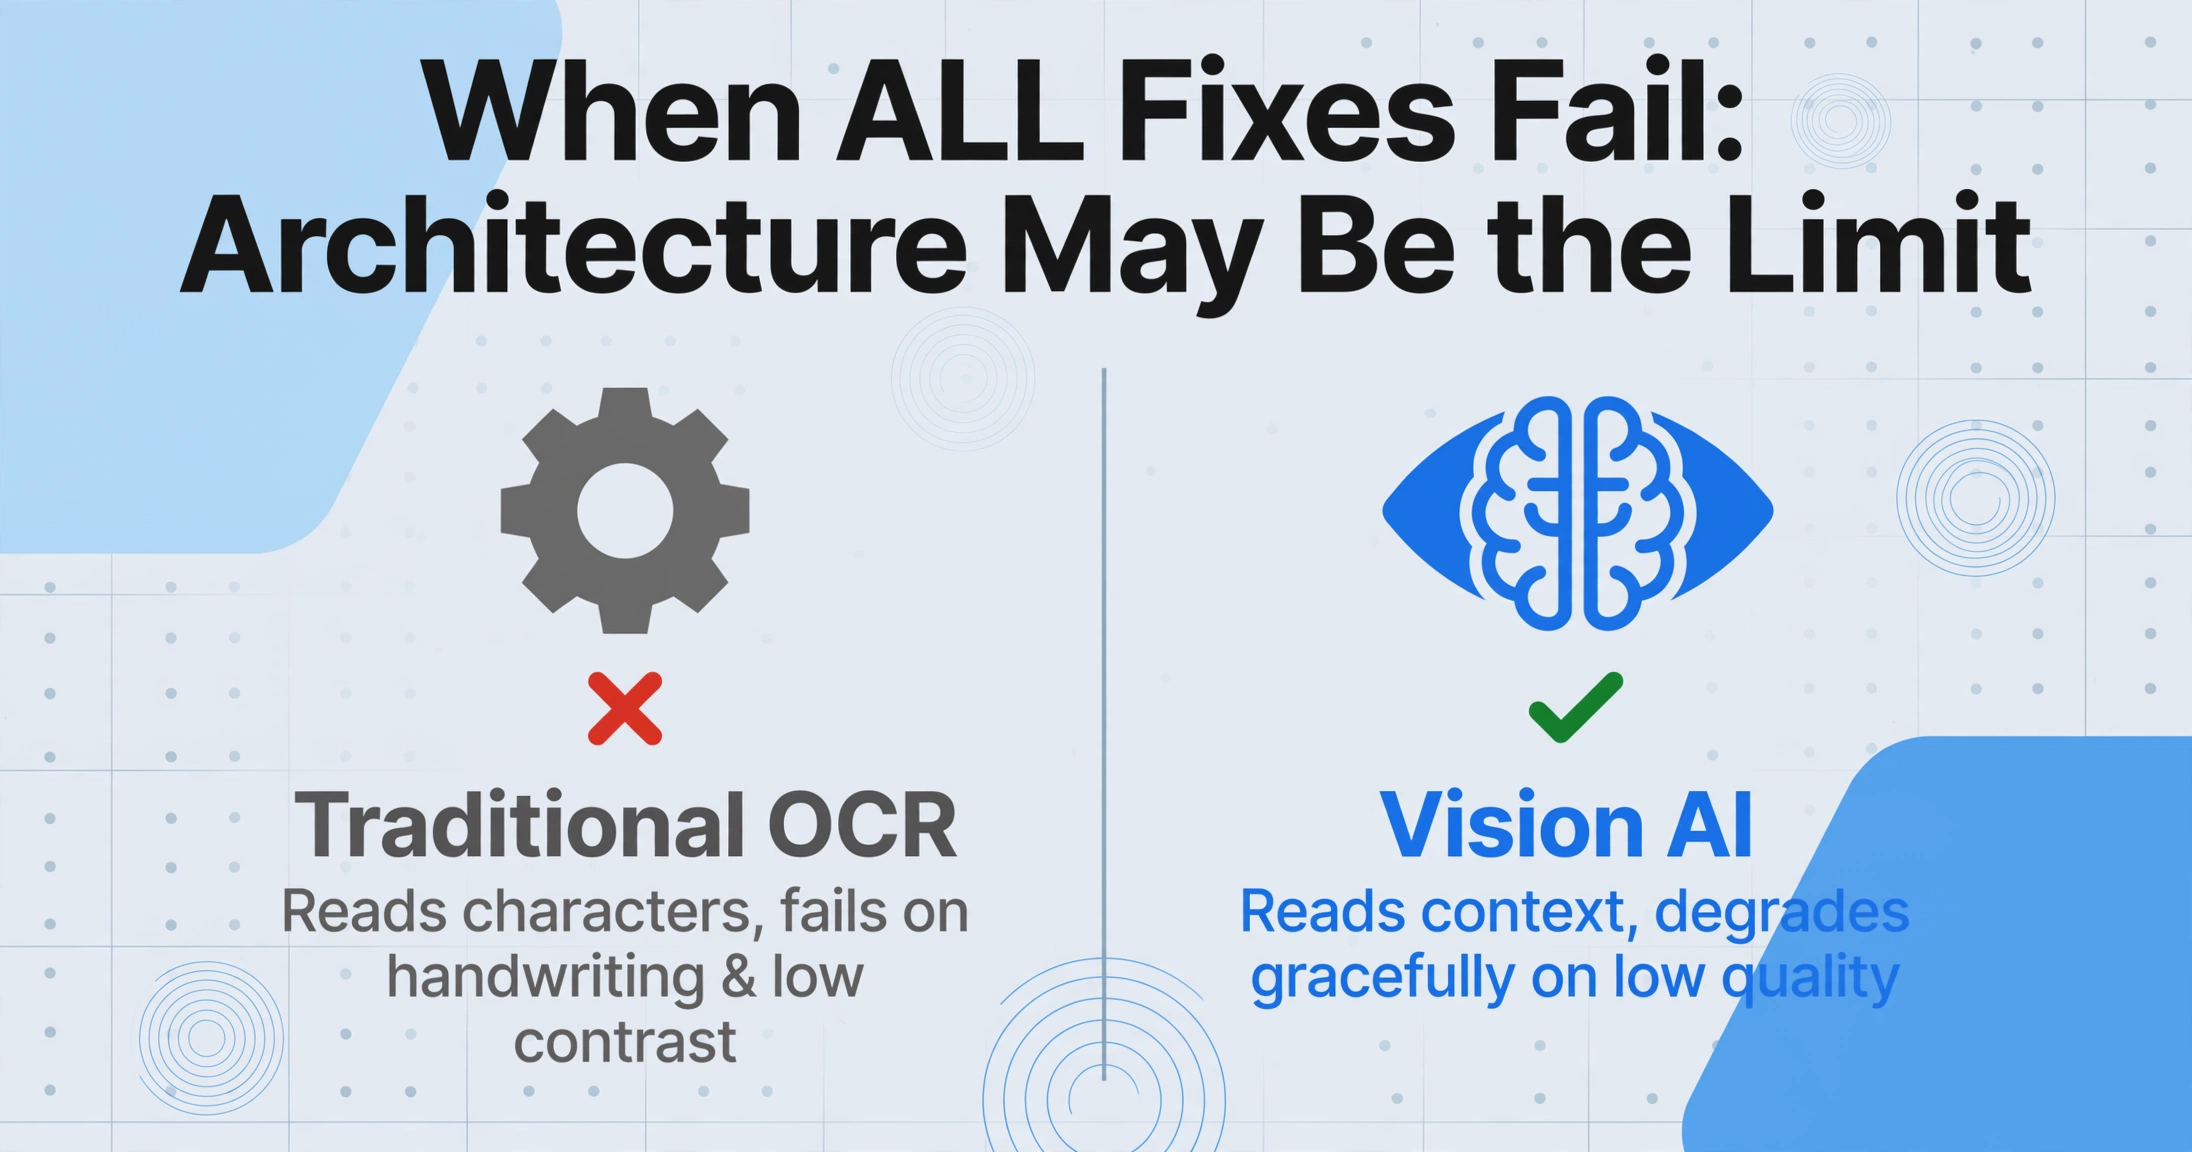
Si ha revisado el artículo correspondiente, aplicado la corrección recomendada y el problema persiste, es momento de considerar que el problema no es cómo usa la herramienta, sino qué es la herramienta en su esencia. Las distintas arquitecturas de extracción tienen diferentes techos de fallo.
Las herramientas tradicionales basadas en OCR, incluidas Tesseract, las API de OCR en la nube y los extractores basados en plantillas, comparten una limitación común: leen caracteres sin comprender el contexto del documento. Esa arquitectura falla de forma predecible con escritura a mano, diseños de bajo contraste, texto tachado y documentos con formato complejo. Cuando el problema es la arquitectura, ningún ajuste de preprocesamiento o parámetros cerrará la brecha. Necesita un enfoque diferente.
Los modelos de IA de visión, que es el enfoque utilizado por ImageToTable.ai, procesan los documentos de manera diferente. No dependen de la segmentación de caracteres ni de la coincidencia de plantillas. En su lugar, interpretan el documento de forma holística: leen el contexto, el diseño y las relaciones entre campos como lo haría un lector humano. Esto significa que se degradan con elegancia ante entradas de baja calidad (la precisión disminuye gradualmente en lugar de colapsar) y manejan la variación de formato sin mantenimiento de plantillas.
Si su herramienta de extracción depende de plantillas fijas, requiere configuración por proveedor o utiliza OCR zonal (extracción de datos de rectángulos predefinidos en la página), y está alcanzando un techo, considere probar una herramienta basada en IA de visión con sus documentos reales para ver si el cambio de arquitectura resuelve sus fallos recurrentes.
Verificación rápida de la realidad: Si su herramienta requiere plantillas o entrenamiento para cada formato de documento, y sus documentos llegan en más de tres diseños diferentes, el cuello de botella es la arquitectura de la herramienta, no su configuración. La extracción sin plantilla elimina toda esa clase de fallos por diseño.
Preguntas Frecuentes
¿Por qué mi herramienta de extracción lee incorrectamente texto claro?
Claro para el ojo humano y claro para un motor de OCR son estándares diferentes. Un documento que le parece perfectamente legible puede tener características sutiles que degradan la segmentación de caracteres, como contraste ligeramente bajo, artefactos menores de compresión o fuentes con espaciado de letras muy ajustado. Las herramientas modernas de IA visual manejan mejor estos casos porque entienden el contexto en lugar de depender únicamente de la forma de los caracteres, pero ninguna herramienta tiene precisión perfecta en todos los documentos.
¿Puede el preprocesamiento de documentos solucionar la mayoría de los problemas de extracción?
El preprocesamiento (enderezar, ajustar el contraste, aumentar los DPI) soluciona un subconjunto significativo de fallos relacionados con la calidad de imagen, aproximadamente los que provienen de una captura deficiente. No soluciona problemas causados por límites de la arquitectura de la herramienta, errores de diseño de campos o estilos de escritura a mano que el modelo no puede interpretar. Una buena regla general: si el preprocesamiento no resuelve el problema en dos intentos, la causa raíz probablemente está en otro lugar, y debe pasar a la tabla de diagnóstico anterior.
¿Por qué obtengo resultados diferentes cuando ejecuto el mismo documento dos veces?
La mayoría de las herramientas de extracción son deterministas: la misma entrada produce la misma salida. Si observa variación, hay tres causas posibles. Primero, el archivo puede haber sido re-comprimido o re-guardado entre ejecuciones, cambiando la entrada a nivel de píxeles. Segundo, algunos modelos de IA incorporan muestreo probabilístico que puede producir una ligera variación en la salida en campos ambiguos. Tercero, el procesamiento por lotes puede introducir condiciones de carrera donde los archivos se procesan en un orden diferente, exponiendo diferentes estados de cola. Ejecute exactamente el mismo archivo tres veces. Si dos de tres coinciden, la variación está dentro de la tolerancia esperada.
Mi herramienta de extracción funciona bien con facturas pero falla con recibos. ¿Por qué?
Las facturas suelen ser documentos estructurados con posiciones de campo consistentes y alta calidad de impresión. Los recibos son frecuentemente impresiones térmicas de baja resolución que están dobladas, arrugadas o desvaídas, el peor escenario para cualquier sistema de extracción. Además, los formatos de recibos varían enormemente entre comercios, lo que hace que los enfoques basados en plantillas sean particularmente frágiles. Si su herramienta requiere plantillas, la brecha de recibos es predecible. Las herramientas sin plantilla manejan mejor los recibos, pero aún enfrentan límites de precisión en papel térmico extremadamente desvaído.
¿Cuánto tiempo debo dedicar a solucionar problemas antes de cambiar de enfoque?
Un presupuesto razonable de solución de problemas: 15-30 minutos por problema recurrente. Si no puede resolver un modo de fallo específico dentro de ese plazo usando las soluciones recomendadas, el problema probablemente es arquitectónico más que de configuración. El costo de continuar solucionando (tiempo invertido, flujos de trabajo retrasados, reingreso de datos) supera rápidamente el costo de probar un enfoque de extracción diferente en una muestra de sus documentos reales.
¿La precisión de la extracción varía según el idioma del documento?
Sí, de forma medible. Los motores de OCR están entrenados predominantemente con documentos en inglés de escritura latina. El rendimiento en documentos que no están en inglés es menor de forma predeterminada, especialmente en escrituras CJK (chino, japonés, coreano) con alta densidad de caracteres, escrituras árabes con formas de letras conectadas y escrituras latinas con acentos. Los modelos de visión por IA reducen esta brecha porque leen los caracteres en contexto en lugar de comparar formas de glifos aisladas, pero la brecha no desaparece por completo. Consulte el artículo sobre extracción multilingüe para conocer puntos de referencia específicos y estrategias de mitigación.
¿Existe una forma de validar la precisión de la extracción sin revisar manualmente cada archivo?
Sí. La verificación estadística por muestreo —verificar una muestra aleatoria del 5-10% de cada lote contra los documentos originales— detecta errores sistemáticos con alta confianza. Además, las reglas de validación a nivel de campo (por ejemplo, «los montos de las facturas deben ser números positivos» o «las fechas deben estar dentro del año fiscal actual») pueden marcar automáticamente los valores atípicos para revisión humana. Para valores individuales sospechosos, el resaltado de origen en el modo de revisión es la verificación más rápida: haga clic en cualquier celda extraída y su origen se resalta en el documento original, de modo que pueda confirmarlo o rechazarlo en segundos. La guía de verificación de extracción proporciona un flujo de trabajo completo para crear una rutina de verificación por muestreo que se adapte a su volumen.
¿Aún no está seguro de qué causa su problema de extracción? Cargue un documento de muestra y vea cómo una herramienta de extracción de IA sin plantilla lo maneja, sin necesidad de registrarse.
Diagnostique su Problema de ExtracciónLos archivos se procesan de forma segura y no se almacenan.