Qu'est-ce que l'extraction de données de bons de commande ?
Automatiser le traitement des PO
L'extraction de données de bons de commande est le processus automatisé de lecture des champs clés — comme le numéro de PO, le fournisseur, l'adresse de livraison, les lignes d'article (code article, description, quantité, prix unitaire, total de ligne) et le montant total — à partir d'un bon de commande PDF ou scanné, et leur sortie sous forme de données structurées dans un tableur. Ce n'est pas la même chose que d'exécuter un OCR sur un PO — l'OCR vous donne un mur de texte. L'extraction vous donne un tableau avec chaque champ dans sa propre colonne, prêt pour le rapprochement, l'analyse ou l'import ERP.
Points clés à retenir
- 14 $ à 200 $ — c'est ce que coûte le traitement manuel d'un bon de commande, et aucun de cet argent ne fait quoi que ce soit que vous ne pourriez pas automatiser avec un simple téléchargement.
- Lorsqu'un fournisseur modifie la mise en page de son PO, les outils basés sur des modèles placent silencieusement de mauvaises valeurs dans les bonnes colonnes — et chaque échec de rapprochement à trois voies qui en résulte prend 30 minutes à démêler.
- Définissez vos colonnes une seule fois par nom — Numéro de PO, Code article, Quantité — et l'extraction sémantique lit le format de chaque fournisseur par signification plutôt que par position, sans aucun modèle à créer ou à maintenir.
Ce qu'est réellement l'extraction de données de bons de commande
L'extraction de bons de commande est l'étape spécifique qui transforme le document PO d'un fournisseur — qu'il arrive sous forme de pièce jointe PDF, de scan envoyé par e-mail ou de photo prise depuis le téléphone d'un acheteur — en champs de données structurés que vous pouvez réellement exploiter. Ce n'est pas la même chose que l'automatisation des PO, qui gère l'ensemble du processus d'approvisionnement (demande, approbations, envoi, rapprochement, paiement). L'extraction est la couche de saisie de données : le pont entre « un fichier PO dans votre boîte de réception » et « des lignes dans votre tableur ou votre ERP ».
Les champs généralement extraits d'un bon de commande se répartissent en deux catégories :
Champs d'en-tête (un par PO)
- Numéro de PO
- Date du PO
- Nom et adresse du fournisseur
- Adresse de facturation / de livraison
- Nom de l'acheteur / service
- Conditions de paiement
- Sous-total, taxes, expédition, total
Lignes d'article (plusieurs lignes par PO)
- Code article / SKU
- Description
- Quantité
- Unité de mesure (UOM)
- Prix unitaire
- Total de la ligne
- Date de livraison (par ligne)
C'est au niveau des lignes d'article que l'extraction devient difficile. Un champ d'en-tête est une valeur unique. Un tableau de lignes d'article peut contenir 20, 50 ou plus de 100 lignes — chacune avec son propre code article, sa description, sa quantité, son UOM et son prix — réparties sur plusieurs pages avec des dispositions de colonnes qui changent d'un fournisseur à l'autre. Un fournisseur utilise « EA » pour l'unité de mesure ; un autre utilise « PCS » ; un troisième écrit « Each » en toutes lettres. Une commande d'un fournisseur industriel peut spécifier des dates de livraison par ligne, tandis qu'un PO de détail peut regrouper le tout sous une seule date d'expédition. Bien gérer les lignes d'article — à travers les formats, les fournisseurs et les sauts de page — est ce qui distingue une extraction exploitable d'un résultat partiel qui nécessite encore un nettoyage manuel.
C'est dans cette lacune que tombent les outils basés sur des modèles. Si vous avez configuré un modèle pour la mise en page du fournisseur A — « le numéro de PO est aux coordonnées (50, 20), les lignes d'article commencent à la ligne 8 » — cela fonctionne jusqu'à ce que le fournisseur A change son modèle de PO parce qu'il a mis à niveau son ERP. Le numéro de PO se retrouve alors à la position (75, 30), et votre modèle extrait silencieusement la mauvaise valeur dans la colonne Numéro de PO. Multipliez cela par 50 fournisseurs, et la maintenance des modèles devient un travail à temps plein. Pour une vue plus large sur la façon dont l'IA change ce paradigme à travers les types de documents, consultez notre guide sur ce qu'est réellement l'extraction de documents par IA.
Extraction de PO vs Traitement de PO vs OCR — Différences clés
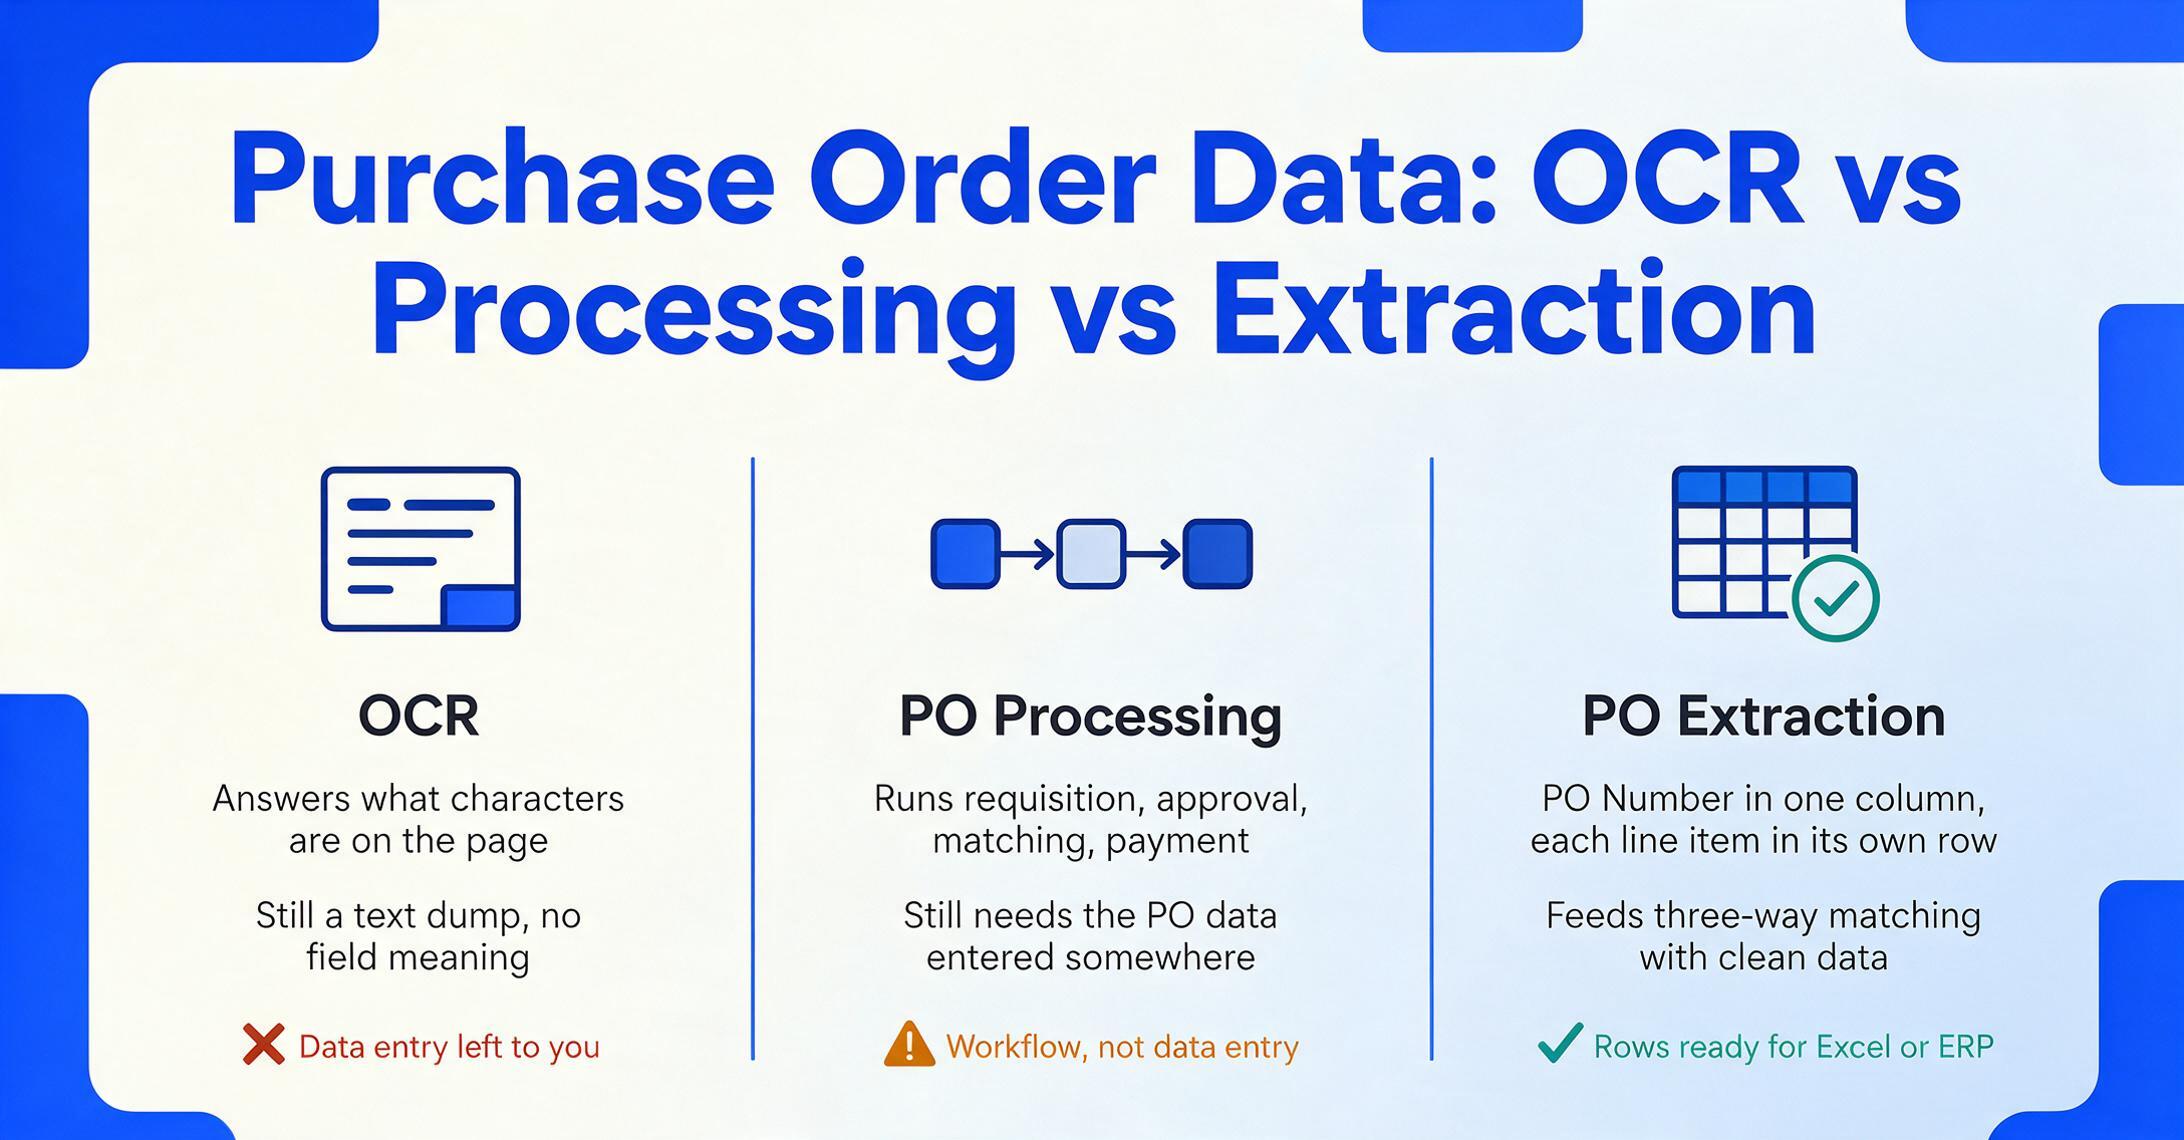
Ces trois termes se côtoient dans les discussions sur les achats, mais les confondre mène à l'achat d'outils qui résolvent le mauvais problème.
OCR (reconnaissance optique de caractères) convertit une image de texte en caractères lisibles par machine. Elle répond à la question « quels caractères figurent sur cette page ? » mais n'a aucune notion de ce que ces caractères signifient. Si vous faites passer un PO dans un OCR, vous obtenez quelque chose comme BON DE COMMANDE PO-2026-0412 DATE 12/04/2026 FOURNISSEUR Atlas Fasteners QTÉ 500 DÉSIGNATION Boulon hexagonal M8 PRIX UNITAIRE 0,42 $ TOTAL 210,00 $ — un simple rejet de texte. Vous devez encore extraire manuellement chaque champ et le saisir dans la bonne cellule. L'OCR a numérisé les caractères. Il n'a pas fait la saisie des données.
Le traitement de PO est le flux de travail complet des achats qui entoure l'extraction : création de la demande, acheminement pour approbation, émission du bon de commande, réception des marchandises, rapprochement du PO avec la facture et le bon de réception (rapprochement à trois voies), planification du paiement et archivage. Les outils de traitement comme SAP Ariba, Coupa ou Oracle Procurement gèrent le flux de travail — mais ils ont toujours besoin que les données du PO entrent dans le système quelque part. Cette étape de saisie, c'est l'extraction.
L'extraction de données de PO est l'étape spécifique qui transforme un document de PO en champs structurés : le numéro de PO dans une colonne, le fournisseur dans une autre, chaque ligne d'article dans sa propre rangée, le total dans une cellule qu'Excel peut additionner. C'est la couche de saisie de données qui alimente le traitement. Vous pouvez avoir une automatisation de flux de travail d'achats de classe mondiale, mais si l'étape d'extraction lui fournit de mauvaises données — quantités erronées, codes d'articles incompatibles, totaux incorrects — le flux de travail ne fait qu'automatiser les erreurs plus rapidement.
La conséquence en aval des erreurs d'extraction est l'échec du rapprochement à trois voies. Les références AP 2025 d'Ardent Partners indiquent que les équipes AP de premier ordre atteignent un taux d'exception de 9 % sur le rapprochement des factures — les autres atteignent en moyenne 22 %. Chaque écart qui remonte à une erreur de saisie de données de PO coûte à un commis AP environ 30 minutes d'enquête entre les achats, la réception et les finances. Bien faire l'extraction au stade du PO évite ces exceptions avant qu'elles n'atteignent le rapprochement.
Comment fonctionne l'extraction de données PO
Derrière l'interface, l'extraction repose sur un changement fondamental survenu ces deux dernières années : le passage de l'extraction basée sur la position à l'extraction sémantique.
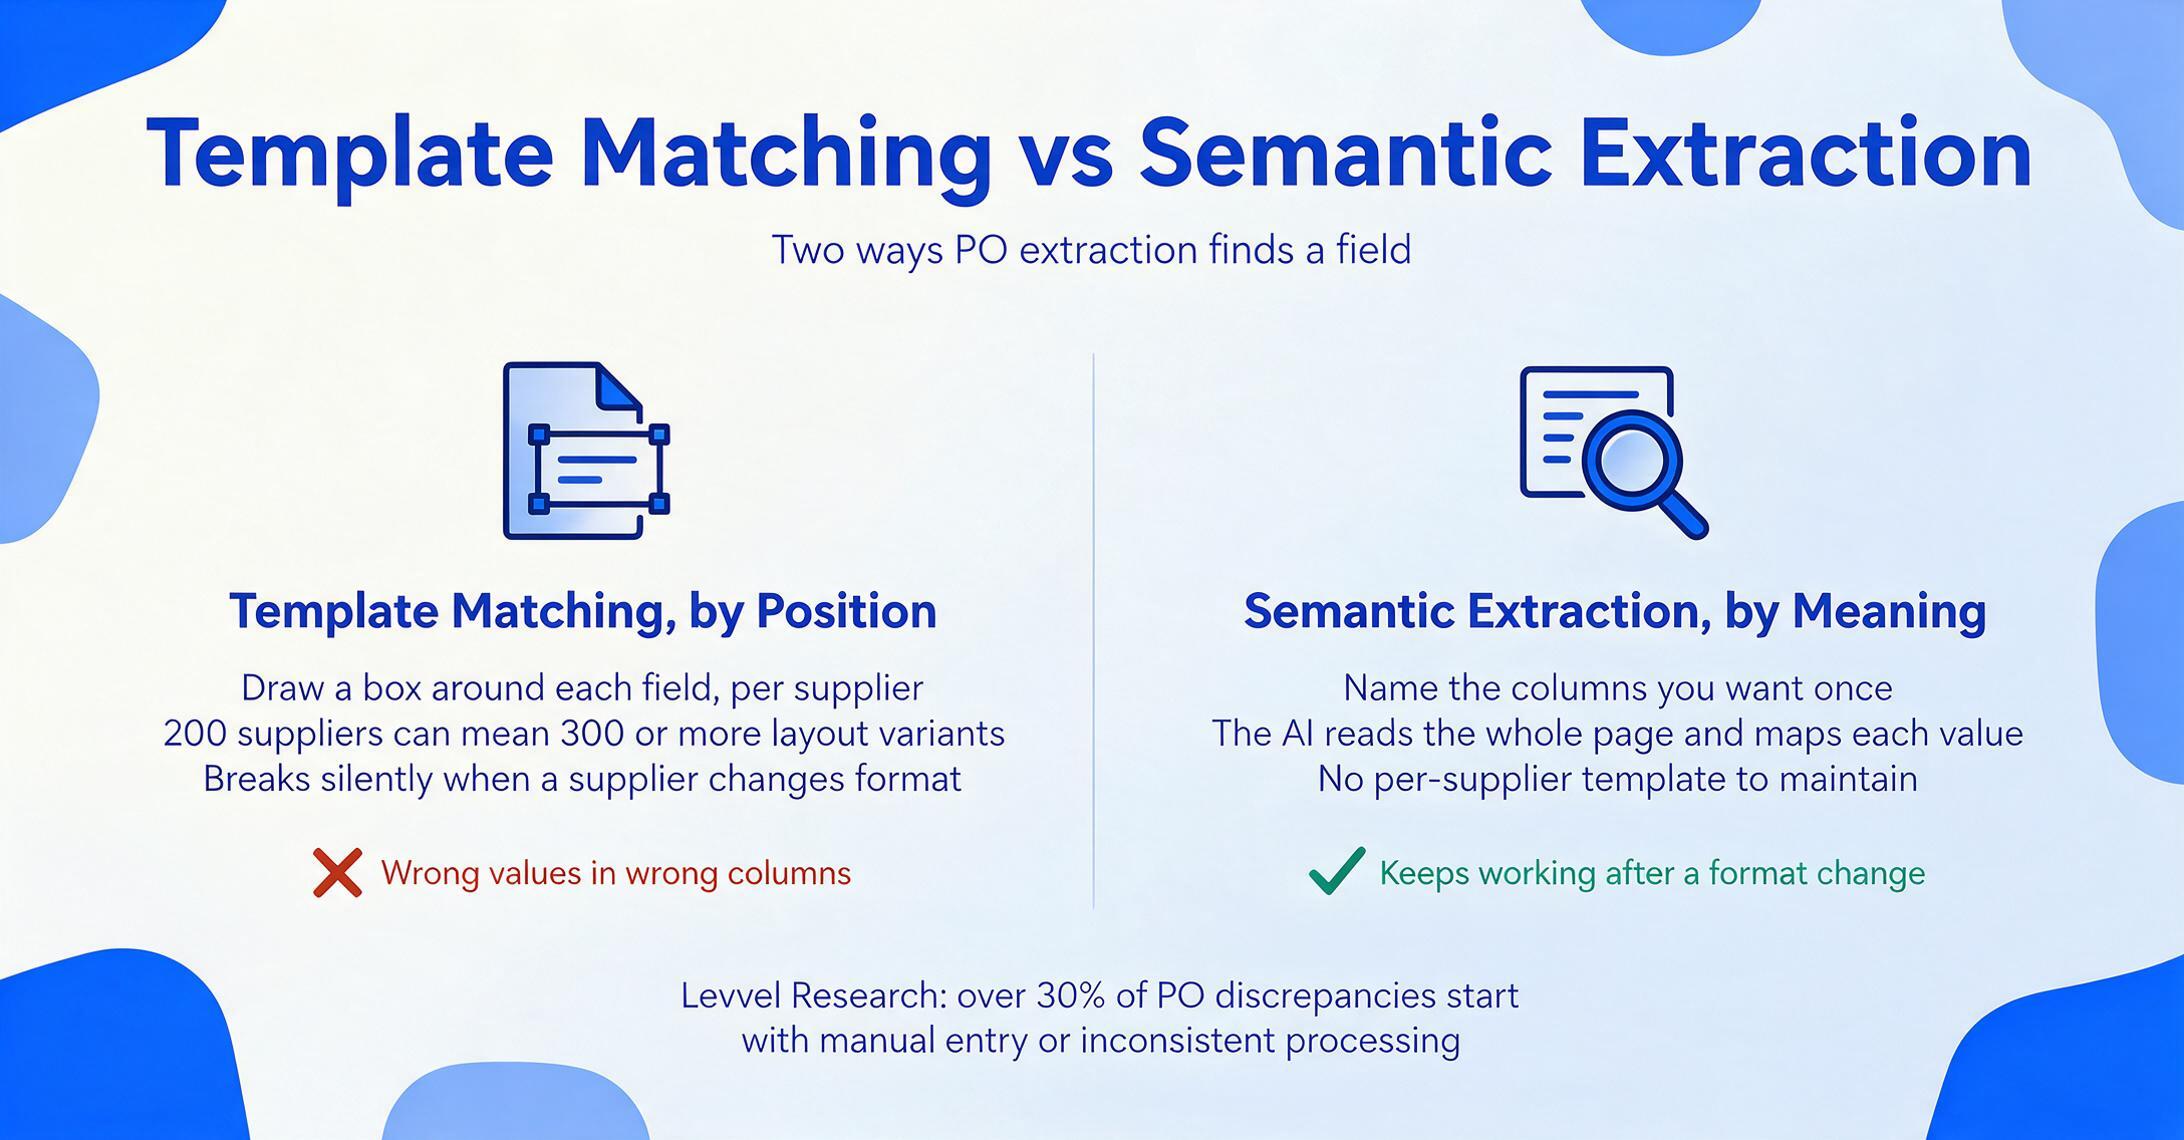
L'ancienne méthode — la correspondance de modèles. Les outils d'extraction PO traditionnels fonctionnent par position. Vous dessinez un rectangle autour de « Numéro de PO » sur la mise en page d'un fournisseur et indiquez au système « la valeur se trouve à droite ». Vous répétez cette opération pour chaque fournisseur, chaque variante de mise en page, chaque champ. Un fabricant de taille moyenne avec 200 fournisseurs actifs peut être confronté à plus de 300 variantes de formats. Pire encore, lorsqu'un fournisseur modifie son format de PO — ce qui arrive à chaque mise à niveau de son ERP ou à chaque changement de marque — le modèle casse silencieusement et commence à insérer de mauvaises valeurs dans de mauvaises colonnes. Levvel Research a constaté que plus de 30 % des écarts de PO proviennent de la saisie manuelle ou d'un traitement incohérent — et l'extraction basée sur des modèles ne fait qu'automatiser cette incohérence au lieu de la corriger.
La méthode moderne — l'extraction sémantique. L'extraction moderne basée sur l'IA fonctionne par signification, et non par position. Au lieu d'entraîner le système sur l'emplacement de chaque champ, vous spécifiez ce que vous voulez trouver : « Numéro de PO », « Nom du fournisseur », « Description de l'article », « Quantité », « Prix unitaire », « Total de la ligne ». L'IA lit l'intégralité du document, comprend ce que représente chaque texte dans son contexte et le mappe à la bonne colonne de sortie — quel que soit son emplacement sur la page. C'est l'Extraction de colonnes personnalisées : vous définissez les colonnes de sortie souhaitées, et l'IA localise les données correspondantes n'importe où sur la page en comprenant la signification de chaque champ. Un champ intitulé « N° PO » sur le document d'un fournisseur et « Référence de commande » sur celui d'un autre est reconnu comme la même chose, car l'IA comprend le rôle sémantique, et non le texte du libellé.
Voici le pipeline de bout en bout :
Téléversement
Déposez des PDF, des scans ou des photos — un seul PO ou un lot de 50. Pas de tri préalable par fournisseur, pas de renommage, aucune exigence de format au-delà de la lisibilité. Chaque document est reçu comme une image visuelle, pas comme du texte — l'IA voit la mise en page, les polices, les tableaux et les espaces blancs comme le ferait un lecteur humain.
Définir les colonnes
Saisissez les noms des champs que vous souhaitez extraire — « N° de PO », « Fournisseur », « Code article », « Description », « Quantité », « Prix unitaire », « Total ligne ». Ceux-ci deviennent les en-têtes de votre feuille de calcul de sortie. Pas de configuration de modèle, pas de données d'entraînement, pas de zones à dessiner. La même liste de colonnes fonctionne avec le format de chaque fournisseur, car l'IA fait correspondre par le sens, pas par la position.
Lecture et mise en correspondance par l'IA
Le modèle de vision scanne chaque page, identifie les blocs de texte correspondant à chaque champ en comprenant leur rôle sémantique, et les fait correspondre à vos colonnes. Une quantité de « 500 » à côté d'une description d'article est reconnue comme une quantité de ligne, pas comme un numéro de PO. Un bloc d'adresse « Livrer à » est distingué d'un bloc « Facturer à » par son contexte environnant — même lorsque les deux contiennent des structures d'adresse similaires. Les lignes d'article s'étendant sur des sauts de page sont assemblées en lignes continues.
Exporter les données structurées
Téléchargez en Excel (XLSX), CSV ou JSON. Chaque PO obtient une ligne dans le tableau d'en-tête ; les lignes d'article se développent en lignes séparées avec les champs d'en-tête du PO répétés pour les filtres et les tableaux croisés dynamiques. Ou écrivez les résultats directement dans Google Sheets. Les données sont pré-formatées — les dates au format AAAA-MM-JJ, les montants en nombres simples — donc aucun reformatage n'est nécessaire entre l'extraction et l'importation dans QuickBooks, NetSuite ou votre ERP.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Quand vous avez besoin d'extraction de données de PO
Toutes les entreprises n'ont pas besoin d'extraction. Une petite opération émettant cinq PO par mois auprès des trois mêmes fournisseurs peut les saisir dans un tableur pendant une pause-café. L'extraction devient rentable lorsque le volume et la variété franchissent un seuil où la saisie manuelle cesse d'être un inconvénient mineur et commence à se cumuler entre fournisseurs, départements et mois.
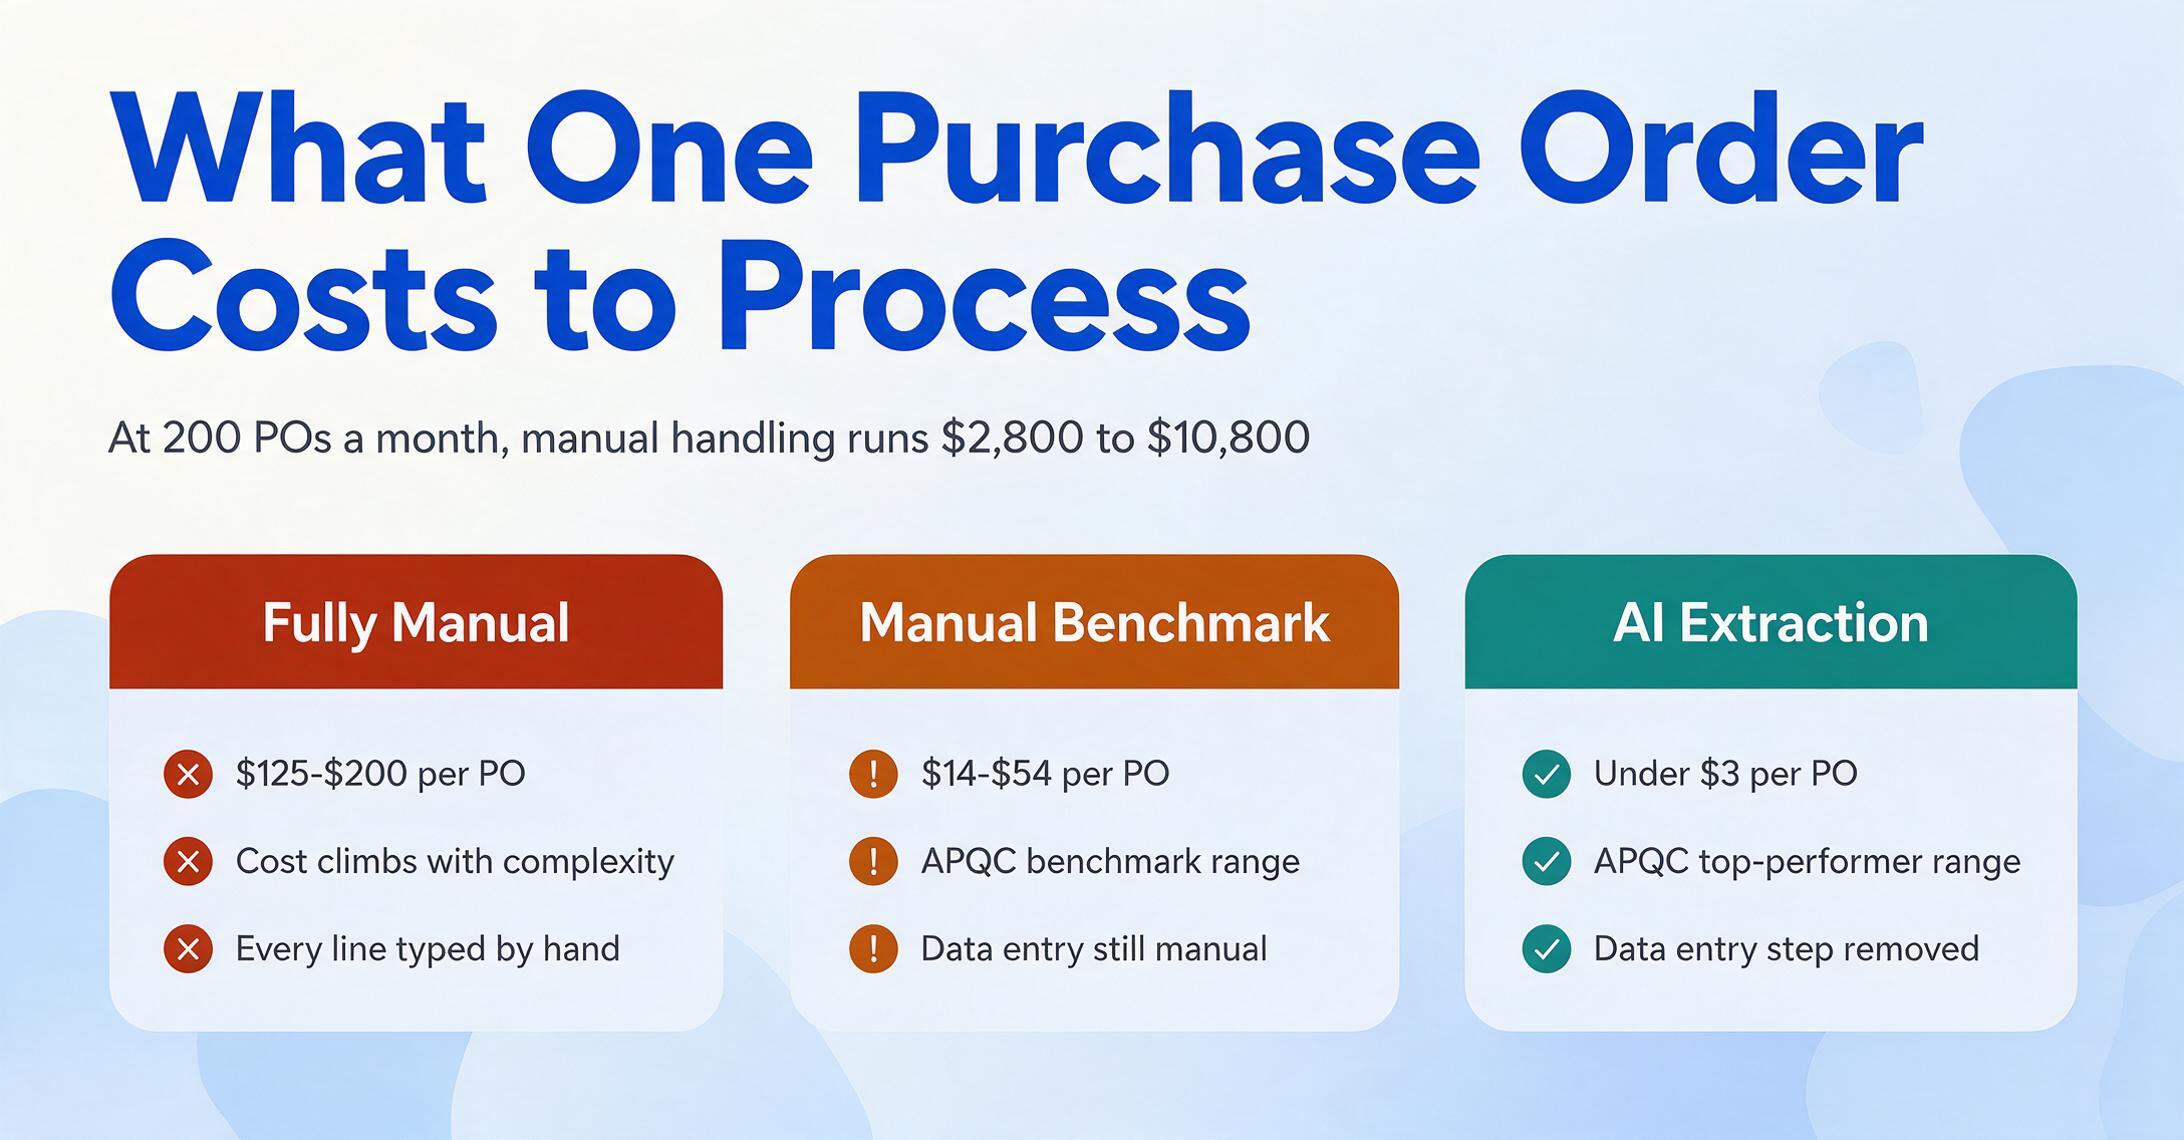
1. Le volume de PO dépasse l'effectif. Les données de CAPS Research montrent que dans le secteur industriel, les dépenses d'approvisionnement représentent en moyenne 55,64 % du chiffre d'affaires — ce qui signifie que pour un fabricant de 50 M$, environ 27,8 M$ transitent par les bons de commande. Les références d'APQC montrent que les coûts de traitement manuel des PO varient de 14 $ à 54 $ par PO, les processus entièrement manuels atteignant 125 à 200 $ par PO selon la complexité. À 200 PO par mois, cela représente 2 800 $ à 10 800 $ par mois en coûts de traitement avant même qu'une seule facture ne soit rapprochée. L'extraction automatisée — en éliminant l'étape de saisie des données — rapproche le coût par PO de la fourchette de moins de 3 $ que les références d'APQC attribuent aux meilleurs performeurs.
2. Chaque fournisseur envoie un format de PO différent. C'est la réalité universelle des achats. Même deux fournisseurs utilisant tous deux SAP produisent des PO qui ne se ressemblent pas, car leurs administrateurs ont configuré des modèles de sortie différents. L'un utilise « PO-2026-XXXX » comme format de numéro de PO ; un autre utilise six chiffres sans préfixe. L'un place les lignes d'article dans un tableau bordé ; un autre utilise des blocs de texte en retrait sans structure de tableau visible. L'un inclut des dates de livraison par ligne d'article ; un autre place une seule date d'expédition dans l'en-tête. Les outils basés sur des modèles échouent face à cette diversité. L'extraction sémantique ne dépend pas du tout du format — c'est la différence entre un outil que vous configurez une fois et un outil que vous maintenez pour toujours. Pour une démonstration pratique de ce flux de travail, consultez notre guide sur l'automatisation de la saisie des données de bons de commande.
3. Vous avez besoin du détail des lignes d'article, pas seulement des totaux d'en-tête. De nombreux outils d'extraction traitent bien les champs d'en-tête : numéro de PO, date, fournisseur, total. Mais si vous avez besoin des lignes d'article — codes d'article, descriptions, quantités, prix unitaires — pour la vérification de réception des marchandises, le rapprochement des stocks ou le rapprochement à trois voies, les exigences de l'outil deviennent plus strictes. Une extraction limitée à l'en-tête qui oblige encore quelqu'un à saisir manuellement 50 lignes d'article à partir d'un PO de 3 pages n'a pas réellement résolu le problème de saisie des données. C'est le point de découverte le plus courant : les équipes réalisent que leur processus actuel n'automatise que 20 % des champs, mais que 80 % des points de données se trouvent dans les lignes d'article.
4. Les erreurs de données de PO se répercutent en échecs de rapprochement à trois voies. Lorsqu'un PO contient une mauvaise quantité, un prix unitaire ou une UOM saisi à la saisie des données, l'étape de rapprochement en aval — comparant le PO au bon de réception et à la facture fournisseur — signalera un écart. Chaque écart signalé nécessite une investigation manuelle : le PO a-t-il été mal saisi ? Le fournisseur a-t-il expédié une quantité différente ? La facture facture-t-elle quelque chose qui n'a pas été commandé ? Si la cause racine est une erreur de saisie de données du PO, vous passez 30 minutes à découvrir un problème qui a coûté 3 secondes à créer. Corriger la précision de l'extraction au stade du PO empêche ces exceptions d'atteindre la file de rapprochement. Pour en savoir plus sur cette dynamique, consultez notre article sur pourquoi le rapprochement à trois voies échoue dans les achats.
Que rechercher dans un outil d'extraction de PO
Les outils d'extraction vont des simples wrappers OCR aux plateformes natives IA. Les listes de fonctionnalités semblent toutes similaires, mais voici les critères qui les différencient réellement dans l'utilisation quotidienne en achats. Pour la référence complète champ par champ — champs d'en-tête, lignes d'article, formats d'export et le cadre de sélection complet — commencez par notre guide complet de l'extraction de bons de commande.
sans modèle. C'est le différenciateur le plus important. Un outil qui exige de créer et de maintenir des modèles d'analyse par format fournisseur n'est pas de l'extraction — c'est de la gestion de modèles avec un peu d'extraction en plus. La bonne question à poser à un fournisseur : « Si un fournisseur modifie la mise en page de son PO demain, que dois-je faire ? » Si la réponse implique de mettre à jour un modèle, de réentraîner un modèle IA ou de remapper des champs, vous achetez une charge de maintenance. L'alternative est Extraction de colonnes personnalisées : vous saisissez les noms de champs souhaités — « N° de PO », « Code article », « Quantité » — une seule fois, et l'IA les trouve dans chaque format fournisseur car elle lit par sens, pas par position. Les noms de colonnes que vous saisissez deviennent vos en-têtes de sortie. Pour comprendre pourquoi cette distinction est importante, lisez notre article sur l'extraction des champs de bons de commande vers Excel.
Qualité d'extraction des lignes d'article sur les sauts de page. Les outils qui extraient de manière fiable les champs d'en-tête sont le minimum requis. Les lignes d'article — surtout sur des PO multipages avec des mises en page de colonnes incohérentes et des variantes d'UOM — sont le vrai test. Demandez à tester l'outil sur un PO de 4 pages avec un tableau de 30 lignes d'article s'étendant des pages 2 à 4, avec des cellules fusionnées dans la colonne de description et des quantités réparties sur plusieurs dates de livraison. S'il gère cela proprement, il gérera tout le reste.
Capacité de traitement par lots. Pouvez-vous télécharger 50 PO de 20 fournisseurs différents en une fois et obtenir une seule feuille de calcul unifiée ? Ou devez-vous les traiter un par un ? Le traitement par lots fait la différence entre « cet outil me fait gagner du temps par PO » et « cet outil me fait gagner des heures par jour ». La sortie doit être un tableau unique où tous les PO sont fusionnés — mêmes colonnes, même structure — prêt pour l'analyse, le rapprochement ou l'importation. Pour en savoir plus sur ce flux de travail, consultez notre guide d'extraction par lots de PO vers Excel.
Format de sortie et intégration. La sortie doit correspondre à votre flux de travail d'achats. Si vous travaillez tout dans Excel, l'export XLSX avec des colonnes correctement typées est indispensable. Si votre équipe travaille dans Google Sheets, un outil qui écrit les résultats directement dans une feuille — éliminant le cycle téléchargement-envoi-importation — vaut la différence. Un module complémentaire Google Sheets dédié à l'extraction de PO vous permet de traiter les PO sans quitter votre feuille de calcul. CSV et JSON sont importants si vous alimentez NetSuite, QuickBooks ou un ERP personnalisé.
Gestion des cas particuliers réels de PO. Expéditions partielles où un seul PO génère plusieurs bons de réception. Écarts d'unités de mesure — le PO commande en « Cartons » mais les lignes précisent « Unités par carton ». Frais de taxe et d'expédition apparaissant dans l'en-tête mais devant être répartis entre les lignes pour la comptabilité analytique. PO-cadres couvrant des mois de livraisons avec des prix variables. Un outil qui traite 95 % de vos PO mais échoue silencieusement sur les 5 % légèrement inhabituels crée plus de risque qu'un outil honnête sur ses limites. Testez l'outil sur vos PO les plus complexes — les commandes-cadres, les PO de fournisseurs internationaux avec double devise, les PO annotés à la main de petits fournisseurs — pas sur vos cas les plus simples.
Questions fréquentes
L'extraction de PO fonctionne-t-elle avec les bons de commande manuscrits ?
Oui, avec des réserves. Les outils d'extraction IA modernes qui utilisent des modèles basés sur la vision peuvent lire l'écriture manuscrite sur les bons de commande — y compris les quantités manuscrites, les corrections manuelles et les champs de formulaire remplis. La précision dépend de la lisibilité de l'écriture : une écriture claire en capitales s'extrait à 90 % et plus, tandis qu'une cursive dense sur des scans de faible qualité donnera des résultats inférieurs. L'avantage clé de l'extraction sémantique ici est que l'IA utilise le contexte du champ pour lever l'ambiguïté : si elle cherche une « Quantité » et voit à la fois un « 500 » tapé et un « 520 » manuscrit à côté, elle peut raisonner sur lequel est la quantité réelle de la commande. Pour les PO entièrement manuscrites — courantes chez les petits fournisseurs qui remplissent des formulaires papier — la précision d'extraction est comparable à celle des factures : suffisante pour une vérification, pas pour un traitement sans intervention. Pour en savoir plus sur ce scénario, consultez notre guide sur l'extraction de bons de commande manuscrits.
L'extraction de PO peut-elle gérer des lignes d'article réparties sur plusieurs pages ?
Oui, c'est une capacité essentielle de l'extraction IA moderne. Lorsqu'un tableau de lignes d'article est coupé par un saut de page — courant pour les PO de 20 lignes et plus — l'IA identifie que le tableau se poursuit sur la page suivante et reconstitue les lignes en enregistrements continus. La condition clé est que les en-têtes de colonnes se répètent ou soient visuellement déductibles sur la page de continuation. Si la deuxième page supprime complètement les en-têtes de colonnes et compte sur le lecteur pour se souvenir de l'ordre des colonnes de la première page, la précision peut baisser. C'est l'un des scénarios à tester lors de l'évaluation d'un outil — apportez une PO multipage dont le tableau s'étend sur plusieurs pages et vérifiez que les lignes des pages 2 et suivantes atterrissent dans les bonnes colonnes.
Qu'en est-il des différentes unités de mesure — l'extraction peut-elle les normaliser ?
L'extraction IA peut lire quelle que soit l'unité de mesure utilisée par le fournisseur — « EA », « PCS », « Each », « CTN », « BOX », « KG », « LB » — et la capturer dans une colonne UOM dédiée. Cependant, la normalisation des unités (par ex., convertir « CTN de 12 » en 12 « EA » individuels) nécessite une logique en aval, car le facteur de conversion varie selon l'article. L'outil d'extraction capture ce que dit la PO. Convertir « 3 cartons × 24 unités/carton = 72 unités » est une étape de calcul qui intervient après l'extraction — soit dans votre tableur, votre ERP, soit via des colonnes calculées qui vous permettent de définir la formule de conversion une seule fois. Le rôle de l'outil d'extraction est de capturer les valeurs brutes avec précision afin que l'étape de normalisation dispose d'intrants propres.
En quoi l'extraction de PO diffère-t-elle du rapprochement à trois voies ?
L'extraction de PO et le rapprochement à trois voies sont des étapes séquentielles de la chaîne d'approvisionnement, et non des alternatives. L'extraction de PO est l'étape de saisie des données : transformer un document PO en champs structurés. Le rapprochement à trois voies est l'étape de vérification : comparer les données PO extraites au bon de réception et à la facture fournisseur pour confirmer que ce qui a été commandé, ce qui a été reçu et ce qui est facturé correspondent. L'extraction intervient en premier. Si les données PO extraites sont erronées — mauvaise quantité, mauvais prix unitaire, mauvais code article — le rapprochement à trois voies échouera avec un écart erroné, et quelqu'un devra enquêter. Une extraction correcte au stade de la PO est ce qui rend possible un rapprochement à trois voies sans intervention. Pour en savoir plus sur la façon dont ces éléments s'articulent, lisez notre analyse sur le rapprochement PO-facture dans le secteur manufacturier.
Puis-je extraire les données de PO directement dans mon ERP ?
La plupart des outils d'extraction produisent des fichiers Excel, CSV ou JSON — des formats que tous les ERP peuvent importer. Le flux de travail typique est le suivant : extraire les données de PO → vérifier le résultat → importer le fichier dans votre ERP (QuickBooks, NetSuite, SAP, Microsoft Dynamics). L'avantage est que les données arrivent pré-formatées — les dates au format AAAA-MM-JJ, les montants en nombres simples avec deux décimales, les codes d'article en texte — il n'y a donc aucune reformatage entre l'extraction et l'importation. Certains outils proposent des intégrations ERP directes via API, mais le chemin d'importation CSV/Excel fonctionne avec pratiquement tous les systèmes et ne nécessite aucune configuration informatique. Pour un guide pas à pas, consultez notre guide sur la conversion des bons de commande en Excel.
Quels formats de fichiers et types de documents l'extraction de PO prend-elle en charge ?
Les outils d'extraction modernes acceptent le PDF (généré numériquement ou scanné), le JPG, le PNG et le WebP. Le PDF est le format universel — la plupart des PO de fournisseurs arrivent en pièces jointes PDF par e-mail. Les photos de PO papier prises avec un téléphone fonctionnent tant que l'image est suffisamment nette et bien éclairée. Certains outils prennent également en charge l'AVIF et le TIFF. La flexibilité des formats est importante car les PO arrivent par plusieurs canaux : pièces jointes e-mail, portails fournisseurs (téléchargement PDF), photos prises par un acheteur sur son téléphone lors d'un salon professionnel (JPG) et PO papier héritées (scannées en PDF). Un outil qui ne gère qu'un seul format vous oblige à tout pré-convertir avant l'extraction. Pour d'autres types de documents qui suivent des schémas d'extraction similaires, consultez nos guides sur ce qu'est l'extraction de données de factures et ce qu'est l'OCR de reçus.
Où aller ensuite
L'extraction de données PO se situe à l'intersection de deux réalités des achats : le problème universel de la diversité des formats fournisseurs, et la dépendance en aval du rapprochement à trois voies vis-à-vis de données PO propres. Les outils existent aujourd'hui pour extraire les données PO de manière fiable, tous formats et fournisseurs confondus, sans configuration de modèle par fournisseur — ce qui n'était pas vrai il y a encore deux ans. Les données de recherche CAPS montrant que les dépenses d'achat représentent 55,64 % du chiffre d'affaires soulignent l'ampleur des flux financiers transitant par les bons de commande, et les références APQC montrant un écart de 11 à 51 $ par PO entre traitement manuel et automatisé rendent le retour sur investissement concret.
La meilleure façon d'évaluer si l'extraction s'intègre à votre flux de travail est de la tester sur de vrais bons de commande — idéalement un mélange de vos fournisseurs à plus fort volume et de vos PO les plus complexes. Si elle gère proprement vos cas les plus difficiles, les cas simples sont acquis. Pour une vue plus large du fonctionnement de l'extraction IA sur différents types de documents, commencez par notre guide fondamental sur l'extraction de documents par IA. Ou si vous êtes prêt à voir comment l'extraction traite un vrai bon de commande, téléversez un échantillon et essayez dès maintenant.