구매 주문 데이터 추출이란?
PO 처리 자동화
구매 주문 데이터 추출은 PO 번호, 공급업체, 배송지 주소, 라인 항목, 총액과 같은 핵심 필드를 PDF 또는 스캔된 구매 주문에서 읽어 스프레드시트의 구조화된 데이터로 출력하는 자동화된 프로세스입니다. PO에 OCR을 실행하는 것과는 다릅니다 — OCR은 텍스트 벽을 제공합니다. 추출은 각 필드가 자체 열에 있는 테이블을 제공하여 매칭, 분석 또는 ERP 가져오기에 바로 사용할 수 있습니다.
주요 요점
- $14~$200 — 구매 주문 하나를 수동으로 처리하는 데 드는 비용이며, 그 비용 중 어느 것도 단일 업로드로 자동화할 수 없는 일을 하지 않습니다.
- 공급업체가 PO 레이아웃을 변경하면 템플릿 기반 도구는 올바른 열에 잘못된 값을 조용히 넣습니다 — 그리고 각각의 3자 매칭 실패는 해결하는 데 30분이 걸립니다.
- 열을 이름으로 한 번 정의하세요 — PO 번호, 품목 코드, 수량 — 의미 기반 추출은 위치 대신 의미로 모든 공급업체의 형식을 읽으며, 구축하거나 유지 관리할 템플릿이 없습니다.
구매 주문 데이터 추출이 실제로 무엇인가
구매 주문 추출은 공급업체의 PO 문서를 실제로 활용할 수 있는 구조화된 데이터 필드로 변환하는 구체적인 단계입니다. 전체 조달 워크플로우를 관리하는 PO 자동화와는 다릅니다. 추출은 데이터 입력 계층, 즉 "받은 편지함의 PO 파일"과 "스프레드시트 또는 ERP의 행" 사이의 다리입니다.
구매 주문에서 일반적으로 추출되는 필드는 두 가지 범주로 나뉩니다:
헤더 필드
- PO 번호
- PO 날짜
- 공급업체/벤더 이름 및 주소
- 청구지/배송지 주소
- 구매자 이름/부서
- 결제 조건
- 소계, 세금, 배송비, 합계
라인 항목
- 품목 코드 / SKU
- 설명
- 수량
- 단위 (UOM)
- 단가
- 라인 합계
- 납품 날짜
라인 항목이 추출을 어렵게 만드는 부분입니다. 헤더 필드는 단일 값입니다. 라인 항목 테이블은 20개, 50개, 또는 100개 이상의 행을 포함할 수 있으며 — 각각 고유한 품목 코드, 설명, 수량, UOM, 가격을 가지며 — 공급업체마다 다른 열 배열로 여러 페이지에 걸쳐 있습니다. 한 공급업체는 단위로 "EA"를 사용하고, 다른 공급업체는 "PCS"를, 또 다른 공급업체는 "Each"를 전체로 표기합니다. 산업용 공급업체의 구매 주문은 라인 항목별로 납품 날짜를 지정할 수 있는 반면, 소매 PO는 모든 것을 하나의 배송 날짜로 묶을 수 있습니다. 라인 항목을 올바르게 처리하는 것 — 다양한 형식, 다양한 공급업체, 페이지 나눔을 넘어 — 이 수동 정리가 여전히 필요한 부분적 결과와 실용적인 추출을 구분짓는 요소입니다.
이것이 템플릿 기반 도구가 한계에 부딪히는 지점입니다. 공급업체 A의 레이아웃에 맞게 템플릿을 구성했다면 — "PO 번호는 좌표 (50, 20)에 있고, 라인 항목은 8행에서 시작합니다" — 공급업체 A가 ERP를 업그레이드하면서 PO 템플릿을 변경할 때까지는 작동합니다. 이제 PO 번호는 (75, 30) 위치에 있고, 템플릿은 PO 번호 열에 잘못된 값을 조용히 추출합니다. 이를 50개 공급업체로 곱하면 템플릿 유지보수는 전일제 작업이 됩니다. AI가 문서 유형 전반에 걸쳐 이 패러다임을 어떻게 바꾸는지 더 자세히 알아보려면 AI 문서 추출이 실제로 무엇인지에 대한 가이드를 참조하세요.
PO 추출 vs PO 처리 vs OCR — 주요 차이점
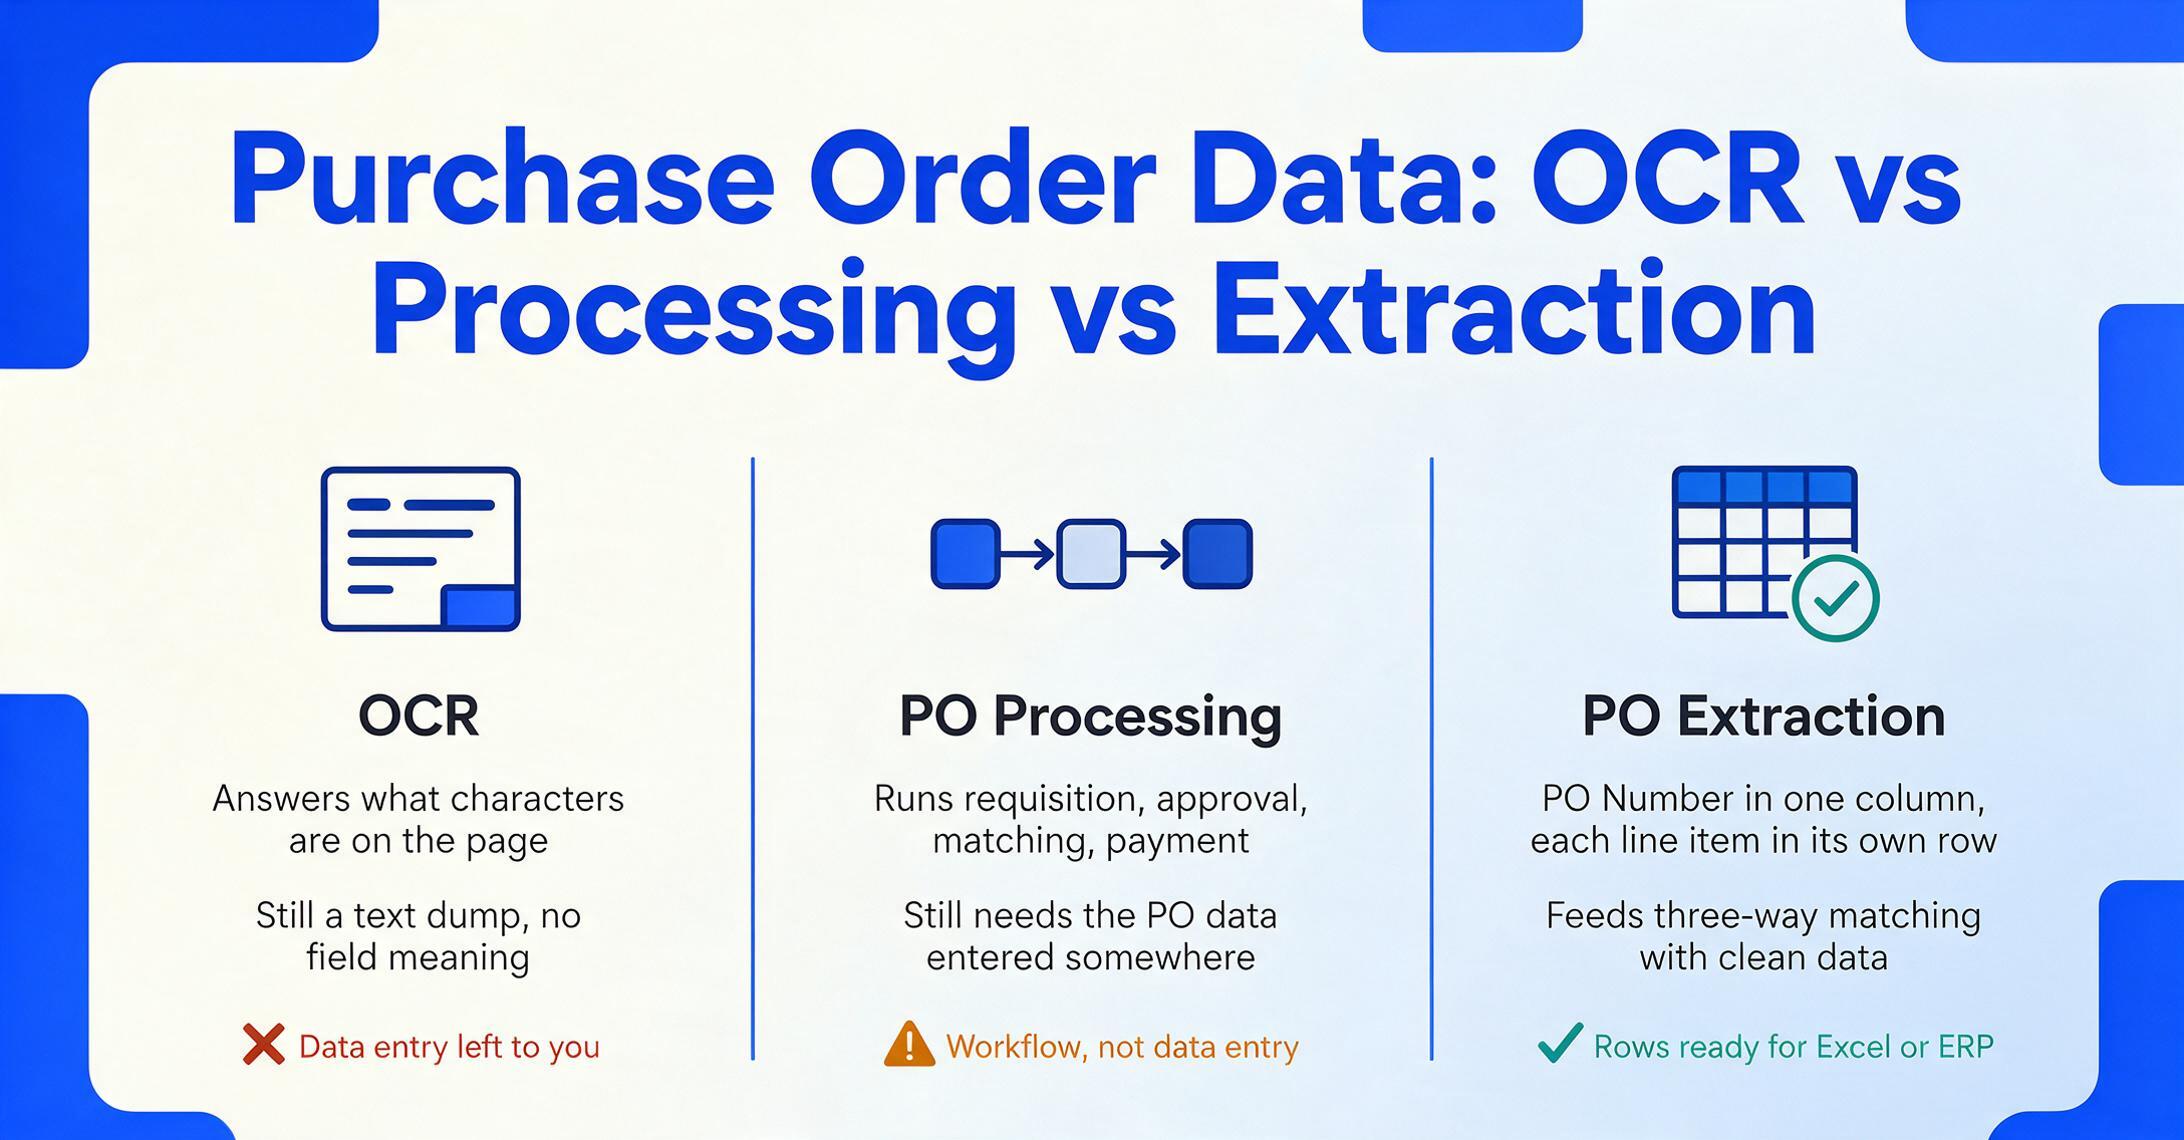
이 세 가지 용어는 조달 관련 대화에서 자주 함께 등장하지만, 이를 혼동하면 잘못된 문제를 해결하는 도구를 구매하게 됩니다.
OCR은 이미지 속 텍스트를 기계가 읽을 수 있는 문자로 변환합니다. "이 페이지에 어떤 문자가 있는가?"라는 질문에는 답하지만, 그 문자가 무엇을 의미하는지는 이해하지 못합니다. PO를 OCR에 넣으면 PURCHASE ORDER PO-2026-0412 DATE 12/04/2026 VENDOR Atlas Fasteners QTY 500 DESC M8 Hex Bolt UNIT $0.42 TOTAL $210.00 같은 결과가 나옵니다 — 즉 텍스트 덤프입니다. 각 필드를 수동으로 추출하여 올바른 셀에 입력해야 합니다. OCR은 문자를 디지털화했을 뿐, 데이터 입력을 수행한 것은 아닙니다.
PO 처리는 추출을 둘러싼 전체 조달 워크플로우입니다: 요청서 작성, 승인 라우팅, 구매 주문 발행, 자재 수령, 송장 및 자재 수령증과 PO 매칭, 결제 일정 수립, 보관까지 포함합니다. SAP Ariba, Coupa, Oracle Procurement 같은 처리 도구는 워크플로우를 관리하지만, PO 데이터가 어딘가에서 시스템에 입력되어야 합니다. 그 입력 단계가 바로 추출입니다.
PO 데이터 추출은 PO 문서를 구조화된 필드로 변환하는 특정 단계입니다: PO 번호는 한 열에, 공급업체는 다른 열에, 각 라인 항목은 자체 행에, 합계는 Excel에서 합산할 수 있는 셀에 배치합니다. 이는 처리를 지원하는 데이터 입력 계층입니다. 세계적 수준의 조달 워크플로우 자동화를 갖추고 있어도, 추출 단계에서 잘못된 데이터 — 잘못된 수량, 불일치 품목 코드, 부정확한 합계 — 가 유입되면 워크플로우는 실수를 더 빠르게 자동화할 뿐입니다.
추출 오류의 하위 영향은 3자 매칭 실패입니다. Ardent Partners의 2025 AP 벤치마크에 따르면 최고 수준의 AP 팀은 송장 매칭 예외율 9%를 달성하며, 나머지 팀은 평균 22%입니다. PO 데이터 입력 오류로 추적되는 모든 불일치는 AP 담당자가 조달, 수령, 재무 부서를 조사하는 데 약 30분이 소요됩니다. PO 단계에서 추출을 올바르게 수행하면 매칭 단계에 도달하기 전에 이러한 예외를 방지할 수 있습니다.
PO 데이터 추출 작동 방식
인터페이스 뒤에서 추출은 지난 2년간 일어난 근본적인 변화, 즉 위치 기반 추출에서 의미 기반 추출로의 전환을 기반으로 실행됩니다.
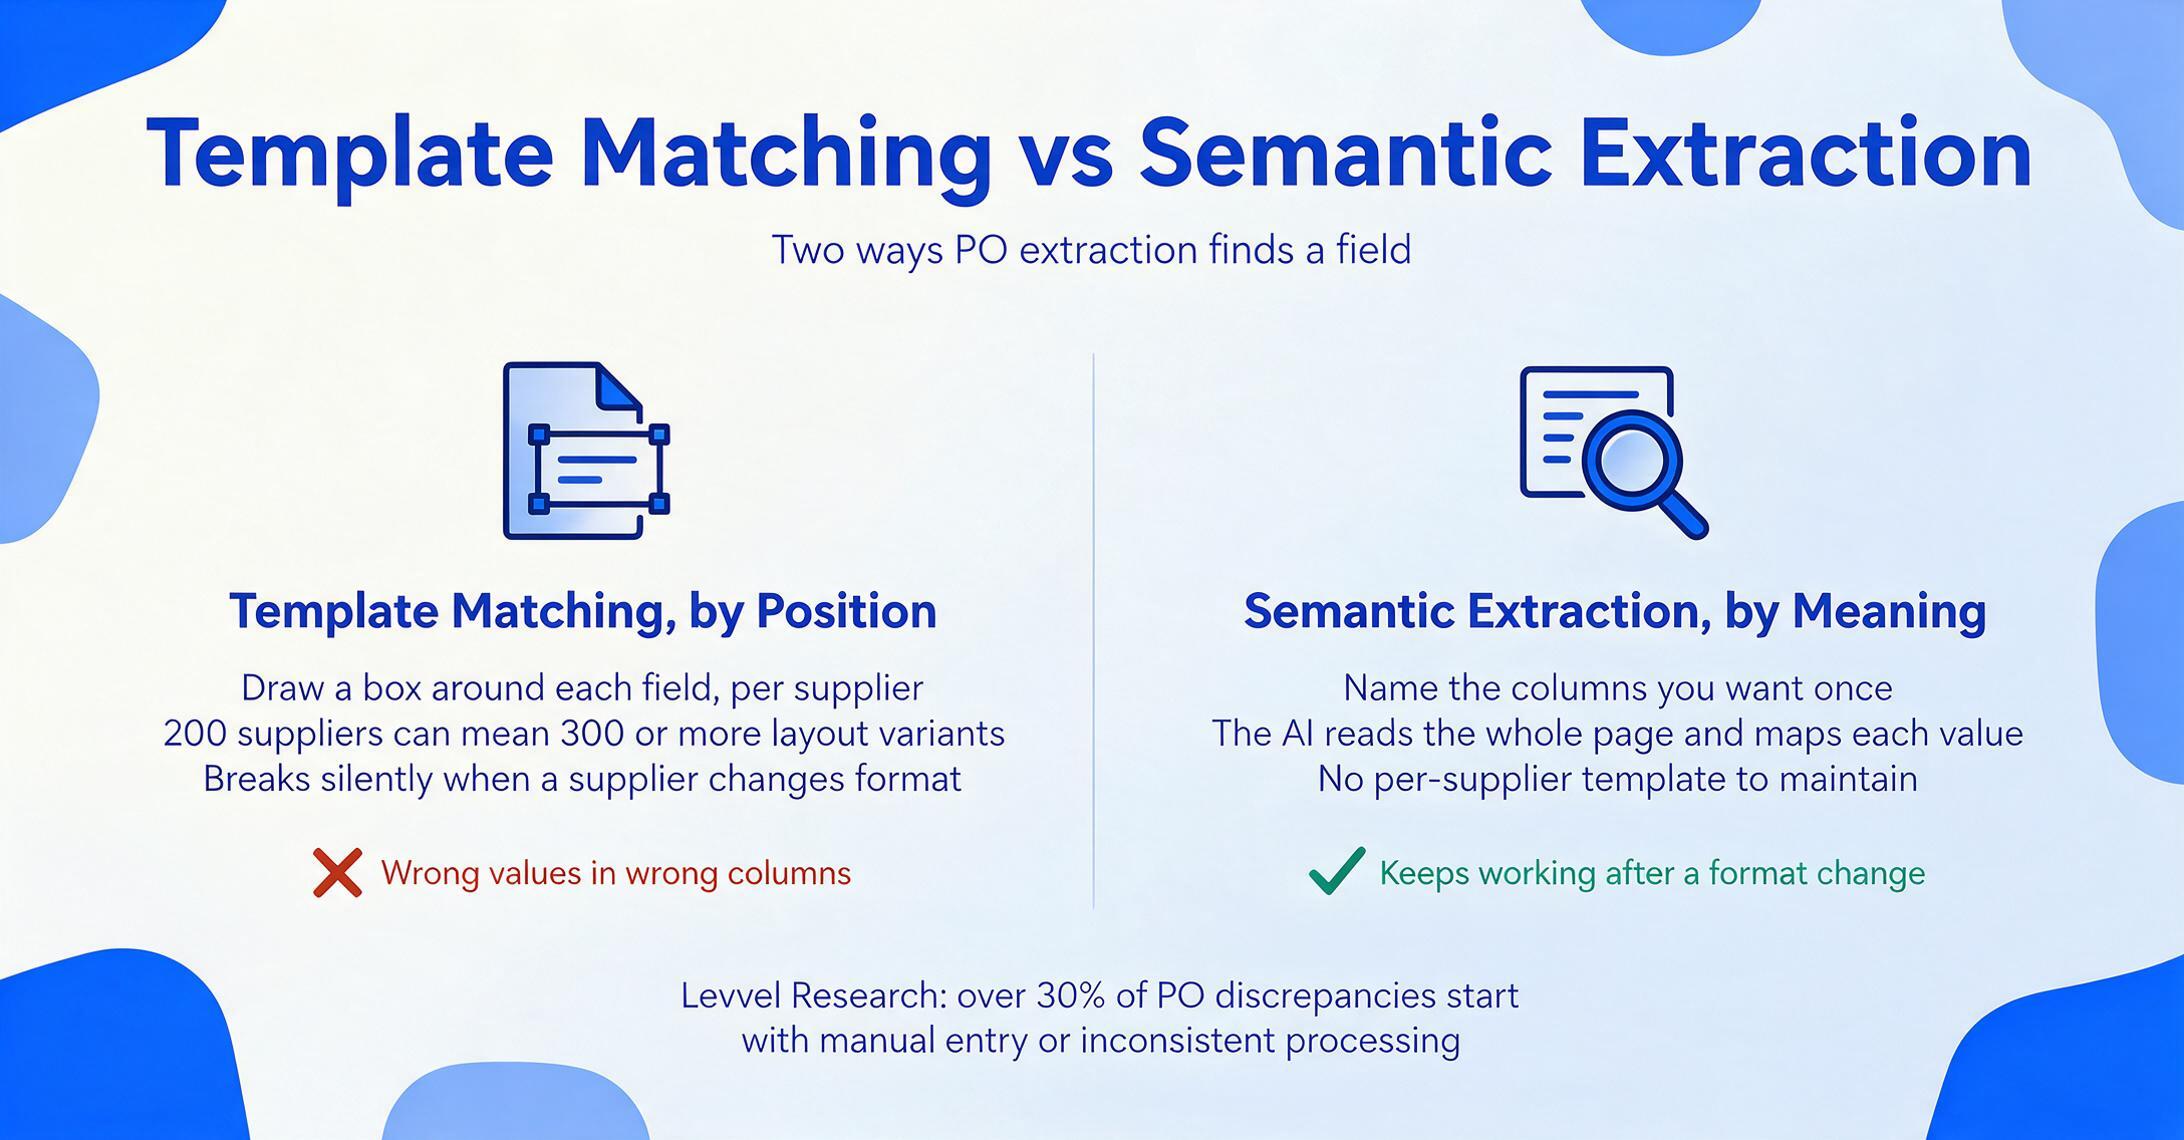
기존 방식 — 템플릿 매칭. 기존 PO 추출 도구는 위치 기반으로 작동합니다. 한 공급업체의 레이아웃에서 "PO 번호" 주위에 사각형을 그리고 시스템에 "값은 오른쪽에 있다"고 알려줍니다. 이 과정을 모든 공급업체, 모든 레이아웃 변형, 모든 필드에 대해 반복해야 합니다. 공급업체 200곳을 두는 중견 제조업체라면 300개 이상의 형식 변형을 처리해야 할 수 있습니다. 더 나쁜 것은, 공급업체가 PO 형식을 변경할 때 — ERP를 업그레이드하거나 브랜드를 바꿀 때마다 발생 — 템플릿이 조용히 깨지면서 잘못된 값을 잘못된 열에 넣기 시작한다는 점입니다. Levvel Research에 따르면 PO 불일치의 30% 이상이 수동 입력 또는 일관되지 않은 처리에서 비롯되며, 템플릿 기반 추출은 그 불일치를 고치지 않고 자동화할 뿐입니다.
현대적 방식 — 의미 기반 추출. 현대 AI 기반 추출은 위치가 아닌 의미로 작동합니다. 각 필드가 어디에 있는지 시스템을 훈련시키는 대신, 찾고자 하는 것을 지정합니다: "PO 번호," "공급업체 이름," "품목 설명," "수량," "단가," "라인 합계." AI는 문서 전체를 읽고 각 텍스트 조각이 문맥에서 무엇을 의미하는지 이해한 다음, 페이지의 어디에 나타나든 올바른 출력 열에 매핑합니다. 이것이 맞춤 열 추출입니다: 원하는 출력 열을 정의하면 AI가 각 필드의 의미를 이해하여 페이지 어디에서든 일치하는 데이터를 찾습니다. 한 공급업체 문서에서 "PO #"로, 다른 공급업체 문서에서 "Order Reference"로 표시된 필드는 AI가 라벨 텍스트가 아닌 의미적 역할을 이해하기 때문에 동일한 것으로 인식됩니다.
전체 파이프라인은 다음과 같습니다:
업로드
PDF, 스캔본, 사진을 드롭하세요 — 단일 PO 또는 50개 배치. 공급업체별 사전 분류, 파일명 변경, 가독성 외의 형식 요구사항 없음. 각 문서는 텍스트가 아닌 시각적 이미지로 수신됩니다 — AI는 사람이 읽는 방식대로 레이아웃, 글꼴, 표, 공백을 인식합니다.
열 정의
추출하려는 필드 이름을 입력하세요 — "PO 번호," "공급업체," "품목 코드," "설명," "수량," "단가," "라인 합계." 이 이름들이 출력 스프레드시트의 헤더가 됩니다. 템플릿 설정, 학습 데이터, 영역 지정 없음. AI가 위치가 아닌 의미로 매핑하므로 동일한 열 목록이 모든 공급업체 형식에서 작동합니다.
AI 읽기 및 매핑
비전 모델이 각 페이지를 스캔하고, 의미적 역할을 이해하여 어떤 텍스트 블록이 어떤 필드에 해당하는지 식별한 후 열에 매핑합니다. 품목 설명 옆의 수량 "500"은 PO 번호가 아닌 라인 품목 수량으로 인식됩니다. "Ship To" 주소 블록은 유사한 주소 구조를 포함하더라도 주변 맥락에 따라 "Bill To" 블록과 구분됩니다. 페이지 나누기에 걸친 라인 품목은 연속된 행으로 조합됩니다.
구조화된 데이터 내보내기
Excel(XLSX), CSV 또는 JSON으로 다운로드하세요. 각 PO는 헤더 테이블에서 한 행을 차지하고, 라인 품목은 필터링 및 피벗 테이블용으로 PO 헤더 필드가 반복된 별도의 행으로 확장됩니다. 또는 결과를 Google Sheets에 직접 작성하세요. 데이터는 사전 형식화되어 있습니다 — 날짜는 YYYY-MM-DD, 금액은 일반 숫자 — QuickBooks, NetSuite 또는 ERP로 가져올 때 재형식화가 필요 없습니다.
파일은 안전하게 처리되며 저장되지 않습니다.
PO 데이터 추출이 필요한 경우
모든 비즈니스에 추출이 필요한 것은 아닙니다. 한 달에 같은 세 공급업체에 PO 5건을 발행하는 소규모 업체라면 커피 한 잔 마시는 동안 스프레드시트에 직접 입력할 수 있습니다. 추출이 가치를 갖는 시점은 수량과 다양성이 임계점을 넘어 수동 입력이 단순한 불편함이 아니라 공급업체, 부서, 월별로 누적되는 비용이 되기 시작할 때입니다.
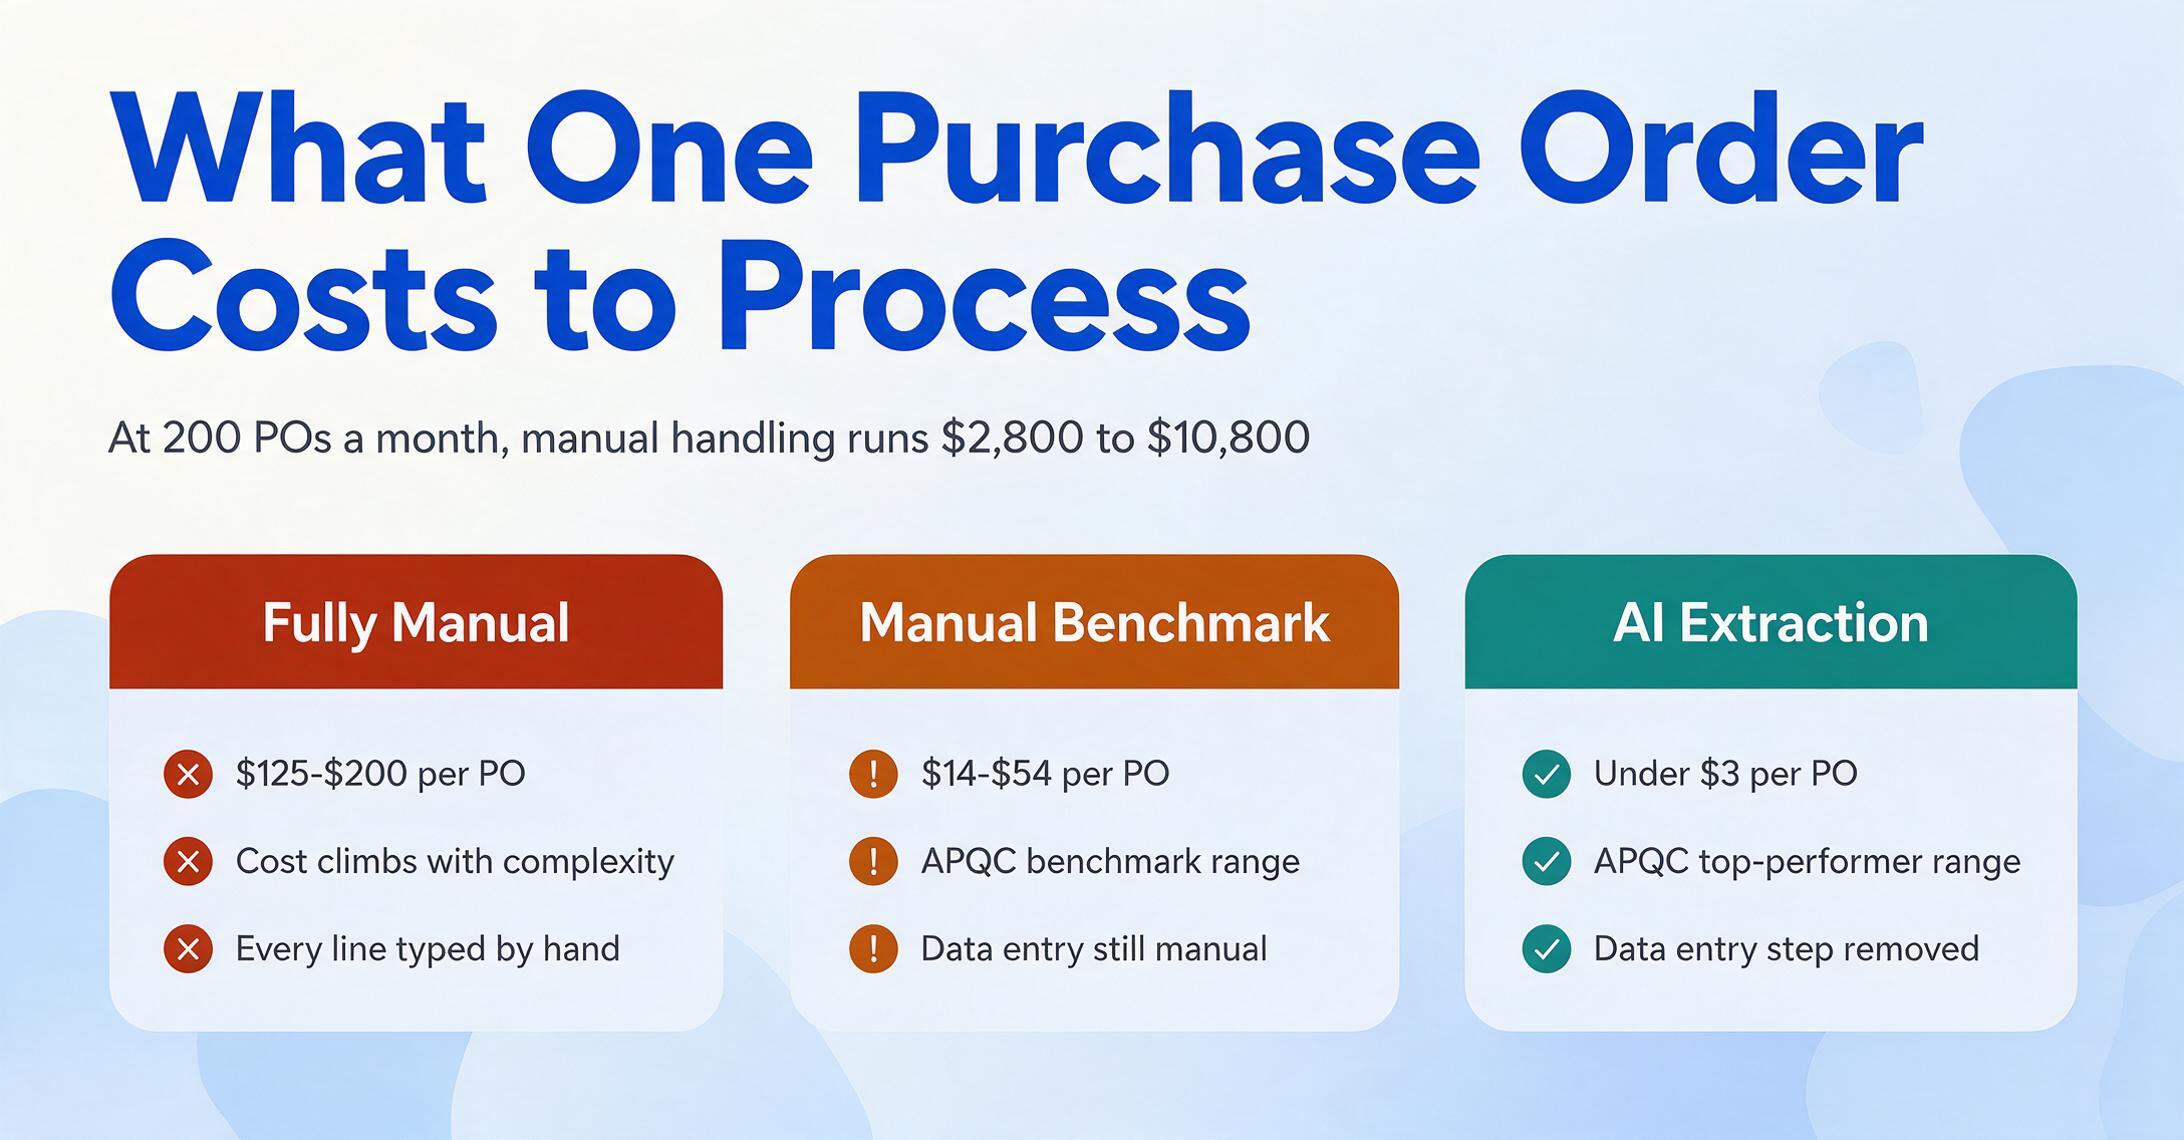
1. PO 물량이 인력 규모를 초과합니다. CAPS Research 데이터에 따르면 산업 부문에서 조달 지출은 매출의 평균 55.64%를 차지합니다. 즉, 매출 $50M 규모의 제조업체는 약 $27.8M이 구매 주문을 통해 흐릅니다. APQC 벤치마크에 따르면 수동 PO 처리 비용은 PO당 $14~$54이며, 완전 수동 프로세스는 복잡도에 따라 PO당 $125~$200에 달합니다. 월 200건의 PO 기준으로 단일 인보이스 매칭 전에 월 $2,800~$10,800의 처리 비용이 발생합니다. 자동화된 추출은 데이터 입력 단계를 제거함으로써 PO당 비용을 APQC가 최고 성과 기업 기준으로 벤치마킹한 $3 미만 범위로 낮춥니다.
2. 공급업체마다 PO 형식이 다릅니다. 이것은 보편적인 조달 현실입니다. 두 공급업체가 모두 SAP를 사용하더라도 관리자가 서로 다른 출력 템플릿을 구성했기 때문에 생성되는 PO는 전혀 다르게 보입니다. 한 곳은 PO 번호 형식으로 "PO-2026-XXXX"를 사용하고, 다른 곳은 접두사 없이 6자리 숫자를 사용합니다. 한 곳은 라인 항목을 테두리 표로 표시하고, 다른 곳은 표 구조가 없는 들여쓰기 텍스트 블록을 사용합니다. 한 곳은 라인 항목별로 납품 날짜를 포함하고, 다른 곳은 헤더에 단일 선적 날짜를 넣습니다. 템플릿 기반 도구는 이러한 다양성 앞에서 한계를 드러냅니다. 의미론적 추출은 형식에 전혀 의존하지 않습니다. 이것이 한 번 설정하면 끝인 도구와 계속 유지보수해야 하는 도구의 차이입니다. 이 워크플로우에 대한 실습 가이드는 구매 주문 데이터 입력 자동화 문서를 참조하세요.
3. 헤더 합계가 아닌 라인 항목 세부 정보가 필요합니다. 많은 추출 도구는 PO 번호, 날짜, 공급업체, 합계와 같은 헤더 필드를 잘 처리합니다. 그러나 입고 확인, 재고 조정 또는 3자 매칭을 위해 라인 항목이 필요하다면 도구 요구 사항이 더 엄격해집니다. 3페이지 분량의 PO에서 50개 라인 항목을 여전히 수동으로 입력해야 하는 헤더 전용 추출은 실제로 데이터 입력 문제를 해결한 것이 아닙니다. 이것이 가장 흔한 발견 지점입니다. 팀은 현재 프로세스가 필드의 20%만 자동화하지만 데이터 포인트의 80%는 라인 항목에 있다는 것을 깨닫게 됩니다.
4. PO 데이터 오류가 3자 매칭 실패로 이어집니다. PO에 수량, 단가 또는 UOM이 데이터 입력 시 잘못 기록되면, 이후 매칭 단계 — PO를 입고 확인서 및 공급업체 송장과 비교하는 과정 — 에서 불일치가 발생합니다. 각 불일치 항목은 수동 조사가 필요합니다. PO가 잘못 입력되었나? 공급업체가 다른 수량을 배송했나? 송장에 주문하지 않은 항목이 청구되었나? 근본 원인이 PO 데이터 입력 오류라면, 3초 만에 만들어진 문제를 발견하는 데 30분을 소비하는 셈입니다. PO 단계에서 추출 정확성을 개선하면 이러한 예외가 매칭 대기열에 도달하는 것을 방지할 수 있습니다. 이 역학에 대한 자세한 내용은 조달에서 3자 매칭이 실패하는 이유에 대한 기사를 참조하세요.
PO 추출 도구에서 찾아야 할 것
추출 도구는 기본 OCR 래퍼부터 AI 기반 플랫폼까지 다양합니다. 기능 목록은 모두 비슷해 보이지만, 일상적인 조달 사용에서 실제로 차별화되는 기준은 다음과 같습니다. 필드별 전체 참조 — 헤더 필드, 라인 항목, 내보내기 형식 및 완전한 선택 프레임워크 — 는 구매 주문 추출에 대한 전체 가이드에서 시작하세요.
템플릿 불필요. 이것이 가장 중요한 차별화 요소입니다. 공급업체 형식별로 구문 분석 템플릿을 만들고 유지 관리해야 하는 도구는 추출이 아니라 템플릿 관리에 추출이 부수적으로 포함된 것입니다. 공급업체에 물어봐야 할 올바른 질문: "공급업체가 내일 PO 레이아웃을 변경하면 어떻게 해야 하나요?" 답변에 템플릿 업데이트, 모델 재학습 또는 필드 재매핑이 포함된다면 유지 관리 부담을 사는 것입니다. 대안은 맞춤 열 추출입니다. 원하는 필드 이름을 한 번 입력하면 AI가 의미로 읽기 때문에 모든 공급업체 형식에서 해당 필드를 찾습니다. 입력한 열 이름이 출력 헤더가 됩니다. 이 차이가 중요한 이유에 대해 자세히 알아보려면 구매 주문 필드를 Excel로 추출에 대해 읽어보세요.
페이지 나눔을 넘어선 라인 항목 추출 품질. 헤더 필드를 안정적으로 추출하는 도구는 기본입니다. 라인 항목 — 특히 일관되지 않은 열 레이아웃과 UOM 변형이 있는 다중 페이지 PO에서 — 이 진정한 테스트입니다. 설명 열에 병합된 셀이 있고 수량이 여러 배송 날짜에 분산된, 2~4페이지에 걸친 30행 라인 항목 테이블이 있는 4페이지 PO로 도구를 테스트해 보세요. 이를 깔끔하게 처리한다면 다른 모든 것도 처리할 수 있습니다.
일괄 처리 기능. 20개 공급업체의 PO 50개를 한 번에 업로드하고 통합된 단일 스프레드시트를 받을 수 있나요? 아니면 하나씩 처리해야 하나요? 일괄 처리는 "이 도구는 PO당 시간을 절약해 준다"와 "이 도구는 하루에 몇 시간을 절약해 준다"의 차이입니다. 출력은 모든 PO가 병합된 단일 테이블 — 동일한 열, 동일한 구조 — 이어야 하며 분석, 매칭 또는 가져오기에 바로 사용할 수 있어야 합니다. 이 워크플로에 대한 자세한 내용은 Excel로 PO 일괄 추출 가이드를 참조하세요.
출력 형식 및 통합. 출력은 조달 워크플로와 일치해야 합니다. 모든 것을 Excel로 처리한다면, 올바르게 유형화된 열이 있는 XLSX 내보내기는 필수입니다. 팀이 Google Sheets에서 작업한다면 결과를 시트에 직접 작성하는 도구 — 업로드-다운로드-가져오기 주기를 제거하는 — 가 차이를 만듭니다. 전용 PO 추출용 Google Sheets 애드온을 사용하면 스프레드시트를 벗어나지 않고 PO를 처리할 수 있습니다. NetSuite, QuickBooks 또는 맞춤 ERP에 데이터를 공급하는 경우 CSV와 JSON이 중요합니다.
실제 PO 엣지 케이스 처리. 하나의 PO가 여러 자재 수령을 생성하는 부분 선적. 단위 불일치 — PO는 "케이스" 단위로 주문하지만 라인 항목은 "케이스당 단위"를 지정하는 경우. 헤더에 표시되지만 원가 회계를 위해 라인 항목에 배분해야 하는 세금 및 배송비. 수개월간의 납품과 변동 가격을 포함하는 포괄 PO. PO의 95%를 처리하지만 약간 특이한 5%에서 조용히 실패하는 도구는 한계를 솔직히 인정하는 도구보다 더 큰 위험을 만듭니다. 가장 복잡한 PO — 포괄 주문, 이중 통화를 사용하는 해외 공급업체 PO, 소규모 공급업체의 수기 표시 PO — 로 도구를 테스트하세요. 가장 깔끔한 PO가 아니라요.
자주 묻는 질문
PO 추출은 손으로 작성된 구매 주문서에서도 작동하나요?
네, 단, 조건이 있습니다. 비전 기반 모델을 사용하는 최신 AI 추출 도구는 구매 주문서의 손글씨를 읽을 수 있습니다. 여기에는 손으로 쓴 수량, 수동 수정 사항, 직접 기입한 양식 필드가 포함됩니다. 정확도는 손글씨의 가독성에 따라 달라집니다. 또박또박 쓴 인쇄체는 90% 이상 추출되지만, 저품질 스캔의 빽빽한 필기체는 정확도가 더 낮아집니다. 여기서 의미 기반 추출의 핵심 장점은 AI가 필드 맥락을 사용해 모호성을 해소한다는 점입니다. "수량"을 찾는 중에 옆에 타자로 입력된 "500"과 손으로 쓴 "520"이 모두 보이면, AI가 실제 주문 수량이 무엇인지 추론할 수 있습니다. 종이 양식을 작성하는 소규모 공급업체에서 흔히 볼 수 있는 완전히 손으로 작성된 PO의 경우, 추출 정확도는 인보이스 추출과 비슷합니다. 검토에는 충분하지만 완전 자동화에는 부족합니다. 이 시나리오에 대한 자세한 내용은 손으로 작성된 구매 주문서 추출 가이드를 참조하세요.
PO 추출은 여러 페이지에 걸친 라인 항목을 처리할 수 있나요?
네, 이는 최신 AI 추출의 핵심 기능입니다. 라인 항목 테이블이 페이지 경계를 넘어 끊어지는 경우, AI는 테이블이 다음 페이지에서 계속된다는 것을 식별하고 행을 연속된 레코드로 다시 조립합니다. 핵심 요구 사항은 열 머리글이 반복되거나 계속 페이지에서 시각적으로 유추 가능해야 한다는 것입니다. 두 번째 페이지에서 열 머리글이 완전히 사라지고 독자가 첫 페이지의 열 순서를 기억하는 데 의존한다면 정확도가 떨어질 수 있습니다. 이는 도구를 평가할 때 테스트해야 할 시나리오 중 하나입니다. 테이블이 여러 페이지에 걸쳐 있는 다중 페이지 PO를 가져와 2페이지 이후의 라인 항목이 올바른 열에 들어가는지 확인하세요.
측정 단위가 다른 경우에는 어떻게 하나요? 추출 시 정규화할 수 있나요?
AI 추출은 공급업체가 사용하는 모든 UOM("EA", "PCS", "Each", "CTN", "BOX", "KG", "LB")을 읽고 전용 UOM 열에 캡처할 수 있습니다. 그러나 UOM을 정규화하는 작업은 품목별로 변환 계수가 다르기 때문에 다운스트림 로직이 필요합니다. 추출 도구는 PO에 명시된 내용을 캡처합니다. "3 Cases × 24 Units/Case = 72 Units" 변환은 추출 후에 이루어지는 계산 단계입니다. 스프레드시트, ERP 또는 변환 공식을 한 번만 정의하면 되는 계산 열을 통해 수행할 수 있습니다. 추출 도구의 역할은 원시 값을 정확하게 캡처하여 정규화 단계에 깨끗한 입력값을 제공하는 것입니다.
PO 추출과 3자 매칭은 어떻게 다른가요?
PO 추출과 3자 매칭은 조달 프로세스에서 순차적인 단계이지 대안이 아닙니다. PO 추출은 데이터 입력 단계로, PO 문서를 구조화된 필드로 변환합니다. 3자 매칭은 검증 단계로, 추출된 PO 데이터를 입고 확인서 및 공급업체 인보이스와 비교하여 주문한 것, 수령한 것, 청구된 것이 모두 일치하는지 확인합니다. 추출이 먼저 이루어집니다. 추출된 PO 데이터가 잘못된 경우, 3자 매칭은 잘못된 불일치로 실패하고 누군가 조사해야 합니다. PO 단계에서 추출을 정확하게 수행하는 것이 완전 자동화된 3자 매칭을 가능하게 만드는 핵심입니다. 이러한 요소들이 어떻게 맞물리는지에 대한 자세한 내용은 제조업의 PO-인보이스 매칭 분석을 읽어보세요.
PO 데이터를 ERP로 직접 추출할 수 있나요?
대부분의 추출 도구는 모든 ERP에서 가져올 수 있는 Excel, CSV 또는 JSON 형식으로 출력합니다. 일반적인 워크플로는 다음과 같습니다: PO 데이터 추출 → 출력 검토 → 파일을 ERP(QuickBooks, NetSuite, SAP, Microsoft Dynamics)로 가져오기. 장점은 데이터가 사전 형식화된 상태로 도착한다는 것입니다 — 날짜는 YYYY-MM-DD, 금액은 소수점 두 자리의 일반 숫자, 품목 코드는 텍스트로 — 따라서 추출과 가져오기 사이에 재형식화가 필요 없습니다. 일부 도구는 API를 통한 직접 ERP 통합을 제공하지만, CSV/Excel 가져오기 경로는 사실상 모든 시스템에서 작동하며 IT 설정이 필요 없습니다. 단계별 안내는 구매 주문서를 Excel로 변환하는 방법 가이드를 참조하세요.
PO 추출은 어떤 파일 형식과 문서 유형을 지원하나요?
최신 추출 도구는 PDF, JPG, PNG, WebP를 지원합니다. PDF는 보편적인 형식입니다 — 대부분의 공급업체 PO는 PDF 이메일 첨부 파일로 도착합니다. 종이 PO의 휴대폰 사진도 이미지가 충분히 선명하고 조명이 밝으면 작동합니다. 일부 도구는 AVIF와 TIFF도 지원합니다. PO가 이메일 첨부 파일(PDF), 공급업체 포털, 전시회에서 구매자 휴대폰으로 찍은 사진(JPG), 기존 종이 PO 등 여러 채널을 통해 도착하기 때문에 형식 유연성이 중요합니다. 한 형식만 처리하는 도구는 추출 전에 모든 것을 사전 변환해야 합니다. 유사한 추출 패턴을 따르는 다른 문서 유형은 인보이스 데이터 추출이란 무엇인가 및 영수증 OCR이란 무엇인가 가이드를 참조하세요.
다음 단계
PO 데이터 추출은 두 가지 조달 현실의 교차점에 있습니다: 공급업체 형식 다양성이라는 보편적 문제와 깨끗한 PO 데이터에 대한 3자 매칭의 하류 의존성입니다. 오늘날에는 공급업체별 템플릿 설정 없이도 형식과 공급업체를 넘어 PO 데이터를 안정적으로 추출할 수 있는 도구가 존재합니다 — 이는 불과 2년 전만 해도 불가능했던 일입니다. 조달 지출이 매출의 55.64%에 달한다는 CAPS Research 데이터는 구매 주문을 통해 얼마나 많은 돈이 흐르는지 강조하며, 수동 처리와 자동 처리 간 PO당 $11–$51 격차를 보여주는 APQC 벤치마크는 ROI 사례를 구체적으로 만듭니다.
추출이 워크플로우에 맞는지 평가하는 가장 좋은 방법은 실제 구매 주문으로 테스트하는 것입니다 — 이상적으로는 최대 거래량의 공급업체와 가장 복잡한 PO를 혼합하여 사용하는 것입니다. 가장 어려운 사례를 깨끗하게 처리한다면 쉬운 사례는 당연히 처리됩니다. 문서 유형 전반에 걸친 AI 추출에 대한 더 넓은 관점을 보려면 AI 문서 추출 기초 가이드부터 시작하세요. 또는 실제 구매 주문에서 추출이 어떻게 작동하는지 확인할 준비가 되었다면 샘플을 업로드하고 지금 시도해 보세요.