O que é Extração de Dados de Pedido de Compra?
Automatizando o Processamento de PO
A extração de dados de pedido de compra é o processo automatizado de ler campos-chave — como número do PO, fornecedor, endereço de entrega, itens de linha (código do item, descrição, quantidade, preço unitário, total da linha) e valor total — de um PO em PDF ou digitalizado e gerá-los como dados estruturados em uma planilha. Não é o mesmo que rodar OCR em um PO — o OCR entrega um bloco de texto. A extração entrega uma tabela com cada campo em sua própria coluna, pronta para conciliação, análise ou importação para o ERP.
Principais Conclusões
- $14 a $200 — é quanto custa processar manualmente um pedido de compra, e nada desse dinheiro faz algo que você não poderia automatizar com um único upload.
- Quando um fornecedor muda o layout do PO, ferramentas baseadas em modelo colocam silenciosamente valores errados nas colunas certas — e cada falha de conciliação de três vias resultante leva 30 minutos para ser resolvida.
- Defina suas colunas uma vez por nome — Número do PO, Código do Item, Quantidade — e a extração semântica lê o formato de cada fornecedor pelo significado em vez da posição, sem nenhum modelo para criar ou manter.
O que a Extração de Dados de PO Realmente É
A extração de pedidos de compra é a etapa específica que transforma o documento de PO de um fornecedor — seja um anexo em PDF, um scan enviado por e-mail ou uma foto tirada do celular de um comprador — em campos de dados estruturados com os quais você pode realmente trabalhar. Não é o mesmo que automação de PO, que gerencia todo o fluxo de compras (requisição, aprovações, envio, conciliação de três vias, pagamento). A extração é a camada de entrada de dados: a ponte entre "um arquivo de PO na sua caixa de entrada" e "linhas na sua planilha ou ERP".
Os campos normalmente extraídos de um pedido de compra se dividem em duas categorias:
Campos de Cabeçalho (um por PO)
- Número do PO
- Data do PO
- Nome e Endereço do Fornecedor
- Endereço de Cobrança / Entrega
- Nome do Comprador / Departamento
- Condições de Pagamento
- Subtotal, Imposto, Frete, Total
Itens de Linha (várias linhas por PO)
- Código do Item / SKU
- Descrição
- Quantidade
- Unidade de Medida (UOM)
- Preço Unitário
- Total da Linha
- Data de Entrega (por linha)
Os itens de linha são onde a extração fica difícil. Um campo de cabeçalho é um valor único. Uma tabela de itens de linha pode conter 20, 50 ou mais de 100 linhas — cada uma com seu próprio código de item, descrição, quantidade, UOM e preço — distribuídas em várias páginas com arranjos de colunas que mudam de um fornecedor para o outro. Um fornecedor usa "EA" para unidade de medida; outro usa "PCS"; um terceiro escreve "Each" por extenso. Um pedido de compra de um fornecedor industrial pode especificar datas de entrega por item de linha, enquanto um PO de varejo pode agrupar tudo sob uma única data de envio. Acertar os itens de linha — entre formatos, entre fornecedores, entre quebras de página — é o que separa uma extração utilizável de um resultado parcial que ainda precisa de limpeza manual.
É nessa lacuna que as ferramentas baseadas em modelo tropeçam. Se você configurou um modelo para o layout do Fornecedor A — "o Número do PO está nas coordenadas (50, 20), os itens de linha começam na linha 8" — ele funciona até o Fornecedor A mudar seu modelo de PO porque atualizou o ERP. Agora o número do PO está na posição (75, 30), e seu modelo extrai silenciosamente o valor errado para a coluna Número do PO. Multiplique isso por 50 fornecedores, e a manutenção de modelos se torna um trabalho em tempo integral. Para uma visão mais ampla de como a IA muda esse paradigma em todos os tipos de documento, veja nosso guia sobre o que a extração de documentos por IA realmente é.
Extração de PO vs Processamento de PO vs OCR — Principais Diferenças
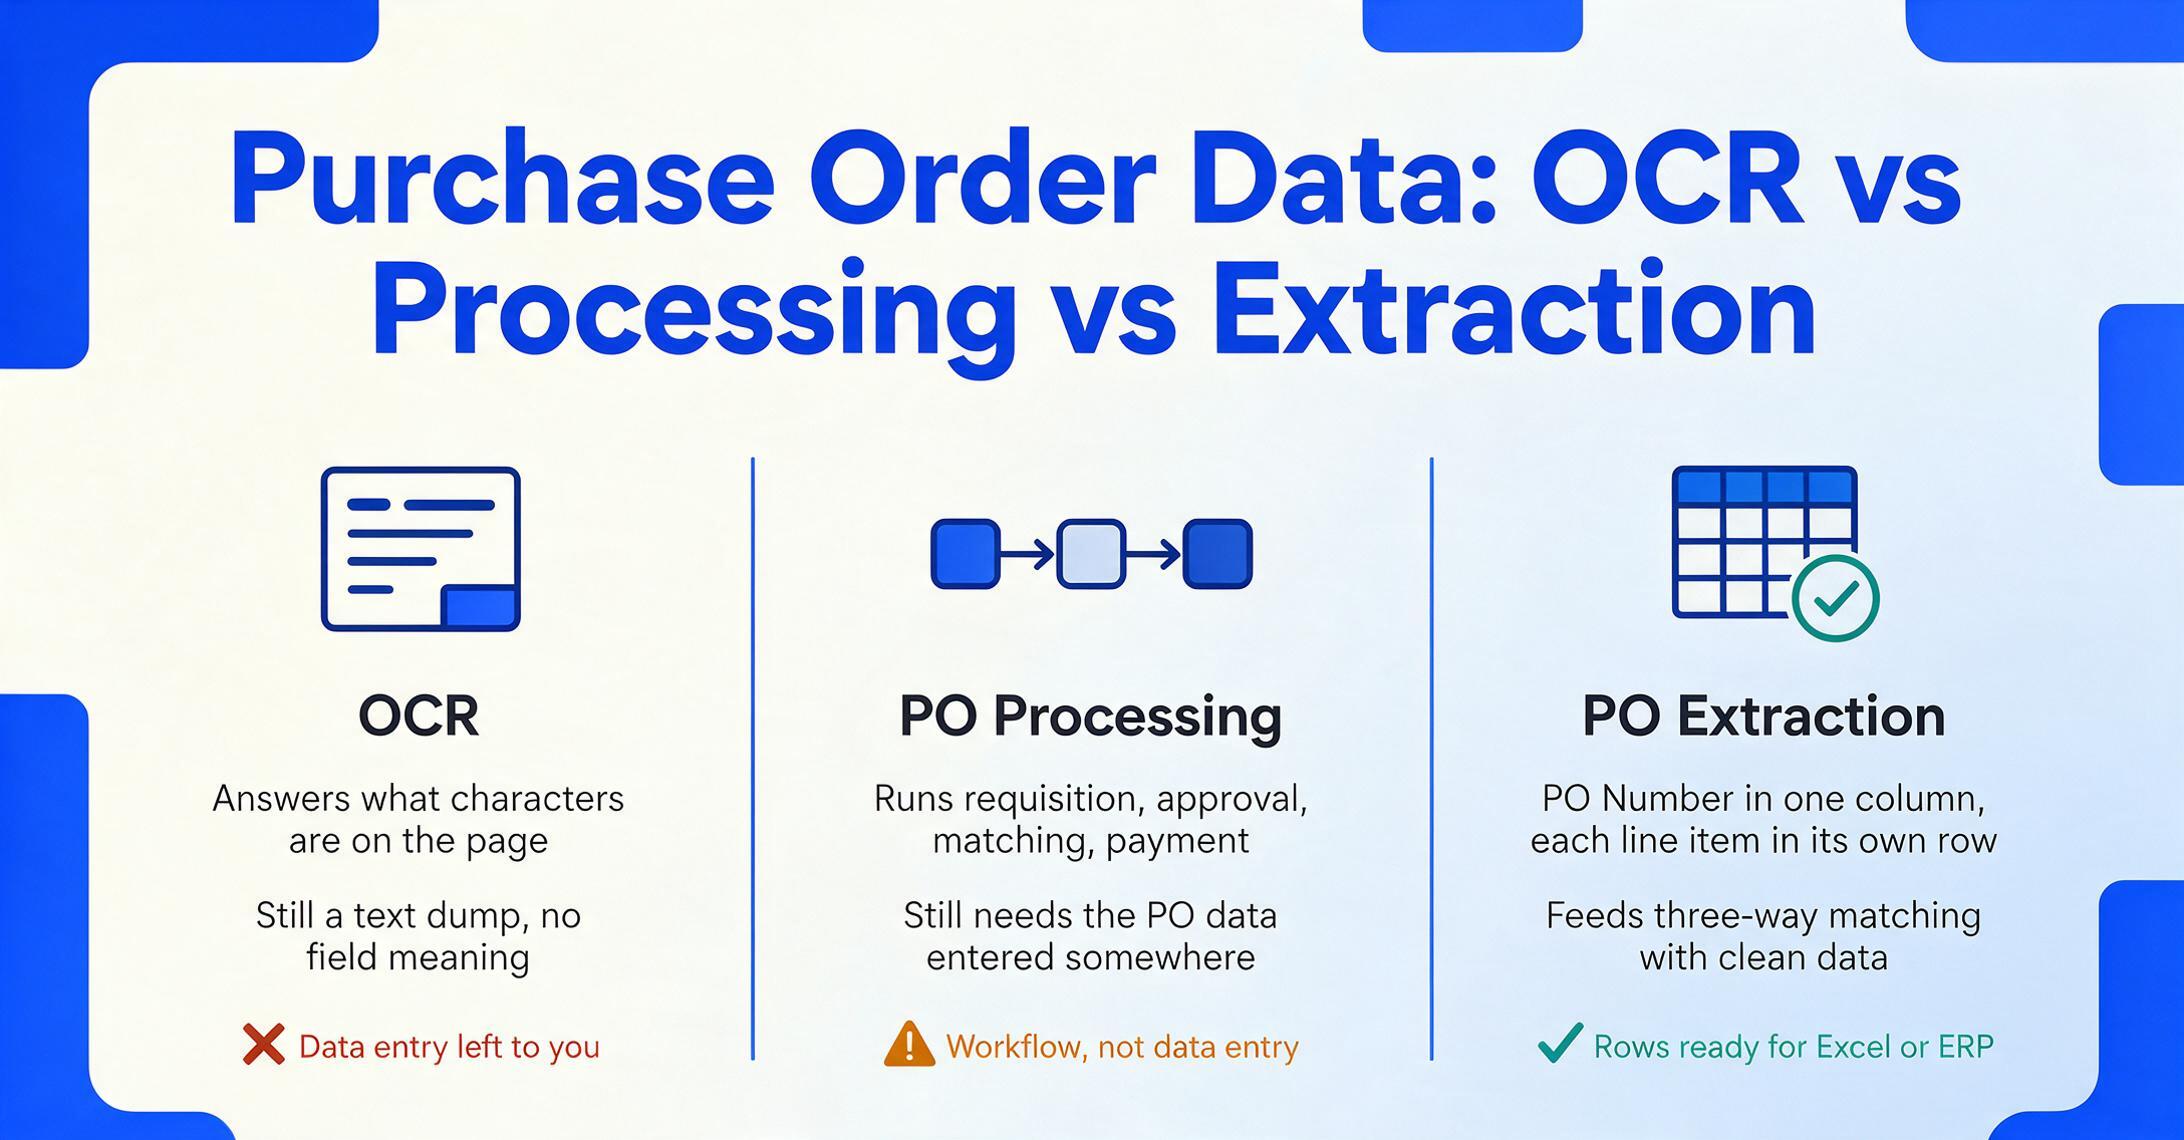
Esses três termos aparecem em conversas adjacentes de compras, mas confundi-los leva à compra de ferramentas que resolvem o problema errado.
OCR (Optical Character Recognition) converte uma imagem de texto em caracteres legíveis por máquina. Ele responde "quais caracteres estão nesta página?", mas não tem noção do que esses caracteres significam. Passe um PO pelo OCR e você recebe algo como PURCHASE ORDER PO-2026-0412 DATE 12/04/2026 VENDOR Atlas Fasteners QTY 500 DESC M8 Hex Bolt UNIT $0.42 TOTAL $210.00 — um despejo de texto. Você ainda precisa extrair manualmente cada campo e digitá-lo na célula correta. O OCR digitalizou os caracteres. Ele não fez a entrada de dados.
Processamento de PO é o fluxo de trabalho completo de compras que envolve a extração: criar a requisição, encaminhá-la para aprovação, emitir o pedido de compra, receber as mercadorias, conciliar o PO com a fatura e o recebimento de mercadorias (conciliação de três vias), agendar o pagamento e arquivar. Ferramentas de processamento como SAP Ariba, Coupa ou Oracle Procurement gerenciam o fluxo de trabalho — mas ainda precisam que os dados do PO entrem no sistema em algum lugar. Essa etapa de entrada é a extração.
Extração de dados de PO é a etapa específica que transforma um documento de PO em campos estruturados: Número do PO em uma coluna, Fornecedor em outra, cada item de linha em sua própria linha, o total em uma célula que o Excel pode somar. É a camada de entrada de dados que alimenta o processamento. Você pode ter automação de fluxo de trabalho de compras de classe mundial, mas se a etapa de extração estiver alimentando-a com dados errados — quantidades erradas, códigos de item incompatíveis, totais incorretos — o fluxo de trabalho apenas automatiza os erros mais rápido.
A consequência downstream dos erros de extração é a falha na conciliação de três vias. Os benchmarks de AP de 2025 da Ardent Partners relatam que equipes de AP de melhor desempenho alcançam uma taxa de exceção de 9% na conciliação de faturas — as demais têm média de 22%. Cada divergência que remonta a um erro de entrada de dados de PO custa a um analista de AP cerca de 30 minutos para investigar em compras, recebimento e finanças. Fazer a extração corretamente na etapa do PO evita essas exceções antes que cheguem à conciliação.
Como Funciona a Extração de Dados de PO
Por trás da interface, a extração se baseia em uma mudança fundamental ocorrida nos últimos dois anos: a transição da extração baseada em posição para a extração semântica.
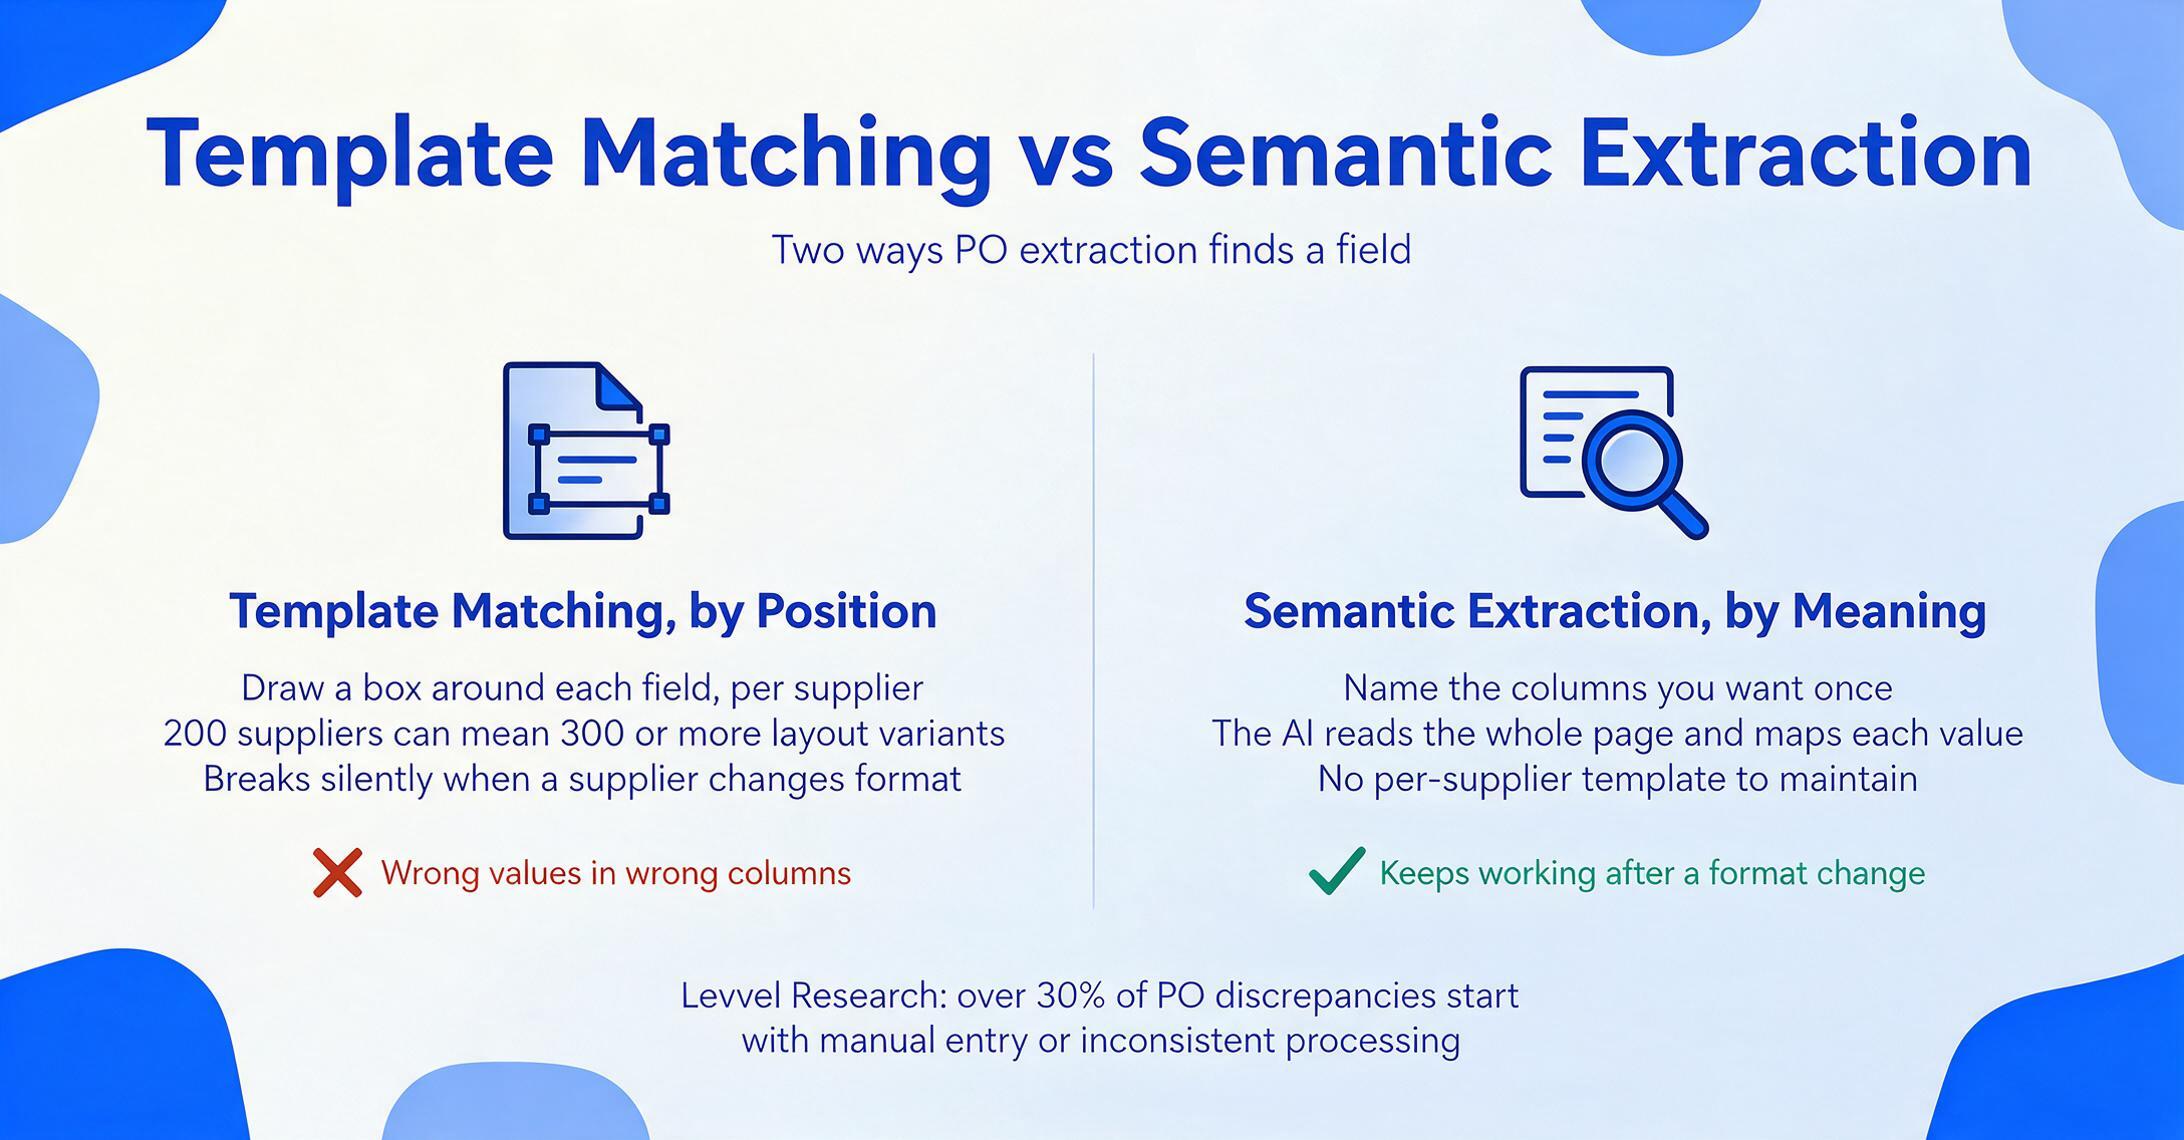
O método antigo — correspondência de modelo. As ferramentas tradicionais de extração de PO funcionam por posição. Você desenha um retângulo ao redor de "PO Number" no layout de um fornecedor e diz ao sistema "o valor está à direita". Você repete isso para cada fornecedor, cada variante de layout, cada campo. Um fabricante de médio porte com 200 fornecedores ativos pode enfrentar mais de 300 variantes de formato. Pior ainda, quando um fornecedor muda o formato do seu PO — o que acontece toda vez que ele atualiza seu ERP ou muda de marca — o modelo quebra silenciosamente e começa a puxar valores errados para colunas erradas. A Levvel Research descobriu que mais de 30% das discrepâncias de PO decorrem de entrada manual ou processamento inconsistente — e a extração baseada em modelo apenas automatiza essa inconsistência em vez de corrigi-la.
O método moderno — extração semântica. A extração moderna baseada em IA funciona por significado, não por posição. Em vez de treinar o sistema sobre onde cada campo fica, você especifica o que deseja encontrar: "PO Number", "Vendor Name", "Item Description", "Quantity", "Unit Price", "Line Total". A IA lê o documento inteiro, entende o que cada trecho de texto representa no contexto e o mapeia para a coluna de saída correta — independentemente de onde ele apareça na página. Isso é a Extração de Colunas Personalizadas: você define as colunas de saída que deseja, e a IA localiza os dados correspondentes em qualquer lugar da página entendendo o que cada campo significa. Um campo rotulado como "PO #" no documento de um fornecedor e "Order Reference" no de outro é reconhecido como a mesma coisa porque a IA entende o papel semântico, não o texto do rótulo.
Veja o fluxo completo de ponta a ponta:
Upload
Solte PDFs, digitalizações ou fotos — um único PO ou um lote de 50. Sem pré-organização por fornecedor, sem renomear, sem requisitos de formato além da legibilidade. Cada documento é recebido como imagem visual, não como texto — a IA vê o layout, as fontes, as tabelas e os espaços em branco como um leitor humano veria.
Definir Colunas
Digite os nomes dos campos que deseja extrair — "PO Number", "Vendor", "Item Code", "Description", "Quantity", "Unit Price", "Line Total". Eles se tornam os cabeçalhos da sua planilha de saída. Sem configuração de modelo, sem dados de treinamento, sem desenhar zonas. A mesma lista de colunas funciona em todos os formatos de fornecedor porque a IA mapeia por significado, não por posição.
A IA Lê e Mapeia
O modelo de visão examina cada página, identifica quais blocos de texto correspondem a quais campos ao entender seu papel semântico e os mapeia para suas colunas. Uma quantidade de "500" ao lado da descrição de um item é reconhecida como quantidade de item de linha, não como número de PO. Um bloco de endereço "Ship To" é distinguido de um bloco "Bill To" pelo contexto ao redor — mesmo quando ambos contêm estruturas de endereço semelhantes. Itens de linha que atravessam quebras de página são montados em linhas contínuas.
Exportar Dados Estruturados
Baixe como Excel (XLSX), CSV ou JSON. Cada PO recebe uma linha na tabela de cabeçalho; os itens de linha se expandem em linhas separadas com os campos do cabeçalho do PO repetidos para filtragem e tabelas dinâmicas. Ou grave os resultados diretamente no Google Sheets. Os dados já vêm pré-formatados — datas como YYYY-MM-DD, valores como números simples — então não há reformatação entre a extração e a importação no QuickBooks, NetSuite ou no seu ERP.
Os arquivos são processados com segurança e não são armazenados.
Quando Você Precisa de Extração de Dados de PO
Nem toda empresa precisa de extração. Uma operação pequena que emite cinco POs por mês para os mesmos três fornecedores pode digitá-los em uma planilha durante uma pausa para o café. A extração vale a pena quando o volume e a variedade cruzam um limiar em que a entrada manual deixa de ser um pequeno incômodo e começa a se acumular entre fornecedores, departamentos e meses.
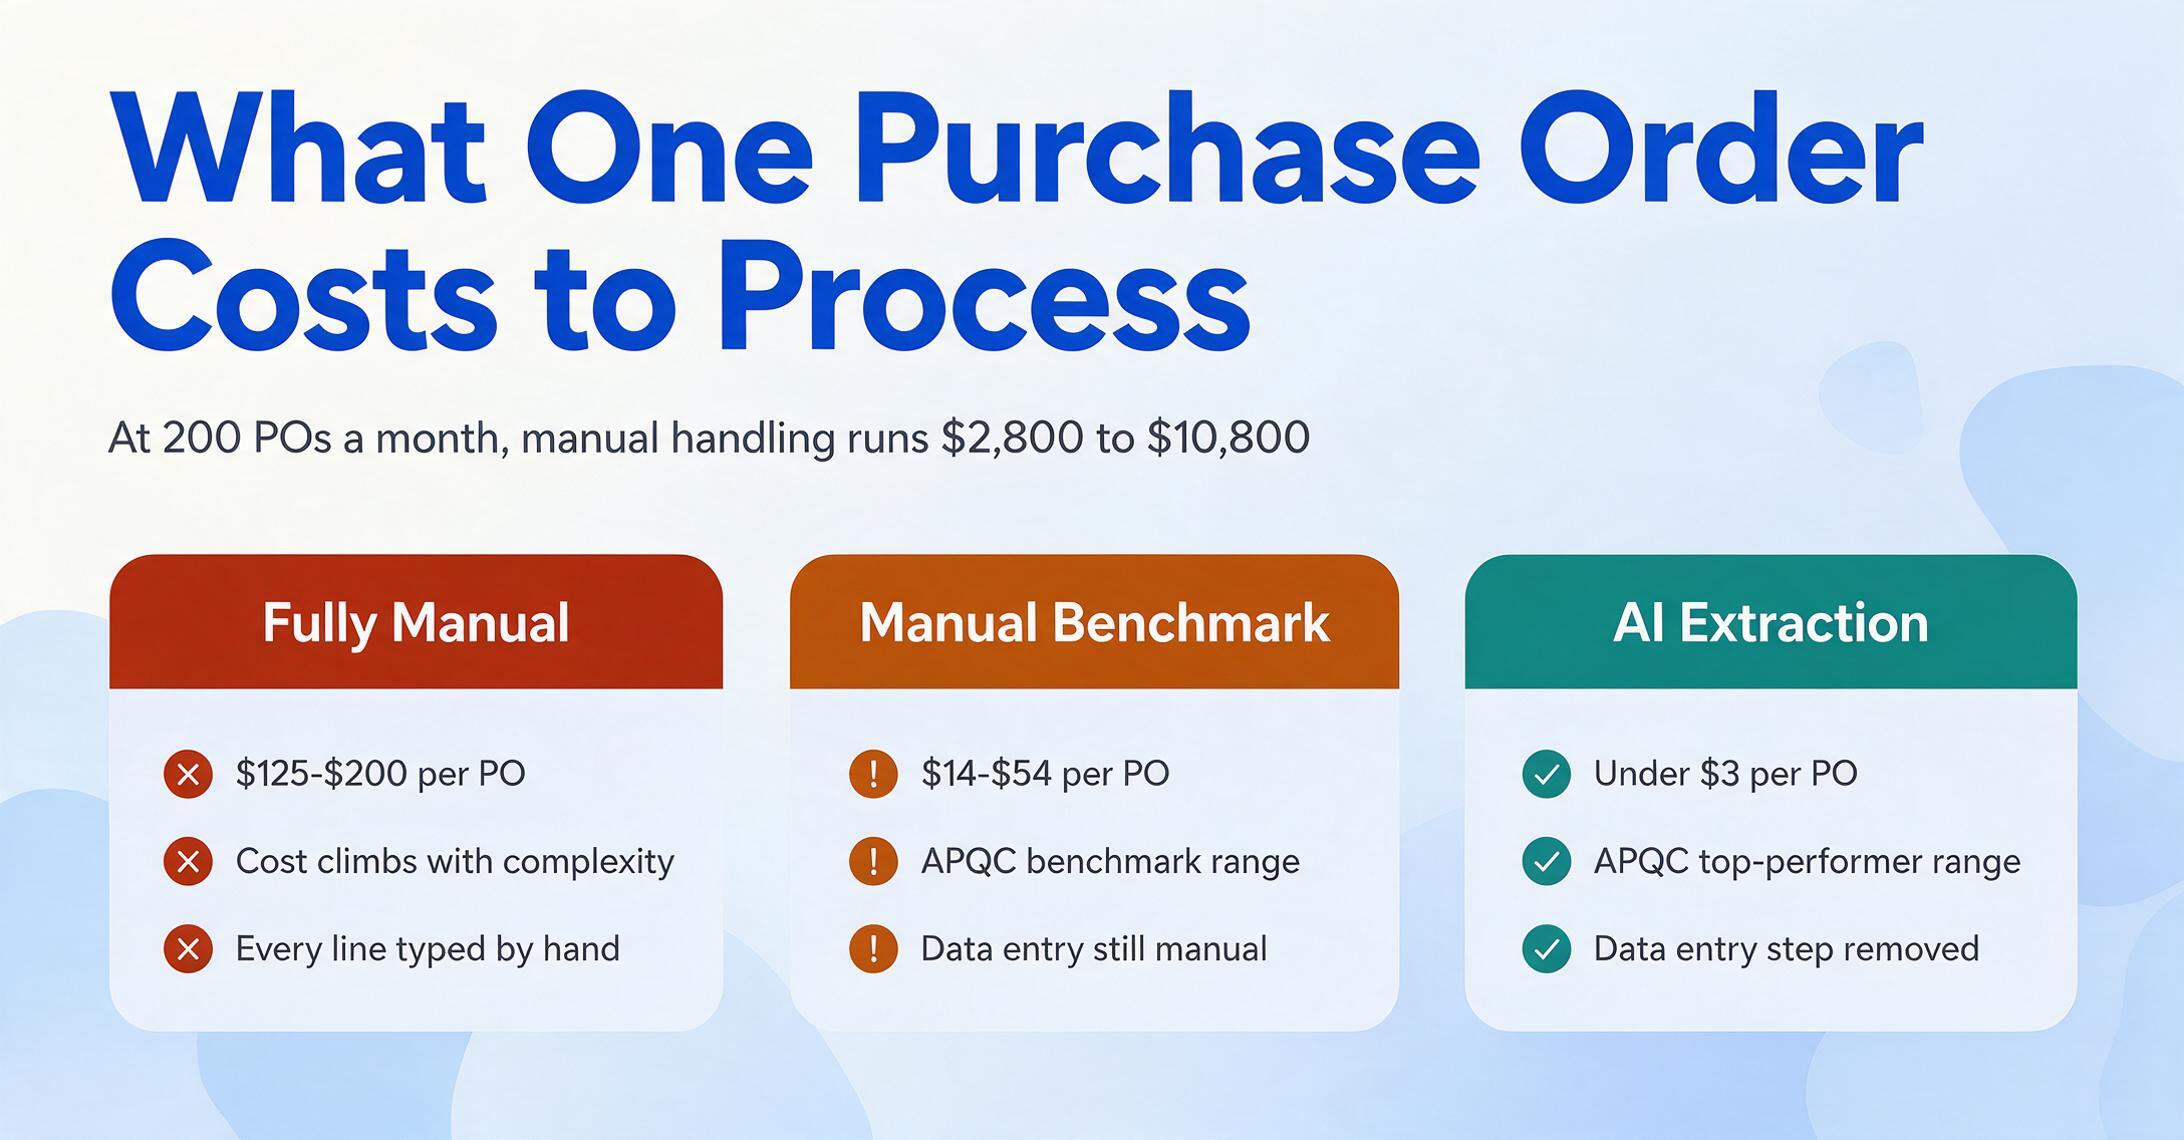
1. O volume de POs supera a capacidade da equipe. Dados da CAPS Research mostram que no setor industrial, os gastos com compras representam em média 55,64% da receita — ou seja, para um fabricante de $50M, cerca de $27,8M fluem por meio de pedidos de compra. Benchmarks da APQC mostram que o processamento manual de POs custa entre $14 e $54 por PO, com processos totalmente manuais chegando a $125–$200 por PO dependendo da complexidade. Com 200 POs por mês, isso representa de $2.800 a $10.800 por mês em custo de processamento antes mesmo de uma única fatura ser conciliada. A extração automatizada — ao eliminar a etapa de entrada de dados — empurra o custo por PO para a faixa abaixo de $3 dos benchmarks da APQC para os melhores desempenhos.
2. Cada fornecedor envia um formato de PO diferente. Essa é a realidade universal das compras. Até dois fornecedores que usam SAP produzem POs que não se parecem em nada porque seus administradores configuraram modelos de saída diferentes. Um usa "PO-2026-XXXX" como formato de número de PO; outro usa seis dígitos sem prefixo. Um coloca os itens de linha em uma tabela com bordas; outro usa blocos de texto recuados sem estrutura de tabela visível. Um inclui datas de entrega por item de linha; outro coloca uma única data de envio no cabeçalho. Ferramentas baseadas em modelo quebram diante dessa diversidade. A extração semântica não depende de formato algum — que é a diferença entre uma ferramenta que você configura uma vez e uma ferramenta que você mantém para sempre. Para um passo a passo prático desse fluxo de trabalho, veja nosso guia sobre automatizar a entrada de dados de pedidos de compra.
3. Você precisa de detalhes dos itens de linha, não apenas dos totais do cabeçalho. Muitas ferramentas de extração lidam bem com campos de cabeçalho: número do PO, data, fornecedor, total. Mas se você precisa de itens de linha — códigos de item, descrições, quantidades, preços unitários — para verificação de recebimento de mercadorias, conciliação de estoque ou conciliação de três vias, os requisitos da ferramenta ficam mais rígidos. Uma extração apenas de cabeçalho que ainda obriga alguém a digitar manualmente 50 itens de linha de um PO de 3 páginas não resolveu de fato o problema de entrada de dados. Esse é o ponto de descoberta mais comum: as equipes percebem que seu processo atual automatiza apenas 20% dos campos, mas 80% dos pontos de dados estão nos itens de linha.
4. Erros nos dados de PO estão se propagando em falhas de conciliação de três vias. Quando uma PO tem quantidade, preço unitário ou UOM incorretos registrados na entrada de dados, a etapa de conciliação subsequente — comparar a PO com o recebimento de mercadorias e a fatura do fornecedor — sinalizará uma divergência. Cada divergência sinalizada exige uma investigação manual: a PO foi inserida errada? O fornecedor enviou uma quantidade diferente? A fatura está cobrando algo que não foi pedido? Se a causa raiz for um erro de entrada de dados na PO, você está gastando 30 minutos para descobrir um problema que levou 3 segundos para ser criado. Corrigir a precisão da extração na etapa da PO evita que essas exceções cheguem à fila de conciliação. Para saber mais sobre essa dinâmica, veja nosso artigo sobre por que a conciliação de três vias falha no setor de compras.
O que procurar em uma ferramenta de extração de PO
As ferramentas de extração vão de simples wrappers de OCR a plataformas nativas de IA. As listas de recursos parecem todas iguais, mas estes são os critérios que realmente as diferenciam no uso diário de compras. Para a referência completa campo a campo — campos de cabeçalho, itens de linha, formatos de exportação e o framework completo de seleção — comece pelo nosso guia completo de extração de pedidos de compra.
Operação sem modelo. Este é o diferenciador mais importante. Uma ferramenta que exige que você crie e mantenha modelos de análise por formato de fornecedor não é extração — é gerenciamento de modelos com um pouco de extração de brinde. A pergunta certa a fazer a um fornecedor: "Se um fornecedor mudar o layout da PO amanhã, o que eu preciso fazer?" Se a resposta envolver atualizar um modelo, retreinar um modelo ou remapear campos, você está comprando um fardo de manutenção. A alternativa é a Extração de Colunas Personalizadas: você digita os nomes dos campos que deseja — "PO Number", "Item Code", "Quantity" — uma vez, e a IA os encontra no formato de cada fornecedor porque lê por significado, não por posição. Os nomes das colunas que você digita se tornam seus cabeçalhos de saída. Para uma análise mais profunda de por que essa distinção importa, leia sobre extrair campos de pedidos de compra para o Excel.
Qualidade da extração de itens de linha em quebras de página. Ferramentas que extraem campos de cabeçalho de forma confiável são o básico. Itens de linha — especialmente em POs de várias páginas com layouts de colunas inconsistentes e variantes de UOM — são o verdadeiro teste. Peça para testar a ferramenta em uma PO de 4 páginas com uma tabela de itens de linha de 30 linhas que abrange as páginas 2 a 4, com células mescladas na coluna de descrição e quantidades divididas em várias datas de entrega. Se ela lidar com isso sem problemas, lidará com todo o resto.
Capacidade de processamento em lote. Você consegue enviar 50 POs de 20 fornecedores diferentes de uma vez e receber uma planilha unificada de volta? Ou precisa processá-las uma a uma? O processamento em lote é a diferença entre "esta ferramenta me economiza tempo por PO" e "esta ferramenta me economiza horas por dia." A saída deve ser uma única tabela onde todas as POs são mescladas — mesmas colunas, mesma estrutura — prontas para análise, conciliação ou importação. Para saber mais sobre esse fluxo de trabalho, veja nosso guia para extração de PO em lote para o Excel.
Formato de saída e integração. A saída deve corresponder ao seu fluxo de trabalho de compras. Se você faz tudo pelo Excel, a exportação XLSX com colunas devidamente tipadas é indispensável. Se sua equipe trabalha no Google Sheets, uma ferramenta que grava os resultados diretamente em uma planilha — eliminando o ciclo de upload-download-importação — vale a diferença. Um add-on dedicado do Google Sheets para extração de PO permite processar POs sem sair da sua planilha. CSV e JSON importam se você estiver alimentando dados no NetSuite, QuickBooks ou um ERP personalizado.
Tratamento de casos extremos reais de PO. Entregas parciais em que um PO gera múltiplos recebimentos de mercadorias. Incompatibilidades de unidade de medida — o PO pede em "Caixas", mas os itens de linha especificam "Unidades por Caixa". Impostos e frete que aparecem no cabeçalho, mas devem ser alocados entre os itens de linha para contabilidade de custos. POs guarda-chuva que cobrem meses de entregas com preços variáveis. Uma ferramenta que processa 95% dos seus POs, mas falha silenciosamente nos 5% que são um pouco incomuns, cria mais risco do que uma ferramenta que é honesta sobre seus limites. Teste a ferramenta nos seus POs mais complexos — os pedidos guarda-chuva, os POs de fornecedores internacionais com moeda dupla, os POs anotados à mão de fornecedores menores — não nos seus mais simples.
Perguntas Frequentes
A extração de PO funciona com pedidos de compra manuscritos?
Sim, com ressalvas. Ferramentas modernas de extração com IA que usam modelos baseados em visão conseguem ler manuscritos em pedidos de compra — incluindo quantidades manuscritas, correções manuais e campos de formulário preenchidos. A precisão depende da legibilidade da caligrafia: letra de forma clara extrai com 90%+ de precisão, enquanto cursiva densa em digitalizações de baixa qualidade terá resultados menores. A principal vantagem da extração semântica aqui é que a IA usa o contexto do campo para desambiguar: se está procurando uma "Quantidade" e vê tanto um "500" digitado quanto um "520" manuscrito ao lado, ela consegue raciocinar sobre qual é a quantidade real do pedido. Para POs totalmente manuscritos — comuns com fornecedores menores que preenchem formulários em papel — a precisão da extração é comparável à extração de faturas: boa o suficiente para revisão, não para processamento sem toque. Para saber mais sobre esse cenário, consulte nosso guia sobre extração de pedidos de compra manuscritos.
A extração de PO consegue lidar com itens de linha que abrangem várias páginas?
Sim, essa é uma capacidade central da extração moderna com IA. Quando uma tabela de itens de linha quebra entre páginas — comum em POs com 20+ itens — a IA identifica que a tabela continua na página seguinte e remonta as linhas em registros contínuos. O requisito principal é que os cabeçalhos das colunas se repitam ou sejam visualmente inferíveis na página de continuação. Se a segunda página elimina completamente os cabeçalhos das colunas e depende de o leitor lembrar a ordem das colunas da primeira página, a precisão pode cair. Esse é um dos cenários a testar ao avaliar uma ferramenta — traga um PO de várias páginas em que a tabela abrange páginas e verifique se os itens das páginas 2+ caem nas colunas corretas.
E quanto às diferentes unidades de medida — a extração consegue normalizá-las?
A extração com IA consegue ler qualquer UOM que o fornecedor use — "EA", "PCS", "Each", "CTN", "BOX", "KG", "LB" — e capturá-la em uma coluna UOM dedicada. No entanto, normalizar UOMs (por exemplo, converter "CTN de 12" em 12 "EA" individuais) exige lógica downstream, porque o fator de conversão varia por item. A ferramenta de extração captura o que o PO diz. Converter "3 Caixas × 24 Unidades/Caixa = 72 Unidades" é uma etapa de cálculo que acontece após a extração — seja na sua planilha, no seu ERP ou por meio de colunas calculadas que permitem definir a fórmula de conversão uma vez. O trabalho da ferramenta de extração é capturar os valores brutos com precisão para que a etapa de normalização tenha entradas limpas.
Qual é a diferença entre extração de PO e conciliação de três vias?
Extração de PO e conciliação de três vias são etapas sequenciais na cadeia de compras, não alternativas. A extração de PO é a etapa de entrada de dados: transformar um documento de PO em campos estruturados. A conciliação de três vias é a etapa de verificação: comparar os dados extraídos do PO com o recebimento de mercadorias e a fatura do fornecedor para confirmar que o que foi pedido, o que foi recebido e o que está sendo cobrado estão todos alinhados. A extração acontece primeiro. Se os dados extraídos do PO estiverem errados — quantidade errada, preço unitário errado, código de item errado — a conciliação de três vias falhará com uma divergência falsa, e alguém terá que investigar. Acertar a extração na etapa do PO é o que torna possível a conciliação de três vias sem toque. Para saber mais sobre como essas peças se encaixam, leia nossa análise sobre conciliação de PO e fatura na indústria.
Posso extrair dados de PO diretamente para o meu ERP?
A maioria das ferramentas de extração gera saída em Excel, CSV ou JSON — formatos que qualquer ERP consegue importar. O fluxo típico é: extrair dados de PO → revisar a saída → importar o arquivo no seu ERP (QuickBooks, NetSuite, SAP, Microsoft Dynamics). A vantagem é que os dados chegam pré-formatados — datas como YYYY-MM-DD, valores como números simples com duas casas decimais, códigos de item como texto — então não há reformatação entre a extração e a importação. Algumas ferramentas oferecem integrações diretas com ERP via API, mas o caminho de importação por CSV/Excel funciona para praticamente qualquer sistema e não exige configuração de TI. Para um passo a passo, veja nosso guia sobre converter ordens de compra para Excel.
Quais formatos de arquivo e tipos de documento a extração de PO suporta?
Ferramentas de extração modernas aceitam PDF (gerado digitalmente ou digitalizado), JPG, PNG e WebP. O PDF é o formato universal — a maioria dos POs de fornecedores chega como anexo de e-mail em PDF. Fotos de celular de POs em papel funcionam desde que a imagem esteja razoavelmente nítida e bem iluminada. Algumas ferramentas também suportam AVIF e TIFF. A flexibilidade de formato importa porque os POs chegam por vários canais: anexos de e-mail (PDF), portais de fornecedores (download em PDF), fotos tiradas do celular de um comprador em uma feira (JPG) e POs em papel legados (digitalizados para PDF). Uma ferramenta que lida com apenas um formato obriga você a pré-converter tudo antes da extração. Para outros tipos de documento que seguem padrões de extração semelhantes, veja nossos guias sobre o que é extração de dados de faturas e o que é OCR de recibos.
Para Onde Ir a Partir daqui
A extração de dados de PO está na interseção de duas realidades de compras: o problema universal da diversidade de formatos de fornecedores e a dependência posterior da conciliação de três vias de dados de PO limpos. As ferramentas existem hoje para extrair dados de PO de forma confiável, em todos os formatos e fornecedores, sem configuração de modelo por fornecedor — algo que não era verdade nem há dois anos. Dados da CAPS Research mostrando gastos de compras em 55,64% da receita ressaltam quanto dinheiro flui pelos pedidos de compra, e os benchmarks da APQC mostrando uma diferença de $11–$51 por PO entre processamento manual e automatizado tornam o caso de ROI concreto.
A melhor maneira de avaliar se a extração se encaixa no seu fluxo de trabalho é testá-la em pedidos de compra reais — idealmente uma mistura dos seus fornecedores de maior volume e dos seus POs mais complexos. Se ela lidar com seus casos mais difíceis de forma limpa, os fáceis são garantidos. Para uma visão mais ampla de como a extração por IA funciona em diferentes tipos de documentos, comece com nosso guia fundamental de extração de documentos por IA. Ou, se você estiver pronto para ver como a extração lida com um pedido de compra real, envie uma amostra e experimente agora.