購買発注データ抽出とは?
PO処理の自動化
購買発注データ抽出とは、PDFやスキャンされた注文書からPO番号、仕入先、納品先住所、明細行(品目コード、説明、数量、単価、行合計)、合計金額などの主要フィールドを自動で読み取り、スプレッドシートの構造化データとして出力するプロセスです。POにOCRを実行するのとは異なります。OCRはテキストの壁を出力しますが、抽出は各フィールドが独自の列に入ったテーブルを出力し、照合、分析、ERPインポートにすぐ使えます。
重要ポイント
- 1件の注文書の手動処理コストは$14〜$200。そのコストはすべて、1回のアップロードで自動化できる作業です。
- サプライヤーがPOレイアウトを変更すると、テンプレート型ツールは正しい列に誤った値を静かに入力します。その結果発生するスリーマッチングの失敗は、1件あたり30分の修正作業を要します。
- PO番号、品目コード、数量など、列を名前で一度定義するだけで、セマンティック抽出は各サプライヤーの形式を位置ではなく意味で読み取ります。テンプレートの作成や保守は一切不要です。
POデータ抽出とは実際には何か
POデータ抽出とは、サプライヤーのPO文書(PDF添付、メールで送られたスキャン、買い手のスマホで撮影した写真など)を、実際に活用できる構造化データフィールドに変換する特定のステップです。これは、調達ワークフロー全体(要求、承認、発送、照合、支払い)を管理するPO自動化とは異なります。抽出はデータ入力層、つまり「受信トレイのPOファイル」と「スプレッドシートやERPの行」をつなぐ橋渡しです。
発注書から抽出される典型的なフィールドは、次の2つのカテゴリに分類されます。
ヘッダーフィールド(POごとに1件)
- PO番号
- PO日付
- ベンダー/サプライヤー名・住所
- 請求先/送付先住所
- 購入者名/部門
- 支払条件
- 小計、税、送料、合計
明細行(POごとに複数行)
- 品目コード/SKU
- 説明
- 数量
- 単位(UOM)
- 単価
- 行合計
- 納期(行ごと)
抽出が難しくなるのは明細行です。ヘッダーフィールドは単一の値です。一方、明細行テーブルには20行、50行、または100行以上含まれることがあり、各行に独自の品目コード、説明、数量、UOM、価格があり、複数ページにまたがり、列の配置もサプライヤーごとに異なります。あるサプライヤーは単位に「EA」を使い、別のサプライヤーは「PCS」を使い、3つ目は「Each」と完全に表記します。産業用サプライヤーの発注書では明細行ごとに納期を指定する場合がありますが、小売りのPOではすべてを1つの出荷日にまとめる場合もあります。明細行を正しく処理すること(フォーマットをまたいで、サプライヤーをまたいで、ページ区切りをまたいで)こそが、実用的な抽出と、手作業での修正がまだ必要な部分的な結果を分けるポイントです。
ここがテンプレートベースのツールが陥るギャップです。サプライヤーAのレイアウト用にテンプレートを設定した場合(「PO番号は座標(50, 20)、明細行は8行目から開始」)、サプライヤーAがERPをアップグレードしてPOテンプレートを変更するまでは機能します。するとPO番号は位置(75, 30)に移動し、テンプレートはPO番号列に誤った値を静かに抽出します。それを50社のサプライヤーで掛け合わせると、テンプレートのメンテナンスはフルタイムの仕事になります。AIが文書タイプをまたいでこのパラダイムをどう変えるかについてのより広い視点は、AI文書抽出とは実際には何かのガイドをご覧ください。
PO抽出 vs PO処理 vs OCR — 主な違い
これら3つの用語は購買業務の会話で隣り合わせに登場しますが、混同すると間違った問題を解決するツールを購入することになります。
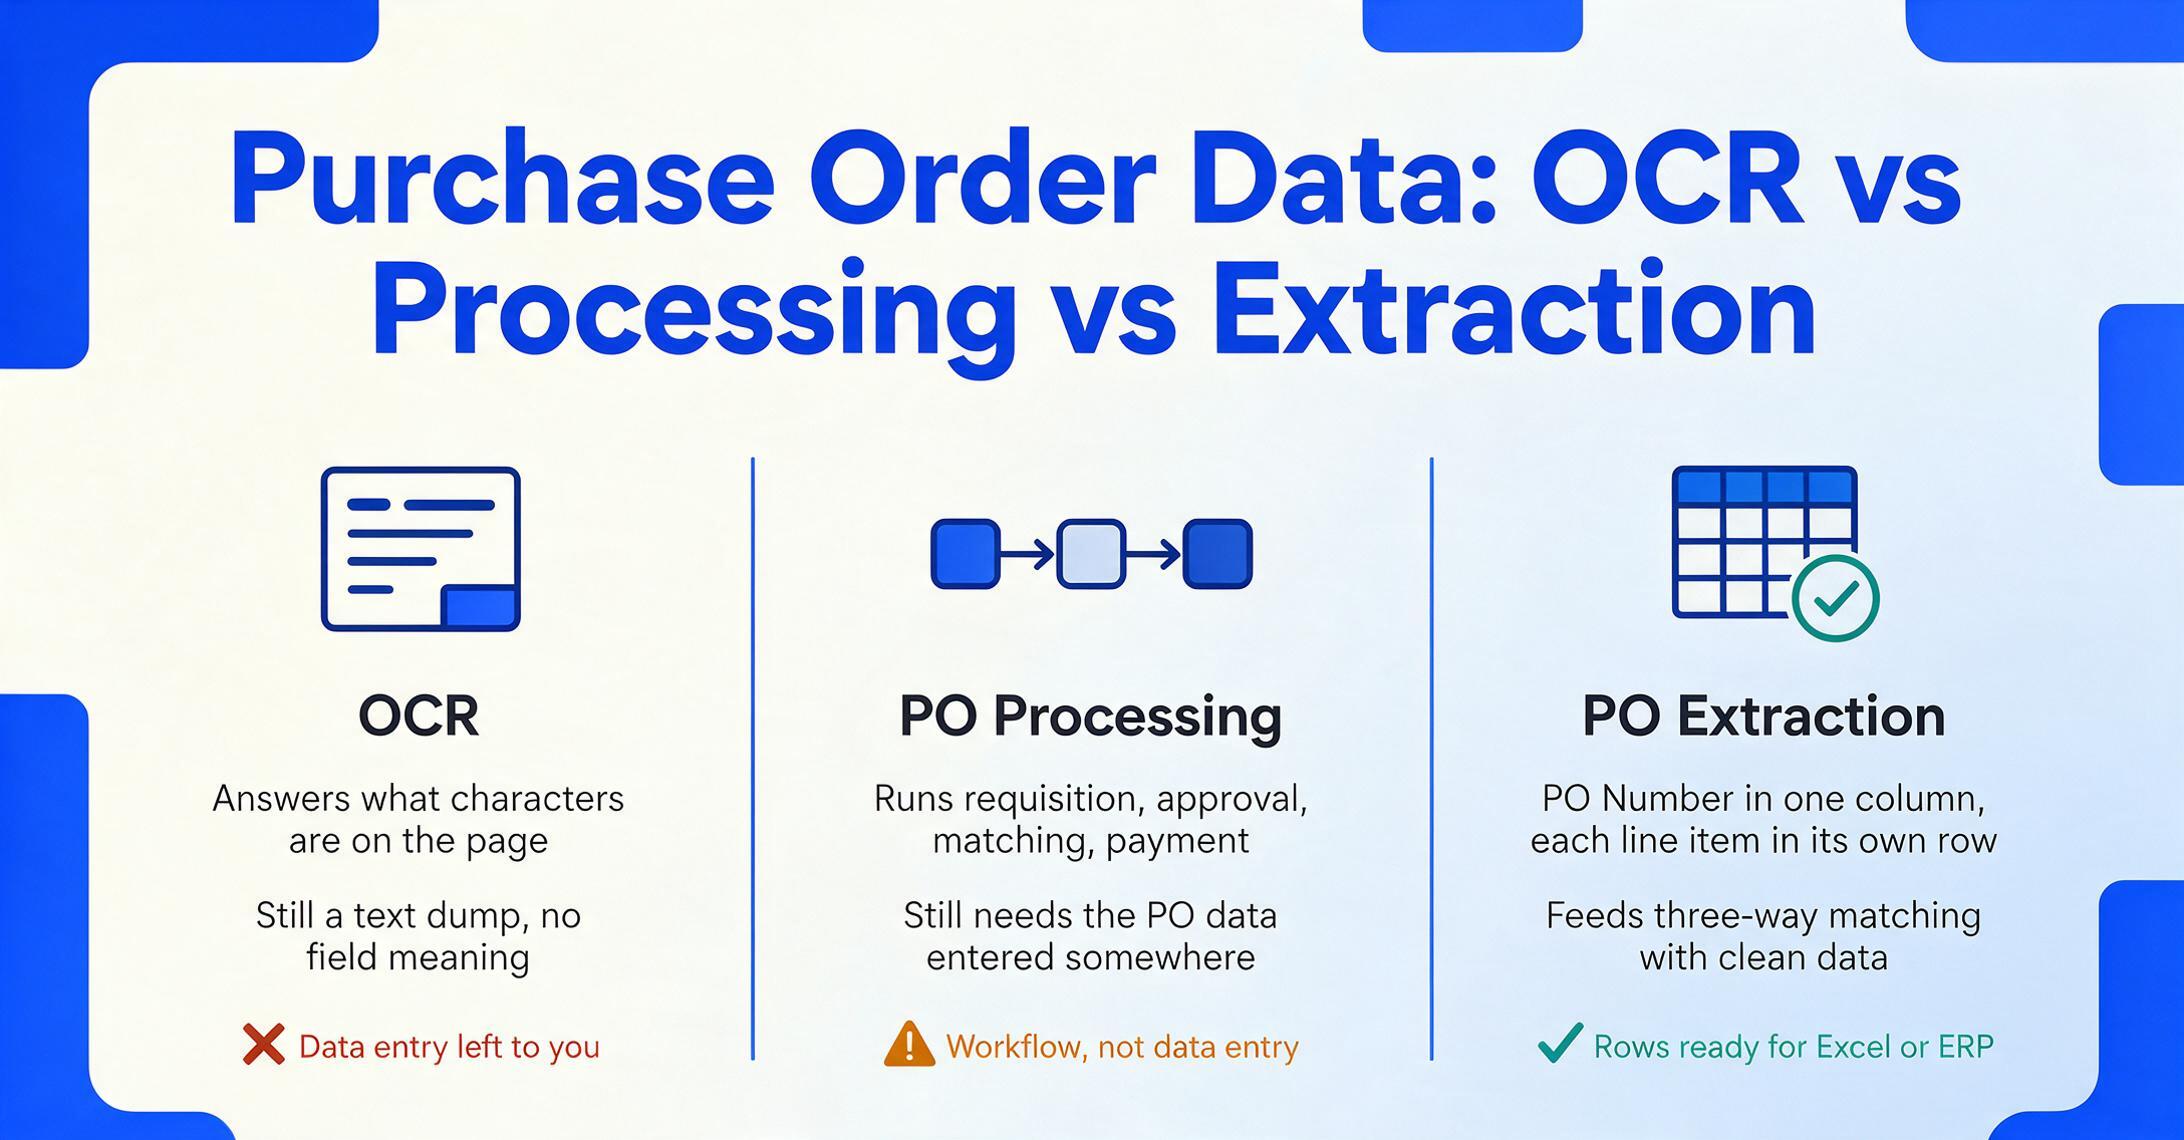
OCR(光学文字認識)は、テキストの画像を機械読み取り可能な文字に変換します。「このページにどんな文字があるか」には答えますが、その文字が何を意味するかは理解しません。POをOCRに通すと、PURCHASE ORDER PO-2026-0412 DATE 12/04/2026 VENDOR Atlas Fasteners QTY 500 DESC M8 Hex Bolt UNIT $0.42 TOTAL $210.00のようなテキストダンプが返ってきます。各フィールドを手動で抽出し、正しいセルに入力する必要がまだあります。OCRは文字をデジタル化しただけで、データ入力は行っていません。
PO処理は、抽出を取り巻く購買ワークフロー全体です。要求書の作成、承認ルート、発注書の発行、商品の受領、POと請求書・納品書の照合(スリーマッチング)、支払いのスケジュール、アーカイブまでを含みます。SAP Ariba、Coupa、Oracle Procurementなどの処理ツールはワークフローを管理しますが、POデータをどこかでシステムに入力する必要があります。その入力ステップが抽出です。
POデータ抽出は、PO文書を構造化フィールドに変換する特定のステップです。PO番号を1つの列に、仕入先を別の列に、各明細をそれぞれの行に、合計をExcelで集計できるセルに入れます。処理にデータを供給するデータ入力レイヤーです。世界クラスの購買ワークフロー自動化があっても、抽出ステップが誤ったデータ(誤った数量、不一致の品目コード、誤った合計)を供給していれば、ワークフローは間違いをより速く自動化するだけです。
抽出エラーの下流での結果はスリーマッチングの失敗です。Ardent Partnersの2025 APベンチマークによると、ベストインクラスのAPチームは請求書照合の例外率9%を達成していますが、それ以外のチームは平均22%です。POデータ入力エラーに遡る不一致はそれぞれ、AP担当者が購買・受領・経理を横断して調査するのに約30分かかります。PO段階で抽出を正しく行えば、照合前にこれらの例外を防げます。
POデータ抽出の仕組み
インターフェースの背後では、抽出はここ2年で起きた根本的な変化、つまり位置ベース抽出から意味ベース抽出への移行に基づいて動作しています。
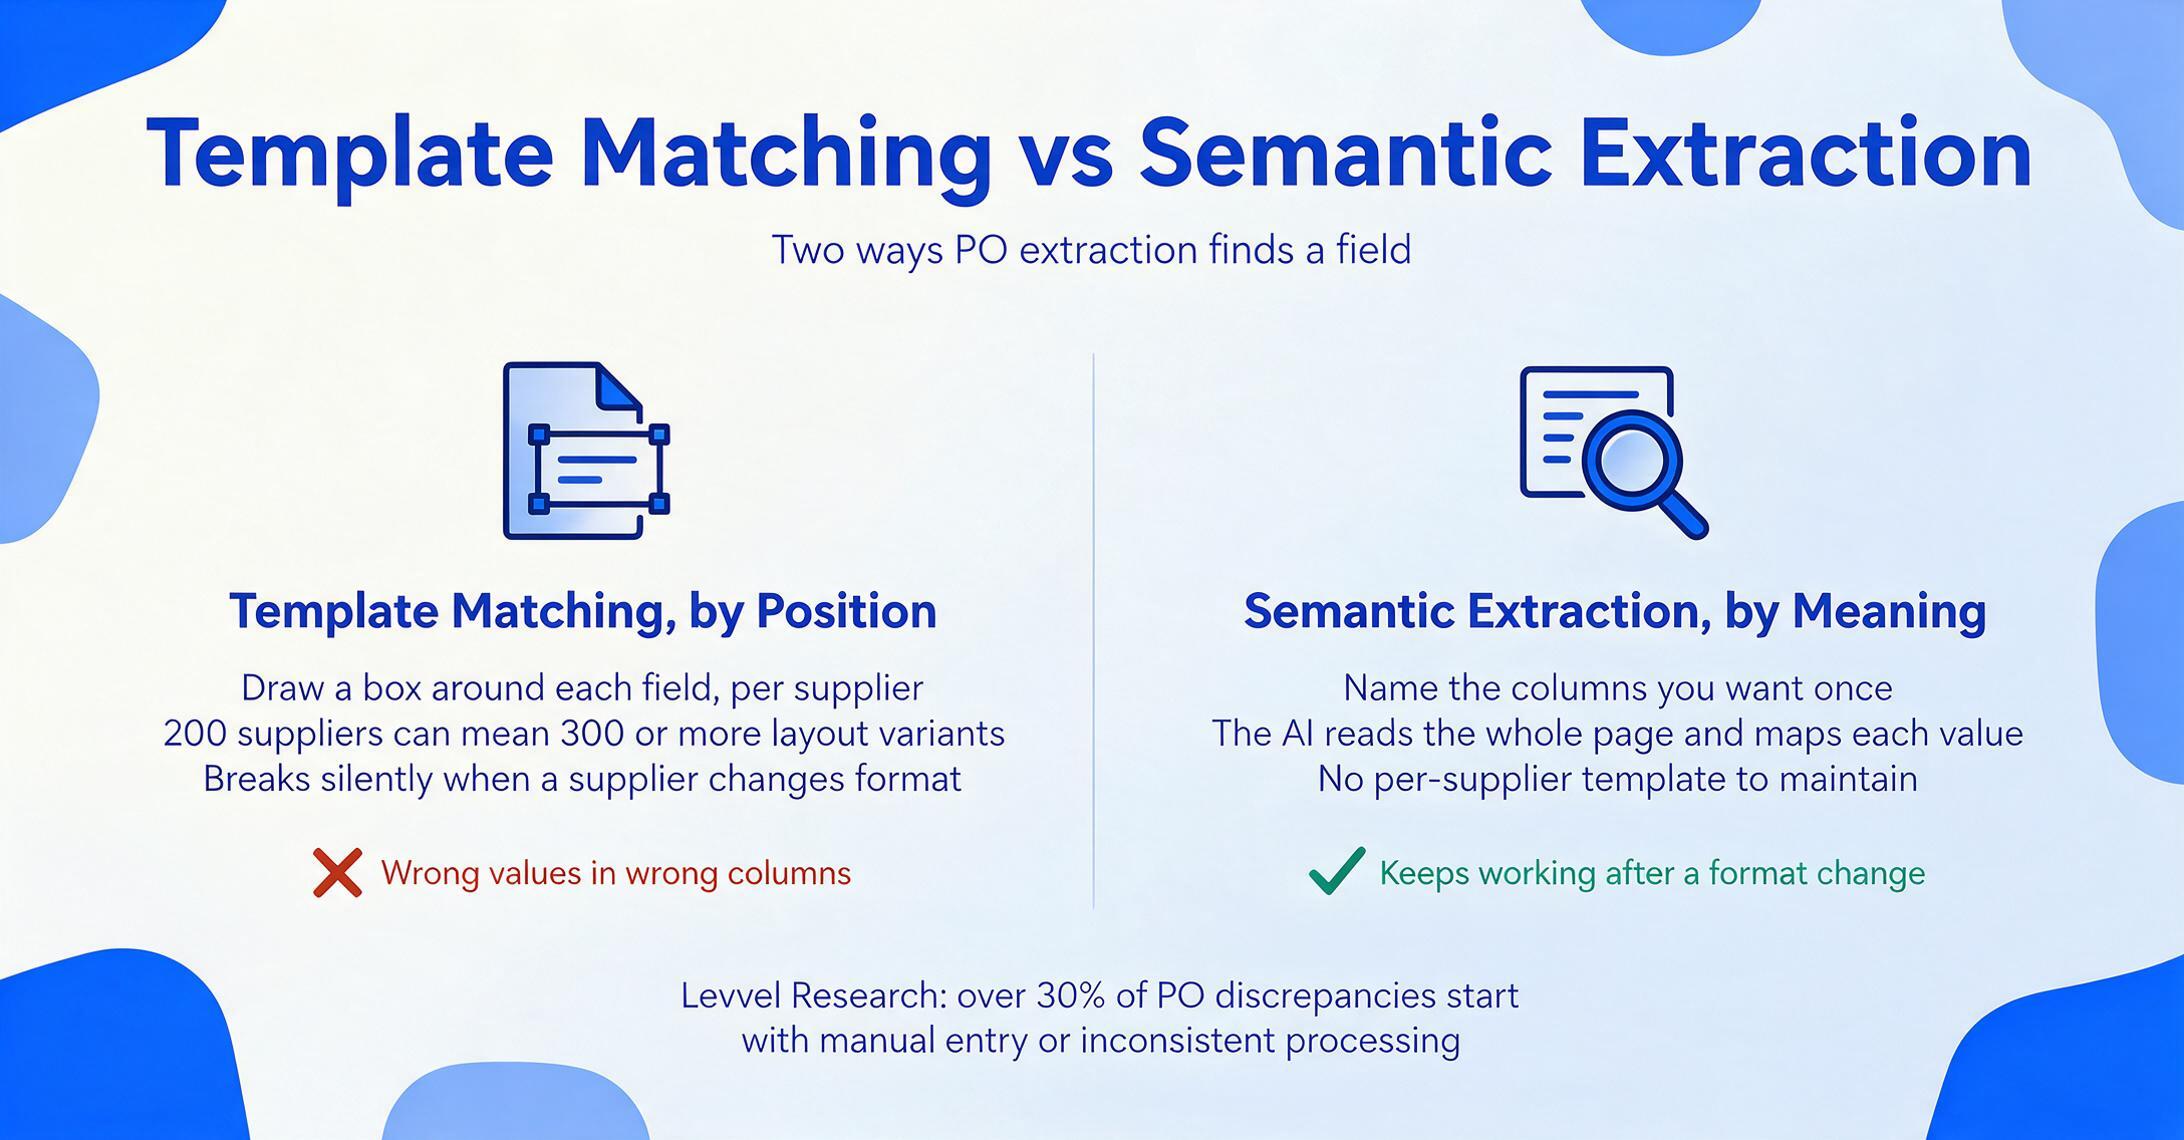
従来の方法 — テンプレートマッチング。 従来のPO抽出ツールは位置ベースで動作します。ある仕入先のレイアウトで「PO番号」の周囲に矩形を描き、「値は右側にある」とシステムに指示します。これを全仕入先、全レイアウトバリエーション、全フィールドに対して繰り返します。仕入先を200社抱える中規模メーカーでは、300以上のフォーマットバリエーションに直面する可能性があります。さらに悪いことに、仕入先がPOフォーマットを変更すると(ERPのアップグレードやリブランドのたびに発生)、テンプレートは静かに壊れ、誤った値を誤った列に取り込み始めます。Levvel Researchによると、PO不一致の30%以上は手動入力または不整合な処理に起因しており、テンプレートベースの抽出はその不整合を修正するどころか自動化しているにすぎません。
現代の方法 — 意味ベース抽出。 現代のAIベースの抽出は、位置ではなく意味で動作します。各フィールドがどこにあるかをシステムに学習させる代わりに、何を見つけたいかを指定します:「PO番号」「仕入先名」「品目説明」「数量」「単価」「行合計」。AIは文書全体を読み取り、各テキストが文脈上何を表すかを理解し、ページ上のどこに表示されていても正しい出力列にマッピングします。これがカスタム列抽出です。必要な出力列を定義すると、AIは各フィールドの意味を理解することで、ページ上のどこからでも一致するデータを特定します。ある仕入先の文書で「PO #」とラベル付けされたフィールドと、別の仕入先の「Order Reference」とラベル付けされたフィールドは、AIがラベルテキストではなく意味的役割を理解するため、同じものとして認識されます。
パイプライン全体は次のとおりです:
アップロード
PDF、スキャン、写真をドロップ — 単一のPOでも50件のバッチでもOK。仕入先ごとの事前仕分けも、ファイル名の変更も、読み取れる範囲を超えるフォーマット要件も不要です。各文書はテキストではなく視覚画像として受け取られます — AIは人間の読者と同じようにレイアウト、フォント、表、余白を認識します。
列を定義
抽出したいフィールド名を入力 — 「PO番号」「仕入先」「品目コード」「説明」「数量」「単価」「行合計」。これらが出力スプレッドシートのヘッダーになります。テンプレート設定も、トレーニングデータも、領域指定も不要です。AIが意味でマッピングするため、同じ列リストがすべての仕入先フォーマットで機能します。
AIが読み取り・マッピング
ビジョンモデルが各ページをスキャンし、セマンティックな役割を理解してどのテキストブロックがどのフィールドに対応するかを特定し、列にマッピングします。品目説明の横にある数量「500」は、PO番号ではなく明細数量として認識されます。「Ship To」住所ブロックは、周囲のコンテキストによって「Bill To」ブロックと区別されます — 両方が類似した住所構造を含む場合でも同様です。ページをまたぐ明細行は連続した行に組み立てられます。
構造化データをエクスポート
Excel(XLSX)、CSV、JSONでダウンロード。各POはヘッダーテーブルに1行入り、明細行はPOヘッダーフィールドを繰り返した別行に展開され、フィルタリングやピボットテーブルに使用できます。または結果を直接Google Sheetsに書き込むことも可能。データは事前フォーマット済み — 日付はYYYY-MM-DD、金額はプレーンな数値 — なので、抽出からQuickBooks、NetSuite、またはERPへのインポートまでの再フォーマットは不要です。
ファイルは安全に処理され、保存されません。
POデータ抽出が必要なケース
すべての企業に抽出が必要なわけではありません。月に5件のPOを同じ3社のサプライヤーに発行する小規模な事業であれば、コーヒーブレイク中にスプレッドシートへ入力できるでしょう。抽出が価値を持つのは、量と多様性が閾値を超え、手動入力が小さな手間ではなくなり、サプライヤー、部門、月をまたいで複合的に影響を及ぼし始めたときです。
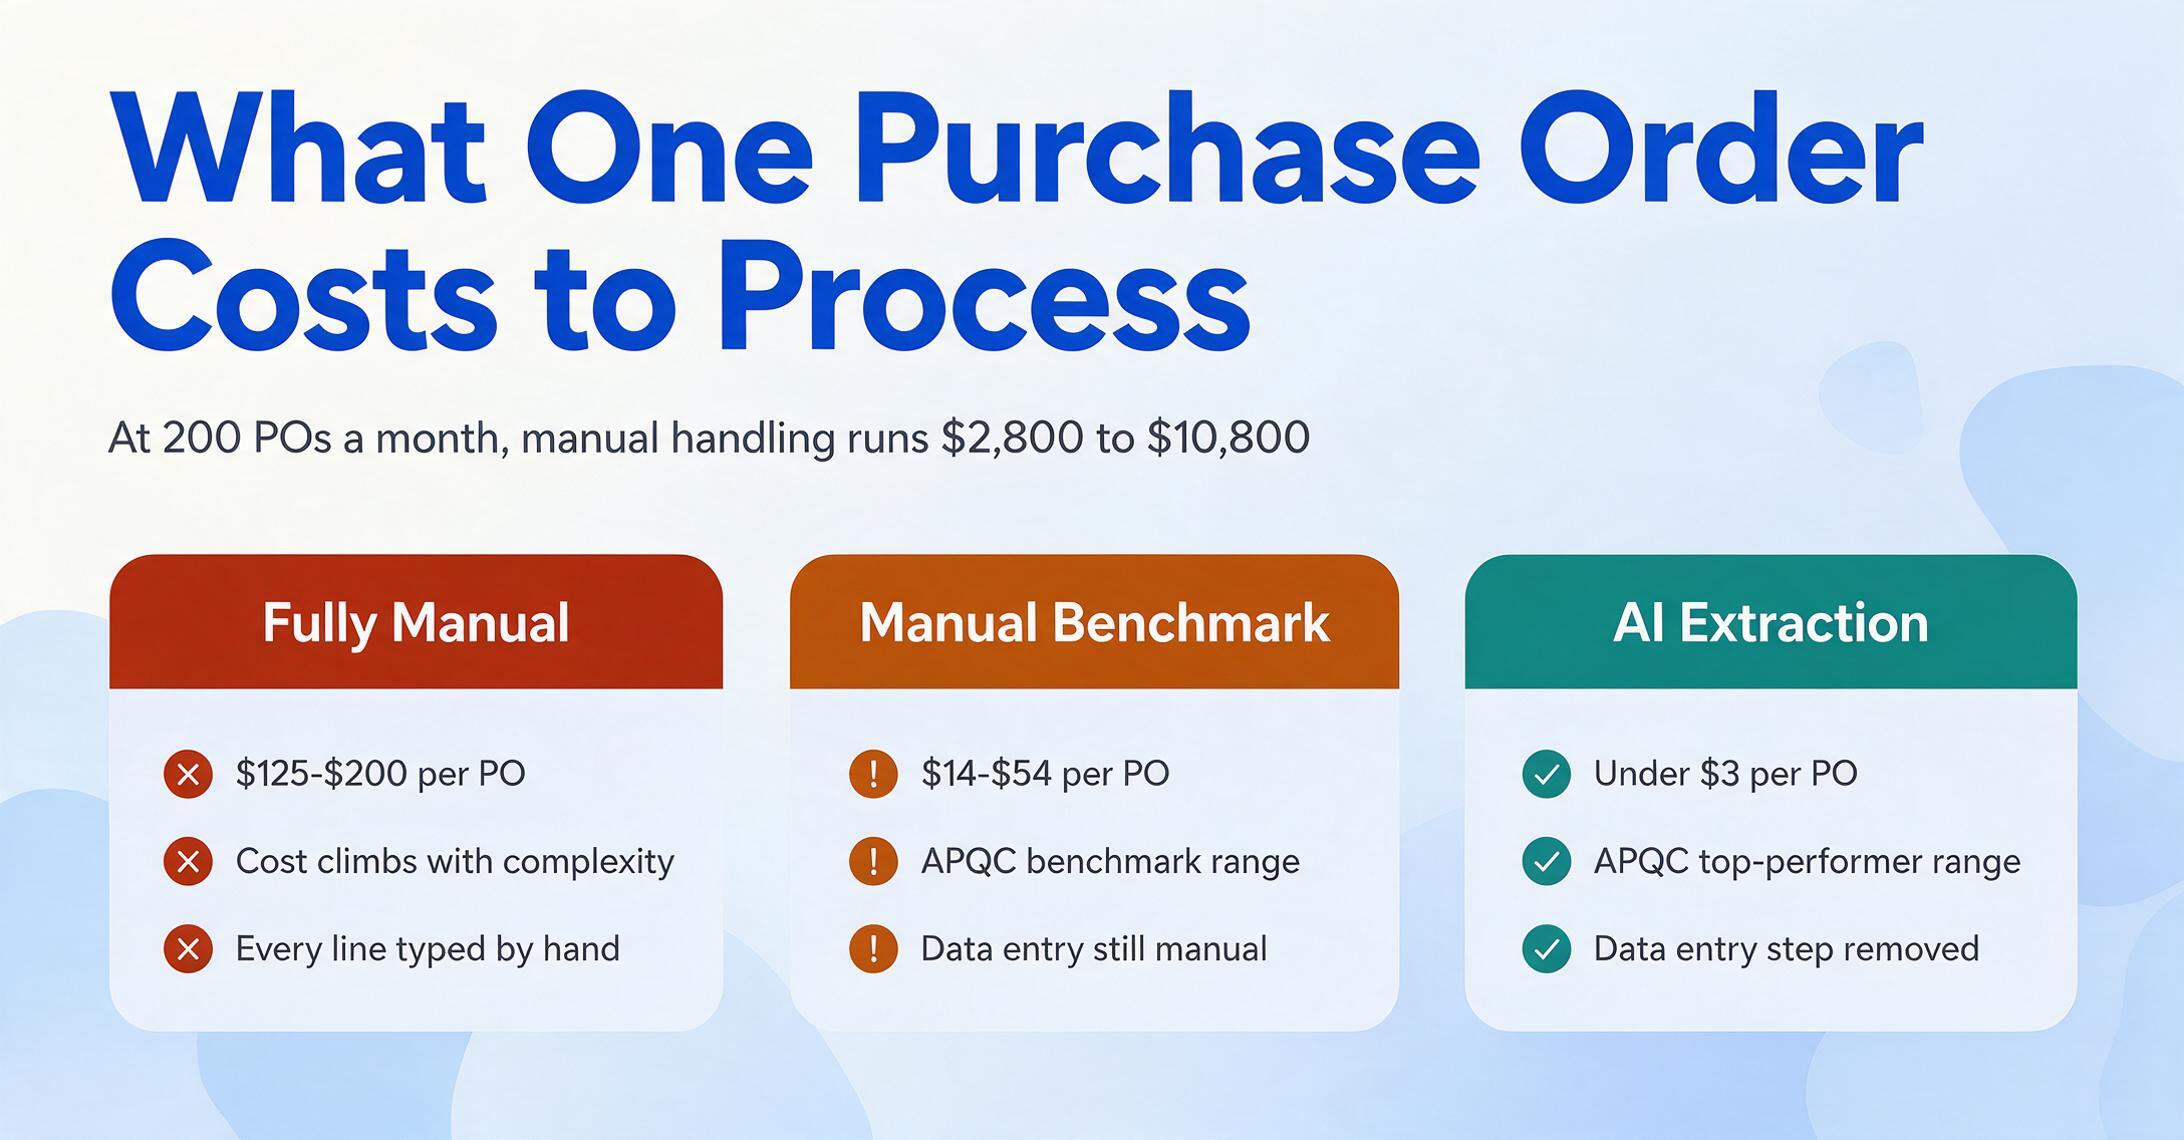
1. POの量が人員数を上回る。 CAPSリサーチのデータによると、産業部門では調達支出は売上の平均55.64%を占めます。つまり、売上$50Mのメーカーでは、約$27.8Mが発注書を通じて流れることになります。APQCのベンチマークでは、手動PO処理コストはPOあたり$14〜$54、完全手動プロセスでは複雑さに応じてPOあたり$125〜$200に達します。月200件のPOの場合、請求書の照合前に月間$2,800〜$10,800の処理コストがかかります。自動抽出はデータ入力ステップを排除することで、POあたりのコストをAPQCがトップパフォーマーとしてベンチマークする$3未満の範囲に引き下げます。
2. サプライヤーごとにPO形式が異なる。 これは調達における普遍的な現実です。同じSAPを使用している2社のサプライヤーでも、管理者が異なる出力テンプレートを設定しているため、生成されるPOはまったく似ていません。ある企業はPO番号形式として「PO-2026-XXXX」を使用し、別の企業はプレフィックスなしの6桁を使用します。ある企業は明細項目を枠線付きテーブルに配置し、別の企業は目に見えるテーブル構造のないインデントされたテキストブロックを使用します。ある企業は明細項目ごとに納期を含め、別の企業はヘッダーに単一の出荷日を記載します。テンプレートベースのツールはこの多様性に対応できません。セマンティック抽出は形式にまったく依存しません。これは、一度設定すれば済むツールと、永遠にメンテナンスが必要なツールの違いです。このワークフローの実践的なチュートリアルについては、発注書データ入力の自動化に関するガイドをご覧ください。
3. ヘッダー合計だけでなく、明細レベルの詳細が必要。 多くの抽出ツールはヘッダーフィールド(PO番号、日付、ベンダー、合計)をうまく処理します。しかし、商品コード、説明、数量、単価などの明細項目が、入庫検証、在庫照合、スリーマッチングに必要な場合、ツールの要件はより厳しくなります。3ページのPOから50件の明細項目を手動で入力する必要があるヘッダー専用抽出では、データ入力の問題は実際には解決されていません。これは最も一般的な発見ポイントです。チームは現在のプロセスがフィールドの20%しか自動化しておらず、データポイントの80%が明細項目にあることに気づきます。
4. POデータの誤りがスリーマッチングの失敗を連鎖的に引き起こす。 データ入力時にPOの数量、単価、またはUOMが誤って記録されると、後続のマッチング工程(POを受領書および仕入先請求書と照合する工程)で不一致が検出されます。検出された不一致はそれぞれ手動調査が必要です。POの入力が誤っていたのか?仕入先が異なる数量を出荷したのか?請求書に注文していない品目が請求されているのか?根本原因がPOのデータ入力ミスであれば、作成に3秒しかかからなかった問題を発見するために30分を費やしていることになります。PO段階で抽出精度を改善すれば、こうした例外がマッチングキューに到達するのを防げます。この仕組みの詳細については、調達におけるスリーマッチングが機能不全に陥る理由に関する記事をご覧ください。
PO抽出ツールに求めるべき点
抽出ツールは、基本的なOCRラッパーからAIネイティブなプラットフォームまで多岐にわたります。機能リストはどれも似ていますが、日常の調達業務で実際に差が出るのは以下の基準です。ヘッダーフィールド、明細行、エクスポート形式、完全な選定フレームワークを含むフィールド別の完全なリファレンスについては、発注書抽出の完全ガイドから始めてください。
テンプレート不要の運用。 これは最も重要な差別化要因です。仕入先フォーマットごとに解析テンプレートの作成・保守が必要なツールは、抽出ではなく「テンプレート管理に抽出が少し付いたもの」です。ベンダーに問うべき質問はこれです。「仕入先が明日POレイアウトを変更したら、何をする必要がありますか?」答えがテンプレートの更新、モデルの再トレーニング、フィールドの再マッピングを含むなら、それは保守負担を買っていることになります。その代替がカスタム列抽出です。「PO番号」「品目コード」「数量」など、必要なフィールド名を一度入力するだけで、AIが意味で読み取るため、あらゆる仕入先フォーマットでそれらを見つけ出します。入力した列名がそのまま出力ヘッダーになります。この違いが重要な理由をさらに詳しく知りたい方は、発注書フィールドのExcelへの抽出についてお読みください。
ページをまたぐ明細行の抽出品質。 ヘッダーフィールドを確実に抽出できるツールは最低条件です。明細行、特に列レイアウトが不統一でUOMのバリエーションがある複数ページのPOでは、これが本当の試練となります。説明列に結合セルがあり、数量が複数の納期に分割されている、2〜4ページにまたがる30行の明細行テーブルがある4ページのPOでテストを依頼してください。それをきれいに処理できれば、他のすべても処理できます。
バッチ処理機能。 20社の仕入先からの50件のPOを一度にアップロードして、1つの統合スプレッドシートを得られますか?それとも1件ずつ処理する必要がありますか?バッチ処理は「このツールはPOごとに時間を節約する」と「このツールは毎日数時間を節約する」の違いです。出力は、すべてのPOがマージされた単一のテーブル(同じ列、同じ構造)で、分析、マッチング、インポートにすぐ使えるものであるべきです。このワークフローの詳細については、POのExcelへのバッチ抽出ガイドをご覧ください。
出力形式と統合。 出力は調達ワークフローに適合する必要があります。すべてをExcelで処理するなら、適切に型付けされた列でのXLSXエクスポートは必須です。チームがGoogle Sheetsで作業しているなら、結果をシートに直接書き込むツール(アップロード・ダウンロード・インポートのサイクルを排除)が価値があります。専用のPO抽出用Google Sheetsアドオンを使えば、スプレッドシートから離れずにPOを処理できます。NetSuite、QuickBooks、カスタムERPにデータを送る場合は、CSVとJSONも重要です。
実世界のPOエッジケースへの対応。1つのPOから複数の入荷伝票が生成される部分納品。単位の不一致 — POは「ケース」単位で発注しているのに、明細行は「ケースあたりの単位数」を指定しているケース。ヘッダーに表示される税や送料を、原価計算のために明細行に配分する必要があるケース。数ヶ月にわたる納品と変動価格をカバーする包括PO。POの95%を処理できるが、わずかに特殊な5%で静かに失敗するツールは、自らの限界を正直に認めるツールよりも大きなリスクを生み出します。最も複雑なPO — 包括注文、二重通貨の国際サプライヤーPO、小規模ベンダーからの手書きPO — でツールをテストしてください。最もきれいなPOではなく。
よくある質問
PO抽出は手書きの注文書でも機能しますか?
はい、条件付きで機能します。ビジョンベースのモデルを使用する最新のAI抽出ツールは、注文書の手書き文字を読み取ることができます。手書きの数量、手動修正、記入済みのフォーム欄なども含まれます。精度は手書きの読みやすさに依存します。明瞭なブロック体は90%以上の精度ですが、低品質スキャンの密集した筆記体では精度が低下します。ここでのセマンティック抽出の主な利点は、AIがフィールドの文脈を使用して曖昧さを解消することです。「数量」を探しているときに、横にタイプされた「500」と手書きの「520」の両方を見た場合、どちらが実際の注文数量かを推論できます。完全に手書きで届くPO(紙のフォームに記入する小規模サプライヤーに一般的)の場合、抽出精度は請求書抽出と同等です。レビューには十分ですが、タッチレスではありません。このシナリオの詳細については、手書き注文書の抽出に関するガイドをご覧ください。
PO抽出は複数ページにまたがる明細行を処理できますか?
はい、これは最新のAI抽出の中核機能です。明細テーブルがページ境界をまたいで分割される場合(20行以上の明細があるPOで一般的)、AIはテーブルが次のページに続いていることを識別し、行を連続したレコードに再構成します。重要な要件は、列ヘッダーが継続ページで繰り返されるか、視覚的に推測可能であることです。2ページ目で列ヘッダーが完全に省略され、1ページ目の列順序を読者が覚えていることに依存する場合、精度が低下する可能性があります。これはツールを評価する際にテストすべきシナリオの1つです。テーブルがページをまたぐ複数ページのPOを持ち込み、2ページ目以降の明細行が正しい列に配置されるか確認してください。
異なる測定単位はどうですか?抽出で正規化できますか?
AI抽出は、サプライヤーが使用するあらゆるUOM(「EA」「PCS」「Each」「CTN」「BOX」「KG」「LB」など)を読み取り、専用のUOM列に取得できます。ただし、UOMの正規化(例:「CTN of 12」を12個の「EA」に変換)には、換算係数が品目ごとに異なるため、後続のロジックが必要です。抽出ツールはPOに記載されている内容を取得します。「3ケース×24個/ケース=72個」への変換は、抽出後に実行される計算ステップです。スプレッドシート、ERP、または換算式を一度定義できる計算列を使用して行います。抽出ツールの役割は、正規化ステップがクリーンな入力を受け取れるよう、生の値を正確に取得することです。
PO抽出はスリーマッチングとどう違うのですか?
PO抽出とスリーマッチングは、調達チェーンにおける連続したステップであり、代替手段ではありません。PO抽出はデータ入力ステップです。PO文書を構造化フィールドに変換します。スリーマッチングは検証ステップです。抽出されたPOデータを納品書とサプライヤー請求書と比較し、注文されたもの、受け取ったもの、請求されているものがすべて一致することを確認します。抽出が最初に行われます。抽出されたPOデータが間違っている場合(数量、単価、品目コードの誤り)、スリーマッチングは誤った不一致で失敗し、誰かが調査する必要があります。PO段階で抽出を正確に行うことが、タッチレスのスリーマッチングを可能にするのです。これらの連携の詳細については、製造業におけるPOと請求書のマッチングに関する分析をご覧ください。
POデータを直接ERPに取り込めますか?
ほとんどの抽出ツールは、あらゆるERPがインポートできるExcel、CSV、JSON形式で出力します。一般的なワークフローは、POデータを抽出→出力を確認→ファイルをERP(QuickBooks、NetSuite、SAP、Microsoft Dynamics)にインポート、という流れです。利点は、データが事前にフォーマットされた状態で届くことです(日付はYYYY-MM-DD、金額は小数点以下2桁の数値、品目コードはテキスト)。そのため、抽出からインポートまでの間に再フォーマットの必要はありません。API経由でERPに直接統合できるツールもありますが、CSV/Excelインポートの方法はほぼすべてのシステムで機能し、IT設定も不要です。ステップバイステップの手順については、購買注文をExcelに変換するガイドをご覧ください。
PO抽出はどのファイル形式と文書タイプに対応していますか?
最新の抽出ツールは、PDF(デジタル生成・スキャン両方)、JPG、PNG、WebPに対応しています。PDFは標準的な形式で、ほとんどのサプライヤーのPOはPDFのメール添付で届きます。紙のPOをスマホで撮影した場合も、画像が十分に鮮明で明るければ処理できます。AVIFやTIFFに対応しているツールもあります。形式の柔軟性が重要なのは、POが複数の経路で届くためです。メール添付(PDF)、サプライヤーポータル(PDFダウンロード)、展示会でのバイヤーのスマホ撮影(JPG)、旧来の紙のPO(PDFにスキャン)などです。1つの形式しか扱えないツールでは、抽出前にすべてを変換する必要があります。同様の抽出パターンを持つ他の文書タイプについては、請求書データ抽出とはおよびレシートOCRとはのガイドをご覧ください。
次のステップ
POデータ抽出は、調達における2つの現実の交差点に位置しています。サプライヤーのフォーマット多様性という普遍的な問題と、スリーマッチングがクリーンなPOデータに依存する下流工程です。現在では、ベンダーごとのテンプレート設定なしに、フォーマットやサプライヤーを問わずPOデータを確実に抽出するツールが存在します — これは2年前には不可能だったことです。CAPS Researchのデータによると、調達支出は収益の55.64%を占め、APQCのベンチマークでは、手動処理と自動処理の間のPOあたり$11〜$51の差が示されており、ROIの根拠は具体的です。
抽出がワークフローに適合するかどうかを評価する最善の方法は、実際の注文書でテストすることです — 理想的には、最も取引量の多いサプライヤーと最も複雑なPOを混ぜて使用します。最も難しいケースをきれいに処理できれば、簡単なケースは当然問題ありません。文書タイプを横断したAI抽出の広範な概要については、AI文書抽出の基礎ガイドから始めてください。実際の注文書で抽出を試す準備ができている場合は、サンプルをアップロードして今すぐお試しください。