Was ist Purchase-Order-Datenextraktion?
PO-Verarbeitung automatisieren
Purchase-Order-Datenextraktion ist der automatisierte Prozess, bei dem Schlüsselfelder – wie PO-Nummer, Lieferant, Lieferadresse, Positionszeilen (Artikelnr., Beschreibung, Menge, Einzelpreis, Positionssumme) und Gesamtbetrag – aus einer PDF oder gescannten Bestellung gelesen und als strukturierte Daten in einer Tabelle ausgegeben werden. Das ist nicht dasselbe wie OCR auf einer PO – OCR liefert Ihnen einen Textblock. Extraktion liefert Ihnen eine Tabelle, in der jedes Feld seine eigene Spalte hat, bereit für Abgleich, Analyse oder ERP-Import.
Wichtigste Erkenntnisse
- $14 bis $200 – so viel kostet die manuelle Verarbeitung einer einzigen Bestellung, und kein einziger Dollar davon leistet etwas, das Sie nicht mit einem einzigen Upload automatisieren könnten.
- Wenn ein Lieferant sein PO-Layout ändert, setzen vorlagenbasierte Tools stillschweigend falsche Werte in die richtigen Spalten – und jeder daraus resultierende fehlgeschlagene Drei-Wege-Abgleich kostet 30 Minuten zur Bereinigung.
- Definieren Sie Ihre Spalten einmal per Name – PO-Nummer, Artikelnr., Menge – und die semantische Extraktion liest jedes Lieferantenformat nach Bedeutung statt nach Position, ganz ohne Vorlagen, die Sie erstellen oder pflegen müssten.
Was die Extraktion von Bestelldaten tatsächlich ist
Die Extraktion von Bestellungen ist der spezifische Schritt, der das PO-Dokument eines Lieferanten – ob als PDF-Anhang, per E-Mail gescannt oder als Foto vom Telefon eines Käufers – in strukturierte Datenfelder verwandelt, mit denen Sie tatsächlich arbeiten können. Sie ist nicht dasselbe wie die PO-Automatisierung, die den gesamten Beschaffungsworkflow verwaltet (Anforderung, Genehmigungen, Versand, Abgleich, Zahlung). Die Extraktion ist die Datenerfassungsebene: die Brücke zwischen „einer PO-Datei in Ihrem Posteingang" und „Zeilen in Ihrer Tabellenkalkulation oder Ihrem ERP."
Die Felder, die typischerweise aus einer Bestellung extrahiert werden, fallen in zwei Kategorien:
Kopffelder (eines pro PO)
- PO-Nummer
- PO-Datum
- Lieferantenname & -adresse
- Rechnungs- / Lieferadresse
- Käufername / Abteilung
- Zahlungsbedingungen
- Zwischensumme, Steuer, Versand, Gesamt
Positionen (mehrere Zeilen pro PO)
- Artikelcode / SKU
- Beschreibung
- Menge
- Maßeinheit (UOM)
- Einzelpreis
- Positionssumme
- Lieferdatum (pro Zeile)
Die Positionen sind der Punkt, an dem die Extraktion schwierig wird. Ein Kopffeld ist ein einzelner Wert. Eine Positionstabelle kann 20, 50 oder über 100 Zeilen enthalten – jede mit eigenem Artikelcode, Beschreibung, Menge, UOM und Preis – verteilt über mehrere Seiten mit Spaltenanordnungen, die sich von Lieferant zu Lieferant ändern. Ein Lieferant verwendet „EA" als Maßeinheit, ein anderer „PCS", ein dritter schreibt „Each" aus. Eine Bestellung von einem Industrielieferanten kann Liefertermine pro Position angeben, während eine Einzelhandels-PO alles unter einem Versanddatum zusammenfasst. Positionen richtig zu erfassen – über Formate, Lieferanten und Seitenumbrüche hinweg – unterscheidet brauchbare Extraktion von einem Teilergebnis, das noch manuelle Bereinigung benötigt.
Das ist die Lücke, in die vorlagenbasierte Tools tappen. Wenn Sie eine Vorlage für das Layout von Lieferant A konfiguriert haben – „PO-Nummer befindet sich bei den Koordinaten (50, 20), Positionen beginnen in Zeile 8" – funktioniert das, bis Lieferant A seine PO-Vorlage ändert, weil er sein ERP aktualisiert hat. Jetzt befindet sich die PO-Nummer an Position (75, 30), und Ihre Vorlage extrahiert stillschweigend den falschen Wert in die PO-Nummern-Spalte. Multiplizieren Sie das mit 50 Lieferanten, und die Vorlagenpflege wird zum Vollzeitjob. Für einen breiteren Blick darauf, wie KI dieses Paradigma über Dokumenttypen hinweg verändert, lesen Sie unseren Leitfaden zu was KI-Dokumentenextraktion tatsächlich ist.
PO-Extraktion vs. PO-Verarbeitung vs. OCR – die wichtigsten Unterschiede
Diese drei Begriffe tauchen in angrenzenden Beschaffungsdiskussionen auf, aber sie zu vermischen führt zum Kauf von Tools, die das falsche Problem lösen.
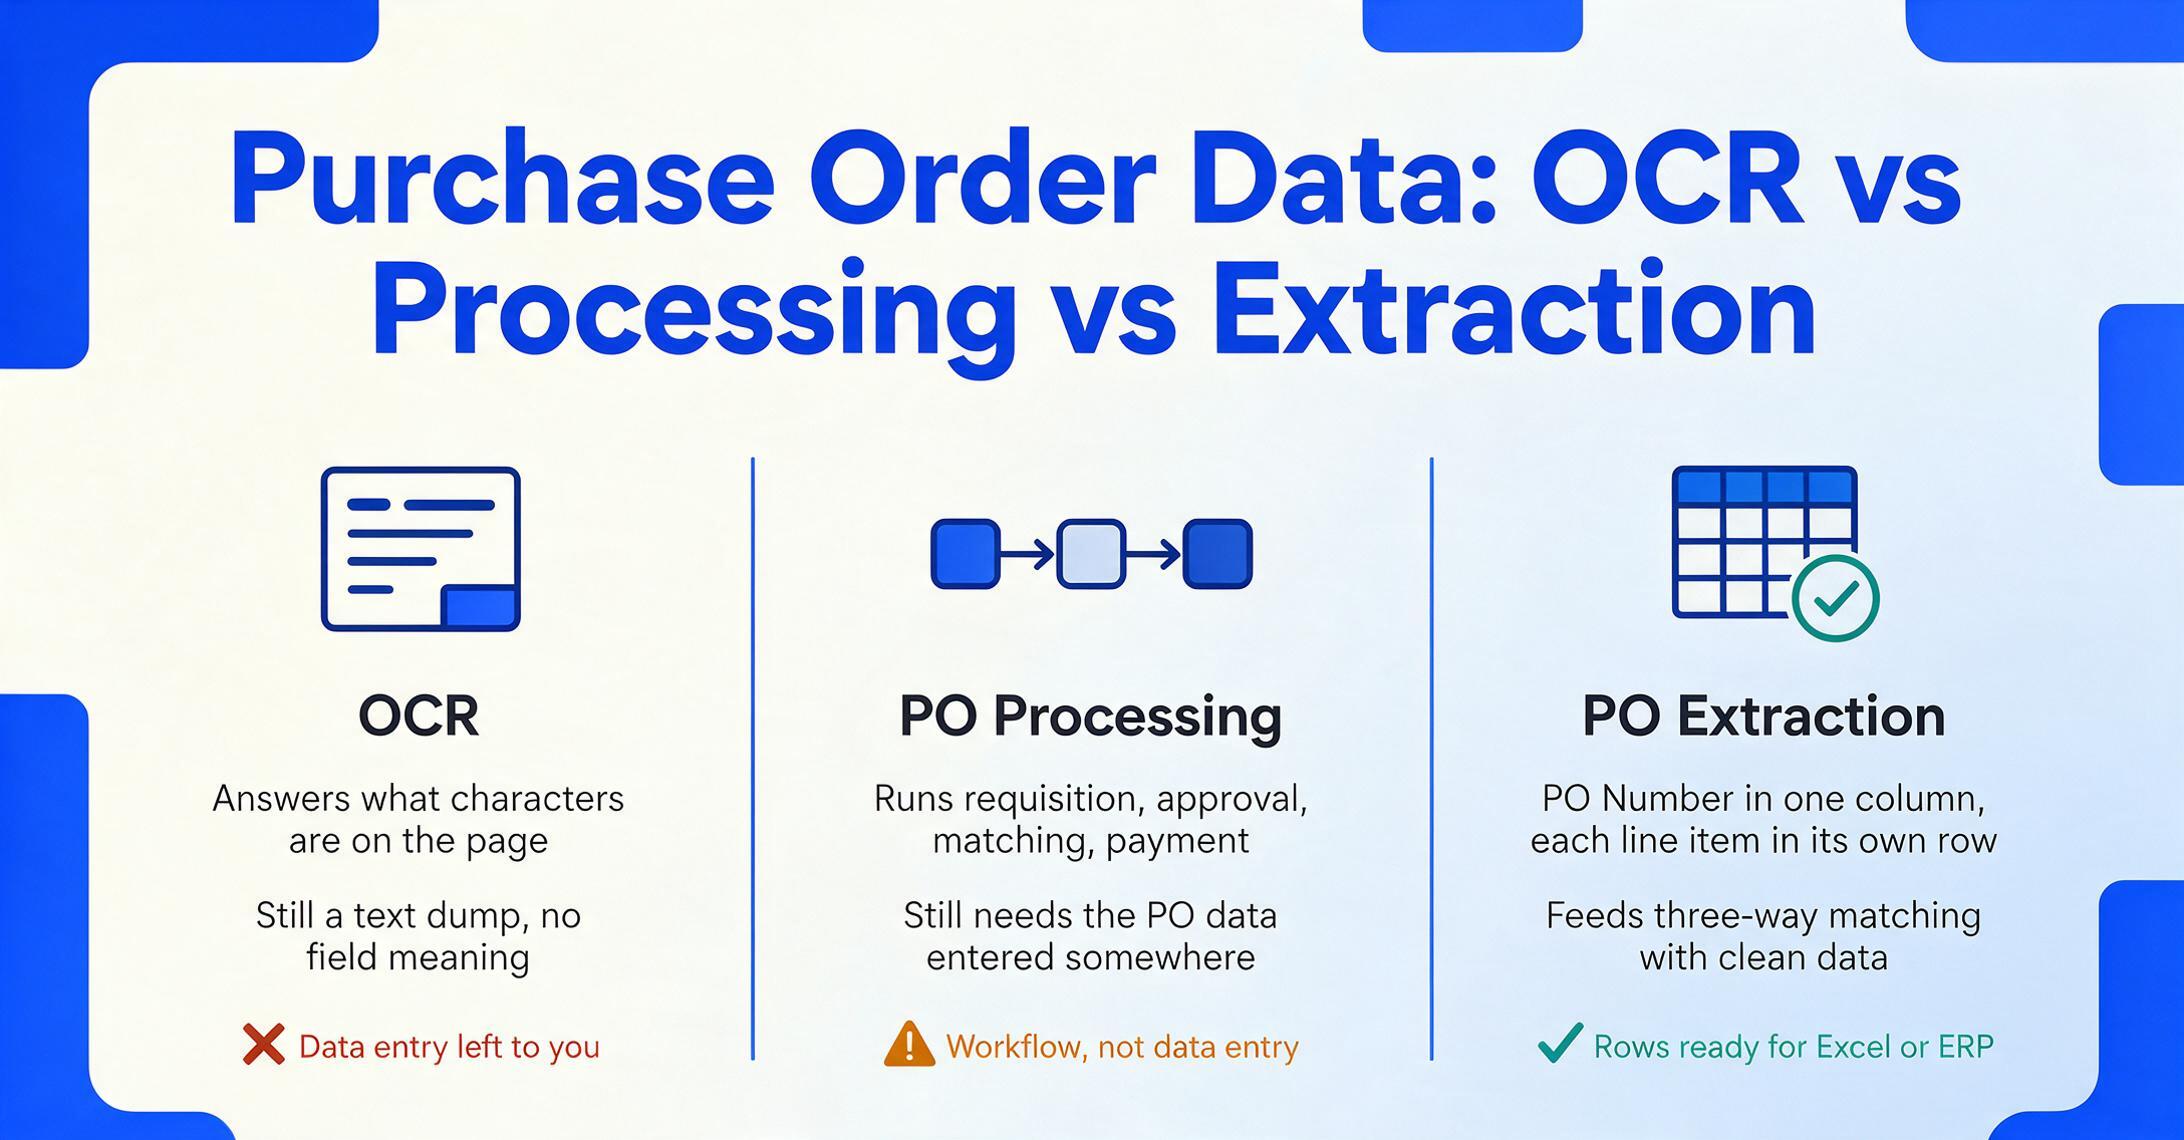
OCR (Optische Zeichenerkennung) wandelt ein Bild von Text in maschinenlesbare Zeichen um. Es beantwortet die Frage „Welche Zeichen sind auf dieser Seite?“, hat aber kein Verständnis dafür, was diese Zeichen bedeuten. Schickt man eine PO durch OCR, erhält man so etwas wie PURCHASE ORDER PO-2026-0412 DATE 12/04/2026 VENDOR Atlas Fasteners QTY 500 DESC M8 Hex Bolt UNIT $0.42 TOTAL $210.00 – ein Text-Dump. Man muss jedes Feld weiterhin manuell extrahieren und in die richtige Zelle tippen. OCR hat die Zeichen digitalisiert. Es hat nicht die Dateneingabe übernommen.
PO-Verarbeitung ist der vollständige Beschaffungsworkflow rund um die Extraktion: Erstellung der Anforderung, Weiterleitung zur Genehmigung, Ausstellung der Bestellung, Warenannahme, Abgleich der PO mit Rechnung und Wareneingang (Drei-Wege-Abgleich), Zahlungsplanung und Archivierung. Verarbeitungstools wie SAP Ariba, Coupa oder Oracle Procurement verwalten den Workflow – aber sie benötigen die PO-Daten, die irgendwo ins System eingegeben werden. Dieser Eingabeschritt ist die Extraktion.
PO-Datenextraktion ist der spezifische Schritt, der ein PO-Dokument in strukturierte Felder verwandelt: PO-Nummer in einer Spalte, Lieferant in einer anderen, jede Positionszeile in einer eigenen Zeile, die Summe in einer Zelle, die Excel summieren kann. Es ist die Dateneingabeebene, die in die Verarbeitung einfließt. Man kann eine erstklassige Workflow-Automatisierung für die Beschaffung haben, aber wenn der Extraktionsschritt falsche Daten liefert – falsche Mengen, nicht übereinstimmende Artikelcodes, falsche Summen – automatisiert der Workflow die Fehler nur schneller.
Die Folge von Extraktionsfehlern ist ein fehlgeschlagener Drei-Wege-Abgleich. Die AP-Benchmarks 2025 von Ardent Partners berichten, dass Best-in-Class-AP-Teams eine Ausnahmerate von 9 % beim Rechnungsabgleich erreichen – der Rest liegt im Durchschnitt bei 22 %. Jede Abweichung, die auf einen PO-Dateneingabefehler zurückgeht, kostet einen AP-Sachbearbeiter etwa 30 Minuten für die Untersuchung über Beschaffung, Warenannahme und Finanzen hinweg. Die Extraktion bereits im PO-Stadium korrekt durchzuführen, verhindert diese Ausnahmen, bevor sie den Abgleich erreichen.
So funktioniert die PO-Datenextraktion
Hinter der Oberfläche basiert die Extraktion auf einem grundlegenden Wandel, der in den letzten zwei Jahren stattfand: der Übergang von positionsbasierter zu semantischer Extraktion.
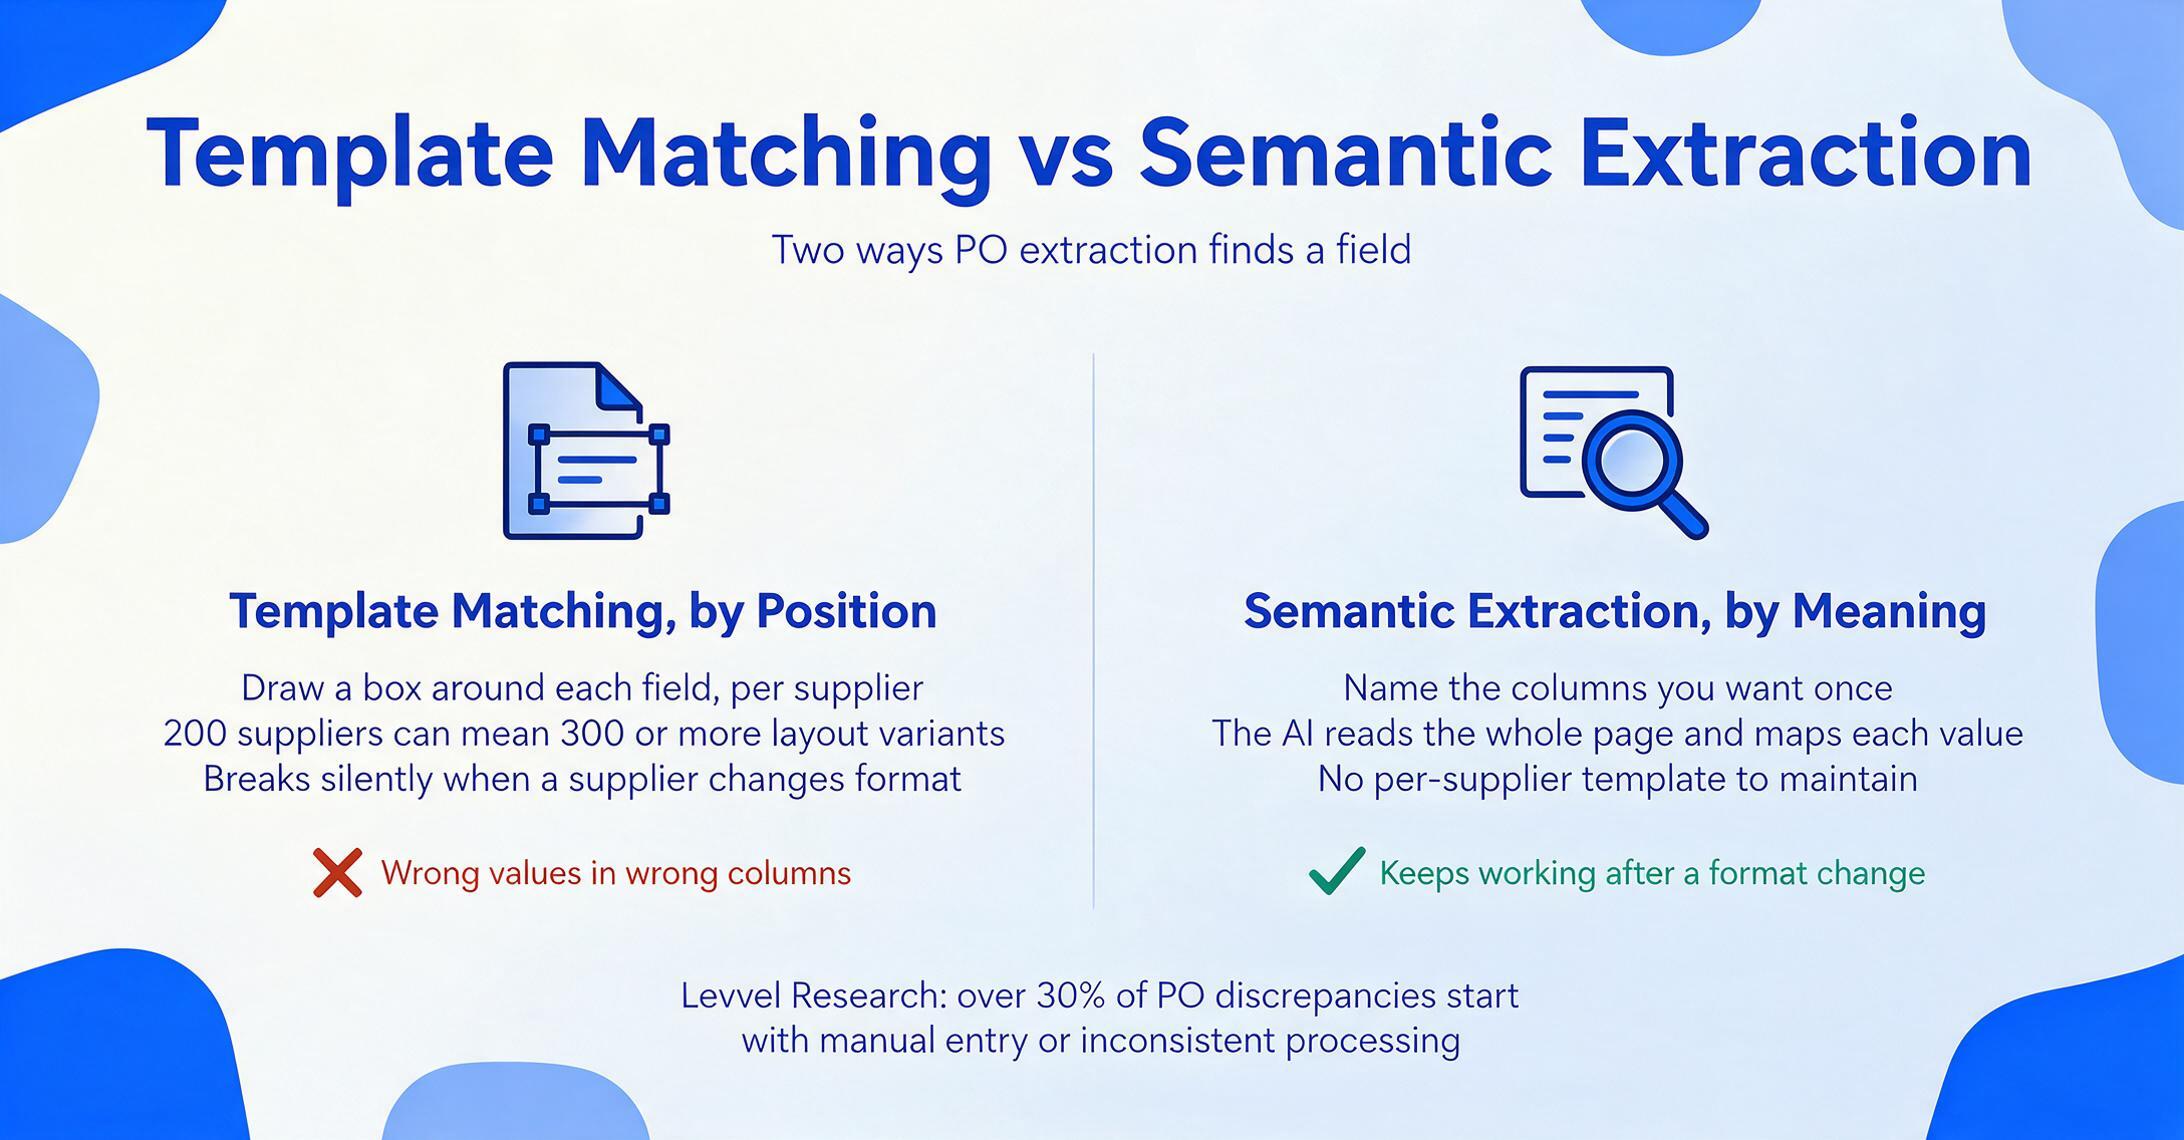
Der alte Weg – Template-Matching. Traditionelle PO-Extraktionstools arbeiten positionsbasiert. Sie zeichnen ein Rechteck um „PO-Nummer" auf dem Layout eines Lieferanten und teilen dem System mit: „Der Wert steht rechts." Dies wiederholen Sie für jeden Lieferanten, jede Layoutvariante, jedes Feld. Ein mittelständischer Hersteller mit 200 aktiven Lieferanten könnte mit über 300 Formatvarianten konfrontiert sein. Schlimmer noch: Wenn ein Lieferant sein PO-Format ändert – was jedes Mal passiert, wenn er sein ERP-System aktualisiert oder sein Branding überarbeitet –, bricht das Template stillschweigend und beginnt, falsche Werte in falsche Spalten zu ziehen. Levvel Research fand heraus, dass über 30 % der PO-Diskrepanzen auf manuelle Eingaben oder inkonsistente Verarbeitung zurückzuführen sind – und templatebasierte Extraktion automatisiert diese Inkonsistenz lediglich, anstatt sie zu beheben.
Der moderne Weg – semantische Extraktion. Moderne KI-basierte Extraktion arbeitet nach Bedeutung, nicht nach Position. Statt das System darauf zu trainieren, wo sich jedes Feld befindet, legen Sie fest, was Sie finden möchten: „PO-Nummer", „Lieferantenname", „Artikelbeschreibung", „Menge", „Einzelpreis", „Positionssumme". Die KI liest das gesamte Dokument, versteht, was jeder Textabschnitt im Kontext bedeutet, und ordnet ihn der richtigen Ausgabespalte zu – unabhängig davon, wo er auf der Seite erscheint. Dies ist die Benutzerdefinierte Spaltenextraktion: Sie definieren die gewünschten Ausgabespalten, und die KI lokalisiert die passenden Daten überall auf der Seite, indem sie versteht, was jedes Feld bedeutet. Ein Feld mit der Bezeichnung „PO #" auf dem Dokument eines Lieferanten und „Bestellreferenz" auf dem eines anderen wird als dasselbe erkannt, weil die KI die semantische Rolle versteht, nicht den Beschriftungstext.
So sieht die Pipeline von Anfang bis Ende aus:
Hochladen
PDFs, Scans oder Fotos ablegen – einzelne PO oder ein Stapel von 50. Kein Vorsortieren nach Lieferant, kein Umbenennen, keine Formatvorgaben außer Lesbarkeit. Jedes Dokument wird als visuelles Bild empfangen, nicht als Text – die KI sieht Layout, Schriftarten, Tabellen und Leerraum so, wie ein menschlicher Leser es täte.
Spalten definieren
Geben Sie die Feldnamen ein, die extrahiert werden sollen – „PO-Nummer", „Lieferant", „Artikelcode", „Beschreibung", „Menge", „Einzelpreis", „Positionssumme". Diese werden zu den Kopfzeilen Ihrer Ausgabetabelle. Keine Vorlageneinrichtung, keine Trainingsdaten, keine Zonenzeichnung. Dieselbe Spaltenliste funktioniert über jedes Lieferantenformat hinweg, weil die KI nach Bedeutung statt nach Position zuordnet.
KI liest & ordnet zu
Das Vision-Modell scannt jede Seite, erkennt, welche Textblöcke welchen Feldern entsprechen, indem es deren semantische Rolle versteht, und ordnet sie Ihren Spalten zu. Eine Menge von „500" neben einer Artikelbeschreibung wird als Positionsmenge erkannt, nicht als PO-Nummer. Ein „Lieferadresse"-Block wird von einem „Rechnungsadresse"-Block durch seinen umgebenden Kontext unterschieden – selbst wenn beide ähnliche Adressstrukturen enthalten. Positionen, die sich über Seitenumbrüche erstrecken, werden zu durchgehenden Zeilen zusammengesetzt.
Strukturierte Daten exportieren
Als Excel (XLSX), CSV oder JSON herunterladen. Jede PO erhält eine Zeile in der Kopftabelle; Positionen werden in separate Zeilen aufgeteilt, wobei die PO-Kopffelder für Filter und Pivot-Tabellen wiederholt werden. Oder schreiben Sie Ergebnisse direkt in Google Sheets. Die Daten sind vorformatiert – Daten als JJJJ-MM-TT, Beträge als einfache Zahlen – sodass keine Neuformatierung zwischen Extraktion und Import in QuickBooks, NetSuite oder Ihr ERP nötig ist.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wann Sie PO-Datenextraktion benötigen
Nicht jedes Unternehmen benötigt Extraktion. Ein kleiner Betrieb, der fünf POs pro Monat an dieselben drei Lieferanten ausstellt, kann diese während einer Kaffeepause in eine Tabellenkalkulation eingeben. Extraktion lohnt sich, wenn Menge und Vielfalt eine Schwelle überschreiten, ab der manuelle Eingabe kein kleines Ärgernis mehr ist, sondern sich über Lieferanten, Abteilungen und Monate hinweg aufsummiert.
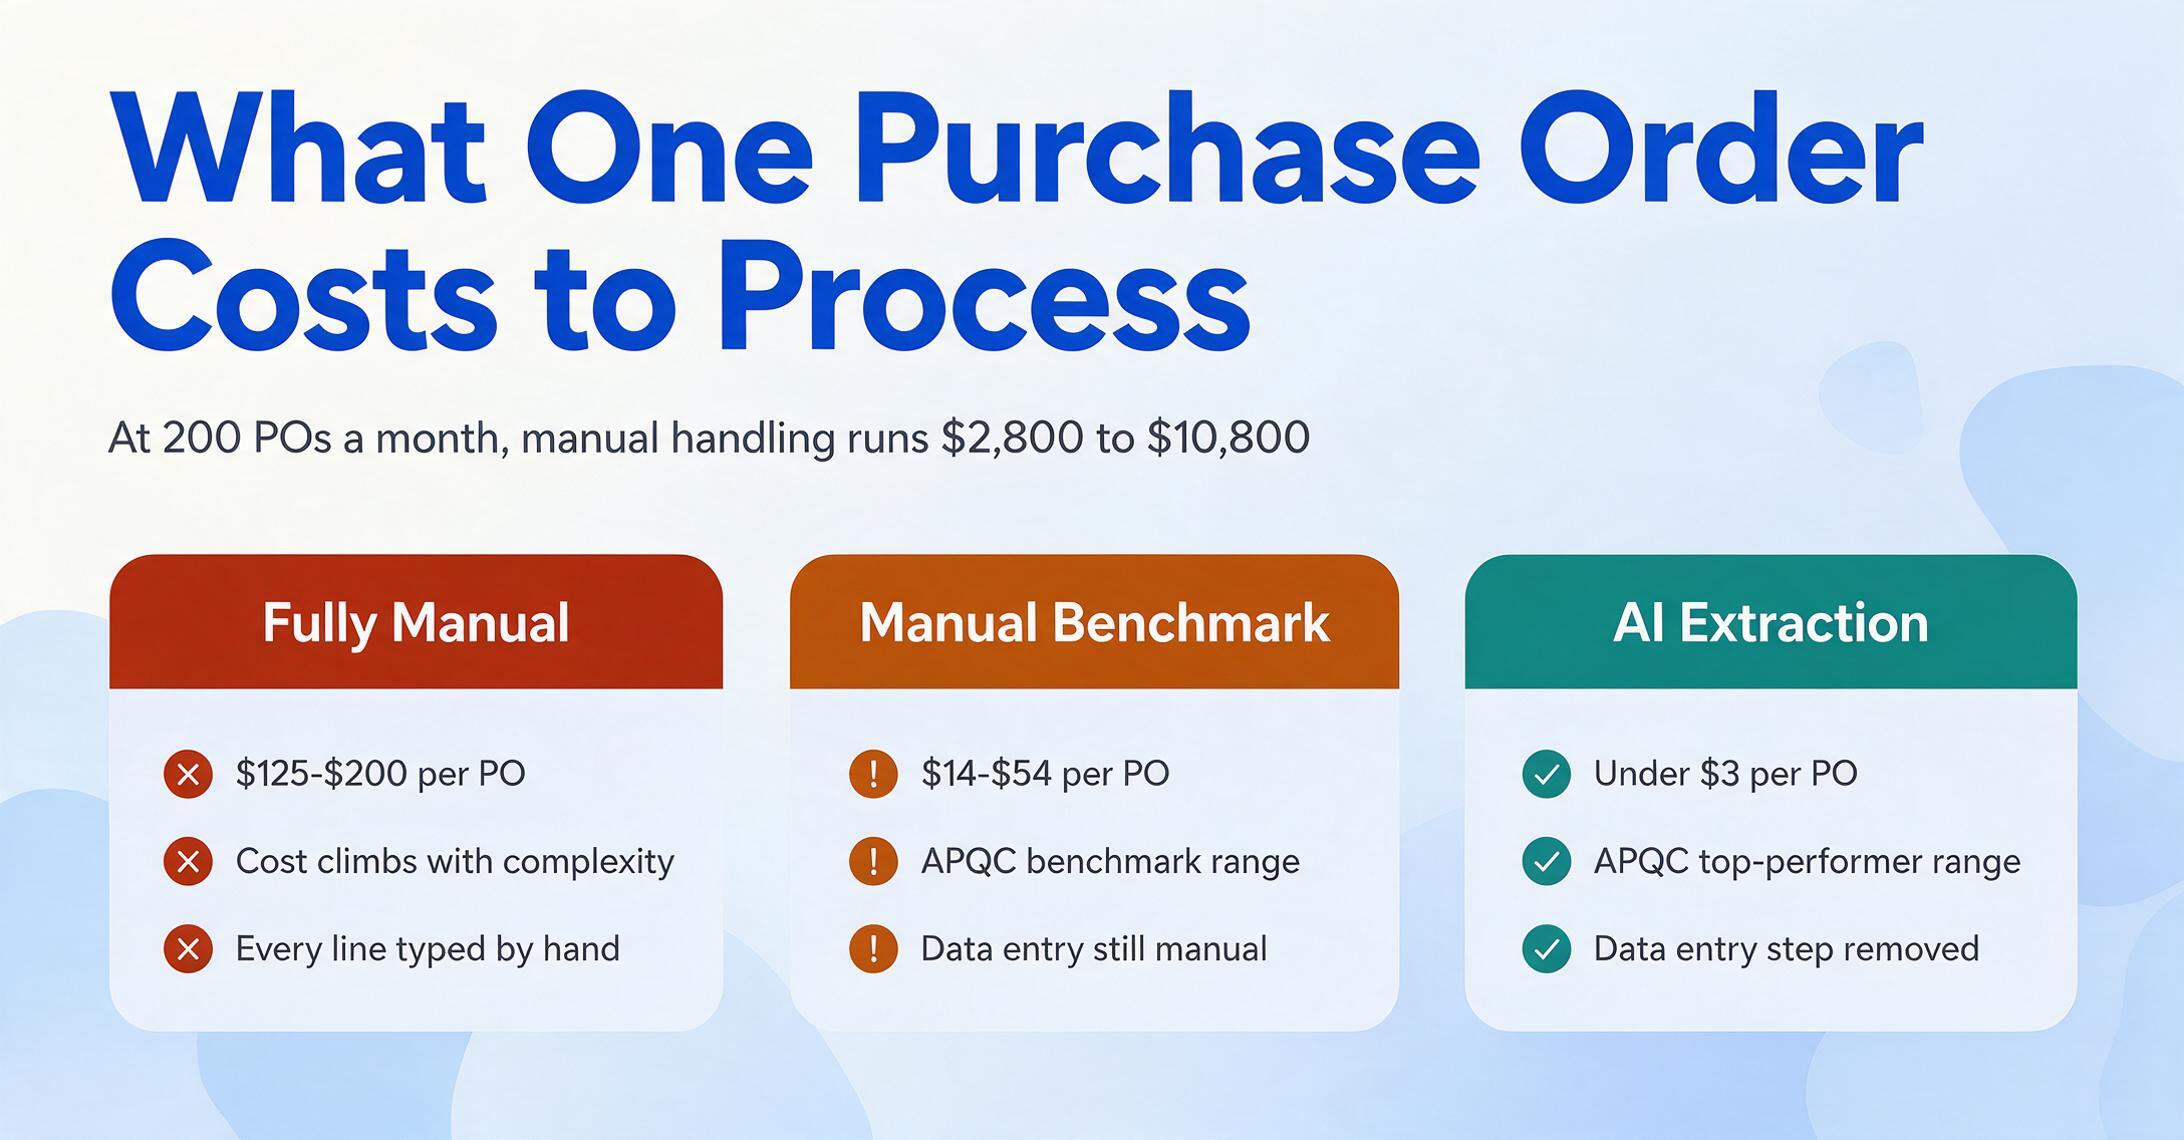
1. Das PO-Volumen übersteigt die Personalkapazität. Daten von CAPS Research zeigen, dass im Industriesektor die Beschaffungsausgaben durchschnittlich 55,64 % des Umsatzes betragen — das bedeutet für einen Hersteller mit 50 Mio. $ Umsatz, dass etwa 27,8 Mio. $ über Bestellungen fließen. APQC-Benchmarks zeigen, dass die manuelle PO-Verarbeitung zwischen 14 und 54 $ pro PO kostet, wobei vollständig manuelle Prozesse je nach Komplexität 125–200 $ pro PO erreichen. Bei 200 POs pro Monat sind das 2.800 bis 10.800 $ pro Monat an Verarbeitungskosten, bevor auch nur eine einzige Rechnung abgeglichen wird. Automatisierte Extraktion — durch die Eliminierung des Dateneingabeschritts — drückt die Kosten pro PO in Richtung der unter-3-$-Spanne, die APQC für Top-Performer benchmarkt.
2. Jeder Lieferant sendet ein anderes PO-Format. Das ist die universelle Realität im Beschaffungswesen. Selbst zwei Lieferanten, die beide SAP nutzen, erzeugen POs, die sich völlig unterscheiden, weil ihre Administratoren unterschiedliche Ausgabevorlagen konfiguriert haben. Einer verwendet „PO-2026-XXXX" als PO-Nummernformat; ein anderer verwendet sechs Ziffern ohne Präfix. Einer platziert Positionszeilen in einer umrandeten Tabelle; ein anderer verwendet eingerückte Textblöcke ohne sichtbare Tabellenstruktur. Einer enthält Liefertermine pro Position; ein anderer setzt ein einziges Versanddatum in den Kopfbereich. Vorlagenbasierte Tools scheitern an dieser Vielfalt. Semantische Extraktion hängt überhaupt nicht vom Format ab — das ist der Unterschied zwischen einem Tool, das Sie einmal einrichten, und einem Tool, das Sie für immer warten. Für eine praktische Anleitung zu diesem Workflow lesen Sie unseren Leitfaden zu automatisierter Bestelldateneingabe.
3. Sie benötigen Positionsdetails, nicht nur Kopfsummen. Viele Extraktionstools verarbeiten Kopffelder gut: PO-Nummer, Datum, Lieferant, Gesamtsumme. Wenn Sie jedoch Positionen benötigen — Artikelcodes, Beschreibungen, Mengen, Einzelpreise — für Wareneingangsprüfung, Inventarabstimmung oder Drei-Wege-Abgleich, werden die Anforderungen an das Tool strenger. Eine Nur-Kopf-Extraktion, die jemanden immer noch zwingt, 50 Positionen aus einer 3-seitigen Bestellung manuell einzutippen, hat das Dateneingabeproblem nicht wirklich gelöst. Dies ist der häufigste Entdeckungspunkt: Teams stellen fest, dass ihr aktueller Prozess nur 20 % der Felder automatisiert, aber 80 % der Datenpunkte in den Positionen liegen.
4. PO-Datenfehler führen zu Fehlern beim Drei-Wege-Abgleich. Wenn eine PO bei der Datenerfassung die falsche Menge, den falschen Einzelpreis oder die falsche Mengeneinheit aufweist, wird der nachgelagerte Abgleichsschritt – der die PO mit dem Wareneingang und der Lieferantenrechnung vergleicht – eine Abweichung feststellen. Jede festgestellte Abweichung erfordert eine manuelle Untersuchung: Wurde die PO falsch eingegeben? Hat der Lieferant eine andere Menge geliefert? Wird in der Rechnung etwas abgerechnet, das nicht bestellt wurde? Wenn die Ursache ein Fehler bei der PO-Dateneingabe ist, verbringen Sie 30 Minuten damit, ein Problem zu entdecken, dessen Entstehung 3 Sekunden gedauert hat. Die Verbesserung der Extraktionsgenauigkeit in der PO-Phase verhindert, dass diese Ausnahmen überhaupt erst in die Abgleichswarteschlange gelangen. Weitere Informationen zu dieser Dynamik finden Sie in unserem Artikel über warum der Drei-Wege-Abgleich im Einkauf scheitert.
Worauf Sie bei einem PO-Extraktionstool achten sollten
Extraktionstools reichen von einfachen OCR-Wrappern bis hin zu KI-nativen Plattformen. Die Funktionslisten klingen alle ähnlich, aber diese Kriterien unterscheiden sie tatsächlich im täglichen Einkaufseinsatz. Für die vollständige feldbezogene Referenz – Kopffelder, Positionszeilen, Exportformate und das vollständige Auswahlframework – beginnen Sie mit unserem vollständigen Leitfaden zur Bestellungs-Extraktion.
Ohne Vorlage. Dies ist der wichtigste Unterschied. Ein Tool, das Sie dazu zwingt, Parsing-Vorlagen pro Lieferantenformat zu erstellen und zu pflegen, ist keine Extraktion – es ist Vorlagenverwaltung mit etwas Extraktion am Rande. Die richtige Frage an einen Anbieter: „Wenn ein Lieferant sein PO-Layout morgen ändert, was muss ich tun?" Wenn die Antwort die Aktualisierung einer Vorlage, das Neulernen eines Modells oder das Neuzuordnen von Feldern beinhaltet, kaufen Sie eine Wartungslast. Die Alternative ist die Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Feldnamen einmal ein – „PO-Nummer", „Artikelnr.", „Menge" – und die KI findet sie in jedem Lieferantenformat, weil sie nach Bedeutung und nicht nach Position liest. Die von Ihnen eingegebenen Spaltennamen werden zu Ihren Ausgabe-Headern. Für einen tieferen Einblick, warum dieser Unterschied wichtig ist, lesen Sie über das Extrahieren von Bestellfeldern nach Excel.
Qualität der Positionszeilen-Extraktion über Seitenumbrüche hinweg. Tools, die Kopffelder zuverlässig extrahieren, sind Grundvoraussetzung. Positionszeilen – insbesondere bei mehrseitigen POs mit inkonsistenten Spaltenlayouts und Mengeneinheiten-Varianten – sind der eigentliche Test. Bitten Sie darum, das Tool mit einer 4-seitigen PO mit einer 30-zeiligen Positionstabelle zu testen, die sich über die Seiten 2 bis 4 erstreckt, mit zusammengeführten Zellen in der Beschreibungsspalte und Mengen, die auf mehrere Liefertermine aufgeteilt sind. Wenn es das sauber verarbeitet, wird es alles andere auch verarbeiten.
Batch-Verarbeitungsfähigkeit. Können Sie 50 POs von 20 verschiedenen Lieferanten gleichzeitig hochladen und eine einheitliche Tabelle zurückbekommen? Oder müssen Sie sie einzeln verarbeiten? Batch-Verarbeitung ist der Unterschied zwischen „Dieses Tool spart mir Zeit pro PO" und „Dieses Tool spart mir Stunden pro Tag". Die Ausgabe sollte eine einzige Tabelle sein, in der alle POs zusammengeführt sind – gleiche Spalten, gleiche Struktur – bereit für Analyse, Abgleich oder Import. Weitere Informationen zu diesem Workflow finden Sie in unserem Leitfaden zur Batch-PO-Extraktion nach Excel.
Ausgabeformat und Integration. Die Ausgabe sollte zu Ihrem Einkaufsworkflow passen. Wenn Sie alles über Excel laufen lassen, ist der XLSX-Export mit korrekt typisierten Spalten unerlässlich. Wenn Ihr Team in Google Sheets arbeitet, ist ein Tool, das Ergebnisse direkt in ein Sheet schreibt – und damit den Upload-Download-Import-Zyklus eliminiert – den Unterschied wert. Ein dediziertes Google-Sheets-Add-on für die PO-Extraktion ermöglicht es Ihnen, POs zu verarbeiten, ohne Ihre Tabelle zu verlassen. CSV und JSON sind wichtig, wenn Sie Daten in NetSuite, QuickBooks oder ein benutzerdefiniertes ERP einspeisen.
Umgang mit realen PO-Edge-Cases. Teillieferungen, bei denen eine PO mehrere Waren eingänge erzeugt. Abweichende Maßeinheiten – die PO bestellt in „Cases", aber die Positionen geben „Units per Case" an. Steuern und Versandkosten, die im Kopf erscheinen, aber für die Kostenrechnung auf die Positionen verteilt werden sollten. Blanko-POs, die Monate an Lieferungen mit variablem Preis abdecken. Ein Tool, das 95 % Ihrer POs verarbeitet, aber bei den 5 % leicht ungewöhnlichen Fällen still scheitert, schafft mehr Risiko als ein Tool, das seine Grenzen ehrlich benennt. Testen Sie das Tool mit Ihren komplexesten POs – den Blanko-Aufträgen, den internationalen Lieferanten-POs mit Doppelwährung, den handschriftlich markierten POs kleinerer Anbieter – nicht mit Ihren saubersten.
Häufig gestellte Fragen
Funktioniert die PO-Erfassung mit handschriftlichen Bestellungen?
Ja, mit Einschränkungen. Moderne KI-Erfassungstools, die visionbasierte Modelle verwenden, können Handschrift auf Bestellungen lesen – einschließlich handschriftlicher Mengen, manueller Korrekturen und ausgefüllter Formularfelder. Die Genauigkeit hängt von der Lesbarkeit der Handschrift ab: Deutliche Druckschrift wird zu über 90 % erfasst, während dichte Schreibschrift in Scans mit niedriger Qualität schlechter abschneidet. Der Hauptvorteil der semantischen Erfassung liegt hier darin, dass die KI den Feldkontext zur Disambiguierung nutzt: Wenn sie nach einer „Menge" sucht und neben einem getippten „500" ein handschriftliches „520" sieht, kann sie ableiten, welche Zahl die tatsächliche Bestellmenge ist. Bei Bestellungen, die vollständig handschriftlich eintreffen – häufig bei kleineren Lieferanten, die Papierformulare ausfüllen – ist die Erfassungsgenauigkeit mit der Rechnungserfassung vergleichbar: gut genug für die Prüfung, nicht für den vollautomatischen Betrieb. Weitere Informationen zu diesem Szenario finden Sie in unserem Leitfaden zur Erfassung handschriftlicher Bestellungen.
Kann die PO-Erfassung Positionszeilen verarbeiten, die sich über mehrere Seiten erstrecken?
Ja, das ist eine Kernfunktion moderner KI-Erfassung. Wenn eine Positionstabelle über Seitengrenzen hinweg bricht – üblich bei Bestellungen mit 20+ Positionen – erkennt die KI, dass die Tabelle auf der nächsten Seite fortgesetzt wird, und setzt die Zeilen zu durchgehenden Datensätzen zusammen. Die wichtigste Voraussetzung ist, dass die Spaltenüberschriften auf der Fortsetzungsseite wiederholt werden oder visuell ableitbar sind. Wenn die zweite Seite die Spaltenüberschriften vollständig weglässt und darauf vertraut, dass der Leser sich die Spaltenreihenfolge von der ersten Seite merkt, kann die Genauigkeit sinken. Dies ist eines der Szenarien, die Sie bei der Bewertung eines Tools testen sollten – nehmen Sie eine mehrseitige Bestellung, bei der sich die Tabelle über Seiten erstreckt, und prüfen Sie, ob Positionszeilen ab Seite 2 in den richtigen Spalten landen.
Was ist mit unterschiedlichen Maßeinheiten – kann die Erfassung sie normalisieren?
KI-Erfassung kann jede Maßeinheit lesen, die der Lieferant verwendet – „EA", „PCS", „Each", „CTN", „BOX", „KG", „LB" – und in einer eigenen Maßeinheitsspalte erfassen. Die Normalisierung von Maßeinheiten (z. B. die Umrechnung von „CTN à 12" in 12 einzelne „EA") erfordert jedoch nachgelagerte Logik, da der Umrechnungsfaktor je nach Artikel variiert. Das Erfassungstool erfasst, was in der Bestellung steht. Die Umrechnung von „3 Kartons × 24 Einheiten/Karton = 72 Einheiten" ist ein Berechnungsschritt, der nach der Erfassung erfolgt – entweder in Ihrer Tabellenkalkulation, in Ihrem ERP oder über berechnete Spalten, mit denen Sie die Umrechnungsformel einmal definieren können. Die Aufgabe des Erfassungstools ist es, die Rohwerte genau zu erfassen, damit der Normalisierungsschritt saubere Eingaben erhält.
Wie unterscheidet sich die PO-Erfassung vom Drei-Wege-Abgleich?
PO-Erfassung und Drei-Wege-Abgleich sind aufeinanderfolgende Schritte in der Beschaffungskette, keine Alternativen. Die PO-Erfassung ist der Datenerfassungsschritt: Sie wandelt ein Bestelldokument in strukturierte Felder um. Der Drei-Wege-Abgleich ist der Prüfschritt: Er vergleicht die erfassten PO-Daten mit dem Wareneingang und der Lieferantenrechnung, um zu bestätigen, dass Bestelltes, Geliefertes und Berechnetes übereinstimmen. Die Erfassung erfolgt zuerst. Wenn die erfassten PO-Daten falsch sind – falsche Menge, falscher Einzelpreis, falscher Artikelschlüssel – schlägt der Drei-Wege-Abgleich mit einer falschen Abweichung fehl, und jemand muss nachforschen. Eine korrekte Erfassung im PO-Stadium ist die Voraussetzung für einen vollautomatischen Drei-Wege-Abgleich. Weitere Informationen dazu, wie diese Komponenten zusammenpassen, finden Sie in unserer Analyse zum PO-Rechnungsabgleich in der Fertigung.
Kann ich PO-Daten direkt in mein ERP extrahieren?
Die meisten Extraktionstools geben Daten an Excel, CSV oder JSON aus – Formate, die jedes ERP importieren kann. Der typische Ablauf ist: PO-Daten extrahieren → Ausgabe prüfen → Datei in Ihr ERP importieren (QuickBooks, NetSuite, SAP, Microsoft Dynamics). Der Vorteil ist, dass die Daten bereits vorformatiert ankommen – Daten als JJJJ-MM-TT, Beträge als einfache Zahlen mit zwei Dezimalstellen, Artikelnr. als Text – sodass keine Neuformatierung zwischen Extraktion und Import nötig ist. Einige Tools bieten direkte ERP-Integrationen über API, aber der CSV/Excel-Importweg funktioniert praktisch für jedes System und erfordert keine IT-Einrichtung. Eine Schritt-für-Schritt-Anleitung finden Sie in unserem Leitfaden zum Konvertieren von Bestellungen in Excel.
Welche Dateiformate und Dokumenttypen unterstützt die PO-Extraktion?
Moderne Extraktionstools akzeptieren PDF (sowohl digital erstellt als auch gescannt), JPG, PNG und WebP. PDF ist das universelle Format – die meisten Lieferanten-Bestellungen kommen als PDF-E-Mail-Anhänge. Handyfotos von Papier-Bestellungen funktionieren, solange das Bild einigermaßen scharf und gut beleuchtet ist. Einige Tools unterstützen auch AVIF und TIFF. Die Formatflexibilität ist wichtig, weil Bestellungen über mehrere Kanäle eingehen: E-Mail-Anhänge, Lieferantenportale (PDF-Download), Fotos vom Handy eines Käufers auf einer Messe (JPG) und Altpapier-Bestellungen (zu PDF gescannt). Ein Tool, das nur ein Format verarbeitet, zwingt Sie, alles vor der Extraktion umzuwandeln. Für andere Dokumenttypen mit ähnlichen Extraktionsmustern finden Sie unsere Leitfäden zu Rechnungsdatenextraktion und Beleg-OCR.
Wie es weitergeht
Die PO-Datenextraktion liegt an der Schnittstelle zweier Beschaffungsrealitäten: dem universellen Problem unterschiedlicher Lieferantenformate und der nachgelagerten Abhängigkeit des Drei-Wege-Matchings von sauberen PO-Daten. Es gibt heute bereits Tools, die PO-Daten zuverlässig, über Formate und Lieferanten hinweg und ohne anbieterspezifische Vorlagen extrahieren – etwas, das noch vor zwei Jahren nicht möglich war. CAPS-Research-Daten, die Beschaffungsausgaben bei 55,64 % des Umsatzes zeigen, verdeutlichen, wie viel Geld über Bestellungen fließt, und APQC-Benchmarks mit einer Lücke von 11–51 $ pro PO zwischen manueller und automatisierter Verarbeitung machen den ROI-Fall konkret.
Der beste Weg, um zu prüfen, ob die Extraktion zu Ihrem Workflow passt, ist ein Test mit echten Bestellungen – idealerweise einer Mischung aus Ihren volumenstärksten Lieferanten und Ihren komplexesten POs. Wenn das Tool Ihre schwierigsten Fälle sauber bewältigt, sind die einfachen selbstverständlich. Für einen breiteren Überblick darüber, wie KI-Extraktion über Dokumenttypen hinweg funktioniert, beginnen Sie mit unserer grundlegenden Anleitung zur KI-Dokumentenextraktion. Oder wenn Sie bereit sind zu sehen, wie die Extraktion eine echte Bestellung verarbeitet, laden Sie eine Stichprobe hoch und probieren Sie es jetzt aus.