Le guide de l'expert-comptable pour l'extraction de données documentaires par IA
Quoi automatiser en premier
Les experts-comptables ne manquent pas de documents à traiter. Un cabinet moyen de 10 personnes traite chaque mois des relevés bancaires de 30 institutions financières, des factures de 200 fournisseurs, des reçus dans 15 orientations de photo, des W-2 et 1099 pour 40 employés, et des notes de frais assemblées à partir de SMS, d'e-mails et de papiers froissés. Ce qui manque aux experts-comptables, c'est un moyen de transformer ce mélange de documents en données structurées sans y consacrer 30 heures facturables par semaine. Ce guide couvre chaque grand type de document rencontré par un cabinet comptable, ce qui est extractible de chacun, ce qui nécessite encore un jugement humain, et le parcours de mise en œuvre qui s'insère entre deux saisons fiscales.
Points clés
- 60 % du temps de préparation fiscale n'est pas consacré aux décisions de jugement ou au conseil client — il est consacré à l'extraction et à la correction de données, ce qui engloutit 30 heures facturables par semaine dans un cabinet moyen de 10 personnes.
- Un outil d'extraction basé sur des modèles exige un nouveau modèle pour chaque fournisseur et chaque banque utilisés par vos 30 clients — et lorsqu'une colonne se décale silencieusement sur un relevé, le résultat semble correct mais les montants sont faux jusqu'à la réconciliation.
- Lorsque l'extraction devient indépendante du format — lisant selon ce que les champs signifient plutôt que selon leur emplacement — votre rôle passe d'opérateur de saisie à réviseur d'exceptions, le seul travail pour lequel un diplôme d'expert-comptable a été délivré.
Pourquoi les experts-comptables ont besoin de l'extraction de documents : le dossier chiffré
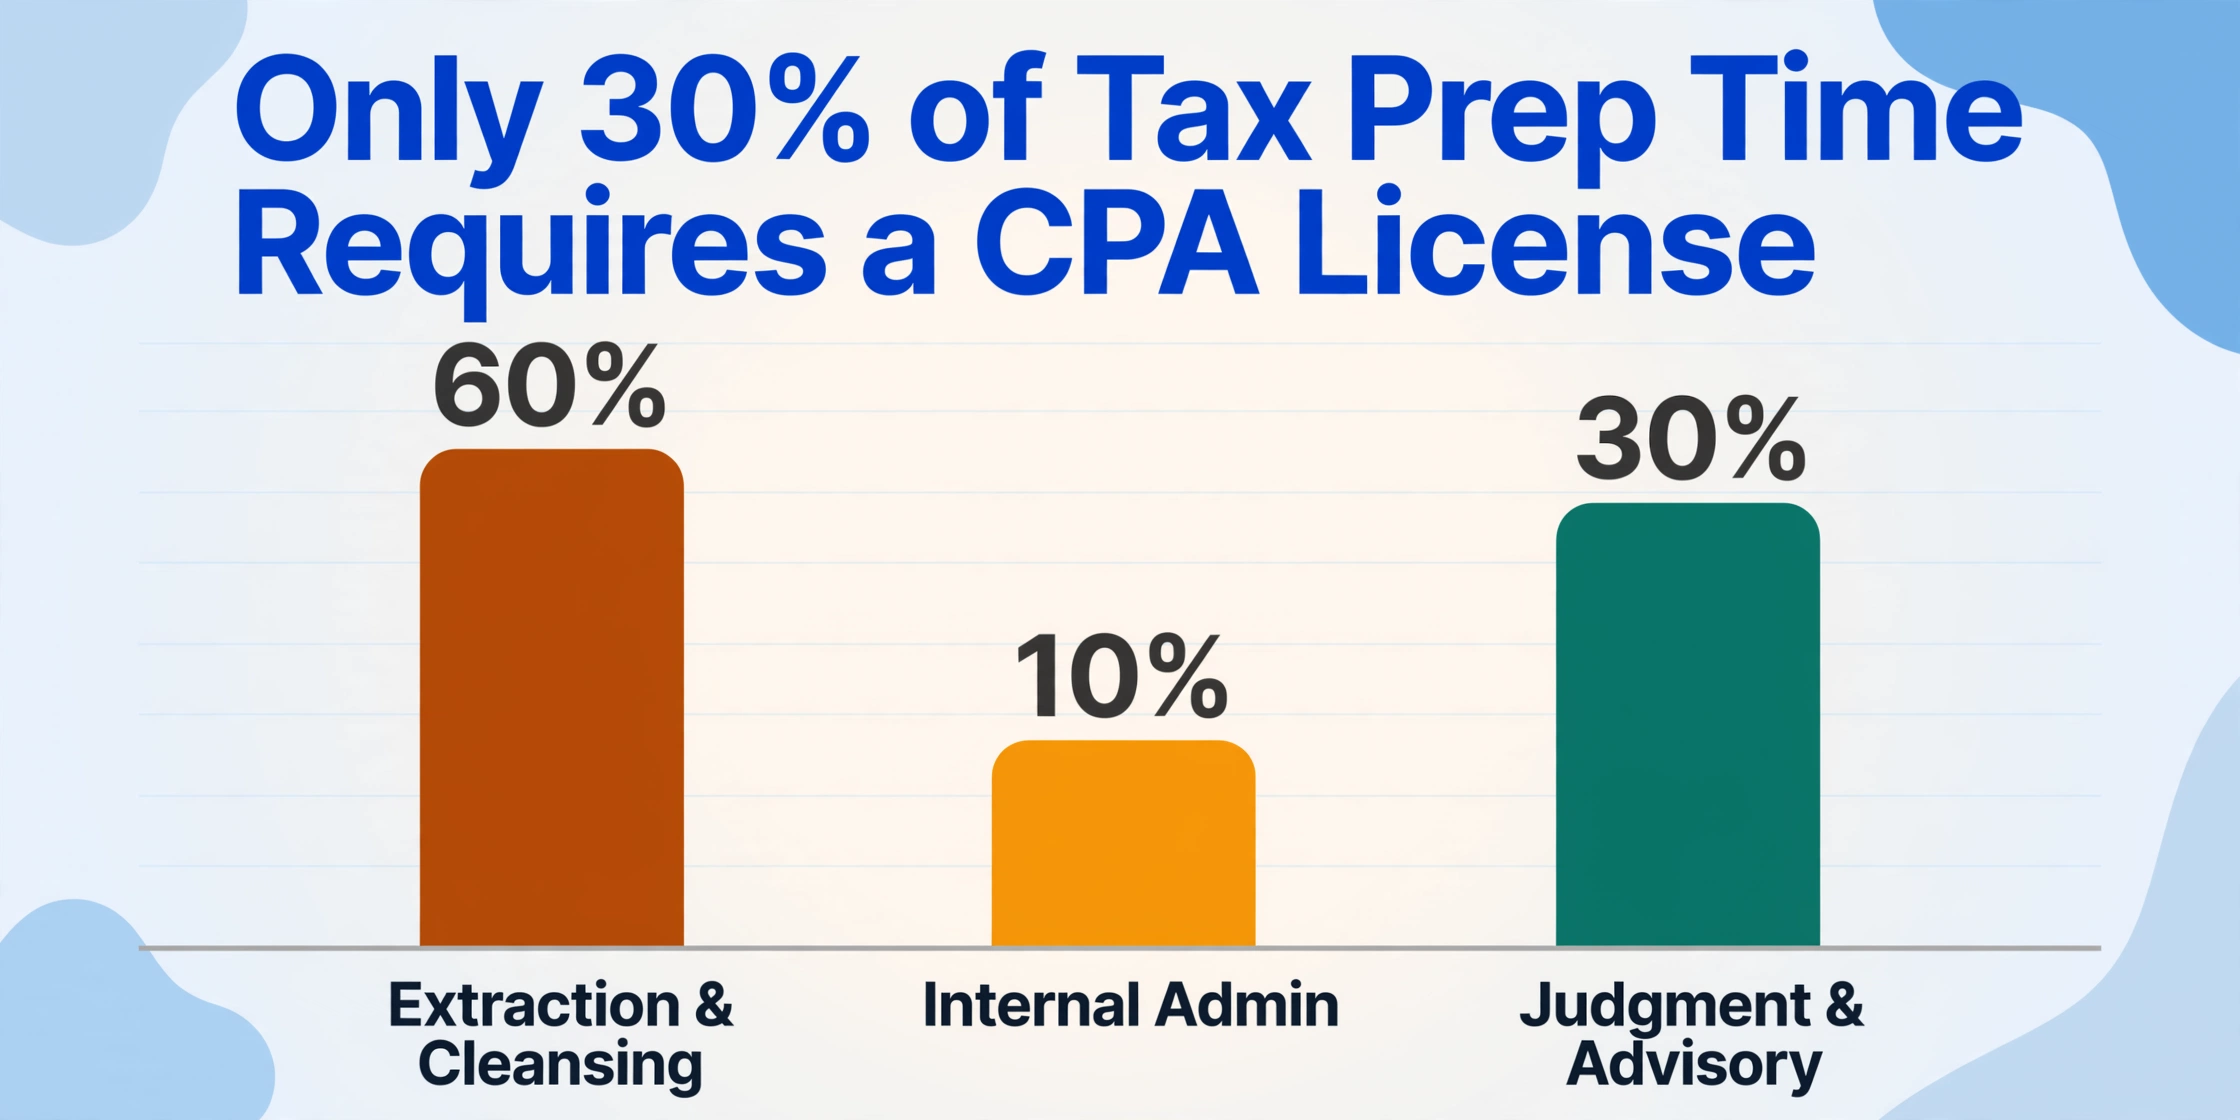
Une étude PwC des flux de travail de conformité fiscale a révélé que 60 % du temps consacré à la préparation des déclarations fiscales est absorbé par l'extraction, le nettoyage et l'analyse des données — et non par le jugement professionnel, l'évaluation des risques ou le conseil client. 10 % supplémentaires sont consacrés à l'administration interne. Il reste donc environ 30 % du temps d'un professionnel de la fiscalité pour le travail qui exige réellement un diplôme d'expert-comptable. Dans un cabinet facturant entre 200 et 400 $ de l'heure, rediriger ne serait-ce que la moitié de ce temps d'extraction vers des heures de conseil représente un gain de revenus qu'aucune embauche ne peut égaler.
L'observation structurelle que la plupart des cabinets comptables négligent : la saisie manuelle des données ne coûte pas seulement le temps passé à taper. Elle coûte aussi le temps de correction qui s'ensuit. Chaque erreur introduite lors de la saisie — 2 à 5 pour 100 champs, selon les références financières de l'APQC — doit être détectée et corrigée, et repérer un chiffre transposé sur une facture de 47 000 $ prend plus de temps que de le saisir correctement.
Côté résultats, l'extraction assistée par IA traite une page en 5 à 10 secondes — environ 18 fois plus vite que la saisie manuelle — avec une précision au niveau du champ sur texte imprimé constamment supérieure à 97 %. Le compromis n'est pas la vitesse contre la précision. C'est la vitesse et la précision contre la même équipe qui fait de la saisie trois jours par mois. Le U.S. Bureau of Labor Statistics prévoit une baisse d'environ 5 % de l'emploi en comptabilité entre 2023 et 2033, attribuant ce recul à l'automatisation logicielle des tâches de saisie — un signal que le marché n'attend pas que les cabinets se décident.
Mais « extraction de documents » n'est pas un seul problème. C'est six problèmes différents sous une même étiquette, car un relevé bancaire, une facture, un reçu, un W-2, une note de frais et un P60 britannique présentent chacun des défis d'extraction fondamentalement différents. Le reste de ce guide passe en revue chacun d'eux — ce qui est extractible, ce qui est difficile, combien de temps vous pouvez espérer récupérer, et où le jugement humain reste non négociable. Si vous découvrez la technologie d'extraction de documents, commencez par notre explication du fonctionnement de l'OCR et ce que cela signifie pour les flux de travail comptables — puis revenez ici pour l'analyse type de document par type de document.
Factures : la base de l'extraction
Les factures sont le type de document le plus souvent automatisé en comptabilité — et celui où l'extraction par IA montre son avantage le plus net sur les outils à base de modèles. Une facture fournisseur typique contient 8 à 15 champs structurés : nom du fournisseur, numéro de facture, date, date d'échéance, numéro de bon de commande, lignes de détail avec descriptions et quantités, sous-total, montant de taxe, frais de port et total. Sur un PDF propre d'un fournisseur connu, l'OCR à modèle traditionnel fonctionne de manière fiable. Le problème, c'est la partie « d'un fournisseur connu ».
Un cabinet comptable qui traite les dettes fournisseurs de ses clients ne reçoit pas des factures de 5 fournisseurs. Il reçoit des factures de tous les fournisseurs avec lesquels ses 30 clients font affaire — Amazon Business, Home Depot, des électriciens locaux avec des factures manuscrites, des abonnements SaaS avec des PDF par e-mail et des fournisseurs internationaux avec des lignes multidevises. Chaque nouveau fournisseur signifie une nouvelle mise en page, et les outils à base de modèles traitent chaque mise en page comme un nouveau projet de configuration. L'extraction par IA qui lit les documents en comprenant ce que chaque champ signifie — plutôt qu'en mémorisant sa position sur la page — traite la facture d'un nouveau fournisseur avec la même configuration qu'une facture familière.
Pour un examen plus approfondi de ce fonctionnement sur un lot à fort volume, consultez notre guide de traitement des factures par lots. Le point clé pour les comptables : l'extraction de factures est le type de document où vous devez mesurer le succès non pas par « combien de champs sont corrects sur la facture du fournisseur A », mais par « combien de nouveaux fournisseurs vous pouvez intégrer sans toucher à la configuration d'extraction ».
Relevés bancaires : le goulot d'étranglement de la réconciliation
Les relevés bancaires sont le type de document le plus volumineux dans la plupart des cabinets comptables — et celui où la diversité des formats frappe le plus durement. Un cabinet avec 30 clients peut recevoir des relevés mensuels de Chase, Wells Fargo, Bank of America, de coopératives de crédit régionales, de banques en ligne comme Mercury et Relay, et d'institutions internationales comme Revolut — chacune avec des dispositions de colonnes, des formats de date et des conventions de regroupement des transactions différentes.
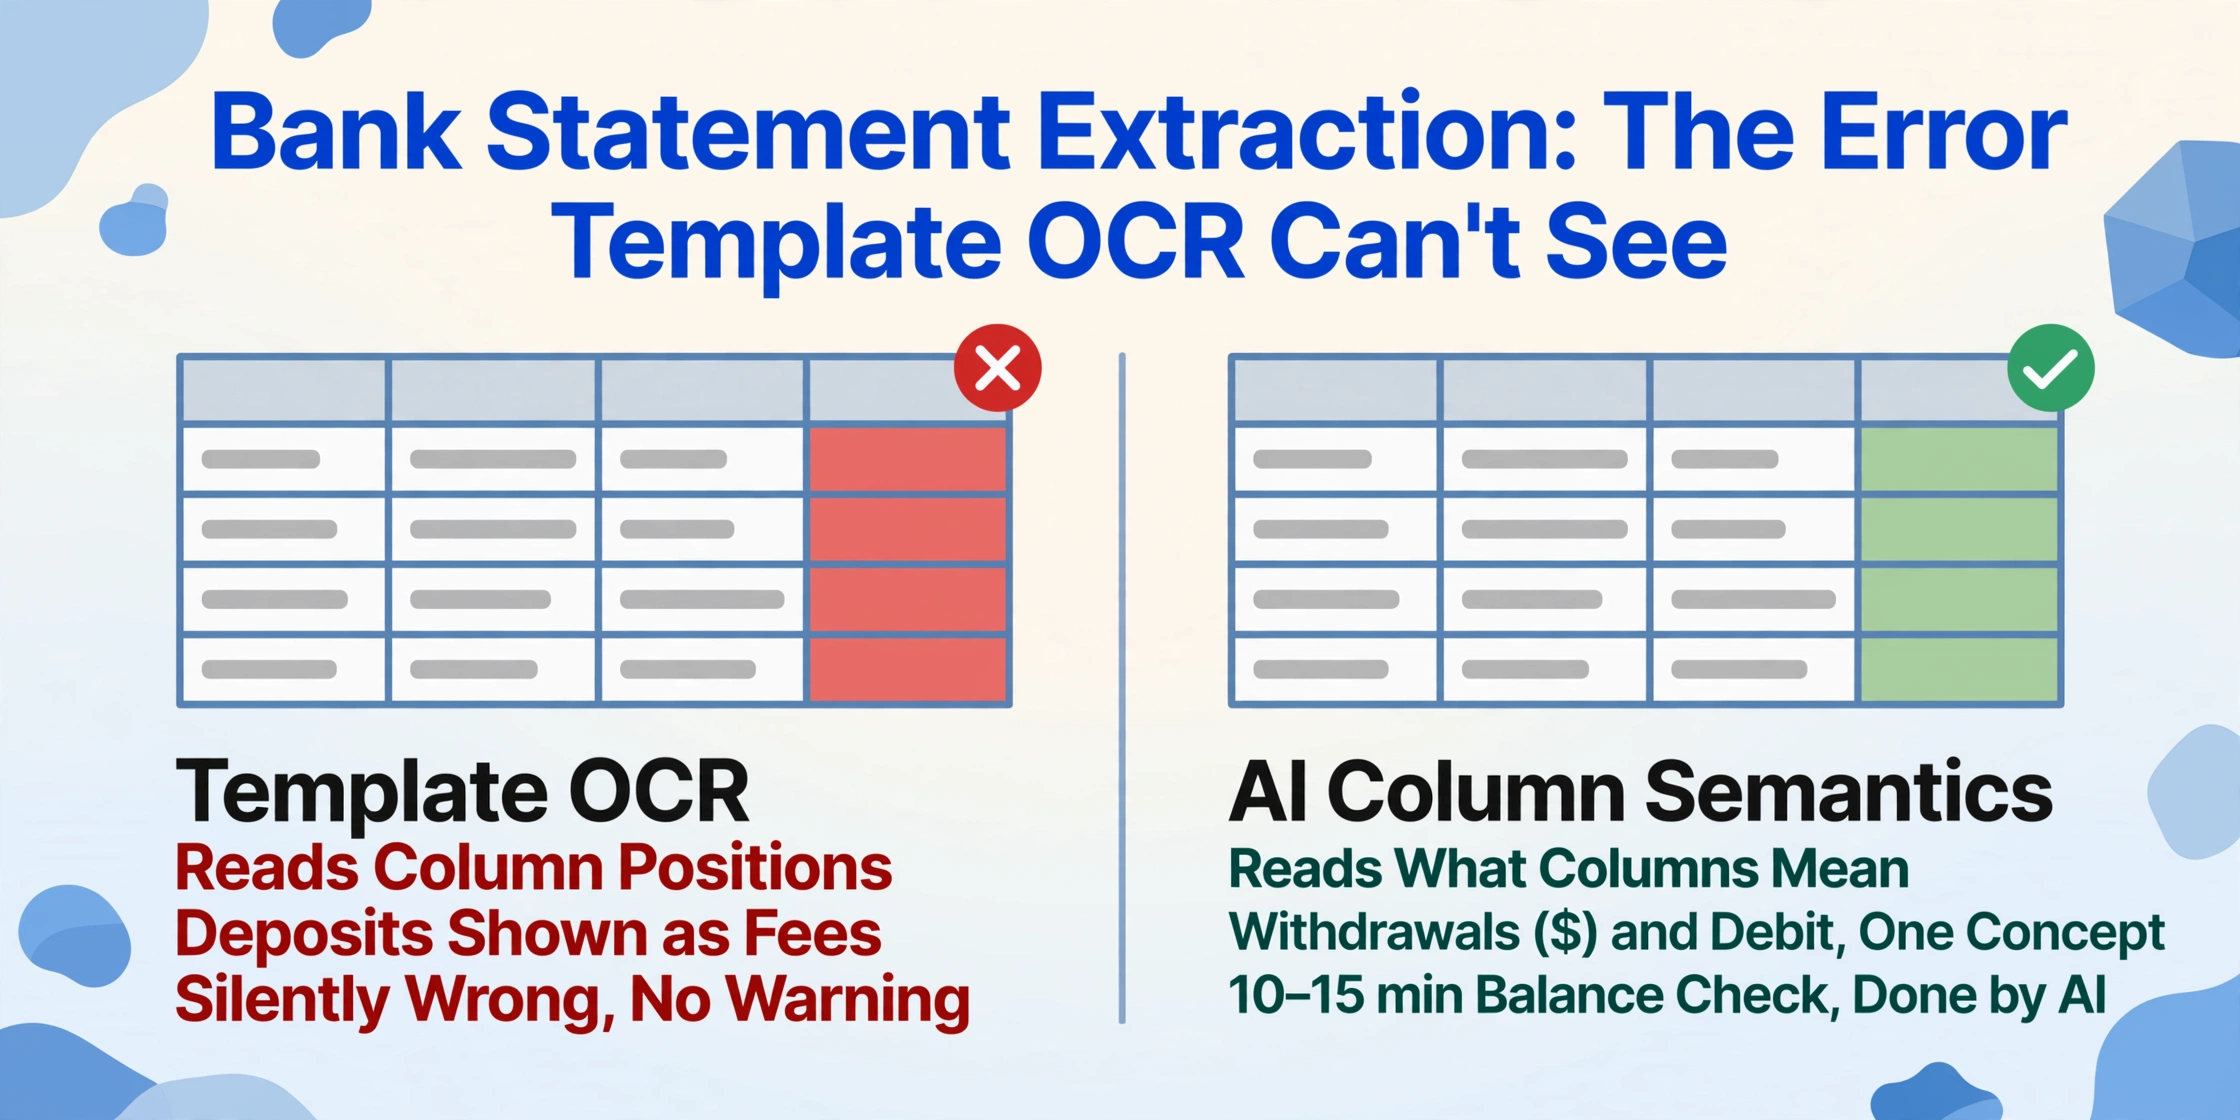
Les outils à base de modèles peinent face à cette diversité : un modèle conçu pour les relevés Chase se trompe silencieusement sur un PDF Wells Fargo qui sépare les débits et les crédits dans des colonnes distinctes au lieu d'une seule colonne de montant de transaction. Les données extraites semblent correctes — les chiffres sont dans les bonnes colonnes — mais les paiements par carte de crédit apparaissent comme des retraits et les dépôts comme des frais. L'OCR traditionnel n'a aucun moyen de savoir qu'il a commis cette erreur, car il lit les positions, pas le sens.
L'extraction par IA qui comprend la sémantique des colonnes — en reconnaissant que « Withdrawals ($) » et « Debit » sont le même concept exprimé différemment — élimine entièrement cette classe d'erreurs. Pour les relevés bancaires en particulier, la capacité d'IA la plus précieuse n'est pas la vitesse d'extraction mais la vérification par colonne calculée : l'IA peut calculer le solde de clôture à partir du solde d'ouverture plus les débits moins les crédits, le comparer au solde de clôture indiqué sur le relevé et signaler tout écart — une étape de réconciliation qui prend normalement 10 à 15 minutes à un humain par relevé. Pour un aperçu du flux de travail de bout en bout, consultez notre guide de conversion des relevés bancaires vers Excel.
Référence de gain de temps : un relevé bancaire professionnel mensuel de 12 pages prend généralement à un comptable 15 à 20 minutes pour saisir manuellement les informations d'en-tête et vérifier le solde par contrôle ponctuel. L'extraction par IA le traite en moins de 60 secondes, et la vérification calculée du solde remplace entièrement le contrôle ponctuel manuel. Sur 30 clients × 12 mois, cela représente environ 90 heures par an récupérées sur la seule saisie des relevés — avant même de compter les erreurs de rapprochement ainsi évitées.
Reçus : le problème des photos
Les reçus sont le type de document où la qualité de l'entrée — et non la technologie d'extraction — constitue la contrainte déterminante. Un reçu numérique propre provenant d'Amazon ou d'une plateforme SaaS s'extrait avec une précision quasi parfaite. Une photo d'un reçu de restaurant sur papier thermique froissé, prise en biais sous un éclairage jaune, avec une encre délavée et une tache de café — le genre que vos clients envoient réellement — pose un tout autre problème.
Le plafond d'extraction sur les reçus est déterminé par ce qui est lisible sur la photo, et non par ce que l'IA peut théoriquement lire. Si un humain plissant les yeux sur l'image ne peut pas distinguer si la ligne de pourboire indique $8.00 ou $8.80, l'IA non plus — et ni l'un ni l'autre ne devrait être approuvé sans vérification.
Ce que l'extraction par IA ajoute au traitement des reçus au-delà de l'OCR de base, c'est la catégorisation. La plupart des reçus n'impriment pas de catégorie de dépense. Un reçu de restaurant indique « Table 12, Server: Maria, $54.30 » — pas « Meals & Entertainment ». Une IA dotée de la capacité de colonne inférée peut lire le nom du commerçant et le contexte d'achat, puis attribuer une catégorie : « Meals » pour les restaurants, « Travel » pour les hôtels, « Office Supplies » pour Staples. Cette étape de classification, réalisée manuellement par un comptable ou un aide-comptable qui examine chaque reçu par rapport à un plan comptable, ajoute généralement 30 à 60 secondes par reçu. À raison de 200 reçus par mois et par client, cela représente plus de 2 heures récupérées rien que sur la classification.
Consultez notre guide d'extraction des reçus vers Excel pour le flux de travail étape par étape, notamment la façon dont l'Extraction de colonnes personnalisées — où vous saisissez les noms de champs souhaités et l'IA localise chaque valeur selon sa signification plutôt que selon sa position sur la page — gère la variété des formats de reçus qui met en échec les outils basés sur des modèles.
Formulaires fiscaux W-2 et 1099 : une extraction à forts enjeux
Les formulaires fiscaux sont le type de document où l'exactitude a des conséquences juridiques. Un montant de facture mal catégorisé crée une erreur de rapprochement que vous détecterez lors de la clôture mensuelle. Un montant de salaire mal transcrit dans la case 1 d'un W-2 ou un montant de rémunération de non-salarié mal transcrit sur un 1099-NEC crée une erreur de déclaration qui déclenche un avis de l'IRS — et potentiellement une conversation avec le client qu'aucun comptable ne souhaite avoir.
Les formulaires W-2 contiennent 14 champs encadrés, plus les données d'identification de l'employeur et du salarié. Les formulaires 1099-NEC et 1099-MISC ajoutent une couche supplémentaire avec les TIN du payeur, les TIN du bénéficiaire et des affectations de cases variables selon la variante du formulaire. Les outils basés sur des modèles gèrent cela en identifiant le numéro de contrôle OMB de l'IRS dans le coin supérieur droit — 1545-0008 pour le W-2, 1545-0116 pour le 1099-NEC, 1545-0074 pour le 1040 — et en appliquant une logique d'extraction propre à cette mise en page. Cela fonctionne pour les PDF numériques propres, mais échoue sur les copies scannées où le numéro OMB est illisible, ou sur les photos de formulaires où les reflets masquent l'identifiant.
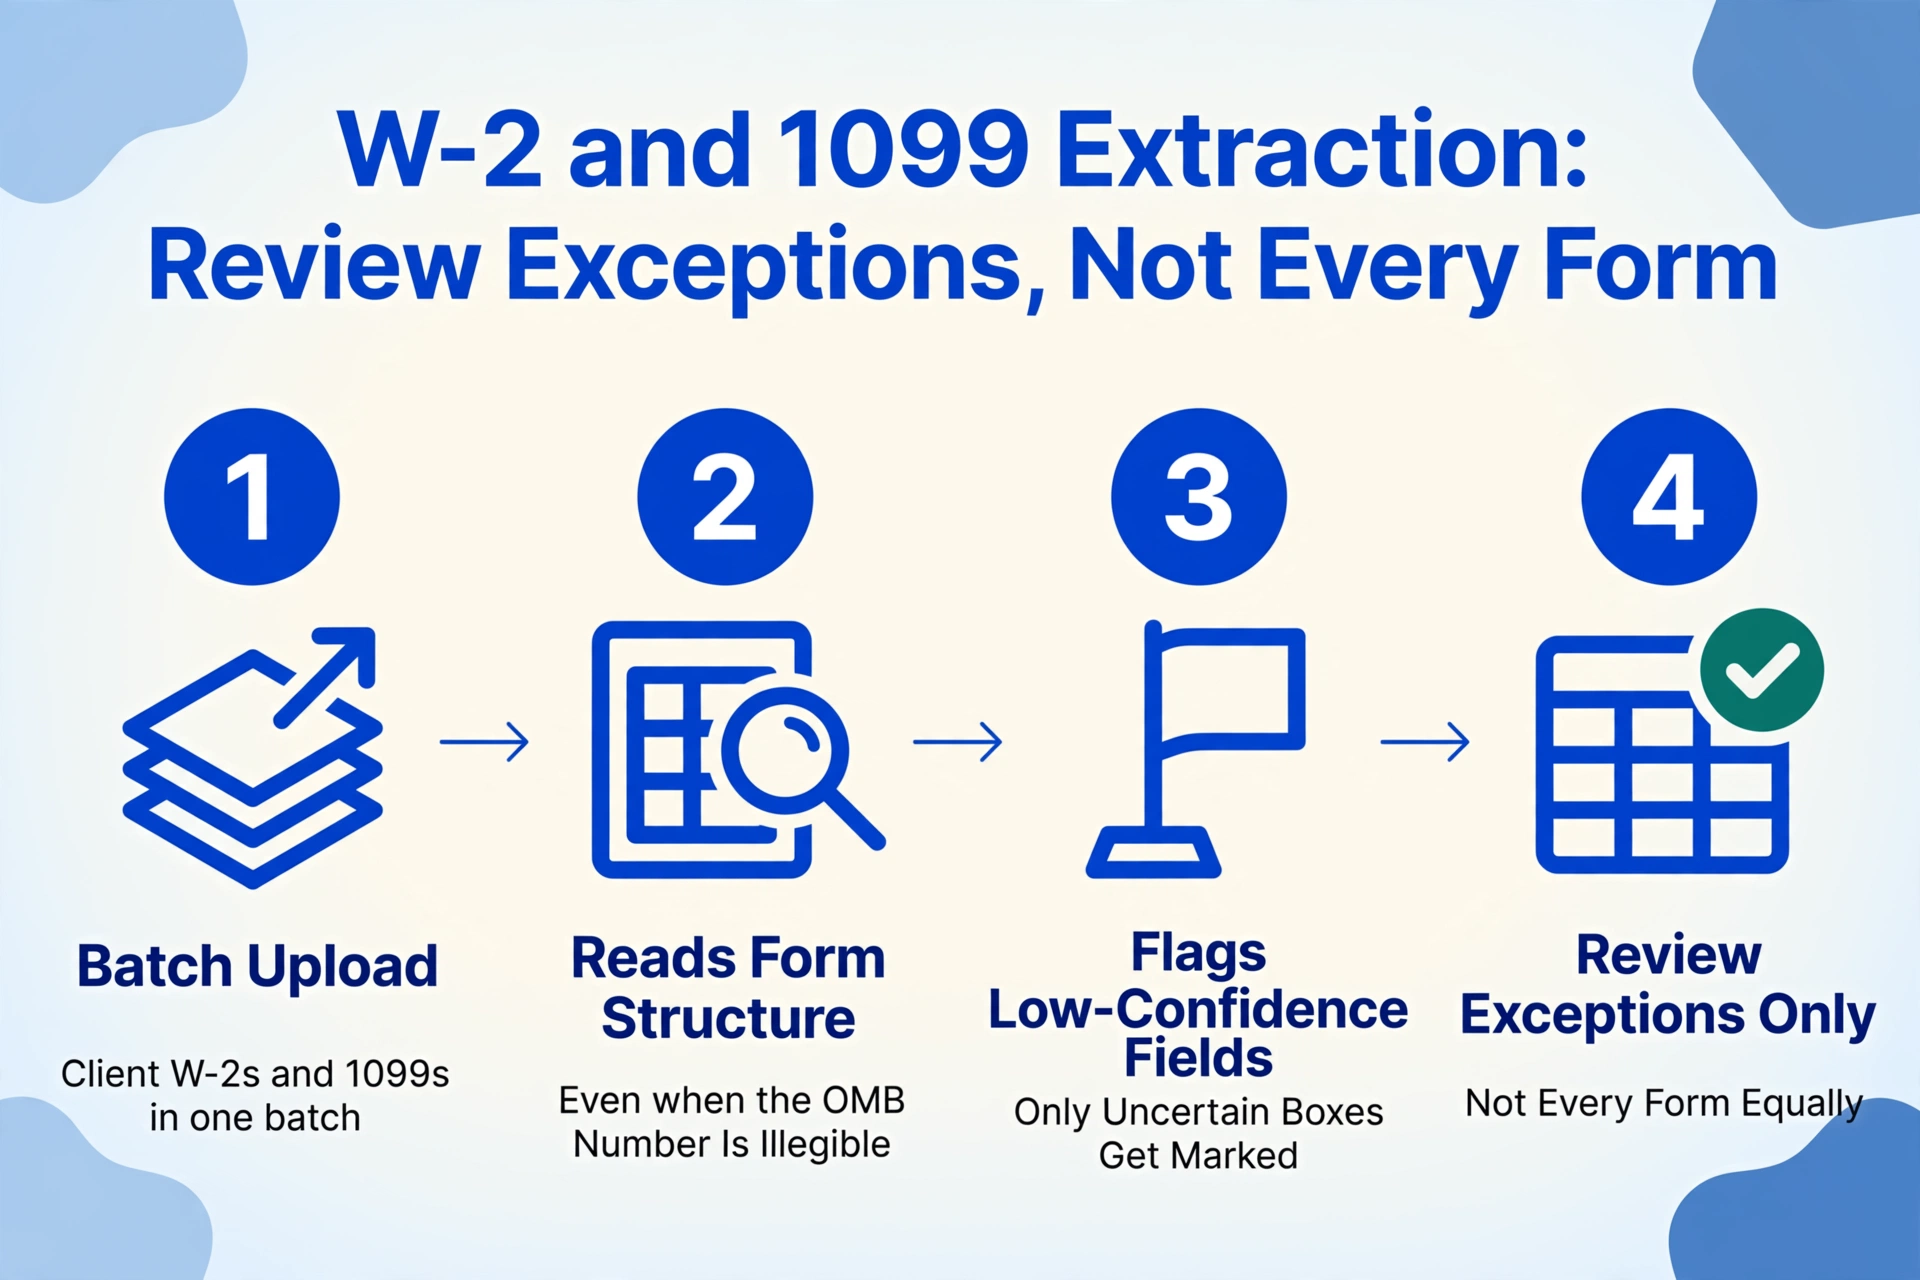
L'extraction par IA qui lit la structure de contenu du formulaire — en reconnaissant la mise en page d'un relevé de salaires et de taxes, que le numéro de contrôle soit visible ou non — offre une solution de repli lorsque l'identification par modèle échoue. Le flux de travail pratique pour un cabinet fiscal : lancer l'extraction sur un lot de W-2 et de 1099 clients, exporter vers un tableur, puis consacrer le temps de révision aux formulaires que l'IA a signalés comme peu fiables plutôt qu'à tous les formulaires de manière égale. Cela fait passer le rôle du comptable de « transcripteur de numéros de cases » à « réviseur d'exceptions » — le rôle pour lequel son diplôme a été délivré.
Pour les flux de travail d'extraction spécifiques aux W-2 et 1099, consultez notre guide d'extraction des 1099 vers Excel. La dimension de conformité à l'IRS — stockage sécurisé, contrôle des accès, pistes d'audit — est traitée en détail dans notre guide d'achat de la saisie de données par IA pour les comptables, y compris les exigences de la Circular 230 et de l'IRC §7216 qui régissent la manière dont les informations fiscales des clients doivent être traitées à chaque étape du traitement.
Notes de frais : le problème du document composite
Les notes de frais ne constituent pas un type de document unique. C'est un document composite : un formulaire ou un tableur de note de frais, accompagné d'une pile de reçus qui servent de justificatifs. Le défi de l'extraction n'est pas de lire les reçus individuels — c'est le même problème de reçus décrit plus haut — mais de faire correspondre chaque reçu à la bonne ligne de la note de frais et de vérifier que les montants correspondent.
Une note de frais client type pour un déplacement professionnel peut inclure un itinéraire de vol ($487), une facture d'hôtel ($1,240 pour 4 nuits), cinq reçus de repas ($15–$85 chacun), deux reçus de taxi et une facture d'inscription à une conférence. Le travail de l'expert-comptable consiste à vérifier que la somme de tous les reçus joints correspond au total déclaré sur la note, que chaque reçu est correctement catégorisé et qu'aucun reçu en double n'a été soumis dans plusieurs notes. C'est le type de recoupement multi-documents que les outils d'extraction IA actuels n'automatisent pas — et celui que la plupart des cabinets comptables ne souhaitent pas automatiser entièrement, car c'est à l'étape de vérification que les fraudes et les erreurs sont détectées.
Là où l'extraction IA réduit réellement la charge de traitement des notes de frais : extraire toutes les données des reçus dans un seul tableur avec des colonnes cohérentes (date, commerçant, montant, catégorie), puis laisser l'expert-comptable ou le comptable parcourir le tableur à la recherche d'anomalies au lieu de feuilleter 50 images de reçus individuelles. Cela fait passer l'étape de révision de 3 minutes par reçu à 30 secondes par anomalie signalée — et maintient l'étape de jugement humain là où elle doit être.
Documents fiscaux internationaux : P60, PAYG et T4
La plupart des guides d'extraction de documents s'arrêtent aux formulaires fiscaux américains. Les cabinets comptables ayant des clients internationaux — ou les cabinets basés hors des États-Unis — ont besoin d'une couverture qui s'étend aux documents fiscaux que leurs clients produisent réellement. Voici les trois documents de revenus d'emploi non américains les plus courants, ce qui est extractible de chacun et ce qu'il faut surveiller.
P60 britannique (End of Year Certificate). Délivré par les employeurs aux employés après la fin de chaque exercice fiscal (5 avril), le P60 récapitule la rémunération totale, l'impôt total retenu, le numéro d'assurance nationale, le code fiscal final et les coordonnées de l'employeur pour l'année. Champs extractibles clés : nom de l'employeur et référence PAYE, numéro NI de l'employé, rémunération totale de l'année, impôt total retenu, code fiscal final et éventuelles prestations légales (maternité, paternité, adoption). Le principal défi : les P60 provenant de différents prestataires de paie (Sage, Xero, BrightPay, QuickBooks UK) utilisent des mises en page légèrement différentes bien qu'ils contiennent les mêmes champs obligatoires HMRC. L'extraction indépendante du format gère cette variation sans configuration par prestataire.
PAYG Payment Summary australien. Remplacé par les relevés de revenus Single Touch Payroll (STP) pour la plupart des employés, mais toujours émis dans certaines circonstances — notamment pour les sous-traitants et les employés de petits employeurs pas encore passés au STP. Champs extractibles clés : ABN du payeur, nom du payeur, TFN du bénéficiaire, paiements bruts, impôt total retenu, montants des avantages accessoires déclarables et paiements forfaitaires avec leurs codes de type (A à E). La plupart des outils d'extraction qui traitent les formulaires fiscaux américains ne reconnaissent pas les conventions de mise en page de l'ATO — vérifiez la couverture avant de vous engager sur un outil si vous traitez des documents de paie australiens.
T4 canadien (Statement of Remuneration Paid). Le T4 est l'équivalent canadien du W-2, avec une différence cruciale : il utilise jusqu'à 85 numéros de cases CRA plutôt que les 14 du W-2. Les champs clés couvrent le revenu d'emploi (case 14), les cotisations RPC (case 16), les gains assurables AE (case 24), les cotisations RPA (case 20), les cotisations syndicales (case 44) et des dizaines d'autres codes pour les avantages imposables et les déductions. Le défi de l'extraction n'est pas de lire les chiffres — c'est de faire correspondre la bonne case CRA au bon champ dans TaxCycle ou Intuit ProFile, où les exigences de format d'importation sont précises. Un outil qui vous permet de définir vos propres noms de colonnes — par exemple, en spécifiant « Box 14 Employment Income » et « Box 16 Employee CPP » comme colonnes personnalisées — produit une sortie qui correspond directement au modèle d'importation de votre logiciel fiscal sans renommage de colonnes après extraction. Pour un guide détaillé du flux de travail d'extraction des feuillets fiscaux canadiens, consultez notre guide d'extraction de formulaires — la même approche de colonnes personnalisées fonctionne pour toutes les juridictions fiscales.
Que rechercher dans un outil d'extraction : la grille d'un expert-comptable
Les critères habituels d'évaluation logicielle — prix, listes de fonctionnalités, logos d'intégration — ne vous disent pas ce que vous devez réellement savoir en tant que cabinet comptable. Voici les cinq facteurs qui déterminent si un outil d'extraction résiste au contact de vos vrais documents clients.
Séparation des lots multi-clients
Traiter 15 relevés bancaires pour le client A et 8 relevés bancaires pour le client B doit produire deux feuilles de calcul distinctes — sans que vous ayez à trier les fichiers dans des dossiers au préalable. Un outil conçu pour la comptabilité d'une entité unique traite chaque import comme un seul ensemble de données. Un outil conçu pour les cabinets comptables vous permet de nommer des lots par client et d'exporter les résultats lot par lot. Pour une comparaison complète des outils qui gèrent les flux multi-clients, consultez notre comparatif des outils d'extraction pour cabinets comptables.
Indépendance du format, pas de modèles à configurer
Un outil qui propose de « puissants générateurs de modèles » et une « configuration OCR par zones » vous vend un travail de maintenance de modèles, pas de l'automatisation. La capacité qui compte, c'est l'indépendance du format : l'outil traite la facture d'un nouveau fournisseur, le relevé d'une nouvelle banque ou les formulaires d'un nouveau prestataire de paie avec la même configuration qu'un document familier — parce qu'il lit les documents en comprenant ce que signifient les champs, et non en mesurant leur emplacement. Pour la distinction technique entre ces approches, consultez notre explication de l'OCR IA vs l'OCR traditionnel.
Des modèles de colonnes personnalisées à enregistrer, pas à reconstruire
Les colonnes que vous extrayez pour un client restaurateur (coûts alimentaires par catégorie, pourboires déclarés, montants de règlement POS) diffèrent de celles d'un client du bâtiment (codes de coûts de chantier, retenues de garantie, renonciations à privilège). Un outil de qualité professionnelle enregistre des modèles de colonnes par client ou par type de mission, pour que vos collaborateurs ne reconstruisent pas les configurations d'extraction de zéro chaque mois.
Une sortie au format attendu par vos outils en aval
QuickBooks Online importe des CSV avec des en-têtes de colonnes précis. Drake Tax attend certaines correspondances de champs. Les imports en masse de Xero exigent des formats de date particuliers. Votre outil d'extraction doit produire une sortie Excel ou CSV qui corresponde au format d'import de votre logiciel comptable — avec des noms de colonnes identiques, des formats de date analysables et des champs numériques sans symboles monétaires. Si l'outil n'exporte que dans son propre format propriétaire, vousve traded data entry for data reformatting.
Collecte de documents, pas seulement extraction
Le goulot d'étranglement dans la plupart des cabinets comptables n'est pas l'extraction des données des documents — c'est d'abord d'obtenir les documents des clients. Un outil qui inclut un Lien de collecte — un lien partageable que les clients ouvrent (sans connexion requise) pour téléverser des documents directement dans votre file de traitement — résout le problème en amont. Au lieu d'envoyer des e-mails, des SMS et de relancer les clients pour leurs relevés mensuels et leurs reçus de dépenses, vous envoyez un seul lien qui alimente tout votre pipeline d'extraction. Pour les cabinets qui servent des clients à but non lucratif, consultez notre guide sur l'extraction des données de reçus de dons pour un cas d'usage du Lien de collecte propre à ce secteur.
Pièges courants lors de l'automatisation de l'extraction de documents
Chaque cabinet comptable ayant adopté l'extraction de documents a rencontré au moins l'un de ces pièges. Les connaître à l'avance transforme une leçon apprise à la dure en une liste de vérification à contrôler avant que l'outil ne touche votre premier dossier client.
Piège 1 : Acheter un outil à modèles pour un environnement multiformat. Les outils OCR basés sur des modèles sont vendus comme « configurez une fois, utilisez pour toujours ». Pour un cabinet comptable, « une fois » signifie par fournisseur, par banque, par client — et vous ne cessez jamais de configurer parce que les clients changent de banque et les fournisseurs changent de format de facture. L'outil qui fonctionnait pendant la démo sur trois PDF propres casse au quatrième mois quand le Client C passe de Wells Fargo à Mercury et que les colonnes du relevé s'inversent. La solution n'est pas d'acheter un meilleur outil à modèles. C'est d'acheter un outil qui n'utilise pas de modèles.
Piège 2 : Traiter la précision comme un chiffre unique. Un outil qui annonce « 99 % de précision » a atteint ce chiffre sur les documents de son jeu de données de référence — des PDF propres avec du texte imprimé dans des mises en page standard. Ce même outil peut tourner à 80 % de précision sur des reçus photographiés dans des restaurants mal éclairés, 70 % sur des relevés bancaires scannés provenant de coopératives de crédit utilisant des imprimantes matricielles, et 50 % sur des notes manuscrites en marge. La précision qui compte est celle sur vos pires documents, pas sur les meilleurs du fournisseur. Avant de vous engager avec un outil, testez-le sur 10 de vos fichiers les plus problématiques — les reçus froissés, les W-2 faxés, les factures de chaînes de restaurants de trois pages — pas ceux qui ressemblent à la démo du fournisseur. C'est la méthodologie que nous détaillons dans notre guide pratique de la précision.
Piège 3 : Automatiser l'extraction avant d'automatiser la collecte. Si votre pipeline d'extraction peut traiter 100 documents par heure mais que vos clients mettent deux semaines à envoyer ces documents, vous avez accéléré une étape en aval du vrai goulot d'étranglement. Réglez d'abord le problème de collecte : standardisez la façon dont les clients soumettent les documents (un seul Lien de collecte au lieu de pièces jointes par e-mail), fixez des échéances de soumission et automatisez les rappels. La vitesse d'extraction ne signifie rien s'il n'y a rien à extraire.
Piège 4 : Surautomatiser l'étape de révision. IRS Circular 230, Section 10.22 exige qu'un praticien fasse preuve de diligence raisonnable dans la préparation des déclarations fiscales — ce qui inclut la vérification de l'exactitude des données saisies. L'automatisation de l'extraction ne supprime pas votre obligation de révision ; elle la transforme : au lieu de vérifier chaque donnée, vous vérifiez les exceptions. Concevez votre flux de travail de sorte que les données extraites soient clairement rattachées à l'image du document d'origine, avec les champs à faible confiance signalés pour révision humaine, et le reste vérifié par exception. Un flux de travail « tout vérifier » annule les gains de temps. Un flux de travail « ne rien vérifier » viole la Circular 230. Le juste milieu — la vérification par exception — est ce qui légitime les outils d'extraction dans un cabinet CPA.
Feuille de route de mise en œuvre pour les cabinets comptables
Le déploiement de l'extraction de documents dans un cabinet comptable doit suivre les types de documents par ordre de volume et de régularité de format — et non par ordre d'importance perçue. L'objectif est de renforcer la confiance du personnel et d'ancrer les habitudes de travail sur les documents les plus simples avant d'introduire les plus complexes.
Phase 1 : Relevés bancaires et de cartes de crédit (Mois 1–2). Commencez ici car les relevés sont volumineux, arrivent mensuellement selon un calendrier prévisible et — malgré la variation des formats selon les banques — présentent une structure interne cohérente (transactions en lignes chronologiques avec colonnes date, description, montant). Choisissez 3 à 5 clients dont les formats de relevés sont les plus homogènes et traitez un mois de relevés. Comparez les résultats d'extraction à la saisie manuelle pour évaluer l'exactitude. Chronométrez la différence de bout en bout : de la réception du PDF à l'obtention de données vérifiées prêtes pour le rapprochement. À la fin de la Phase 1, le personnel doit faire confiance à l'outil sur les relevés et le cabinet doit disposer d'une référence claire en matière de gain de temps.
Phase 2 : Factures fournisseurs (Mois 2–4). Ajoutez les factures une fois le flux de travail des relevés stabilisé. Commencez par les factures récurrentes de fournisseurs connus — ceux dont vous avez déjà vu 20 variantes et dont vous connaissez la structure des données — avant d'introduire de nouveaux fournisseurs. Enregistrez des modèles de colonnes par client incluant leurs codes GL et affectations de centres de coûts habituels, afin que les résultats d'extraction soient pré-mappés à la structure du grand livre. Pour les organisations à but non lucratif et celles ayant des besoins spécifiques de suivi des dépenses, consultez notre guide d'extraction des reçus de dons pour un exemple de conception de modèle.
Phase 3 : Reçus et notes de frais (Mois 4–6). Les reçus introduisent la variable de la qualité photo et nécessitent les fonctionnalités de catégorisation que l'OCR de base ne fournit pas. Commencez par les reçus numériques (Amazon, abonnements SaaS, factures électroniques) avant d'introduire les reçus papier photographiés. Créez un guide à destination des clients pour la prise de photo des reçus — lisible, à plat, bien éclairé — qui réduit les problèmes de qualité des entrées avant qu'ils n'atteignent votre pipeline d'extraction. Pour les notes de frais, lancez d'abord l'extraction IA sur les reçus, puis utilisez la sortie tableur pour vérifier les totaux de la note — et non l'inverse.
Phase 4 : Formulaires fiscaux (fenêtre juillet–octobre). Les formulaires fiscaux exigent la plus grande exactitude et ont les conséquences réglementaires les plus lourdes en cas d'erreur. Ne déployez pas l'extraction des formulaires fiscaux pendant la saison chargée de décembre à avril. Utilisez la fenêtre juillet–octobre pour tester sur les W-2 et 1099 de l'année précédente, comparer l'extraction IA à la saisie manuelle formulaire par formulaire, et construire le flux de travail de révision par exception avant que des déclarations réelles n'en dépendent. Au moment où les W-2 de janvier commencent à arriver, le personnel doit déjà savoir quels formulaires l'outil traite de manière fiable et lesquels nécessitent une révision manuelle complète.
Principe de timing : Ne déployez jamais un nouveau flux d'extraction dans les 60 jours précédant une échéance fiscale. La courbe d'apprentissage — déterminer quels documents s'extraient proprement, lesquels nécessitent une révision humaine et que faire en cas d'échec d'extraction — consomme plus de temps du personnel que l'outil n'en fait gagner le premier mois. Planifiez les déploiements pendant les périodes creuses entre les saisons de déclaration, pas pendant les pics.
FAQ
L'extraction par IA peut-elle traiter les reçus manuscrits et les notes en marge ?
Partiellement. L'écriture en lettres capitales s'extrait avec une précision d'environ 75–85 % par champ ; l'écriture cursive et précipitée tombe à 50–70 %. L'IA peut lire ce qui est lisible. Si un humain ne parvient pas à déchiffrer le montant sur un reçu thermique délavé avec une tache de café, l'IA non plus — et vous ne devriez pas vous fier à ce champ sans confirmation du client.
L'extraction fonctionne-t-elle avec des relevés bancaires scannés dont les pages sont inclinées et imprimés en matriciel ?
Oui, avec des réserves. L'extraction par IA gère mieux l'inclinaison, la rotation et les scans à basse résolution que l'OCR traditionnel, car elle perçoit la mise en page globale plutôt que de scanner caractère par caractère. Toutefois, l'impression matricielle sur du papier jauni depuis plus de 5 ans crée un texte à faible contraste qui dégrade la précision de tout système d'extraction. Ces documents doivent être signalés pour révision humaine quel que soit l'outil utilisé.
Les données financières du client sont-elles sécurisées pendant le traitement par IA ?
Cela dépend de l'architecture de l'outil. Certains outils acheminent les documents via des API d'IA tierces qui conservent les données pour l'entraînement des modèles — un risque potentiel au regard de l'IRC §7216 si les données contiennent des informations fiscales du client. D'autres traitent les documents via leur propre infrastructure sans conservation des données à des fins d'entraînement. Vérifiez la politique de traitement des données de l'outil par rapport à vos exigences WISP avant de téléverser des documents clients. Au minimum : confirmez que les documents téléversés ne sont pas utilisés pour l'entraînement des modèles, que le traitement est chiffré en transit et que les documents sont automatiquement supprimés après une période de conservation définie.
Dois-je entraîner un modèle par client ou une seule configuration peut-elle gérer tout le monde ?
Avec les outils basés sur des modèles, vous entraînez effectivement par client — ou par fournisseur, par banque, par type de formulaire — car chaque nouvelle mise en page de document nécessite un nouveau modèle. Avec l'extraction par IA indépendante du format, vous définissez une seule fois les colonnes souhaitées (Date, Description, Montant, Catégorie) et la même configuration traite les documents de n'importe quel client, n'importe quelle banque, n'importe quel fournisseur. Aucun entraînement par client, aucune création de modèle par fournisseur. C'est la question d'architecture la plus importante à vérifier avant d'acheter un outil pour un cabinet multi-clients.
Comment l'extraction par IA interagit-elle avec QuickBooks ou Xero ?
Les outils d'extraction par IA produisent des données structurées au format Excel ou CSV — ils ne publient pas directement les transactions dans QuickBooks ou Xero comme le font Dext ou Hubdoc. Le flux de travail est le suivant : l'IA extrait les données → vous révisez la sortie du tableur → vous importez dans QuickBooks/Xero via la fonction d'import en masse du logiciel. Cela vous donne un contrôle total sur ce qui entre dans le grand livre, au prix d'une étape d'import. Si vous souhaitez une publication directe au grand livre sans intermédiaire tableur, un outil de capture intégré à la comptabilité comme Dext ou Veryfi est l'outil adapté — mais ces outils imposent des règles strictes sur les types de documents et la catégorisation. Les outils d'extraction par IA sont flexibles sur tout document mais vous laissent l'étape d'import. Aucune architecture n'est universellement supérieure ; elles servent des flux de travail différents. Comparez les options dans notre sélection d'outils pour cabinets comptables.
Que se passe-t-il si l'IA se trompe sur un champ — comment le détecter ?
Le workflow de vérification le plus efficace est la revue par exception, et non le contrôle champ par champ. Après l'extraction : (1) recherchez les champs vides là où des données devraient exister — ce sont des échecs d'extraction évidents ; (2) vérifiez par échantillonnage les colonnes calculées par rapport aux documents sources (par ex., le solde de clôture calculé correspond-il au solde de clôture déclaré ?) ; (3) triez par montant et vérifiez les 5 premières et 5 dernières entrées — les transactions les plus importantes présentent le plus de risque en cas d'erreur. Cette revue en trois étapes détecte la grande majorité des erreurs d'extraction en moins de 5 minutes par lot, contre plus de 20 minutes de vérification champ par champ. Ne sautez pas complètement la revue — les obligations de diligence raisonnable de Circular 230 s'appliquent au travail assisté par IA de la même manière qu'au travail manuel.
Peut-il gérer les factures multidevises et les formulaires fiscaux internationaux ?
Oui pour la reconnaissance multidevise — l'extraction par IA peut identifier les symboles monétaires ($, €, £, ¥) et les conserver dans les données extraites, mais vous devrez gérer la conversion des devises séparément, car les outils d'extraction n'effectuent pas de calculs de change. Pour les formulaires fiscaux internationaux (P60 britannique, PAYG australien, T4 canadien), la couverture varie considérablement selon l'outil. La plupart des outils optimisés pour le marché américain ne reconnaissent pas les mises en page des formulaires non américains. Vérifiez explicitement la prise en charge des formulaires internationaux avant d'acheter — ne supposez pas que « prend en charge les formulaires fiscaux » signifie autre chose que les W-2/1099 américains. Un outil qui vous permet de définir vos propres colonnes par numéro de case CRA ou nom de champ HMRC peut fonctionner avec des formulaires internationaux même sans reconnaissance intégrée des formulaires, car l'IA lit le contenu du formulaire par le sens plutôt que par correspondance avec un modèle.
Le temps qu'un cabinet comptable consacre à la saisie de données est du temps qu'il ne peut pas consacrer à l'analyse, au conseil et aux relations clients qui font réellement croître le cabinet. L'extraction de documents ne se contente pas de réduire les coûts — elle convertit des heures facturables de travail de transcription en travail d'expertise, le seul type de travail pour lequel un diplôme d'expert-comptable a été conçu. L'outil est la première étape. La décision stratégique — quels clients accepter, quels services développer, quels types de documents cesser de traiter manuellement — est l'étape qui le rentabilise.
Testez sur les documents de vos clients les plus difficiles →