Der Buchhalter-Leitfaden zur KI-gestützten Dokumentdatenextraktion
Was Sie zuerst automatisieren sollten
Buchhaltern mangelt es nicht an zu verarbeitenden Dokumenten. Eine durchschnittliche Kanzlei mit 10 Mitarbeitern verarbeitet monatlich Kontoauszüge von 30 Finanzinstituten, Rechnungen von 200 Lieferanten, Belege in 15 Fotoausrichtungen, W-2- und 1099-Formulare von 40 Mitarbeitern sowie Spesenabrechnungen, die aus Texten, E-Mails und zerknittertem Papier zusammengestellt werden. Was Buchhaltern fehlt, ist eine Möglichkeit, diese Dokumentmischung in strukturierte Daten umzuwandeln, ohne 30 abrechenbare Stunden pro Woche zu verbrauchen. Dieser Leitfaden behandelt jeden wichtigen Dokumenttyp, der in einer Buchhaltungspraxis vorkommt, was daraus extrahierbar ist, was weiterhin menschliches Urteilsvermögen erfordert, und den Implementierungspfad, der zwischen die Steuersaisons passt.
Wichtigste Erkenntnisse
- 60% der Steuererklärungszeit wird nicht für Ermessensentscheidungen oder Kundenberatung aufgewendet – sondern für Datenextraktion und -korrektur, was einer durchschnittlichen Kanzlei mit 10 Mitarbeitern 30 abrechenbare Stunden pro Woche entzieht.
- Ein vorlagenbasiertes Extraktionstool erfordert eine neue Vorlage für jeden Lieferanten und jede Bank, die Ihre 30 Kunden nutzen – und wenn sich eine Spalte in einem Kontoauszug still verschiebt, sieht die Ausgabe korrekt aus, aber die Beträge sind bis zum Abgleich falsch.
- Wenn die Extraktion formatunabhängig wird – indem sie danach liest, was Felder bedeuten, statt wo sie stehen – wechselt Ihre Aufgabe vom Dateneingabe-Operator zum Ausnahmeprüfer, der einzigen Arbeit, für die eine CPA-Lizenz ausgestellt wurde.
Warum Buchhalter Dokumentenextraktion benötigen: Die quantifizierte Begründung
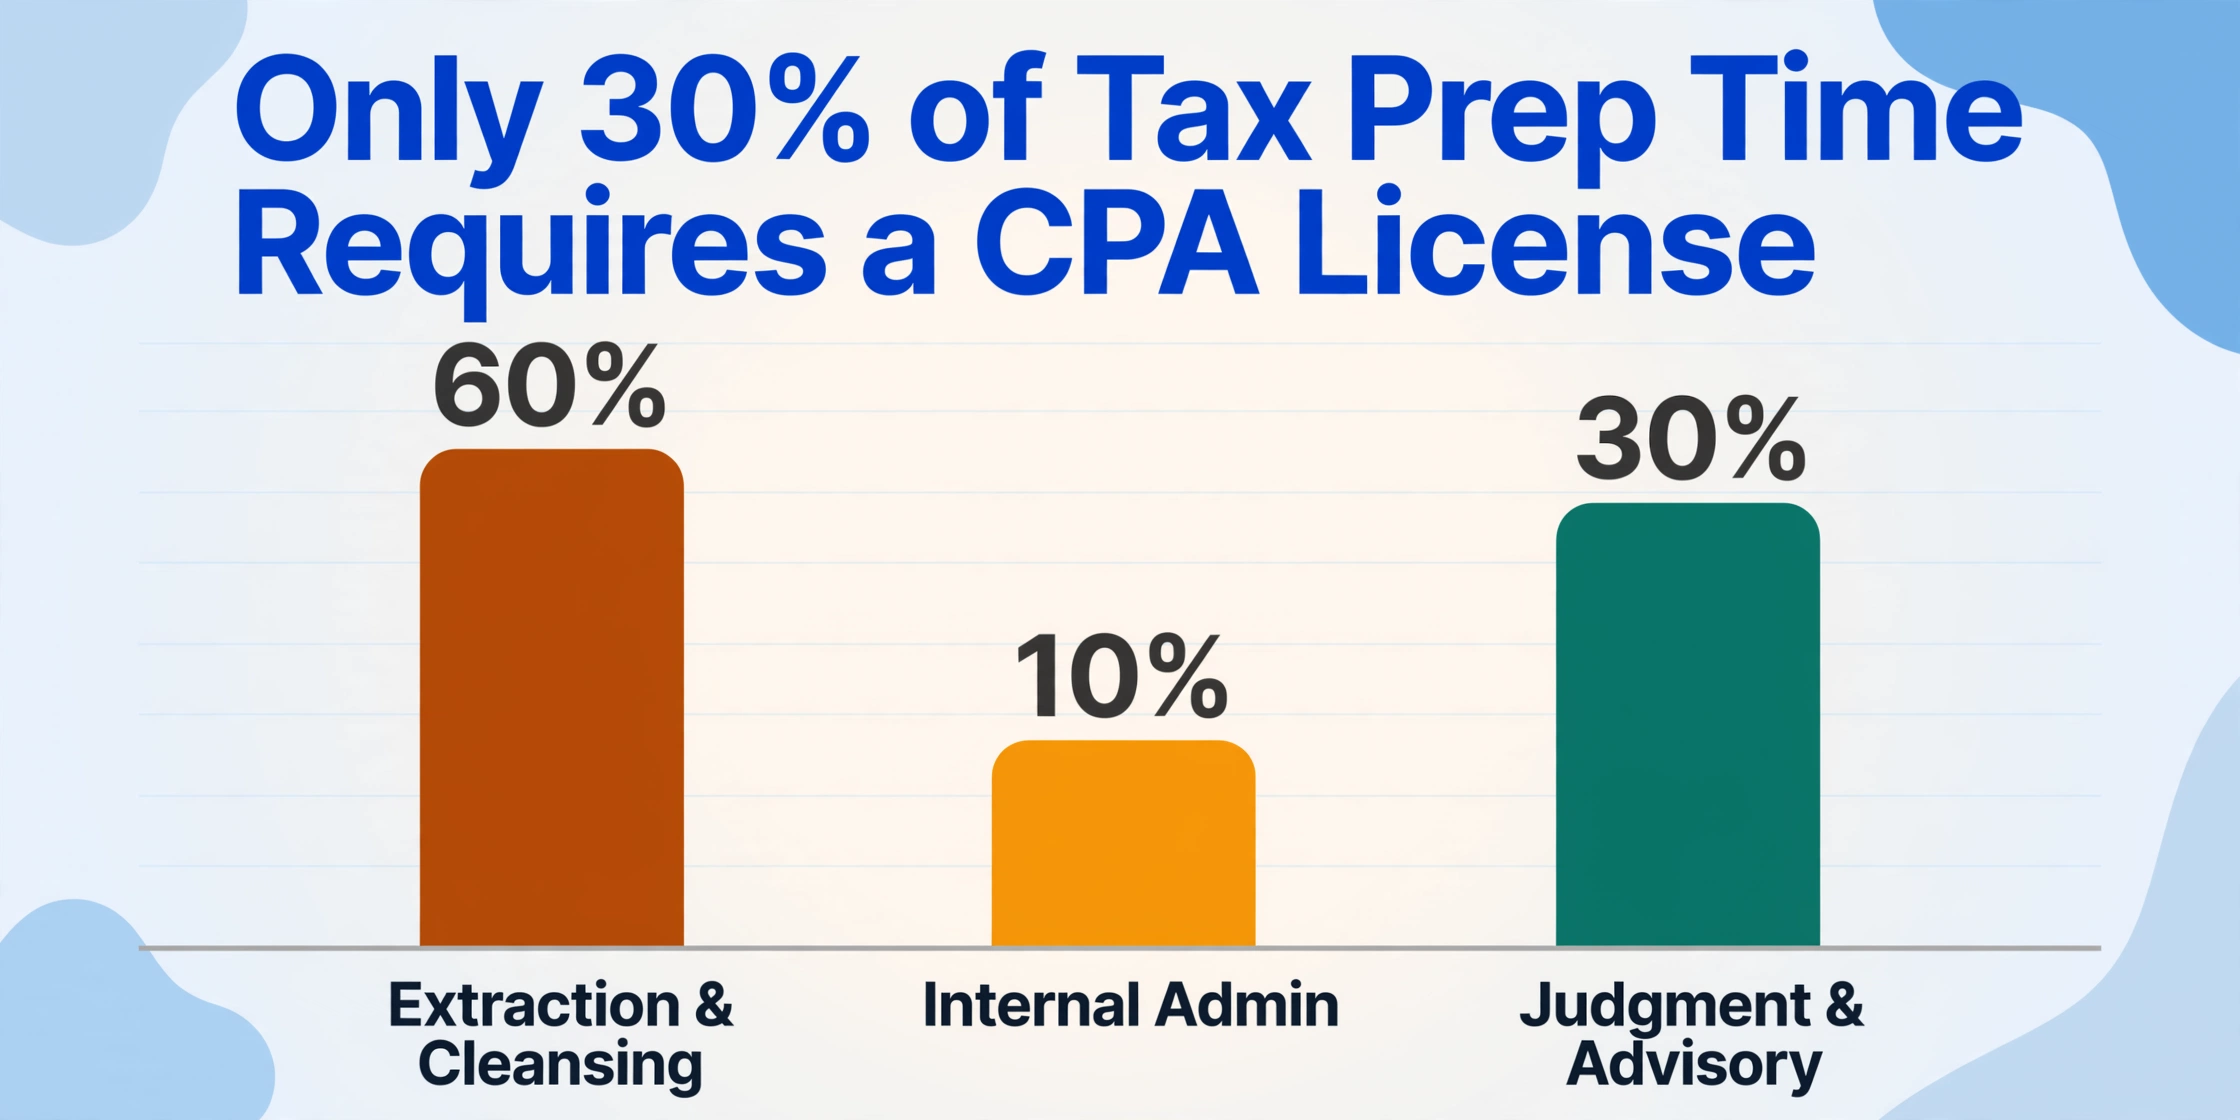
Eine PwC-Studie zu Steuer-Compliance-Workflows ergab, dass 60 % der Zeit für die Erstellung von Steuererklärungen auf Datenextraktion, -bereinigung und -analyse entfallen – nicht auf professionelles Urteilsvermögen, Risikobewertung oder Kundenberatung. Weitere 10 % entfallen auf interne Verwaltung. Das lässt etwa 30 % der Zeit eines Steuerfachmanns für die Arbeit übrig, die tatsächlich eine CPA-Lizenz erfordert. In einer Kanzlei mit einem Stundensatz von 200–400 $ stellt die Umleitung selbst der Hälfte dieser Extraktionszeit in Beratungsstunden eine Umsatzverschiebung dar, die keine noch so große Personaleinstellung erreichen kann.
Die strukturelle Erkenntnis, die die meisten Buchhaltungskanzleien übersehen: Manuelle Dateneingabe kostet nicht nur die Zeit des Tippens. Sie kostet auch die anschließende Bereinigungszeit. Jeder Fehler, der während der Eingabe entsteht – 2 bis 5 pro 100 Felder, laut APQC-Finanzbenchmarks – muss gefunden und korrigiert werden, und das Auffinden einer vertauschten Ziffer auf einer Rechnung über 47.000 $ dauert länger, als sie korrekt einzutippen.
Auf der Ausgabeseite verarbeitet KI-gestützte Extraktion eine einzelne Seite in 5 bis 10 Sekunden – etwa 18-mal schneller als manuelle Eingabe – mit einer Feldgenauigkeit bei gedrucktem Text, die konstant über 97 % liegt. Der Kompromiss ist nicht Geschwindigkeit gegen Genauigkeit. Es ist Geschwindigkeit und Genauigkeit gegen dasselbe Team, das jeden Monat drei Tage lang Dateneingabe macht. Das U.S. Bureau of Labor Statistics prognostiziert einen Rückgang der Buchhaltungsbeschäftigung um etwa 5 % von 2023 bis 2033 und führt diese Verschiebung auf softwarebasierte Automatisierung von Dateneingabeaufgaben zurück – ein Signal, dass der Markt nicht darauf wartet, dass Kanzleien sich entscheiden.
Aber „Dokumentenextraktion“ ist nicht ein Problem. Es sind sechs verschiedene Probleme unter demselben Etikett, denn ein Kontoauszug, eine Rechnung, eine Quittung, ein W-2, ein Spesenbericht und ein britisches P60 stellen jeweils grundlegend unterschiedliche Extraktionsherausforderungen dar. Der Rest dieses Leitfadens geht auf jedes einzelne ein – was extrahierbar ist, was schwierig ist, wie viel Zeit Sie voraussichtlich einsparen können und wo menschliches Urteilsvermögen unverzichtbar bleibt. Wenn Sie mit der Dokumentenextraktionstechnologie selbst neu sind, beginnen Sie mit unserer Erklärung, wie OCR funktioniert und was sie für Buchhaltungsworkflows bedeutet – und kehren Sie dann hierher zurück für die Aufschlüsselung nach Dokumenttyp.
Rechnungen: Die Extraktions-Baseline
Rechnungen sind der am häufigsten automatisierte Dokumenttyp in der Buchhaltung – und derjenige, bei dem die KI-Extraktion ihren deutlichsten Vorteil gegenüber vorlagenbasierten Tools zeigt. Eine typische Lieferantenrechnung enthält 8–15 strukturierte Felder: Lieferantenname, Rechnungsnummer, Datum, Fälligkeitsdatum, Bestellnummer, Positionszeilen mit Beschreibungen und Mengen, Zwischensumme, Steuerbetrag, Versand und Gesamtsumme. Bei einem sauberen PDF eines bekannten Lieferanten funktioniert die herkömmliche Template-OCR zuverlässig. Das Problem ist der Teil „von einem bekannten Lieferanten“.
Eine Buchhaltungskanzlei, die Zahlungseingänge ihrer Mandanten verarbeitet, erhält keine Rechnungen von 5 Lieferanten. Sie erhält Rechnungen von jedem Lieferanten, mit dem ihre 30 Mandanten Geschäfte machen – Amazon Business, Home Depot, örtliche Elektriker mit handschriftlichen Rechnungen, SaaS-Abonnements mit E-Mail-PDFs und internationale Lieferanten mit Positionszeilen in mehreren Währungen. Jeder neue Lieferant bedeutet ein neues Layout, und vorlagenbasierte Tools behandeln jedes Layout als neues Konfigurationsprojekt. KI-gestützte Extraktion, die Dokumente liest, indem sie versteht, was jedes Feld bedeutet – statt sich zu merken, wo es auf der Seite steht –, verarbeitet die Rechnung eines neuen Lieferanten mit demselben Setup wie die eines bekannten.
Für einen tieferen Einblick, wie das bei großen Stapeln funktioniert, lesen Sie unseren Leitfaden zur Stapelverarbeitung von Rechnungen. Der entscheidende Punkt für Buchhalter: Die Rechnungsextraktion ist der Dokumenttyp, bei dem Sie den Erfolg nicht daran messen sollten, „wie viele Felder bei der Rechnung von Lieferant A korrekt erkannt werden“, sondern daran, „wie viele neue Lieferanten Sie integrieren können, ohne die Extraktionskonfiguration anzufassen“.
Kontoauszüge: Der Abstimmungs-Engpass
Kontoauszüge sind der Dokumenttyp mit dem höchsten Volumen in den meisten Buchhaltungskanzleien – und derjenige, bei dem die Formatvielfalt am stärksten zuschlägt. Eine Kanzlei mit 30 Mandanten erhält monatliche Kontoauszüge von Chase, Wells Fargo, Bank of America, regionalen Kreditgenossenschaften, Online-Banken wie Mercury und Relay sowie internationalen Instituten wie Revolut – jeweils mit unterschiedlichen Spaltenlayouts, Datumsformaten und Transaktionsgruppierungskonventionen.
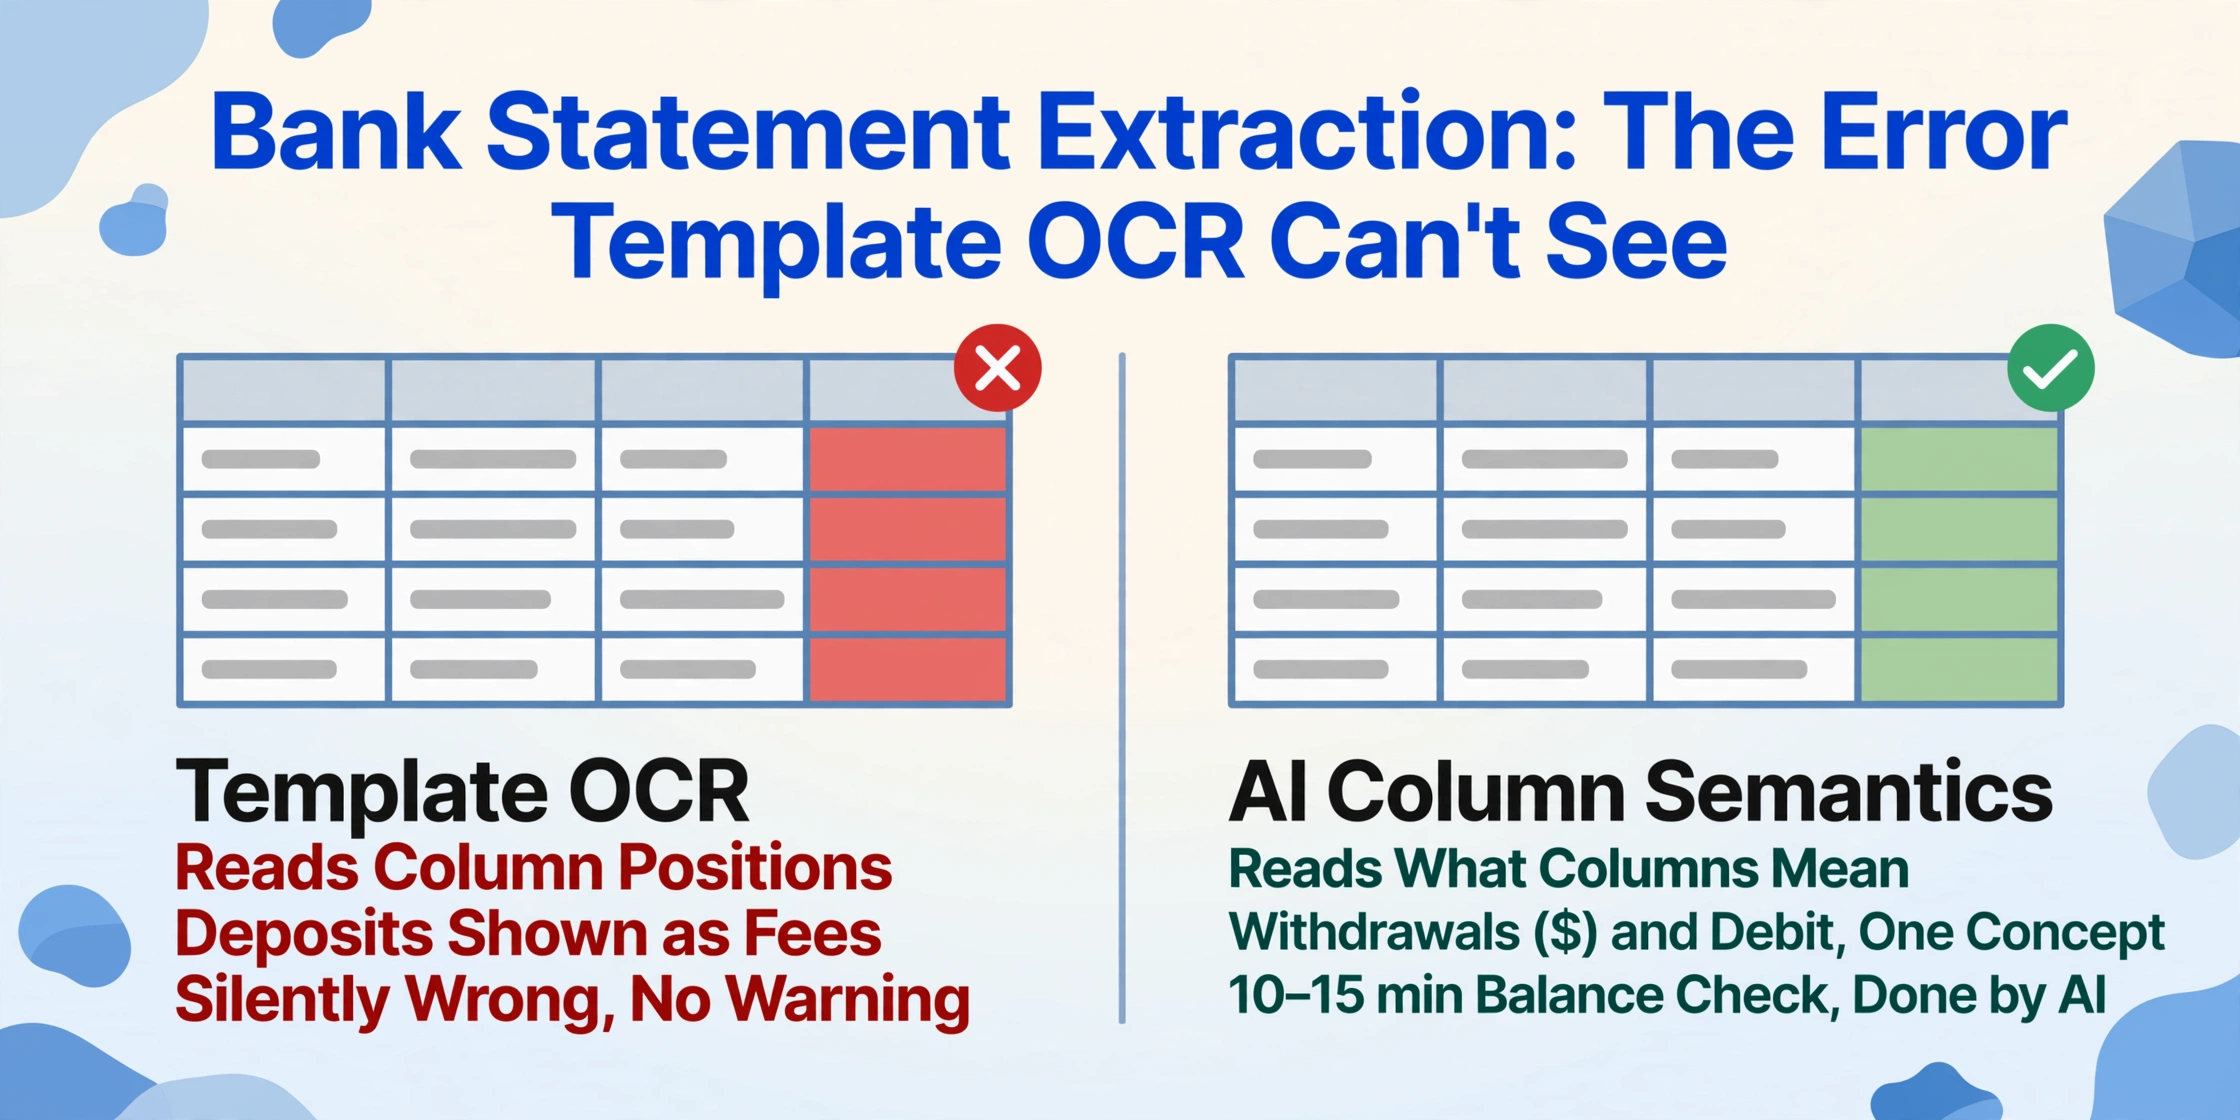
Vorlagenbasierte Tools scheitern an dieser Vielfalt: Eine für Chase-Kontoauszüge erstellte Vorlage versagt stillschweigend bei einem Wells-Fargo-PDF, das Soll und Haben in getrennten Spalten statt in einer einzigen Transaktionsbetragsspalte führt. Die extrahierten Daten sehen richtig aus – die Zahlen stehen in den richtigen Spalten –, aber die Kreditkartenzahlungen erscheinen als Abhebungen und die Einzahlungen als Gebühren. Herkömmliche OCR hat keine Möglichkeit, diesen Fehler zu erkennen, weil sie Positionen liest, nicht Bedeutungen.
KI-Extraktion, die Spaltensemantik versteht – erkennt, dass „Abhebungen ($)“ und „Soll“ dasselbe Konzept sind, nur anders ausgedrückt –, eliminiert diese Fehlerklasse vollständig. Speziell bei Kontoauszügen ist die wertvollste KI-Fähigkeit nicht die Extraktionsgeschwindigkeit, sondern die Prüfung berechneter Spalten: Die KI kann den Endsaldo aus Anfangssaldo plus Soll minus Haben berechnen, ihn mit dem ausgewiesenen Endsaldo auf dem Kontoauszug vergleichen und jede Abweichung kennzeichnen – ein Abstimmungsschritt, der normalerweise 10–15 Minuten menschlicher Arbeit pro Kontoauszug erfordert. Für eine Schritt-für-Schritt-Anleitung des gesamten Workflows lesen Sie unseren Leitfaden zur Konvertierung von Kontoauszügen in Excel.
Zeitersparnis-Benchmark: Eine 12-seitige monatliche Geschäftsbankabrechnung benötigt bei einem Buchhalter in der Regel 15–20 Minuten, um die Kopfzeileninformationen manuell zu erfassen und den Saldo stichprobenartig zu prüfen. Die KI-Extraktion verarbeitet sie in unter 60 Sekunden, und die berechnete Saldenprüfung ersetzt die manuelle Stichprobenprüfung vollständig. Bei 30 Mandanten × 12 Monaten entspricht das etwa 90 Stunden pro Jahr, die allein durch die Abrechnungserfassung eingespart werden – bevor man die Abgleichfehler zählt, die dadurch verhindert werden.
Belege: Das Fotoproblem
Belege sind der Dokumenttyp, bei dem die Eingabequalität – nicht die Extraktionstechnologie – der begrenzende Faktor ist. Ein sauberer digitaler Beleg von Amazon oder einer SaaS-Plattform wird mit nahezu perfekter Genauigkeit extrahiert. Ein Foto eines zerknitterten ThermoPapier-Restaurantbelegs, schräg unter gelber Beleuchtung aufgenommen, mit verblasster Tinte und einem Kaffeefleck – die Art, die Ihre Mandanten tatsächlich senden – ist ein völlig anderes Problem.
Die Extraktionsgrenze bei Belegen wird durch das bestimmt, was auf dem Foto lesbar ist, nicht durch das, was die KI theoretisch lesen kann. Wenn ein Mensch, der das Bild zusammenkneift, nicht erkennen kann, ob die Trinkgeldzeile $8.00 oder $8.80 beträgt, kann es die KI auch nicht – und keiner von beiden sollte ohne Verifizierung vertraut werden.
Was KI-Extraktion über die grundlegende OCR hinaus zur Belegverarbeitung beiträgt, ist die Kategorisierung. Die meisten Belege drucken keine Ausgabenkategorie. Ein Restaurantbeleg sagt „Tisch 12, Kellnerin: Maria, $54.30“ – nicht „Mahlzeiten & Unterhaltung“. KI mit abgeleiteter Spaltenfunktion kann den Händlernamen und den Kaufkontext lesen und eine Kategorie zuweisen: „Mahlzeiten“ für Restaurants, „Reisen“ für Hotels, „Bürobedarf“ für Staples. Dieser Klassifizierungsschritt, der manuell von einem Buchhalter oder Bilanzbuchhalter durchgeführt wird, der jeden Beleg gegen einen Kontenplan prüft, dauert in der Regel 30–60 Sekunden pro Beleg. Bei 200 Belegen pro Monat über alle Mandanten hinweg sind das über 2 Stunden, die allein durch die Klassifizierung eingespart werden.
Sehen Sie sich unseren Leitfaden zur Beleg-zu-Excel-Extraktion für den schrittweisen Workflow an, einschließlich der Benutzerdefinierten Spaltenextraktion – bei der Sie die gewünschten Feldnamen eingeben und die KI jeden Wert danach lokalisiert, was er bedeutet, statt nach seiner Position auf der Seite – die die Belegformatvielfalt bewältigt, an der vorlagenbasierte Tools scheitern.
W-2- und 1099-Steuerformulare: Extraktion mit hohem Risiko
Steuerformulare sind der Dokumenttyp, bei dem Genauigkeit rechtliche Konsequenzen hat. Ein falsch kategorisierter Rechnungsbetrag erzeugt einen Abstimmungsfehler, den Sie beim Monatsabschluss entdecken. Ein falsch übertragener W-2-Box-1-Lohnbetrag oder eine 1099-NEC-Vergütung für nicht angestellte Personen erzeugt einen Meldungsfehler, der eine IRS-Mitteilung auslöst – und möglicherweise ein Mandantengespräch, das kein Buchhalter führen möchte.
W-2-Formulare enthalten 14 nummerierte Felder plus Arbeitgeber-/Arbeitnehmer-Identifikationsdaten. 1099-NEC- und 1099-MISC-Formulare fügen eine weitere Ebene mit TINs des Zahlers, TINs des Empfängers und unterschiedlichen Feldzuweisungen je nach Formularvariante hinzu. Vorlagenbasierte Tools bewältigen dies, indem sie die IRS-OMB-Kontrollnummer in der oberen rechten Ecke identifizieren – 1545-0008 für W-2, 1545-0116 für 1099-NEC, 1545-0074 für 1040 – und eine für dieses Formularlayout spezifische Extraktionslogik anwenden. Dies funktioniert bei sauberen digitalen PDFs, scheitert jedoch bei gescannten Kopien, bei denen die OMB-Nummer unleserlich ist, oder bei Fotos von Formularen, bei denen Spiegelungen die Kennung verdecken.
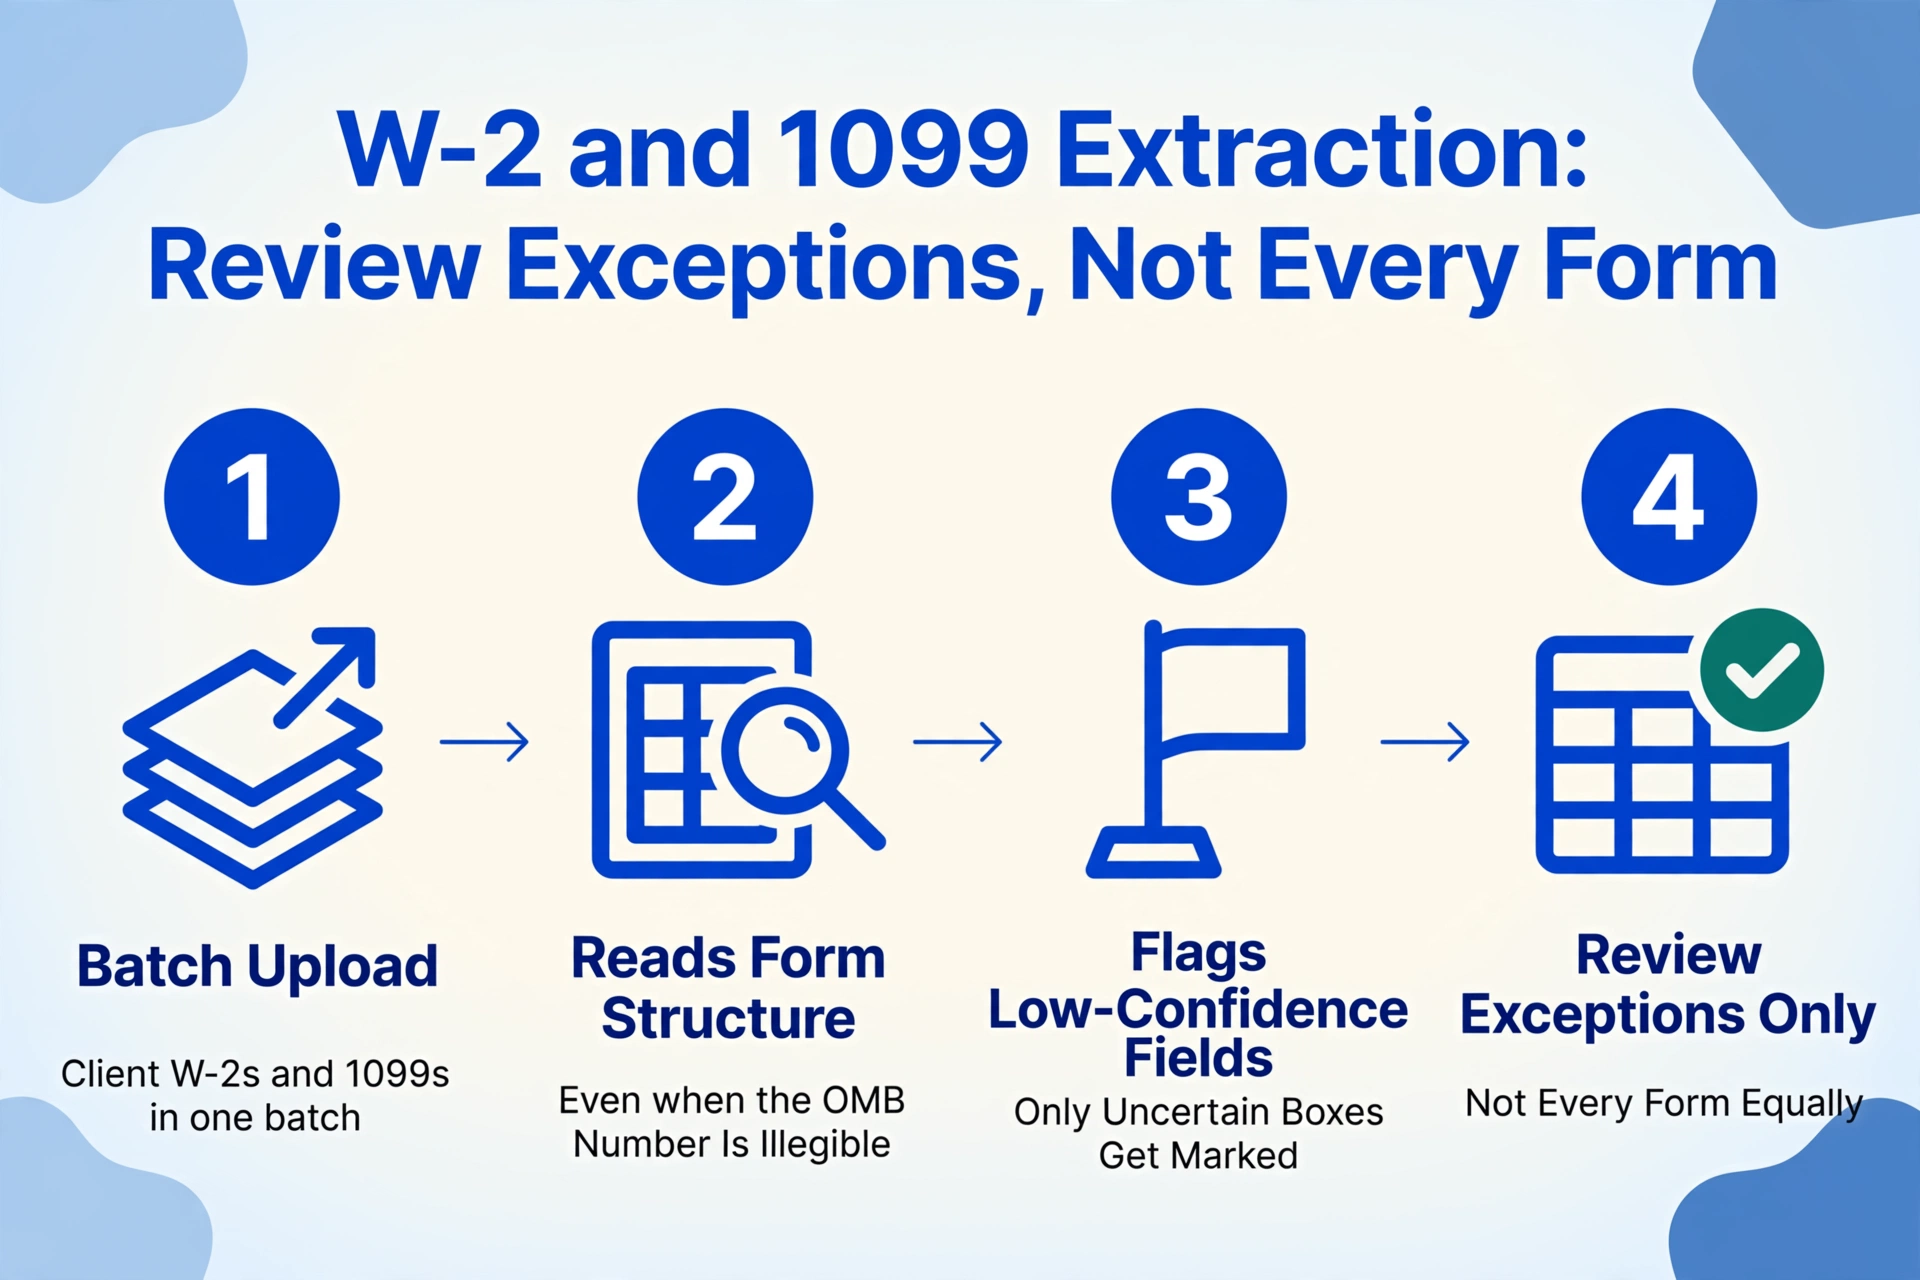
KI-Extraktion, die die Inhaltsstruktur des Formulars liest – die Lohn- und Steuerbescheinigungsstruktur erkennt, unabhängig davon, ob die Kontrollnummer sichtbar ist – bietet einen Fallback, wenn die Vorlagenidentifikation fehlschlägt. Der praktische Workflow für eine Steuerkanzlei: Extraktion auf einem Stapel von Mandanten-W-2s und 1099s ausführen, in eine Tabellenkalkulation exportieren und die Prüfzeit auf die Formulare verwenden, die die KI als mit geringer Konfidenz markiert hat, statt auf jedes Formular gleichermaßen. Dies verschiebt die Rolle des Buchhalters vom „Übertrager von Feldnummern“ zum „Prüfer von Ausnahmen“ – die Rolle, für die seine Lizenz ausgestellt wurde.
Für W-2- und 1099-spezifische Extraktionsworkflows siehe unseren Leitfaden zur 1099-zu-Excel-Extraktion. Die IRS-Compliance-Dimension – sichere Speicherung, Zugriffskontrolle, Prüfprotokolle – wird ausführlich in unserem KI-Datenerfassungs-Käuferleitfaden für Buchhalter behandelt, einschließlich der Anforderungen von Circular 230 und IRC §7216, die regeln, wie vertrauliche Mandantensteuerdaten in jeder Verarbeitungsstufe behandelt werden müssen.
Spesenabrechnungen: Das Problem zusammengesetzter Dokumente
Spesenabrechnungen sind kein einzelner Dokumenttyp. Sie sind ein zusammengesetztes Dokument: ein Spesenabrechnungsformular oder eine Tabellenkalkulation plus ein Stapel Belege, die als Belegdokumentation dienen. Die Extraktionsherausforderung besteht nicht darin, die einzelnen Belege zu lesen – das ist dasselbe Belegproblem wie oben beschrieben – sondern darin, jeden Beleg dem korrekten Abrechnungsposten zuzuordnen und zu verifizieren, dass die Beträge übereinstimmen.
Ein typischer Spesenbericht eines Kunden für eine Geschäftsreise kann einen Flugplan (487 $), eine Hotelrechnung (1.240 $ für 4 Nächte), fünf Belege für Mahlzeiten (15–85 $ pro Beleg), zwei Taxiquittungen und eine Konferenzanmelde-Rechnung enthalten. Die Aufgabe des Buchhalters besteht darin, zu prüfen, ob die Summe aller beigefügten Belege mit dem im Bericht angegebenen Gesamtbetrag übereinstimmt, ob jeder Beleg korrekt kategorisiert ist und ob keine doppelten Belege über mehrere Berichte hinweg eingereicht wurden. Diese Art der dokumentübergreifenden Abgleichung wird von aktuellen KI-Extraktionstools nicht automatisiert – und sie ist die Art, die die meisten Kanzleien nicht vollständig automatisieren möchten, denn der Prüfschritt ist der Punkt, an dem Betrug und Fehler aufgedeckt werden.
Wo KI-Extraktion die Bearbeitung von Spesenberichten doch reduziert: beim Extrahieren aller Belegdaten in eine einzige Tabelle mit konsistenten Spalten (Datum, Händler, Betrag, Kategorie), sodass der Buchhalter die Tabelle auf Anomalien durchsehen kann, statt 50 einzelne Belegbilder durchzublättern. Das verkürzt den Prüfschritt von 3 Minuten pro Beleg auf 30 Sekunden pro markierter Anomalie – und belässt den menschlichen Beurteilungsschritt dort, wo er hingehört.
Internationale Steuerdokumente: P60, PAYG und T4
Die meisten Leitfäden zur Dokumentextraktion enden bei US-Steuerformularen. Kanzleien mit internationalen Mandanten – oder Firmen außerhalb der USA – benötigen eine Abdeckung, die sich auf die Steuerdokumente erstreckt, die ihre Mandanten tatsächlich erstellen. Hier sind die drei häufigsten nicht-US-amerikanischen Einkommensdokumente, was aus jedem extrahierbar ist und worauf zu achten ist.
UK P60 (Jahresbescheinigung). Der P60 wird vom Arbeitgeber nach Ende jedes Steuerjahres (5. April) an die Arbeitnehmer ausgegeben und fasst den Gesamtlohn, die insgesamt einbehaltene Steuer, die National Insurance-Nummer, den endgültigen Steuercode und die Arbeitgeberdaten des Jahres zusammen. Wichtige extrahierbare Felder: Arbeitgebername und PAYE-Referenz, NI-Nummer des Arbeitnehmers, Gesamtlohn des Jahres, insgesamt einbehaltene Steuer, endgültiger Steuercode sowie etwaige gesetzliche Zahlungen (Mutterschafts-, Vaterschafts-, Adoptionsleistungen). Die größte Herausforderung: P60-Formulare verschiedener Lohnabrechnungsanbieter (Sage, Xero, BrightPay, QuickBooks UK) verwenden leicht unterschiedliche Layouts, obwohl sie dieselben Pflichtfelder der HMRC enthalten. Die formatunabhängige Extraktion bewältigt diese Variation ohne anbieterspezifische Konfiguration.
Australien PAYG Payment Summary. Wird für die meisten Arbeitnehmer durch Single Touch Payroll (STP)-Einkommensnachweise ersetzt, aber in einigen Fällen weiterhin ausgestellt – insbesondere für Auftragnehmer und Arbeitnehmer kleiner Arbeitgeber, die noch nicht auf STP umgestellt haben. Wichtige extrahierbare Felder: ABN des Zahlers, Name des Zahlers, TFN des Zahlungsempfängers, Bruttozahlungen, insgesamt einbehaltene Steuer, meldepflichtige Fringe-Benefits-Beträge und Pauschalzahlungen mit ihren Typschlüsseln (A bis E). Die meisten Extraktionstools, die US-Steuerformulare verarbeiten, erkennen die Layout-Konventionen der ATO nicht – prüfen Sie die Abdeckung, bevor Sie sich für ein Tool entscheiden, wenn Sie australische Lohnabrechnungsdokumente verarbeiten.
Kanada T4 (Erklärung der gezahlten Vergütung). Das T4 ist Kanadas Äquivalent zum W-2, mit einem entscheidenden Unterschied: Es verwendet bis zu 85 CRA-Boxnummern statt der 14 des W-2. Die wichtigsten Felder umfassen Arbeitseinkommen (Box 14), CPP-Beiträge (Box 16), EI-Versicherungsverdienst (Box 24), RPP-Beiträge (Box 20), Gewerkschaftsbeiträge (Box 44) und Dutzende weiterer Codes für steuerpflichtige Leistungen und Abzüge. Die Herausforderung bei der Extraktion liegt nicht im Lesen der Zahlen – sondern in der Zuordnung der richtigen CRA-Box zum richtigen Feld in TaxCycle oder Intuit ProFile, wo die Importformat-Anforderungen präzise sind. Ein Tool, mit dem Sie eigene Spaltennamen definieren können – zum Beispiel „Box 14 Arbeitseinkommen" und „Box 16 Arbeitnehmer-CPP" als benutzerdefinierte Spalten – erzeugt eine Ausgabe, die direkt auf die Importvorlage Ihrer Steuersoftware abgebildet werden kann, ohne dass Spalten nach der Extraktion umbenannt werden müssen. Eine ausführliche Anleitung zum Workflow der Extraktion kanadischer Steuerbelege finden Sie in unserem Leitfaden zur Formularextraktion — derselbe Ansatz mit benutzerdefinierten Spalten funktioniert in allen Steuerjurisdiktionen.
Worauf Sie bei einem Extraktionstool achten sollten: Ein Rahmenwerk für Buchhalter
Die üblichen Software-Bewertungskriterien – Preis, Feature-Listen, Integrationslogos – sagen Ihnen nicht, was Sie als Buchhaltungspraxis tatsächlich wissen müssen. Hier sind die fünf Faktoren, die darüber entscheiden, ob ein Extraktionstool den Kontakt mit Ihren tatsächlichen Mandantendokumenten übersteht.
Batch-Trennung für mehrere Mandanten
Die Verarbeitung von 15 Kontoauszügen für Mandant A und 8 Kontoauszügen für Mandant B sollte zwei getrennte Tabellenkalkulationen ergeben – ohne dass Sie Dateien vorab in Ordner sortieren müssen. Ein Tool, das für die Buchhaltung einzelner Unternehmen gebaut wurde, behandelt jeden Upload als einen einzigen Datenpool. Ein Tool, das für Buchhaltungspraxen gebaut wurde, ermöglicht es Ihnen, Batches pro Mandant zu benennen und Ergebnisse pro Batch zu exportieren. Für einen vollständigen Vergleich von Tools, die Multi-Mandanten-Workflows unterstützen, lesen Sie unsere Übersicht der Extraktionstools für Buchhaltungsfirmen.
Formatunabhängigkeit, nicht Vorlagenkonfigurierbarkeit
Ein Tool, das „leistungsstarke Vorlagen-Builder" und „Zonen-OCR-Konfiguration" anbietet, verkauft Ihnen einen Vorlagenwartungsjob, keine Automatisierung. Die entscheidende Fähigkeit ist Formatunabhängigkeit: Das Tool verarbeitet die Rechnung eines neuen Lieferanten, den Kontoauszug einer neuen Bank oder die Formulare eines neuen Lohnabrechnungsanbieters mit derselben Einrichtung wie bei einem bekannten – weil es Dokumente liest, indem es versteht, was Felder bedeuten, nicht indem es misst, wo sie sich befinden. Für den technischen Unterschied zwischen diesen Ansätzen lesen Sie unsere Erklärung zu KI-OCR vs. traditionellem OCR.
Benutzerdefinierte Spaltenvorlagen, die Sie speichern statt neu erstellen
Die Spalten, die Sie für einen Restaurantkunden extrahieren (Lebensmittelkosten nach Kategorie, gemeldete Trinkgelder, POS-Abrechnungsbeträge), unterscheiden sich von den Spalten für einen Baukunden (Auftragskostencodes, Einbehalte, Pfandverzichte). Ein praxistaugliches Tool speichert Spaltenvorlagen pro Mandant oder pro Auftragsart, sodass Mitarbeiter die Extraktionskonfigurationen nicht jeden Monat von Grund auf neu erstellen müssen.
Ausgabe im Format, das Ihre nachgelagerten Tools erwarten
QuickBooks Online importiert CSV mit bestimmten Spaltenüberschriften. Drake Tax erwartet bestimmte Feldzuordnungen. Xero-Massenimporte erfordern bestimmte Datumsformate. Ihr Extraktionstool muss Excel- oder CSV-Ausgaben erzeugen, die dem Importformat Ihrer Buchhaltungssoftware entsprechen – mit passenden Spaltennamen, Datumsformaten, die sich parsen lassen, und numerischen Feldern ohne Währungssymbole. Wenn das Tool nur in sein eigenes proprietäres Format exportiert,I've traded data entry for data reformatting.
Dokumentensammlung, nicht nur Extraktion
Der Engpass in den meisten Buchhaltungskanzleien liegt nicht in der Datenextraktion aus Dokumenten – sondern darin, die Dokumente überhaupt erst von den Mandanten zu erhalten. Ein Tool mit einem Sammellink – einem teilbaren Link, den Mandanten ohne Anmeldung öffnen, um Dokumente direkt in Ihre Verarbeitungswarteschlange hochzuladen – löst das vorgelagerte Problem. Statt Mandanten per E-Mail und SMS hinterherzujagen und ihre monatlichen Kontoauszüge und Belege anzufordern, senden Sie einen einzigen Link, der alles direkt in Ihre Extraktionspipeline einspeist. Für Kanzleien, die gemeinnützige Mandanten betreuen, finden Sie in unserem Leitfaden zum Extrahieren von Spendenbelegdaten einen Anwendungsfall für den Sammellink, der speziell auf diesen Sektor zugeschnitten ist.
Häufige Fallstricke bei der Automatisierung der Dokumentenextraktion
Jede Buchhaltungskanzlei, die Dokumentenextraktion eingeführt hat, ist mindestens einem dieser Fallstricke begegnet. Wer sie im Voraus kennt, verwandelt eine schmerzhaft gelernte Lektion in eine Checkliste, die Sie prüfen können, bevor das Tool Ihre erste Mandantendatei berührt.
Fallstrick 1: Ein Vorlagen-Tool für eine Umgebung mit vielen Formaten kaufen. Vorlagenbasierte OCR-Tools werden als „einmal einrichten, für immer nutzen" verkauft. In einer Buchhaltungskanzlei bedeutet „einmal" pro Anbieter, pro Bank, pro Mandant – und das Einrichten hört nie auf, weil Mandanten die Bank wechseln und Anbieter ihre Rechnungsformate ändern. Das Tool, das in der Demo mit drei sauberen PDFs funktioniert hat, versagt im vierten Monat, wenn Mandant C von Wells Fargo zu Mercury wechselt und sich die Spalten im Kontoauszug umkehren. Die Lösung ist nicht, ein besseres Vorlagen-Tool zu kaufen, sondern ein Tool, das ohne Vorlagen arbeitet.
Fallstrick 2: Genauigkeit als eine einzelne Zahl behandeln. Ein Tool, das „99 % Genauigkeit" bewirbt, hat diesen Wert mit Dokumenten aus seinem Benchmark-Datensatz erreicht – saubere PDFs mit gedrucktem Text in Standardlayouts. Dasselbe Tool kann bei fotografierten Belegen aus schlecht beleuchteten Restaurants nur 80 % Genauigkeit erreichen, bei gescannten Kontoauszügen von Kreditgenossenschaften mit Nadeldruckern 70 % und bei handschriftlichen Randnotizen 50 %. Entscheidend ist die Genauigkeit bei Ihren schwierigsten Dokumenten, nicht bei den besten des Anbieters. Bevor Sie sich für ein Tool entscheiden, testen Sie es mit 10 Ihrer problematischsten Dateien – den zerknitterten Belegen, den gefaxten W-2-Formularen, den dreiseitigen Rechnungen der Restaurantkette – nicht mit Dokumenten, die wie die Demo des Anbieters aussehen. Diese Methodik erläutern wir in unserem praktischen Leitfaden zur Genauigkeit.
Fallstrick 3: Extraktion automatisieren, bevor die Sammlung automatisiert wird. Wenn Ihre Extraktionspipeline 100 Dokumente pro Stunde verarbeiten kann, Ihre Mandanten aber zwei Wochen brauchen, um diese Dokumente zu senden, haben Sie einen Schritt beschleunigt, der hinter dem eigentlichen Engpass liegt. Lösen Sie zuerst das Sammlungsproblem: Standardisieren Sie, wie Mandanten Dokumente einreichen (ein einziger Sammellink statt E-Mail-Anhängen), legen Sie Abgabefristen fest und automatisieren Sie Erinnerungen. Extraktionsgeschwindigkeit ist bedeutungslos, wenn es nichts zu extrahieren gibt.
Fallstrick 4: Den Prüfschritt überautomatisieren. IRS Circular 230, Abschnitt 10.22 verlangt, dass ein Steuerberater bei der Erstellung von Steuererklärungen die gebotene Sorgfalt walten lässt – einschließlich der Überprüfung der Richtigkeit der eingegebenen Daten. Die Automatisierung der Extraktion ersetzt Ihre Prüfungspflicht nicht; sie verändert sie von der Prüfung jedes einzelnen Datenpunkts hin zur Prüfung der Ausnahmen. Gestalten Sie Ihren Workflow so, dass extrahierte Daten eindeutig auf das ursprüngliche Belegbild zurückgeführt werden können, Felder mit geringer Konfidenz zur manuellen Prüfung markiert werden und der Rest per Ausnahmeprüfung verifiziert wird. Ein „alles prüfen“-Workflow macht die Zeitersparnis zunichte. Ein „nichts prüfen“-Workflow verstößt gegen Circular 230. Der Mittelweg – Prüfung per Ausnahme – ist der Punkt, an dem Extraktionstools ihren Platz in einer CPA-Kanzlei verdienen.
Implementierungsfahrplan für Buchhaltungskanzleien
Die Einführung der Belegextraktion in einer Buchhaltungspraxis sollte den Belegarten in der Reihenfolge von Volumen und Formatkonsistenz folgen – nicht in der Reihenfolge der vermeintlichen Wichtigkeit. Ziel ist es, das Vertrauen der Mitarbeiter und Workflow-Gewohnheiten anhand der einfachsten Belege aufzubauen, bevor die schwierigeren eingeführt werden.
Phase 1: Kontoauszüge und Kreditkartenabrechnungen (Monat 1–2). Beginnen Sie hier, weil Kontoauszüge ein hohes Volumen haben, monatlich in einem vorhersehbaren Rhythmus eintreffen und – trotz Formatunterschieden zwischen den Banken – eine konsistente interne Struktur aufweisen (Transaktionen in chronologischen Zeilen mit Datums-, Beschreibungs- und Betragsspalten). Wählen Sie 3–5 Mandanten mit den konsistentesten Kontoauszugsformaten und verarbeiten Sie einen Monat Kontoauszüge. Vergleichen Sie die Extraktionsergebnisse mit der manuellen Erfassung auf Genauigkeit. Messen Sie den Zeitunterschied durchgängig: vom Erhalt der PDF bis zu verifizierten, für den Abgleich bereiten Daten. Am Ende von Phase 1 sollten die Mitarbeiter dem Tool bei Kontoauszügen vertrauen und die Kanzlei sollte eine klare Zeitersparnis-Baseline haben.
Phase 2: Lieferantenrechnungen (Monat 2–4). Fügen Sie Rechnungen hinzu, sobald der Kontoauszugs-Workflow stabil ist. Beginnen Sie mit wiederkehrenden Rechnungen bekannter Lieferanten – solchen, bei denen Sie bereits 20 Varianten gesehen haben und wissen, wie die Daten aussehen sollten – bevor Sie neue Lieferanten einführen. Speichern Sie Spaltenvorlagen pro Mandant, die deren häufig verwendete SKR-Konten und Kostenstellenzuordnungen enthalten, damit die Extraktionsergebnisse direkt auf die Kontenstruktur abgebildet werden. Für gemeinnützige Organisationen und Organisationen mit spezifischem Ausgaben-Tracking finden Sie in unserem Leitfaden zur Spendenbeleg-Extraktion ein Beispiel für die Vorlagengestaltung.
Phase 3: Belege und Spesenabrechnungen (Monat 4–6). Belege führen die Fotoqualitätsvariable ein und erfordern die Kategorisierungsfunktionen, die einfache OCR nicht bietet. Beginnen Sie mit digitalen Belegen (Amazon, SaaS-Abonnements, elektronische Rechnungen), bevor Sie fotografierte Papierbelege einführen. Erstellen Sie einen mandantenorientierten Leitfaden für Belegfotos – lesbar, flach, gut beleuchtet – der Eingabequalitätsprobleme reduziert, bevor sie Ihre Extraktionspipeline erreichen. Führen Sie bei Spesenabrechnungen zuerst die KI-Extraktion auf den Belegen durch und verwenden Sie dann die Tabellenkalkulationsausgabe, um die Abrechnungssummen zu verifizieren – nicht umgekehrt.
Phase 4: Steuerformulare (Fenster Juli–Oktober). Steuerformulare erfordern die höchste Genauigkeit und haben die schwerwiegendsten regulatorischen Konsequenzen bei Fehlern. Führen Sie die Steuerformular-Extraktion nicht während der Hochsaison Dezember–April ein. Nutzen Sie das Fenster Juli–Oktober, um W-2s und 1099s aus Vorjahren zu testen, die KI-Extraktion formularweise mit der manuellen Erfassung zu vergleichen und den Prüfung-per-Ausnahme-Workflow aufzubauen, bevor Live-Erklärungen davon abhängen. Wenn die Januar-W-2s eintreffen, sollten die Mitarbeiter bereits wissen, welche Formulare das Tool zuverlässig verarbeitet und welche eine vollständige manuelle Prüfung erfordern.
Timing-Prinzip: Führen Sie niemals einen neuen Extraktions-Workflow in den 60 Tagen vor einer Steuerfrist ein. Die Einarbeitungszeit – herauszufinden, welche Dokumente sauber extrahiert werden, welche eine manuelle Prüfung benötigen und was zu tun ist, wenn die Extraktion fehlschlägt – bindet im ersten Monat mehr Personalzeit, als das Tool einspart. Planen Sie Einführungen für die ruhigen Zeiten zwischen den Steuersaisons, nicht für die Spitzenzeiten.
Häufig gestellte Fragen
Kann die KI-Extraktion handschriftliche Belege und Randnotizen verarbeiten?
Teilweise. Handschrift in Blockschrift wird mit einer Feldergenauigkeit von etwa 75–85 % extrahiert; Schreibschrift und flüchtige Handschrift fallen auf 50–70 %. Die KI kann lesen, was lesbar ist. Wenn ein Mensch den Betrag auf einem verblassten Thermodruck-Beleg mit Kaffeefleck nicht erkennen kann, schafft das auch die KI nicht – und Sie sollten sich ohne Bestätigung durch den Mandanten nicht auf dieses Feld verlassen.
Funktioniert die Extraktion mit gescannten Kontoauszügen, die schräge Seiten und Nadeldruck aufweisen?
Ja, mit Einschränkungen. Die KI-Extraktion verarbeitet Schräglage, Drehung und niedrig aufgelöste Scans besser als herkömmliche OCR, weil sie das gesamte Seitenlayout erfasst statt Zeichen für Zeichen zu scannen. Allerdings erzeugt Nadeldruck auf Papier, das über 5+ Jahre vergilbt ist, kontrastarmen Text, der die Genauigkeit jedes Extraktionssystems beeinträchtigt. Diese Dokumente sollten unabhängig vom verwendeten Tool zur manuellen Prüfung markiert werden.
Sind die Finanzdaten von Mandanten während der KI-Verarbeitung sicher?
Das hängt von der Architektur des Tools ab. Einige Tools leiten Dokumente über KI-APIs von Drittanbietern, die Daten für das Modelltraining aufbewahren – ein potenzielles Problem im Sinne von IRC §7216, wenn die Daten Steuerinformationen von Mandanten enthalten. Andere verarbeiten Dokumente über die eigene Infrastruktur und bewahren keine Daten zu Trainingszwecken auf. Prüfen Sie die Datenverarbeitungsrichtlinie des Tools anhand Ihrer WISP-Anforderungen, bevor Sie Mandantendokumente hochladen. Mindestens sollten Sie sicherstellen: hochgeladene Dokumente werden nicht für das Modelltraining verwendet, die Verarbeitung ist während der Übertragung verschlüsselt, und Dokumente werden nach einem festgelegten Aufbewahrungszeitraum automatisch gelöscht.
Muss ich ein Modell pro Mandant trainieren oder kann eine Einrichtung alle Mandanten verarbeiten?
Bei vorlagenbasierten Tools trainieren Sie de facto pro Mandant – oder pro Lieferant, pro Bank, pro Formulartyp –, weil jedes neue Dokumentlayout eine neue Vorlage erfordert. Mit der formatunabhängigen KI-Extraktion definieren Sie die gewünschten Spalten einmal (Datum, Beschreibung, Betrag, Kategorie), und dieselbe Einrichtung verarbeitet Dokumente von jedem Mandanten, jeder Bank und jedem Lieferanten. Kein Training pro Mandant, keine Vorlagenerstellung pro Lieferant. Dies ist die mit Abstand wichtigste Architekturfrage, die Sie vor dem Kauf eines Tools für eine Kanzlei mit mehreren Mandanten prüfen sollten.
Wie arbeitet die KI-Extraktion mit QuickBooks oder Xero zusammen?
Tools zur KI-Extraktion erzeugen strukturierte Daten im Excel- oder CSV-Format – sie buchen Transaktionen nicht direkt in QuickBooks oder Xero, so wie es Dext oder Hubdoc tun. Der Workflow ist: KI extrahiert Daten → Sie prüfen die Tabellenausgabe → Import in QuickBooks/Xero über die Sammelimport-Funktion der Software. Das gibt Ihnen die volle Kontrolle darüber, was ins Hauptbuch gelangt, erfordert aber einen Import-Schritt. Wenn Sie eine direkte Verbuchung im Hauptbuch ohne Tabellen-Zwischenschritt wünschen, ist ein in die Buchhaltung integriertes Erfassungstool wie Dext oder Veryfi die richtige Wahl – diese Tools machen jedoch feste Vorgaben bei Dokumenttypen und Kategorisierungsregeln. Tools zur KI-Extraktion sind bei jedem Dokument flexibel, überlassen den Import-Schritt jedoch Ihnen. Keine Architektur ist universell überlegen; sie bedienen unterschiedliche Workflows. Vergleichen Sie die Optionen in unserem Übersicht der Tools für Buchhaltungskanzleien.
Was passiert, wenn die KI ein Feld falsch erkennt – wie kann ich das feststellen?
Der effektivste Prüfworkflow ist die Prüfung nach Ausnahmen, nicht die feldweise Kontrolle. Nach der Extraktion: (1) nach leeren Feldern suchen, wo Daten vorhanden sein sollten – das sind offensichtliche Extraktionsfehler; (2) berechnete Spalten stichprobenartig mit den Quelldokumenten abgleichen (z. B. stimmt der berechnete Endsaldo mit dem angegebenen Endsaldo überein?); (3) nach Betrag sortieren und die obersten und untersten 5 Einträge prüfen – die größten Transaktionen bergen das höchste Risiko, wenn sie falsch sind. Diese dreistufige Prüfung erfasst die überwiegende Mehrheit der Extraktionsfehler in weniger als 5 Minuten pro Batch, gegenüber 20+ Minuten feldweiser Kontrolle. Die Prüfung darf nicht vollständig übersprungen werden – die Sorgfaltspflichten gemäß Circular 230 gelten für KI-gestützte Arbeit genauso wie für manuelle Arbeit.
Kann es mehrwährungsfähige Rechnungen und internationale Steuerformulare verarbeiten?
Ja, was die Erkennung mehrerer Währungen betrifft – die KI-Extraktion kann Währungssymbole ($, €, £, ¥) identifizieren und in den extrahierten Daten beibehalten, allerdings müssen Sie die Währungsumrechnung separat vornehmen, da Extraktionstools keine Devisenberechnungen durchführen. Bei internationalen Steuerformularen (UK P60, Australia PAYG, Canada T4) variiert die Abdeckung je nach Tool erheblich. Die meisten auf den US-Markt optimierten Tools erkennen keine Nicht-US-Formularlayouts. Prüfen Sie die Unterstützung internationaler Formulare vor dem Kauf ausdrücklich – gehen Sie nicht davon aus, dass „unterstützt Steuerformulare“ mehr bedeutet als US-W-2/1099. Ein Tool, mit dem Sie eigene Spalten nach CRA-Boxnummer oder HMRC-Feldname definieren können, funktioniert auch mit internationalen Formularen ohne integrierte Formularerkennung, da die KI den Formularinhalt nach Bedeutung liest und nicht durch Abgleich mit einer Vorlage.
Die Zeit, die eine Buchhaltungskanzlei für Dateneingabe aufwendet, ist Zeit, die sie nicht für Analyse, Beratung und Kundenbeziehungen nutzen kann – die Dinge, die die Kanzlei tatsächlich wachsen lassen. Dokumentextraktion senkt nicht nur Kosten – sie wandelt abrechenbare Stunden von Transkriptionsarbeit in Facharbeit um, die einzige Art von Arbeit, für die eine CPA-Lizenz gedacht ist. Das Tool ist der erste Schritt. Die Praxisentscheidung – welche Mandanten man aufnimmt, welche Dienstleistungen man ausbaut, welche Dokumenttypen man nicht mehr von Hand bearbeitet – ist der Schritt, der sich auszahlt.
Testen Sie es mit Ihren anspruchsvollsten Mandantendokumenten →