会計士のためのAIドキュメントデータ抽出ガイド
まず何を自動化すべきか
会計士は処理すべき書類に事欠きません。平均的な10人規模の事務所では、毎月、30の金融機関の銀行明細書、200社の請求書、15通りの撮影向きのレシート、40名分のW-2と1099、テキスト・メール・しわくちゃの紙から集めた経費精算書を扱っています。会計士に足りないのは、こうした書類の山を、週30時間の請求可能時間を奪わずに構造化データへ変換する手段です。本ガイドでは、会計事務所が遭遇する主要な書類タイプごとに、何が抽出でき、何に依然として人の判断が必要か、そして税務シーズンの合間に収まる導入の道筋を解説します。
主なポイント
- 税務申告作業時間の60%は、判断や顧客への助言ではなく、データの抽出と修正に費やされており、平均的な10人規模の事務所で週30時間の請求可能時間を奪っています。
- テンプレートベースの抽出ツールでは、30社の顧客が利用するベンダーや銀行ごとに新しいテンプレートが必要です。さらに明細書上で列がひっそりずれると、照合するまで出力は正しく見えても金額が誤っています。
- 抽出がフォーマット非依存になると — 項目がどこにあるかではなく、何を意味するかで読み取るようになると — あなたの仕事はデータ入力作業者から例外レビュアーへと変わり、それこそがCPA資格が発行された唯一の業務です。
会計士がドキュメント抽出を必要とする理由:定量化された根拠
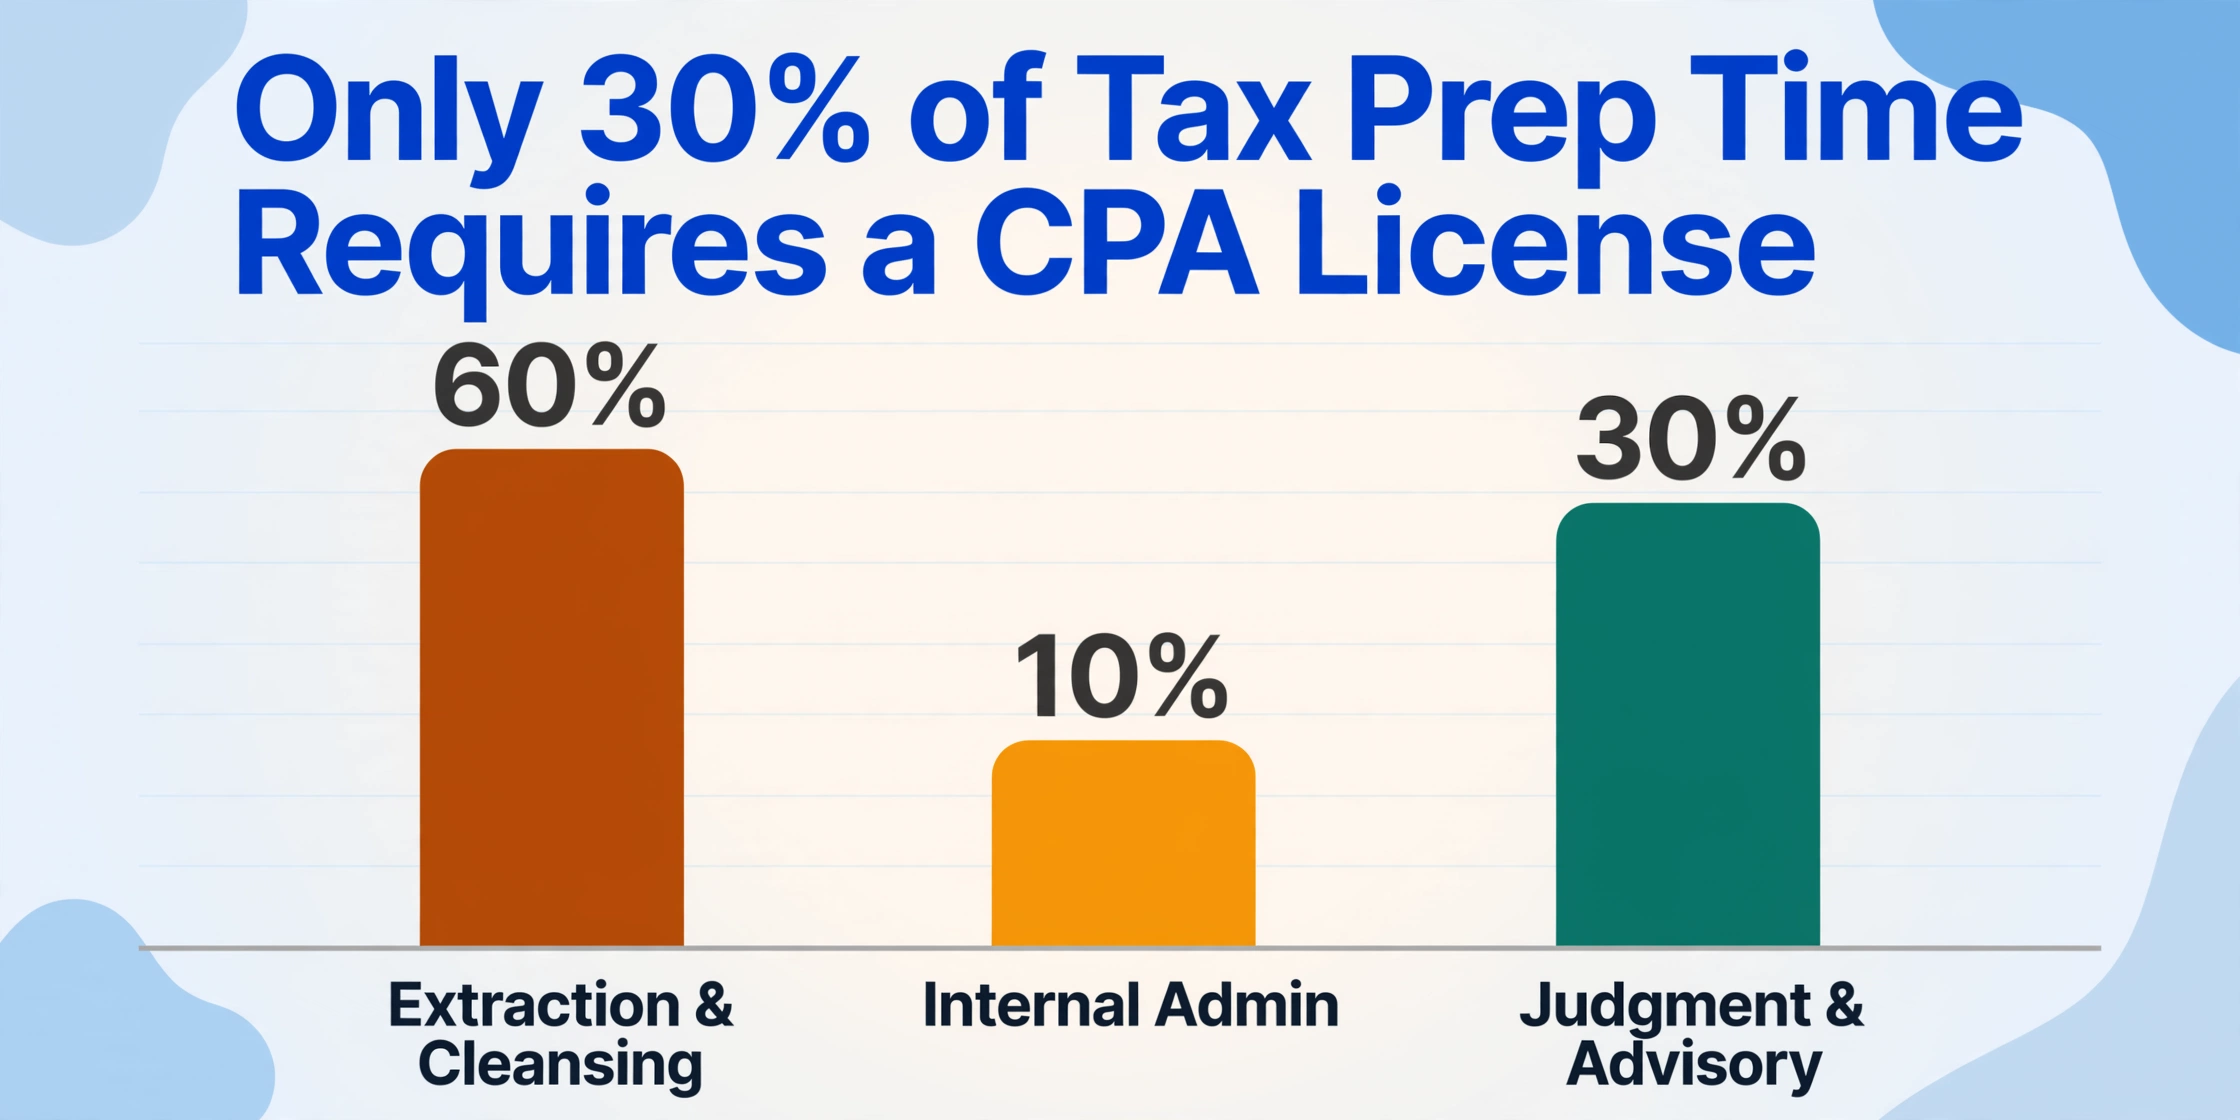
PWCの税務コンプライアンス業務に関する調査によると、確定申告書作成に費やす時間の60%はデータの抽出・クレンジング・分析に消費されており、専門的判断、リスク評価、顧客へのアドバイスに使われているわけではありません。さらに10%は社内管理業務に充てられています。つまり、税務専門家の時間のうち約30%しか、CPAライセンスを実際に必要とする業務に残されていません。時間単価$200〜400で請求する事務所において、その抽出時間の半分でもアドバイザリー業務に振り向ければ、どれだけ人員を採用しても追いつかないほどの収益シフトとなります。
多くの会計事務所が見落としている構造的な洞察:手入力のコストは、入力にかかる時間だけではありません。その後のクリーンアップ時間もかかります。入力中に発生するすべてのエラー(APQCの財務ベンチマークによると100フィールドあたり2〜5件)は発見して修正しなければならず、$47,000の請求書で数字の転記ミスを見つけるのは、最初から正しく入力するよりも時間がかかります。
出力側では、AIによる抽出は1ページを5〜10秒で処理します。これは手入力の約18倍の速さであり、印刷されたテキストに対するフィールド単位の精度は一貫して97%を超えています。トレードオフは速度対精度ではありません。速度と精度対、毎月3日間データ入力に追われる同じチーム、という構図です。米国労働統計局は、簿記業務の雇用が2023年から2033年にかけて約5%減少すると予測しており、その要因をデータ入力業務のソフトウェアによる自動化に帰しています。これは、市場が事務所の決断を待っていないというシグナルです。
しかし「ドキュメント抽出」は一つの問題ではありません。銀行明細書、請求書、レシート、W-2、経費精算書、英国のP60はそれぞれ根本的に異なる抽出課題を提示するため、同じラベルを貼られた6つの異なる問題なのです。このガイドの残りでは、それぞれについて説明します — 何が抽出可能か、何が難しいか、どのくらいの時間を回収できるか、そして人間の判断が譲れない領域はどこか。ドキュメント抽出技術自体が初めての方は、まずOCRの仕組みの説明と会計ワークフローにとっての意味をご覧ください。その後、ここに戻ってドキュメントタイプ別の内訳をご確認ください。
請求書:抽出の基準
請求書は会計業務で最も自動化されている文書タイプであり、AI抽出がテンプレートベースのツールに対する明確な優位性を示す文書でもあります。一般的なベンダー請求書には8~15の構造化フィールドが含まれます:ベンダー名、請求書番号、日付、支払期日、PO番号、説明と数量を含む明細行、小計、税額、送料、合計。既知のベンダーからのクリーンなPDFであれば、従来のテンプレートOCRは確実に機能します。問題は「既知のベンダーから」という部分です。
クライアントの買掛金を処理する会計事務所は、5社のベンダーから請求書を受け取るわけではありません。30社のクライアントが取引するすべてのベンダーから請求書を受け取ります — Amazon Business、Home Depot、手書きの請求書を出す地元の電気工事店、メールPDFで届くSaaSサブスクリプション、多通貨の明細行を持つ海外サプライヤーなどです。新しいベンダーごとに新しいレイアウトが生まれ、テンプレートベースのツールは各レイアウトを新たな設定プロジェクトとして扱います。各フィールドがページ上のどこにあるかを記憶するのではなく、各フィールドの意味を理解して文書を読み取るAI抽出は、新しいベンダーの請求書も既知のベンダーと同じ設定で処理します。
大量バッチでの仕組みについて詳しくは、バッチ請求書処理ガイドをご覧ください。会計士にとっての要点:請求書抽出は、「ベンダーAの請求書でいくつのフィールドを正しく取得できるか」ではなく、「抽出設定に触れることなく、いくつの新しいベンダーをオンボーディングできるか」で成功を測るべき文書タイプです。
銀行明細書:照合のボトルネック
銀行明細書はほとんどの会計事務所で最も量の多い文書タイプであり、フォーマットの多様性が最も深刻に影響する文書です。30社のクライアントを持つ事務所は、Chase、Wells Fargo、Bank of America、地域の信用組合、MercuryやRelayなどのオンラインバンク、Revolutなどの国際金融機関から毎月の明細書を受け取る可能性があり、それぞれ列レイアウト、日付形式、取引のグループ化規則が異なります。
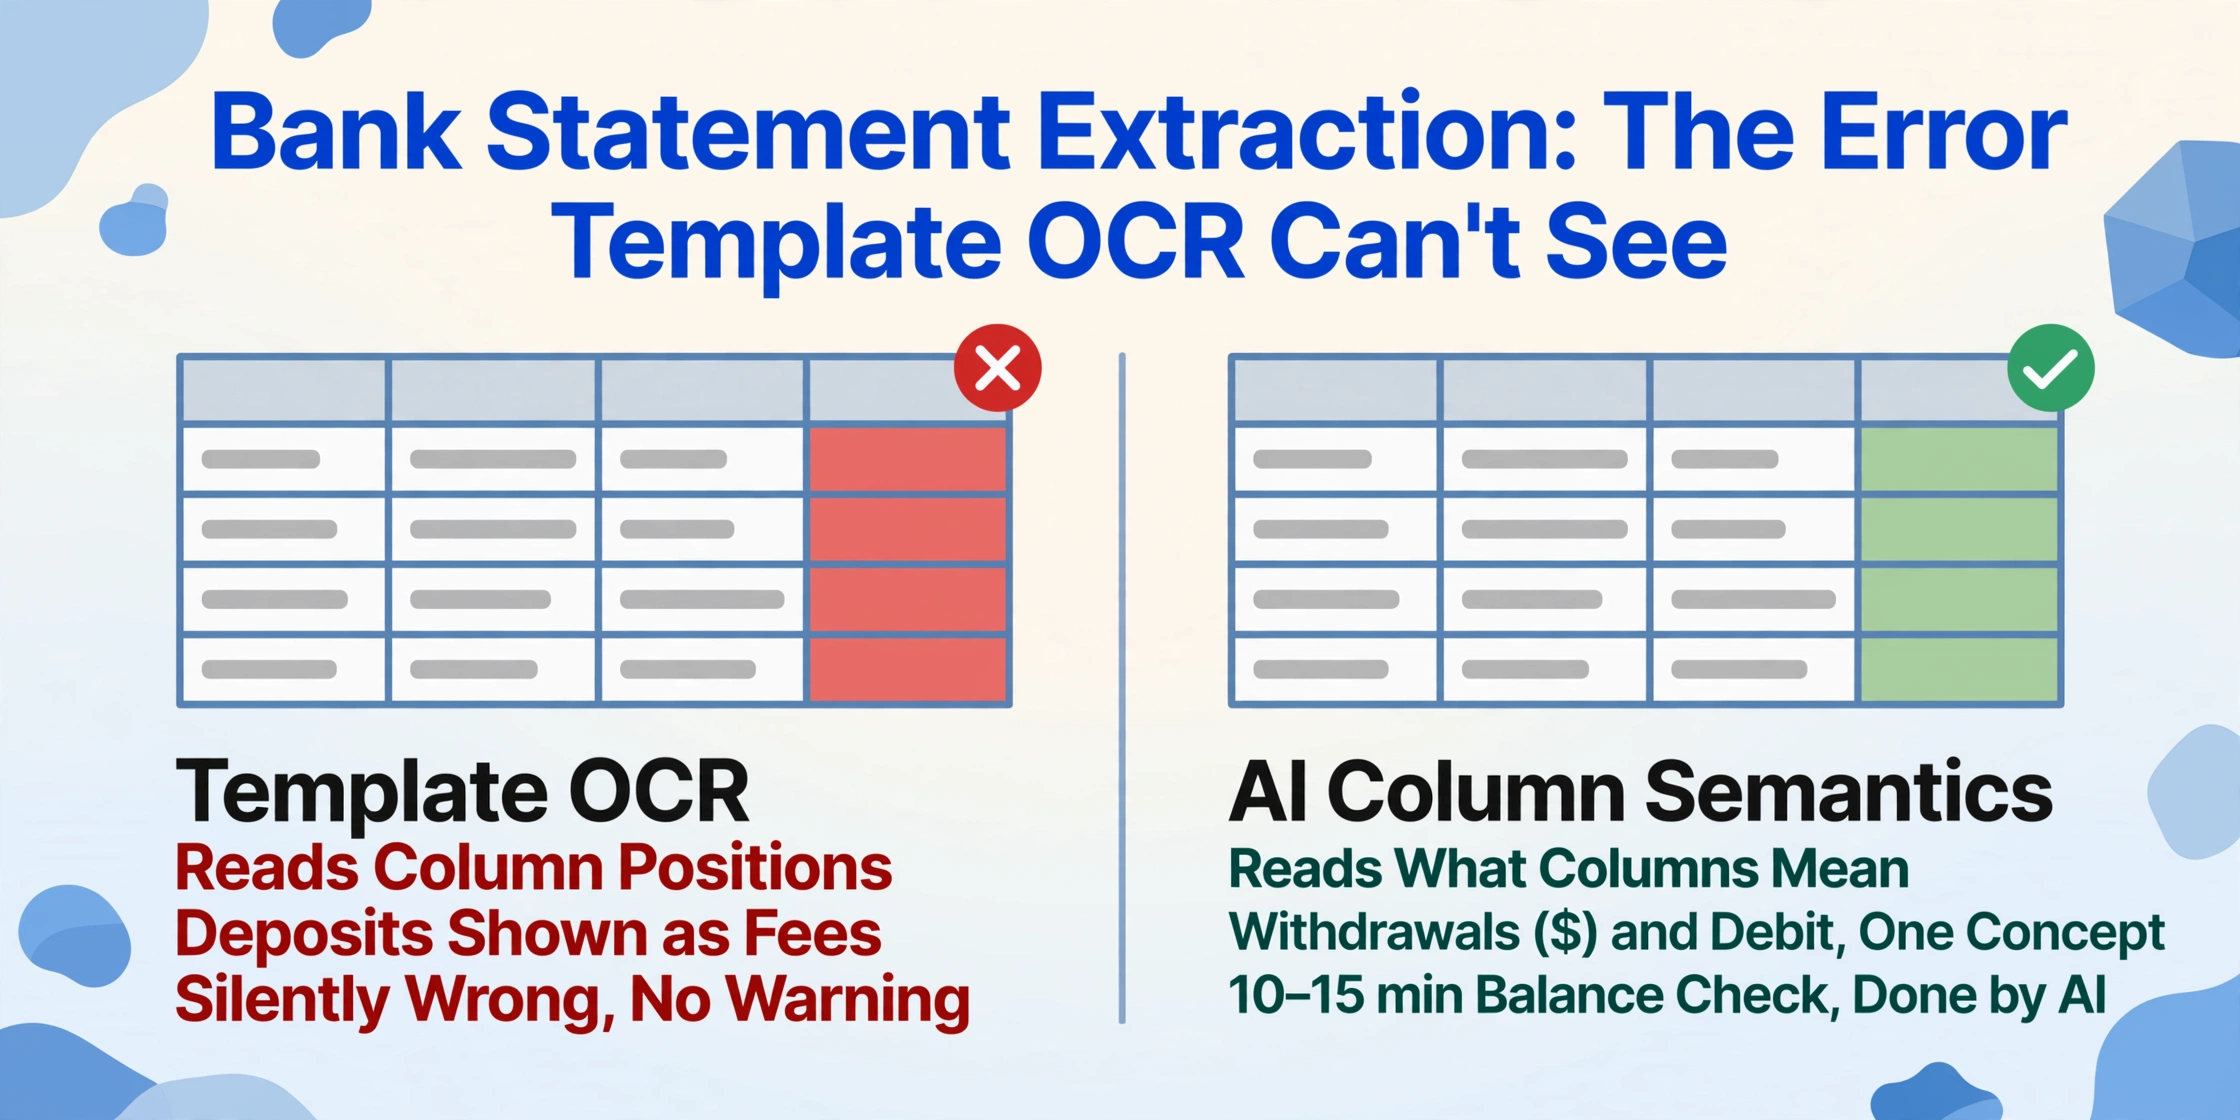
テンプレートベースのツールはこの多様性に苦戦します:Chaseの明細書用に作られたテンプレートは、借方と貸方を単一の取引金額列ではなく別々の列に分割するWells FargoのPDFでは、気づかれないまま誤動作します。抽出されたデータは正しく見えます — 数字は正しい列にあります — しかしクレジットカードの支払いが引き出しとして表示され、入金が手数料として表示されます。従来のOCRは位置を読み取るのであって意味を読むのではないため、このエラーが発生したことを知る方法がありません。
列のセマンティクスを理解するAI抽出 — 「Withdrawals ($)」と「Debit」が同じ概念を異なる表現で示していることを認識する — は、この種のエラーを完全に排除します。特に銀行明細書において、最も価値のあるAI機能は抽出速度ではなく計算列の検証です:AIは期首残高に借方額を加え貸方額を差し引いて期末残高を計算し、明細書に記載された期末残高と比較して、不一致があればフラグを立てることができます — 通常は人間が明細書1件あたり10~15分かかる照合作業です。エンドツーエンドのワークフローの詳細については、銀行明細書のExcel変換ガイドをご覧ください。
時間節約のベンチマーク:12ページの月次事業用銀行明細は、通常、会計士がヘッダー情報を手入力し、残高を抜き取り確認するのに15~20分かかります。AI抽出は60秒未満で処理し、計算された残高検証が手動の抜き取り確認を完全に置き換えます。30顧客×12か月では、明細入力だけで年間約90時間が回収されます — それが防ぐ照合エラーを数える前の話です。
レシート:写真の問題
レシートは、入力品質 — 抽出技術ではなく — が制約となる文書タイプです。AmazonやSaaSプラットフォームからのきれいなデジタルレシートは、ほぼ完璧な精度で抽出されます。黄色い照明の下で斜めから撮影され、インクがかすれ、コーヒーの染みがついた、しわくちゃの感熱紙レストランレシートの写真 — 顧客が実際に送ってくるようなもの — は、まったく別の問題です。
レシートの抽出限界は、AIが理論上読み取れるかどうかではなく、写真で判読できるかどうかによって決まります。画像を目を細めて見てもチップ行が$8.00なのか$8.80なのか分からないなら、AIにも分かりません — そして検証なしに信頼すべきでもありません。
基本的なOCRを超えて、AI抽出がレシート処理に加えるのは分類です。ほとんどのレシートには経費カテゴリが印刷されていません。レストランのレシートには「Table 12, Server: Maria, $54.30」と書かれているだけで、「Meals & Entertainment」とは書かれていません。推論列機能を備えたAIは、加盟店名と購入内容を読み取り、カテゴリを割り当てることができます。レストランなら「Meals」、ホテルなら「Travel」、Staplesなら「Office Supplies」といった具合です。この分類ステップを会計士や簿記担当者が各レシートを勘定科目表と照合しながら手作業で行うと、通常1件あたり30~60秒かかります。クライアント全体で月200件のレシートとなると、分類だけで2時間以上が回収されます。
ステップバイステップのワークフローについては、レシートからExcelへの抽出ガイドをご覧ください。ここにはカスタム列抽出 — 欲しいフィールド名を入力すると、AIがページ上の位置ではなく意味に基づいて各値を特定する機能 — が、テンプレートベースのツールを破綻させるレシートの多様なフォーマットにどう対応するかが含まれています。
W-2および1099税務フォーム:高リスクの抽出
税務フォームは、正確性が法的な結果を招く文書タイプです。請求書の金額を誤って分類しても、月末決算時に発見できる照合エラーにしかなりません。しかし、W-2のBox 1賃金額や1099-NECの非従業員報酬額を誤って転記すると、IRSからの通知を招く申告エラーとなり、会計士なら誰も望まないクライアントとの会話につながる可能性があります。
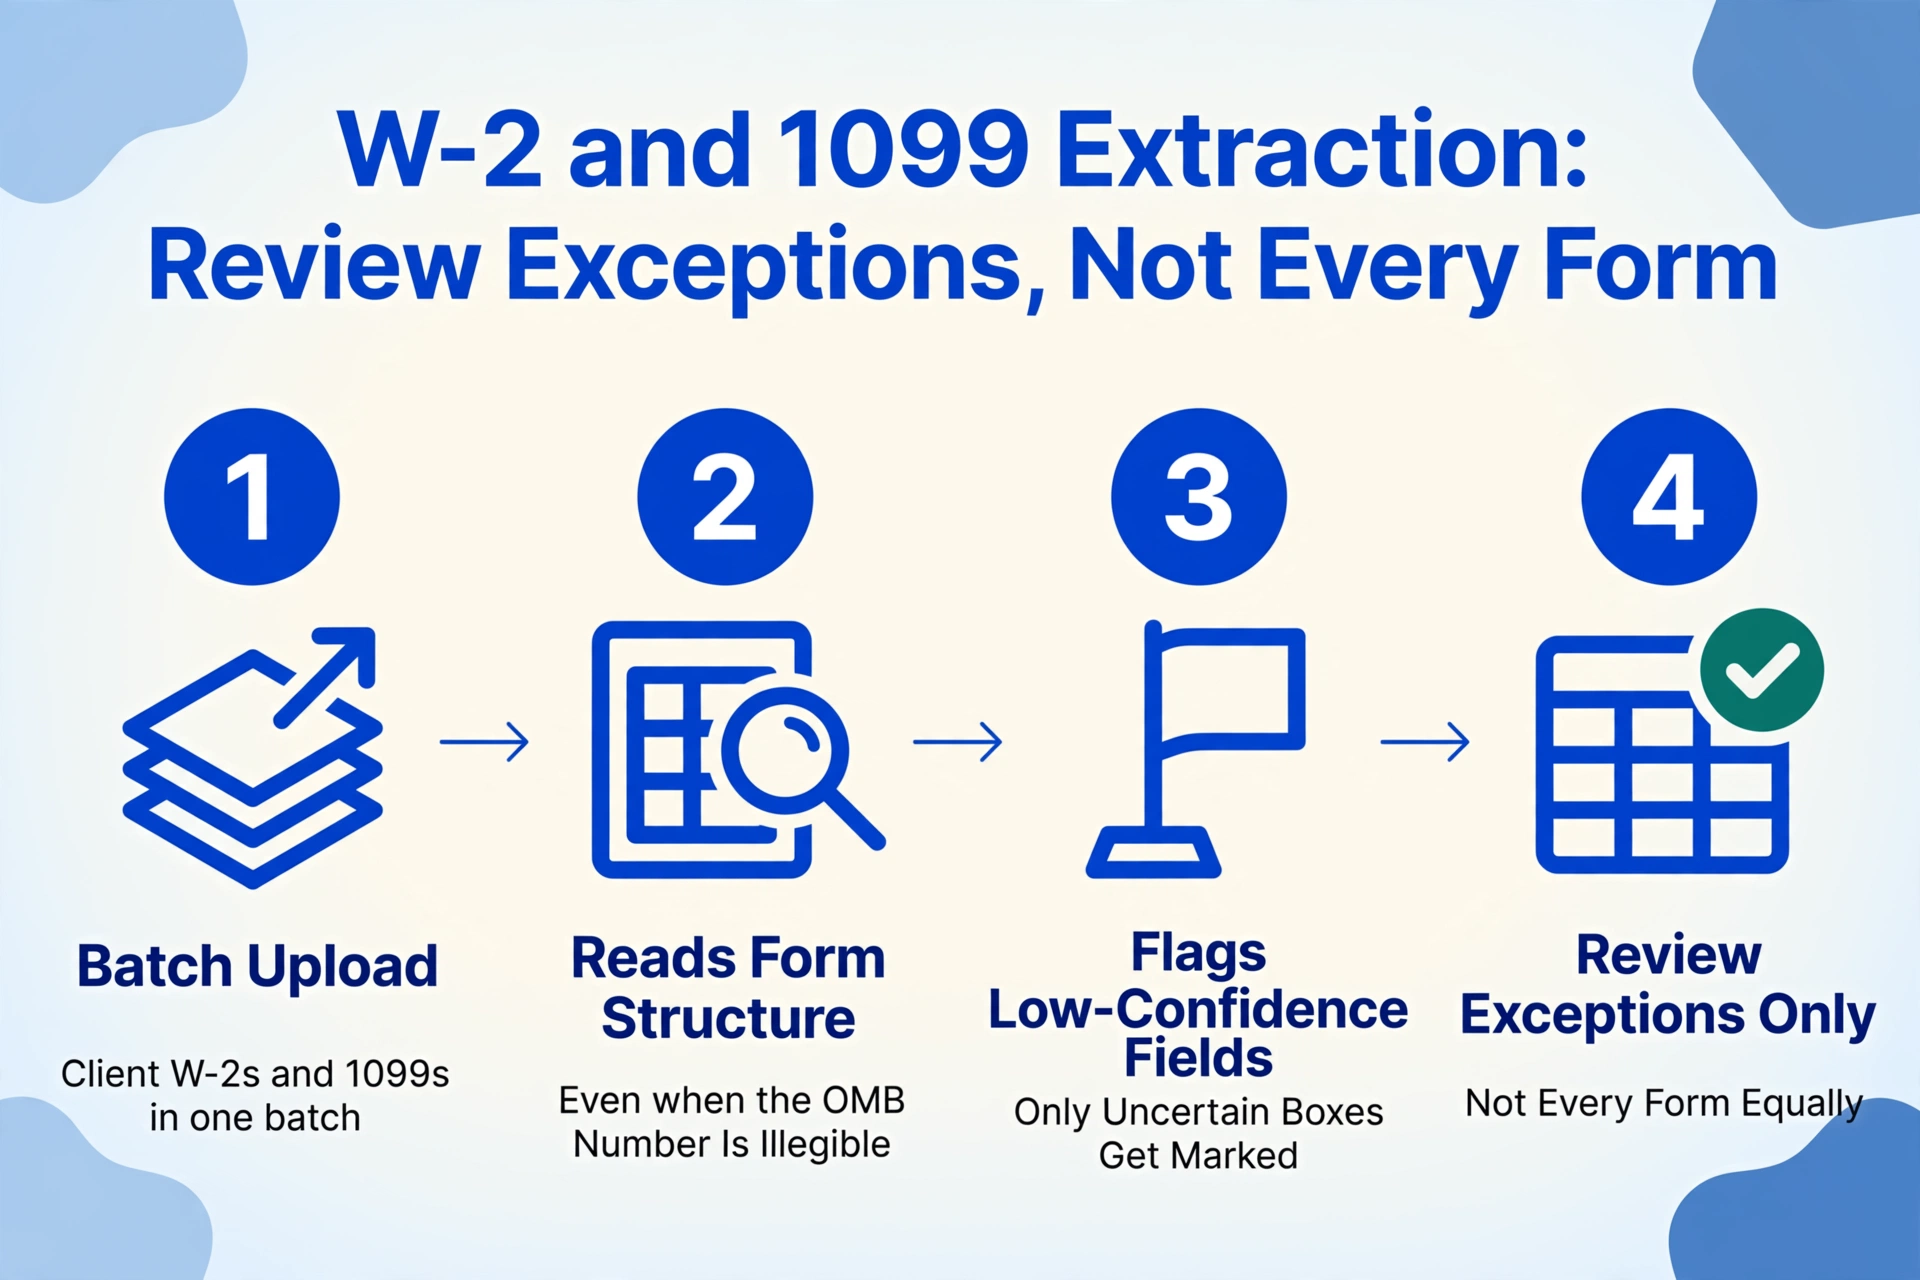
W-2フォームには14の欄別フィールドに加え、雇用者・従業員の識別データが含まれます。1099-NECおよび1099-MISCフォームは、支払者TIN、受取人TIN、フォームの種類ごとに異なる欄の割り当てという別の層を追加します。テンプレートベースのツールは、右上隅にあるIRSのOMBコントロール番号 — W-2なら1545-0008、1099-NECなら1545-0116、1040なら1545-0074 — を識別し、そのフォームレイアウトに固有の抽出ロジックを適用することで対応します。これはクリーンなデジタルPDFでは機能しますが、OMB番号が判読できないスキャンコピーや、識別子が光の反射で見えにくいフォームの写真では破綻します。
フォームの内容構造を読み取るAI抽出 — コントロール番号が見えるかどうかに関わらず、賃金・税務明細書のレイアウトを認識する — は、テンプレート識別が失敗したときのフォールバックを提供します。税務実務における実用的なワークフローは、クライアントのW-2と1099のバッチに対して抽出を実行し、スプレッドシートにエクスポートし、すべてのフォームを均等にではなく、AIが低信頼度としてフラグを立てたフォームにレビュー時間を費やすことです。これにより、会計士の役割は「欄番号の転記者」から「例外のレビュアー」へと移行します — まさに彼らの資格が発行された理由である役割です。
W-2および1099に特化した抽出手順については、1099からExcelへの抽出ガイドをご覧ください。IRSコンプライアンスの側面 — 安全な保管、アクセス制御、監査証跡 — は、会計士向けAIデータ入力バイヤーズガイドで詳しく扱っており、すべての処理段階でクライアントの税務情報をどのように扱うべきかを規定するCircular 230およびIRC §7216の要件も含まれています。
経費精算レポート:複合文書の問題
経費精算レポートは単一の文書タイプではありません。それは複合文書です。経費精算フォームまたはスプレッドシートに加え、裏付け資料となるレシートの束から成ります。抽出の課題は個々のレシートを読むこと — それは上述と同じレシートの問題です — ではなく、各レシートを正しいレポートの明細行に照合し、金額が一致することを検証することです。.
出張の典型的なクライアント経費精算レポートには、航空券の旅程($487)、ホテルの宿泊明細(4泊で$1,240)、5枚の食事の領収書(各$15~$85)、2枚のタクシー領収書、カンファレンス登録の請求書が含まれることがあります。会計士の仕事は、添付されたすべての領収書の合計がレポートに記載された合計と一致すること、各領収書が正しく分類されていること、複数のレポートにわたって重複した領収書が提出されていないことを確認することです。これは現在のAI抽出ツールが自動化していない種類の複数ドキュメントの相互参照であり、ほとんどの会計事務所が完全に自動化したくない種類の作業です。なぜなら、検証ステップこそが不正やエラーを発見する場所だからです。
AI抽出が経費精算レポート処理の負担を実際に軽減するのは、すべての領収書データを一貫した列(日付、業者、金額、カテゴリ)を持つ単一のスプレッドシートに抽出し、会計士や簿記担当者が50枚の個別の領収書画像をめくる代わりに、スプレッドシートで異常をスキャンできるようにする場合です。これにより、レビューステップが領収書1枚あたり3分から、フラグが立てられた異常1件あたり30秒に短縮され、人間の判断ステップをあるべき場所に保つことができます。
国際税務書類:P60、PAYG、T4
ほとんどのドキュメント抽出ガイドは米国の税務フォームで止まっています。国際的なクライアントを持つ会計事務所、または米国外に拠点を置く事務所は、クライアントが実際に作成する税務書類にまで及ぶカバレッジを必要としています。ここでは、最も一般的な非米国の雇用所得書類3つ、それぞれから抽出できるもの、そして注意すべき点を紹介します。
英国P60(年末証明書)。 各税年度の終了後(4月5日)に雇用主から従業員に発行されるP60は、その年の総支払額、控除された税金の総額、国民保険番号、最終税コード、雇用主の詳細をまとめたものです。抽出可能な主要フィールド:雇用主名とPAYE参照番号、従業員のNI番号、年間総支払額、控除税総額、最終税コード、法定給付(産休、育休、養子縁組)。主な課題:異なる給与計算プロバイダー(Sage、Xero、BrightPay、QuickBooks UK)のP60は、同じHMRC必須フィールドを含んでいても、若干異なるレイアウトを使用しています。フォーマット非依存の抽出は、プロバイダーごとの設定なしでこのばらつきに対応します。
オーストラリアPAYG支払概要書。 ほとんどの従業員にとってはSingle Touch Payroll(STP)の所得明細に置き換えられましたが、特定の状況では依然として発行されています。特に、請負業者やまだSTPに対応していない小規模雇用主の従業員の場合です。抽出可能な主要フィールド:支払者のABN、支払者名、受取人のTFN、総支払額、源泉徴収税総額、報告対象の福利厚生額、および種類コード(A~E)付きの一時金支払。米国の税務フォームを扱うほとんどの抽出ツールは、ATOのレイアウト規則を認識しません。オーストラリアの給与計算書類を処理する場合は、ツールを選定する前にカバレッジを確認してください。
カナダT4(報酬支払明細書)。 T4はカナダ版のW-2ですが、決定的な違いがあります。W-2の14ボックスではなく、最大85のCRAボックス番号を使用します。主要フィールドは、雇用所得(ボックス14)、CPP拠出金(ボックス16)、EI被保険所得(ボックス24)、RPP拠出金(ボックス20)、組合費(ボックス44)、および課税対象福利厚生と控除のための数十の他のコードに及びます。抽出の課題は数字を読み取ることではなく、正しいCRAボックスをTaxCycleやIntuit ProFileの正しいフィールドにマッピングすることです。そこではインポート形式の要件が厳密です。独自の列名を定義できるツール、たとえば「Box 14 Employment Income」や「Box 16 Employee CPP」をカスタム列として指定できるツールは、抽出後の列名変更なしで、税務ソフトウェアのインポートテンプレートに直接マッピングされる出力を生成します。カナダの税務明細抽出ワークフローの詳細な手順については、フォーム抽出ガイドをご覧ください。 — 同じカスタム列のアプローチは、すべての税務管轄区域で機能します。
抽出ツールの選定基準:会計士のためのフレームワーク
標準的なソフトウェア評価基準 — 価格、機能リスト、連携ロゴ — は、会計事務所として本当に知る必要があることを教えてくれません。以下は、抽出ツールが実際のクライアント書類に触れて生き残れるかを決める5つの要素です。
複数クライアントのバッチ分離
クライアントAの銀行明細15件とクライアントBの銀行明細8件を処理する場合、ファイルを事前にフォルダ分けしなくても、2つの別々のスプレッドシートが生成されるべきです。単一法人向けに作られたツールは、すべてのアップロードを1つのデータプールとして扱います。会計事務所向けに作られたツールなら、クライアントごとにバッチを命名し、バッチごとに結果をエクスポートできます。複数クライアントのワークフローに対応するツールの完全な比較については、会計事務所向け抽出ツールのまとめをご覧ください。
テンプレート設定可能性ではなく、フォーマット非依存
「強力なテンプレートビルダー」や「ゾーンOCR設定」を提供するツールは、自動化ではなくテンプレート保守作業を売り込んでいます。本当に意味のある機能はフォーマット非依存です。つまり、新しい取引先の請求書、新しい銀行の明細、新しい給与計算プロバイダーのフォームを、慣れた書類と同じ設定で処理できます。フィールドの位置を測定するのではなく、フィールドの意味を理解して書類を読み取るからです。これらのアプローチの技術的な違いについては、AI OCRと従来のOCRの説明をご覧ください。
再構築ではなく保存できるカスタム列テンプレート
飲食店クライアント向けに抽出する列(カテゴリ別の食材費、申告されたチップ、POS決済金額)は、建設業クライアント向けの列(ジョブコストコード、保留金、リーエン放棄証書)とは異なります。実務グレードのツールは、クライアントごとまたはエンゲージメント種類ごとに列テンプレートを保存するため、スタッフが毎月ゼロから抽出設定を再構築する必要がありません。
後続ツールが期待する形式での出力
QuickBooks Onlineは特定の列ヘッダーを持つCSVをインポートします。Drake Taxは特定のフィールドマッピングを想定しています。Xeroの一括インポートには特定の日付形式が必要です。抽出ツールは、会計ソフトのインポート形式に対応したExcelまたはCSV出力を生成する必要があります — 一致する列名、解析可能な日付形式、通貨記号のない数値フィールドを備えている必要があります。ツールが独自形式にしかエクスポートできない場合、あなデータ入力からデータ再フォーマットへと移行しました。
抽出だけでなく、ドキュメントの収集も
多くの会計事務所におけるボトルネックは、ドキュメントからのデータ抽出ではなく、そもそもクライアントからドキュメントを受け取ることです。コレクションリンク(クライアントがログイン不要で開き、ドキュメントを直接処理キューにアップロードできる共有リンク)を備えたツールは、この上流の問題を解決します。毎月の明細や経費の領収書を求めてメールやメッセージでクライアントを追いかける代わりに、1つのリンクを送るだけで全てが抽出パイプラインに流れ込みます。非営利団体のクライアントを担当する事務所向けに、この分野特有のコレクションリンク活用事例として寄付領収書データの抽出に関するガイドもご覧ください。
ドキュメント抽出を自動化する際のよくある落とし穴
ドキュメント抽出を導入した会計事務所は、少なくともこれらのうち1つに遭遇しています。事前に知っておくことで、苦労して学ぶ教訓を、ツールが最初のクライアントファイルに触れる前に確認できるチェックリストに変えられます。
落とし穴1:マルチフォーマット環境でテンプレートツールを購入する。テンプレートベースのOCRツールは「一度設定すれば永遠に使える」として販売されています。会計事務所にとって「一度」とは、取引先ごと、銀行ごと、クライアントごとを意味し、クライアントは銀行を変え、取引先は請求書フォーマットを変えるため、設定が終わることはありません。デモで3つのきれいなPDFに対して機能したツールも、4か月目にクライアントCがWells FargoからMercuryに切り替えて明細の列が反転すると壊れます。解決策はより優れたテンプレートツールを買うことではありません。テンプレートを使わないツールを買うことです。
落とし穴2:精度を単一の数値として扱う。「99%の精度」を謳うツールは、ベンチマークデータセット内のドキュメント(標準レイアウトで印刷されたテキストのきれいなPDF)でその数値を達成しています。同じツールでも、照明の悪いレストランで撮影された領収書では80%、ドットマトリクスプリンターを使う信用組合のスキャンした銀行明細では70%、手書きの余白メモでは50%の精度しか出ないかもしれません。重要なのはあなたの最悪のドキュメントでの精度であり、ベンダーの最高のドキュメントでの精度ではありません。どのツールを導入する前にでも、最も問題のある10ファイル——しわくちゃの領収書、FAXされたW-2、3ページにわたるレストランチェーンの請求書——で実行してください。ベンダーのデモのような見た目のファイルではなく。これが実践的な精度ガイドで解説している方法論です。
落とし穴3:収集を自動化する前に抽出を自動化する。抽出パイプラインが1時間に100件のドキュメントを処理できても、クライアントがそのドキュメントを送るのに2週間かかるなら、本当のボトルネックより下流のステップを加速しただけです。まず収集の問題を解決しましょう。クライアントのドキュメント提出方法を標準化し(メール添付ではなく単一のコレクションリンク)、提出期限を設定し、リマインダーを自動化します。抽出するものがないなら、抽出速度は何の意味もありません。
落とし穴4:レビュー工程を過度に自動化する。 IRS Circular 230のSection 10.22では、税務申告書を作成する際に相当の注意(デューデリジェンス)を払うことが求められています。これには入力データの正確性の検証も含まれます。抽出を自動化してもレビュー義務がなくなるわけではありません。すべてのデータポイントをレビューする義務が、例外をレビューする義務に変わるだけです。抽出データが元のドキュメント画像まで明確に追跡でき、信頼度の低いフィールドは人によるレビュー用にフラグが立てられ、それ以外は例外方式で検証されるようにワークフローを設計してください。「すべてをレビューする」ワークフローでは時間短縮の効果が損なわれます。「何もレビューしない」ワークフローはCircular 230に違反します。その中間、つまり例外による検証こそが、抽出ツールがCPA業務の中でその価値を発揮する場面です。
会計事務所向けの導入ロードマップ
会計事務所全体へのドキュメント抽出の展開は、重要度の高い順ではなく、件数とフォーマットの一貫性の順に従って進めるべきです。目的は、より難しいドキュメントを導入する前に、最も簡単なドキュメントでスタッフの自信とワークフローの習慣を築くことです。
フェーズ1:銀行・クレジットカード明細(1〜2か月目)。ここから始めるのは、明細は件数が多く、毎月決まったスケジュールで届き、銀行ごとのフォーマットの違いはあっても内部構造が一貫している(日付、摘要、金額の列を持つ時系列の取引行)ためです。明細のフォーマットが最も安定しているクライアントを3〜5社選び、1か月分の明細を処理します。抽出結果と手入力の精度を比較します。PDFの受領から照合可能な検証済みデータができるまで、エンドツーエンドで時間を計測します。フェーズ1の終わりには、スタッフが明細についてツールを信頼し、事務所として明確な時間短縮のベースラインを持っているべきです。
フェーズ2:仕入先請求書(2〜4か月目)。明細のワークフローが安定したら請求書を追加します。まずは既知の仕入先からの定期請求書 — すでに20種類のバリエーションを見ていて、データがどうあるべきかを把握しているもの — から始め、その後で新しい仕入先を導入します。クライアントごとに、よく使うGLコードやコストセンターの割り当てを含む列テンプレートを保存し、抽出結果が元帳構造に事前にマッピングされるようにします。非営利団体や特定の経費追跡が必要な組織については、テンプレート設計の例として寄付領収書の抽出ガイドをご覧ください。
フェーズ3:領収書・経費精算書(4〜6か月目)。領収書は写真の品質という変数を伴い、基本的なOCRでは提供できない分類機能が必要です。紙の領収書を撮影したものを導入する前に、まずデジタル領収書(Amazon、SaaSのサブスクリプション、電子請求書)から始めます。領収書の撮影方法についてクライアント向けガイド — 判読しやすく、平らで、十分な明るさ — を作成し、入力品質の問題が抽出パイプラインに到達する前に減らします。経費精算書については、先に領収書に対してAI抽出を実行し、その後にスプレッドシート出力を使って精算書の合計を検証します。逆ではありません。
フェーズ4:税務フォーム(7月〜10月の期間)。税務フォームは最も高い精度が求められ、誤りによる規制上の影響も最も深刻です。12月〜4月の繁忙期に税務フォーム抽出の展開を行わないでください。7月〜10月の期間を使って前年分のW-2と1099でテストし、フォームごとにAI抽出と手入力を比較し、実際の申告書が依存する前に例外レビューのワークフローを構築します。1月にW-2が届き始めるころには、スタッフはツールが確実に処理できるフォームと、完全な手動レビューが必要なフォームをすでに把握しているべきです。
タイミングの原則: 新しい抽出ワークフローは、税務申告期限の60日以内に導入しないでください。学習曲線——どのドキュメントがきれいに抽出でき、どれが人間による確認を必要とし、抽出が失敗したときにどうすべきか——は、導入初月においてツールが節約する以上のスタッフ時間を消費します。導入計画は、繁忙期ではなく申告シーズンの合間の閑散期に立ててください。
FAQ
AI抽出は手書きの領収書や余白のメモに対応できますか?
部分的に対応できます。ブロック体の手書き文字は約75~85%のフィールド精度で抽出されますが、筆記体や急いで書かれた手書き文字は50~70%に低下します。AIは判読可能なものを読み取ることができます。コーヒーの染みがついた色あせた感熱紙の領収書で人間が金額を読み取れない場合、AIも同様に読み取れません——そして、クライアントの確認なしにそのフィールドを信用すべきではありません。
傾いたページやドットマトリクス印刷のスキャンされた銀行明細書でも抽出は機能しますか?
はい、ただし条件付きです。AI抽出は、文字単位でスキャンするのではなくページ全体のレイアウトを認識するため、傾き、回転、低解像度のスキャンを従来のOCRよりも適切に処理します。ただし、5年以上黄色く変色した紙へのドットマトリクス印刷は低コントラストのテキストを生み、あらゆる抽出システムの精度を低下させます。これらのドキュメントは、使用するツールに関係なく、人間による確認のためにフラグを立てるべきです。
AI処理中、クライアントの財務データは安全ですか?
これはツールのアーキテクチャによります。一部のツールは、モデルトレーニングのためにデータを保持するサードパーティのAI APIを通じてドキュメントを送信します——データにクライアントの税務情報が含まれる場合、IRC §7216上の懸念となり得ます。その他のツールは、トレーニング目的でのデータ保持を行わない自社インフラを通じてドキュメントを処理します。クライアントのドキュメントをアップロードする前に、ツールのデータ処理ポリシーをWISP要件と照らし合わせて確認してください。最低限:アップロードされたドキュメントがモデルトレーニングに使用されないこと、処理が転送中に暗号化されること、ドキュメントが定義された保持期間後に自動削除されることを確認してください。
クライアントごとにモデルをトレーニングする必要がありますか、それとも1つの設定で全員に対応できますか?
テンプレートベースのツールでは、実質的にクライアントごと——あるいはベンダーごと、銀行ごと、フォームタイプごと——にトレーニングすることになります。新しいドキュメントレイアウトごとに新しいテンプレートが必要だからです。フォーマット非依存のAI抽出では、必要な列(日付、説明、金額、カテゴリ)を一度定義すれば、同じ設定で任意のクライアント、任意の銀行、任意のベンダーのドキュメントを処理できます。クライアントごとのトレーニングも、ベンダーごとのテンプレート構築も不要です。これは、複数クライアントを扱う実務でツールを購入する前に確認すべき、最も重要なアーキテクチャ上の問いです。
AI抽出はQuickBooksやXeroとどのように連携しますか?
AI抽出ツールはExcelまたはCSV形式で構造化データを生成します——DextやHubdocのように取引をQuickBooksやXeroに直接転記するものではありません。ワークフローは:AIがデータを抽出 → スプレッドシート出力を確認 → ソフトウェアの一括インポート機能を使ってQuickBooks/Xeroにインポート、という流れです。これにより台帳に入るものを完全に管理できますが、インポート手順が必要になります。スプレッドシートを介さずに直接台帳へ転記したい場合は、DextやVeryfiのような簿記連携のキャプチャツールがその用途に適しています——ただし、これらのツールはドキュメントタイプや分類ルールについて独自の前提があります。AI抽出ツールはあらゆるドキュメントに柔軟に対応しますが、インポート手順はあなたに委ねられます。どちらのアーキテクチャも普遍的に優れているわけではなく、異なるワークフローに適しています。選択肢の比較はこちらをご覧ください 会計事務所向けツールまとめ。
AIがフィールドを間違えた場合、どうやって見つけますか?
最も効果的な検証ワークフローは、フィールドごとの確認ではなく例外レビューです。抽出後:(1) データがあるべきなのに空欄のフィールドを探す — これらは明らかな抽出失敗です。(2) 計算列をソースドキュメントと照合する(例:計算された期末残高が記載された期末残高と一致するか?)。(3) 金額で並べ替え、上位と下位の5件を検証する — 最大の取引は誤りがあった場合のリスクが最も大きいです。この3ステップのレビューで、バッチあたり5分未満で抽出エラーの大部分を捕捉できます。フィールドごとの検証では20分以上かかります。レビューを完全に省略しないでください — Circular 230のデューデリジェンス義務は、手作業と同じようにAI支援作業にも適用されます。
多通貨の請求書や国際税務フォームに対応できますか?
多通貨の認識は可能です — AI抽出は通貨記号($、€、£、¥)を識別し、抽出データに保持できますが、抽出ツールは為替計算を行わないため、通貨換算は別途処理する必要があります。国際税務フォーム(英国P60、オーストラリアPAYG、カナダT4)については、ツールによる対応範囲が大きく異なります。米国市場向けに最適化されたほとんどのツールは、米国以外のフォームレイアウトを認識しません。購入前に国際フォーム対応を明示的に確認してください — 「税務フォーム対応」が米国のW-2/1099以外を意味すると仮定しないでください。CRAのボックス番号やHMRCのフィールド名で独自の列を定義できるツールは、組み込みのフォーム認識がなくても国際フォームで機能します。AIはテンプレートの照合ではなく、意味によってフォームの内容を読み取るからです。
会計事務所がデータ入力に費やす時間は、事務所を実際に成長させる分析、アドバイザリー、顧客関係に費やせない時間です。ドキュメント抽出はコストを削減するだけでなく、請求可能な時間を転記作業から専門知識作業へと変換します。これはCPAライセンスが本来目的とした唯一の作業です。ツールは第一歩にすぎません。どの顧客を受け入れるか、どのサービスを拡大するか、どのドキュメントタイプを手作業で行うのをやめるかという事務所の判断こそが、その投資を回収するステップです。