회계사를 위한 AI 문서 데이터 추출 가이드
무엇을 먼저 자동화할까
회계사에게 처리할 문서가 부족한 것은 아닙니다. 평균 10인 규모 사무소는 매달 30개 금융기관의 은행 명세서, 200개 공급업체의 인보이스, 15가지 방향으로 촬영된 영수증, 40명 직원의 W-2와 1099, 문자·이메일·구겨진 종이로 모인 경비 보고서를 처리합니다. 회계사에게 부족한 것은 이 문서들을 주당 30시간의 청구 가능 시간을 잡아먹지 않으면서 구조화된 데이터로 바꾸는 방법입니다. 이 가이드는 회계 사무소가 마주치는 모든 주요 문서 유형, 각 문서에서 추출 가능한 항목, 여전히 사람의 판단이 필요한 부분, 그리고 세무 시즌 사이에 맞출 수 있는 도입 경로를 다룹니다.
핵심 요약
- 세무 준비 시간의 60%는 판단이나 고객 자문에 쓰이지 않습니다. 데이터 추출과 수정에 쓰이며, 평균 10인 사무소에서 주당 30시간의 청구 가능 시간을 소모합니다.
- 템플릿 기반 추출 도구는 고객 30곳이 사용하는 모든 공급업체와 은행마다 새 템플릿이 필요합니다. 또한 명세서에서 열이 조용히 밀리면 출력은 맞아 보이지만 조정 전까지 금액이 틀립니다.
- 추출이 형식 독립적으로 바뀌면 — 필드가 어디에 있는지가 아니라 무엇을 의미하는지로 읽으면 — 업무는 데이터 입력 작업자에서 예외 검토자로 전환됩니다. CPA 라이선스가 발급된 이유인 유일한 업무입니다.
회계사에게 문서 추출이 필요한 이유: 수치로 본 근거
PWC의 세무 컴플라이언스 워크플로 연구에 따르면 세금 신고서 준비에 소요되는 시간의 60%는 데이터 추출, 정제, 분석에 소비되며, 전문적 판단, 리스크 평가, 고객 자문에 쓰이지 않습니다. 또 다른 10%는 내부 행정에 할애됩니다. 즉 세무 전문가의 시간 중 약 30%만이 실제로 CPA 자격이 필요한 업무에 쓰이는 셈입니다. 시간당 $200–400를 청구하는 사무소라면, 그 추출 시간의 절반만 자문 시간으로 전환해도 어떤 인력 채용으로도 따라잡을 수 없는 매출 변화가 발생합니다.
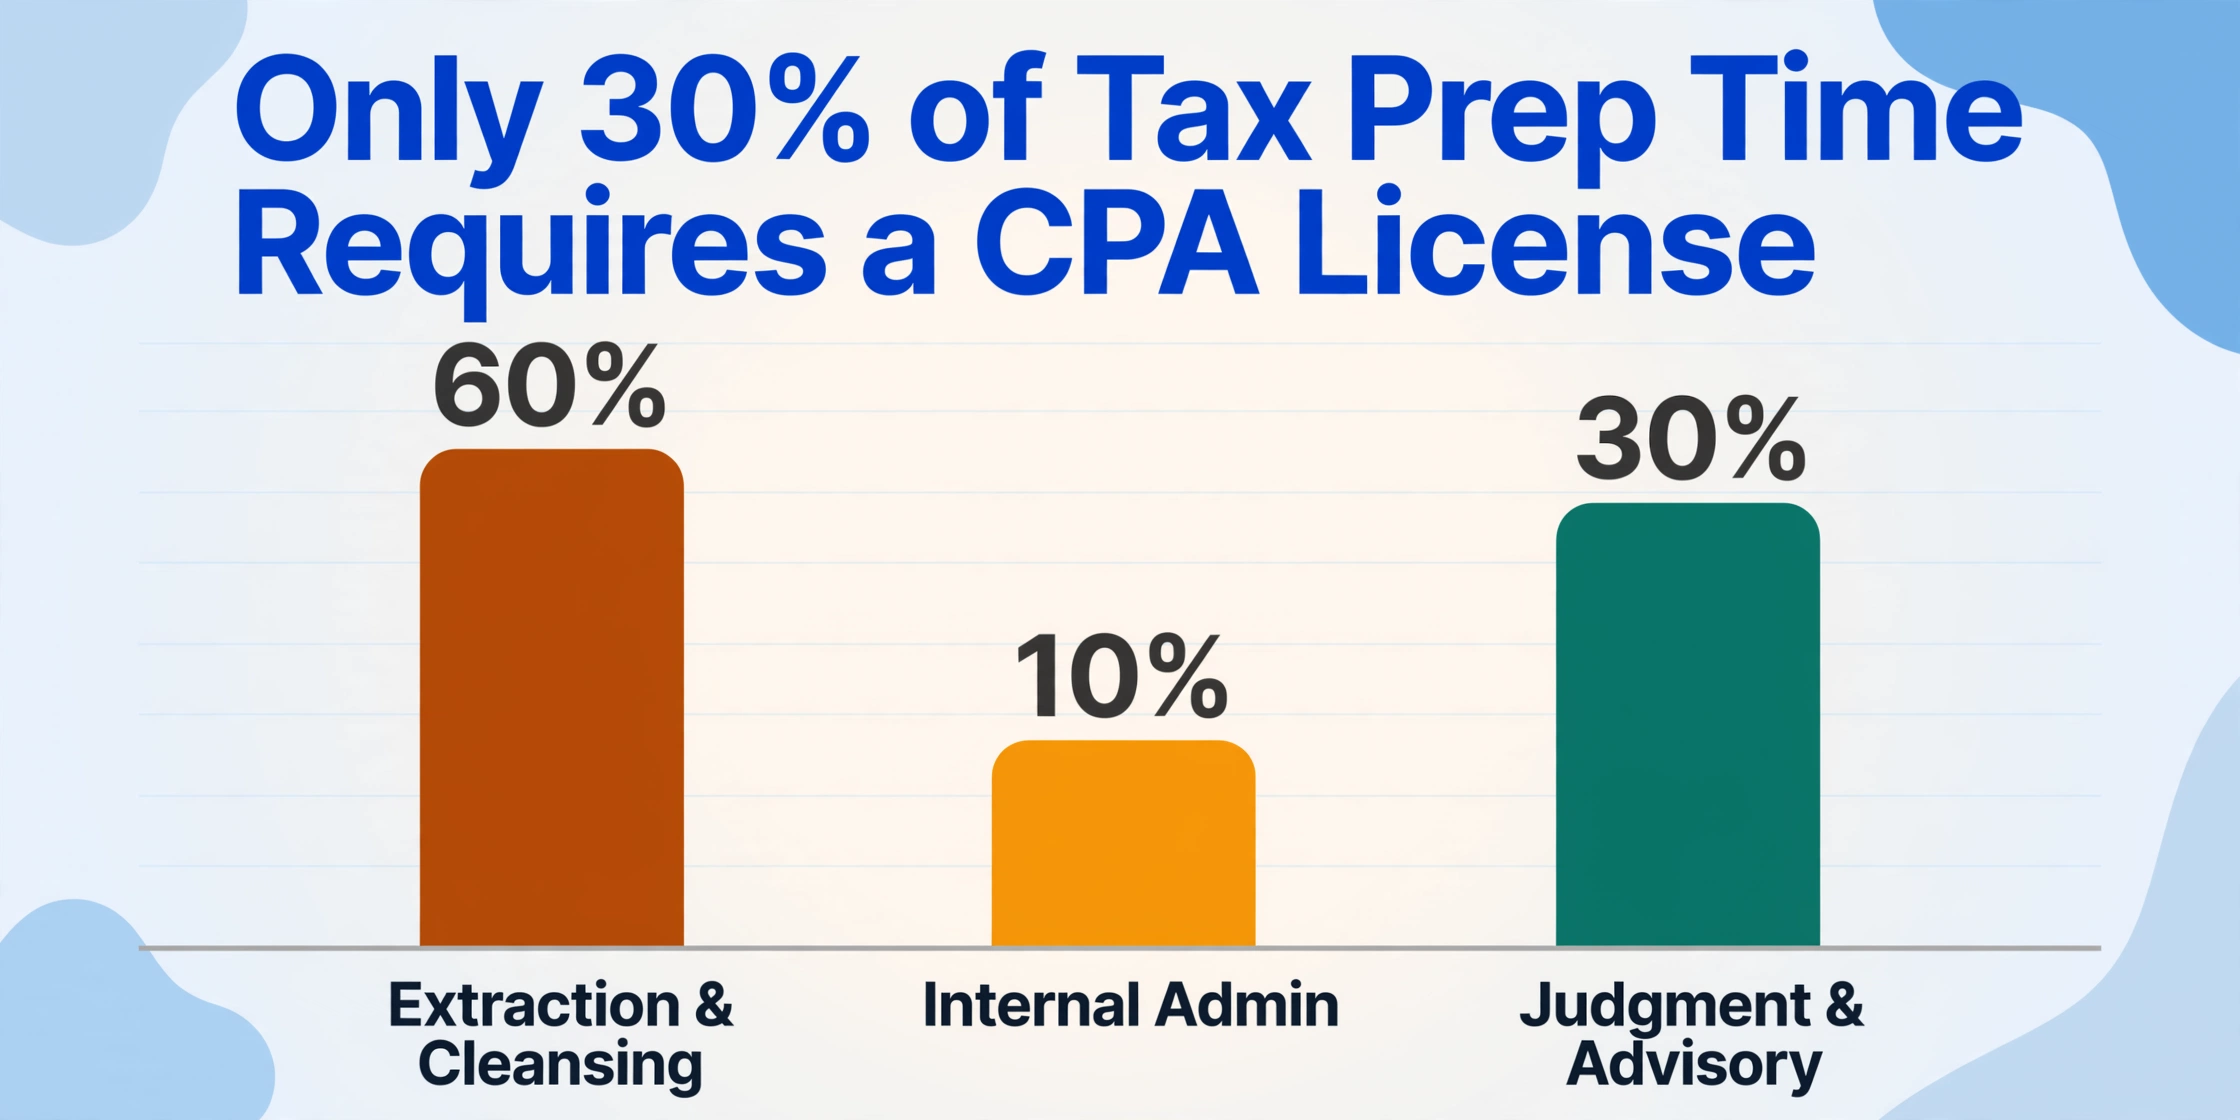
대부분의 회계 사무소가 놓치는 구조적 통찰: 수동 데이터 입력은 단순히 타이핑에 드는 시간만 비용이 아닙니다. 그 이후의 정리 시간도 비용입니다. 입력 중 발생하는 모든 오류 — APQC 재무 벤치마크 기준 100개 필드당 2~5건 — 는 반드시 발견하고 수정해야 하며, $47,000 청구서에서 자릿수가 뒤바뀐 숫자를 찾아내는 데는 처음부터 올바르게 입력하는 것보다 더 오랜 시간이 걸립니다.
출력 측면에서 AI 기반 추출은 단일 페이지를 5~10초에 처리하며, 이는 수동 입력보다 약 18배 빠른 속도이고 인쇄 텍스트에 대한 필드 수준 정확도는 일관되게 97%를 초과합니다. 여기서의 트레이드오프는 속도 대 정확성이 아닙니다. 속도 와 정확성 대 매달 사흘씩 같은 팀이 데이터 입력을 하는 것의 트레이드오프입니다. 미국 노동통계국은 부기 관련 고용이 2023년부터 2033년까지 약 5% 감소할 것으로 전망하며, 그 원인을 데이터 입력 업무의 소프트웨어 기반 자동화로 돌립니다. 이는 시장이 사무소의 결정을 기다리지 않는다는 신호입니다.
그러나 "문서 추출"은 하나의 문제가 아닙니다. 은행 명세서, 청구서, 영수증, W-2, 경비 보고서, 영국 P60은 각각 근본적으로 다른 추출 과제를 제시하기 때문에, 같은 이름을 쓴 여섯 가지 문제입니다. 이 가이드의 나머지 부분에서는 각각을 하나씩 살펴봅니다 — 무엇을 추출할 수 있는지, 무엇이 어려운지, 얼마나 많은 시간을 회수할 수 있을지, 그리고 인간의 판단이 반드시 필요한 지점은 어디인지. 문서 추출 기술 자체가 처음이라면 OCR 작동 방식 설명과 회계 워크플로에 미치는 의미부터 시작한 뒤, 여기로 돌아와 문서 유형별 분석을 확인하십시오.
인보이스: 추출의 기준선
인보이스는 회계에서 가장 흔히 자동화되는 문서 유형이며, AI 추출이 템플릿 기반 도구보다 확실한 우위를 보이는 분야입니다. 일반적인 공급업체 인보이스에는 8~15개의 구조화된 필드가 포함됩니다: 공급업체명, 인보이스 번호, 날짜, 지불 기한, PO 번호, 설명과 수량이 포함된 품목, 소계, 세액, 배송비, 합계. 잘 알려진 공급업체의 깔끔한 PDF에서는 기존 템플릿 OCR이 안정적으로 작동합니다. 문제는 "잘 알려진 공급업체"라는 부분입니다.
고객 지급 계정을 처리하는 회계 법인은 5개 공급업체로부터 인보이스를 받지 않습니다. 30개 고객사가 거래하는 모든 공급업체로부터 인보이스를 받습니다 — Amazon Business, Home Depot, 손으로 쓴 청구서를 보내는 지역 전기 기술자, 이메일 PDF로 오는 SaaS 구독, 다중 통화 품목을 가진 해외 공급업체까지. 새로운 공급업체마다 새로운 레이아웃이 생기고, 템플릿 기반 도구는 각 레이아웃을 새로운 설정 프로젝트로 취급합니다. 각 필드가 페이지 어디에 있는지 외우는 대신 각 필드의 의미를 이해하여 문서를 읽는 AI 기반 추출은 새로운 공급업체의 인보이스를 익숙한 공급업체와 동일한 설정으로 처리합니다.
대량 배치에서 이것이 어떻게 작동하는지 더 자세히 알아보려면 배치 인보이스 처리 가이드를 참조하십시오. 회계사에게 중요한 점: 인보이스 추출은 성공을 "공급업체 A의 인보이스에서 몇 개의 필드를 정확히 추출하는가"가 아니라 "추출 설정을 건드리지 않고 몇 개의 새로운 공급업체를 온보딩할 수 있는가"로 측정해야 하는 문서 유형입니다.
은행 명세서: 조정의 병목
은행 명세서는 대부분의 회계 실무에서 가장 많은 양의 문서 유형이며, 형식 다양성이 가장 크게 영향을 미치는 분야입니다. 30개 고객사를 둔 법인은 Chase, Wells Fargo, Bank of America, 지역 신용 조합, Mercury와 Relay 같은 온라인 은행, Revolut 같은 해외 기관으로부터 매월 명세서를 받을 수 있으며, 각기 다른 열 레이아웃, 날짜 형식, 거래 그룹화 관례를 가지고 있습니다.
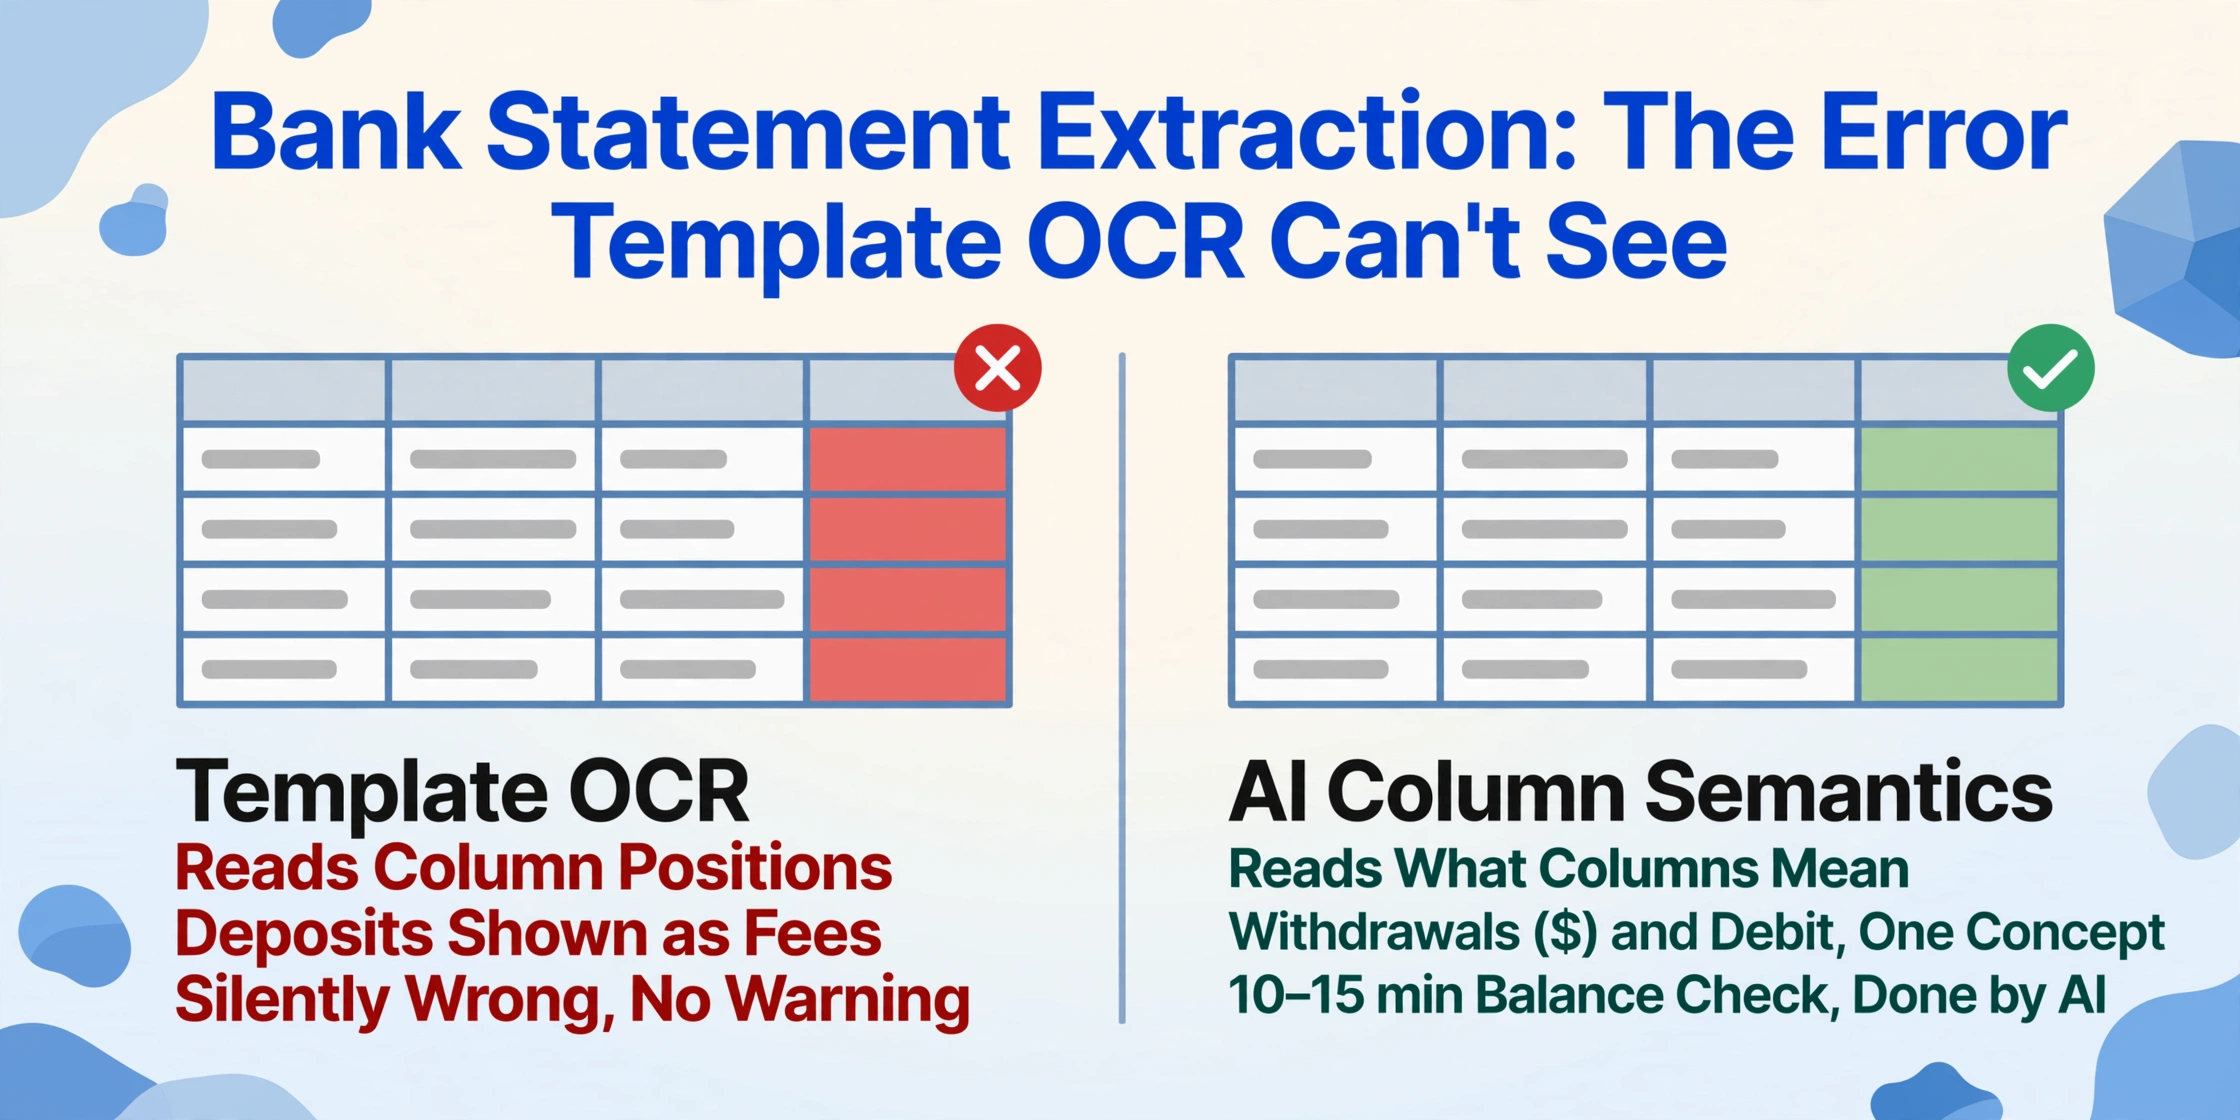
템플릿 기반 도구는 이러한 다양성에 어려움을 겪습니다: Chase 명세서용으로 만든 템플릿은 출금과 입금을 단일 거래 금액 열 대신 별도 열로 나누는 Wells Fargo PDF에서 조용히 오작동합니다. 추출된 데이터는 맞아 보입니다 — 숫자가 올바른 열에 있습니다 — 하지만 신용카드 결제가 출금으로 표시되고 입금이 수수료로 표시됩니다. 기존 OCR은 위치를 읽지 의미를 읽지 않기 때문에 이런 오류를 범했다는 것을 알 방법이 없습니다.
열 의미를 이해하는 AI 추출 — "Withdrawals ($)"와 "Debit"이 다르게 표현된 같은 개념임을 인식하는 — 은 이러한 종류의 오류를 완전히 제거합니다. 특히 은행 명세서의 경우 가장 가치 있는 AI 기능은 추출 속도가 아니라 계산 열 검증입니다: AI는 기초 잔액에 출금을 더하고 입금을 빼서 기말 잔액을 계산하고, 명세서에 기재된 기말 잔액과 비교하여 불일치를 표시할 수 있습니다 — 일반적으로 명세서당 사람이 10~15분 걸리는 조정 단계입니다. 전체 워크플로우를 살펴보려면 은행 명세서를 Excel로 변환 가이드를 참조하십시오.
시간 절약 벤치마크: 12페이지 분량의 월간 사업용 은행 명세서는 일반적으로 회계사가 헤더 정보를 수동 입력하고 잔액을 표본 점검하는 데 15~20분이 걸립니다. AI 추출은 60초 이내에 처리하며, 계산된 잔액 검증이 수동 표본 점검을 완전히 대체합니다. 30명의 고객 × 12개월 기준으로, 이는 명세서 입력만으로 연간 약 90시간을 회복하는 셈입니다 — 이로 인해 예방되는 조정 오류는 계산하기 전입니다.
영수증: 사진 문제
영수증은 입력 품질 — 추출 기술이 아닌 — 이 결정적 제약이 되는 문서 유형입니다. Amazon 또는 SaaS 플랫폼의 깨끗한 디지털 영수증은 거의 완벽한 정확도로 추출됩니다. 구겨진 감열지 식당 영수증을 노란 조명 아래 비스듬히 촬영한 사진 — 잉크가 흐릿하고 커피 얼룩이 있는, 고객이 실제로 보내는 바로 그런 사진 — 은 전혀 다른 문제입니다.
영수증의 추출 한계는 AI가 이론적으로 읽을 수 있는 것이 아니라 사진에서 판독 가능한 것에 의해 결정됩니다. 이미지를 눈을 가늘게 뜨고 보는 사람도 팁 줄이 $8.00인지 $8.80인지 구분할 수 없다면, AI도 마찬가지이며 — 검증 없이 신뢰해서도 안 됩니다.
AI 추출이 기본 OCR을 넘어 영수증 처리에 추가하는 것은 분류입니다. 대부분의 영수증에는 지출 카테고리가 인쇄되어 있지 않습니다. 식당 영수증에는 "Table 12, Server: Maria, $54.30"이라고 적혀 있을 뿐 "Meals & Entertainment"라고 적혀 있지 않습니다. 추론 열 기능을 갖춘 AI는 가맹점 이름과 구매 맥락을 읽고 카테고리를 지정할 수 있습니다. 식당에는 "Meals", 호텔에는 "Travel", Staples에는 "Office Supplies"를 지정합니다. 회계사나 부기 담당자가 각 영수증을 계정과목표와 대조하며 수동으로 수행하는 이 분류 단계는 영수증당 보통 30~60초가 추가됩니다. 고객 전체에 걸쳐 월 200건의 영수증이라면 분류만으로 2시간 이상이 절약됩니다.
단계별 워크플로는 영수증에서 Excel 추출 가이드를 참조하십시오. 원하는 필드 이름을 입력하면 AI가 페이지상의 위치가 아니라 의미를 기준으로 각 값을 찾아내는 맞춤 열 추출이 템플릿 기반 도구를 무너뜨리는 영수증 형식의 다양성을 어떻게 처리하는지도 포함되어 있습니다.
W-2 및 1099 세금 양식: 위험 부담이 큰 추출
세금 양식은 정확성이 법적 결과를 초래하는 문서 유형입니다. 잘못 분류된 인보이스 금액은 월말 마감 시 발견하게 되는 조정 오류를 만듭니다. 잘못 입력된 W-2 Box 1 임금 금액이나 1099-NEC 비근로자 보상 금액은 IRS 통지를 촉발하는 신고 오류를 만들며, 어느 회계사도 하고 싶지 않은 고객과의 대화로 이어질 수 있습니다.
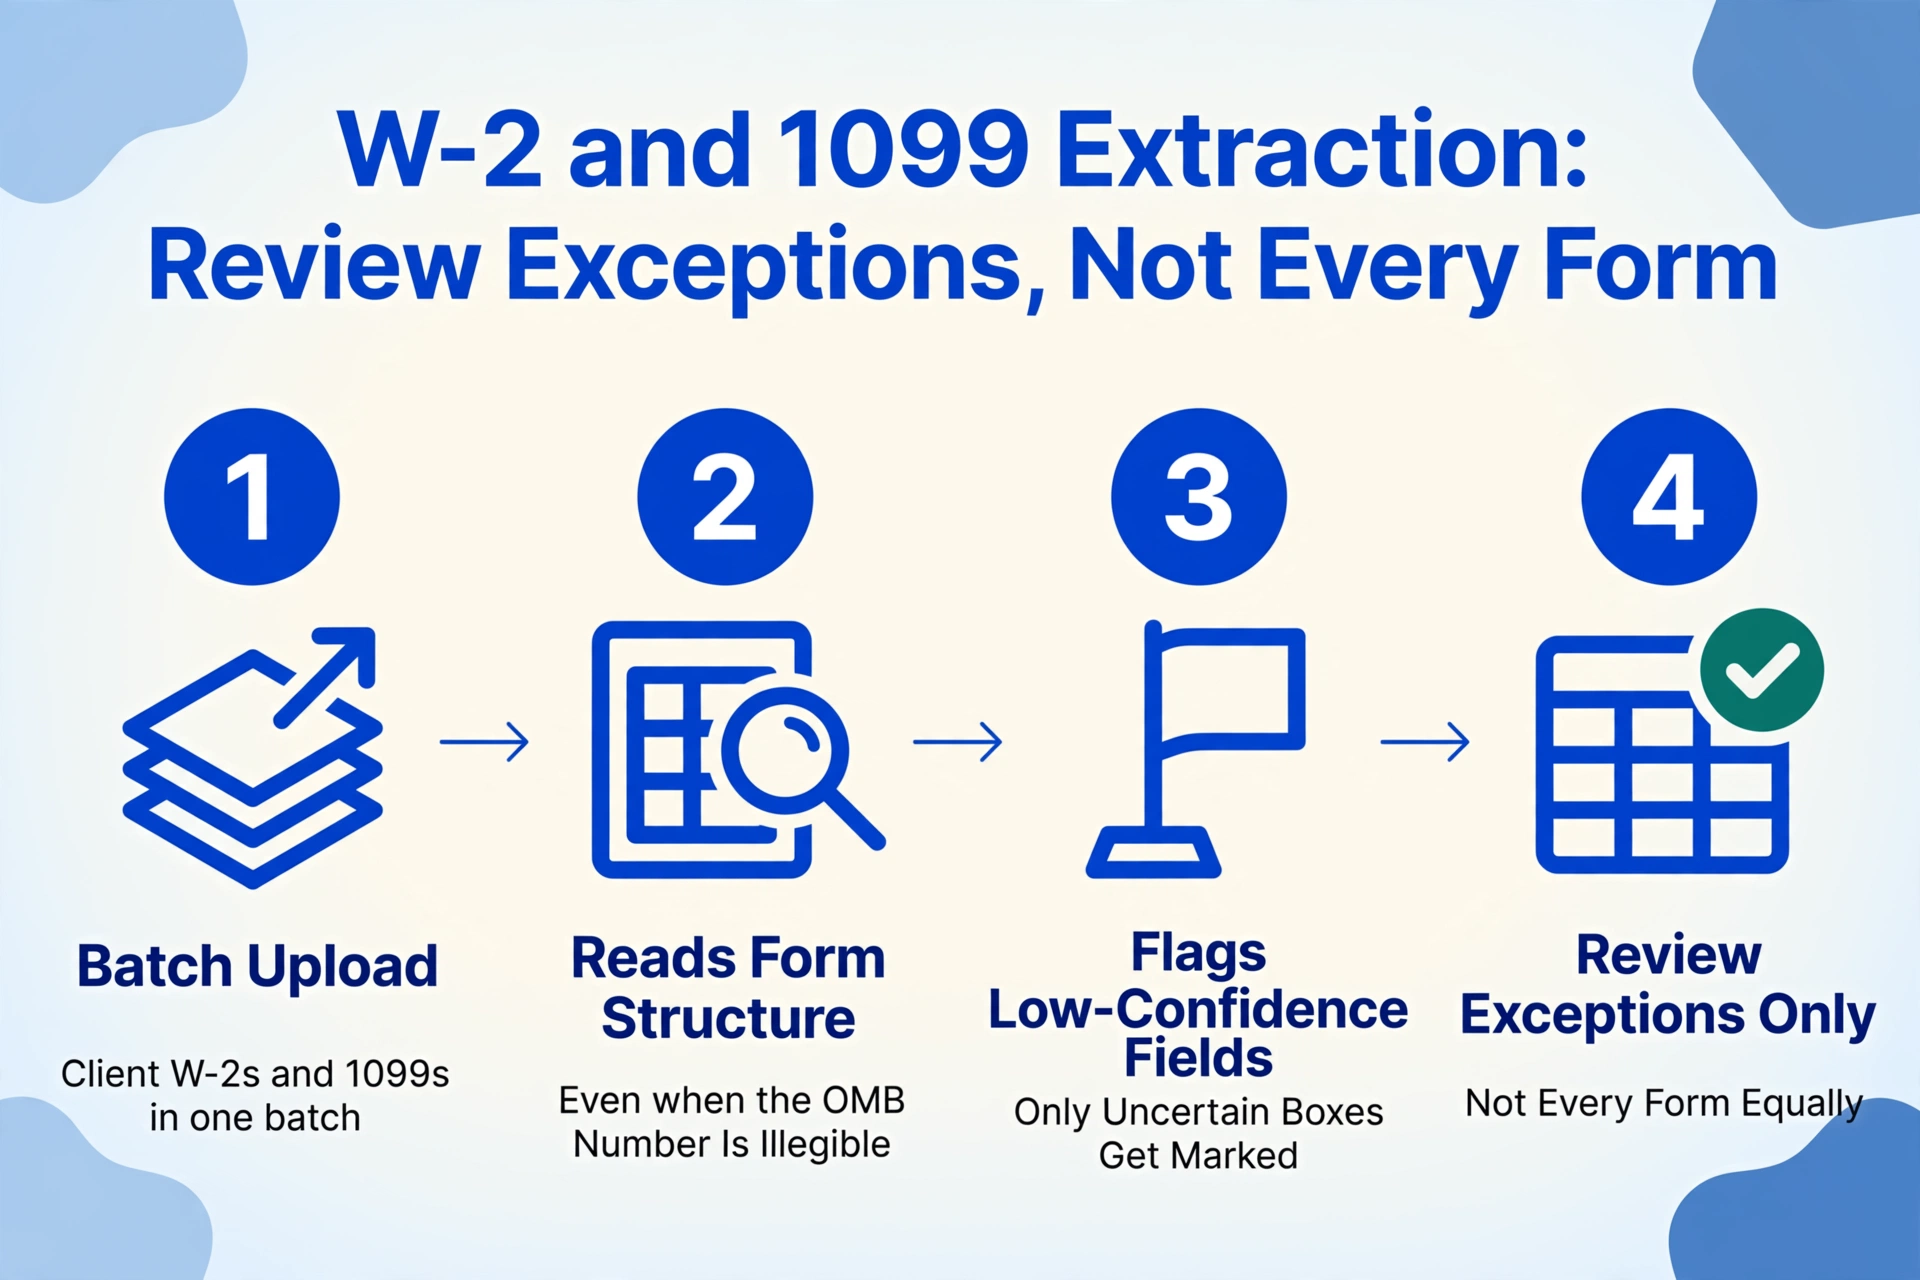
W-2 양식에는 14개의 박스 필드와 고용주/근로자 식별 데이터가 포함됩니다. 1099-NEC 및 1099-MISC 양식은 지급자 TIN, 수령자 TIN, 양식 변형별로 달라지는 박스 배정이라는 또 다른 층을 추가합니다. 템플릿 기반 도구는 우측 상단 모서리의 IRS OMB 통제 번호(W-2는 1545-0008, 1099-NEC는 1545-0116, 1040은 1545-0074)를 식별하고 해당 양식 레이아웃에 특화된 추출 로직을 적용하여 이를 처리합니다. 이는 깨끗한 디지털 PDF에서는 작동하지만 OMB 번호를 읽을 수 없는 스캔본이나 식별자를 가리는 반사광이 있는 양식 사진에서는 무너집니다.
통제 번호가 보이는지 여부와 관계없이 양식의 콘텐츠 구조를 읽어 임금 및 세금 명세서 레이아웃을 인식하는 AI 추출은 템플릿 식별이 실패할 때 대체 수단을 제공합니다. 세무 실무의 실용적인 워크플로는 고객 W-2 및 1099 배치에 추출을 실행하고, 스프레드시트로 내보낸 뒤, 모든 양식에 똑같이 시간을 쓰는 대신 AI가 낮은 신뢰도로 표시한 양식에 검토 시간을 쓰는 것입니다. 이는 회계사의 역할을 "박스 번호 입력자"에서 "예외 검토자"로 전환합니다. 바로 그들이 면허를 받은 역할입니다.
W-2 및 1099 전용 추출 워크플로는 1099에서 Excel 추출 가이드를 참조하십시오. IRS 규정 준수 측면(안전한 보관, 접근 제어, 감사 추적)은 모든 처리 단계에서 고객 세금 정보를 어떻게 취급해야 하는지 규정하는 Circular 230 및 IRC §7216 요건을 포함하여 회계사를 위한 AI 데이터 입력 구매 가이드에서 자세히 다룹니다.
경비 보고서: 복합 문서 문제
경비 보고서는 단일 문서 유형이 아닙니다. 이는 복합 문서로, 경비 보고서 양식이나 스프레드시트에 증빙 자료 역할을 하는 영수증 더미가 함께 있는 것입니다. 추출 과제는 개별 영수증을 읽는 것(위에서 설명한 것과 동일한 영수증 문제)이 아니라 각 영수증을 올바른 보고서 항목에 매칭하고 금액이 일치하는지 확인하는 것.
출장을 위한 일반적인 고객 경비 보고서에는 항공권 일정($487), 호텔 청구서(4박 $1,240), 식사 영수증 5장(각 $15–$85), 택시 영수증 2장, 컨퍼런스 등록 인보이스가 포함될 수 있습니다. 회계사의 업무는 첨부된 모든 영수증의 합계가 보고서에 청구된 총액과 일치하는지, 각 영수증이 올바르게 분류되었는지, 여러 보고서에 걸쳐 중복 영수증이 제출되지 않았는지 확인하는 것입니다. 이는 현재 AI 추출 도구가 자동화하지 않는 다중 문서 교차 참조 유형이며, 대부분의 회계 법인이 완전 자동화를 원하지 않는 유형입니다. 검증 단계에서 사기와 오류가 적발되기 때문입니다.
AI 추출이 경비 보고서 처리 부담을 실제로 줄이는 부분: 모든 영수증 데이터를 일관된 열(날짜, 가맹점, 금액, 카테고리)이 있는 단일 스프레드시트로 추출한 다음, 회계사나 부기 담당자가 50개의 개별 영수증 이미지를 넘겨보는 대신 스프레드시트에서 이상 징후를 스캔하도록 하는 것입니다. 이는 검토 단계를 영수증당 3분에서 플래그된 이상 징후당 30초로 단축하고, 인간의 판단 단계를 마땅히 있어야 할 곳에 유지합니다.
국제 세무 문서: P60, PAYG, T4
대부분의 문서 추출 가이드는 미국 세무 양식에서 멈춥니다. 국제 고객을 둔 회계 사무소나 미국 외에 기반을 둔 법인은 고객이 실제로 생성하는 세무 문서까지 포괄하는 범위가 필요합니다. 다음은 가장 흔한 비미국 고용 소득 문서 세 가지와 각 문서에서 추출할 수 있는 항목, 주의할 점입니다.
영국 P60(연말 증명서). 각 세무 연도 종료 후(4월 5일) 고용주가 직원에게 발급하는 P60은 해당 연도의 총 급여, 총 공제 세액, National Insurance 번호, 최종 세금 코드, 고용주 정보를 요약합니다. 주요 추출 가능 필드: 고용주 이름 및 PAYE 참조 번호, 직원 NI 번호, 연간 총 급여, 총 공제 세액, 최종 세금 코드, 법정 지급금(출산, 육아, 입양). 주요 과제: 다양한 급여 제공업체(Sage, Xero, BrightPay, QuickBooks UK)의 P60은 동일한 HMRC 필수 필드를 포함하지만 레이아웃이 약간씩 다릅니다. 형식 독립적 추출은 제공업체별 구성 없이 이러한 차이를 처리합니다.
호주 PAYG 지급 명세서. 대부분의 직원에게는 Single Touch Payroll(STP) 소득 명세서로 대체되었지만 일부 상황에서는 여전히 발급됩니다. 특히 계약자와 아직 STP를 도입하지 않은 소규모 고용주의 직원에게 해당합니다. 주요 추출 가능 필드: 지급인 ABN, 지급인 이름, 수령인 TFN, 총 지급액, 총 원천징수 세액, 보고 대상 부가 혜택 금액, 유형 코드(A~E)가 있는 일시금 지급액. 미국 세무 양식을 처리하는 대부분의 추출 도구는 ATO의 레이아웃 관례를 인식하지 못합니다. 호주 급여 문서를 처리한다면 도구를 선택하기 전에 지원 범위를 확인하십시오.
캐나다 T4(보수 지급 명세서). T4는 캐나다의 W-2에 해당하지만 중요한 차이가 있습니다. W-2의 14개 대신 최대 85개의 CRA 박스 번호를 사용합니다. 주요 필드는 고용 소득(Box 14), CPP 기여금(Box 16), EI 보험 가능 소득(Box 24), RPP 기여금(Box 20), 노조비(Box 44), 그리고 과세 혜택 및 공제를 위한 수십 개의 기타 코드에 걸쳐 있습니다. 추출 과제는 숫자를 읽는 것이 아니라 올바른 CRA 박스를 TaxCycle 또는 Intuit ProFile의 올바른 필드에 매핑하는 것입니다. 여기서 가져오기 형식 요구 사항이 정확합니다. 예를 들어 "Box 14 Employment Income"과 "Box 16 Employee CPP"를 맞춤 열로 지정하는 등 자신만의 열 이름을 정의할 수 있는 도구는 추출 후 열 이름 변경 없이 세무 소프트웨어의 가져오기 템플릿에 직접 매핑되는 출력을 생성합니다. 캐나다 세무 전표 추출 워크플로에 대한 자세한 안내는 양식 추출 가이드를 참조하십시오. — 동일한 맞춤 열 접근 방식이 모든 세무 관할권에서 작동합니다.
추출 도구에서 무엇을 확인해야 하는가: 회계사의 프레임워크
표준적인 소프트웨어 평가 기준인 가격, 기능 목록, 연동 로고는 회계 법인이 실제로 알아야 할 사항을 알려주지 않습니다. 다음은 추출 도구가 실제 고객 문서와 맞닥뜨렸을 때 살아남을 수 있는지를 결정하는 다섯 가지 요소입니다.
다중 고객 배치 분리
고객 A의 은행 명세서 15건과 고객 B의 은행 명세서 8건을 처리하면 두 개의 별도 스프레드시트가 생성되어야 합니다. 파일을 폴더로 미리 분류할 필요가 없습니다. 단일 법인 회계용으로 만들어진 도구는 모든 업로드를 하나의 데이터 풀로 취급합니다. 회계 법인용으로 만들어진 도구는 고객별로 배치의 이름을 지정하고 배치별 결과를 내보낼 수 있습니다. 다중 고객 워크플로를 처리하는 도구의 전체 비교는 회계 법인을 위한 추출 도구 모음을 참조하십시오.
템플릿 구성 가능성이 아니라 형식 독립성
"강력한 템플릿 빌더"와 "구역별 OCR 구성"을 제공하는 도구는 자동화가 아니라 템플릿 유지보수 작업을 팔고 있는 것입니다. 의미 있는 역량은 형식 독립성입니다. 즉, 새 공급업체의 인보이스, 새 은행의 명세서, 새 급여 제공업체의 양식을 익숙한 양식과 동일한 설정으로 처리합니다. 이는 필드가 무엇을 의미하는지 이해하여 문서를 읽기 때문이지, 필드가 어디에 위치하는지 측정하기 때문이 아닙니다. 이러한 접근 방식 간의 기술적 차이는 AI OCR과 기존 OCR의 차이 설명을 참조하십시오.
다시 만들지 않고 저장할 수 있는 맞춤 열 템플릿
레스토랑 고객을 위해 추출하는 열(카테고리별 식자재 비용, 신고된 팁, POS 정산 금액)은 건설 고객을 위한 열(작업 원가 코드, 유보금, 유치권 포기서)과 다릅니다. 회계 법인급 도구는 고객별 또는 업무 유형별로 열 템플릿을 저장하므로, 직원들이 매달 추출 구성을 처음부터 다시 만들 필요가 없습니다.
다운스트림 도구가 기대하는 형식으로 출력
QuickBooks Online은 특정 열 헤더가 있는 CSV를 가져옵니다. Drake Tax는 특정 필드 매핑을 요구합니다. Xero 대량 가져오기는 특정 날짜 형식을 필요로 합니다. 추출 도구는 회계 소프트웨어의 가져오기 형식에 매핑되는 Excel 또는 CSV 출력을 생성해야 합니다. 일치하는 열 이름, 파싱되는 날짜 형식, 통화 기호가 없는 숫자 필드를 갖추어야 합니다. 도구가 자체 독점 형식으로만 내보낸다면, 귀하는데이터 입력을 데이터 재포맷팅으로 바꾼 것입니다.
추출만이 아니라 문서 수집까지
대부분의 회계 사무소에서 병목은 문서에서 데이터를 추출하는 것이 아니라, 애초에 고객으로부터 문서를 받는 것입니다. Collection Link를 포함한 도구 — 고객이 로그인 없이 열어 문서를 처리 대기열에 직접 업로드할 수 있는 공유 링크 — 는 이 상류 문제를 해결합니다. 매월 명세서와 비용 영수증을 받기 위해 이메일과 문자를 보내며 고객을 쫓아다니는 대신, 하나의 링크를 보내면 모든 것이 추출 파이프라인으로 들어갑니다. 비영리 고객을 지원하는 사무소라면 해당 분야에 특화된 Collection Link 활용 사례를 다룬 기부 영수증 데이터 추출 가이드를 참고하십시오.
문서 추출 자동화 시 흔한 함정
문서 추출을 도입한 모든 회계 법인은 이 중 최소 하나는 겪었습니다. 미리 알고 있으면 어렵게 배운 교훈을, 도구가 첫 고객 파일을 건드리기 전에 확인할 수 있는 체크리스트로 바꿀 수 있습니다.
함정 1: 다중 형식 환경에서 템플릿 도구 구매. 템플릿 기반 OCR 도구는 "한 번 설정하면 영구 사용"으로 판매됩니다. 회계 사무소에서 "한 번"이란 거래처별, 은행별, 고객별을 의미하며, 고객은 은행을 바꾸고 거래처는 청구서 형식을 바꾸므로 설정은 끝나지 않습니다. 데모에서 깔끔한 PDF 세 개로 작동하던 도구는 4개월 차에 고객 C가 Wells Fargo에서 Mercury로 바꾸면서 명세서 열 순서가 뒤집히면 망가집니다. 해결책은 더 나은 템플릿 도구를 사는 것이 아니라, 템플릿을 사용하지 않는 도구를 사는 것입니다.
함정 2: 정확도를 단일 숫자로 취급. "99% 정확도"를 광고하는 도구는 벤치마크 데이터셋의 문서 — 표준 레이아웃에 인쇄된 텍스트가 있는 깔끔한 PDF — 에서 그 숫자를 달성한 것입니다. 같은 도구가 조명이 어두운 식당에서 촬영한 영수증 사진에서는 80%, 도트 매트릭스 프린터를 쓰는 신용 조합의 스캔한 은행 명세서에서는 70%, 손으로 쓴 여백 메모에서는 50% 정확도로 작동할 수 있습니다. 중요한 정확도는 벤더의 최고가 아니라 귀하의 최악 문서에서의 정확도입니다. 어떤 도구든 도입하기 전에 가장 문제가 많은 파일 10개 — 구겨진 영수증, 팩스로 받은 W-2, 세 페이지짜리 식당 체인 청구서 — 로 실행해 보십시오. 벤더 데모처럼 보이는 파일이 아닙니다. 이것이 실전 정확도 가이드에서 다루는 방법론입니다.
함정 3: 수집 자동화 전에 추출 자동화. 추출 파이프라인이 시간당 100건을 처리해도 고객이 그 문서를 보내는 데 2주가 걸린다면, 실제 병목의 하류 단계만 가속한 것입니다. 수집 문제를 먼저 해결하십시오. 고객이 문서를 제출하는 방식을 표준화하고(이메일 첨부 대신 단일 Collection Link), 제출 마감일을 정하고, 알림을 자동화하십시오. 추출할 것이 없으면 추출 속도는 의미가 없습니다.
함정 4: 검토 단계의 과잉 자동화. IRS Circular 230, Section 10.22에 따르면 실무자는 세금 신고서를 준비할 때 상당한 주의를 기울여야 하며, 여기에는 입력 데이터의 정확성 검증도 포함됩니다. 추출을 자동화하더라도 검토 의무가 사라지는 것은 아니며, 모든 데이터 포인트를 검토하는 것에서 예외 항목을 검토하는 것으로 바뀔 뿐입니다. 추출된 데이터가 원본 문서 이미지로 명확히 소급 추적되고, 신뢰도가 낮은 필드는 사람이 검토하도록 표시되며, 나머지는 예외 방식으로 검증되도록 워크플로를 설계하십시오. "모두 검토"하는 워크플로는 시간 절약 효과를 무력화합니다. "아무것도 검토하지 않는" 워크플로는 Circular 230을 위반합니다. 그 중간 지점인 예외 검증 방식이 바로 추출 도구가 CPA 실무에서 제 역할을 하는 지점입니다.
회계 법인을 위한 구현 로드맵
회계 실무 전반에 문서 추출을 도입할 때는 인식된 중요도 순서가 아니라 문서 유형의 처리량과 형식 일관성 순서를 따라야 합니다. 목표는 더 어려운 문서를 도입하기 전에 가장 쉬운 문서에서 직원의 신뢰와 워크플로 습관을 쌓는 것입니다.
1단계: 은행 및 신용카드 명세서(1~2개월차). 여기서 시작하십시오. 명세서는 처리량이 많고 매월 예측 가능한 일정으로 도착하며, 은행마다 형식은 달라도 내부 구조는 일관되기 때문입니다(거래가 날짜, 설명, 금액 열로 된 시간순 행). 명세서 형식이 가장 일관된 고객 3~5명을 선택해 한 달치 명세서를 처리하십시오. 추출 결과를 수동 입력과 비교해 정확성을 확인하십시오. PDF를 받은 시점부터 조정 준비가 된 검증 데이터가 나올 때까지 전체 소요 시간을 측정하십시오. 1단계가 끝날 무렵에는 직원이 명세서에 대해 도구를 신뢰할 수 있어야 하고, 법인은 명확한 시간 절약 기준선을 확보해야 합니다.
2단계: 공급업체 인보이스(2~4개월차). 명세서 워크플로가 안정되면 인보이스를 추가하십시오. 새 공급업체를 도입하기 전에 이미 20가지 변형을 보고 데이터가 어떤 모습이어야 하는지 아는 알려진 공급업체의 반복 인보이스부터 시작하십시오. 고객별로 자주 쓰는 GL 코드와 비용 센터 배정을 포함한 열 템플릿을 저장해 추출 결과가 원장 구조에 미리 매핑되도록 하십시오. 비영리단체와 특정 비용 추적이 필요한 조직은 템플릿 설계 예시를 위해 기부금 영수증 추출 가이드를 참조하십시오.
3단계: 영수증 및 경비 보고서(4~6개월차). 영수증은 사진 품질 변수를 도입하며 기본 OCR가 제공하지 않는 분류 기능이 필요합니다. 촬영한 종이 영수증을 도입하기 전에 디지털 영수증(Amazon, SaaS 구독, 전자 인보이스)부터 시작하십시오. 읽기 쉽고 평평하며 조명이 좋은 영수증 사진을 위한 고객용 가이드를 만들어 입력 품질 문제가 추출 파이프라인에 도달하기 전에 줄이십시오. 경비 보고서의 경우 영수증에 AI 추출을 먼저 실행한 다음 스프레드시트 출력으로 보고서 합계를 검증하십시오. 반대 순서가 아닙니다.
4단계: 세금 양식(7~10월 기간). 세금 양식은 가장 높은 정확성을 요구하며 오류에 대한 규제상 결과가 가장 큽니다. 12월~4월 성수기에는 세금 양식 추출을 도입하지 마십시오. 7~10월 기간을 활용해 전년도 W-2와 1099로 테스트하고, 양식별로 AI 추출과 수동 입력을 비교하며, 실제 신고서가 이에 의존하기 전에 예외 검토 워크플로를 구축하십시오. 1월에 W-2가 도착하기 시작할 때쯤이면 직원은 도구가 안정적으로 처리하는 양식과 전면 수동 검토가 필요한 양식을 이미 알고 있어야 합니다.
시기 원칙: 세금 신고 마감일 60일 이내에는 새로운 추출 워크플로를 도입하지 마십시오. 학습 곡선 — 어떤 문서가 깔끔하게 추출되는지, 어떤 문서는 사람이 검토해야 하는지, 추출이 실패하면 어떻게 해야 하는지 파악하는 과정 — 은 첫 달 동안 도구가 절약해 주는 시간보다 더 많은 직원 시간을 소모합니다. 도입은 신고 시즌의 피크가 아니라 시즌 사이의 한가한 시기에 계획하십시오.
FAQ
AI 추출이 손으로 쓴 영수증과 여백 메모를 처리할 수 있습니까?
부분적으로 가능합니다. 블록체로 또박또박 쓴 손글씨는 약 75–85%의 필드 정확도로 추출되지만, 흘림체나 급하게 쓴 손글씨는 50–70%로 떨어집니다. AI는 판독 가능한 부분을 읽을 수 있습니다. 커피 얼룩이 묻은 흐릿한 감열 영수증에서 사람이 금액을 알아볼 수 없다면 AI도 마찬가지이며, 고객 확인 없이 그 필드에 의존해서는 안 됩니다.
기울어진 페이지와 도트 매트릭스 인쇄가 있는 스캔한 은행 명세서에서도 추출이 작동합니까?
예, 단 조건이 있습니다. AI 추출은 문자 단위로 스캔하는 대신 페이지 전체 레이아웃을 보기 때문에 기울어짐, 회전, 저해상도 스캔을 기존 OCR보다 더 잘 처리합니다. 그러나 5년 이상 지나 누렇게 변한 종이에 인쇄된 도트 매트릭스는 저대비 텍스트를 만들어 어떤 추출 시스템의 정확도도 떨어뜨립니다. 이러한 문서는 사용하는 도구와 관계없이 사람이 검토하도록 표시해야 합니다.
AI 처리 중에 고객 금융 데이터는 안전합니까?
이는 도구의 아키텍처에 달려 있습니다. 일부 도구는 모델 학습을 위해 데이터를 보관하는 제3자 AI API를 통해 문서를 전송하는데, 데이터에 고객 세무 정보가 포함된 경우 IRC §7216 관련 우려가 될 수 있습니다. 다른 도구는 학습 목적의 데이터 보관 없이 자체 인프라를 통해 문서를 처리합니다. 고객 문서를 업로드하기 전에 도구의 데이터 처리 정책을 WISP 요건과 대조하여 확인하십시오. 최소한 다음을 확인해야 합니다: 업로드된 문서가 모델 학습에 사용되지 않는지, 처리가 전송 중 암호화되는지, 정해진 보관 기간 후 문서가 자동으로 삭제되는지.
고객별로 모델을 학습시켜야 합니까, 아니면 한 번의 설정으로 모든 고객을 처리할 수 있습니까?
템플릿 기반 도구의 경우 사실상 고객별로 — 또는 공급업체별, 은행별, 양식 유형별로 — 학습시켜야 합니다. 새로운 문서 레이아웃마다 새 템플릿이 필요하기 때문입니다. 형식 독립적 AI 추출의 경우 원하는 열(Date, Description, Amount, Category)을 한 번 정의하면 동일한 설정으로 모든 고객, 모든 은행, 모든 공급업체의 문서를 처리합니다. 고객별 학습도, 공급업체별 템플릿 구축도 필요 없습니다. 다중 고객 실무를 위한 도구를 구매하기 전에 확인해야 할 가장 중요한 아키텍처 질문입니다.
AI 추출은 QuickBooks 또는 Xero와 어떻게 연동됩니까?
AI 추출 도구는 Excel 또는 CSV 형식의 구조화된 데이터를 생성하며, Dext나 Hubdoc처럼 거래를 QuickBooks 또는 Xero에 직접 전기하지는 않습니다. 워크플로는 다음과 같습니다: AI가 데이터 추출 → 스프레드시트 출력 검토 → 소프트웨어의 일괄 가져오기 기능을 사용하여 QuickBooks/Xero로 가져오기. 이렇게 하면 원장에 입력되는 내용을 완전히 통제할 수 있지만 가져오기 단계가 필요합니다. 스프레드시트 중간 단계 없이 원장에 직접 전기하려면 Dext나 Veryfi 같은 부기 통합 캡처 도구가 적합하지만, 이러한 도구는 문서 유형과 분류 규칙에 대해 정해진 방식이 있습니다. AI 추출 도구는 모든 문서에 유연하게 대응하지만 가져오기 단계는 사용자가 해야 합니다. 어느 아키텍처도 보편적으로 우월하지 않으며, 서로 다른 워크플로를 지원합니다. 에서 옵션을 비교하십시오.회계 사무소 도구 모음.
AI가 필드를 잘못 입력하면 어떻게 잡아내나요?
가장 효과적인 검증 워크플로는 필드별 확인이 아니라 예외 검토입니다. 추출 후: (1) 데이터가 있어야 할 곳에 빈 필드가 있는지 확인하십시오 — 명백한 추출 실패입니다. (2) 계산 열을 원본 문서와 대조해 표본 확인하십시오(예: 계산된 기말 잔액이 명시된 기말 잔액과 일치합니까?). (3) 금액순으로 정렬해 상위 및 하위 5건을 검증하십시오 — 가장 큰 거래가 틀리면 위험이 가장 큽니다. 이 3단계 검토는 배치당 5분 이내로 대부분의 추출 오류를 잡아내며, 필드별 검증에 20분 이상 걸리는 것과 대비됩니다. 검토를 완전히 건너뛰지 마십시오 — Circular 230의 실사 의무는 수작업과 마찬가지로 AI 지원 작업에도 적용됩니다.
다중 통화 인보이스와 국제 세무 양식을 처리할 수 있나요?
다중 통화 인식은 가능합니다 — AI 추출은 통화 기호($, €, £, ¥)를 식별해 추출 데이터에 보존할 수 있지만, 추출 도구는 외환 계산을 수행하지 않으므로 통화 변환은 별도로 처리해야 합니다. 국제 세무 양식(영국 P60, 호주 PAYG, 캐나다 T4)의 경우 도구별 지원 범위가 크게 다릅니다. 미국 시장에 최적화된 대부분의 도구는 비미국 양식 레이아웃을 인식하지 못합니다. 구매 전에 국제 양식 지원 여부를 명확히 확인하십시오 — "세무 양식 지원"이 미국 W-2/1099 이상을 의미한다고 가정하지 마십시오. CRA 박스 번호나 HMRC 필드 이름으로 직접 열을 정의할 수 있는 도구는 내장 양식 인식이 없어도 국제 양식에 사용할 수 있습니다. AI가 템플릿 매칭이 아니라 의미로 양식 내용을 읽기 때문입니다.
회계 사무소가 데이터 입력에 쓰는 시간은 사무소를 실제로 성장시키는 분석, 자문, 고객 관계에 쓸 수 없는 시간입니다. 문서 추출은 비용을 줄일 뿐만 아니라 청구 가능 시간을 전사 작업에서 전문성 작업으로 전환합니다. CPA 라이선스가 설계된 유일한 작업 유형입니다. 도구는 첫 단계입니다. 어떤 고객을 받을지, 어떤 서비스를 확장할지, 어떤 문서 유형을 수작업으로 그만둘지에 대한 사무소의 결정이 그 비용을 정당화하는 단계입니다.