Extraction de livret bancaire japonais (通帳) :
Guide complet pour la comptabilité et la déclaration fiscale
Le système de livret bancaire japonais est unique parmi les économies développées : un livret physique imprimé en temps réel par les distributeurs automatiques à l'aide de têtes d'impression matricielles ou thermiques, contenant chaque transaction sous forme de registre à cinq colonnes avec un solde courant — et, pour les 4,6 millions d'indépendants et de petites entreprises qui l'utilisent comme document financier principal, la source de référence définitive pour la déclaration fiscale. En 2024, la Japanese Bankers Association (全国銀行協会) a rapporté que les distributeurs automatiques des grandes banques traitent encore plus de 300 millions de mises à jour de livrets chaque année, même avec l'adoption croissante de la banque numérique. Pour le problème de l'extraction, ce volume signifie une chose précise : le livret n'est pas un format hérité en voie de disparition. C'est le format que le flux de travail comptable doit intégrer, et comprendre sa structure est la condition préalable pour automatiser la saisie de données qui consume actuellement des heures de transcription manuelle à chaque saison de déclaration fiscale.
Points clés à retenir
- Un livret japonais n'est pas un relevé bancaire — c'est un registre continu où un seul chiffre mal lu sur la ligne 47 corrompt tous les soldes suivants sur les 153 lignes restantes.
- La réforme fiscale de 2027 réduit l'abattement de la déclaration bleue sur papier de ¥550 000 à ¥100 000 — une pénalité de ¥450 000 pour continuer la même transcription manuelle de livret que vous avez toujours faite.
- Le même schéma d'extraction à cinq colonnes lit les livrets de MUFG Bank, Japan Post Bank et des coopératives de crédit régionales en un seul lot — car l'IA lit la signification de chaque valeur plutôt que sa position sur la page.
Ce qui fait du livret bancaire japonais une cible d'extraction unique
Dans la plupart des pays, un relevé bancaire est un récapitulatif mensuel — un PDF ou un document papier couvrant une période définie, avec un solde d'ouverture, un solde de clôture et les transactions intermédiaires. Chaque relevé est autonome. Une erreur de lecture sur le relevé de mars n'affecte pas celui d'avril.
Un livret bancaire japonais (通帳, tsūchō) n'est pas un relevé. C'est un registre courant imprimé par un distributeur automatique — un support physique continu alimenté en insérant le livret dans une machine qui imprime de nouvelles lignes de transaction directement sur la page à l'aide d'une tête d'impression matricielle ou thermique. Chaque ligne comporte cinq champs : date (月日), description (摘要, tekiyō), montant de retrait (お支払金額), montant de dépôt (お預り金額) et solde courant (差引残高). Chaque nouvelle ligne prolonge la chaîne. Le solde de la ligne 47 dépend de l'exactitude des lignes 1 à 46. Une seule erreur de lecture corrompt tous les soldes suivants — un mode de défaillance appelé dérive de solde (残高ずれ) qui n'a pas d'équivalent dans les systèmes basés sur des relevés.
Ce mécanisme d'impression crée un problème d'extraction de second ordre que la plupart des outils OCR génériques n'ont jamais été conçus pour traiter. Les pages de livret ne sont pas des documents typographiés avec une densité d'encre et un alignement cohérents. Ce sont des sorties d'imprimante — et la qualité d'impression varie selon le modèle de distributeur, l'âge du ruban encreur et la propreté de la tête d'impression. Deux livrets de la même banque, mis à jour à des distributeurs différents à six mois d'intervalle, peuvent présenter des différences notables de noirceur des caractères, d'alignement et de lisibilité. Une tête d'impression matricielle en fin de cycle de remplacement produit des caractères plus fins avec plus d'espaces entre les points — le même code 振込 (virement bancaire) qu'un distributeur propre imprime en traits nets et continus devient une constellation de points déconnectés sur une tête usée.
Le format du livret est régi par la Japanese Bankers Association (全国銀行協会), qui établit les normes d'échange de données interbancaires, d'interopérabilité des distributeurs et de la piste magnétique (磁気ストライプ) au dos de la couverture qui stocke les informations du compte. Le distributeur lit cette piste pour identifier le compte, puis imprime les lignes de transaction — ce qui signifie que le livret que vous tenez est une sortie d'imprimante, pas un document conçu. Le format est suffisamment standardisé pour que la disposition à cinq colonnes soit cohérente dans toutes les banques du Japon. La qualité d'impression, elle, ne l'est pas. Cette tension — format standard, exécution variable — définit le défi de l'extraction.
La différence structurelle qui compte pour l'extraction : une déclaration de revenus SA100 au Royaume-Uni ou un relevé BAS australien est un instantané — extrayez-le une fois, vérifiez-le par rapport à une source externe, terminé. Un livret japonais est une chaîne — l'extraction est une opération de continuité où l'exactitude de chaque ligne dépend de toutes les lignes précédentes. Le traiter comme un document basé sur des relevés et traiter les pages indépendamment est la source la plus courante d'échec d'extraction dans les flux de travail comptables japonais.
Le paysage bancaire japonais et ses implications pour l'extraction de livrets
Le Japon compte plus de 100 banques émettant des livrets physiques, et bien que la disposition à cinq colonnes soit standard, les détails de formatage — taille de police, interligne, présence ou absence d'une colonne de succursale (取抜店), et le fait qu'une transaction occupe une ligne ou en couvre deux — varient selon l'institution. Savoir quelle banque a émis un livret n'est pas une question théorique. Cela détermine les défis d'extraction à anticiper.
| Banque | Style de livret | Considérations d'extraction | Rôle sur le marché |
|---|---|---|---|
| MUFG Bank (三菱UFJ銀行) | Saisie sur une seule ligne, date à gauche, colonne du code d'agence (取抜店) incluse. Mise en page moderne et épurée. | Le plus facile à extraire — alignement matriciel cohérent, année de l'ère clairement imprimée en haut de page. La colonne du code d'agence est une donnée supplémentaire à extraire ou à ignorer selon les besoins comptables. | La plus grande banque du Japon — 7,93 % des entreprises en font leur banque principale (selon Tokyo Shoko Research) |
| SMBC (三井住友銀行) | Format sur une seule ligne similaire à MUFG. Peut abréger l'année de l'ère (R6 au lieu de 令和6年). | Les années d'ère abrégées nécessitent de connaître la correspondance des abréviations lors de la conversion des dates. Sinon, difficulté comparable à MUFG. | 6,34 % de part de marché en tant que banque principale. Forte base d'entreprises. |
| Mizuho Bank (みずほ銀行) | Similaire à MUFG/SMBC. Impression traditionnelle ; les années d'ère sont souvent en caractères pleine largeur. | Les caractères pleine largeur des années d'ère peuvent être lus comme des caractères séparés par l'OCR au niveau des caractères. L'extraction sémantique basée sur l'IA évite ce problème en lisant le champ de date dans son ensemble. | 5,04 % de part de marché en tant que banque principale. La plus traditionnelle des trois mégabanques. |
| Japan Post Bank (ゆうちょ銀行) | Format de deux lignes par transaction — la description passe sur une deuxième ligne. Impression compacte. Le code d'agence est affiché uniquement en chiffres. | Le format standard le plus difficile — le passage à la ligne sur deux lignes signifie que l'OCR basé sur des modèles entraînés sur des formats à une seule ligne manquera des détails de la description. L'extraction sémantique gère cela en lisant les deux lignes comme une seule unité sémantique. Propose également un « livret numérique » (デジタル通帳) pour les titulaires de comptes Yucho Direct+. | Réseau national — plus de 24 000 distributeurs automatiques. Banque par défaut pour de nombreux comptes personnels. |
| Resona Bank (りそな銀行) | Format sur une seule ligne. Forte orientation PME et particuliers ; les livrets incluent souvent des messages de services bancaires supplémentaires après les lignes de transaction. | Les messages de service supplémentaires imprimés entre les lots de transactions peuvent être lus à tort comme des lignes de données par les outils qui ne distinguent pas les lignes de transaction du texte informatif. | Membre du groupe Resona — forte base PME. Orientation bancaire régionale. |
| Banques régionales et coopératives de crédit (地方銀行・信用金庫) | Variées — la plupart suivent la disposition standard à cinq colonnes, mais avec des conventions d'impression localisées, du matériel de guichet automatique plus ancien et des formats d'année d'ère ancienne (y compris les dates de l'ère Showa pour les comptes de longue durée). | Le matériel de guichet automatique plus ancien entraîne une plus grande variance dans la qualité d'impression. Les livrets bancaires ouverts dans les années 1980 peuvent contenir des dates de l'ère Showa (昭和) nécessitant une conversion Showa + 1925. La grande variance est l'argument le plus fort en faveur de l'extraction sémantique — vous ne pouvez pas créer de modèle pour plus de 100 conventions d'impression régionales. | Collectivement, elles desservent une plus grande part de PME que les trois mégabanques réunies. |
L'implication pratique pour l'extraction est qu'un schéma à colonne unique — Date, Description (摘要), Retrait, Dépôt, Solde — fonctionne pour toutes ces banques. L'IA localise chaque valeur en lisant ce qu'elle signifie, et non en faisant correspondre les coordonnées de pixels d'un modèle. Un livret de MUFG avec une impression propre sur une seule ligne et un livret Yucho avec un retour à la ligne sur deux lignes produisent la même feuille de calcul à cinq colonnes dans le même lot, car le moteur d'extraction lit la sémantique des champs, et non leurs positions. Pour une présentation détaillée de cette approche par colonnes, consultez le guide étape par étape de l'extraction de livrets bancaires japonais.
L'architecture à cinq colonnes du livret — et pourquoi l'OCR générique échoue sur chacune d'elles
La disposition à cinq colonnes du livret est d'une simplicité élégante en surface et structurellement hostile à l'OCR conventionnel en profondeur. Chaque colonne présente un mode de défaillance distinct :
月日 (Date) — le problème du calendrier impérial japonais
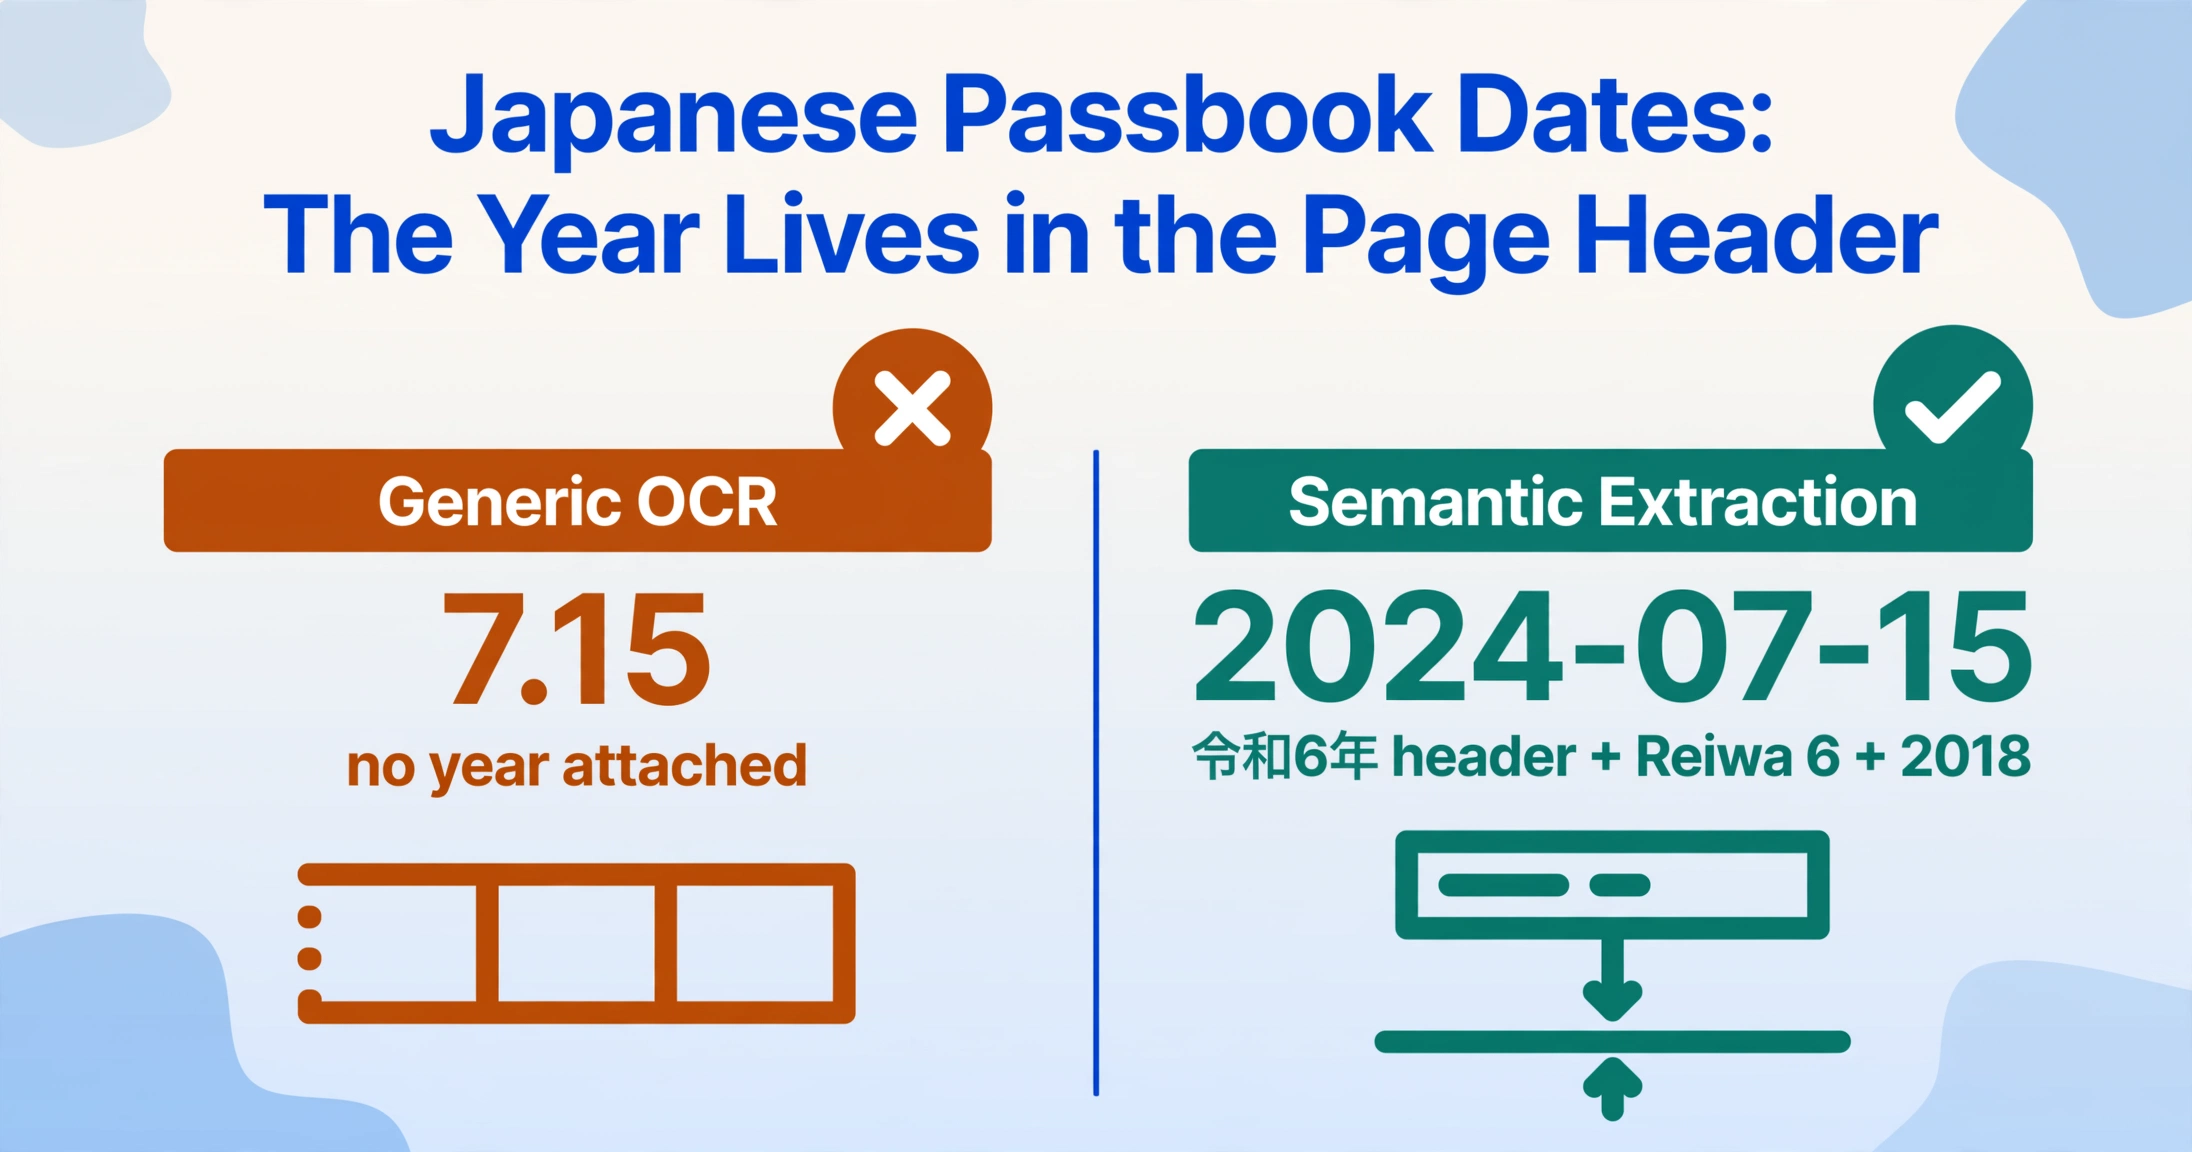
Les dates des livrets bancaires utilisent le calendrier impérial japonais : 令和 (Reiwa, début mai 2019), 平成 (Heisei, 1989–2019), 昭和 (Showa, 1926–1989). Une date imprimée R6.7.15 correspond au 15 juillet 2024 (année Reiwa 6 + 2018). H30.3.31 correspond au 31 mars 2018 (année Heisei 30 + 1988). L'en-tête d'année n'est imprimé qu'une fois en haut de page — les lignes suivantes de la même page et des pages de continuation ne portent que le mois et le jour. Un outil OCR générique qui lit « 7.15 » isolément obtient une date sans année, et un en-tête d'année trois pages en arrière qu'il n'a jamais vu. La formule de conversion est déterministe — Reiwa n = n + 2018, Heisei n = n + 1988, Showa n = n + 1925 — mais identifier quelle formule appliquer à quelle ligne exige de lire la relation entre l'en-tête de page et ses lignes de contenu, et non de lire des cellules individuelles.
摘要 (Description) — l'écart de classification des codes
La colonne de description utilise des codes compacts qu'un lecteur japonais catégorise immédiatement : 振込 (virement bancaire), ATM (transaction ATM), 給与 (dépôt de salaire), 引落 (prélèvement automatique), 手数料 (frais bancaires, généralement ¥110–¥550), 利息 (intérêts), カード (transaction par carte). Une extraction brute qui reproduit fidèlement ces codes produit une liste de transactions. Une extraction qui les classe pendant le traitement produit un grand livre pré-catégorisé. La logique de classification peut être définie une fois comme colonne calculée : si Description contient « 給与 » alors « Salary Income » ; si contient « 引落 » alors « Direct Debit » ; si contient « 手数料 » alors « Bank Fee » ; si contient « 利息 » alors « Interest Income ». Le code le plus ambigu est 振込 — un virement de ¥500 000 provenant d'une société cliente connue est un revenu d'entreprise ; un virement de ¥15 000 provenant d'un particulier est probablement personnel. Une colonne calculée peut combiner la description et le montant pour lever l'ambiguïté : si Description=« 振込 » et Montant > 100000 alors « Business Income » ; sinon « Personal Transfer ».
お支払金額 / お預り金額 (Retrait / Dépôt) — le piège de l'exclusion mutuelle
Une transaction donnée comporte une entrée soit dans la colonne des retraits, soit dans celle des dépôts — jamais les deux. Cette exclusivité mutuelle est la base structurelle de la vérification du solde, mais elle crée aussi une défaillance OCR courante : un dépôt de ¥30 000 placé dans la colonne des retraits par une lecture mal alignée. Le calcul du solde échouera sur cette ligne, et toutes les lignes suivantes échoueront également, car solde précédent + 0 (aucun dépôt lu) − ¥30 000 (mauvaise colonne) ne peut pas égaler le solde courant imprimé. Ce n'est pas une erreur aléatoire — c'est une erreur structurée caractéristique des formats à colonnes avec logique d'exclusion mutuelle, et l'OCR basé sur des modèles qui lit les cellules par position y est particulièrement vulnérable.
差引残高 (Solde courant) — le moteur d'auto-vérification
Le solde courant est à la fois le plus grand avantage d'extraction du livret bancaire et son mode de défaillance le plus dangereux. C'est un avantage car la colonne du solde porte sa propre vérification en interne : solde précédent + dépôt − retrait doit être égal au solde actuel. Définissez une colonne calculée qui vérifie cela sur chaque ligne pendant l'extraction — Vérification du solde (solde précédent + dépôt − retrait = solde actuel ? 'OK' : 'À VÉRIFIER') — et vous saurez quelles lignes examiner avant que les données n'entrent dans votre logiciel comptable. C'est dangereux car une seule erreur de lecture — une virgule omise transformant ¥30 000 en ¥3 000 — corrompt le solde de cette ligne, ce qui corrompt la vérification de la ligne suivante, et de toutes les lignes suivantes. Un livret de 280 transactions avec une erreur de lecture sur la ligne 47 produit 233 drapeaux « À VÉRIFIER » — mais la cause racine est la première ligne signalée. Corrigez la ligne 47, et les lignes 48 à 280 se recalculeront correctement. Cet effet en cascade fait l'objet du guide sur les erreurs courantes de saisie de données de livret bancaire, qui couvre en profondeur la prévention de la dérive du solde.
Piste magnétique (磁気ストライプ) — la dépendance matérielle
La piste magnétique sur la couverture arrière stocke le numéro de compte, le code d'agence et le type de compte. Lorsqu'un livret est inséré dans un guichet automatique, la machine lit la piste, identifie le compte, récupère les transactions non imprimées et les imprime. La piste est un composant lu par machine — les informations de compte qu'elle contient ne sont pas imprimées sous forme de texte sur la page du livret lui-même (la couverture avant affiche généralement le nom du titulaire en katakana, pas le numéro de compte). Pour l'extraction, le numéro de compte et les informations d'agence sont des points de données qui doivent provenir soit de la carte bancaire (キャッシュカード), des informations de la couverture avant (si présentes), soit d'une saisie manuelle — les pages du livret elles-mêmes ne portent pas ces données sous une forme imprimée lisible par machine. Une piste magnétique endommagée sur un ancien livret signifie que le guichet automatique ne peut pas la lire pour les mises à jour d'impression, mais cela n'empêche pas l'extraction des pages imprimées existantes — les données de transactions imprimées sont indépendantes de la piste.
Le flux d'extraction : du livret papier au tableur prêt pour la comptabilité
L'extraction des données de livrets bancaires japonais suit une architecture en trois étapes, identique que vous traitiez un livret ou dix, une année ou cinq. La phase de configuration est effectuée une seule fois et réutilisée indéfiniment. La phase de traitement est celle où le moteur d'extraction fait le travail. La phase de vérification est celle où vous confirmez que la sortie est correcte — et la colonne de solde auto-vérifiante du livret rend cette étape des ordres de grandeur plus rapide que le rapprochement manuel.
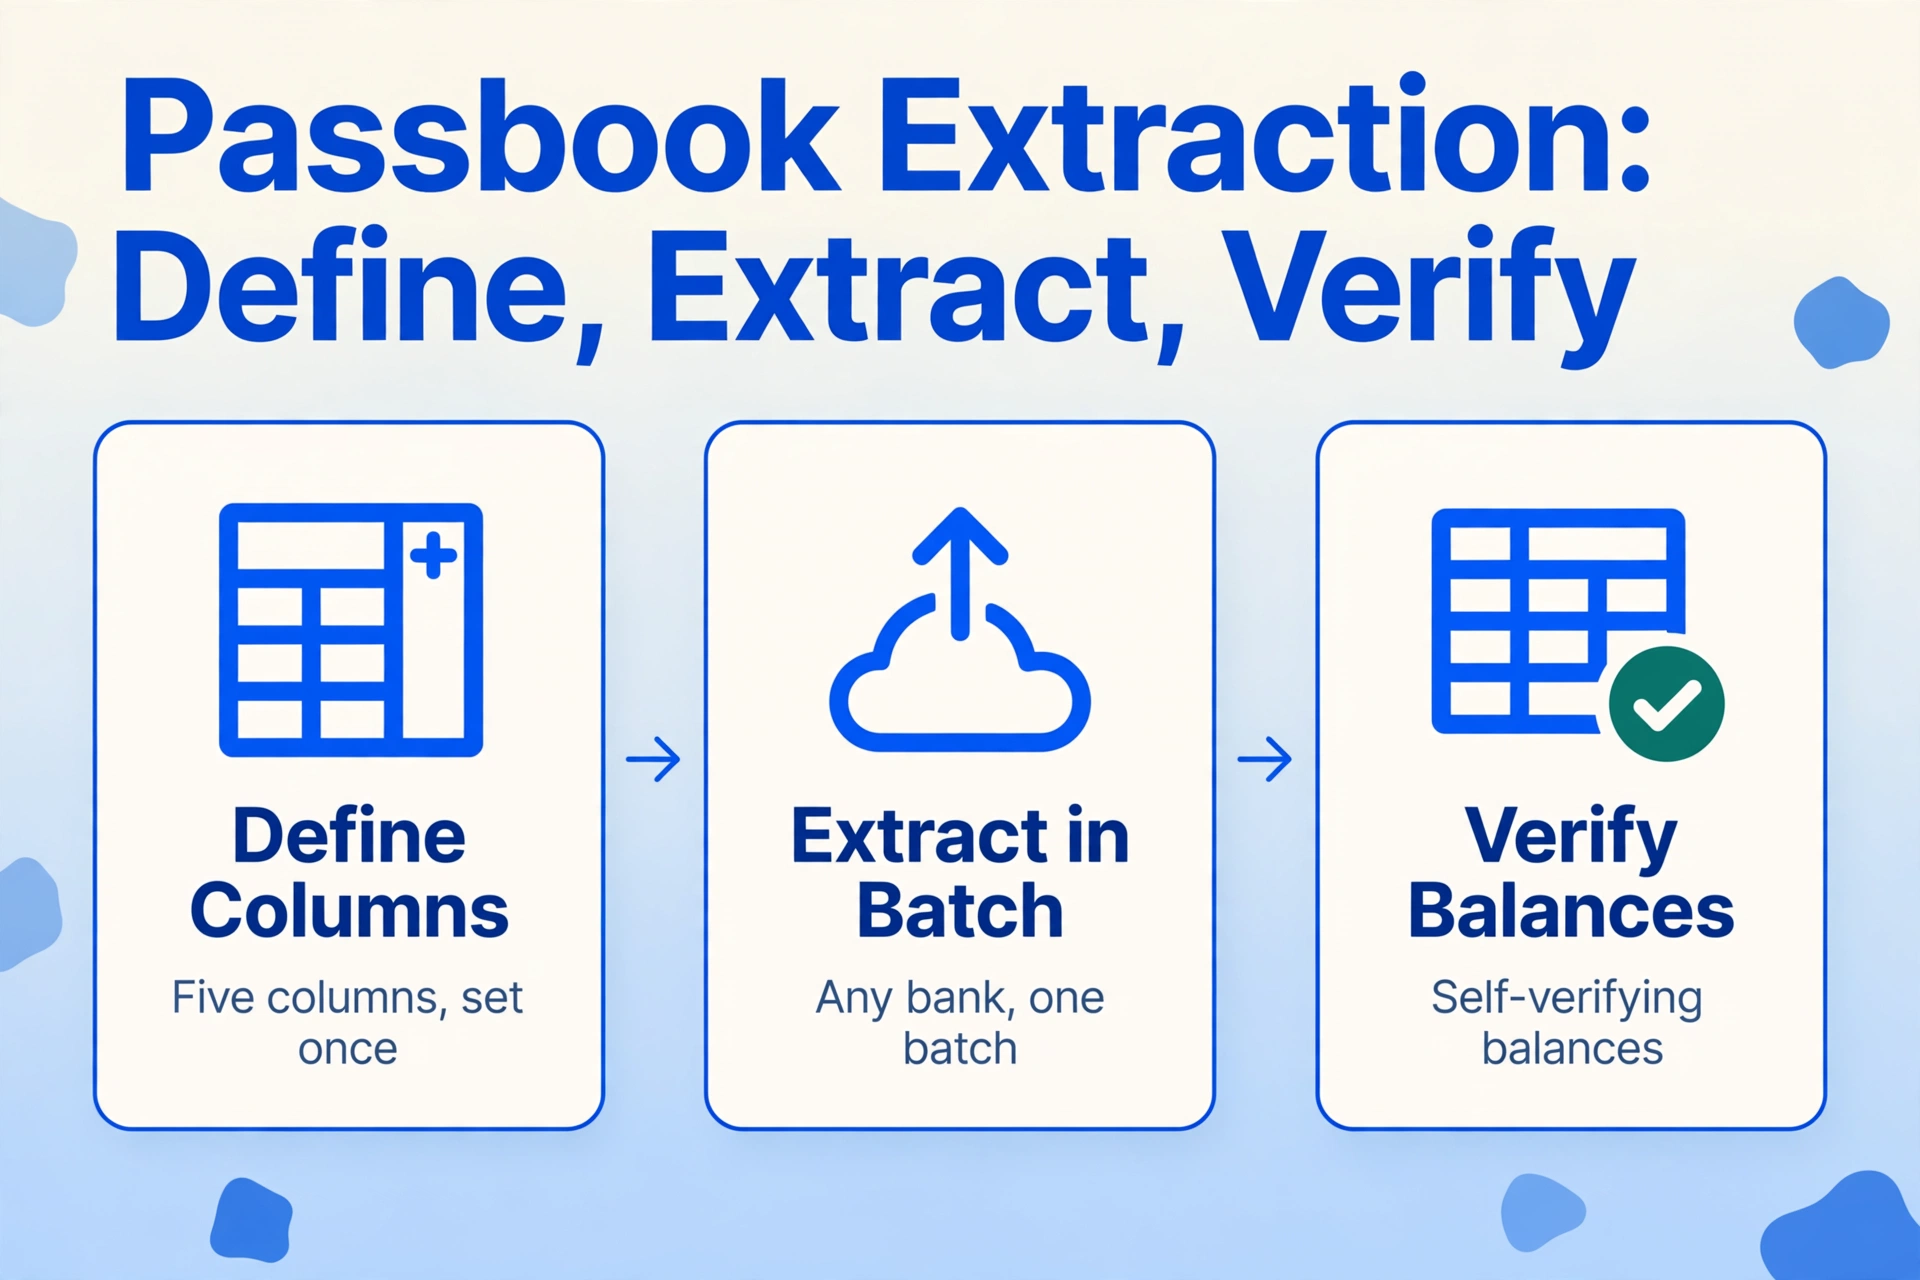
Définition du schéma de sortie. Vous spécifiez cinq noms de colonnes — Date, Description (摘要), Retrait (お支払金額), Dépôt (お預り金額), Solde (差引残高) — et vous pouvez ajouter des colonnes calculées pour la pré-classification et la vérification. Il s'agit d'Extraction de colonnes personnalisées : vous définissez la sortie, et l'IA fait correspondre les champs imprimés de chaque livret à vos colonnes en lisant la signification de chaque valeur. Le même schéma de colonnes fonctionne avec toutes les banques — MUFG, SMBC, Mizuho, Japan Post Bank, coopératives de crédit régionales — car l'IA lit la sémantique des champs, pas les coordonnées des pixels. Un modèle configuré pour la mise en page sur une ligne de MUFG échouerait sur l'habillage sur deux lignes de Japan Post Bank ; un schéma sémantique gère les deux formats dans le même lot car il lit la signification de chaque champ, pas sa position.
Téléchargement et traitement. Numérisez ou photographiez les pages du livret — y compris les pages de couverture avant montrant le nom du titulaire du compte, la couverture arrière pour référence, et chaque page de transactions — et téléchargez toutes les images en un seul lot. Chaque page est traitée indépendamment avec le même schéma de colonnes appliqué. Les dates d'ère (和暦) sont converties en calendrier grégorien (aaaa-mm-jj) au niveau de la sortie, en appliquant le contexte d'ère correct par page. Les codes de description sont capturés tels quels et éventuellement classés en catégories de dépenses via des colonnes calculées. Le solde courant de chaque ligne est vérifié par rapport au solde de la ligne précédente lors de l'extraction, signalant les écarts.
Exportation et vérification. La sortie est un fichier Excel avec une ligne par transaction et chaque champ dans sa propre colonne. La colonne de vérification du solde affiche OK sur chaque ligne où le calcul est correct, et REVIEW sur les lignes présentant des écarts. Un livret de trois ans avec environ 280 transactions produit généralement un ou deux drapeaux REVIEW — virgules mal lues, chiffres tachés sur des pages vieillissantes, ou une correction manuscrite qui a perturbé le lecteur d'impression. Corrigez ces lignes, et les 278 restantes sont vérifiées. Le tableur s'importe directement dans tout logiciel de comptabilité japonais qui accepte les données de transactions CSV.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Pour une démonstration pratique de ce flux de travail — y compris la configuration des colonnes, les stratégies de numérisation des pages et la gestion courante des erreurs — le guide d'extraction de livret unique couvre chaque étape en détail. Pour la stratégie de traitement par lots qui gère plusieurs livrets sur plusieurs années, le guide de traitement par lots aborde la fusion multi-livrets, le report des dates d'ère entre les pages et la vérification de l'équilibre à l'échelle du lot. Pour une analyse des raisons pour lesquelles la saisie manuelle persiste malgré les outils numériques disponibles, voir l'analyse approfondie du problème de la saisie manuelle des livrets japonais.
Traitement par lots : quand un livret devient une décennie de données
Un livret unique contient environ 8 à 10 transactions par page et 50 à 100 pages, ce qui lui confère une durée de vie utile typique d'un à trois ans selon l'activité du compte. Un entrepreneur individuel déposant une déclaration bleue (青色申告) qui maintient des livrets séparés pour les opérations quotidiennes (MUFG), les réserves fiscales (Japan Post Bank) et la paie (coopérative de crédit régionale) a trois livrets à extraire — environ 36 pages de transactions imprimées, 280 lignes, selon trois conventions d'impression.
L'extraction par lots gère cela comme une opération unique. Les trois livrets sont téléversés en un seul lot avec le même schéma de cinq colonnes. Les dates d'ère sont converties par page avec le contexte d'ère correct — le livret MUFG utilisant des années d'ère abrégées (R6), le livret Japan Post Bank utilisant des noms d'ère complets (令和6年), et le livret de la coopérative de crédit contenant des transactions de la fin de l'ère Showa provenant de comptes ouverts dans les années 1980 — toutes étant résolues en dates grégoriennes dans la sortie. Le même lot gère les notes manuscrites en marge (家賃 pour le loyer, 仕入 pour les achats de stock) comme colonne Notes supplémentaire, et les colonnes calculées pré-classifient les transactions en catégories de dépenses et signalent les écarts de solde.
L'alternative — l'extraction sur page unique avec fusion manuelle — oblige l'utilisateur à consolider 36 fichiers de feuilles de calcul séparés, à recouper les dates d'ère entre les pages où l'en-tête d'année apparaît sur la page 1 et disparaît pour les sept pages de continuation suivantes, et à vérifier manuellement la continuité des soldes entre les limites des livrets. Pour trois années de données provenant de trois banques, l'étape de fusion manuelle seule prend environ deux à trois heures. L'approche par lots l'élimine entièrement — un téléversement, une feuille de calcul, une passe de vérification. Pour l'architecture complète du flux de travail par lots, voir le guide de traitement par lots des pages de livret dans un grand livre de dépenses annuel. Pour une ventilation chiffrée de ce que la saisie manuelle des données coûte réellement aux petites entreprises japonaises, l'analyse des coûts traduit le temps et les taux d'erreur en chiffres concrets.
Traitement par lots des livrets bancaires vs. autres scénarios de lots du marché : un cabinet britannique traitant par lots 80 déclarations SA100 gère des documents indépendants — chaque déclaration est un ensemble de données autonome, et une erreur de lecture sur la déclaration 47 n'affecte que la déclaration 47. Un lot de livrets bancaires traite des pages interdépendantes — le solde cumulé se répercute d'une page à l'autre, et une erreur de lecture sur la page 3 corrompt silencieusement la vérification de toutes les pages suivantes. Le lot doit tenir compte de la structure de continuité du type de document, et non traiter chaque page comme une île. C'est pourquoi la vérification des colonnes calculées au moment de l'extraction — et non après — fait la différence technique entre un lot qui produit des résultats vérifiés et un lot qui produit des données que vous devez entièrement revérifier dans votre logiciel comptable.
Dans l'écosystème comptable japonais : Yayoi, freee, MoneyForward et au-delà
La feuille de calcul extraite est un pont — la destination est le logiciel comptable japonais. Les trois plateformes qui dominent le marché des indépendants et des petites entreprises — Yayoi Accounting (弥生会計), freee Accounting (freee会計) et MoneyForward Cloud Accounting (マネーフォワード クラウド会計) — couvrent collectivement la grande majorité des déclarants à déclaration bleue. Chacune a un chemin d'importation distinct, et la sortie d'extraction doit correspondre aux attentes de la plateforme cible.
Yayoi Accounting (弥生会計). Le leader du marché, notamment auprès des experts-comptables fiscalistes (税理士). L'importation se fait par CSV via la fonction Smart Transaction Import (スマート取引取込). Yayoi exige les dates au format aaaa-mm-jj — la conversion de l'ère au calendrier grégorien à l'étape d'extraction doit être complète avant l'exportation. Yayoi utilise un « format d'importation Yayoi » propriétaire (弥生インポート形式) pour le CSV, donc la sortie d'extraction doit être mappée au schéma de champs Yayoi : date, compte débiteur (借方勘定科目), montant débiteur, compte créditeur (貸方勘定科目), montant créditeur, description (摘要).
freee Accounting (freee会計). Natif cloud avec plus de 270 endpoints API et prise en charge MCP (Model Context Protocol) — le plus riche en API des trois. Importation via téléchargement CSV manuel (取引 CSV インポート) en utilisant le format de modèle d'importation de freee, ou via l'API freee pour une ingestion automatisée. Les règles de catégorisation automatique de freee (自動登録ルール) peuvent être configurées pour reconnaître les codes de description des livrets et attribuer des intitulés de comptes (勘定科目) — ce qui signifie que l'étape d'extraction peut se concentrer sur la capture fidèle des codes, et que la logique de classification vit dans le moteur de règles du logiciel comptable.
MoneyForward Cloud Accounting (マネーフォワード クラウド会計). Importation via la fonction de migration de données (他社ソフトデータの移行), en sélectionnant le format compatible Yayoi comme format CSV intermédiaire. La force de MoneyForward est le tableau de bord unifié combinant les données des livrets, les relevés de carte de crédit et les scans de reçus en une image financière complète. Si la sortie d'extraction utilise le format de date et de colonnes compatible Yayoi, elle s'importe dans MoneyForward avec le même mappage de colonnes.
Les autres plateformes prises en charge qui acceptent le même import CSV incluent : MJS Accounting (会計大将), TKC (séries FX2/MX), OBC Kanjo Bugyo (勘定奉行), Sorimachi Accounting King (会計王), EPSON Financial Support (財務応援R4) et PCA Accounting (PCA会計). Le format à cinq colonnes du livret est standardisé dans toutes les banques japonaises, donc la même sortie d'extraction fonctionne avec toute plateforme comptable qui importe des données de transactions CSV — le format de date, les colonnes de montants et le champ de description sont les mêmes quel que soit le logiciel récepteur.
La distinction clé entre les trois principales plateformes pour la planification de l'extraction : Yayoi est limité au CSV et nécessite que l'extraction produise un fichier compatible avec le format d'importation Yayoi. freee prend en charge à la fois le CSV et l'API — la voie API permet des pipelines automatisés de relevé à comptabilité sans transfert manuel de fichiers. MoneyForward utilise le CSV au format Yayoi comme format intermédiaire, donc les résultats d'extraction formatés pour Yayoi fonctionnent pour les deux plateformes. Pour la plupart des petites entreprises sans intégration API, cibler le format d'importation Yayoi comme norme de sortie d'extraction offre la plus large compatibilité.
Le lien avec la déclaration bleue : pourquoi l'extraction de relevés devient cruciale avec la réforme fiscale de 2027
Le plan de réforme fiscale japonaise (令和8年度税制改正の大綱), publié par la coalition au pouvoir le 19 décembre 2025, restructure la déduction spéciale pour déclaration bleue (青色申告特別控除) — l'incitation fiscale qui rend la comptabilité en partie double utile pour les entrepreneurs individuels depuis l'introduction du système. Les changements prennent effet pour l'année fiscale 2027 (déclarée en 2028) et redéfinissent directement l'économie de la numérisation des relevés bancaires.
Sous le système actuel (2026), un déclarant bleu tenant une comptabilité en partie double et déposant par voie électronique reçoit une déduction de ¥650 000 sur le revenu imposable. Les déclarants papier avec comptabilité en partie double reçoivent ¥550 000. La réforme de 2027 réduit la déduction papier à ¥100 000 — une baisse de ¥450 000 — et introduit un niveau supérieur de ¥750 000 pour les déclarants qui utilisent e-Tax électronique ET tiennent des livres électroniques qualifiés (優良な電子帳簿) ou utilisent un système de calcul électronique spécifié avec liaison automatique des données (デジタルシームレス). La structure à trois niveaux devient :
| Méthode de déclaration | Tenue de livres | Déduction (2026) | Déduction (2027+) | Changement |
|---|---|---|---|---|
| e-Tax + Livres électroniques qualifiés ou liaison automatique | Partie double | — | ¥750 000 | Nouveau niveau |
| Déclaration électronique e-Tax | Partie double | ¥650 000 | ¥650 000 | Aucun changement |
| Déclaration papier | Partie double | ¥550 000 | ¥100 000 | −¥450 000 |
| Tenue de livres simplifiée | Partie simple | ¥100 000 | ¥100 000 (revenu ≤ ¥10M) ¥0 (revenu > ¥10M) | Restriction sur le revenu ajoutée |
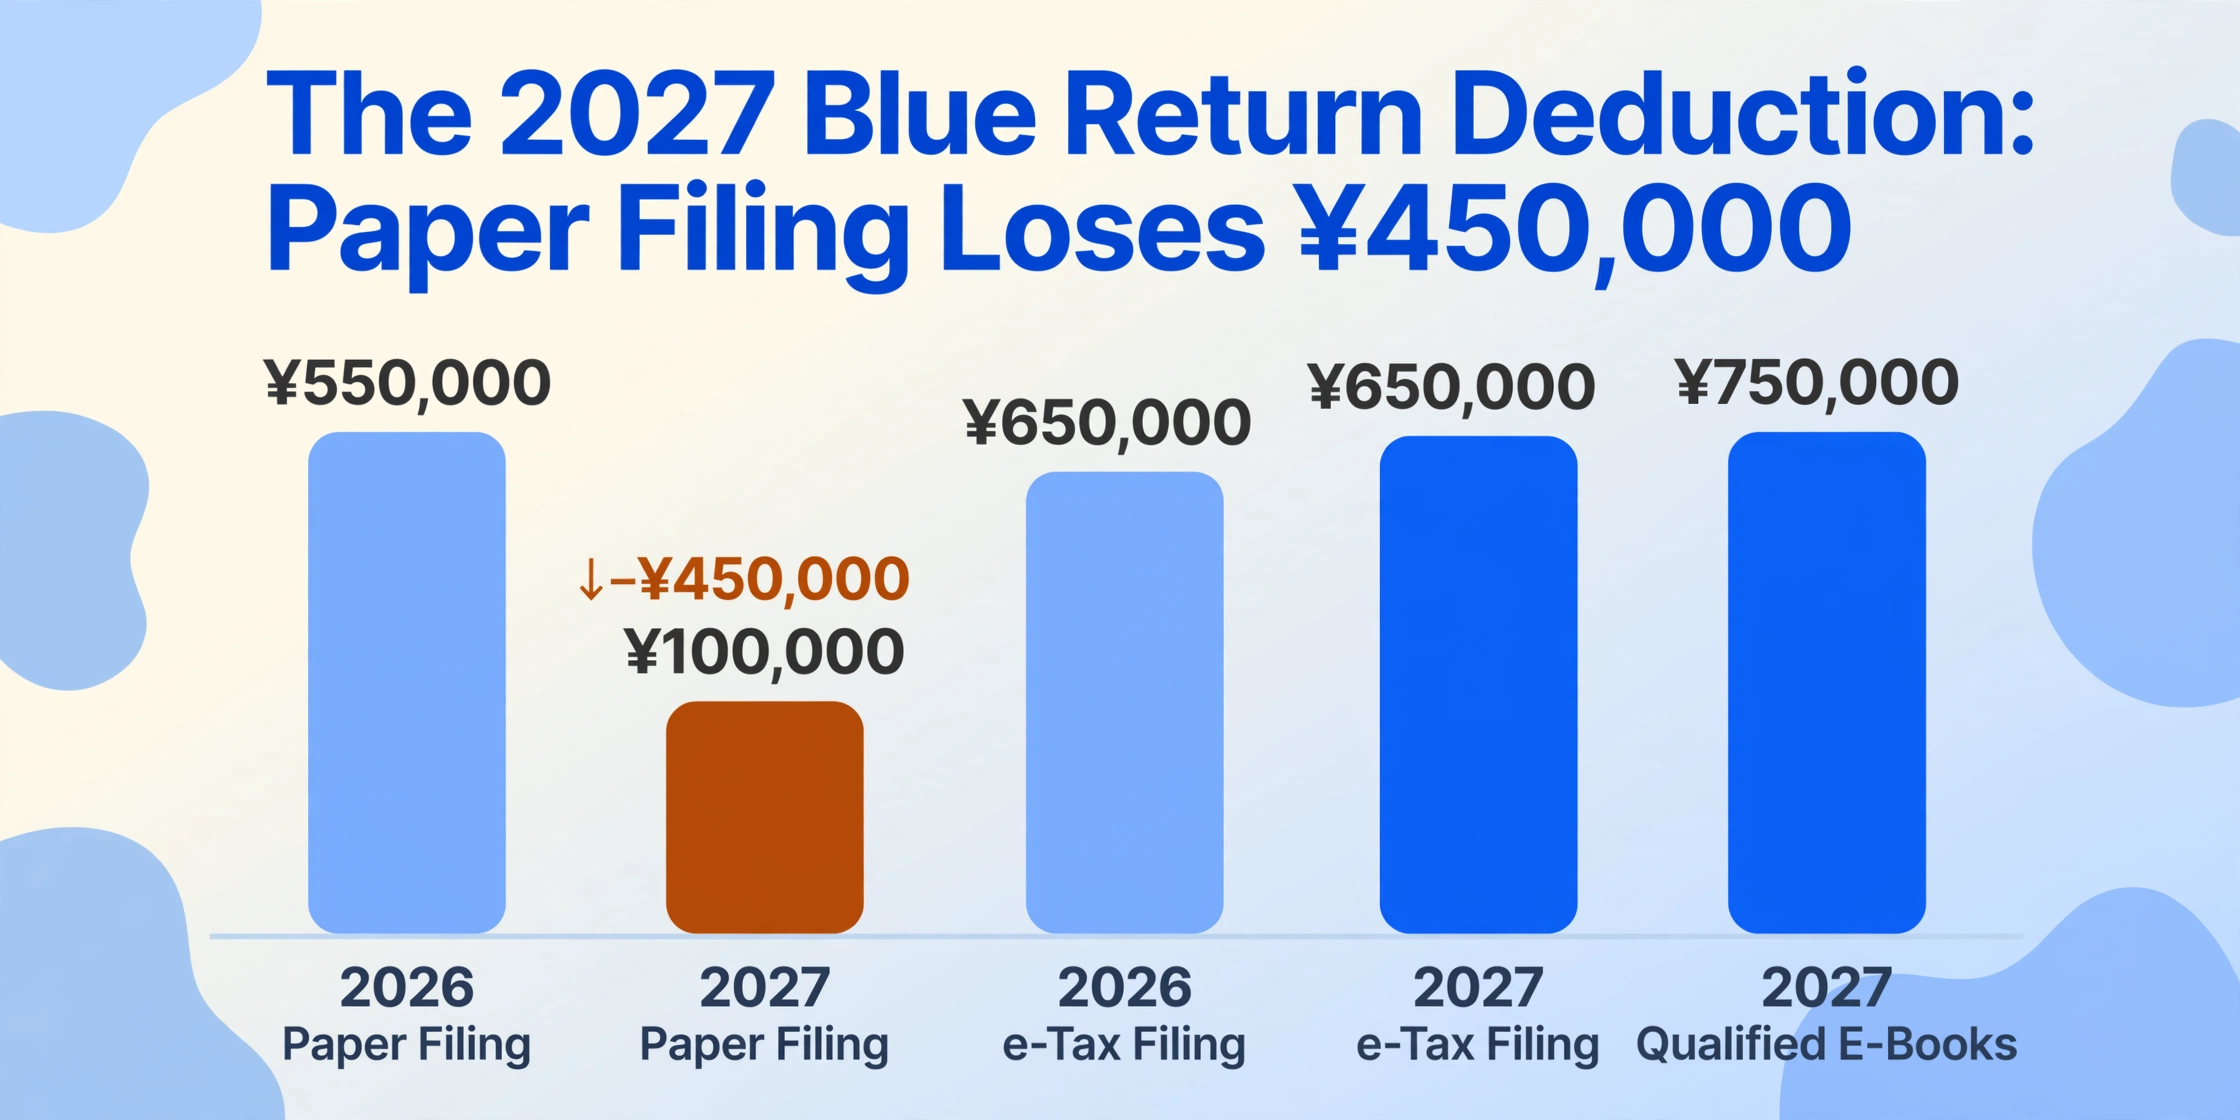
Le lien avec l'extraction de livret bancaire est direct. Un entrepreneur individuel déposant une déclaration papier en 2026 avec une comptabilité en partie double et une transcription manuelle du livret a obtenu 550 000 ¥. Ce même déclarant, poursuivant la même approche manuelle en 2027, obtient 100 000 ¥ — une réduction de déduction de 450 000 ¥, équivalant à environ 90 000 ¥ à 180 000 ¥ d'impôt supplémentaire selon le taux marginal. La réforme rend la déclaration électronique e-Tax obligatoire pour le palier de 650 000 ¥ — ce qui signifie que l'ensemble du pipeline comptable, de la saisie des données du livret à la soumission finale de la déclaration, doit être numérique. L'extraction de livret n'est pas une amélioration de confort. C'est le premier maillon d'une chaîne qui détermine désormais votre palier de déduction fiscale.
En vertu de la loi sur la conservation des livres électroniques (電子帳簿保存法), les copies numérisées de documents financiers peuvent servir de documents légalement admissibles si elles respectent les exigences de résolution (200 dpi) et de couleur. L'amendement de 2024 a assoupli l'exigence d'horodatage — les documents numérisés stockés dans un système avec historique de modification et de suppression (訂正・削除履歴) n'ont plus besoin d'un horodatage séparé. Pour l'extraction de livret, cela signifie que les pages de livret numérisées utilisées comme entrée d'extraction peuvent également servir de copie légale du document, à condition que la résolution de numérisation respecte l'exigence de couleur à 200 dpi et que les fichiers numérisés soient stockés dans un système conforme. Le livret physique doit toujours être conservé pendant la période légale de sept ans — l'extraction remplace l'étape de saisie manuelle des données, pas le document légal.
Cas particuliers et dépannage
La plupart des extractions de livrets bancaires produisent une sortie propre avec une ou deux lignes signalées. Les cas particuliers ci-dessous couvrent les scénarios où les résultats d'extraction nécessitent une vérification humaine — savoir à quoi ils ressemblent avant qu'ils ne se produisent transforme une séance de dépannage frustrante en une correction de deux minutes.
Corrections manuscrites (手書き通帳修正)
Les utilisateurs de livrets bancaires corrigent parfois les entrées imprimées à la main — un guichetier écrit une correction à côté d'un montant mal imprimé, ou le titulaire du compte annote la colonne de description avec une note comme 家賃 (loyer) ou 仕入 (achat de stock). Ces annotations font légalement partie du registre et contiennent des informations cruciales pour la comptabilité. L'extraction par modèle de vision peut lire les annotations manuscrites en plus du texte imprimé — mais la qualité de l'écriture varie : une annotation claire au stylo à bille en kanji est généralement lisible ; une note au crayon estompée et inclinée traversant les lignes imprimées de la grille est moins fiable. Pour les livrets où les notes manuscrites sont la seule trace de la catégorisation des transactions, la feuille de calcul extraite doit être vérifiée avec le livret physique ouvert pour les lignes où l'écriture était ambiguë. L'IA gère la majorité lisible ; la vérification est un traitement des exceptions, pas une lecture ligne par ligne.
Ambiguïté du code de description (摘要あいまい性)
Un 振込 (virement) de ¥500 000 provenant d'un nom de client connu est un revenu d'entreprise. Un 振込 de ¥15 000 provenant d'un particulier est probablement personnel. Le code de description du livret seul ne peut pas les distinguer — c'est l'attribution de catégorie du logiciel de comptabilité qui le fait. L'extraction doit capturer le code fidèlement ; la logique de classification vit en aval, soit dans les règles de catégorisation automatique du logiciel de comptabilité, soit dans une colonne calculée qui combine le code de description avec le seuil de montant. Un mode d'erreur courant est d'écrire des règles de classification trop agressives — une règle qui classe tous les 振込 supérieurs à ¥100 000 comme « Revenu d'entreprise » classera à tort un don familial ponctuel de ¥200 000. Les règles doivent être prudentes, classant les cas évidents et laissant les cas ambigus à la vérification manuelle.
Pages de livret endommagées ou dégradées
Les livrets de cinq ans ou plus peuvent avoir des pages à l'impression estompée, des dégâts d'eau, des bavures d'encre ou des plis traversant la zone des transactions. Pour l'impression estompée, numériser à une résolution plus élevée (300 dpi ou plus) et ajuster le contraste avant l'extraction améliore la lisibilité. Pour les plis qui déforment les caractères matriciels, photographier la page sous lumière naturelle en biais peut réduire l'ombre du pli. Pour les pages où les dégâts rendent une ligne de transaction illisible — généralement 1 à 2 lignes dans un livret de 280 — marquez la ligne pour une saisie manuelle en vous basant sur le livret physique. L'extraction gère les 278 autres lignes. L'échec de la ligne endommagée est visible dans la colonne de vérification : un drapeau REVIEW sur une ligne où le calcul du solde ne correspond pas, souvent causé par un chiffre de montant partiellement illisible.
Livrets numériques (デジタル通帳) vs. livrets physiques
Certaines banques — notamment Japan Post Bank via son service Yucho Direct+ — proposent des livrets numériques qui remplacent le livret physique par une vue des transactions en ligne et un export CSV téléchargeable. Cependant, le format d'export, la plage de dates et les colonnes disponibles varient selon la banque et ne correspondent souvent pas au format attendu par les logiciels comptables. Un CSV de livret numérique de Japan Post Bank peut exporter des dates au calendrier grégorien, tandis que le livret physique du même compte imprimé à un guichet automatique utilise les dates d'ère — et le CSV peut ne couvrir que les 12 derniers mois alors que le livret physique contient tout l'historique du compte. Pour les déclarants à la déclaration bleue dont le logiciel comptable attend un format CSV spécifique, la voie d'extraction — scanner le livret physique ou faire une capture d'écran de la vue du livret numérique — produit une sortie au format cohérent quelle que soit la source de données, la conversion ère-vers-grégorien étant gérée au niveau de la sortie quel que soit le format d'entrée.
Livrets multi-ères et en-têtes d'année manquants
Un livret ouvert en 2018 et renouvelé en 2024 contient des transactions couvrant deux ères impériales : 平成 (Heisei) et 令和 (Reiwa). La frontière entre les ères — 平成31年 (janvier–avril 2019) passant à 令和元年 (mai–décembre 2019) — se situe au milieu du livret. L'extraction doit détecter le changement d'ère à la page où l'en-tête d'année passe de 平成 à 令和 et appliquer le décalage correct pour chaque transaction. De même, les pages de continuation du même livret qui ne réimpriment pas l'en-tête d'année s'appuient sur le contexte reporté de la page la plus récente comportant un en-tête. Si la page 5 imprime 令和6年 et que les pages 6 à 8 n'impriment que le mois et le jour, l'extraction applique le contexte 令和6年 à toutes les transactions des pages 5 à 8 — et lorsque la page 9 imprime 令和7年 après la frontière du 1er janvier, le contexte est mis à jour. Un report manqué produit des transactions avec des dates flottantes (« 7.15 » sans année) qui ne peuvent être placées sur une chronologie et feront échouer l'import dans le logiciel comptable.
Questions fréquemment posées
L'extraction de livret bancaire peut-elle gérer toutes les banques japonaises dans le même lot ?
Oui — un livret MUFG avec une seule ligne par opération, un livret Japan Post Bank (ゆうちょ銀行) avec un format de deux lignes par opération, et un livret d'une caisse régionale (信用金庫) avec une impression compacte peuvent tous être téléversés dans le même lot et produire une feuille de calcul unifiée avec des colonnes cohérentes. L'extraction sémantique lit ce que chaque valeur signifie — une date est une date qu'elle soit imprimée R6.7.15 sur un livret ou 令和6年7月15日 sur un autre. Le même schéma à cinq colonnes fonctionne pour tous les formats. La conversion de l'ère vers le calendrier grégorien est appliquée par page en fonction de l'en-tête d'ère détecté sur chaque page, donc un lot contenant des livrets de différentes ères — 平成 sur le livret MUFG, 令和 sur le livret Japan Post Bank, 昭和 sur un vieux livret de caisse régionale — résout toutes les dates au format aaaa-mm-jj dans la sortie.
Comment l'extraction gère-t-elle les dates du calendrier impérial japonais (和暦) qui s'étendent sur différentes ères ?
L'extraction lit l'en-tête d'année d'ère de chaque page et applique la formule de conversion correcte : Reiwa n = n + 2018, Heisei n = n + 1988, Showa n = n + 1925. Pour les pages de continuation sans en-tête d'année, le contexte d'ère est reporté depuis la page la plus récente avec un en-tête. Lorsqu'une frontière d'ère survient en milieu de livret — comme la transition Heisei 31 vers Reiwa 1 le 1er mai 2019 — le moteur détecte le changement d'ère à la page où l'en-tête bascule. Pour l'année frontière critique, les opérations sur les pages avec l'en-tête 平成 utilisent le décalage Heisei, et les opérations sur les pages avec l'en-tête 令和 utilisent le décalage Reiwa. Toutes les dates de la sortie sont au calendrier grégorien (aaaa-mm-jj) pour une compatibilité directe avec Yayoi Accounting, freee Accounting et MoneyForward Cloud Accounting.
Que se passe-t-il si la vérification du solde cumulé échoue sur plusieurs lignes ?
Plusieurs indicateurs REVIEW consécutifs remontent presque toujours à une cause unique — la première ligne signalée. Une virgule mal lue (¥30 000 → ¥3 000) sur la ligne 47 corrompt le solde de la ligne 47, ce qui corrompt la vérification de la ligne 48, et toutes les lignes suivantes jusqu'à la fin du livret. Corrigez la ligne 47 — corrigez le montant mal lu — et les lignes 48 à 280 se recalculent correctement. L'approche Computed Column détecte le problème au point de défaillance ; l'utilisateur corrige la première ligne signalée, et le reste se résout. Sans cette étape de vérification, l'erreur apparaît dans le logiciel comptable lorsque le bilan de vérification ne correspond pas au relevé bancaire — un rapprochement qui doit remonter chaque ligne pour trouver l'unique erreur de lecture à l'origine de la cascade. Le signalement à l'extraction est deux minutes de correction. Le signalement en comptabilité est une heure de travail de vérification forensique. Pour un traitement complet de ce problème et d'autres modes de défaillance courants de saisie de livret, consultez le guide des erreurs courantes.
Comment l'extraction gère-t-elle les annotations manuscrites en marge des pages du livret ?
Définissez une colonne nommée « Notes » dans votre schéma de sortie. Toute annotation manuscrite lisible près d'une ligne de transaction — une note comme 家賃 (loyer), 仕入 (achats), ou un nom de client écrit à côté d'une entrée 振込 — est capturée comme contexte supplémentaire lors de l'extraction. La qualité de l'écriture varie considérablement : une annotation claire au stylo à bille en kanji standard est généralement lisible ; une note au crayon estompée, écrite en biais et traversant les lignes imprimées du quadrillage, est moins fiable. Pour les livrets où les notes manuscrites sont la seule trace de catégorisation des transactions, la feuille de calcul extraite doit être vérifiée avec le livret physique ouvert pour les lignes où l'écriture était ambiguë. L'IA traite la majorité lisible — réduisant la vérification de chaque ligne à quelques lignes où la qualité de l'annotation était insuffisante.
Les données extraites du livret peuvent-elles être intégrées directement dans Yayoi Accounting pour la déclaration bleue (青色申告) ?
Oui — le résultat de l'extraction est une feuille de calcul Excel avec des dates au format aaaa-mm-jj, que Yayoi Accounting (弥生会計) accepte via la fonction Smart Transaction Import (スマート取引取込). Mappez les colonnes extraites au schéma de champs de Yayoi : date, compte débiteur (借方勘定科目), montant débiteur, compte créditeur (貸方勘定科目), montant créditeur et description (摘要). Si vous utilisez les colonnes calculées pour pré-classifier les transactions — en mappant 給与 à « Revenus salariaux » et 引落 à « Services publics » — les champs d'intitulé de compte sont déjà renseignés avant l'importation. Si vous préférez laisser le logiciel comptable gérer la classification, extrayez les codes de description bruts et configurez les règles de catégorisation automatique de Yayoi ou de freee pour les mapper aux bons intitulés de compte. Les plus de 270 points d'API de freee permettent des pipelines automatisés d'extraction vers la comptabilité sans transfert manuel de fichiers ; Yayoi et MoneyForward utilisent l'import CSV avec le format compatible Yayoi comme format intermédiaire courant. Les plateformes supplémentaires prises en charge incluent MJS Accounting, TKC, OBC Kanjo Bugyo, Sorimachi, EPSON et PCA — toutes acceptent le même format de transaction CSV.
Le livret physique est-il encore nécessaire après l'extraction ?
En vertu de la loi sur la conservation des livres électroniques (電子帳簿保存法), les copies numérisées de documents financiers peuvent servir de documents légalement recevables si elles respectent l'exigence de numérisation couleur à 200 dpi et les règles de conformité de conservation. Cependant, le livret physique reste le document original de référence. L'Agence nationale des impôts (国税庁) peut demander les originaux lors d'un contrôle fiscal. Bonne pratique : extrayez le livret en feuille de calcul pour votre flux de travail comptable, conservez les pages numérisées comme copie électronique du document, et gardez le livret physique pendant la période légale de conservation de sept ans. L'extraction remplace la saisie manuelle des données — elle ne remplace pas le document légal.
Vue d'ensemble : où s'inscrit l'extraction de livret bancaire dans le flux de travail comptable japonais
Le flux de travail de déclaration fiscale d'un entrepreneur individuel japonais a toujours été divisé en deux moitiés déconnectées. La première moitié — la saisie des données du livret bancaire — est manuelle : des pages étalées sur le bureau, des dates du calendrier impérial converties mentalement, des montants saisis dans un tableur ou un logiciel de comptabilité, ligne par ligne. La seconde moitié — la comptabilité et la déclaration — se déroule dans Yayoi, freee ou MoneyForward, où les données sont rapprochées, catégorisées et assemblées dans la déclaration bleue (青色申告決算書). Les deux moitiés sont reliées par une transcription manuelle, et la qualité de cette jonction détermine si la déclaration fiscale se rapproche du premier coup ou du cinquième.
L'extraction de livret remplace la jonction par transcription par une jonction automatisée. Les pages du livret deviennent des images ; les images deviennent un tableur avec des dates vérifiées, des transactions catégorisées et des écarts signalés ; le tableur s'importe dans le logiciel de comptabilité, où le reste du flux de travail est inchangé. L'étape d'extraction ne modifie pas le logiciel de comptabilité, le processus de déclaration fiscale ni la structure de déductions de la déclaration bleue — elle modifie le pipeline de données qui les alimente.
Dans le cadre de la réforme fiscale de 2027, ce pipeline a une valeur de déduction qui lui est attachée. Un déclarant qui reste sur papier — transcription manuelle du livret, déclaration papier — reçoit ¥100,000. Un déclarant qui numérise le pipeline — données de livret extraites alimentant le dépôt électronique e-Tax — reçoit ¥650,000, ou ¥750,000 avec des livres électroniques qualifiés. L'écart de ¥450,000–¥650,000 n'est pas un crédit d'impôt pour l'utilisation d'un logiciel d'extraction. C'est le système fiscal qui facture au coût réel le statu quo de la saisie manuelle des données de livret — et qui encourage le passage au numérique avant que la fenêtre de déduction ne se rétrécisse.
Le guide pratique de l'extraction d'un seul livret couvre la configuration à cinq colonnes et la première extraction. Le guide de traitement par lots gère la consolidation multi-années et multi-banques. L'analyse des problèmes explique pourquoi le statu quo manuel persiste malgré les outils disponibles. L'analyse des coûts quantifie la perte financière de la saisie manuelle continue. Le guide des erreurs courantes couvre la dérive du solde et la stratégie de vérification. Cet article — le hub — les relie en une vue d'ensemble unique : pourquoi l'extraction de livret existe, comment elle fonctionne, où elle s'inscrit dans la pile comptable, et pourquoi la réforme fiscale de 2027 en fait la voie par défaut pour tout entrepreneur individuel japonais qui dépose une déclaration bleue.