Extração de Caderneta Bancária Japonesa (通帳):
Guia Completo para Contabilidade e Declaração de Impostos
O sistema de caderneta bancária do Japão é único entre as economias desenvolvidas: um livreto físico impresso em tempo real por caixas eletrônicos usando cabeçotes de impressão matricial ou térmica, com cada transação registrada em um razão de cinco colunas com saldo corrente — e, para os 4,6 milhões de autônomos e pequenas empresas que o usam como registro financeiro principal, a fonte definitiva para a declaração de impostos. Em 2024, a Associação de Bancos do Japão (全国銀行協会) informou que os caixas eletrônicos dos grandes bancos ainda processam mais de 300 milhões de atualizações de cadernetas anualmente — mesmo com o aumento da adoção do banco digital. Para o problema da extração, esse volume significa algo específico: a caderneta não é um formato legado em extinção. É o formato que o fluxo de trabalho contábil precisa acomodar, e entender sua estrutura é o pré-requisito para automatizar a entrada de dados que hoje consome horas de transcrição manual a cada temporada de impostos.
Principais Conclusões
- Uma caderneta japonesa não é um extrato bancário — é um razão contínuo em que um dígito lido incorretamente na linha 47 corrompe todos os saldos subsequentes nas 153 linhas seguintes.
- A reforma tributária de 2027 reduz a dedução da declaração azul em papel de ¥550.000 para ¥100.000 — uma penalidade de ¥450.000 por continuar a mesma transcrição manual de caderneta que você sempre fez.
- O mesmo esquema de extração de cinco colunas lê cadernetas do MUFG, Japan Post Bank e cooperativas de crédito regionais em um único lote — porque a IA lê o que cada valor significa, em vez de onde ele está na página.
O Que Torna a Caderneta Bancária Japonesa um Alvo de Extração Único
Na maioria dos países, um extrato bancário é um resumo mensal — um PDF ou relatório impresso que cobre um período específico, com saldo inicial, saldo final e as transações intermediárias. Cada extrato é autossuficiente. Uma leitura incorreta no extrato de março não afeta o de abril.
Uma caderneta bancária japonesa (通帳, tsūchō) não é um extrato. É um livro-razão contínuo impresso por um caixa eletrônico — um registro físico contínuo mantido ao inserir o livreto em uma máquina que imprime novas linhas de transação diretamente na página usando uma cabeça de impressão matricial ou térmica. Cada linha contém cinco campos: data (月日), descrição (摘要, tekiyō), valor de saque (お支払金額), valor de depósito (お預り金額) e saldo atual (差引残高). Cada nova linha estende a cadeia. O saldo na linha 47 depende de todas as linhas 1 a 46 estarem corretas. Uma única leitura incorreta corrompe todos os saldos seguintes — um modo de falha chamado desvio de saldo (残高ずれ) que não tem equivalente em sistemas baseados em extratos.
Esse mecanismo de impressão cria um problema de extração de segunda ordem que a maioria das ferramentas genéricas de OCR nunca foi projetada para resolver. As páginas da caderneta não são documentos tipografados com densidade de tinta e alinhamento consistentes. São saídas de impressora — e a qualidade de impressão varia conforme o modelo do caixa eletrônico, a idade da fita de tinta e a limpeza da cabeça de impressão. Duas cadernetas do mesmo banco, atualizadas em caixas eletrônicos diferentes com seis meses de intervalo, podem ter escurecimento, alinhamento e legibilidade dos caracteres visivelmente diferentes. Uma cabeça de impressão matricial próxima do fim do ciclo de substituição produz caracteres mais finos com mais espaços entre os pontos — o mesmo código de 振込 (transferência bancária) que um caixa eletrônico limpo imprime em traços nítidos e contínuos torna-se uma constelação de pontos desconectados em um desgastado.
O formato da caderneta é regulamentado pela Associação de Bancos do Japão (全国銀行協会), que define padrões para troca de dados interbancários, interoperabilidade de caixas eletrônicos e a tarja magnética (磁気ストライプ) na contracapa que armazena as informações da conta. O caixa eletrônico lê essa tarja para identificar a conta e então imprime as linhas de transação — ou seja, a caderneta que você possui é uma saída de impressora, não um documento projetado. O formato é padronizado o suficiente para que o layout de cinco colunas seja consistente em todos os bancos do Japão. A qualidade de impressão não é. Essa tensão — formato padrão, execução variável — define o desafio de extração.
A diferença estrutural que importa para a extração: uma declaração de imposto de renda SA100 do Reino Unido ou uma declaração BAS australiana é um instantâneo — extraia uma vez, verifique contra uma fonte externa, pronto. Uma caderneta japonesa é uma cadeia — a extração é uma operação de continuidade em que a exatidão de cada linha depende de todas as linhas anteriores. Tratá-la como um documento baseado em extrato e processar as páginas de forma independente é a fonte mais comum de falha de extração em fluxos de trabalho contábeis japoneses.
O Panorama Bancário do Japão e o Que Ele Significa para a Extração de Passbooks
O Japão tem mais de 100 bancos que emitem passbooks físicos e, embora o layout de cinco colunas seja padrão, os detalhes de formatação — tamanho da fonte, espaçamento entre linhas, presença ou ausência de uma coluna de agência (取抜店) e se uma única transação ocupa uma linha ou se divide em duas — variam por instituição. Entender qual banco emitiu um passbook não é algo acadêmico. Isso determina quais desafios de extração esperar.
| Banco | Estilo do Passbook | Considerações de Extração | Papel no Mercado |
|---|---|---|---|
| MUFG Bank (三菱UFJ銀行) | Entrada de linha única, data à esquerda, coluna de código da agência (取抜店) incluída. Layout moderno e limpo. | Mais fácil de extrair — alinhamento consistente de matriz de pontos, cabeçalho do ano da era claramente impresso no topo da página. A coluna de código da agência é um dado extra para extrair ou ignorar, dependendo das necessidades contábeis. | Maior banco do Japão — 7,93% das empresas o têm como banco principal (segundo a Tokyo Shoko Research) |
| SMBC (三井住友銀行) | Formato de linha única semelhante ao MUFG. Pode abreviar o ano da era (R6 em vez de 令和6年). | Anos de era abreviados exigem atenção ao mapeamento de abreviações durante a conversão de datas. Fora isso, dificuldade comparável à do MUFG. | Participação de 6,34% como banco principal. Base corporativa forte. |
| Mizuho Bank (みずほ銀行) | Semelhante ao MUFG/SMBC. Formatação de impressão tradicional; anos de era frequentemente em caracteres de largura total. | Caracteres de ano de era em largura total podem ser lidos como caracteres separados por OCR de nível de caractere. A extração semântica baseada em IA evita isso lendo o campo de data como um todo. | Participação de 5,04% como banco principal. O mais tradicional dos três megabancos. |
| Japan Post Bank (ゆうちょ銀行) | Formato de duas linhas por transação — o campo de descrição quebra para uma segunda linha. Impressão compacta. Código da agência exibido apenas como números. | Formato padrão mais desafiador — a quebra em duas linhas faz com que OCR baseado em modelo treinado em formatos de linha única perca detalhes da descrição. A extração semântica lida com isso lendo as duas linhas como uma única unidade semântica. Também oferece um "caderno virtual" (デジタル通帳) para titulares de contas Yucho Direct+. | Rede nacional — mais de 24.000 caixas eletrônicos. Banco padrão para muitas contas pessoais. |
| Resona Bank (りそな銀行) | Formato de linha única. Forte foco em PMEs e clientes de varejo; cadernetas frequentemente incluem mensagens de serviço bancário suplementares após as linhas de transação. | Mensagens de serviço suplementares impressas entre lotes de transações podem ser lidas erroneamente como linhas de dados por ferramentas que não distinguem linhas de transação de texto informativo. | Parte do Grupo Resona — forte base de PMEs. Foco bancário regional. |
| Bancos Regionais e Cooperativas de Crédito (地方銀行・信用金庫) | Variados — a maioria segue o layout padrão de cinco colunas, mas com convenções de impressão localizadas, caixas eletrônicos mais antigos e formatos de ano de épocas anteriores (incluindo datas da Era Showa para contas de longa duração). | Caixas eletrônicos mais antigos significam maior variação na qualidade de impressão. Cadernetas abertas nos anos 1980 podem conter datas da Era Showa (昭和), exigindo conversão de Showa + 1925. A grande variação é o argumento mais forte para a extração semântica — você não pode criar um modelo para mais de 100 convenções de impressão regionais. | Atendem coletivamente uma parcela maior de PMEs do que os três megabancos juntos. |
A implicação prática para a extração é que um esquema de coluna única — Data, Descrição (摘要), Saque, Depósito, Saldo — funciona em todos esses bancos. A IA localiza cada valor lendo o que ele significa, não combinando coordenadas de pixels de um modelo. Um passbook do MUFG com impressão limpa de linha única e um passbook do Yucho com quebra de linha dupla produzem a mesma planilha de cinco colunas no mesmo lote, porque o mecanismo de extração lê a semântica dos campos, não as posições dos campos. Para um passo a passo detalhado dessa abordagem baseada em colunas, consulte o guia passo a passo para extração de passbooks japoneses.
A Arquitetura de Cinco Colunas do Passbook — e Por Que o OCR Genérico Falha em Cada Uma
O layout de cinco colunas do passbook é elegantemente simples na superfície e estruturalmente hostil ao OCR convencional em profundidade. Cada coluna apresenta um modo distinto de falha:
月日 (Data) — o problema do calendário imperial japonês
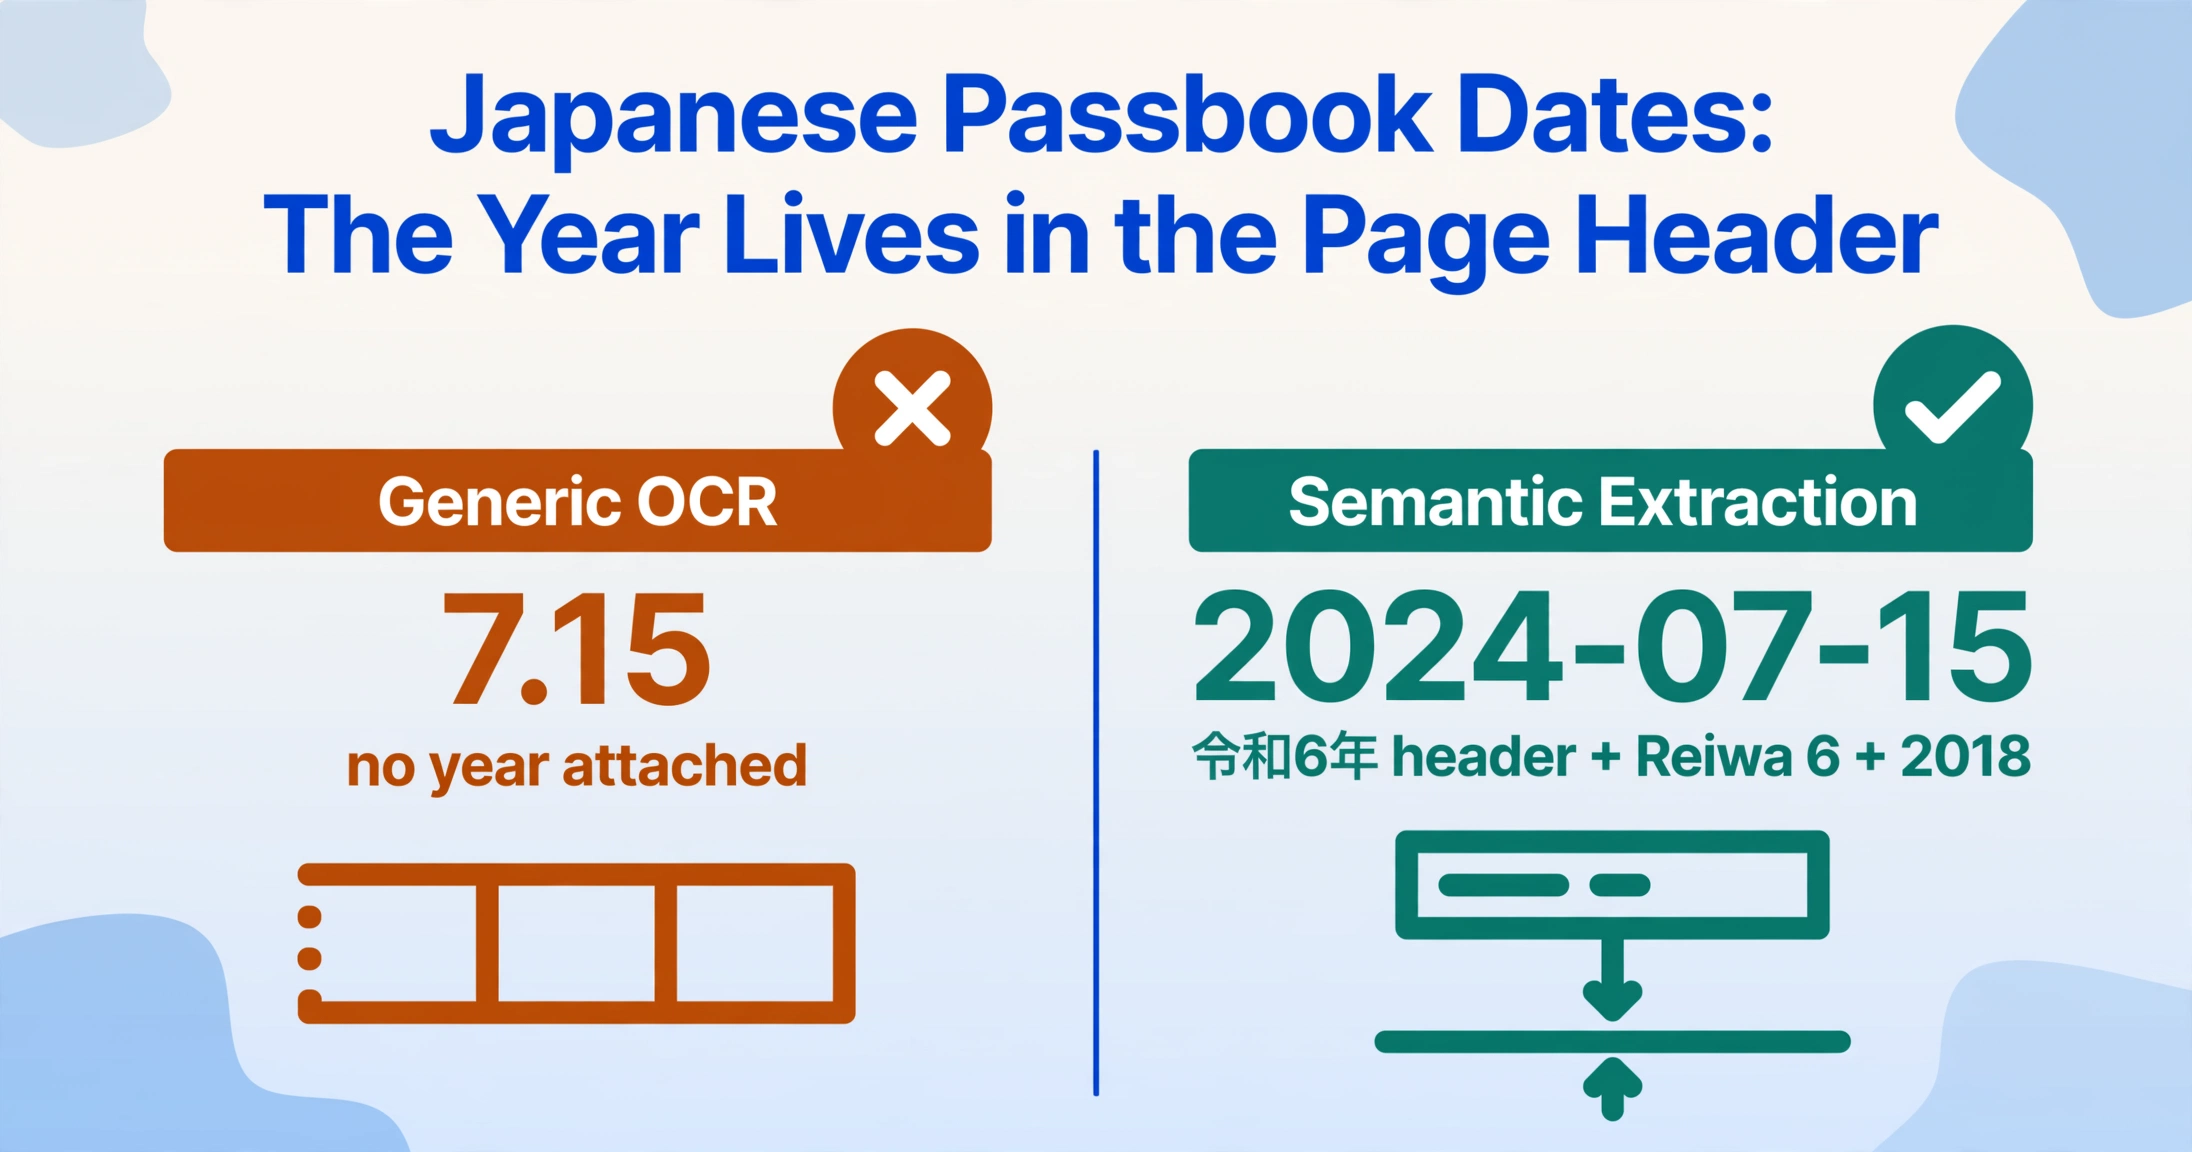
As datas da caderneta bancária usam o calendário imperial japonês: 令和 (Reiwa, iniciado em maio de 2019), 平成 (Heisei, 1989–2019), 昭和 (Showa, 1926–1989). Uma data impressa como R6.7.15 é 15 de julho de 2024 (ano 6 da era Reiwa + 2018). H30.3.31 é 31 de março de 2018 (ano 30 da era Heisei + 1988). O cabeçalho com o ano da era é impresso uma vez no topo da página — as linhas seguintes na mesma página e nas páginas de continuação trazem apenas mês e dia. Uma ferramenta OCR genérica que lê "7.15" isoladamente tem uma data sem ano, e um cabeçalho de ano três páginas atrás que ela nunca viu. A fórmula de conversão é determinística — Reiwa n = n + 2018, Heisei n = n + 1988, Showa n = n + 1925 — mas identificar qual fórmula aplicar a qual linha exige ler a relação entre o cabeçalho da página e suas linhas de conteúdo, não ler células individuais.
摘要 (Descrição) — a lacuna na classificação de códigos
A coluna de descrição usa códigos compactos que um leitor japonês categoriza imediatamente: 振込 (transferência bancária), ATM (transação em caixa eletrônico), 給与 (depósito de salário), 引落 (débito direto), 手数料 (tarifa bancária, normalmente ¥110–¥550), 利息 (juros), カード (transação com cartão). Uma extração bruta que reproduz fielmente esses códigos produz uma lista de transações. Uma extração que os classifica durante o processamento produz um livro-razão pré-categorizado. A lógica de classificação pode ser definida uma vez como uma coluna calculada: if Description contains "給与" then "Salary Income"; if contains "引落" then "Direct Debit"; if contains "手数料" then "Bank Fee"; if contains "利息" then "Interest Income". O código mais ambíguo é 振込 — uma transferência de ¥500.000 de uma empresa cliente conhecida é receita comercial; uma transferência de ¥15.000 de um indivíduo provavelmente é pessoal. Uma coluna calculada pode combinar a descrição com o valor para desambiguar: if Description="振込" and Amount > 100000 then "Business Income"; else "Personal Transfer".
お支払金額 / お預り金額 (Retirada / Depósito) — a armadilha da exclusão mútua
Uma determinada transação tem entrada na coluna de retirada ou na coluna de depósito — nunca em ambas. Essa exclusividade mútua é a base estrutural para a verificação de saldo, mas também cria uma falha comum de OCR: um depósito de ¥30.000 colocado na coluna de retirada por uma leitura desalinhada. O cálculo do saldo falhará nessa linha, e todas as linhas seguintes também falharão, porque saldo anterior + 0 (nenhum depósito lido) − ¥30.000 (coluna errada) não pode ser igual ao saldo atual impresso. Isso não é um erro aleatório — é um erro estruturado característico de formatos baseados em colunas com lógica de exclusão mútua, e OCR baseado em modelo que lê células por posição é particularmente vulnerável a ele.
差引残高 (Saldo Corrente) — o mecanismo de autoverificação
O saldo corrente é simultaneamente a maior vantagem de extração da caderneta e seu modo de falha mais perigoso. É uma vantagem porque a coluna de saldo carrega sua própria verificação interna: saldo anterior + depósito − saque deve ser igual ao saldo atual. Defina uma coluna calculada que verifique isso em cada linha durante a extração — Verificação de Saldo (Saldo Anterior + Depósito − Saque = Saldo Atual? 'OK' : 'REVISAR') — e você saberá quais linhas revisar antes que os dados entrem no seu software de contabilidade. É perigoso porque uma única leitura incorreta — uma vírgula perdida transformando ¥30.000 em ¥3.000 — corrompe o saldo daquela linha, o que corrompe a verificação da linha seguinte e de todas as linhas subsequentes. Uma caderneta com 280 transações e uma leitura incorreta na linha 47 produz 233 sinalizações de REVISAR — mas a causa raiz é a primeira linha sinalizada. Corrija a linha 47, e as linhas 48–280 serão recalculadas corretamente. Esse efeito cascata é o tema do guia de erros comuns de lançamento de dados em cadernetas, que aborda em profundidade a prevenção de desvios de saldo.
Tarja magnética (磁気ストライプ) — a dependência de hardware
A tarja magnética na contracapa armazena o número da conta, o código da agência e o tipo de conta. Quando uma caderneta é inserida em um caixa eletrônico, a máquina lê a tarja, identifica a conta, recupera transações não impressas e as imprime. A tarja é um componente lido por máquina — os dados da conta que ela contém não são impressos como texto na página da caderneta (a capa normalmente exibe o nome do titular em katakana, não o número da conta). Para fins de extração, o número da conta e as informações da agência são dados que devem vir do cartão bancário (キャッシュカード), das informações da capa (se disponíveis) ou de entrada manual — as páginas da caderneta não contêm esses dados em formato impresso legível por máquina. Uma tarja magnética danificada em uma caderneta antiga impede que o caixa eletrônico a leia para atualizações de impressão, mas não impede a extração das páginas já impressas — os dados de transação impressos são independentes da tarja.
O Fluxo de Extração: Da Caderneta Bancária em Papel à Planilha Pronta para Contabilidade
Extrair dados de cadernetas bancárias japonesas segue uma arquitetura de três etapas, igual quer esteja processando uma caderneta ou dez, um ano ou cinco. A etapa de configuração é feita uma única vez e reutilizada indefinidamente. A etapa de processamento é onde o motor de extração faz o trabalho. A etapa de verificação é onde você confirma que a saída está correta — e a columna de saldo autoverificável da caderneta torna esta etapa ordens de magnitude mais rápida que a conciliação manual.
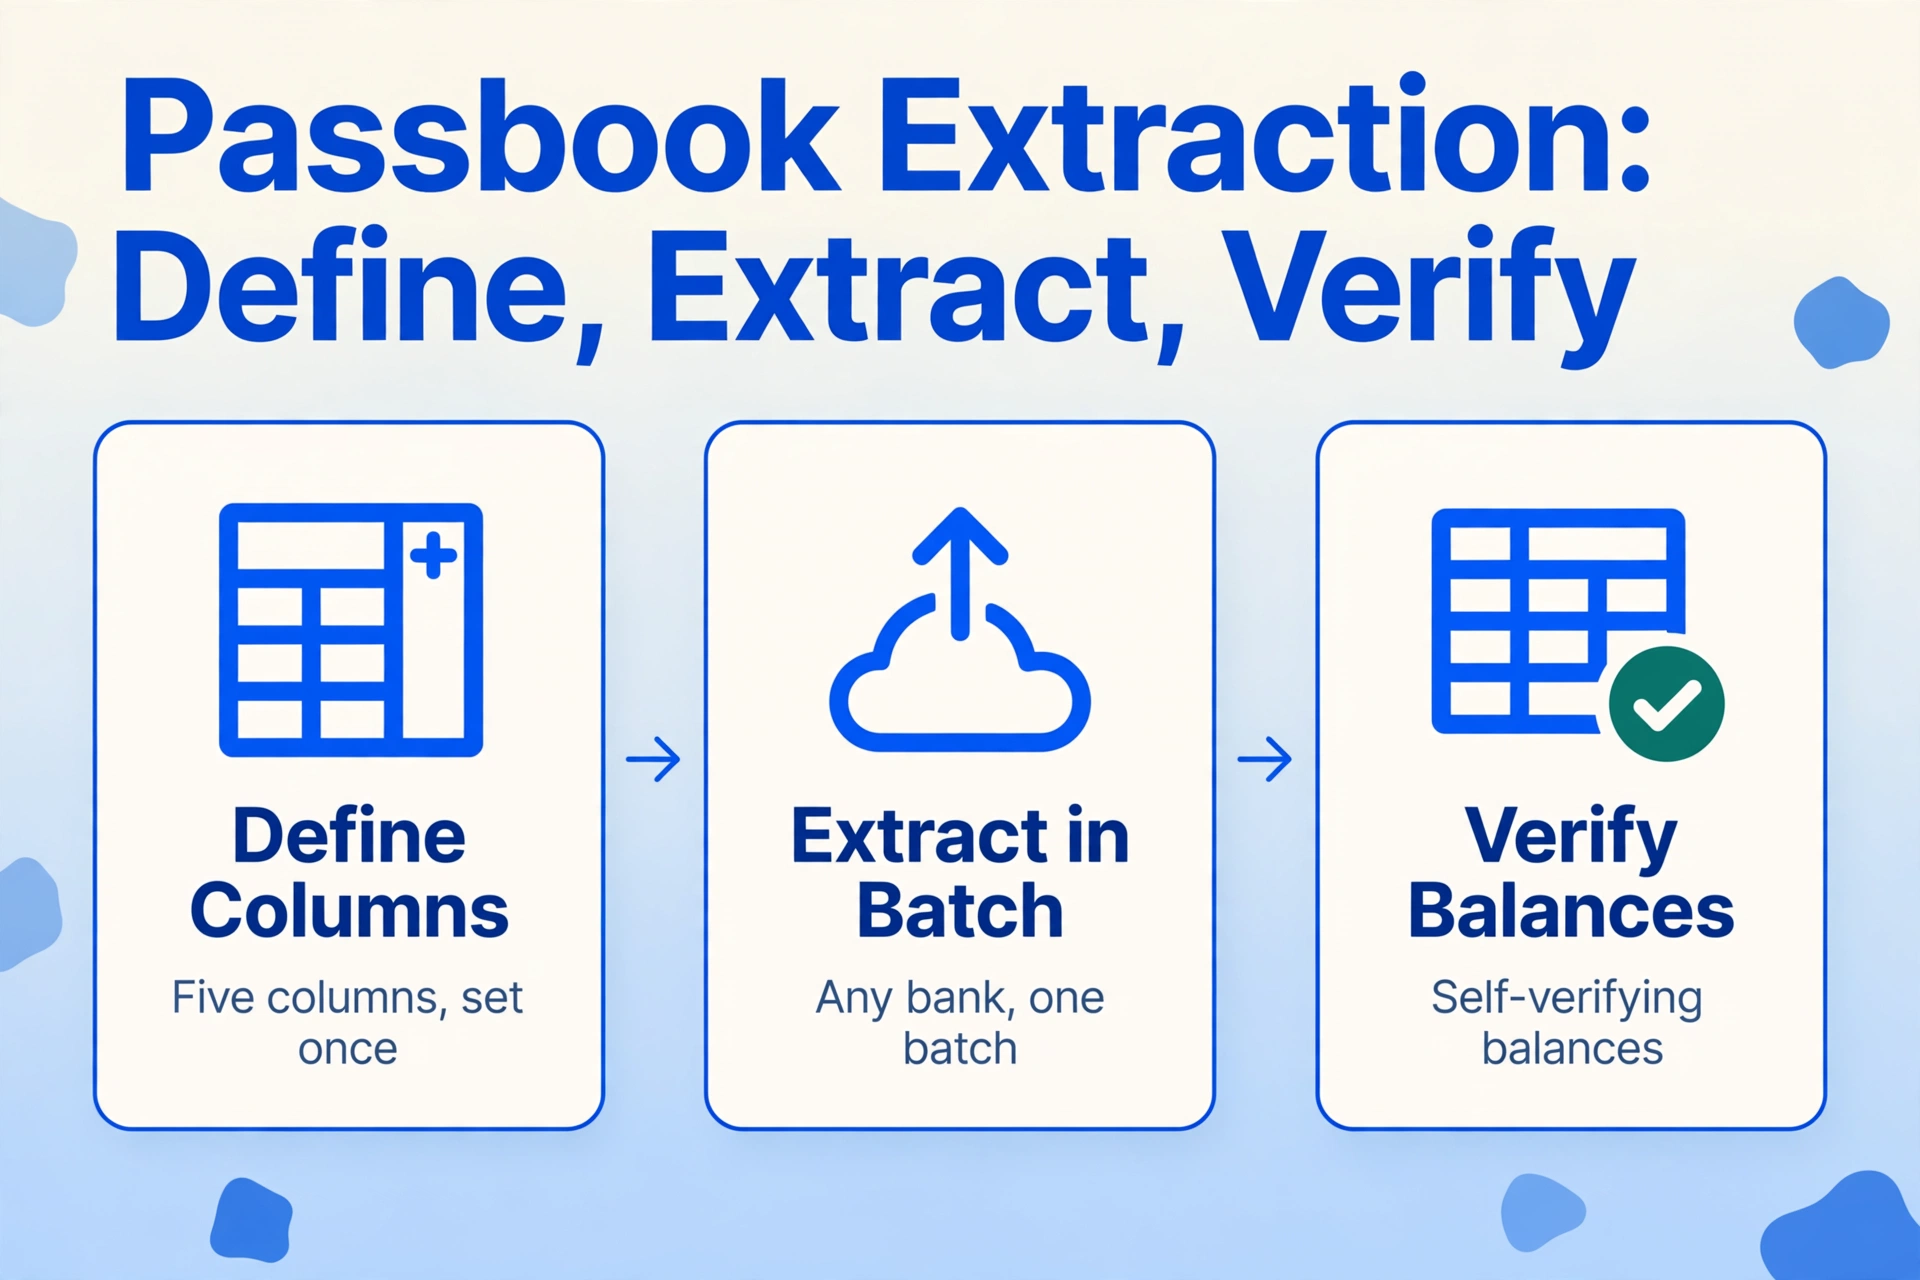
Definindo o esquema de saída. Você especifica cinco nomes de colunas — Data, Descrição (摘要), Retiro (お支払金額), Depósito (お預り金額), Saldo (差引残高) — e opcionalmente adiciona colunas calculadas para pré-classificación e verificação. Isto é Extraction de Colunas Personalizadas: você define a saída, e a IA mapea os campos impressos de cada caderneta às suas colunas lendo o que cada valor significa. O mesmo esquema de colunas funciona em todos os bancos — MUFG, SMBC, Mizuho, Japan Post Bank, cooperativas de crédito regionais — porque a IA lê a semântica dos campos, não coordenadas de píxeles. Um modelo configurado para o layout de linha única da MUFG falharía no layout de duas linhas da Japan Post Bank; um esquema semântico lida com ambos formatos no mesmo lote porque lê o significado de cada campo, não sua posição.
Enviando e processando. Digitalize ou fotografe as páginas da caderneta — incluindo capas frontales que mostram o nome do titular da conta, a contracapa para referência, e cada página de transações — e envie todas as imagens como um único lote. Cada página é processada independentemente com o mesmo esquema de colunas aplicado. As datas de era (和暦) são convertidas ao calendário gregoriano (aaaa-mm-dd) na capa de saída, aplicando o contexto de era correto por página. Os códigos de descrição são capturados como estão e opcionalmente classificados em categorias de gastos via colunas calculadas. O saldo corrente em cada linha é verificado contra o saldo da linha anterior durante a extração, sinalizando discrepâncias.
Exportando e verificando. A saída é um único arquivo Excel com uma linha por transação e cada campo em sua própria columna. A columna de verificação de saldo mostra OK em cada linha onde a matemática bate, e REVIEW em linhas com discrepâncias. Uma caderneta de três anos com aproximadamente 280 transações normalmente produz uma ou duas banderas de REVIEW — comas mal lidas, dígitos borrados em páginas antigas, ou uma correção manuscrita que confundió o lector de impressão. Corrija essas linhas, e as 278 restantes estão verificadas. A planilha importa diretamente em qualquer software de contabilidade japonês que aceite dados de transações CSV.
Os arquivos são processados com segurança e não são armazenados.
Para um passo a passo prático deste fluxo de trabalho — incluindo configuração de colunas, estratégias de digitalização de páginas e tratamento de erros comuns — o guia de extração de caderneta bancária única aborda cada etapa em detalhes. Para a estratégia de processamento em lote que lida com várias cadernetas ao longo de vários anos, o guia de processamento em lote aborda a mesclagem de várias cadernetas, a continuidade de datas de era entre páginas e a verificação de saldo em escala de lote. Para uma análise de por que o status quo de entrada manual persiste apesar das ferramentas digitais disponíveis, veja o mergulho profundo no problema da entrada manual de cadernetas japonesas.
Processamento em Lote: Quando uma Caderneta Vira uma Década de Dados
Uma caderneta bancária única contém aproximadamente 8–10 transações por página e 50–100 páginas, dando a ela uma vida útil típica de um a três anos, dependendo da atividade da conta. Um proprietário individual que declara a declaração azul (青色申告) e mantém cadernetas separadas para operações diárias (MUFG), reservas fiscais (Japan Post Bank) e folha de pagamento (cooperativa de crédito regional) tem três cadernetas para extrair — aproximadamente 36 páginas de transações impressas, 280 linhas, em três convenções de impressão.
A extração em lote lida com isso como uma única operação. As três cadernetas vão em um único upload com o mesmo esquema de cinco colunas. As datas de era são convertidas por página com o contexto de era correto — a caderneta do MUFG usando anos de era abreviados (R6), a caderneta do Japan Post Bank usando nomes de era completos (令和6年) e a caderneta da cooperativa de crédito contendo transações do final da era Showa de contas abertas nos anos 1980 — todas resolvendo para datas gregorianas na saída. O mesmo lote lida com anotações manuscritas nas margens (家賃 para aluguel, 仕入 para compras de estoque) como uma coluna suplementar de Notas, e as colunas calculadas pré-classificam as transações em categorias de gastos e sinalizam discrepâncias de saldo.
A alternativa — extração de página única com mesclagem manual — força o usuário a consolidar 36 arquivos de planilha separados, cruzar datas de era entre páginas onde o cabeçalho do ano aparece na página 1 e desaparece nas próximas sete páginas de continuação, e verificar manualmente a continuidade do saldo entre os limites das cadernetas. Para três anos de dados de três bancos, apenas a etapa de mesclagem manual leva aproximadamente duas a três horas. A abordagem em lote a elimina completamente — um upload, uma planilha, uma verificação. Para a arquitetura completa do fluxo de trabalho em lote, veja o guia de processamento em lote de páginas de caderneta em um livro-razão de gastos anual. Para uma análise quantificada do que a entrada manual de dados realmente custa aos pequenos empresários japoneses, a análise de custos coloca taxas de tempo e erro em números concretos.
Processamento em lote de passbooks vs. outros cenários de lote do mercado: uma prática no Reino Unido processando 80 declarações de autoavaliação SA100 lida com documentos independentes — cada declaração é um conjunto de dados autossuficiente, e uma leitura incorreta na declaração 47 afeta apenas a declaração 47. Um lote de passbooks processa páginas interdependentes — o saldo acumulado em cascata atravessa os limites das páginas, e uma leitura incorreta na página 3 corrompe silenciosamente a verificação de todas as páginas subsequentes. O lote deve estar ciente da estrutura de continuidade do tipo de documento, não apenas processar cada página como uma ilha. É por isso que a verificação de coluna calculada no momento da extração — não depois — é a diferença de engenharia entre um lote que produz saída verificada e um lote que produz dados que você precisa re-verificar completamente dentro do seu software de contabilidade.
No Ecossistema Contábil Japonês: Yayoi, freee, MoneyForward e Além
A planilha extraída é uma ponte — o destino é o software de contabilidade japonês. As três plataformas que dominam o mercado de proprietários individuais e pequenas empresas — Yayoi Accounting (弥生会計), freee Accounting (freee会計) e MoneyForward Cloud Accounting (マネーフォワード クラウド会計) — cobrem coletivamente a grande maioria dos declarantes da declaração azul. Cada uma tem um caminho de importação distinto, e a saída da extração deve corresponder às expectativas da plataforma de destino.
Yayoi Accounting (弥生会計). O líder de mercado, especialmente entre contadores fiscais (税理士). A importação é baseada em CSV via a função Smart Transaction Import (スマート取引取込). O Yayoi exige datas no formato yyyy-mm-dd — a conversão de era para gregoriano na etapa de extração deve estar completa antes da exportação. O Yayoi usa um "Formato de Importação Yayoi" proprietário (弥生インポート形式) para CSV, então a saída da extração deve ser mapeada para o esquema de campos do Yayoi: data, conta de débito (借方勘定科目), valor de débito, conta de crédito (貸方勘定科目), valor de crédito, descrição (摘要).
freee Accounting (freee会計). Nativo em nuvem com mais de 270 endpoints de API e suporte a MCP (Model Context Protocol) — o mais rico em API dos três. Importação via upload manual de CSV (取引 CSV インポート) usando o formato de modelo de importação do freee, ou via API do freee para ingestão automatizada. As regras de categorização automática do freee (自動登録ルール) podem ser configuradas para reconhecer códigos de descrição do passbook e atribuir títulos de conta (勘定科目) — o que significa que a etapa de extração pode focar na captura fiel dos códigos, e a lógica de classificação vive no mecanismo de regras do software de contabilidade.
MoneyForward Cloud Accounting (マネーフォワード クラウド会計). Importação via a função de migração de dados (他社ソフトデータの移行), selecionando o formato compatível com Yayoi como formato CSV intermediário. O ponto forte do MoneyForward é o painel unificado que combina dados do passbook, extratos de cartão de crédito e digitalizações de recibos em um quadro financeiro completo. Se a saída da extração usar o formato de data e colunas compatível com Yayoi, ela importa para o MoneyForward com o mesmo mapeamento de colunas.
Outras plataformas suportadas que aceitam a mesma importação CSV incluem: MJS Accounting (会計大将), TKC (séries FX2/MX), OBC Kanjo Bugyo (勘定奉行), Sorimachi Accounting King (会計王), EPSON Financial Support (財務応援R4) e PCA Accounting (PCA会計). O formato de cinco colunas do passbook é padronizado em todos os bancos japoneses, então a mesma saída de extração funciona com qualquer plataforma de contabilidade que importe dados de transações CSV — o formato de data, as colunas de valor e o campo de descrição são os mesmos independentemente do software receptor.
A principal distinção entre as três principais plataformas para planejamento de extração: Yayoi é somente CSV e exige que a extração produza um arquivo compatível com o Formato de Importação Yayoi. freee suporta tanto CSV quanto API — a rota via API permite pipelines automatizados de passbook para contabilidade sem transferência manual de arquivos. MoneyForward usa CSV no formato Yayoi como formato intermediário, então a saída da extração formatada para Yayoi funciona para ambas as plataformas. Para a maioria das pequenas empresas sem integração via API configurada, direcionar o Formato de Importação Yayoi como padrão de saída da extração oferece a maior compatibilidade.
A Conexão com a Declaração Azul: Por Que a Extração de Passbook se Torna Crítica Sob a Reforma Tributária de 2027
O esboço da reforma tributária japonesa (令和8年度税制改正の大綱), divulgado pela coalizão governante em 19 de dezembro de 2025, reestrutura a dedução especial da declaração azul (青色申告特別控除) — o incentivo fiscal que tornou a contabilidade de partidas dobradas viável para profissionais autônomos desde que o sistema foi introduzido. As mudanças entram em vigor para o ano fiscal de 2027 (declarado em 2028) e remodelam diretamente a economia da digitalização de passbooks.
Sob o sistema atual (2026), um declarante da declaração azul que mantém livros de partidas dobradas e declara eletronicamente recebe uma dedução de ¥650.000 da renda tributável. Declarantes em papel com livros de partidas dobradas recebem ¥550.000. A reforma de 2027 reduz a dedução em papel para ¥100.000 — uma redução de ¥450.000 — e introduz um nível superior de ¥750.000 para declarantes que usam declaração eletrônica e-Tax E mantêm livros eletrônicos qualificados (優良な電子帳簿) ou usam um sistema de computação eletrônica especificado com vinculação automática de dados (デジタルシームレス). A estrutura de três níveis se torna:
| Método de Declaração | Contabilidade | Dedução (2026) | Dedução (2027+) | Mudança |
|---|---|---|---|---|
| e-Tax + Livros Eletrônicos Qualificados ou Vinculação Automática | Partidas dobradas | — | ¥750.000 | Novo nível |
| Declaração Eletrônica e-Tax | Partidas dobradas | ¥650.000 | ¥650.000 | Sem mudança |
| Declaração em Papel | Partidas dobradas | ¥550.000 | ¥100.000 | −¥450.000 |
| Contabilidade Simplificada | Partidas simples | ¥100.000 | ¥100.000 (receita ≤ ¥10M) ¥0 (receita > ¥10M) | Restrição de receita adicionada |
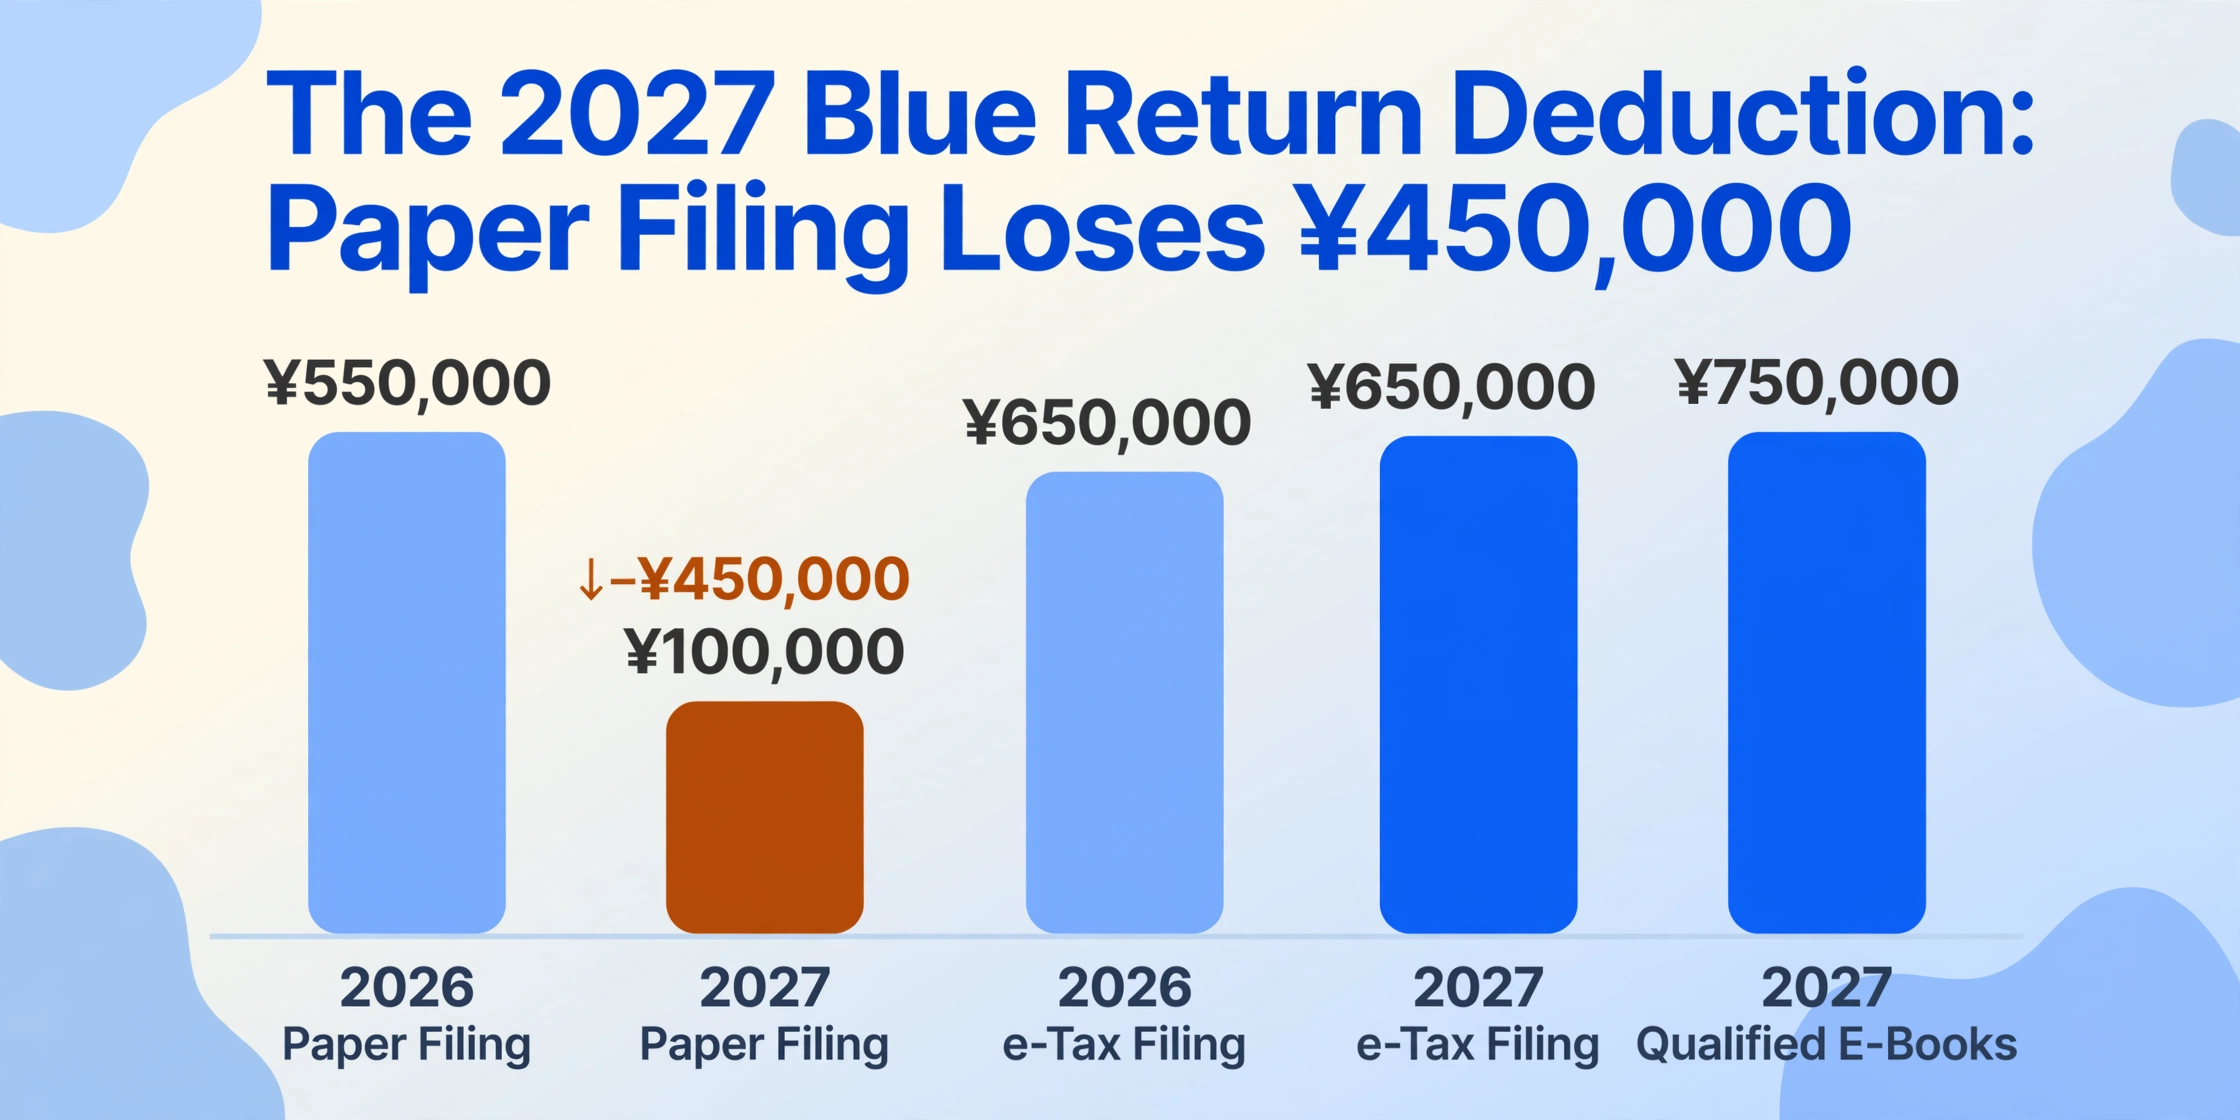
A conexão com a extração de passbook é direta. Um profissional autônomo que declarou em papel em 2026, com escrituração contábil pelo método de partidas dobradas e transcrição manual do passbook, obteve ¥550.000. Esse mesmo declarante, mantendo a mesma abordagem manual em 2027, recebe ¥100.000 — uma redução de ¥450.000 na dedução, equivalente a aproximadamente ¥90.000–¥180.000 em impostos adicionais, dependendo da alíquota marginal. A reforma torna o envio eletrônico via e-Tax obrigatório para o nível de ¥650.000 — o que significa que todo o pipeline contábil, da entrada de dados do passbook à entrega final da declaração, precisa ser digital. A extração de passbook não é uma melhoria de conveniência. É o primeiro elo de uma cadeia que agora determina o seu nível de dedução fiscal.
De acordo com a Lei de Preservação de Livros Eletrônicos (電子帳簿保存法), cópias digitalizadas de documentos financeiros podem servir como registros legalmente admissíveis se atenderem aos requisitos de resolução (200 dpi) e cor. A emenda de 2024 flexibilizou o requisito de carimbo de data/hora — documentos digitalizados armazenados em um sistema com histórico de edição e exclusão (訂正・削除履歴) não precisam mais de um carimbo de data/hora separado. Para a extração de passbook, isso significa que as páginas digitalizadas do passbook usadas como entrada para a extração também podem servir como cópia legal do registro, desde que a resolução de digitalização atenda ao requisito de 200 dpi em cores e os arquivos digitalizados sejam armazenados em um sistema compatível. O passbook físico ainda deve ser guardado pelo período legal de sete anos — a extração substitui a etapa de entrada manual de dados, não o registro legal.
Casos Especiais e Solução de Problemas
A maioria das extrações de cadernetas bancárias produz resultados limpos com uma ou duas linhas marcadas. Os casos especiais abaixo cobrem os cenários em que os resultados da extração precisam de revisão humana — saber como são antes de que ocorran transforma uma sessão frustrante de solução de problemas em uma correção de dois minutos.
Correções manuscritas (手書き通帳修正)
Os usuários de cadernetas às vezes corrigem entradas impressas à mano — um caixa do banco escreve uma correção ao lado de um montante mal impresso, ou o titular da conta anota na columna de descrição uma nota como 家賃 (alquiler) ou 仕入 (compra de inventário). Estas anotações fazem parte legal do registro e contêm informações críticas para a contabilidade. A extração com modelos de visão pode ler anotações manuscritas junto com texto impresso — mas a qualidade da caligrafía varia: uma anotação clara em kanji com caneta esferográfica é geralmente legible; uma nota desvanecida a lápiz em ângulo cruzando as linhas impressas da grade é menos confiable. Para cadernetas onde as notas manuscritas são o único registro da categorização de transações, a planilha extraída deve ser revisada com a caderneta física aberta para linhas onde a caligrafía era ambigua. A IA maneja a maioria legible; a revisão é manejo de excepciones, não linha por linha.
Ambiguidade do código de descrição (摘要あいまい性)
Uma 振込 (transferência) de ¥500.000 de uma empresa cliente conhecida é renda empresarial. Uma 振込 de ¥15.000 de um indivíduo é provavelmente pessoal. O código de descrição da caderneta sozinho não pode distinguir entre eles — a atribuição de categoria do software de contabilidade é o que faz. A extração deve capturar o código fielmente; a lógica de classificação vive a jusante, seja nas regras automáticas de categorização do software de contabilidade ou em uma coluna calculada que combina o código de descrição com o limite de montante. Um modo de erro comum é escrever regras de classificação demasiado agressivas — uma regra que classifica todas as 振込 acima de ¥100.000 como "Renda Empresarial" categorizará incorretamente um presente familiar único de ¥200.000. As regras devem ser conservadoras, classificando casos óbvios e deixando os ambiguos para revisão manual.
Páginas de caderneta danificadas ou degradadas
Cadernetas com cinco ou mais anos podem ter páginas com impressão desvanecida, danos por água, borrones de tinta ou dobras que atravessam a área de transações. Para impressão desvanecida, escanear a maior resolução (300 dpi ou superior) e ajustar o contraste antes da extração melhora a legibilidade. Para dobras que distorsionam os caracteres de matriz de pontos, fotografiar a página sob luz natural desde um ângulo pode reduzir a sombra da dobra. Para páginas onde o dano torna uma linha de transação ilegible — tipicamente 1–2 linhas em uma caderneta de 280 — marque a linha para entrada manual com base na caderneta física. A extração maneja as outras 278 linhas. A falha da linha danificada é visível na columna de verificação: uma bandera REVISAR em uma linha onde a matemática do saldo não bate, frequentemente causada por um dígito de montante parcialmente ilegible.
Cadernetas bancárias digitais (デジタル通帳) vs. cadernetas físicas
Alguns bancos — notadamente o Japan Post Bank através de seu serviço Yucho Direct+ — oferecem cadernetas bancárias digitais que substituem o livreto físico por uma visualização de transações baseada na web e exportação de CSV para download. No entanto, o formato de exportação, o intervalo de datas e as colunas disponíveis variam de acordo com o banco e muitas vezes não correspondem ao formato esperado pelo software de contabilidade. Um CSV de caderneta bancária digital do Japan Post Bank pode exportar datas no calendário gregoriano, enquanto a caderneta física da mesma conta impressa em um caixa eletrônico usa datas do calendário imperial — e o CSV pode cobrir apenas os últimos 12 meses, enquanto a caderneta física tem todo o histórico da conta. Para declarantes da declaração azul cujo software de contabilidade espera um formato específico de CSV, o caminho de extração — escanear a caderneta física ou capturar a tela da visualização da caderneta digital — fornece saída consistente em formato para qualquer fonte de dados, com a conversão de calendário imperial para gregoriano tratada na camada de saída, independentemente do formato de entrada.
Cadernetas com múltiplos calendários imperiais e cabeçalhos de ano ausentes
Uma caderneta aberta em 2018 e renovada em 2024 contém transações que abrangem dois calendários imperiais: 平成 (Heisei) e 令和 (Reiwa). A fronteira entre os calendários — 平成31年 (janeiro–abril de 2019) fazendo a transição para 令和元年 (maio–dezembro de 2019) — fica no meio da caderneta. A extração deve detectar a mudança de calendário na página onde o cabeçalho do ano muda de 平成 para 令和 e aplicar o deslocamento correto por transação. Da mesma forma, páginas de continuação dentro da mesma caderneta que não reimprimem o cabeçalho do ano dependem do contexto transmitido da página mais recente com um cabeçalho. Se a página 5 imprimir 令和6年 e as páginas 6–8 imprimirem apenas mês e dia, a extração aplica o contexto de 令和6年 a todas as transações das páginas 5 a 8 — e quando a página 9 imprime 令和7年 após a fronteira de 1º de janeiro, o contexto é atualizado. Uma transmissão perdida produz transações com datas flutuantes ("7.15" sem ano) que não podem ser colocadas em uma linha do tempo e farão com que a importação do software de contabilidade falhe.
Perguntas Frequentes
A extração de passbook consegue lidar com todos os bancos japoneses no mesmo lote?
Sim — um passbook do MUFG com entrada de linha única, um passbook do Japan Post Bank (ゆうちょ銀行) com formato de duas linhas por transação, e um passbook de cooperativa de crédito regional (信用金庫) com impressão compacta podem ser todos carregados no mesmo lote e produzir uma planilha unificada com colunas consistentes. A extração semântica lê o que cada valor significa — uma data é uma data, seja impressa como R6.7.15 em um passbook ou 令和6年7月15日 em outro. O mesmo esquema de cinco colunas funciona em todos os formatos. A conversão de era para calendário gregoriano é aplicada por página com base no cabeçalho de era detectado em cada página, então um lote contendo passbooks de diferentes eras — 平成 no passbook do MUFG, 令和 no passbook do Japan Post Bank, 昭和 em um passbook antigo de cooperativa de crédito — resolve todas as datas para aaaa-mm-dd na saída.
Como a extração lida com datas do calendário imperial japonês (和暦) que abrangem diferentes eras?
A extração lê o cabeçalho do ano da era de cada página e aplica a fórmula de conversão correta: Reiwa n = n + 2018, Heisei n = n + 1988, Showa n = n + 1925. Para páginas de continuação sem cabeçalho de ano, o contexto da era é transportado da página mais recente com cabeçalho. Quando uma fronteira de era ocorre no meio do passbook — como Heisei 31 transicionando para Reiwa 1 em 1º de maio de 2019 — o mecanismo detecta a mudança de era na página onde o cabeçalho muda. Para o ano crítico de fronteira, transações em páginas com cabeçalho 平成 usam o offset de Heisei, e transações em páginas com cabeçalho 令和 usam o offset de Reiwa. Todas as datas na saída são gregorianas (aaaa-mm-dd) para compatibilidade direta com Yayoi, freee e MoneyForward.
O que acontece se a verificação do saldo acumulado falhar em várias linhas?
Múltiplos sinalizadores REVIEW consecutivos quase sempre remontam a uma única causa raiz — a primeira linha sinalizada. Uma vírgula mal lida (¥30.000 → ¥3.000) na linha 47 corrompe o saldo na linha 47, o que corrompe a verificação na linha 48, e cada linha subsequente até o final do passbook. Corrija a linha 47 — corrija o valor mal lido — e as linhas 48 a 280 recalculam corretamente. A abordagem de coluna calculada detecta o problema no ponto de falha; o usuário corrige a primeira linha sinalizada e o restante se resolve. Sem esta etapa de verificação, o erro aparece dentro do software de contabilidade quando o balancete não corresponde ao extrato bancário — uma conciliação que deve rastrear retroativamente cada linha para encontrar a única leitura incorreta que iniciou a cascata. O sinalizador no momento da extração são dois minutos de correção. O sinalizador no momento da contabilidade é uma hora de contabilidade forense. Para um tratamento completo deste e de outros modos comuns de falha na entrada de dados de passbook, consulte o guia de erros comuns.
Como a extração lida com anotações manuscritas nas margens das páginas do passbook?
Defina uma coluna chamada "Notes" no seu esquema de saída. Qualquer anotação manuscrita legível perto de uma linha de transação — uma nota como 家賃 (aluguel), 仕入 (estoque) ou o nome de um cliente escrito ao lado de um lançamento de 振込 — é capturada como contexto adicional durante a extração. A qualidade da caligrafia varia significativamente: uma anotação clara de caneta esferográfica em kanji padrão geralmente é legível; uma nota desbotada a lápis, escrita em ângulo e cruzando as linhas impressas da grade, é menos confiável. Para passbooks em que as anotações manuscritas são o único registro da categorização das transações, a planilha extraída deve ser revisada com o passbook físico aberto nas linhas em que a caligrafia estava ambígua. A IA lida com a maioria legível — reduzindo a revisão de todas as linhas para apenas algumas em que a qualidade da anotação foi insuficiente.
Os dados extraídos do passbook podem ir diretamente para o Yayoi Accounting para a declaração 青色申告?
Sim — a saída da extração é uma planilha Excel com datas no formato yyyy-mm-dd, que o Yayoi Accounting (弥生会計) aceita pela função Smart Transaction Import (スマート取引取込). Mapeie as colunas extraídas para o esquema de campos do Yayoi: data, conta de débito (借方勘定科目), valor de débito, conta de crédito (貸方勘定科目), valor de crédito e descrição (摘要). Se você usar coluna calculada para pré-classificar transações — mapeando 給与 para "Salary Income" e 引落 para "Utilities" — os campos de título de conta já estarão preenchidos antes da importação. Se preferir deixar o software de contabilidade lidar com a classificação, extraia os códigos de descrição brutos e configure as regras de categorização automática do Yayoi ou do freee para mapeá-los aos títulos de conta corretos. Os mais de 270 endpoints de API do freee permitem pipelines automatizados de extração para contabilidade sem transferência manual de arquivos; Yayoi e MoneyForward usam importação CSV com o formato compatível com Yayoi como formato intermediário comum. Outras plataformas suportadas incluem MJS Accounting, TKC, OBC Kanjo Bugyo, Sorimachi, EPSON e PCA — todas aceitam o mesmo formato de transação CSV.
Ainda preciso do passbook físico após a extração?
De acordo com a Lei de Preservação de Livros Eletrônicos (電子帳簿保存法), cópias digitalizadas de documentos financeiros podem servir como registros legalmente admissíveis se atenderem ao requisito de digitalização colorida de 200 dpi e às regras de conformidade de armazenamento. No entanto, o passbook físico continua sendo o documento original definitivo. A Agência Tributária Nacional (国税庁) pode solicitar os originais durante uma auditoria fiscal. Boa prática: extraia o passbook para planilha no seu fluxo de trabalho contábil, retenha as páginas digitalizadas como cópia do registro eletrônico e guarde o passbook físico pelo período legal de retenção de documentos de sete anos. A extração substitui a etapa de entrada manual de dados — ela não substitui o registro legal.
O Panorama Completo: Onde a Extração de Passbook se Encaixa no Fluxo de Trabalho Contábil Japonês
O fluxo de trabalho de declaração de impostos de um profissional autônomo japonês historicamente tem duas metades desconectadas. A primeira metade — entrada de dados do passbook — é manual: páginas espalhadas sobre uma mesa, datas do calendário imperial japonês convertidas mentalmente, valores digitados em uma planilha ou software de contabilidade, uma linha por vez. A segunda metade — contabilidade e declaração — acontece dentro do Yayoi, freee ou MoneyForward, onde os dados são conciliados, categorizados e montados na declaração azul (青色申告決算書). As duas metades são unidas por transcrição manual, e a qualidade dessa união determina se a declaração de imposto concilia na primeira tentativa ou na quinta.
A extração de passbook substitui a transcrição manual por uma automatizada. As páginas do passbook tornam-se imagens; as imagens tornam-se uma planilha com datas verificadas, transações categorizadas e discrepâncias sinalizadas; a planilha é importada para o software de contabilidade, onde o restante do fluxo de trabalho permanece inalterado. A etapa de extração não altera o software de contabilidade, o processo de declaração de impostos ou a estrutura de deduções da declaração azul — ela altera o pipeline de dados que alimenta esses elementos.
Sob a reforma tributária de 2027, esse pipeline tem um valor de dedução associado. Um declarante que permanece no papel — transcrição manual do passbook, declaração em papel — recebe ¥100.000. Um declarante que digitaliza o pipeline — dados extraídos do passbook alimentando a declaração eletrônica e-Tax — recebe ¥650.000, ou ¥750.000 com livros eletrônicos qualificados. A diferença de ¥450.000–¥650.000 não é um crédito fiscal por usar software de extração. É o sistema tributário precificando o status quo da entrada manual de dados do passbook pelo seu custo real — e incentivando a mudança para o digital antes que a janela de dedução se estreite.
O guia prático para extração de um único passbook cobre a configuração de cinco colunas e a primeira extração. O guia de processamento em lote lida com a consolidação de vários anos e vários bancos. A análise de problemas explica por que o status quo manual persiste apesar das ferramentas disponíveis. A análise de custos quantifica o dreno financeiro da entrada manual contínua. O guia de erros comuns cobre o desvio de saldo e a estratégia de verificação. Este artigo — o hub — conecta todos eles em um panorama único de por que a extração de passbook existe, como funciona, onde se encaixa na pilha contábil e por que a reforma tributária de 2027 a torna o caminho padrão para todo profissional autônomo japonês que declara a declaração azul.