Japanisches Bankpassbuch (通帳) – Extraktion:
Vollständiger Leitfaden für Buchhaltung & Steuererklärung
Das japanische Bankpassbuch-System ist unter den entwickelten Volkswirtschaften einzigartig: ein physisches Heft, das in Echtzeit von Geldautomaten mit Punktmatrix- oder Thermodruckköpfen bedruckt wird und jede Transaktion als fünfspaltiges Hauptbuch mit laufendem Saldo führt – und für die 4,6 Millionen Einzelunternehmer und kleinen Unternehmen, die es als primäres Finanzdokument nutzen, die maßgebliche Quelldatei für die Steuererklärung darstellt. Im Jahr 2024 meldete der Japanische Bankenverband (全国銀行協会), dass die Geldautomaten großer Banken jährlich weiterhin über 300 Millionen Passbuch-Aktualisierungen verarbeiten – selbst während die Nutzung des Online-Bankings steigt. Für das Extraktionsproblem bedeutet diese Menge etwas Konkretes: Das Passbuch ist kein verschwindendes Legacy-Format. Es ist das Format, das der Buchhaltungs-Workflow berücksichtigen muss, und das Verständnis seiner Struktur ist die Voraussetzung für die Automatisierung der Dateneingabe, die derzeit jede Steuersaison Stunden manueller Übertragung in Anspruch nimmt.
Wichtigste Erkenntnisse
- Ein japanisches Passbuch ist kein Kontoauszug – es ist ein laufendes Hauptbuch, bei dem eine falsch gelesene Ziffer in Zeile 47 jeden nachfolgenden Saldo auf allen 153 folgenden Zeilen verfälscht.
- Die Steuerreform 2027 senkt den Abzug für die papierbasierte blaue Steuererklärung von ¥550.000 auf ¥100.000 – eine Strafe von ¥450.000 für die Fortsetzung derselben manuellen Passbuch-Übertragung, die Sie bisher immer gemacht haben.
- Dasselbe Fünf-Spalten-Extraktionsschema liest Passbücher von MUFG, Japan Post Bank und regionalen Kreditgenossenschaften in einem Batch – weil die KI liest, was jeder Wert bedeutet, und nicht, wo er auf der Seite steht.
Was das japanische Passbuch zu einem einzigartigen Extraktionsziel macht
In den meisten Ländern ist ein Kontoauszug eine monatliche Zusammenfassung – ein PDF- oder Papierdokument, das einen bestimmten Zeitraum abdeckt, mit Anfangsbestand, Endbestand und den dazwischenliegenden Transaktionen. Jeder Auszug ist in sich abgeschlossen. Ein Lesefehler im März-Auszug wirkt sich nicht auf den April-Auszug aus.
Ein japanisches Bankpassbuch (通帳, tsūchō) ist kein Auszug. Es ist ein fortlaufendes Kassenbuch, das von einem Geldautomaten gedruckt wird – eine kontinuierliche physische Aufzeichnung, die gepflegt wird, indem das Heftchen in ein Gerät eingelegt wird, das neue Transaktionszeilen direkt auf die Seite druckt, mit einem Nadeldrucker- oder Thermodruckkopf. Jede Zeile enthält fünf Felder: Datum (月日), Beschreibung (摘要, tekiyō), Abhebungsbetrag (お支払金額), Einzahlungsbetrag (お預り金額) und laufenden Saldo (差引残高). Jede neue Zeile verlängert die Kette. Der Saldo in Zeile 47 hängt davon ab, dass die Zeilen 1 bis 46 alle korrekt sind. Ein einziger Lesefehler korrumpiert jeden folgenden Saldo – ein Fehlermodus namens Saldo-Drift (残高ずれ), der in auszugsbasierter Bankenwelt kein Gegenstück hat.
Dieser Druckmechanismus erzeugt ein Problem zweiter Ordnung für die Extraktion, das die meisten generischen OCR-Werkzeuge nie bewältigen sollten. Passbuchseiten sind keine gesetzten Dokumente mit konsistenter Tintendichte und Ausrichtung. Sie sind Druckerausgabe – und die Druckqualität variiert je nach ATM-Modell, Farbbandalter und Sauberkeit des Druckkopfs. Zwei Passbücher derselben Bank, die an verschiedenen ATMs im Abstand von sechs Monaten aktualisiert wurden, können deutlich unterschiedliche Zeichendunkelheit, Ausrichtung und Lesbarkeit aufweisen. Ein Nadeldruckkopf, der sich dem Ende seines Austauschzyklus nähert, erzeugt dünnere Zeichen mit mehr Lücken zwischen den Punkten – derselbe 振込 (Banküberweisungs-)Code, den ein sauberer ATM in klaren, durchgehenden Strichen druckt, wird auf einem abgenutzten zu einer Konstellation getrennter Punkte.
Das Passbuchformat wird von der Japanese Bankers Association (全国銀行協会) geregelt, die Standards für den Interbanken-Datenaustausch, die ATM-Interoperabilität und den Magnetstreifen (磁気ストライプ) auf der Rückseite festlegt, der Kontoinformationen speichert. Der ATM liest diesen Streifen, um das Konto zu identifizieren, und druckt dann Transaktionszeilen – das bedeutet, dass das Passbuch, das Sie halten, eine Druckerausgabe ist, kein gestaltetes Dokument. Das Format ist standardisiert genug, dass das Fünf-Spalten-Layout bei jeder Bank in Japan konsistent ist. Die Druckqualität ist es nicht. Diese Spannung – Standardformat, variable Ausführung – definiert die Extraktionsherausforderung.
Der strukturelle Unterschied, der für die Extraktion wichtig ist: eine britische SA100-Selbstbewertungssteuererklärung oder ein australischer BAS-Auszug ist eine Momentaufnahme – einmal extrahieren, gegen eine externe Quelle prüfen, fertig. Ein japanisches Passbuch ist eine Kette – Extraktion ist eine Kontinuitätsoperation, bei der die Korrektheit jeder Zeile von jeder vorherigen Zeile abhängt. Es wie ein auszugsbasiertes Dokument zu behandeln und Seiten unabhängig zu verarbeiten, ist die häufigste Quelle für Extraktionsfehler in japanischen Buchhaltungsworkflows.
Japans Bankenlandschaft und was sie für die Passbuch-Extraktion bedeutet
In Japan geben über 100 Banken physische Passbücher aus, und obwohl das Fünf-Spalten-Layout Standard ist, variieren die Formatierungsdetails – Schriftgröße, Zeilenabstand, das Vorhandensein oder Fehlen einer Filialspalte (取抜店) und ob eine einzelne Transaktion eine Zeile belegt oder auf zwei umbricht – je nach Institut. Zu verstehen, welche Bank ein Passbuch ausgestellt hat, ist nicht akademisch. Es bestimmt, welche Extraktionsherausforderungen zu erwarten sind.
| Bank | Passbuch-Stil | Extraktionsüberlegungen | Marktrolle |
|---|---|---|---|
| MUFG Bank (三菱UFJ銀行) | Einzeilige Buchungen, Datum links, Filialcode-Spalte (取抜店) enthalten. Sauberes, modernes Layout. | Am einfachsten zu extrahieren – konsistente Punktmatrix-Ausrichtung, Ära-Jahreskopfzeile oben auf der Seite klar gedruckt. Die Filialcode-Spalte ist ein zusätzlicher Datenpunkt, der je nach Buchhaltungsbedarf extrahiert oder ignoriert werden kann. | Japans größte Bank – 7,93 % der Unternehmen als Hauptbank (laut Tokyo Shoko Research) |
| SMBC (三井住友銀行) | Ähnliches einzeiliges Format wie MUFG. Ära-Jahr kann abgekürzt werden (R6 statt 令和6年). | Abgekürzte Ära-Jahre erfordern Kenntnis der Abkürzungszuordnung bei der Datumsumrechnung. Ansonsten vergleichbarer Schwierigkeitsgrad wie MUFG. | 6,34 % Hauptbank-Anteil. Starke Unternehmensbasis. |
| Mizuho Bank (みずほ銀行) | Ähnlich wie MUFG/SMBC. Traditionelles Druckformat; Ära-Jahre oft in Vollbreitenzeichen. | Vollbreiten-Ära-Jahreszeichen können von zeichenbasierter OCR als einzelne Zeichen gelesen werden. KI-basierte semantische Extraktion vermeidet dies, indem das Datumsfeld als Ganzes gelesen wird. | 5,04 % Hauptbank-Anteil. Die traditionellste der drei Megabanken. |
| Japan Post Bank (ゆうちょ銀行) | Zweizeiliges Format pro Buchung – das Beschreibungsfeld läuft in eine zweite Zeile um. Kompakter Druck. Filialcode nur als Zahlen angezeigt. | Anspruchsvollstes Standardformat – durch den zweizeiligen Umbruch übersieht vorlagenbasierte OCR, die auf einzeilige Formate trainiert ist, Beschreibungsdetails. Semantische Extraktion behandelt die beiden Zeilen als eine semantische Einheit. Bietet außerdem ein „digitales Passbuch“ (デジタル通帳) für Yucho Direct+ Kontoinhaber. | Bundesweites Netz – über 24.000 Geldautomaten. Standardbank für viele Privatkonten. |
| Resona Bank (りそな銀行) | Einzeiliges Format. Starker Fokus auf KMU- und Privatkunden; Passbücher enthalten nach Buchungszeilen oft zusätzliche Bankdienstleistungs-Hinweise. | Zusätzliche Dienstleistungshinweise zwischen Buchungsblöcken können von Tools, die Buchungszeilen nicht von Informationstext unterscheiden, fälschlich als Datenzeilen gelesen werden. | Teil der Resona Group – starke KMU-Basis. Regionaler Bankfokus. |
| Regionalbanken & Kreditgenossenschaften (地方銀行・信用金庫) | Variiert — die meisten folgen dem Standard-Fünf-Spalten-Layout, jedoch mit lokalisierten Druckkonventionen, älterer ATM-Hardware und Datumsformaten aus früheren Epochen (einschließlich Showa-Daten für langjährige Konten). | Ältere ATM-Hardware bedeutet eine höhere Varianz in der Druckqualität. In den 1980er Jahren eröffnete Passbücher können Showa-Daten (昭和) enthalten, die eine Umrechnung von Showa + 1925 erfordern. Die große Varianz ist das stärkste Argument für die semantische Extraktion — Sie können keine Vorlage für über 100 regionale Druckkonventionen erstellen. | Zusammen bedienen sie einen größeren Anteil an KMU als die drei Megabanken zusammen. |
Die praktische Konsequenz für die Extraktion ist, dass ein Ein-Spalten-Schema – Datum, Beschreibung (摘要), Abhebung, Einzahlung, Saldo – bei allen diesen Banken funktioniert. Die KI lokalisiert jeden Wert, indem sie liest, was er bedeutet, nicht indem sie die Pixelkoordinaten einer Vorlage abgleicht. Ein Passbuch der MUFG mit sauberem einzeiligem Druck und ein Yucho-Passbuch mit zweizeiligem Umbruch erzeugen im selben Batch dieselbe Fünf-Spalten-Tabelle, weil die Extraktions-Engine Feldsemantik liest, nicht Feldpositionen. Für eine detaillierte Anleitung zu diesem spaltenbasierten Ansatz siehe die Schritt-für-Schritt-Anleitung zur japanischen Passbuch-Extraktion.
Die Fünf-Spalten-Architektur des Passbuchs – und warum generische OCR an jeder einzelnen scheitert
Das Fünf-Spalten-Layout des Passbuchs ist an der Oberfläche elegant einfach und in der Tiefe strukturell feindlich gegenüber konventioneller OCR. Jede Spalte weist eine eigene Fehlerart auf:
月日 (Datum) – das Problem der japanischen Ära-Datumsangabe
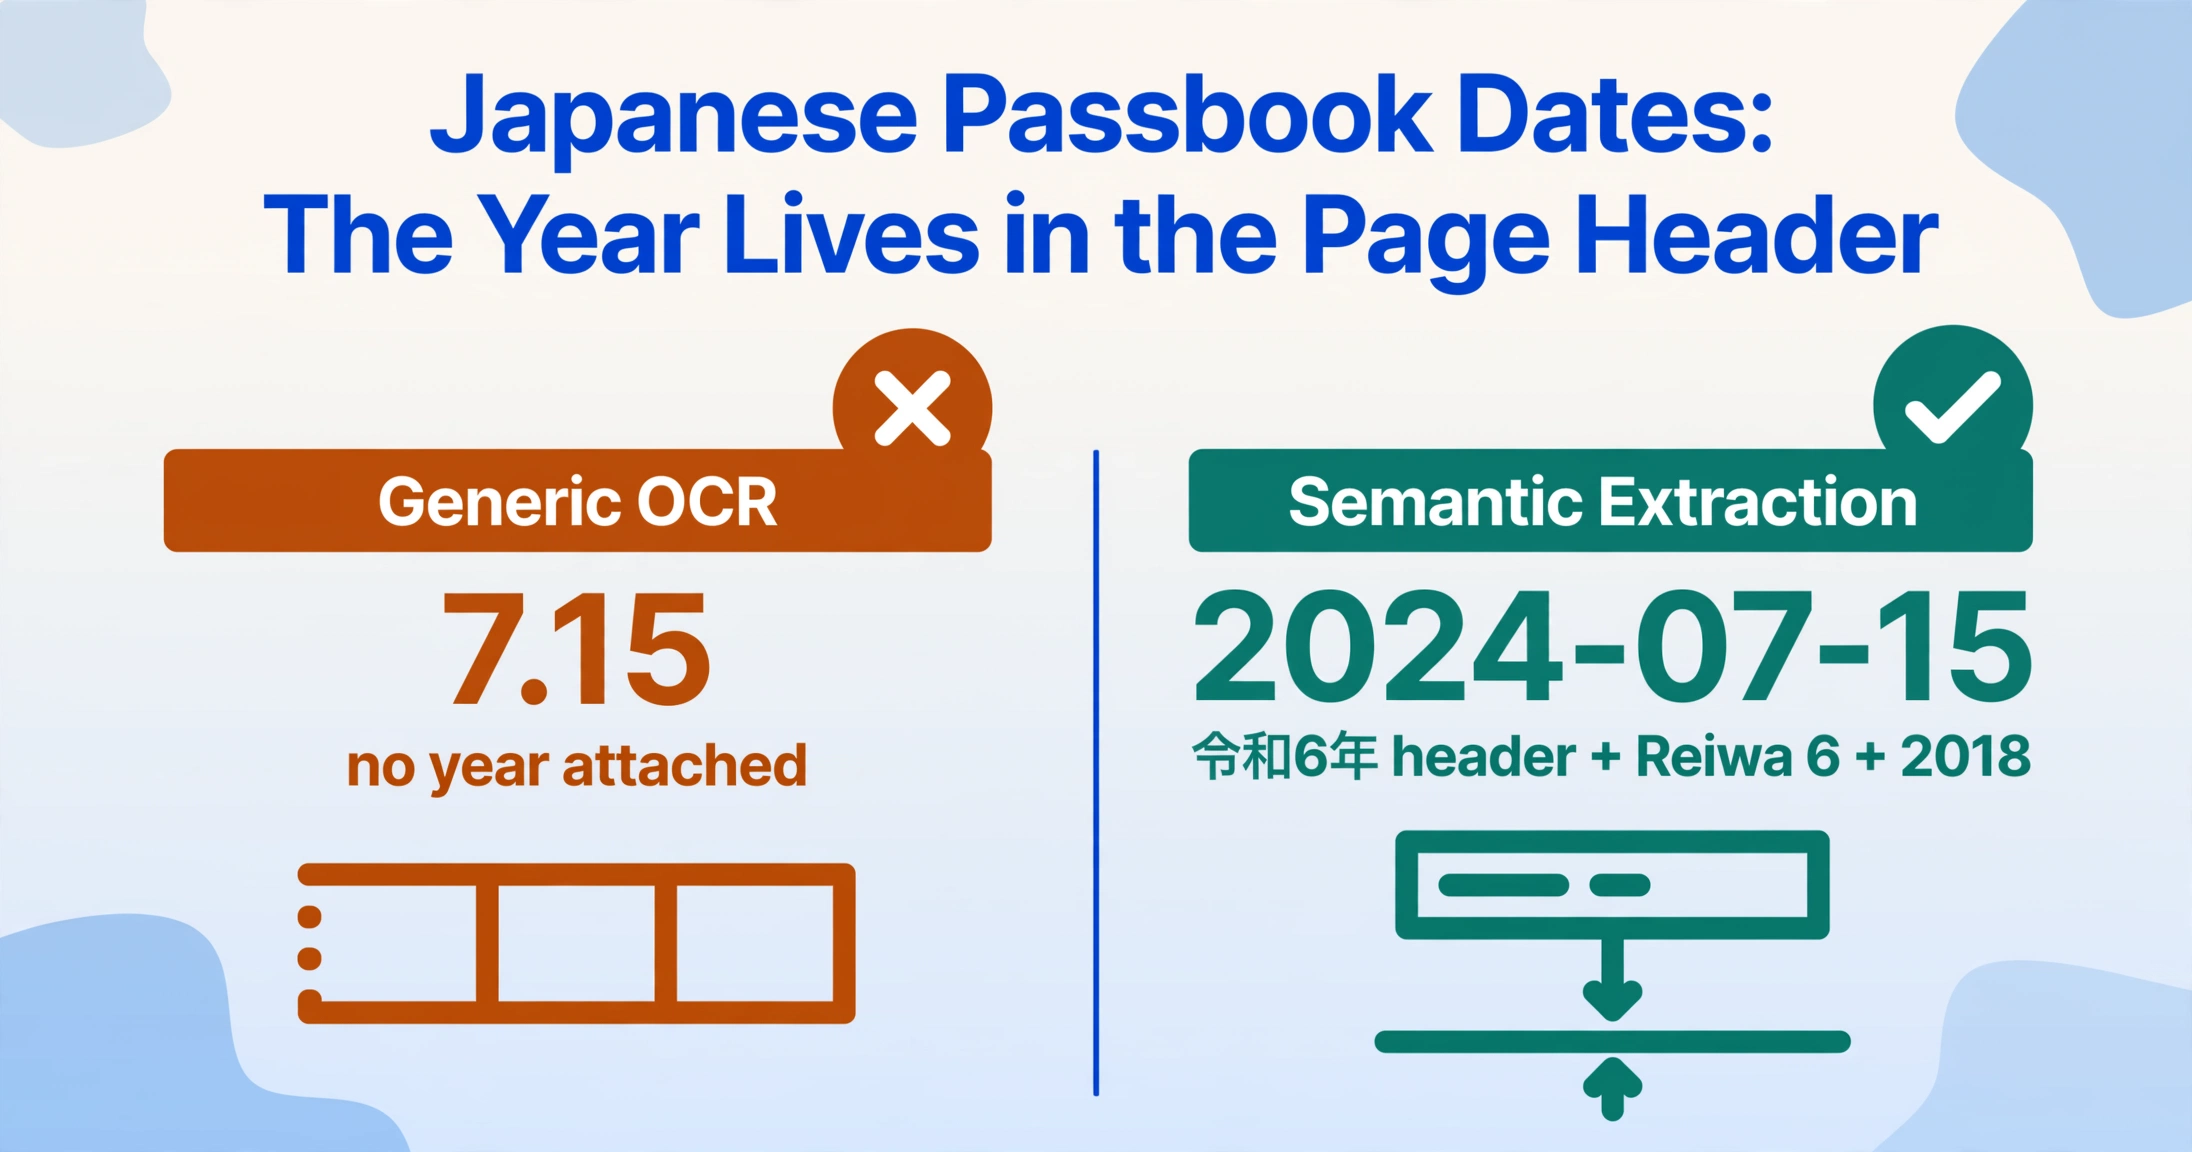
Passbuchdaten verwenden den Kalender der japanischen Kaiserära: 令和 (Reiwa, begann Mai 2019), 平成 (Heisei, 1989–2019), 昭和 (Showa, 1926–1989). Ein Datum wie R6.7.15 ist der 15. Juli 2024 (Reiwa-Jahr 6 + 2018). H30.3.31 ist der 31. März 2018 (Heisei-Jahr 30 + 1988). Die Ära-Jahresüberschrift wird nur einmal oben auf einer Seite gedruckt – nachfolgende Zeilen auf derselben Seite und auf Folgeseiten enthalten nur Monat und Tag. Ein generisches OCR-Tool, das isoliert „7.15“ liest, hat ein Datum ohne Jahr und eine Jahresüberschrift, die drei Seiten zurückliegt und die es nie gesehen hat. Die Umrechnungsformel ist deterministisch – Reiwa n = n + 2018, Heisei n = n + 1988, Showa n = n + 1925 – aber um zu erkennen, welche Formel auf welche Zeile anzuwenden ist, muss die Beziehung zwischen der Seitenüberschrift und ihren Inhaltszeilen gelesen werden, nicht einzelne Zellen.
摘要 (Beschreibung) – die Lücke bei der Code-Klassifizierung
Die Beschreibungsspalte verwendet kompakte Codes, die ein japanischer Leser sofort kategorisiert: 振込 (Überweisung), ATM (ATM-Transaktion), 給与 (Gehaltseingang), 引落 (Lastschrift), 手数料 (Bankgebühr, in der Regel ¥110–¥550), 利息 (Zinsen), カード (Kartentransaktion). Eine rohe Extraktion, die diese Codes originalgetreu wiedergibt, erzeugt eine Transaktionsliste. Eine Extraktion, die sie während der Verarbeitung klassifiziert, erzeugt ein vorkategorisiertes Hauptbuch. Die Klassifizierungslogik kann einmal als berechnete Spalte definiert werden: if Description contains "給与" then "Salary Income"; if contains "引落" then "Direct Debit"; if contains "手数料" then "Bank Fee"; if contains "利息" then "Interest Income". Der mehrdeutigste Code ist 振込 – eine Überweisung von ¥500.000 von einem bekannten Kundendienstunternehmen ist Geschäftseinkommen; eine Überweisung von ¥15.000 von einer Einzelperson ist wahrscheinlich privat. Eine berechnete Spalte kann die Beschreibung mit dem Betrag kombinieren, um die Mehrdeutigkeit aufzulösen: if Description="振込" and Amount > 100000 then "Business Income"; else "Personal Transfer".
お支払金額 / お預り金額 (Abhebung / Einzahlung) – die Falle der gegenseitigen Ausschließlichkeit
Eine bestimmte Transaktion hat einen Eintrag entweder in der Abhebungsspalte oder in der Einzahlungsspalte – nie in beiden. Diese gegenseitige Ausschließlichkeit ist die strukturelle Grundlage für die Saldoverifizierung, erzeugt aber auch einen häufigen OCR-Fehler: eine Einzahlung von ¥30.000, die durch eine falsch ausgerichtete Erfassung in der Abhebungsspalte landet. Die Saldoberechnung schlägt in dieser Zeile fehl, und auch in jeder folgenden Zeile, weil vorheriger Saldo + 0 (keine Einzahlung erfasst) − ¥30.000 (falsche Spalte) nicht dem gedruckten aktuellen Saldo entsprechen kann. Dies ist kein zufälliger Fehler – es ist ein struktureller Fehler, der für spaltenbasierte Formate mit gegenseitiger Ausschließlichkeit charakteristisch ist, und positionsbasiertes OCR mit Vorlagen ist besonders anfällig dafür.
差引残高 (Running Balance) — die Selbstprüfungs-Engine
Der laufende Saldo ist gleichzeitig der größte Extraktionsvorteil des Passbuchs und seine gefährlichste Fehlerquelle. Er ist ein Vorteil, weil die Saldospalte ihre eigene Verifizierung in sich trägt: vorheriger Saldo + Einzahlung − Abhebung muss dem aktuellen Saldo entsprechen. Definieren Sie eine berechnete Spalte, die dies bei jeder Zeile während der Extraktion prüft — Balance Check (vorheriger Saldo + Einzahlung − Abhebung = aktueller Saldo? 'OK' : 'REVIEW') — und Sie wissen, welche Zeilen Sie überprüfen müssen, bevor die Daten in Ihre Buchhaltungssoftware gelangen. Es ist gefährlich, weil ein einziger Lesefehler — ein übersehenes Komma, das ¥30.000 in ¥3.000 verwandelt — den Saldo dieser Zeile korrumpiert, was die Verifizierung der nächsten Zeile korrumpiert und damit aller folgenden Zeilen. Ein Passbuch mit 280 Transaktionen und einem Lesefehler in Zeile 47 erzeugt 233 REVIEW-Flags — aber die Ursache ist die erste markierte Zeile. Korrigieren Sie Zeile 47, und die Zeilen 48–280 werden korrekt neu berechnet. Dieser Kaskadeneffekt ist Gegenstand des Leitfadens zu häufigen Fehlern bei der Passbuch-Dateneingabe, der die Verhinderung von Saldoabweichungen ausführlich behandelt.
Magnetstreifen (磁気ストライプ) — die Hardware-Abhängigkeit
Der Magnetstreifen auf der Rückseite speichert die Kontonummer, den Filialcode und den Kontotyp. Wenn ein Passbuch in einen Geldautomaten eingeführt wird, liest die Maschine den Streifen, identifiziert das Konto, ruft nicht gedruckte Transaktionen ab und druckt sie. Der Streifen ist eine maschinenlesbare Komponente — die darin enthaltenen Kontodaten werden nicht als Text auf der Passbuchseite selbst gedruckt (das Deckblatt zeigt typischerweise den Namen des Kontoinhabers in Katakana, nicht die Kontonummer). Für die Extraktion sind die Kontonummer und die Filialinformationen Datenpunkte, die entweder von der Cash Card (キャッシュカード), den Deckblattinformationen (falls vorhanden) oder durch manuelle Eingabe stammen müssen — die Passbuchseiten selbst tragen diese Daten nicht in maschinenlesbarer gedruckter Form. Ein beschädigter Magnetstreifen auf einem alten Passbuch bedeutet, dass der Geldautomat es nicht für Druckaktualisierungen lesen kann, verhindert aber nicht die Extraktion der vorhandenen gedruckten Seiten — die gedruckten Transaktionsdaten sind unabhängig vom Streifen.
Der Extraktions-Workflow: Vom Papier-Passbuch zur buchhaltungsfertigen Tabelle
Die Extraktion japanischer Passbuchdaten folgt einer dreistufigen Architektur, die identisch ist, egal ob Sie ein Passbuch oder zehn, ein Jahr oder fünf verarbeiten. Die Einrichtungsphase wird einmal durchgeführt und unbegrenzt wiederverwendet. In der Verarbeitungsphase übernimmt die Extraktions-Engine die Arbeit. In der Verifizierungsphase bestätigen Sie, dass die Ausgabe korrekt ist – und die selbstverifizierende Saldenspalte des Passbuchs macht diese Phase um Größenordnungen schneller als manuelle Abstimmung.
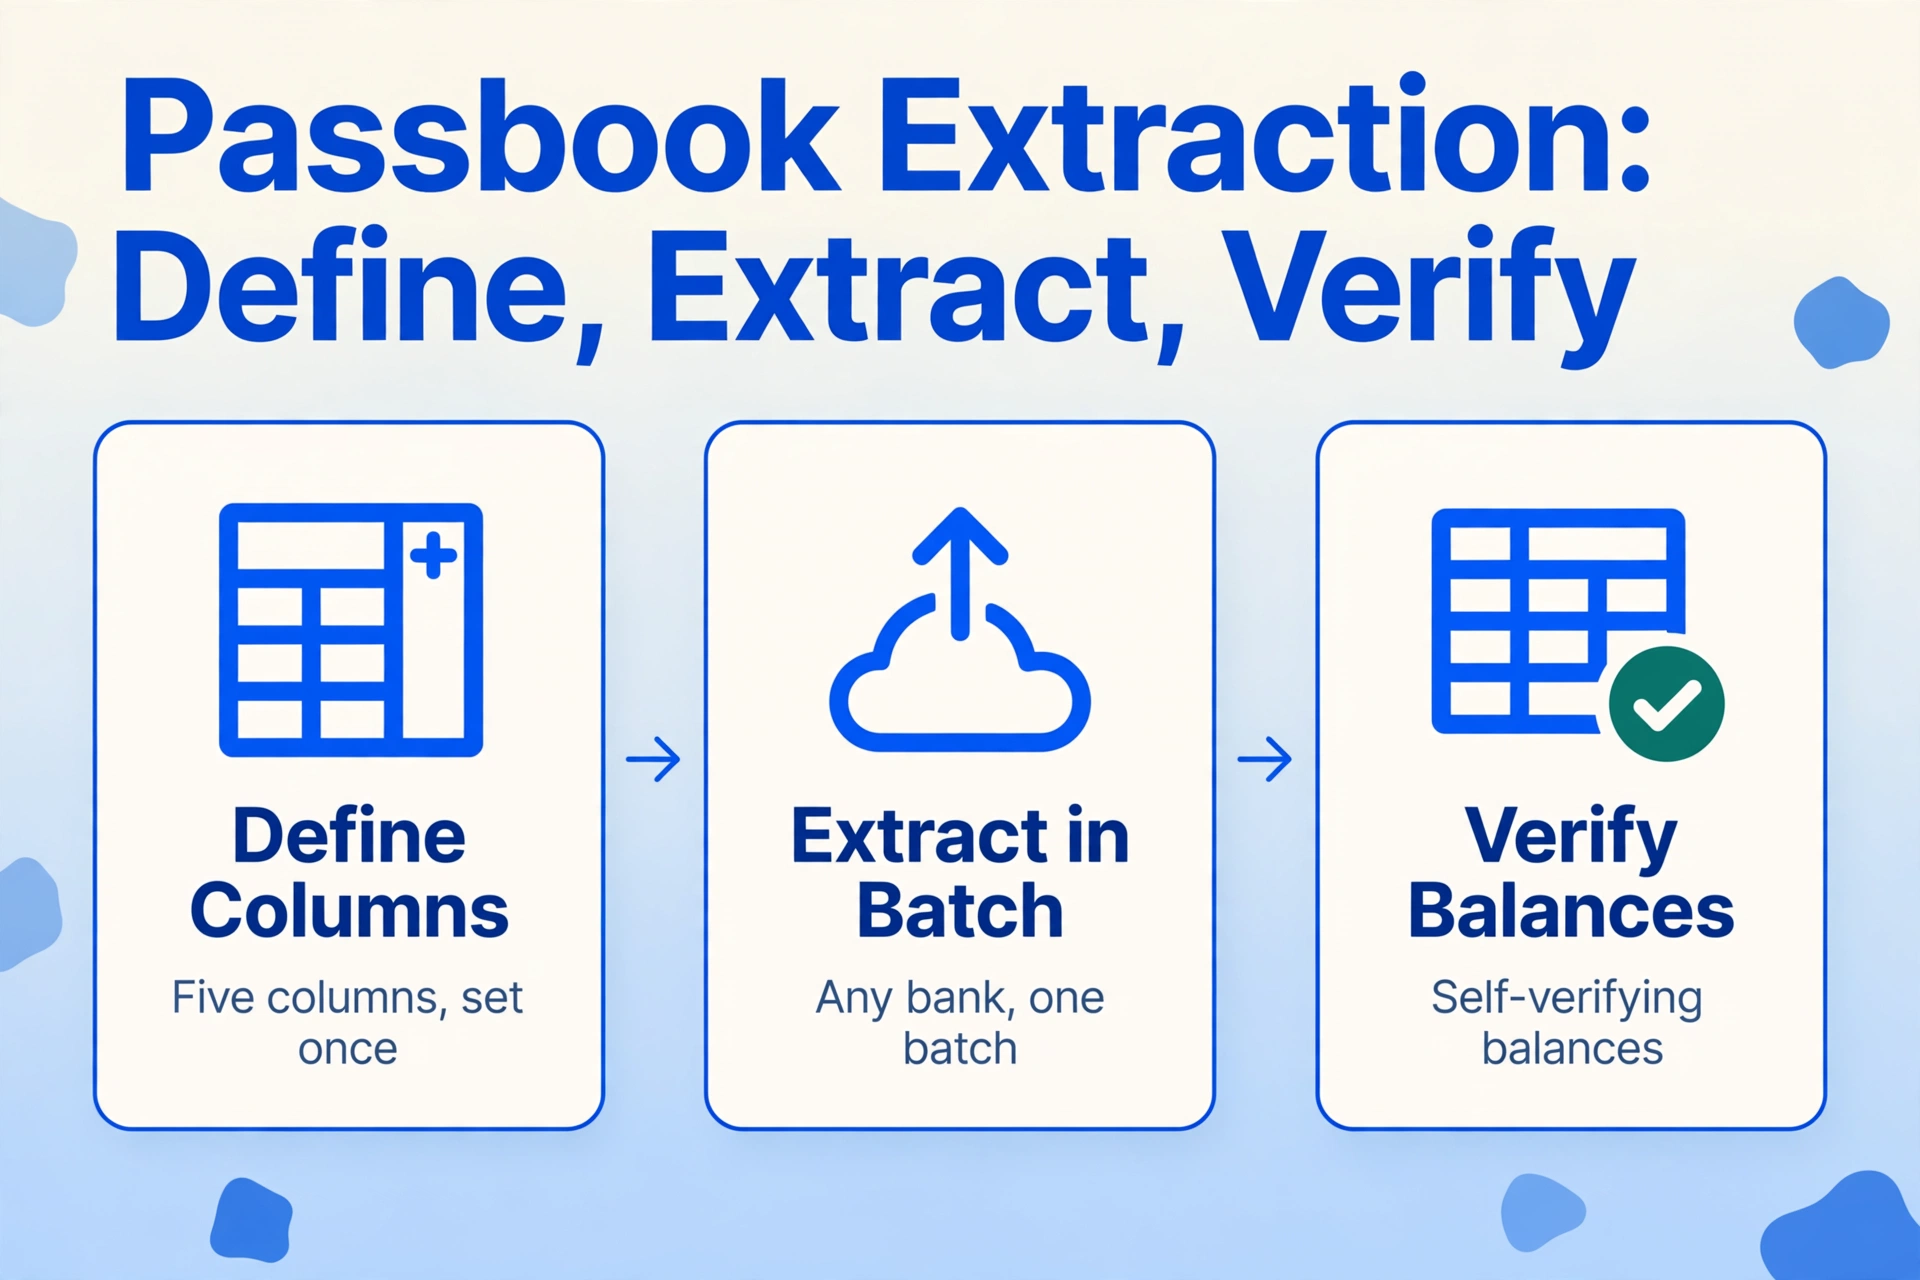
Das Ausgabeschema definieren. Sie legen fünf Spaltennamen fest – Datum, Beschreibung (摘要), Abhebung (お支払金額), Einzahlung (お預り金額), Saldo (差引残高) – und können optional berechnete Spalten für Vorklassifizierung und Verifizierung hinzufügen. Dies ist Benutzerdefinierte Spaltenextraktion: Sie definieren die Ausgabe, und die KI ordnet die gedruckten Felder jedes Passbuchs Ihren Spalten zu, indem sie liest, was jeder Wert bedeutet. Dasselbe Spaltenschema funktioniert bei jeder Bank – MUFG, SMBC, Mizuho, Japan Post Bank, regionale Kreditgenossenschaften – weil die KI Feldbedeutungen liest, nicht Pixelkoordinaten. Eine Vorlage, die für MUFGs einzeiliges Layout konfiguriert ist, würde bei Japan Post Banks zweizeiligem Umbruch scheitern; ein semantisches Schema verarbeitet beide Formate im selben Batch, weil es die Bedeutung jedes Felds liest, nicht seine Position.
Hochladen und Verarbeiten. Scannen oder fotografieren Sie Passbuchseiten – einschließlich Vorderseiten mit Kontoinhabername, Rückseite als Referenz und jeder Transaktionsseite – und laden Sie alle Bilder als einen einzigen Batch hoch. Jede Seite wird unabhängig mit demselben Spaltenschema verarbeitet. Japanische Ära-Datumsangaben (和暦) werden in der Ausgabeschicht in Gregorianisch (jjjj-mm-tt) umgewandelt, wobei der korrekte Ära-Kontext pro Seite angewendet wird. Beschreibungscodes werden unverändert erfasst und optional über berechnete Spalten in Ausgabenkategorien klassifiziert. Der laufende Saldo jeder Zeile wird während der Extraktion gegen den Saldo der vorherigen Zeile verifiziert und Abweichungen werden markiert.
Exportieren und Verifizieren. Die Ausgabe ist eine Excel-Datei mit einer Zeile pro Transaktion und jedem Feld in einer eigenen Spalte. Die Saldenverifizierungsspalte zeigt OK in jeder Zeile, in der die Berechnung stimmt, und REVIEW in Zeilen mit Abweichungen. Ein Drei-Jahres-Passbuch mit etwa 280 Transaktionen erzeugt typischerweise ein oder zwei REVIEW-Flags – falsch gelesene Kommas, verschmierte Ziffern auf gealterten Seiten oder eine handschriftliche Korrektur, die den Druckleser verwirrt hat. Korrigieren Sie diese Zeilen, und die restlichen 278 sind verifiziert. Die Tabelle lässt sich direkt in jede japanische Buchhaltungssoftware importieren, die CSV-Transaktionsdaten akzeptiert.
Dateien werden sicher verarbeitet und nicht gespeichert.
Für eine praktische Einführung in diesen Workflow – einschließlich Spalteneinrichtung, Seiten-Scan-Strategien und häufiger Fehlerbehandlung – deckt der Leitfaden zur Einzel-Passbuch-Extraktion jeden Schritt im Detail ab. Für die Batch-Verarbeitungsstrategie, die mehrere Passbücher über mehrere Jahre hinweg verarbeitet, behandelt der Leitfaden zur Batch-Verarbeitung die Multi-Passbuch-Zusammenführung, die Übertragung der japanischen Ära-Datumsangabe über Seiten hinweg und die Saldenprüfung im Batch-Maßstab. Für eine Analyse, warum die manuelle Eingabe trotz verfügbarer digitaler Werkzeuge weiterhin der Standard ist, siehe den Deep-Dive zum Problem der manuellen Eingabe japanischer Passbücher.
Batch-Verarbeitung: Wenn ein Passbuch zu einem Jahrzehnt an Daten wird
Ein einzelnes Passbuch enthält etwa 8–10 Transaktionen pro Seite und 50–100 Seiten, was ihm je nach Kontenaktivität eine typische Nutzungsdauer von ein bis drei Jahren verleiht. Ein Einzelunternehmer, der eine blaue Steuererklärung (青色申告) einreicht und separate Passbücher für den täglichen Betrieb (MUFG Bank), Steuerrücklagen (Japan Post Bank) und die Lohnabrechnung (regionale Kreditgenossenschaft) führt, hat drei Passbücher zu extrahieren – etwa 36 Seiten gedruckter Transaktionen, 280 Zeilen, über drei Druckkonventionen hinweg.
Die Batch-Extraktion behandelt dies als einen einzigen Vorgang. Die drei Passbücher werden in einen Upload mit demselben Fünf-Spalten-Schema gegeben. Die japanische Ära-Datumsangabe wird pro Seite mit dem korrekten Ära-Kontext umgerechnet – das MUFG-Passbuch verwendet abgekürzte Ära-Jahre (R6), das Japan-Post-Bank-Passbuch vollständige Äranamen (令和6年), und das Passbuch der Kreditgenossenschaft enthält späte Shōwa-Transaktionen von Konten, die in den 1980er Jahren eröffnet wurden – alles wird im Output auf gregorianische Daten aufgelöst. Derselbe Batch verarbeitet handschriftliche Randnotizen (家賃 für Miete, 仕入 für Wareneinkäufe) als ergänzende Notizspalte, und berechnete Spalten klassifizieren Transaktionen vorab in Ausgabenkategorien und kennzeichnen Saldenabweichungen.
Die Alternative – Einzelseiten-Extraktion mit manueller Zusammenführung – zwingt den Nutzer, 36 separate Tabellenkalkulationsdateien zu konsolidieren, Ära-Daten über Seiten hinweg abzugleichen, wo der Jahreskopf auf Seite 1 erscheint und für die nächsten sieben Fortsetzungsseiten verschwindet, und die Saldenkontinuität über Passbuchgrenzen hinweg manuell zu verifizieren. Für drei Jahre Daten von drei Banken dauert allein der manuelle Zusammenführungsschritt etwa zwei bis drei Stunden. Der Batch-Ansatz eliminiert ihn vollständig – ein Upload, eine Tabelle, ein Verifizierungsdurchgang. Für die vollständige Batch-Workflow-Architektur siehe den Leitfaden zur Batch-Verarbeitung von Passbuchseiten in ein jährliches Ausgabenledger. Für eine quantifizierte Aufschlüsselung, was manuelle Dateneingabe japanischen Kleinunternehmern tatsächlich kostet, liefert die Kostenanalyse konkrete Zahlen zu Zeit und Fehlerraten.
Batch-Verarbeitung von Passbüchern im Vergleich zu anderen Markt-Batch-Szenarien: Eine britische Praxis, die 80 SA100-Selbstauskunftsformulare in einem Batch verarbeitet, hat es mit unabhängigen Dokumenten zu tun – jede Steuererklärung ist ein in sich geschlossener Datensatz, und ein Lesefehler auf Seite 47 betrifft nur Seite 47. Ein Passbuch-Batch verarbeitet voneinander abhängige Seiten – der laufende Saldo setzt sich über Seitengrenzen hinweg fort, und ein Lesefehler auf Seite 3 korrumpiert stillschweigend die Verifizierung aller nachfolgenden Seiten. Der Batch muss die Kontinuitätsstruktur des Dokumenttyps kennen, nicht nur jede Seite als Insel behandeln. Deshalb ist die Verifizierung der berechneten Spalte zum Zeitpunkt der Extraktion – und nicht danach – der technische Unterschied zwischen einem Batch, der verifizierte Ausgaben produziert, und einem Batch, der Daten produziert, die Sie in Ihrer Buchhaltungssoftware vollständig neu verifizieren müssen.
In das japanische Buchhaltungs-Ökosystem: Yayoi, freee, MoneyForward und darüber hinaus
Die extrahierte Tabelle ist eine Brücke – das Ziel ist japanische Buchhaltungssoftware. Die drei Plattformen, die den Markt für Einzelunternehmer und kleine Unternehmen dominieren – Yayoi Accounting (弥生会計), freee Accounting (freee会計) und MoneyForward Cloud Accounting (マネーフォワード クラウド会計) – decken zusammen die überwiegende Mehrheit der Antragsteller mit blauer Steuererklärung ab. Jede hat einen eigenen Importpfad, und die Extraktionsausgabe muss den Erwartungen der Zielplattform entsprechen.
Yayoi Accounting (弥生会計). Der Marktführer, insbesondere bei Steuerberatern (税理士). Der Import erfolgt CSV-basiert über die Funktion Smart Transaction Import (スマート取引取込). Yayoi verlangt Daten im Format yyyy-mm-dd – die Umrechnung von der japanischen Ära-Datumsangabe in den gregorianischen Kalender muss vor dem Export abgeschlossen sein. Yayoi verwendet ein proprietäres „Yayoi-Importformat“ (弥生インポート形式) für CSV, daher sollte die Extraktionsausgabe auf das Yayoi-Feldschema abgebildet werden: Datum, Sollkonto (借方勘定科目), Sollbetrag, Habenkonto (貸方勘定科目), Habenbetrag, Beschreibung (摘要).
freee Accounting (freee会計). Cloud-nativ mit über 270 API-Endpunkten und MCP (Model Context Protocol)-Unterstützung – die API-reichste der drei. Import über manuellen CSV-Upload (取引 CSV インポート) mit dem Importvorlagenformat von freee oder über die freee-API für automatisierte Erfassung. Die automatischen Kategorisierungsregeln von freee (自動登録ルール) können so konfiguriert werden, dass sie Passbuch-Beschreibungscodes erkennen und Konten (勘定科目) zuweisen – das bedeutet, dass sich der Extraktionsschritt auf die getreue Code-Erfassung konzentrieren kann und die Klassifizierungslogik in der Regel-Engine der Buchhaltungssoftware lebt.
MoneyForward Cloud Accounting (マネーフォワード クラウド会計). Import über die Datenmigrationsfunktion (他社ソフトデータの移行), wobei das Yayoi-kompatible Format als Zwischen-CSV-Format gewählt wird. Die Stärke von MoneyForward ist das einheitliche Dashboard, das Passbuchdaten, Kreditkartenabrechnungen und Belegscans zu einem vollständigen Finanzbild kombiniert. Wenn die Extraktionsausgabe das Yayoi-kompatible Datums- und Spaltenformat verwendet, lässt sie sich mit derselben Spaltenzuordnung in MoneyForward importieren.
Andere unterstützte Plattformen, die denselben CSV-Import akzeptieren, umfassen: MJS Accounting (会計大将), TKC (FX2/MX-Serie), OBC Kanjo Bugyo (勘定奉行), Sorimachi Accounting King (会計王), EPSON Financial Support (財務応援R4) und PCA Accounting (PCA会計). Das fünfspaltige Format des Passbuchs ist bei allen japanischen Banken standardisiert, sodass dieselbe Extraktionsausgabe mit jeder Buchhaltungsplattform funktioniert, die CSV-Transaktionsdaten importiert – das Datumsformat, die Betragsspalten und das Beschreibungsfeld sind unabhängig von der empfangenden Software identisch.
Der entscheidende Unterschied zwischen den drei wichtigsten Plattformen für die Extraktionsplanung: Yayoi unterstützt nur CSV und erfordert, dass die Extraktion eine Datei im Yayoi-Importformat erzeugt. freee unterstützt sowohl CSV als auch API – der API-Weg ermöglicht automatisierte Passbuch-zu-Buchhaltung-Pipelines ohne manuelle Dateiübertragung. MoneyForward verwendet Yayoi-Format-CSV als Zwischenformat, sodass die für Yayoi formatierte Extraktionsausgabe für beide Plattformen funktioniert. Für die meisten kleinen Unternehmen ohne eingerichtete API-Integration bietet die Ausrichtung auf das Yayoi-Importformat als Extraktionsausgabestandard die breiteste Kompatibilität.
Die 青色申告-Verbindung: Warum Passbuch-Extraktion unter der Steuerreform 2027 entscheidend wird
Der japanische Steuerreformentwurf (令和8年度税制改正の大綱), veröffentlicht von der Regierungskoalition am 19. Dezember 2025, restrukturiert den Sonderabzug für blaue Steuererklärungen (青色申告特別控除) – den Steueranreiz, der die doppelte Buchführung für Einzelunternehmer seit Einführung des Systems lohnenswert gemacht hat. Die Änderungen gelten für das Steuerjahr 2027 (eingereicht 2028) und verändern direkt die Wirtschaftlichkeit der Passbuch-Digitalisierung.
Unter dem aktuellen System (2026) erhält ein Einreicher einer blauen Steuererklärung, der doppelte Bücher führt und elektronisch einreicht, einen Abzug von ¥650.000 vom steuerpflichtigen Einkommen. Papier-Einreicher mit doppelter Buchführung erhalten ¥550.000. Die Reform 2027 senkt den Papierabzug auf ¥100.000 – eine Reduzierung um ¥450.000 – und führt eine oberste Stufe von ¥750.000 für Einreicher ein, die die e-Tax-Elektronikeinreichung NUTZEN und qualifizierte elektronische Bücher (優良な電子帳簿) führen ODER ein bestimmtes elektronisches Berechnungssystem mit automatischer Datenverknüpfung (デジタルシームレス) verwenden. Die dreistufige Struktur wird:
| Einreichungsmethode | Buchführung | Abzug (2026) | Abzug (2027+) | Änderung |
|---|---|---|---|---|
| e-Tax + qualifizierte elektronische Bücher oder automatische Verknüpfung | Doppelt | — | ¥750.000 | Neue Stufe |
| e-Tax-Elektronikeinreichung | Doppelt | ¥650.000 | ¥650.000 | Keine Änderung |
| Papier-Einreichung | Doppelt | ¥550.000 | ¥100.000 | −¥450.000 |
| Vereinfachte Buchführung | Einfach | ¥100.000 | ¥100.000 (Einnahmen ≤ ¥10M) ¥0 (Einnahmen > ¥10M) | Einnahmenbeschränkung hinzugefügt |
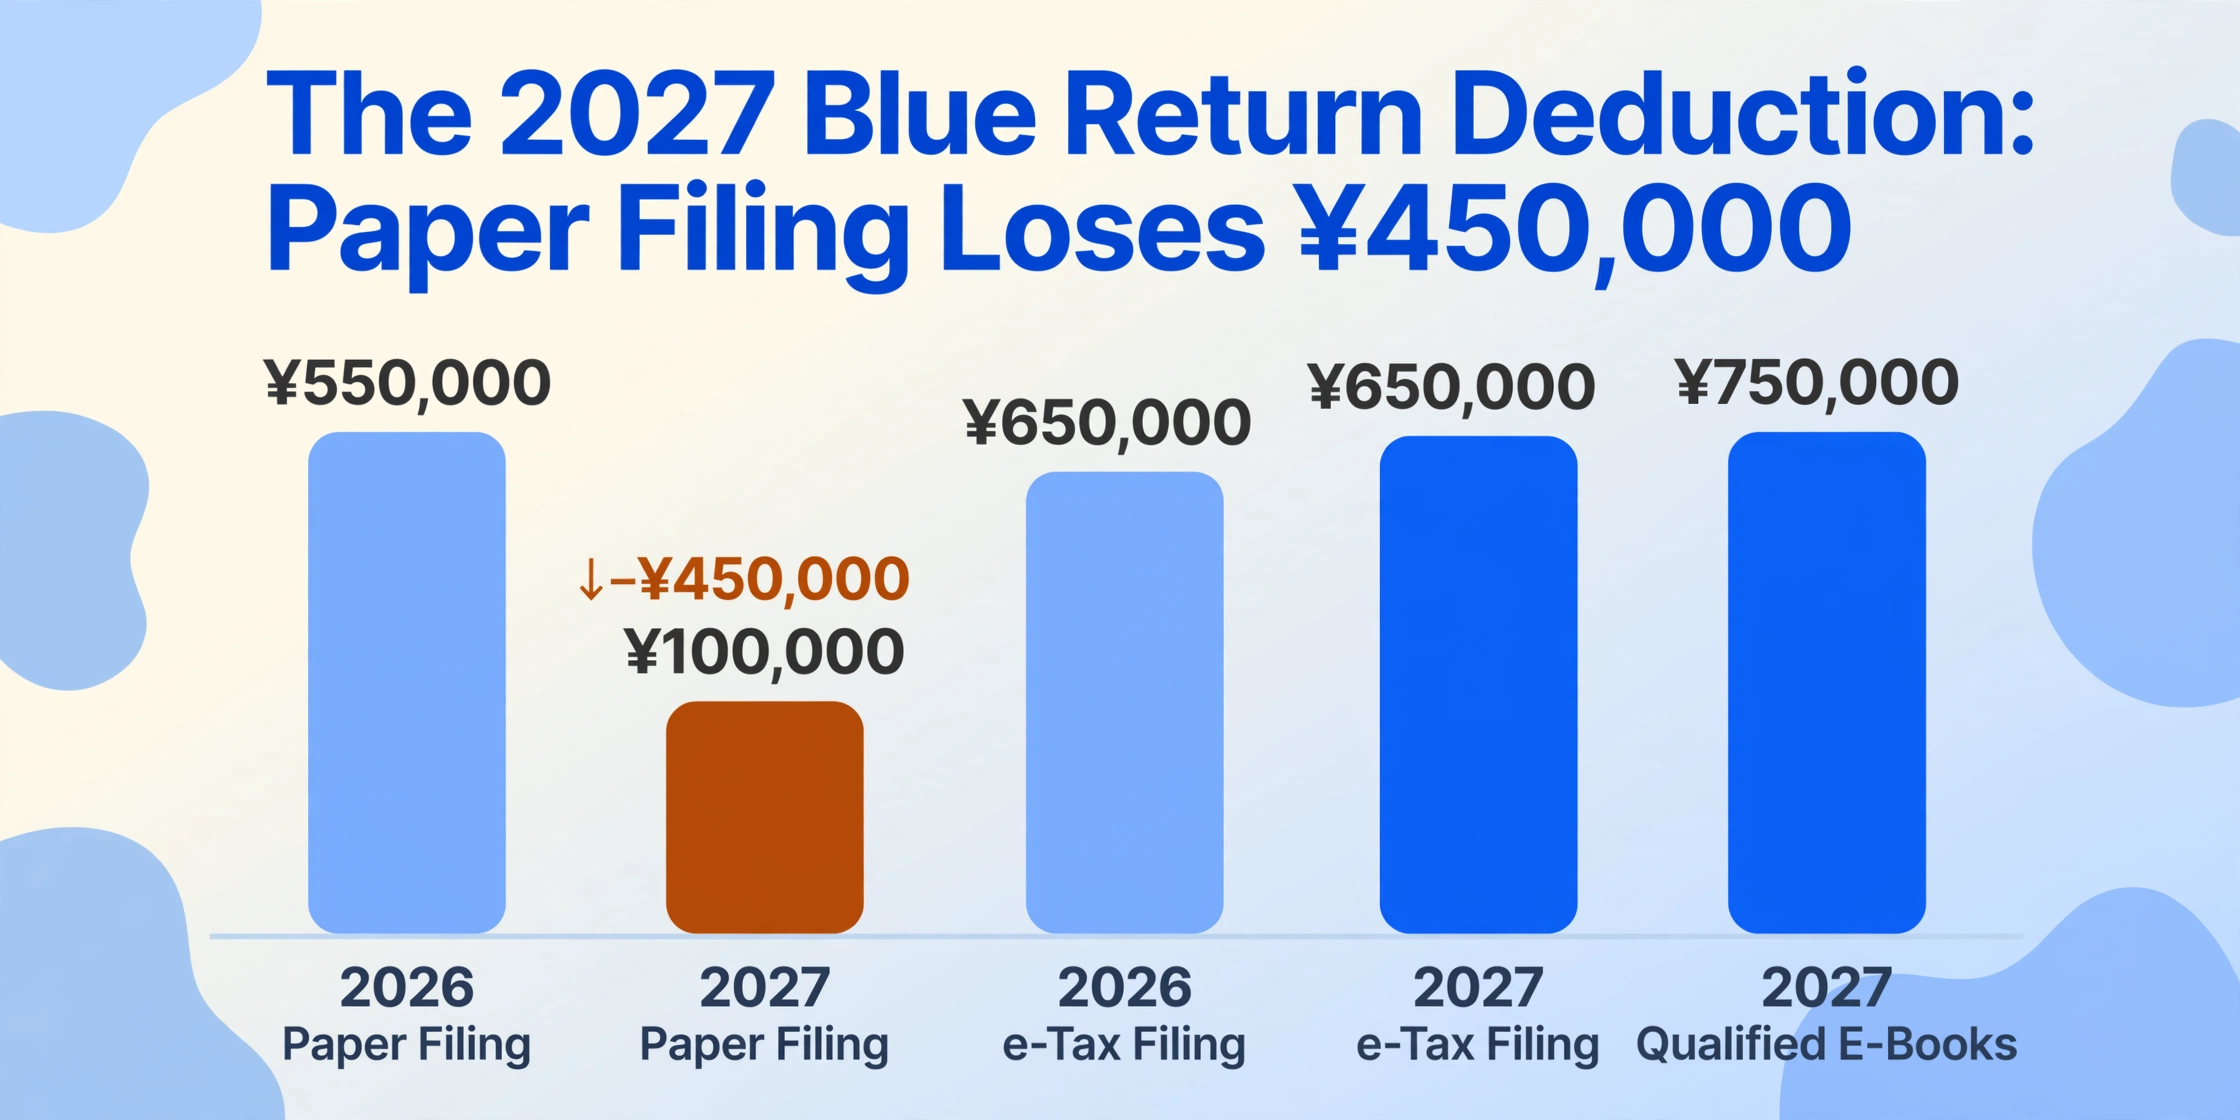
Der Zusammenhang zur Passbuch-Extraktion ist direkt. Ein Einzelunternehmer, der 2026 eine Papiererklärung mit doppelter Buchführung und manueller Passbuch-Übertragung einreichte, erhielt ¥550.000. Derselbe Einreicher, der 2027 denselben manuellen Ansatz fortsetzt, erhält ¥100.000 — eine Reduzierung des Abzugs um ¥450.000, was je nach Grenzsteuersatz etwa ¥90.000–¥180.000 an zusätzlicher Steuer entspricht. Die Reform macht die elektronische e-Tax-Einreichung für die ¥650.000-Stufe verpflichtend — das bedeutet, dass die gesamte Buchhaltungspipeline, von der Passbuch-Datenerfassung bis zur endgültigen Steuererklärung, digital sein muss. Die Passbuch-Extraktion ist kein Komfort-Upgrade. Sie ist das erste Glied in einer Kette, die jetzt Ihre Steuerabzugsstufe bestimmt.
Gemäß dem Gesetz zur Aufbewahrung elektronischer Bücher (電子帳簿保存法) können gescannte Kopien von Finanzdokumenten als rechtlich zulässige Aufzeichnungen dienen, wenn sie die Anforderungen an Auflösung (200 dpi) und Farbe erfüllen. Die Novelle von 2024 lockerte die Zeitstempel-Anforderung — gescannte Dokumente, die in einem System mit Bearbeitungs- und Löschhistorie (訂正・削除履歴) gespeichert sind, benötigen keinen separaten Zeitstempel mehr. Für die Passbuch-Extraktion bedeutet dies, dass die gescannten Passbuch-Seiten, die als Extraktionsinput dienen, auch als rechtliche Kopie der Aufzeichnung dienen können, sofern die Scan-Auflösung die 200-dpi-Farbanforderung erfüllt und die gescannten Dateien in einem konformen System gespeichert werden. Das physische Passbuch muss weiterhin für den gesetzlichen Zeitraum von sieben Jahren aufbewahrt werden — die Extraktion ersetzt den manuellen Datenerfassungsschritt, nicht die rechtliche Aufzeichnung.
Sonderfälle und Fehlerbehebung
Die meisten Passbuch-Extraktionen liefern saubere Ergebnisse mit ein oder zwei markierten Zeilen. Die folgenden Sonderfälle decken Szenarien ab, in denen Extraktionsergebnisse einer manuellen Prüfung bedürfen – wenn man weiß, wie sie aussehen, bevor sie auftreten, wird aus einer frustrierenden Fehlersuche eine Zwei-Minuten-Korrektur.
Handschriftliche Korrekturen (手書き通帳修正)
Passbuch-Nutzer korrigieren gedruckte Einträge manchmal von Hand – ein Bankangestellter schreibt eine Korrektur neben einen fehlgedruckten Betrag, oder der Kontoinhaber ergänzt die Beschreibungsspalte mit einer Notiz wie 家賃 (Miete) oder 仕入 (Wareneinkauf). Diese Anmerkungen sind rechtlich Teil des Dokuments und enthalten buchhaltungsrelevante Informationen. Die Extraktion mit Vision-Modellen kann handschriftliche Anmerkungen neben gedrucktem Text lesen – aber die Qualität der Handschrift variiert: Eine klare Kugelschreiber-Kanji-Notiz ist in der Regel lesbar; eine verblasste Bleistiftnotiz in einem Winkel, die die gedruckten Gitterlinien kreuzt, ist weniger zuverlässig. Bei Passbüchern, in denen handschriftliche Notizen die einzige Aufzeichnung der Transaktionskategorisierung sind, sollte die extrahierte Tabelle mit dem physischen Passbuch für Zeilen geprüft werden, in denen die Handschrift mehrdeutig war. Die KI verarbeitet die lesbare Mehrheit; die Prüfung ist Ausnahmebehandlung, nicht Zeile für Zeile.
Mehrdeutigkeit des Beschreibungscodes (摘要あいまい性)
Eine 振込 (Überweisung) von ¥500.000 von einem bekannten Firmenkundennamen ist Geschäftseinkommen. Eine 振込 von ¥15.000 von einer Privatperson ist wahrscheinlich privat. Der Beschreibungscode im Passbuch allein kann sie nicht unterscheiden – die Kategoriezuordnung der Buchhaltungssoftware tut das. Die Extraktion sollte den Code getreu erfassen; die Klassifizierungslogik liegt nachgelagert, entweder in den automatischen Kategorisierungsregeln der Buchhaltungssoftware oder in einer berechneten Spalte, die den Beschreibungscode mit dem Betragsschwellenwert kombiniert. Ein häufiger Fehlermodus ist das Schreiben zu aggressiver Klassifizierungsregeln – eine Regel, die alle 振込 über ¥100.000 als „Geschäftseinkommen" klassifiziert, wird ein einmaliges Familiengeschenk von ¥200.000 falsch kategorisieren. Die Regeln sollten konservativ sein, offensichtliche Fälle klassifizieren und mehrdeutige für die manuelle Prüfung offen lassen.
Beschädigte oder verschlissene Passbuchseiten
Passbücher, die fünf oder mehr Jahre alt sind, können Seiten mit verblasstem Druck, Wasserschäden, Tintenverschmierungen oder Knicken aufweisen, die durch den Transaktionsbereich verlaufen. Bei verblasstem Druck verbessert das Scannen mit höherer Auflösung (300 dpi oder mehr) und die Kontrastanpassung vor der Extraktion die Lesbarkeit. Bei Knicken, die die Punktmatrix-Zeichen verzerren, kann das Fotografieren der Seite bei natürlichem Licht aus einem Winkel den Knickschatten reduzieren. Bei Seiten, auf denen Schäden eine Transaktionszeile unlesbar machen – typischerweise 1–2 Zeilen in einem Passbuch mit 280 – markieren Sie die Zeile für die manuelle Eingabe anhand des physischen Passbuchs. Die Extraktion verarbeitet die anderen 278 Zeilen. Der Fehler bei beschädigten Zeilen ist in der Prüfspalte sichtbar: ein REVIEW-Flag in einer Zeile, in der die Saldoberechnung nicht aufgeht, oft verursacht durch eine teilweise unlesbare Betragsziffer.
Digitales Passbuch (デジタル通帳) vs. physisches Passbuch
Einige Banken – insbesondere Japan Post Bank über ihren Dienst Yucho Direct+ – bieten digitale Passbücher an, die das physische Heft durch eine webbasierte Transaktionsansicht und einen herunterladbaren CSV-Export ersetzen. Exportformat, Datumsbereich und verfügbare Spalten unterscheiden sich jedoch je nach Bank und entsprechen oft nicht dem Format, das die Buchhaltungssoftware erwartet. Ein CSV-Export des digitalen Passbuchs der Japan Post Bank kann Daten im gregorianischen Kalender ausgeben, während das physische Passbuch desselben Kontos am Geldautomaten mit japanischen Ära-Datumsangaben gedruckt wird – und die CSV-Datei deckt möglicherweise nur die letzten 12 Monate ab, während das physische Passbuch die gesamte Kontohistorie enthält. Für Nutzer der blauen Steuererklärung, deren Buchhaltungssoftware ein bestimmtes CSV-Format erwartet, liefert der Extraktionsweg – physisches Passbuch scannen oder digitale Passbuchansicht als Screenshot erfassen – formatkonsistente Ausgaben aus jeder Datenquelle, wobei die Umrechnung von Ära- in gregorianische Daten unabhängig vom Eingabeformat auf der Ausgabeebene erfolgt.
Ära-übergreifende Passbücher und fehlende Jahreskopfzeilen
Ein 2018 eröffnetes und 2024 erneuertes Passbuch enthält Transaktionen aus zwei Kaiser-Ären: 平成 (Heisei) und 令和 (Reiwa). Die Äragrenze – 平成31年 (Januar–April 2019) mit Übergang zu 令和元年 (Mai–Dezember 2019) – liegt mitten im Passbuch. Die Extraktion muss den Ärawechsel auf der Seite erkennen, an der die Jahreskopfzeile von 平成 auf 令和 wechselt, und den korrekten Offset pro Transaktion anwenden. Ebenso stützen sich Fortsetzungsseiten im selben Passbuch, die die Jahreskopfzeile nicht erneut abdrucken, auf den Kontext, der von der zuletzt mit Kopfzeile versehenen Seite übernommen wird. Druckt Seite 5 令和6年 und enthalten Seiten 6–8 nur Monat und Tag, wendet die Extraktion den Kontext 令和6年 auf alle Transaktionen auf den Seiten 5 bis 8 an – und wenn Seite 9 nach der Jahresgrenze am 1. Januar 令和7年 druckt, wird der Kontext aktualisiert. Eine übersehene Kontextübernahme erzeugt Transaktionen mit unbestimmten Daten („7.15“ ohne Jahr), die keiner Zeitleiste zugeordnet werden können und den Import in die Buchhaltungssoftware scheitern lassen.
Häufig gestellte Fragen
Kann die Passbuch-Extraktion alle japanischen Banken im selben Batch verarbeiten?
Ja — ein MUFG-Passbuch mit einzeiligen Einträgen, ein Passbuch der Japan Post Bank (ゆうちょ銀行) mit zwei Zeilen pro Transaktion und ein Passbuch einer regionalen Kreditgenossenschaft (信用金庫) mit kompaktem Druck können alle im selben Batch hochgeladen werden und eine einheitliche Tabelle mit konsistenten Spalten erzeugen. Die semantische Extraktion liest, was jeder Wert bedeutet — ein Datum ist ein Datum, egal ob es auf einem Passbuch als R6.7.15 oder auf einem anderen als 令和6年7月15日 gedruckt ist. Das gleiche Fünf-Spalten-Schema funktioniert über alle Formate hinweg. Die Umrechnung von Ära- zu Gregorianischem Datum wird pro Seite basierend auf dem auf jeder Seite erkannten Ära-Header angewendet, sodass ein Batch mit Passbüchern aus verschiedenen Ären — 平成 beim MUFG-Passbuch, 令和 beim Japan-Post-Bank-Passbuch, 昭和 bei einem alten Kreditgenossenschafts-Passbuch — alle Daten im Output als yyyy-mm-dd auflöst.
Wie geht die Extraktion mit japanischen Ära-Datumsangaben (和暦) um, die verschiedene Ären umfassen?
Die Extraktion liest den Ära-Jahres-Header von jeder Seite und wendet die korrekte Umrechnungsformel an: Reiwa n = n + 2018, Heisei n = n + 1988, Showa n = n + 1925. Bei Fortsetzungsseiten ohne Jahres-Header wird der Ära-Kontext von der zuletzt mit Header versehenen Seite übernommen. Wenn eine Äragrenze mitten im Passbuch auftritt — etwa der Übergang von Heisei 31 zu Reiwa 1 am 1. Mai 2019 — erkennt die Engine den Ärawechsel auf der Seite, auf der der Header wechselt. Für das kritische Grenzjahr verwenden Transaktionen auf Seiten mit dem 平成-Header den Heisei-Offset, und Transaktionen auf Seiten mit dem 令和-Header den Reiwa-Offset. Alle Daten im Output sind gregorianisch (yyyy-mm-dd) für direkte Kompatibilität mit Yayoi, freee und MoneyForward.
Was passiert, wenn die Saldo-Verifizierung in mehreren Zeilen fehlschlägt?
Mehrere aufeinanderfolgende REVIEW-Flags lassen sich fast immer auf eine einzige Ursache zurückführen — die erste markierte Zeile. Ein falsch gelesenes Komma (¥30.000 → ¥3.000) in Zeile 47 korrumpiert den Saldo in Zeile 47, was die Verifizierung in Zeile 48 korrumpiert und jede weitere Zeile bis zum Ende des Passbuchs. Korrigieren Sie Zeile 47 — korrigieren Sie den falsch gelesenen Betrag — und die Zeilen 48 bis 280 werden korrekt neu berechnet. Der Computed-Column-Ansatz erkennt das Problem am Punkt des Fehlers; der Benutzer korrigiert die erste markierte Zeile, und der Rest löst sich auf. Ohne diesen Verifizierungsschritt tritt der Fehler in der Buchhaltungssoftware auf, wenn die Summenbilanz nicht mit dem Kontoauszug übereinstimmt — ein Abgleich, der rückwärts durch jede Zeile verfolgt werden muss, um die einzelne Fehllesung zu finden, die die Kaskade ausgelöst hat. Das Flag zur Extraktionszeit ist zwei Minuten Korrektur. Das Flag zur Buchhaltungszeit ist eine Stunde forensischer Buchführung. Für eine vollständige Behandlung dieser und anderer häufiger Fehlermodi bei der Passbuch-Dateneingabe siehe den Leitfaden zu häufigen Fehlern.
Wie verarbeitet die Extraktion handschriftliche Randnotizen auf Passbuchseiten?
Definieren Sie eine Spalte namens „Notizen“ in Ihrem Ausgabeschema. Jede lesbare handschriftliche Anmerkung in der Nähe einer Transaktionszeile – etwa eine Notiz wie 家賃 (Miete), 仕入 (Inventar) oder ein Kundenname neben einem 振込-Eintrag – wird während der Extraktion als zusätzlicher Kontext erfasst. Die Qualität der Handschrift variiert stark: Eine klare Kugelschreiber-Notiz in Standard-Kanji ist in der Regel lesbar; eine verblasste Bleistiftnotiz, die schräg geschrieben ist und die gedruckten Gitterlinien kreuzt, ist weniger zuverlässig. Bei Passbüchern, in denen handschriftliche Notizen die einzige Aufzeichnung der Transaktionskategorisierung sind, sollte die extrahierte Tabelle mit dem physischen Passbuch für die Zeilen geprüft werden, in denen die Handschrift unklar war. Die KI übernimmt die lesbare Mehrheit – und reduziert die Prüfung von jeder Zeile auf die wenigen, bei denen die Anmerkungsqualität unzureichend war.
Können extrahierte Passbuchdaten direkt in Yayoi Accounting für die 青色申告-Einreichung verwendet werden?
Ja – das Extraktionsergebnis ist eine Excel-Tabelle mit Daten im Format yyyy-mm-dd, die Yayoi Accounting (弥生会計) über die Funktion Smart Transaction Import (スマート取引取込) akzeptiert. Ordnen Sie die Extraktionsspalten dem Feldschema von Yayoi zu: Datum, Sollkonto (借方勘定科目), Sollbetrag, Habenkonto (貸方勘定科目), Habenbetrag und Beschreibung (摘要). Wenn Sie berechnete Spalten zur Vorabklassifizierung von Transaktionen verwenden – etwa 給与 auf „Gehaltseinkommen“ und 引落 auf „Betriebskosten“ mappen – sind die Kontenüberschriftsfelder bereits vor dem Import ausgefüllt. Wenn Sie die Klassifizierung lieber der Buchhaltungssoftware überlassen möchten, extrahieren Sie die Rohbeschreibungscodes und konfigurieren Sie die automatischen Kategorisierungsregeln von Yayoi oder freee, um sie den korrekten Kontenüberschriften zuzuordnen. Die über 270 API-Endpunkte von freee ermöglichen automatisierte Extraktions-zu-Buchhaltungs-Pipelines ohne manuelle Dateiübertragung; Yayoi und MoneyForward verwenden CSV-Import mit dem Yayoi-kompatiblen Format als gängigem Zwischenformat. Weitere unterstützte Plattformen sind MJS Accounting, TKC, OBC Kanjo Bugyo, Sorimachi, EPSON und PCA – alle akzeptieren dasselbe CSV-Transaktionsformat.
Benötige ich das physische Passbuch nach der Extraktion noch?
Gemäß dem Gesetz zur Aufbewahrung elektronischer Bücher (電子帳簿保存法) können gescannte Kopien von Finanzdokumenten als rechtlich zulässige Aufzeichnungen dienen, sofern sie die Anforderung des 200-dpi-Farbscans und die Speicher-Compliance-Regeln erfüllen. Das physische Passbuch bleibt jedoch das maßgebliche Originaldokument. Die National Tax Agency (国税庁) kann bei einer Steuerprüfung Originale anfordern. Beste Praxis: Extrahieren Sie das Passbuch für Ihren Buchhaltungsworkflow in eine Tabelle, bewahren Sie die gescannten Seiten als elektronische Aufzeichnungskopie auf und behalten Sie das physische Passbuch für den gesetzlichen Aufbewahrungszeitraum von sieben Jahren. Die Extraktion ersetzt den manuellen Dateneingabeschritt – sie ersetzt nicht die rechtliche Aufzeichnung.
Das Gesamtbild: Wo die Passbuch-Extraktion in den japanischen Buchhaltungs-Workflow passt
Der Steuererklärungs-Workflow eines japanischen Einzelunternehmers bestand historisch aus zwei getrennten Hälften. Die erste Hälfte – die Passbuch-Dateneingabe – ist manuell: Seiten auf dem Schreibtisch verteilt, Ära-Daten im Kopf umgerechnet, Beträge Zeile für Zeile in eine Tabellenkalkulation oder Buchhaltungssoftware eingegeben. Die zweite Hälfte – Buchhaltung und Einreichung – findet in Yayoi, freee oder MoneyForward statt, wo die Daten abgeglichen, kategorisiert und zur blauen Steuererklärung (青色申告決算書) zusammengestellt werden. Die beiden Hälften werden durch manuelle Übertragung verbunden, und die Qualität dieser Verbindung bestimmt, ob die Steuererklärung beim ersten oder erst beim fünften Versuch aufgeht.
Die Passbuch-Extraktion ersetzt die manuelle Übertragung durch eine automatisierte. Die Passbuch-Seiten werden zu Bildern; die Bilder werden zu einer Tabellenkalkulation mit verifizierten Daten, kategorisierten Transaktionen und markierten Abweichungen; die Tabellenkalkulation wird in die Buchhaltungssoftware importiert, wo der restliche Workflow unverändert bleibt. Der Extraktionsschritt verändert weder die Buchhaltungssoftware, den Steuererklärungsprozess noch die Abzugsstruktur der blauen Steuererklärung – er verändert die Datenpipeline, die in diese einfließt.
Im Rahmen der Steuerreform 2027 hat diese Pipeline einen Abzugswert. Ein Einreicher, der bei Papier bleibt – manuelle Passbuch-Übertragung, Papiererklärung – erhält ¥100.000. Ein Einreicher, der die Pipeline digitalisiert – extrahierte Passbuch-Daten, die in die elektronische Einreichung über e-Tax fließen – erhält ¥650.000, oder ¥750.000 mit qualifizierten elektronischen Büchern. Die Lücke von ¥450.000–¥650.000 ist keine Steuergutschrift für die Nutzung von Extraktionssoftware. Es ist das Steuersystem, das den Status quo der manuellen Passbuch-Dateneingabe zu seinen tatsächlichen Kosten bepreist – und den Wechsel zu digital vor der Verengung des Abzugsfensters fördert.
Die Anleitung zur Extraktion eines einzelnen Passbuchs behandelt das Fünf-Spalten-Setup und die erste Extraktion. Der Leitfaden zur Batch-Verarbeitung behandelt die Konsolidierung über mehrere Jahre und Banken. Die Problemanalyse erklärt, warum der manuelle Status quo trotz verfügbarer Tools fortbesteht. Die Kostenanalyse quantifiziert den finanziellen Schaden fortgesetzter manueller Eingabe. Der Leitfaden zu häufigen Fehlern behandelt Saldoabweichungen und Verifizierungsstrategie. Dieser Artikel – der Hub – verbindet sie zu einem Gesamtbild, warum die Passbuch-Extraktion existiert, wie sie funktioniert, wo sie in den Buchhaltungs-Stack passt und warum die Steuerreform 2027 sie zum Standardweg für jeden japanischen Einzelunternehmer macht, der eine blaue Steuererklärung einreicht.