ゾーナルOCRとは何か、そして
それを壊す4つの形状
ゾーナルOCRは、機械がページを理解するなど誰も予想していなかった何十年も前から、ドキュメント自動化を可能にしました。それは、何も理解しないことを選ぶことで実現しました。請求書の合計の周りに長方形を描くと、ソフトウェアはその長方形だけを読み取り、値が名前付きフィールドに入ります。
この割り切りがもたらしたのは、スピード、決定性、そして非常に特殊な脆さでした。以下では、ゾーンとはピクセルとOCR呼び出しのレベルで何なのか、ゾーンが壊れる4つのドキュメント形状、そしてゾーンを維持すべきかを決める問い、つまりページのレイアウトを誰が管理しているのかを解説します。
主なポイント
- ゾーナルOCRはフォーム上に描いたボックスだけを読み取るため、最悪の失敗はエラーではなく、形式は正しいが誤った数値が入ることです。
- スキャンの回転が2度あるだけで、小計1,065.00が検証オブジェクトに何も指摘されずに合計フィールドへ入り込みます。
- 1ページを2度回転させて再実行し、ツールがそのずれを検知するのか、それとも黙って転記するのかを確認しましょう。
ゾーンとはピクセルの矩形であり、テンプレートはそのプログラムである
ゾーンとは、ページ上の座標で定義された矩形であり、フィールド名に紐づけられます。テンプレートとは、それらの矩形の集合であり、同じ外観であるべきすべてのドキュメントに適用されます。
この技術にはいくつもの呼び名があります。ゾーンOCR、ゾーナルOCR、テンプレートOCR、フィールドレベルOCRはすべて同じ技術を指すため、ベンダーはこれらの用語を互換的に使っています。あるツールのセットアップが「サンプルをアップロードしてボックスを描く」ことから始まるなら、パンフレットで何と呼ばれていようとそれはゾーナルOCRです。
ゾーナルOCRとページ全体OCRの違いは、出力されるものにあります。ページ全体OCRはページ全体をテキストに変換し、読み取り順序を保持します。これは検索、アーカイブ、検索可能なPDFに適しています。ゾーナルOCRは名前付きの値を返します。これはスプレッドシートの列に適しています。どちらも読み取った内容を解釈しません。一方はドキュメントを生成し、もう一方はレコードを生成します。
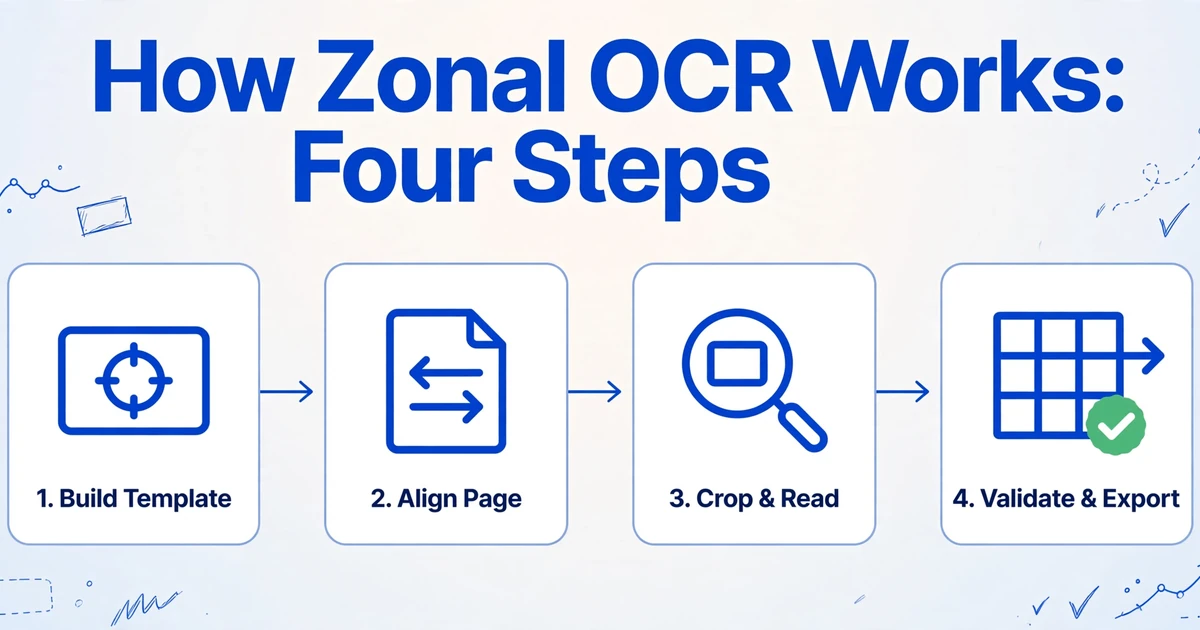
作業は4つのステップで進み、3番目のステップでアーキテクチャの違いが明らかになります。
テンプレートを作成する
代表的なドキュメントを1つスキャンし、各フィールドの周囲に矩形を描き、名前を付けます。ツールは座標を保存しますが、多くの場合ページの幅と高さに対する相対値として保存されるため、サイズ変更しても座標が無効になりません。
受信ページの位置を合わせる
傾き補正、再スケーリングを行い、場合によってはレジストレーションマークやアンカー単語を照合することで、保存された座標がサンプルと同じコンテンツ上に配置されるようにします。
切り出して読み取る
各ゾーンはページ画像から切り出され、それ自体が小さな画像としてOCRエンジンに渡されます。エンジンはページの残りの部分を一切見ません。
検証してエクスポートする
パターンまたはデータ型が各値の形状をチェックし、ラベル付けされた結果がスプレッドシート、データベース、またはERPに送られます。
ステップ3は、設定ミスのように見えてそうではない失敗を説明しています。Tesseractのドキュメントには、エンジンはデフォルトでテキストのページを想定しており、小さな領域をOCRするには入力を行として扱うなど、別のセグメンテーションモードが必要であると記載されています。ゾーンはページへのポインタではありません。それは新しい画像であり、エンジンにはどのような種類の画像を見ているのかを伝える必要があります。
これらすべての制約の見返りはコストです。細い5本の帯を読み取るコストは、ページ全体を読み取るコストのほんの一部であり、ローカルエンジンではページあたりの限界コストはほぼゼロです。精度よりもこの経済性こそが、ゾーナルOCRが今もスキャンソフトウェア、キャプチャスイート、そして長い尾を引く社内スクリプトの中で動き続けている理由です。
ゾーンが依然として他を圧倒する場面
レイアウトを自分で制御できる場合、ゾーナルOCRは今も正しい選択です。これは懐古趣味ではありません。変化しないページに対して利用できる、最も安価な決定論的選択肢です。
適合する範囲は狭く、明確に識別できます。自分で設計・印刷する社内フォーム(経費申請書、点検チェックリスト、入社手続き書類)、公式版が1つしか流通しない標準化された政府フォーム、単一送信者からの大量出力(1つの銀行の明細、1つのラボのレポート)、ID書類、テスト用紙などです。ゾーン内では、同じエンジンで手書き活字用のICRやチェックボックス用のOMRも実行できるため、手書きで記入された社内フォームは正当なユースケースです。
コストモデルは、ほとんどの比較が飛ばしてしまう部分です。ローカルのゾーンエンジンは1ページを約1秒以下で処理し、ページあたりの課金はありません。ビジョンモデルは1ページに数秒かかり、推論に対して課金されます。変化しない1つのフォームを5万ページ処理する場合、精度の話に入る前に、この差がプロジェクトの成否を決めます。
この手法は、その評判よりも柔軟です。実運用のツールにはアンカー(「Invoice No.」という語を見つけてその右側を読む)、パターン(より広いゾーンで請求書番号らしい形を検索する)、ストップワードまでページ下方に伸びる動的ゾーンが追加されています。それぞれの追加が許容度を高めます。しかし、いずれもレイアウトごとの設定を不要にはしません。そしてコストがかかるのはまさにその部分です。
1つのシステムが1つのバージョンで印刷した1つのフォームがすでに正しく読み取れているなら、ビジョンモデルを追加しても、すでに持っている以上のものは得られません。
ゾーンが破綻する4つのドキュメント形状
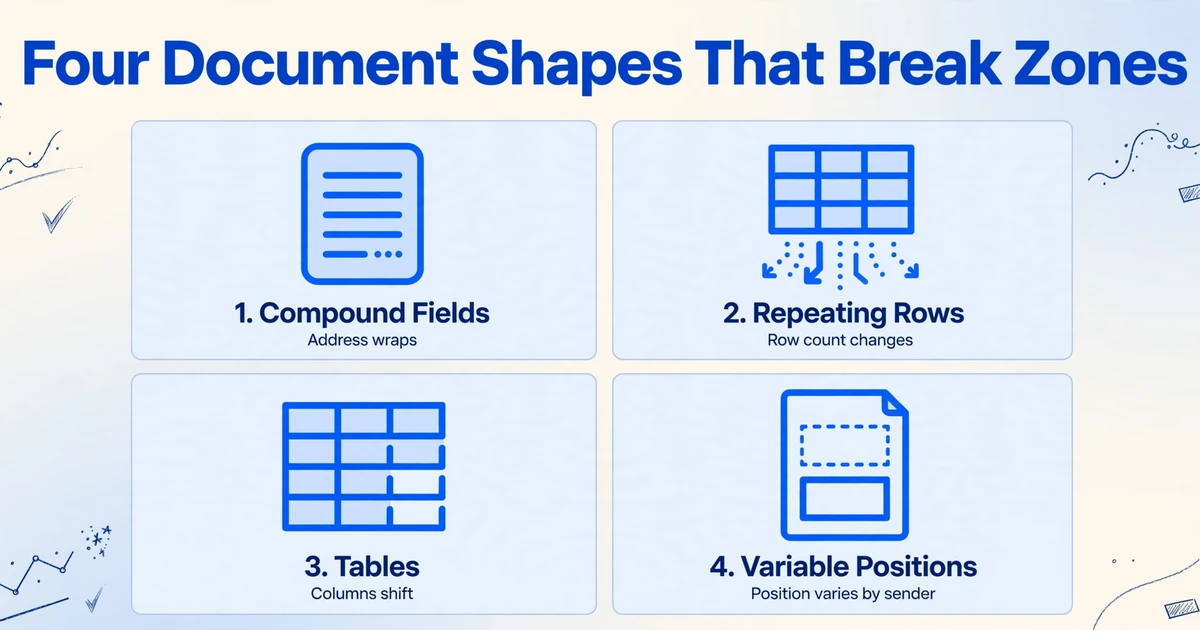
ゾーンが破綻するのは4つのドキュメント形状であり、それぞれ異なる機械的な理由で失敗します。どの形状を見ているかを把握することは、レイアウトが変わるという一般的な警告よりも役立ちます。
1. 複合フィールド
複合フィールドとは、固定された矩形の中の単一行に収まらない値を保持するフィールドです。請求先住所は顧客に応じて2〜5行になります。金額は数字と漢数字でそれぞれ一度ずつ記載されます。ベンダー名は折り返されます。「請求書番号」と「日付」は同じ水平帯を共有し、その間隔は番号の長さに応じて移動します。
ゾーンは最長の住所に合わせて十分な高さが必要であり、かつ下に印刷された電話番号を拾わないよう十分に狭くする必要があります。この2つの要件は互いに矛盾し、テンプレートはどちらか一方しか満たせません。その結果、住所が切り詰められたり、電話番号が市区町村として記録されたりします。
2. 繰り返し行
明細行を追加するたびに、その下のすべてがページ内で下に押し出されます。6行の請求書で構築されたテンプレートは、合計を固定の高さに配置します。同じベンダーに9行の請求書を送ると、合計ゾーンは明細行の上に位置することになります。
固定グリッドは、送信者が同意していない行数をエンコードしています。長い注文ではさらに2つ目の失敗が重なります。合計が2ページ目に移動し、1ページ目用に定義されたテンプレートは代わりに最後の明細行を返します。
3. テーブル
列ごとのゾーンは、列が水平位置を維持し、行が高さを維持することを前提としています。実際の明細行テーブルではどちらも成り立ちません。説明が2行目に折り返され、数量は可変幅のセル内で右揃えになり、合計行は列をまたぎ、結合セルはその右側のすべてをずらします。
Tesseractの公式ドキュメントは、カスタムセグメンテーションとレイアウト分析なしでは、このエンジンがテーブルの扱いを苦手とすると述べています。ゾーナルテンプレートは、まさにその分析を手作業で代替するものであり、テーブルの形状が変わるたびに再構築が必要です。
4. 変動する位置
同じフィールドでも、送信元が異なればドキュメント上の座標も異なります。割引行、税の内訳、発注書参照などは、ある請求書にはあって別の請求書にはなく、任意のブロックがあるたびにその下のフィールドが押し下げられます。スキャナーの倍率が違えば、すべてが一斉にずれます。
これが、1つのテンプレートを200個に増やしてしまう要因です。ゾーナルキャプチャを販売するABBYYは、自社の用語集の項目で、このアプローチは仕入先の請求書や、送信元によってレイアウトが変わるドキュメントには適さないと述べています。その技術の提供元がそう線引きしているなら、真剣に受け止める価値があります。
2度の傾きがゾーンに与える影響
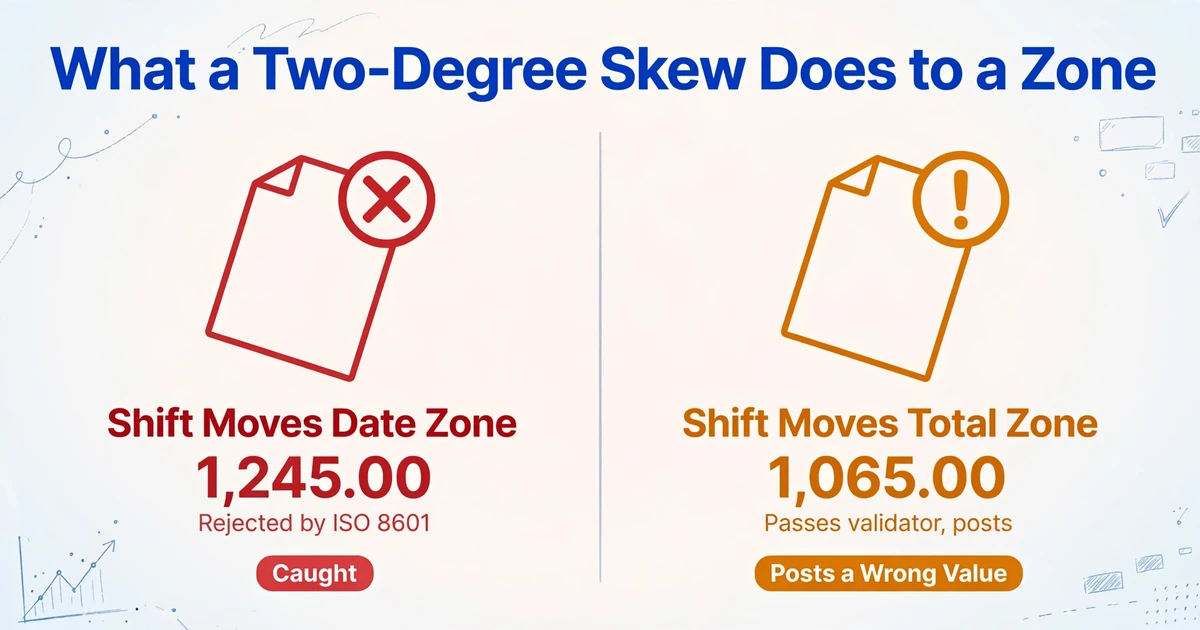
2度の回転で、値は狭いゾーンから外へ出てしまいます。どちらの方向に動くかによって、その誤りに気づけるかどうかが決まります。
Letterサイズのページを2度回転させると、ページ中心から4インチの点は約0.14インチ動きます。300 DPIではおよそ42ピクセルで、10ポイントのテキスト1行分に近い距離です。値の端に合わせて引かれたゾーンは、今や隣の値を読み取っています。
ずれによって日付ゾーンが合計の上に移動すると、そのフィールドには1,245.00のような値が入ります。ISO 8601に基づく日付ルールはこれを拒否し、ドキュメントは例外キューに送られ、誰かがスキャンを修正します。煩わしいですが、目に見えて、安全です。
ずれによって合計ゾーンが1行上に移動すると、合計フィールドには小計1,065.00が入ります。この値自体に不正な点はありません。金額バリデータを通過し、登録され、$180の差額は数週間後の照合で初めて明らかになります。抽出ステップは成功を報告していました。
修正される失敗は、エラーを投げる失敗です。コストを生む失敗は、完全に整った形式の誤った数値を返す失敗です。
テストでは、きれいで位置合わせの取れたサンプルを使います。本番には、スキャナーをわずかに傾いて通過したページも含まれます。そしてバリデータは、今受け入れた数値が割り当てられたフィールドのものかどうかについて、何の意見も持ちません。
テンプレートを保守するのは誰か、不正な行を見つけるのは誰か
テンプレートには所有者がいますが、不正な行を見つけるのは通常は別の人です。この分離こそが、実際の運用コストがかかるところです。
テンプレートは通常、ツールを設定した人が構築します。運用アナリスト、IT担当者、時には契約に署名した本人です。なぜゾーンがテキストより数ピクセル広く描かれたのか、なぜ罫線の下ではなく上から始まるのかは、その人の記憶の中にあり、ツールの中にはありません。その人が異動すると、テンプレートライブラリは考古学になります。
不正な行は、後になって別の場所で見つかります。AP担当者がベンダーの明細書を照合し、金額が一致しません。経理責任者が月末に差異に気づきます。サプライヤーが、なぜ請求書がまだ未払いなのかとメールで尋ねてきます。いずれの場合も、エラーは抽出時に生まれ、下流で発見され、誰も記録していなかったレイアウト変更をたどって特定されます。
オンボーディングはコストのもう半分です。r/dataengineeringのある実務者は、その違いを端的に述べています。「新しいベンダーのレイアウト用にテンプレートを構築するのに約4時間かかっていたのが、0秒になった」。同じコメントは、その時間が代わりにどこへ移ったかも指摘しています。テンプレートを書くのではなく、出力を検証する方へです。時間は消えません。移動するのです。
カバレッジは二者択一です。レイアウトはライブラリに入っているか、いないかのどちらかで、ライブラリの境界は、送信者がフォームを再設計したり、ロゴを変更したり、フィールドを追加したりするたびに動きます。ツールが新しいレイアウトの80%を処理し、見逃した20%を教えてくれるという中間状態はありません。
抽出が座標に依存しなくなると何が変わるか
セマンティック抽出は、問いを「値がどこにあるか」から「値が何であるか」に変えます。ページは依然として重要です。その座標がアドレスでなくなるだけです。
ImageToTable.aiはCustom Column Extractionで動作します。「Invoice Number」「Due Date」「Total」など、必要な列名を入力すると、ビジョンモデルがページ全体を読み取り、各値が何を意味するかによって特定します。入力した列名が出力テーブルのヘッダーになります。これは、位置ではなく名前でドキュメントから特定のフィールドを抽出するのと同じ考え方で、ボックスを描く必要も、座標を保存する必要もありません。ここでいうフォーマット非依存とはそういう意味です。レイアウトが変わっても抽出は変わりません。
レイアウトは依然として証拠です。罫線の下、「Total」という語の隣、右下隅にある数字は、ヘッダーにある同じ数字よりも合計である可能性が高いです。違いは、この証拠が数か月前にテンプレートに固定されるのではなく、抽出時に解釈されることです。何も記憶されていないので、何も古くなりません。
実務上の結果は直接的に導かれます。新しいベンダーの最初の請求書にはセットアップが不要です。60行のテーブルは、テンプレートが想定した6行に切り詰められるのではなく、全体が読み取られます。2度回転したスキャンには、失敗する位置合わせステップがありません。位置合わせする座標系が存在しないからです。
ファイルは安全に処理され、保存されません。
このアプローチで解決できない点も、同じくらい率直に述べておく価値があります。ドキュメントに小計と支払金額という2つのもっともらしい候補が含まれる場合、モデルは依然として選択を迫られ、その判断には列名が十分に具体的である必要があります。ソースに印刷された計算エラーは忠実にコピーされます。かすかな手書き文字は、どのモデルでも読み取れる範囲を制限します。そしてビジョンモデルは自信を持って間違えることがあるため、レビュー画面では各セルの由来となった領域がハイライトされ、疑わしい値を1〜2秒でページ上に遡って確認できます。
印刷された表データは最大99%の精度で認識され、1ページあたりおよそ5〜10秒です。これはバッチ処理には十分な速さであり、台帳に転記するフィールドのレビューを省略する理由にはなりません。失敗の仕方は重要な違いがあります。ゾーンがずれると、同じレイアウトを共有するすべてのドキュメントで同じ誤った値が返される一方、モデルの偶発的な見落としは特定の1つのドキュメントに固有で、次には繰り返されません。
どちらが必要かはドキュメントで判断する方法
ドキュメントの数ではなくレイアウトの数を数え、誰がそれを管理しているかを考えてください。3社からの1万件の請求書はゾーンが得意とする問題です。200社からの200件の請求書はそうではありません。
実用的なルール:レイアウトが自社のもので、安定していて、数が少なければ、ゾーンの方が安く、速く、より正確です。レイアウトが他人のものであったり、予告なく新しいバージョンが届いたり、十数種類以上の異なるフォーマットに及ぶ場合は、ゾーンの維持コストがモデルのページ単価を上回ります。厄介な中間、つまり月に8~10社の送信者から数百ページというケースは、通常、テンプレート修復にどれだけ人員の時間を割けるかで決まります。
3つのチェックで、ベンダーのデモより速く結論が出ます。
- 変動するフィールドを実行する。テンプレート化したことのない20件のドキュメントで、合計、税額、支払期日を取得してください。失敗を数えます。フィールド全体で精度を平均しないでください。
- 1ページを2度回転させて再実行する。ツールがエラーを出すか、もっともらしい誤った数値を返すかを観察してください。後者の動作が帳簿に到達するものです。
- 誤った合計に誰が、いつ気づくかを問う。答えが「来月の照合時」なら、どのエンジンを選んでもレビューステップを追加してください。
| 観点 | ゾーナルOCR | セマンティック抽出 |
|---|---|---|
| レイアウトごとの設定 | サンプル上にボックスを描き、各フィールドに名前を付ける | 必要な列名を入力する |
| 新しい送信者からの最初のドキュメント | テンプレートを待つ | 他のドキュメントと同様に処理される |
| レイアウト変更 | テンプレート修復、多くの場合遅れて発覚する | 修復すべきテンプレートがない |
| 明細行のテーブル | 固定の行グリッド。長いテーブルはあふれる | 行数に関係なく全体を読み取る |
| 回転または拡大縮小されたスキャン | 再調整するか、誤ったピクセルを読み取る | 位置合わせのステップがない |
| ページ単価 | ローカルエンジンならほぼゼロ | モデル推論、1ページあたり数秒 |
| 典型的な失敗 | 誤った場所から取得したもっともらしい値が、そのレイアウトの全ページで繰り返される | ドキュメントごとに時折発生する見落としで、レビューで発見される |
| 最適な用途 | 自社で印刷・管理する固定フォーム | 多くの送信者からのドキュメントや変更されるバージョン |
技術ではなくツールを比較する場合、違いは、これまで見たことのないベンダーを各ツールがどう扱うかに現れます。Docparserのようなテンプレートベースの製品は、何かを読み取る前にレイアウト用の解析ルールが必要ですが、セマンティックツールは列名を要求し、最初のドキュメントから処理を開始します。OCRソフトウェアとその価格のより広範な比較はOCRソフトウェアのまとめにあり、テキストではなくスキャンページをテーブル行に変換するソフトウェアが実際に必要な場合は、データ入力向けOCRソフトウェアのページでその方法を説明しています。
FAQ
ゾーナルOCRとは簡単に言うと何ですか?
サンプルページ上に描いたボックスに限定して行うOCRです。各ボックスはフィールド名に紐づけられるため、出力はテキストの塊ではなく、ラベル付きの値の集合になります。ソフトウェアはボックス内に収まる部分だけを読み取ります。
ゾーナルOCRはテンプレートOCRと同じですか?
はい。ゾーンOCR、ゾーナルOCR、テンプレートOCR、フィールドレベルOCRは同じ技術を指します。見分け方は設定方法です。サンプルをアップロードして矩形を描くところから始まるなら、それはゾーナルOCRです。
ゾーナルOCRとページ全体OCRの違いは何ですか?
ページ全体OCRはページ上のすべての文字を読み取り、通常は検索可能なテキストレイヤーとして読み取り順に返します。ゾーナルOCRは定義した領域だけを読み取り、名前付きフィールドを返します。ページ全体OCRは検索とアーカイブ向けに作られ、ゾーナルOCRはデータキャプチャ向けに作られています。どちらもテキストの意味を理解しません。ここから従来のOCRの精度限界が始まります。
ゾーナルOCRの主な限界は何ですか?
固定位置、固定フィールドサイズ、変動する行数、スキャンの傾き、そしてレイアウトごとに1つのテンプレート。最もコストのかかる限界は、失敗してもエラーではなく間違った場所から正しく見える値が返ることが多く、下流の工程で初めて発覚することです。
ゾーナルOCRは手書き文字に対応していますか?
ゾーン内では、日付ボックスや数値グリッドのような制約されたフィールドであれば、ICRが手書き活字を読み取れます。筆記体や制約のない手書き文字は依然として信頼性が低く、帳票ごとに長さや位置が変わる値にはゾーンは役立ちません。
ゾーナルOCRを完全に置き換えるべきですか?
いいえ。レイアウトが自社のもので、量が多く、帳票が変わらない場合はそのまま使い続けてください。レイアウトが管理できない送信者側のものである場合は置き換えてください。判断の分かれ目はページの所有権であり、技術の古さではありません。
ゾーンとは、次回もページが同じ見た目になるという約束です。その約束が守られるかどうかは、ソフトウェアではなくドキュメントの性質によるものです。
自分で帳票を印刷するなら、その約束は自分で守るものであり、ゾーンはそれを守る良い方法です。他人が印刷するなら、その約束はそもそも自分ができるものではありません。その場合は、欲しい列名を入力し、モデルがどこにあってもそれを見つけるようにすれば、メンテナンスの待ち行列がスプレッドシートに変わります。
壊れ続けるレイアウトをお持ちください。何が返ってくるか見てみましょう。