O que é Zonal OCR e as
quatro formas que o quebram
O Zonal OCR tornou a automação de documentos possível décadas antes de alguém esperar que uma máquina entendesse uma página. Ele fez isso ao se recusar a entender qualquer coisa. Você desenha um retângulo ao redor do total da fatura, o software lê apenas esse retângulo e o valor cai em um campo nomeado.
Essa troca comprou velocidade, determinismo e um tipo muito específico de fragilidade. O que segue aborda o que é uma zona no nível de pixels e chamadas de OCR, as quatro formas de documento em que as zonas quebram e a pergunta que decide se você deve mantê-las: quem controla o layout da página.
Principais conclusões
- O Zonal OCR lê apenas as caixas que você desenha em um formulário, então sua pior falha é um número errado bem formado em vez de um erro.
- Dois graus de rotação na digitalização bastam para colocar o subtotal, 1.065,00, no campo total sem que nenhum validador reclame.
- Gire uma página dois graus e execute-a novamente para ver se sua ferramenta detecta a mudança ou a registra silenciosamente.
Uma zona é um retângulo de pixels, e o modelo é o programa
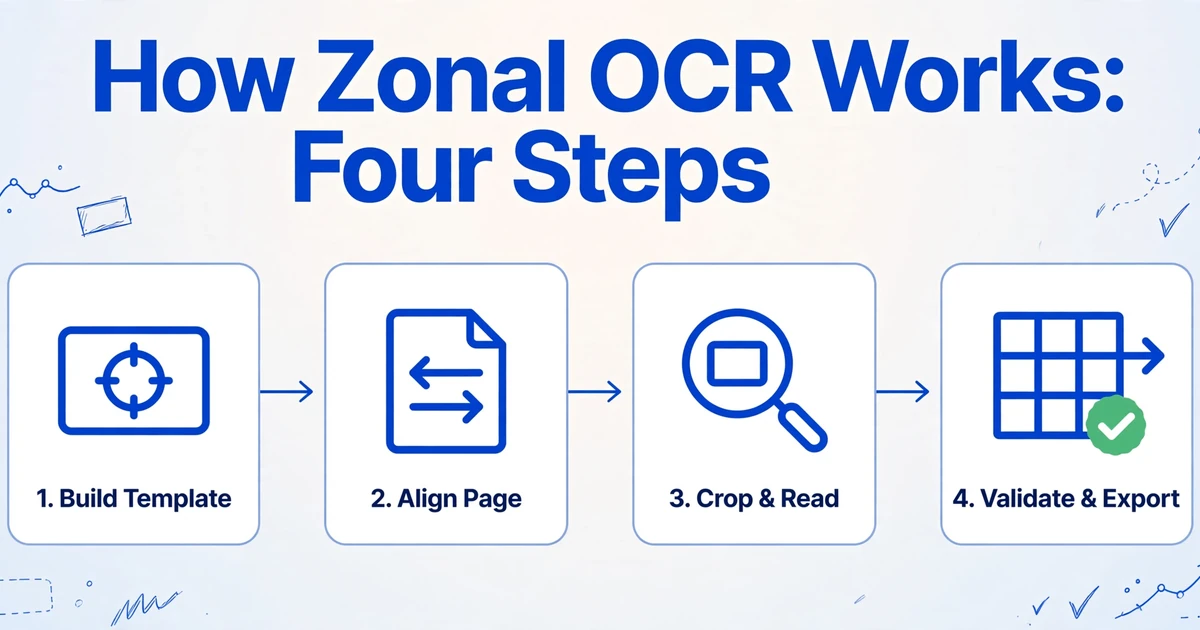
Uma zona é um retângulo de coordenadas em uma página, vinculado a um nome de campo. Um modelo é um conjunto desses retângulos, aplicado a todo documento que deveria ter a mesma aparência.
A técnica atende por vários nomes. Zone OCR, Zonal OCR, OCR de modelo e OCR em nível de campo designam a mesma técnica, então os fornecedores usam os termos de forma intercambiável. Se a configuração de uma ferramenta começa com "envie uma amostra e desenhe caixas", é Zonal OCR, independentemente do nome que o folheto usa.
A diferença entre Zonal OCR e OCR de página inteira está no que sai do outro lado. O OCR de página inteira converte a página toda em texto e mantém a ordem de leitura, que é o que você quer para busca, arquivamento ou um PDF pesquisável. O Zonal OCR retorna valores nomeados, que é o que você quer para uma coluna de planilha. Nenhum dos dois interpreta o que lê. Um produz um documento, o outro produz um registro.
O trabalho acontece em quatro etapas, e é na terceira que a arquitetura se revela.
Crie o modelo
Digitalize um documento representativo, desenhe um retângulo ao redor de cada campo e dê um nome a ele. A ferramenta armazena as coordenadas, muitas vezes relativas à largura e à altura da página, para que um redimensionamento não as invalide.
Alinhe a página recebida
Faça a correção de inclinação, redimensione e, às vezes, corresponda a uma marca de registro ou uma palavra âncora, para que as coordenadas armazenadas caiam sobre o mesmo conteúdo sobre o qual caíram na amostra.
Recorte e leia
Cada zona é recortada da imagem da página e enviada ao mecanismo de OCR como uma pequena imagem própria. O mecanismo nunca vê o restante da página.
Valide e exporte
Um padrão ou tipo de dado verifica o formato de cada valor, e então os resultados rotulados vão para uma planilha, um banco de dados ou um ERP.
A terceira etapa explica uma falha que parece um erro de configuração e não é. A documentação do Tesseract afirma que o mecanismo espera uma página de texto por padrão, e que fazer OCR de uma pequena região exige um modo de segmentação diferente, como tratar a entrada como uma única linha. Uma zona não é um ponteiro para dentro de uma página. É uma nova imagem, e o mecanismo precisa ser informado de que tipo de imagem está vendo.
O retorno de todas essas restrições é o custo. Ler cinco faixas estreitas custa uma fração de ler uma página inteira e, em um mecanismo local, o custo marginal por página é quase nulo. Essa economia, mais do que a precisão, é o motivo pelo qual o Zonal OCR ainda roda dentro de softwares de digitalização, suítes de captura e uma longa cauda de scripts internos.
Onde as Zonas Ainda Superam Todo o Resto
O Zonal OCR continua sendo a escolha correta quando o layout está sob seu controle. Isso não é nostalgia. É a opção determinística mais barata disponível para uma página que não muda.
O encaixe é estreito e reconhecível: formulários internos que você projeta e imprime (pedidos de reembolso, checklists de inspeção, pacotes de integração), formulários governamentais padronizados em que circula apenas uma versão oficial, a saída de um único remetente em volume (extratos de um banco, laudos de um laboratório), documentos de identidade e folhas de teste. Dentro de uma zona, os mesmos mecanismos também podem executar ICR para caracteres impressos à mão e OMR para caixas de seleção, então um formulário interno preenchido à mão é um caso de uso legítimo.
O modelo de custo é a parte que a maioria das comparações ignora. Um mecanismo de zona local processa uma página em cerca de um segundo ou menos e não cobra nada por página. Um modelo de visão leva segundos por página e cobra pela inferência. Em cinquenta mil páginas de um mesmo formulário inalterado, essa diferença decide o projeto antes de a precisão entrar na conversa.
A técnica também é menos rígida do que sua reputação sugere. Ferramentas de produção adicionam âncoras (encontre as palavras "Invoice No." e leia à direita delas), padrões (procure em uma zona mais ampla algo com o formato de um número de fatura) e zonas dinâmicas que se estendem pela página até uma palavra de parada. Cada adição compra tolerância. Nenhuma delas elimina a configuração por layout, que é a parte que custa dinheiro.
Se um formulário, impresso por um sistema, em uma versão, já é lido corretamente, adicionar um modelo de visão não compra nada que você já não tenha.
As Quatro Formas de Documento Onde as Zonas Falham
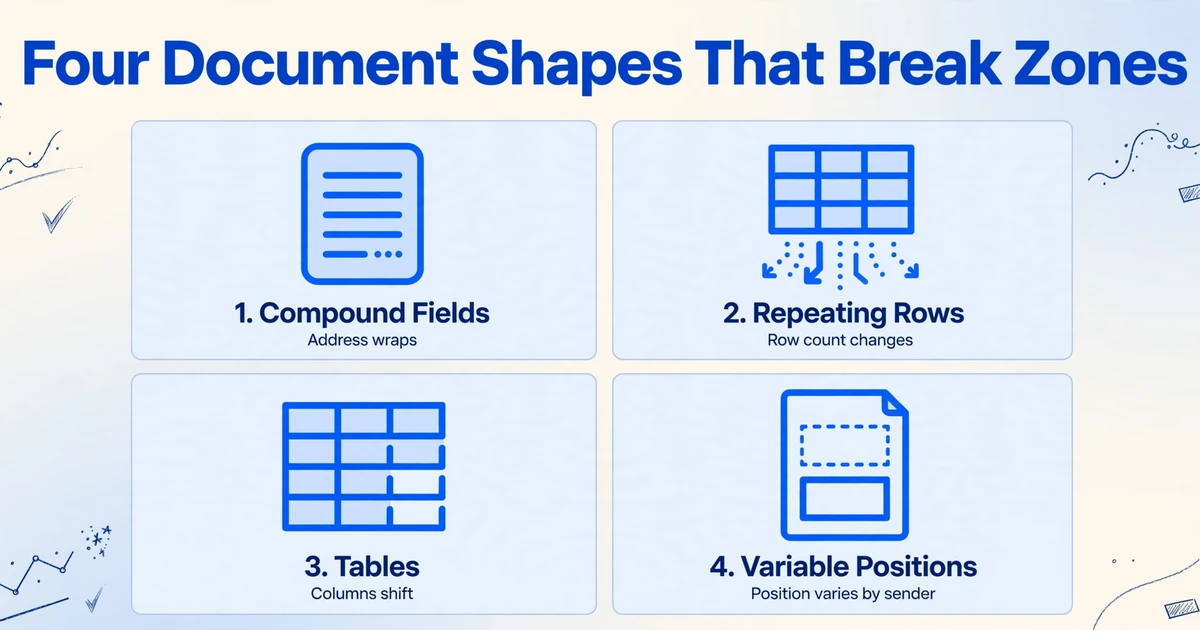
As zonas falham em quatro formas de documento, e cada uma falha por um motivo mecânico diferente. Saber qual forma você está analisando é mais útil do que um aviso genérico de que os layouts mudam.
1. Campos compostos
Um campo composto contém um valor que não é uma única linha dentro de um retângulo fixo. Um endereço de cobrança ocupa de duas a cinco linhas, dependendo do cliente. Um valor aparece uma vez em dígitos e outra em palavras. O nome de um fornecedor quebra em várias linhas. "Invoice No." e "Date" compartilham uma mesma faixa horizontal com um espaço que se desloca conforme o comprimento do número.
Uma zona precisa ser alta o suficiente para o endereço mais longo e estreita o suficiente para não capturar o telefone impresso abaixo. Esses dois requisitos se contradizem, e o modelo só consegue atender a um deles. O resultado é um endereço truncado ou um telefone arquivado como cidade.
2. Linhas repetidas
Cada item de linha que você adiciona empurra tudo abaixo dele para baixo na página. Um modelo criado com base em uma fatura de seis linhas posiciona o total a uma altura fixa. Envie ao mesmo fornecedor uma fatura com nove linhas e a zona do total cai sobre um item de linha.
Uma grade fixa codifica uma contagem de linhas com a qual o remetente nunca concordou. Pedidos longos adicionam uma segunda falha: o total passa para a página dois, e um modelo definido para a página um retorna o último item de linha.
3. Tabelas
Uma zona por coluna pressupõe que as colunas mantenham suas posições horizontais e que as linhas mantenham sua altura. Nenhuma das duas coisas se sustenta em uma tabela real de itens de linha. Uma descrição quebra para uma segunda linha, uma quantidade é alinhada à direita em uma célula de largura variável, uma linha de totais abrange as colunas e uma célula mesclada desloca tudo à sua direita.
A própria documentação do Tesseract observa que o mecanismo tem dificuldades com tabelas sem segmentação personalizada e análise de layout. Um modelo zonal é um substituto construído manualmente para exatamente essa análise, e precisa ser reconstruído sempre que a tabela muda de forma.
4. Posições variáveis
O mesmo campo fica em coordenadas diferentes nos documentos de remetentes diferentes. Uma linha de desconto, um detalhamento de impostos ou uma referência de pedido de compra aparece em algumas faturas e não em outras, e cada bloco opcional empurra os campos abaixo dele para baixo. Uma escala de scanner diferente move tudo de uma vez.
Esse é o formato que transforma um modelo em duzentos. A ABBYY, que vende captura zonal, afirma em sua própria entrada de glossário que a abordagem não é apropriada para faturas de fornecedores nem para qualquer tipo de documento cujo layout varie entre remetentes. Quando o fornecedor da técnica traça essa fronteira, vale a pena levar a sério.
O que uma inclinação de dois graus faz com uma zona
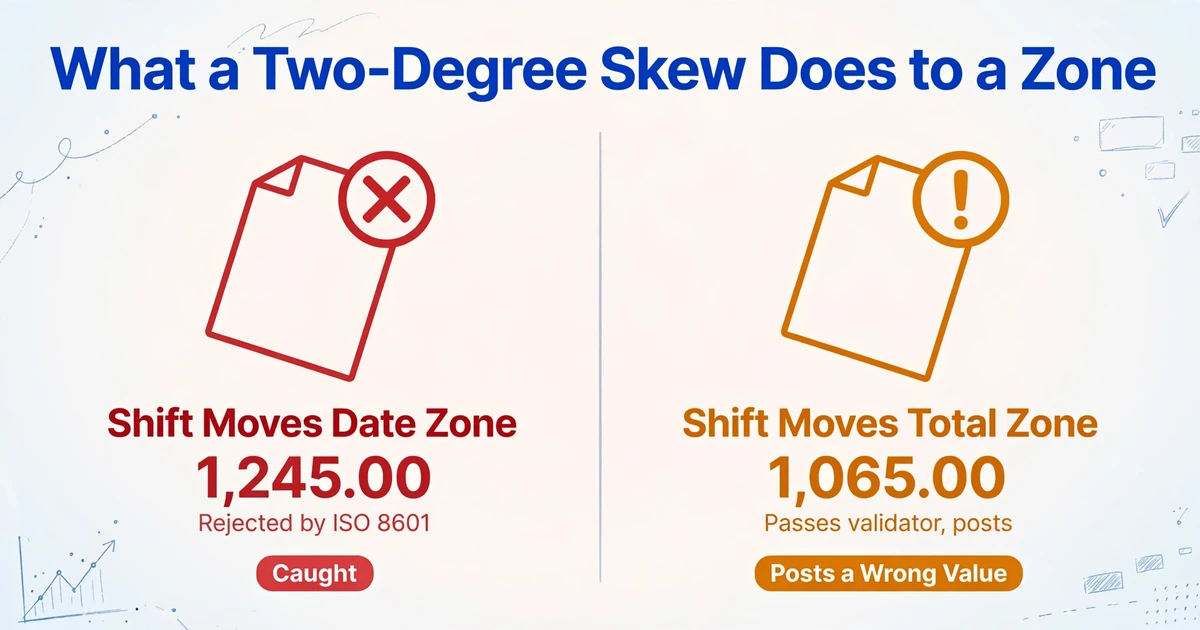
Uma rotação de dois graus é suficiente para mover um valor para fora de uma zona estreita. A direção para a qual ele se move decide se você algum dia vai descobrir.
Girar uma página Letter em dois graus move um ponto a quatro polegadas do centro da página em cerca de 0,14 polegada. A 300 DPI, isso é aproximadamente 42 pixels, perto de uma linha de texto de 10 pontos. Uma zona que foi desenhada até a borda de um valor agora está lendo o vizinho.
Se o deslocamento mover a zona de data para cima do total, o campo recebe algo como 1,245.00. Uma regra de data baseada em ISO 8601 a rejeita, o documento vai para uma fila de exceções e alguém corrige o scan. Irritante, visível, seguro.
Se o deslocamento mover a zona de total uma linha para cima, o campo de total recebe o subtotal, 1,065.00. Nada nesse valor está malformado. Ele passa pelo validador de valores, é registrado, e a diferença de $180 aparece na conciliação semanas depois. A etapa de extração reportou sucesso.
As falhas que são corrigidas são as que geram um erro. As falhas que custam dinheiro são as que retornam um número errado perfeitamente bem formado.
Os testes usam amostras limpas e bem alinhadas. A produção inclui a página que passou pelo scanner levemente inclinada, e o validador não tem opinião sobre se o número que acabou de aceitar pertence ao campo ao qual foi atribuído.
Quem Mantém os Modelos, e Quem Encontra as Linhas Ruins
O modelo tem um dono, e quem encontra a linha ruim geralmente é outra pessoa. É nessa separação que está o custo operacional real.
Os modelos normalmente são criados por quem configurou a ferramenta: um analista de operações, um funcionário de TI, às vezes a pessoa que assinou o contrato. Por que uma zona foi desenhada alguns pixels mais larga que o texto, ou começa acima da linha em vez de abaixo dela, vive na memória dessa pessoa, não na ferramenta. Quando ela muda de função, a biblioteca de modelos vira arqueologia.
A linha ruim é encontrada depois e em outro lugar. Um auxiliar de AP concilia um extrato de fornecedor e não consegue casar um valor. Um controller percebe uma variação no fechamento do mês. Um fornecedor manda e-mail perguntando por que uma fatura ainda não foi paga. Em cada caso, o erro foi criado na extração, descoberto depois, e rastreado até uma mudança de layout que ninguém registrou.
A integração é a outra metade da conta. Um profissional no r/dataengineering resumiu a diferença: "Passamos de ~4 horas para criar um modelo para o layout de um novo fornecedor para 0 segundos." O mesmo comentário observa para onde esse tempo foi em vez disso: para validar a saída, não para escrever modelos. As horas não desaparecem. Elas se deslocam.
A cobertura é binária. Um layout ou está na biblioteca ou não está, e a borda da biblioteca se move toda vez que um remetente redesenha um formulário, muda um logotipo ou adiciona um campo. Não existe um estado intermediário em que a ferramenta lida com 80% de um novo layout e informa quais 20% ela perdeu.
O Que Muda Quando a Extração Deixa de Depender de Coordenadas
A extração semântica muda a pergunta de onde está o valor para o que é o valor. A página ainda importa. Suas coordenadas deixam de ser o endereço.
O ImageToTable.ai funciona através de Custom Column Extraction: você digita os nomes das colunas que deseja, como "Invoice Number", "Due Date" e "Total", e um modelo de visão lê a página inteira e localiza cada valor pelo que ele significa. Os nomes das colunas que você digita se tornam os cabeçalhos da tabela de saída. É a mesma ideia de extrair campos específicos de um documento pelo nome em vez da localização, sem caixas para desenhar e sem coordenadas armazenadas. É isso que independente de formato significa aqui: o layout pode mudar e a extração não.
O layout ainda é evidência. Um número abaixo de uma linha, ao lado da palavra "Total", no canto inferior direito tem mais chance de ser o total do que o mesmo número no cabeçalho. A diferença é que essa evidência é interpretada no momento da extração em vez de congelada em um modelo meses antes. Nada fica desatualizado, porque nada foi memorizado.
As consequências práticas vêm diretamente. A primeira fatura de um novo fornecedor não precisa de configuração. Uma tabela com sessenta linhas é lida por completo em vez de cortada nas seis linhas que um modelo esperava. Um scan girado em dois graus não tem etapa de alinhamento para falhar, porque não há referencial de coordenadas para alinhar.
Os arquivos são processados com segurança e não são armazenados.
O que essa abordagem não resolve merece ser dito com a mesma clareza. Quando um documento contém dois candidatos plausíveis, um subtotal e um valor a pagar, o modelo ainda precisa escolher, e o nome da coluna precisa ser específico o bastante para decidir. Erros aritméticos impressos na origem são copiados fielmente. Escrita à mão apagada ainda limita o que qualquer modelo consegue ler. E um modelo de visão pode errar com confiança, e é por isso que a tela de revisão destaca a região de onde cada célula veio, para que um valor suspeito possa ser rastreado até a página em um ou dois segundos.
Dados de tabelas impressas são reconhecidos com até 99% de precisão, em cerca de 5 a 10 segundos por página. Isso é rápido o suficiente para trabalho em lote e não é motivo para pular a revisão de campos que vão para um razão. Os modos de falha diferem de uma forma que importa: uma zona deslocada retorna o mesmo valor errado para todo documento que compartilha o layout, enquanto uma falha ocasional do modelo é específica de um documento e não se repete no próximo.
Como Decidir Qual Deles Seus Documentos Precisam
Conte layouts, não documentos, e pergunte quem os controla. Dez mil faturas de três fornecedores é um problema que as zonas resolvem bem. Duzentas faturas de duzentos fornecedores não é.
Uma regra viável: se os layouts são seus, estáveis e poucos, as zonas são mais baratas, mais rápidas e mais exatas. Se os layouts pertencem a outras pessoas, chegam em novas versões sem aviso ou alcançam uma dúzia ou mais de formatos distintos, o custo de manutenção das zonas supera o custo por página de um modelo. O meio-termo incômodo, algumas centenas de páginas por mês de oito ou dez remetentes, geralmente se resume a quanto tempo de equipe você tem para reparar modelos.
Três verificações resolvem isso mais rápido que uma demonstração de fornecedor.
- Teste o campo que se move. Pegue o total, o valor do imposto e a data de vencimento em vinte documentos que você nunca modelou. Conte as falhas. Não faça a média de precisão entre os campos.
- Gire uma página dois graus e processe novamente. Observe se a ferramenta gera um erro ou retorna um número errado plausível. O segundo comportamento é o que chega aos seus livros.
- Pergunte quem notaria um total errado, e quando. Se a resposta for "na conciliação do mês que vem", adicione uma etapa de revisão independentemente do mecanismo que escolher.
| Dimensão | Zonal OCR | Extração semântica |
|---|---|---|
| Configuração por layout | Desenhe caixas em uma amostra, nomeie cada campo | Digite os nomes das colunas que você quer |
| Primeiro documento de um novo remetente | Aguarda um modelo | Processado como qualquer outro |
| Mudança de layout | Reparo do modelo, muitas vezes descoberto tarde | Nenhum modelo para reparar |
| Tabelas de itens de linha | Grade de linhas fixa; tabelas longas transbordam | Lidas por completo, não importa quantas linhas |
| Digitalização girada ou redimensionada | Realinhar, ou ler os pixels errados | Nenhuma etapa de alinhamento |
| Custo por página | Quase zero em um mecanismo local | Inferência de modelo, segundos por página |
| Falha típica | Um valor de aparência válida vindo do lugar errado, repetido em cada página com aquele layout | Uma falha ocasional por documento, detectada na revisão |
| Melhor encaixe | Formulários fixos que você imprime e controla | Documentos de muitos remetentes ou versões em mudança |
Se você está comparando ferramentas em vez de técnicas, a diferença aparece em como cada uma lida com um fornecedor que nunca viu. Um produto baseado em modelo como o Docparser precisa de uma regra de análise para o layout antes de conseguir ler qualquer coisa, enquanto uma ferramenta semântica pede os nomes das colunas e começa no primeiro documento. Comparações mais amplas de softwares de OCR e seus preços estão na nossa seleção de softwares de OCR, e se o que você realmente precisa é de um software que transforme páginas digitalizadas em linhas de tabela em vez de texto, a página software de OCR para entrada de dados cobre esse caminho.
Perguntas frequentes
O que é Zonal OCR em termos simples?
É o OCR restrito a caixas que você desenha em uma página de exemplo. Cada caixa está vinculada a um nome de campo, então a saída é um conjunto de valores rotulados em vez de um bloco de texto. O software lê apenas o que está dentro das caixas.
Zonal OCR é o mesmo que OCR de modelo?
Sim. Zone OCR, Zonal OCR, OCR de modelo e OCR em nível de campo nomeiam a mesma técnica. A pista é a configuração: se começa enviando uma amostra e desenhando retângulos, é Zonal OCR.
Qual é a diferença entre Zonal OCR e OCR de texto completo?
O OCR de texto completo lê todos os caracteres da página e os retorna na ordem de leitura, geralmente como uma camada de texto pesquisável. O Zonal OCR lê apenas as regiões que você definiu e retorna campos nomeados. O OCR de texto completo é feito para busca e arquivamento; o Zonal OCR é feito para captura de dados. Nenhum dos dois entende o que o texto significa, e é aí que começam os limites de precisão do OCR tradicional.
Quais são as principais limitações do Zonal OCR?
Posições fixas, tamanhos de campo fixos, contagens de linhas variáveis, inclinação de digitalização e um modelo por layout. A limitação mais cara é que uma falha muitas vezes retorna um valor de aparência válida do lugar errado em vez de um erro, então isso é descoberto depois.
O Zonal OCR funciona com escrita à mão?
Dentro de uma zona, o ICR pode ler caracteres impressos à mão em campos restritos, como uma caixa de data ou uma grade numérica. Cursiva e escrita à mão livre continuam não confiáveis, e uma zona não ajuda com um valor cujo comprimento ou posição muda de formulário para formulário.
Devo substituir o Zonal OCR por completo?
Não. Mantenha-o onde o layout é seu, o volume é alto e o formulário não muda. Substitua-o onde os layouts pertencem a remetentes que você não controla. A pergunta decisiva é a propriedade da página, não a idade da técnica.
Uma zona é uma promessa de que a página ficará igual na próxima vez. Se essa promessa se mantém é uma propriedade dos seus documentos, não do seu software.
Se você imprime o formulário, a promessa é sua para cumprir, e uma zona é uma boa forma de cumpri-la. Se outra pessoa o imprime, a promessa nunca foi sua para fazer. É esse o caso em que digitar os nomes das colunas que você quer, e deixar o modelo encontrá-las onde estiverem, substitui uma fila de manutenção por uma planilha.
Traga o layout que não para de quebrar. Veja o que volta.