Qué es el OCR zonal y las
cuatro formas que lo rompen
El OCR zonal hizo posible la automatización de documentos décadas antes de que nadie esperara que una máquina entendiera una página. Lo logró negándose a entender nada. Usted dibuja un rectángulo alrededor del total de la factura, el software lee solo ese rectángulo y el valor llega a un campo con nombre.
Ese intercambio compró velocidad, determinismo y un tipo muy específico de fragilidad. Lo que sigue cubre qué es una zona a nivel de píxeles y llamadas de OCR, las cuatro formas de documento donde las zonas fallan y la pregunta que decide si debe conservarlas: quién controla el diseño de la página.
Puntos clave
- El OCR zonal lee solo los recuadros que usted dibuja en un formulario, así que su peor fallo es un número incorrecto bien formado en lugar de un error.
- Dos grados de rotación del escaneo bastan para colocar el subtotal, 1,065.00, en el campo del total sin que ningún validador lo objete.
- Gire una página dos grados y vuelva a procesarla para ver si su herramienta detecta el desplazamiento o lo registra en silencio.
Una zona es un rectángulo de píxeles, y la plantilla es el programa
Una zona es un rectángulo de coordenadas en una página, vinculado a un nombre de campo. Una plantilla es un conjunto de esos rectángulos, aplicado a cada documento que se supone que debe verse igual.
La técnica circula bajo varios nombres. Zone OCR, OCR zonal, OCR de plantilla y OCR a nivel de campo designan la misma técnica, por lo que los proveedores usan los términos indistintamente. Si la configuración de una herramienta comienza con "suba una muestra y dibuje cuadros", es OCR zonal sin importar cómo lo llame el folleto.
La diferencia entre el OCR zonal y el OCR de página completa es lo que sale al final. El OCR de página completa convierte toda la página en texto y conserva el orden de lectura, que es lo que usted quiere para búsqueda, archivo o un PDF con texto buscable. El OCR zonal devuelve valores con nombre, que es lo que usted quiere para una columna de hoja de cálculo. Ninguno de los dos interpreta lo que lee. Uno produce un documento, el otro produce un registro.
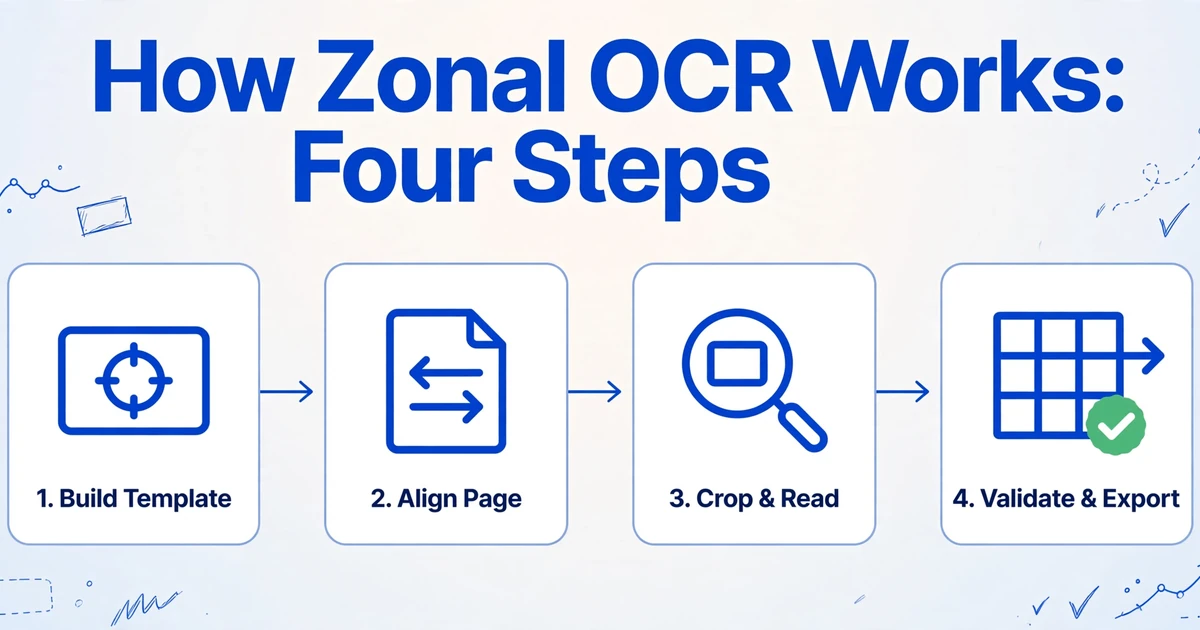
El trabajo ocurre en cuatro pasos, y en el tercero es donde se revela la arquitectura.
Crear la plantilla
Escanee un documento representativo, dibuje un rectángulo alrededor de cada campo y asígnele un nombre. La herramienta almacena las coordenadas, a menudo relativas al ancho y alto de la página para que un cambio de tamaño no las invalide.
Alinear la página entrante
Corrección de inclinación, reescalado y, a veces, coincidencia con una marca de registro o una palabra ancla, para que las coordenadas almacenadas caigan sobre el mismo contenido sobre el que cayeron en la muestra.
Recortar y leer
Cada zona se recorta de la imagen de la página y se pasa al motor de OCR como su propia imagen pequeña. El motor nunca ve el resto de la página.
Validar y exportar
Un patrón o tipo de dato verifica la forma de cada valor, y luego los resultados etiquetados van a una hoja de cálculo, una base de datos o un ERP.
El tercer paso explica un fallo que parece un error de configuración y no lo es. La documentación de Tesseract indica que el motor espera una página de texto de forma predeterminada, y que hacer OCR de una región pequeña requiere un modo de segmentación diferente, como tratar la entrada como una sola línea. Una zona no es un puntero dentro de una página. Es una imagen nueva, y hay que indicarle al motor qué tipo de imagen está viendo.
La recompensa de todas estas restricciones es el costo. Leer cinco franjas estrechas cuesta una fracción de leer una página completa, y en un motor local el costo marginal por página es casi nulo. Esa economía, más que la precisión, es la razón por la que el Zonal OCR sigue funcionando dentro de software de escaneo, suites de captura y una larga cola de scripts internos.
Donde las zonas siguen superando a todo lo demás
El Zonal OCR sigue siendo la opción correcta cuando el diseño está bajo su control. No es nostalgia. Es la opción determinista más económica disponible para una página que no cambia.
El encaje es estrecho y reconocible: formularios internos que usted diseña e imprime (solicitudes de gastos, listas de verificación de inspección, paquetes de incorporación), formularios gubernamentales estandarizados donde solo circula una versión oficial, la salida de un único remitente en volumen (los estados de cuenta de un banco, los informes de un laboratorio), documentos de identidad y hojas de examen. Dentro de una zona, los mismos motores también pueden ejecutar ICR para caracteres impresos a mano y OMR para casillas de verificación, por lo que un formulario interno rellenado a mano es un caso de uso legítimo.
El modelo de costos es la parte que la mayoría de las comparaciones omite. Un motor de zonas local procesa una página en aproximadamente un segundo o menos y no cobra nada por página. Un modelo de visión tarda segundos por página y cobra por la inferencia. Con cincuenta mil páginas de un mismo formulario sin cambios, esa diferencia decide el proyecto antes de que la precisión entre en la conversación.
La técnica también es menos rígida de lo que su reputación sugiere. Las herramientas de producción añaden anclas (encontrar las palabras "Invoice No." y leer a su derecha), patrones (buscar en una zona más amplia algo con la forma de un número de factura) y zonas dinámicas que se extienden hacia abajo en la página hasta una palabra de parada. Cada adición aporta tolerancia. Ninguna elimina la configuración por diseño, que es la parte que cuesta dinero.
Si un formulario, impreso por un sistema, en una versión, ya se lee correctamente, añadir un modelo de visión no aporta nada que usted no tenga ya.
Las cuatro formas de documento donde las zonas fallan
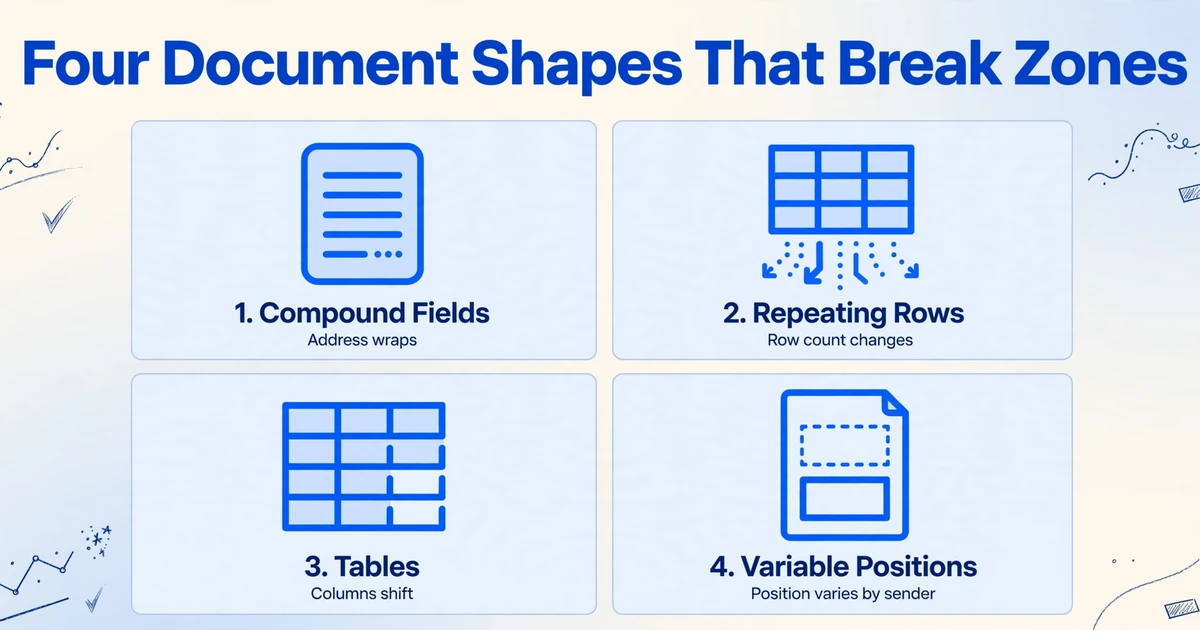
Las zonas fallan en cuatro formas de documento, y cada una falla por una razón mecánica distinta. Saber qué forma está viendo es más útil que una advertencia genérica de que los diseños cambian.
1. Campos compuestos
Un campo compuesto contiene un valor que no es una sola línea dentro de un rectángulo fijo. Una dirección de facturación ocupa de dos a cinco líneas según el cliente. Un importe aparece una vez en dígitos y otra en palabras. El nombre de un proveedor se ajusta en varias líneas. "Invoice No." y "Date" comparten una banda horizontal con un espacio que se desplaza según la longitud del número.
Una zona debe ser lo bastante alta para la dirección más larga y lo bastante estrecha para no capturar el número de teléfono impreso debajo. Esos dos requisitos se contradicen, y la plantilla solo puede cumplir uno. El resultado es una dirección truncada o un número de teléfono archivado como ciudad.
2. Filas repetidas
Cada línea de detalle que agrega empuja todo lo que está debajo hacia abajo en la página. Una plantilla creada sobre una factura de seis filas coloca el total a una altura fija. Envíe al mismo proveedor una factura con nueve filas y la zona del total caerá sobre una línea de detalle.
Una cuadrícula fija codifica un número de filas que el emisor nunca acordó. Los pedidos largos añaden un segundo fallo: el total pasa a la página dos, y una plantilla definida para la página uno devuelve la última línea de detalle.
3. Tablas
Una zona por columna supone que las columnas mantienen sus posiciones horizontales y que las filas mantienen su altura. Ninguna de las dos cosas se cumple en una tabla de líneas de detalle real. Una descripción se ajusta a una segunda línea, una cantidad se alinea a la derecha en una celda de ancho variable, una fila de totales abarca las columnas y una celda combinada desplaza todo lo que está a su derecha.
La propia documentación de Tesseract señala que el motor tiene problemas con las tablas sin segmentación personalizada y análisis de diseño. Una plantilla zonal es un sustituto hecho a mano de exactamente ese análisis, y hay que rehacerla cada vez que la tabla cambia de forma.
4. Posiciones variables
El mismo campo se encuentra en coordenadas distintas en los documentos de distintos remitentes. Una línea de descuento, un desglose de impuestos o una referencia de orden de compra aparece en algunas facturas y en otras no, y cada bloque opcional empuja hacia abajo los campos que están debajo. Una escala de escáner distinta desplaza todo a la vez.
Esta es la forma que convierte una plantilla en doscientas. ABBYY, que vende captura zonal, afirma en su propia entrada de glosario que el enfoque no es apropiado para facturas de proveedores ni para ningún tipo de documento cuya disposición varíe entre remitentes. Cuando el proveedor de la técnica traza esa frontera, conviene tomárselo en serio.
Qué le hace una inclinación de dos grados a una zona
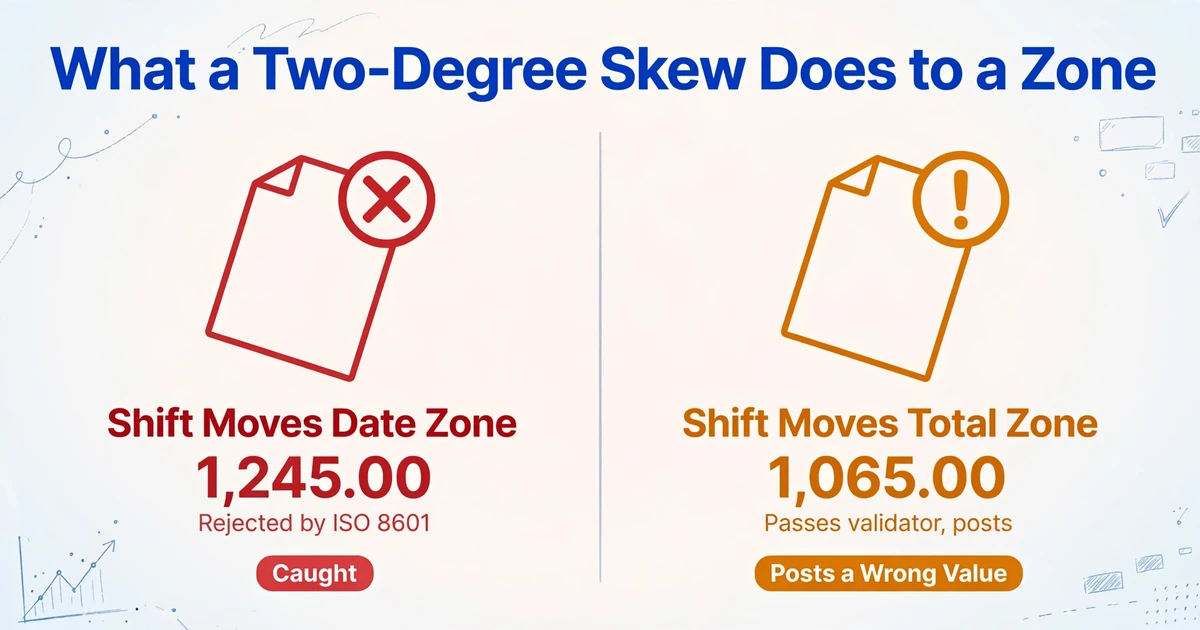
Una rotación de dos grados basta para sacar un valor de una zona ajustada. La dirección en que se mueve decide si llega a enterarse.
Rotar una página Letter dos grados desplaza un punto a cuatro pulgadas del centro de la página unos 0,14 pulgadas. A 300 DPI eso son aproximadamente 42 píxeles, cerca de una línea de texto de 10 puntos. Una zona que se dibujó hasta el borde de un valor ahora está leyendo su vecino.
Si el desplazamiento mueve la zona de fecha sobre el total, el campo recibe algo como 1,245.00. Una regla de fecha basada en ISO 8601 la rechaza, el documento pasa a una cola de excepciones y alguien corrige el escaneo. Molesto, visible, seguro.
Si el desplazamiento mueve la zona de total una línea hacia arriba, el campo de total recibe el subtotal, 1,065.00. Ese valor no tiene nada mal formado. Pasa el validador de importes, se registra y la diferencia de $180 aparece en la conciliación semanas después. El paso de extracción informó de un éxito.
Los fallos que se corrigen son los que lanzan un error. Los fallos que cuestan dinero son los que devuelven un número incorrecto perfectamente bien formado.
Las pruebas usan muestras limpias y bien alineadas. La producción incluye la página que pasó por el escáner con un ligero ángulo, y el validador no opina sobre si el número que acaba de aceptar pertenece al campo al que fue asignado.
Quién mantiene las plantillas y quién encuentra las filas erróneas
La plantilla tiene un dueño, y quien encuentra la fila errónea suele ser otra persona. Esa separación es donde reside el verdadero costo operativo.
Las plantillas normalmente las construye quien configuró la herramienta: un analista de operaciones, un miembro de TI, a veces la persona que firmó el contrato. Por qué una zona se dibujó unos píxeles más ancha que el texto, o empieza por encima de la línea en lugar de por debajo, vive en la memoria de esa persona, no en la herramienta. Cuando cambian de puesto, la biblioteca de plantillas se convierte en arqueología.
La fila errónea se encuentra más tarde y en otro lugar. Un auxiliar de AP concilia un estado de cuenta de proveedor y no logra cuadrar un importe. Un contralor nota una variación al cierre de mes. Un proveedor escribe para preguntar por qué una factura sigue sin pagarse. En cada caso, el error se creó en la extracción, se descubrió más adelante y se rastreó hasta un cambio de diseño que nadie registró.
La incorporación es la otra mitad de la cuenta. Un profesional en r/dataengineering resumió la diferencia con claridad: "Pasamos de ~4 horas para construir una plantilla para el diseño de un nuevo proveedor a 0 segundos". El mismo comentario señala a dónde fue ese tiempo: a validar la salida en lugar de escribir plantillas. Las horas no desaparecen. Se trasladan.
La cobertura es binaria. Un diseño está en la biblioteca o no lo está, y el borde de la biblioteca se mueve cada vez que un remitente rediseña un formulario, cambia un logotipo o agrega un campo. No hay un estado intermedio donde la herramienta maneje el 80% de un nuevo diseño y le diga qué 20% se le escapó.
Qué cambia cuando la extracción deja de depender de las coordenadas
La extracción semántica cambia la pregunta de dónde está el valor a qué es el valor. La página sigue importando. Sus coordenadas dejan de ser la dirección.
ImageToTable.ai funciona mediante Custom Column Extraction: usted escribe los nombres de columna que desea, como "Invoice Number", "Due Date" y "Total", y un modelo de visión lee la página completa y localiza cada valor por lo que significa. Los nombres de columna que escribe se convierten en los encabezados de la tabla de salida. Es la misma idea que extraer campos específicos de un documento por nombre en lugar de por ubicación, sin cuadros que dibujar y sin coordenadas almacenadas. Eso es lo que significa independiente del formato aquí: el diseño puede cambiar y la extracción no.
El diseño sigue siendo evidencia. Un número situado bajo una línea, junto a la palabra "Total", en la esquina inferior derecha tiene más probabilidades de ser el total que el mismo número en el encabezado. La diferencia es que esta evidencia se interpreta en el momento de la extracción en lugar de congelarse en una plantilla meses antes. Nada queda obsoleto, porque nada se memorizó.
Las consecuencias prácticas se derivan directamente. La primera factura de un nuevo proveedor no necesita configuración. Una tabla con sesenta filas se lee completa en lugar de recortarse a las seis filas que esperaba una plantilla. Un escaneo rotado dos grados no tiene un paso de alineación que falle, porque no hay un marco de coordenadas al que alinearse.
Los archivos se procesan de forma segura y no se almacenan.
Conviene decir con la misma claridad lo que este enfoque no resuelve. Cuando un documento contiene dos candidatos plausibles, un subtotal y un importe a pagar, el modelo aún debe elegir, y el nombre de la columna debe ser lo bastante específico para decidir. Los errores aritméticos impresos en el origen se copian fielmente. La escritura manuscrita tenue sigue limitando lo que cualquier modelo puede leer. Y un modelo de visión puede equivocarse con seguridad, por eso la pantalla de revisión resalta la región de la que proviene cada celda, de modo que un valor sospechoso puede rastrearse hasta la página en uno o dos segundos.
Los datos de tablas impresas se reconocen con una precisión de hasta el 99%, en unos 5 a 10 segundos por página. Es lo bastante rápido para el trabajo por lotes y no es motivo para omitir la revisión en campos que se registran en un libro mayor. Los modos de fallo difieren de una manera que importa: una zona desviada devuelve el mismo valor erróneo para cada documento que comparte el diseño, mientras que un fallo ocasional del modelo es específico de un documento y no se repite en el siguiente.
Cómo decidir cuál necesitan sus documentos
Cuente diseños, no documentos, y pregunte quién los controla. Diez mil facturas de tres proveedores es un problema que las zonas resuelven bien. Doscientas facturas de doscientos proveedores, no.
Una regla práctica: si los diseños son suyos, estables y pocos, las zonas son más baratas, más rápidas y más exactas. Si los diseños son de otras personas, llegan en versiones nuevas sin aviso o alcanzan una docena o más de formatos distintos, el costo de mantenimiento de las zonas supera el costo por página de un modelo. El punto medio incómodo, unos cientos de páginas al mes de ocho o diez remitentes, suele depender de cuánto tiempo de personal tenga para reparar plantillas.
Tres comprobaciones lo resuelven más rápido que una demostración de proveedor.
- Pruebe el campo que se mueve. Tome el total, el importe de impuestos y la fecha de vencimiento en veinte documentos que nunca haya convertido en plantilla. Cuente los fallos. No promedie la precisión entre campos.
- Rote una página dos grados y vuelva a procesarla. Observe si la herramienta arroja un error o devuelve un número incorrecto verosímil. El segundo comportamiento es el que llega a sus libros.
- Pregunte quién notaría un total incorrecto, y cuándo. Si la respuesta es "en la conciliación del próximo mes", agregue un paso de revisión sin importar qué motor elija.
| Dimensión | Zonal OCR | Extracción semántica |
|---|---|---|
| Configuración por diseño | Dibuje cuadros sobre una muestra, nombre cada campo | Escriba los nombres de columna que desea |
| Primer documento de un remitente nuevo | Espera una plantilla | Se procesa como cualquier otro |
| Cambio de diseño | Reparación de plantilla, a menudo detectada tarde | No hay plantilla que reparar |
| Tablas de líneas de detalle | Cuadrícula de filas fija; las tablas largas se desbordan | Se leen completas, sin importar cuántas filas |
| Escaneo rotado o reescalado | Realinee, o lea los píxeles equivocados | Sin paso de alineación |
| Costo por página | Casi cero en un motor local | Inferencia del modelo, segundos por página |
| Fallo típico | Un valor de aspecto válido del lugar equivocado, repetido en cada página con ese diseño | Un fallo ocasional por documento, detectado en la revisión |
| Mejor encaje | Formularios fijos que usted imprime y controla | Documentos de muchos remitentes o versiones cambiantes |
Si compara herramientas en lugar de técnicas, la diferencia se nota en cómo cada una maneja un proveedor que nunca ha visto. Un producto basado en plantillas como Docparser necesita una regla de análisis para el diseño antes de poder leer algo, mientras que una herramienta semántica pide nombres de columna y comienza con el primer documento. Las comparaciones más amplias de software OCR y sus precios están en nuestra selección de software OCR, y si lo que realmente necesita es software que convierta páginas escaneadas en filas de tabla en lugar de texto, la página de software OCR para entrada de datos cubre esa ruta.
Preguntas frecuentes
¿Qué es el Zonal OCR en términos simples?
Es OCR restringido a los recuadros que usted dibuja en una página de muestra. Cada recuadro está vinculado a un nombre de campo, por lo que la salida es un conjunto de valores etiquetados en lugar de un bloque de texto. El software lee solo lo que queda dentro de los recuadros.
¿Es el Zonal OCR lo mismo que el OCR de plantilla?
Sí. Zone OCR, Zonal OCR, OCR de plantilla y OCR a nivel de campo nombran la misma técnica. La señal es la configuración: si comienza subiendo una muestra y dibujando rectángulos, es Zonal OCR.
¿Cuál es la diferencia entre el Zonal OCR y el OCR de texto completo?
El OCR de texto completo lee cada carácter de la página y los devuelve en orden de lectura, normalmente como una capa de texto buscable. El Zonal OCR lee solo las regiones que usted definió y devuelve campos con nombre. El OCR de texto completo está diseñado para búsqueda y archivo; el Zonal OCR está diseñado para la captura de datos. Ninguno de los dos entiende qué significa el texto, que es donde comienzan los límites de precisión del OCR tradicional.
¿Cuáles son las principales limitaciones del Zonal OCR?
Posiciones fijas, tamaños de campo fijos, recuentos de filas variables, inclinación del escaneo y una plantilla por diseño. La limitación más costosa es que un fallo a menudo devuelve un valor de aspecto válido desde el lugar equivocado en lugar de un error, por lo que se descubre en etapas posteriores.
¿Funciona el Zonal OCR con escritura manuscrita?
Dentro de una zona, el ICR puede leer caracteres impresos a mano en campos restringidos como un recuadro de fecha o una cuadrícula numérica. La cursiva y la escritura manuscrita sin restricciones siguen siendo poco fiables, y una zona no puede ayudar con un valor cuya longitud o posición cambia de un formulario a otro.
¿Debería reemplazar el Zonal OCR por completo?
No. Consérvelo donde el diseño es suyo, el volumen es alto y el formulario no cambia. Reemplácelo donde los diseños pertenecen a remitentes que usted no controla. La pregunta decisiva es la propiedad de la página, no la antigüedad de la técnica.
Una zona es una promesa de que la página se verá igual la próxima vez. Si esa promesa se cumple es una propiedad de sus documentos, no de su software.
Si usted imprime el formulario, la promesa es suya y una zona es una buena forma de cumplirla. Si lo imprime otra persona, la promesa nunca fue suya. Ese es el caso en el que escribir los nombres de columna que desea, y dejar que el modelo los encuentre donde sea que estén, reemplaza una cola de mantenimiento por una hoja de cálculo.
Traiga el diseño que no deja de fallar. Vea qué devuelve.