Was Zonal OCR ist und die
vier Formen, die es zum Scheitern bringen
Zonal OCR machte Dokumentenautomatisierung Jahrzehnte möglich, bevor irgendjemand erwartete, dass eine Maschine eine Seite versteht. Das gelang, indem es sich weigerte, irgendetwas zu verstehen. Sie ziehen ein Rechteck um die Gesamtsumme der Rechnung, die Software liest nur dieses Rechteck, und der Wert landet in einem benannten Feld.
Dieser Kompromiss brachte Geschwindigkeit, Determinismus und eine ganz bestimmte Art von Fragilität. Im Folgenden erfahren Sie, was eine Zone auf der Ebene von Pixeln und OCR-Aufrufen ist, die vier Dokumentformen, bei denen Zonen versagen, und die Frage, die entscheidet, ob Sie sie behalten sollten: Wer kontrolliert das Layout der Seite.
Wichtigste Erkenntnisse
- Zonal OCR liest nur die Kästchen, die Sie auf einem Formular zeichnen, sodass sein schlimmster Fehler eine wohlgeformte falsche Zahl ist statt einer Fehlermeldung.
- Zwei Grad Scan-Drehung genügen, um die Zwischensumme, 1.065,00, in das Feld für die Gesamtsumme zu bringen, ohne dass ein Validator Einspruch erhebt.
- Drehen Sie eine Seite um zwei Grad und führen Sie sie erneut aus, um zu sehen, ob Ihr Tool die Verschiebung erkennt oder sie stillschweigend übernimmt.
Eine Zone ist ein Rechteck aus Pixeln, und die Vorlage ist das Programm
Eine Zone ist ein Rechteck aus Koordinaten auf einer Seite, das an einen Feldnamen gebunden ist. Eine Vorlage ist eine Menge solcher Rechtecke, die auf jedes Dokument angewendet wird, das gleich aussehen soll.
Die Technik läuft unter mehreren Namen. Zone OCR, Zonal OCR, Vorlagen-OCR und OCR auf Feldebene bezeichnen alle dieselbe Technik, daher verwenden Anbieter die Begriffe austauschbar. Wenn die Einrichtung eines Tools mit „Laden Sie ein Beispiel hoch und zeichnen Sie Kästchen" beginnt, handelt es sich um Zonal OCR, egal wie die Broschüre es nennt.
Der Unterschied zwischen Zonal OCR und Ganzseiten-OCR zeigt sich am Ergebnis. Ganzseiten-OCR wandelt die gesamte Seite in Text um und behält die Lesereihenfolge bei, was Sie für Suche, Archivierung oder ein durchsuchbares PDF wollen. Zonal OCR liefert benannte Werte, was Sie für eine Tabellenkalkulationsspalte wollen. Keine der beiden interpretiert, was sie liest. Die eine erzeugt ein Dokument, die andere einen Datensatz.
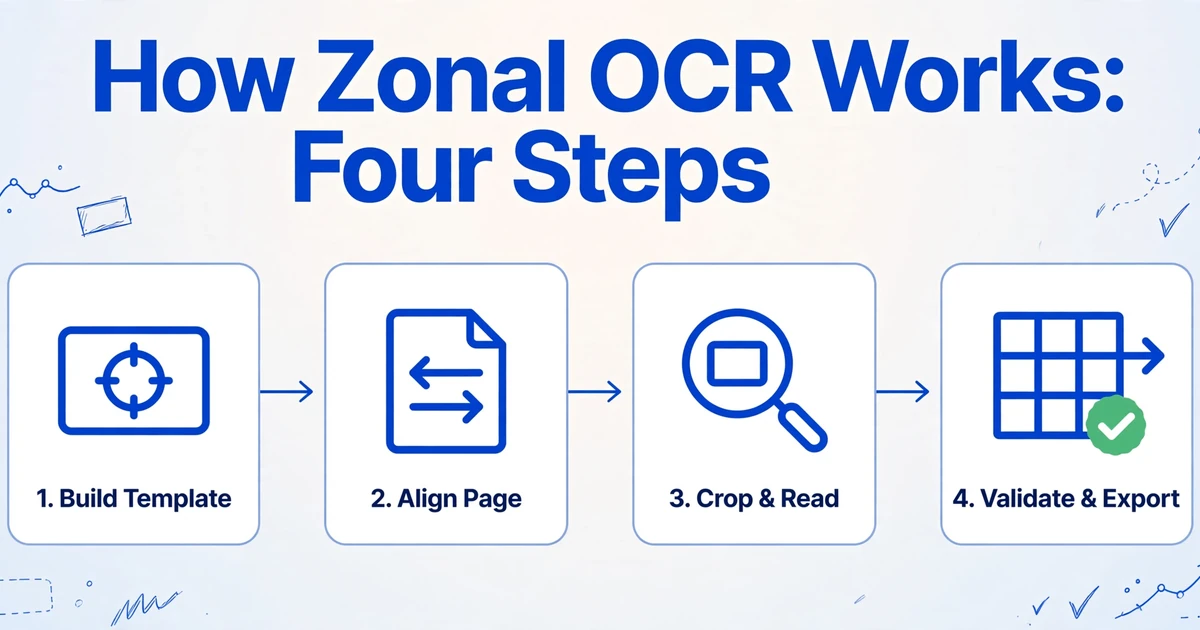
Die Arbeit läuft in vier Schritten ab, und im dritten zeigt sich die Architektur.
Vorlage erstellen
Scannen Sie ein repräsentatives Dokument, zeichnen Sie ein Rechteck um jedes Feld und geben Sie ihm einen Namen. Das Tool speichert die Koordinaten, oft relativ zur Seitenbreite und -höhe, damit eine Größenänderung sie nicht ungültig macht.
Eingehende Seite ausrichten
Begradigung, Neuskalierung und manchmal Abgleich mit einer Passermarke oder einem Ankerwort, damit die gespeicherten Koordinaten auf demselben Inhalt landen wie im Beispiel.
Zuschneiden und lesen
Jede Zone wird aus dem Seitenbild ausgeschnitten und als eigenes kleines Bild an die OCR-Engine übergeben. Die Engine sieht den Rest der Seite nie.
Validieren und exportieren
Ein Muster oder Datentyp prüft die Form jedes Werts, dann gehen die beschrifteten Ergebnisse in eine Tabellenkalkulation, eine Datenbank oder ein ERP.
Schritt drei erklärt einen Fehler, der wie ein Konfigurationsfehler aussieht und keiner ist. Die Dokumentation von Tesseract gibt an, dass die Engine standardmäßig eine Seite mit Text erwartet und dass das OCR einer kleinen Region einen anderen Segmentierungsmodus erfordert, etwa die Behandlung der Eingabe als einzelne Zeile. Eine Zone ist kein Zeiger in eine Seite. Sie ist ein neues Bild, und der Engine muss gesagt werden, welche Art von Bild sie vor sich hat.
Der Lohn für all diese Einschränkungen ist der Preis. Fünf schmale Streifen zu lesen kostet einen Bruchteil einer ganzen Seite, und auf einer lokalen Engine sind die Grenzkosten pro Seite nahezu null. Diese Ökonomie – mehr noch als die Genauigkeit – ist der Grund, warum Zonal OCR noch immer in Scan-Software, Capture-Suites und einer langen Reihe interner Skripte läuft.
Wo Zonen noch alles andere schlagen
Zonal OCR bleibt die richtige Wahl, wenn Sie das Layout unter Kontrolle haben. Das ist keine Nostalgie. Es ist die günstigste deterministische Option für eine Seite, die sich nicht ändert.
Die Eignung ist eng und erkennbar: interne Formulare, die Sie selbst entwerfen und drucken (Spesenabrechnungen, Prüfchecklisten, Onboarding-Unterlagen), standardisierte Behördenformulare, von denen nur eine offizielle Version im Umlauf ist, die Ausgabe eines einzelnen Absenders in hoher Stückzahl (die Kontoauszüge einer Bank, die Berichte eines Labors), Ausweisdokumente und Testbögen. Innerhalb einer Zone können dieselben Engines auch ICR für handgedruckte Zeichen und OMR für Kontrollkästchen ausführen, sodass ein handschriftlich ausgefülltes internes Formular ein legitimer Anwendungsfall ist.
Das Kostenmodell ist der Teil, den die meisten Vergleiche auslassen. Eine lokale Zone-Engine verarbeitet eine Seite in etwa einer Sekunde oder weniger und berechnet nichts pro Seite. Ein Vision-Modell braucht Sekunden pro Seite und berechnet die Inferenz. Bei fünfzigtausend Seiten eines unveränderten Formulars entscheidet diese Lücke das Projekt, bevor die Genauigkeit überhaupt zur Sprache kommt.
Die Technik ist zudem weniger starr als ihr Ruf. Produktionswerkzeuge ergänzen Anker (die Wörter „Invoice No." finden und rechts davon lesen), Muster (eine breitere Zone nach etwas durchsuchen, das wie eine Rechnungsnummer aussieht) und dynamische Zonen, die sich die Seite hinunter ausdehnen, bis ein Stoppwort kommt. Jede Ergänzung erkauft Toleranz. Keine davon beseitigt die Konfiguration pro Layout – und genau die kostet Geld.
Wenn ein Formular, gedruckt von einem System, in einer Version, bereits korrekt gelesen wird, bringt ein zusätzliches Vision-Modell nichts, was Sie nicht schon haben.
Die vier Dokumentformen, bei denen Zonen versagen
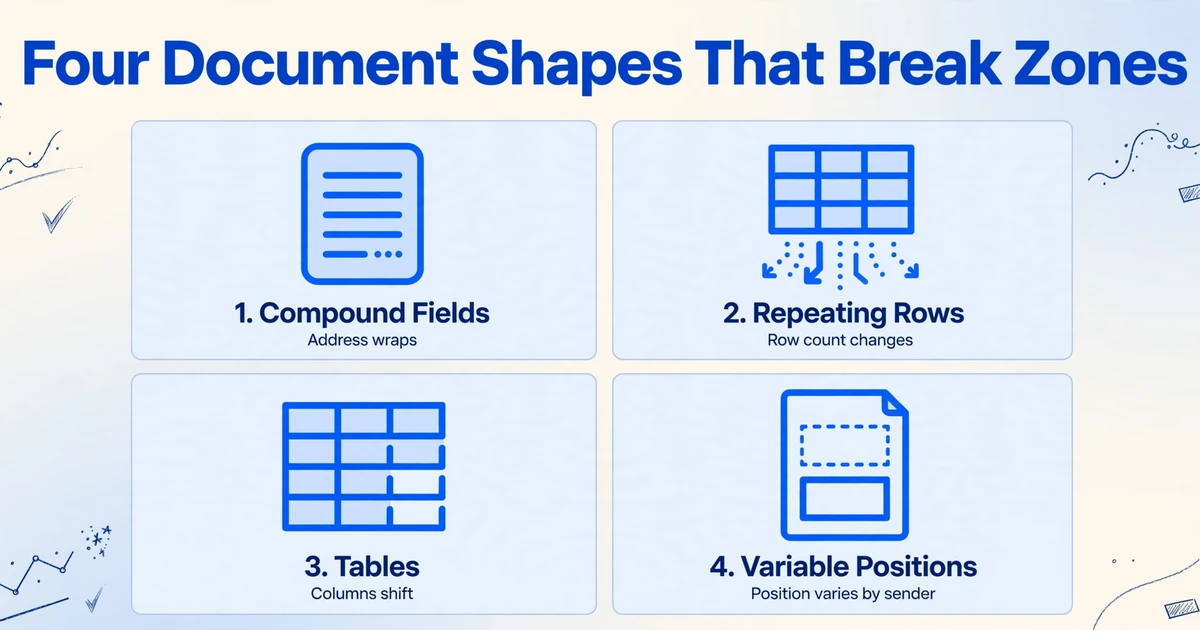
Zonen versagen bei vier Dokumentformen, und jede scheitert aus einem anderen mechanischen Grund. Zu wissen, welche Form Sie vor sich haben, ist nützlicher als eine allgemeine Warnung, dass sich Layouts ändern.
1. Zusammengesetzte Felder
Ein zusammengesetztes Feld enthält einen Wert, der keine einzelne Zeile in einem festen Rechteck ist. Eine Rechnungsadresse umfasst je nach Kunde zwei bis fünf Zeilen. Ein Betrag erscheint einmal in Ziffern und einmal in Worten. Ein Lieferantenname bricht um. „Rechnungsnr." und „Datum" teilen sich ein horizontales Band mit einem Abstand, der sich mit der Länge der Nummer verschiebt.
Eine Zone muss hoch genug für die längste Adresse und schmal genug sein, um nicht die darunter gedruckte Telefonnummer zu erfassen. Diese beiden Anforderungen widersprechen sich, und die Vorlage kann nur eine erfüllen. Das Ergebnis ist eine abgeschnittene Adresse oder eine Telefonnummer, die als Stadt abgelegt wird.
2. Wiederkehrende Zeilen
Jede Position, die Sie hinzufügen, schiebt alles darunter auf der Seite nach unten. Eine Vorlage, die auf einer Rechnung mit sechs Zeilen basiert, platziert die Gesamtsumme auf einer festen Höhe. Senden Sie demselben Lieferanten eine Rechnung mit neun Zeilen, landet die Gesamtsummen-Zone stattdessen auf einer Position.
Ein festes Raster kodiert eine Zeilenanzahl, der der Absender nie zugestimmt hat. Lange Bestellungen fügen einen zweiten Fehler hinzu: Die Gesamtsumme wandert auf Seite zwei, und eine für Seite eins definierte Vorlage liefert stattdessen die letzte Position.
3. Tabellen
Eine Zone pro Spalte setzt voraus, dass die Spalten ihre horizontalen Positionen und die Zeilen ihre Höhe behalten. Beides gilt bei einer echten Positionstabelle nicht. Eine Beschreibung bricht in eine zweite Zeile um, eine Menge ist rechtsbündig in einer Zelle variabler Breite, eine Gesamtsummenzeile überspannt die Spalten, und eine verbundene Zelle verschiebt alles zu ihrer Rechten.
Tesseracts eigene Dokumentation merkt an, dass die Engine Probleme mit Tabellen hat ohne benutzerdefinierte Segmentierung und Layoutanalyse. Eine zonale Vorlage ist ein handgebauter Ersatz für genau diese Analyse, und sie muss neu erstellt werden, wann immer die Tabelle ihre Form ändert.
4. Variable Positionen
Dasselbe Feld befindet sich bei Dokumenten verschiedener Absender an unterschiedlichen Koordinaten. Eine Rabattzeile, eine Steueraufschlüsselung oder eine Bestellreferenz erscheint auf manchen Rechnungen und auf anderen nicht, und jeder optionale Block schiebt die darunter liegenden Felder nach unten. Ein anderer Scanner-Maßstab verschiebt alles auf einmal.
Das ist die Form, die aus einer Vorlage zweihundert macht. ABBYY, das Zonal-Erfassung verkauft, erklärt im eigenen Glossareintrag, dass der Ansatz für Lieferantenrechnungen oder jeden Dokumenttyp, bei dem das Layout je nach Absender variiert, nicht geeignet ist. Wenn der Anbieter der Technik selbst diese Grenze zieht, sollte man das ernst nehmen.
Was eine Neigung von zwei Grad mit einer Zone macht
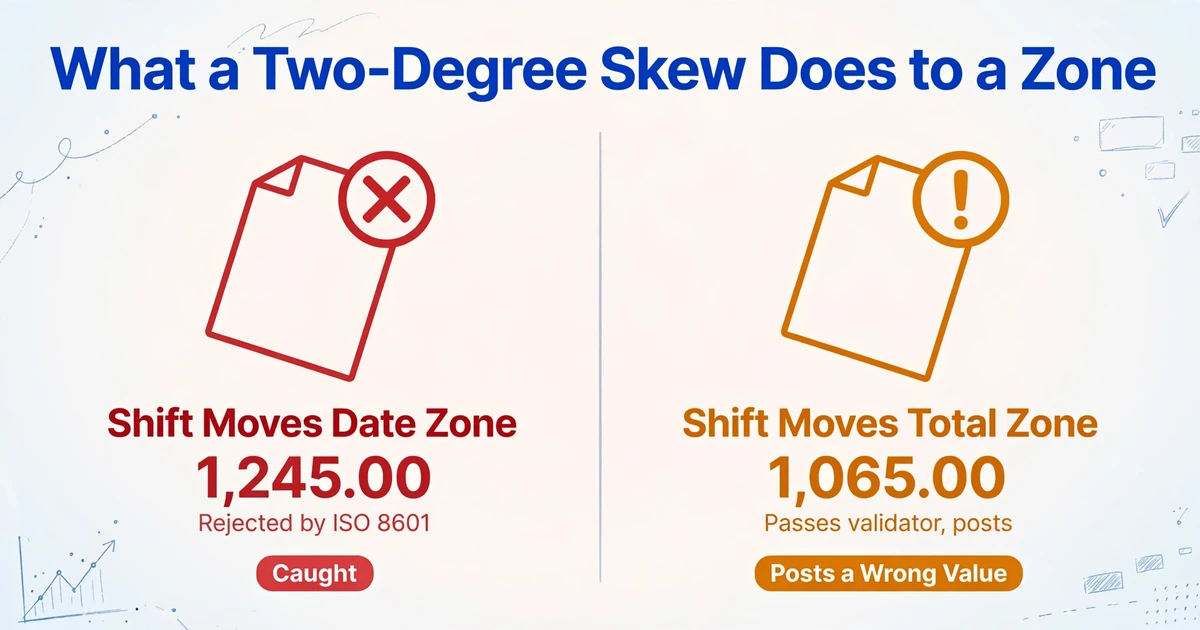
Eine Drehung um zwei Grad genügt, um einen Wert aus einer engen Zone herauszubewegen. Die Richtung entscheidet, ob Sie es jemals erfahren.
Dreht man eine Letter-Seite um zwei Grad, bewegt sich ein Punkt vier Zoll vom Seitenzentrum um etwa 0,14 Zoll. Bei 300 DPI sind das rund 42 Pixel, fast eine Zeile 10-Punkt-Text. Eine Zone, die bis an den Rand eines Werts gezeichnet wurde, liest nun den Nachbarn.
Wenn die Verschiebung die Datumszone auf die Gesamtsumme bewegt, erhält das Feld etwas wie 1,245.00. Eine Datumsregel, die auf ISO 8601 basiert, lehnt das ab, das Dokument landet in einer Ausnahmewarteschlange, und jemand korrigiert den Scan. Ärgerlich, sichtbar, sicher.
Wenn die Verschiebung die Gesamtsummenzone um eine Zeile nach oben bewegt, erhält das Gesamtsummenfeld die Zwischensumme, 1,065.00. An diesem Wert ist nichts fehlerhaft. Er besteht die Betragsprüfung, wird gebucht, und die Differenz von $180 zeigt sich Wochen später beim Abgleich. Der Extraktionsschritt meldete Erfolg.
Die Fehler, die behoben werden, sind die, die einen Fehler auslösen. Die Fehler, die Geld kosten, sind die, die eine völlig wohlgeformte falsche Zahl zurückgeben.
Tests verwenden saubere, gut ausgerichtete Beispiele. In der Produktion ist auch die Seite dabei, die leicht schräg durch den Scanner kam, und die Prüfung hat keine Meinung dazu, ob die Zahl, die sie gerade akzeptiert hat, zu dem Feld gehört, dem sie zugewiesen wurde.
Wer die Vorlagen pflegt und wer die fehlerhaften Zeilen findet
Die Vorlage hat einen Eigentümer, und die Person, die die fehlerhafte Zeile findet, ist meist jemand anderes. In dieser Trennung liegen die eigentlichen Betriebskosten.
Vorlagen werden in der Regel von der Person erstellt, die das Tool konfiguriert hat: ein Betriebsanalyst, ein IT-Mitarbeiter, manchmal die Person, die den Vertrag unterschrieben hat. Warum eine Zone ein paar Pixel breiter als der Text gezeichnet wurde oder oberhalb der Linie statt darunter beginnt, steckt im Gedächtnis dieser Person, nicht im Tool. Wenn sie die Rolle wechselt, wird die Vorlagenbibliothek zur Archäologie.
Die fehlerhafte Zeile wird später und an anderer Stelle gefunden. Ein AP-Sachbearbeiter gleicht eine Lieferantenabrechnung ab und kann einen Betrag nicht zuordnen. Ein Controller bemerkt am Monatsende eine Abweichung. Ein Lieferant schreibt eine E-Mail und fragt, warum eine Rechnung noch unbezahlt ist. In jedem Fall entstand der Fehler bei der Extraktion, wurde nachgelagert entdeckt und ließ sich auf eine Layoutänderung zurückführen, die niemand protokolliert hatte.
Das Onboarding ist die andere Hälfte der Rechnung. Ein Praktiker in r/dataengineering brachte den Unterschied auf den Punkt: „Wir sind von ~4 Stunden für den Bau einer Vorlage für ein neues Lieferantenlayout auf 0 Sekunden gekommen." Derselbe Kommentar erwähnt, wohin diese Zeit stattdessen floss: in die Validierung der Ausgabe statt in das Schreiben von Vorlagen. Die Stunden verschwinden nicht. Sie verschieben sich.
Die Abdeckung ist binär. Ein Layout ist entweder in der Bibliothek oder nicht, und der Rand der Bibliothek verschiebt sich jedes Mal, wenn ein Absender ein Formular neu gestaltet, ein Logo ändert oder ein Feld hinzufügt. Es gibt keinen Zwischenzustand, in dem das Tool 80 % eines neuen Layouts verarbeitet und Ihnen sagt, welche 20 % es verpasst hat.
Was sich ändert, wenn die Extraktion nicht mehr von Koordinaten abhängt
Semantische Extraktion ändert die Frage von „Wo ist der Wert?" zu „Was ist der Wert?". Die Seite zählt weiterhin. Ihre Koordinaten sind nicht mehr die Adresse.
ImageToTable.ai arbeitet über Custom Column Extraction: Sie geben die gewünschten Spaltennamen ein, etwa „Rechnungsnummer", „Fälligkeitsdatum" und „Gesamtsumme", und ein Vision-Modell liest die ganze Seite und findet jeden Wert danach, was er bedeutet. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen der Ausgabetabelle. Das ist dieselbe Idee wie bestimmte Felder aus einem Dokument nach Namen statt nach Position zu extrahieren, ohne Kästchen zu zeichnen und ohne gespeicherte Koordinaten. Das bedeutet formatunabhängig hier: Das Layout kann sich ändern, die Extraktion nicht.
Das Layout ist weiterhin ein Indiz. Eine Zahl unter einer Linie, neben dem Wort „Gesamtsumme", in der unteren rechten Ecke ist wahrscheinlicher die Gesamtsumme als dieselbe Zahl in der Kopfzeile. Der Unterschied ist, dass dieses Indiz zum Zeitpunkt der Extraktion interpretiert wird statt Monate vorher in einer Vorlage festgeschrieben zu sein. Nichts veraltet, weil nichts auswendig gelernt wurde.
Die praktischen Folgen ergeben sich direkt. Die erste Rechnung eines neuen Lieferanten erfordert keine Einrichtung. Eine Tabelle mit sechzig Zeilen wird vollständig gelesen statt auf die sechs Zeilen beschnitten, die eine Vorlage erwartet hatte. Ein um zwei Grad gedrehter Scan hat keinen Ausrichtungsschritt, der fehlschlagen kann, weil es keinen Koordinatenrahmen gibt, an dem ausgerichtet werden müsste.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was dieser Ansatz nicht behebt, sollte ebenso deutlich gesagt werden. Wenn ein Dokument zwei plausible Kandidaten enthält, eine Zwischensumme und einen fälligen Betrag, muss das Modell dennoch wählen, und der Spaltenname muss spezifisch genug sein, um zu entscheiden. In der Quelle gedruckte Rechenfehler werden originalgetreu übernommen. Schwache Handschrift begrenzt weiterhin, was ein Modell lesen kann. Und ein Vision-Modell kann sich sicher irren, weshalb der Prüfbildschirm den Bereich hervorhebt, aus dem jede Zelle stammt, sodass ein verdächtiger Wert in ein bis zwei Sekunden auf die Seite zurückverfolgt werden kann.
Gedruckte Tabellendaten werden mit bis zu 99 % Genauigkeit erkannt, bei etwa 5 bis 10 Sekunden pro Seite. Das ist schnell genug für Batch-Arbeit und kein Grund, die Prüfung von Feldern zu überspringen, die in ein Hauptbuch gebucht werden. Die Fehlerarten unterscheiden sich auf eine Weise, die wichtig ist: Eine verschobene Zone liefert für jedes Dokument mit demselben Layout denselben falschen Wert, während ein gelegentlicher Fehler des Modells spezifisch für ein Dokument ist und sich beim nächsten nicht wiederholt.
Wie Sie entscheiden, was Ihre Dokumente brauchen
Zählen Sie Layouts, nicht Dokumente, und fragen Sie, wer sie kontrolliert. Zehntausend Rechnungen von drei Lieferanten sind ein Problem, das Zonen gut lösen. Zweihundert Rechnungen von zweihundert Lieferanten sind es nicht.
Eine praktikable Regel: Wenn die Layouts Ihre eigenen sind, stabil und wenige, sind Zonen günstiger, schneller und exakter. Wenn die Layouts anderen gehören, in neuen Versionen ohne Vorwarnung eintreffen oder ein Dutzend oder mehr verschiedene Formate erreichen, übersteigen die Wartungskosten der Zonen die Kosten pro Seite eines Modells. Der unangenehme Mittelweg – ein paar hundert Seiten pro Monat von acht oder zehn Absendern – hängt meist davon ab, wie viel Personalzeit Sie für die Reparatur von Vorlagen haben.
Drei Prüfungen klären das schneller als eine Anbieter-Demo.
- Testen Sie das Feld, das sich bewegt. Nehmen Sie die Gesamtsumme, den Steuerbetrag und das Fälligkeitsdatum aus zwanzig Dokumenten, die Sie nie als Vorlage erfasst haben. Zählen Sie die Fehler. Mitteln Sie die Genauigkeit nicht über alle Felder.
- Drehen Sie eine Seite um zwei Grad und lassen Sie sie erneut laufen. Beobachten Sie, ob das Tool einen Fehler ausgibt oder eine plausibel falsche Zahl zurückgibt. Das zweite Verhalten ist das, das in Ihre Bücher gelangt.
- Fragen Sie, wer eine falsche Gesamtsumme bemerken würde – und wann. Wenn die Antwort „beim Abgleich nächsten Monat" lautet, fügen Sie einen Prüfschritt hinzu, egal für welche Engine Sie sich entscheiden.
| Dimension | Zonal OCR | Semantische Extraktion |
|---|---|---|
| Einrichtung pro Layout | Rahmen auf einem Muster zeichnen, jedes Feld benennen | Die gewünschten Spaltennamen eingeben |
| Erstes Dokument von einem neuen Absender | Wartet auf eine Vorlage | Wird wie jedes andere verarbeitet |
| Layoutänderung | Vorlagenreparatur, oft spät entdeckt | Keine Vorlage zu reparieren |
| Positionstabellen | Festes Zeilenraster; lange Tabellen laufen über | Vollständig gelesen, egal wie viele Zeilen |
| Gedrehter oder skalierter Scan | Neu ausrichten, sonst werden die falschen Pixel gelesen | Kein Ausrichtungsschritt |
| Kosten pro Seite | Nahe null bei einer lokalen Engine | Modell-Inferenz, Sekunden pro Seite |
| Typischer Fehler | Ein gültig aussehender Wert von der falschen Stelle, wiederholt auf jeder Seite mit diesem Layout | Ein gelegentlicher Fehler pro Dokument, der bei der Prüfung auffällt |
| Beste Eignung | Feste Formulare, die Sie drucken und kontrollieren | Dokumente von vielen Absendern oder wechselnden Versionen |
Wenn Sie Tools statt Techniken vergleichen, zeigt sich der Unterschied darin, wie jedes mit einem Anbieter umgeht, den es noch nie gesehen hat. Ein vorlagenbasiertes Produkt wie Docparser braucht eine Parsing-Regel für das Layout, bevor es etwas lesen kann, während ein semantisches Tool nach Spaltennamen fragt und beim ersten Dokument beginnt. Breitere Vergleiche von OCR-Software und deren Preise finden Sie in unserer OCR-Software-Übersicht, und wenn Sie eigentlich Software brauchen, die gescannte Seiten in Tabellenzeilen statt in Text verwandelt, deckt die Seite OCR-Software für die Dateneingabe diesen Weg ab.
FAQ
Was ist Zonal OCR in einfachen Worten?
Es ist OCR, die auf die Kästchen beschränkt ist, die Sie auf einer Beispielseite zeichnen. Jedes Kästchen ist an einen Feldnamen gebunden, sodass die Ausgabe eine Reihe beschrifteter Werte statt eines Textblocks ist. Die Software liest nur, was in die Kästchen fällt.
Ist Zonal OCR dasselbe wie Vorlagen-OCR?
Ja. Zone OCR, Zonal OCR, Vorlagen-OCR und OCR auf Feldebene bezeichnen dieselbe Technik. Das Erkennungsmerkmal ist die Einrichtung: Wenn sie mit dem Hochladen eines Beispiels und dem Zeichnen von Rechtecken beginnt, ist es Zonal OCR.
Was ist der Unterschied zwischen Zonal OCR und Volltext-OCR?
Volltext-OCR liest jedes Zeichen auf der Seite und gibt sie in Lesereihenfolge zurück, meist als durchsuchbare Textebene. Zonal OCR liest nur die von Ihnen definierten Bereiche und gibt benannte Felder zurück. Volltext-OCR ist für Suche und Archivierung gedacht; Zonal OCR ist für die Datenerfassung gedacht. Keine von beiden versteht, was der Text bedeutet – hier beginnen die Genauigkeitsgrenzen traditioneller OCR.
Was sind die wichtigsten Einschränkungen von Zonal OCR?
Feste Positionen, feste Feldgrößen, variable Zeilenanzahlen, Scan-Schräglage und eine Vorlage pro Layout. Die teuerste Einschränkung ist, dass ein Fehler oft einen gültig aussehenden Wert von der falschen Stelle statt einer Fehlermeldung zurückgibt, sodass er erst nachgelagert entdeckt wird.
Funktioniert Zonal OCR mit Handschrift?
Innerhalb einer Zone kann ICR handgedruckte Zeichen in eingeschränkten Feldern wie einem Datumsfeld oder einem numerischen Raster lesen. Schreibschrift und uneingeschränkte Handschrift bleiben unzuverlässig, und eine Zone kann bei einem Wert nicht helfen, dessen Länge oder Position sich von Formular zu Formular ändert.
Sollte ich Zonal OCR ganz ersetzen?
Nein. Behalten Sie es dort, wo das Layout Ihnen gehört, das Volumen hoch ist und sich das Formular nicht ändert. Ersetzen Sie es dort, wo die Layouts Absendern gehören, die Sie nicht kontrollieren. Die entscheidende Frage ist der Besitz der Seite, nicht das Alter der Technik.
Eine Zone ist ein Versprechen, dass die Seite beim nächsten Mal gleich aussieht. Ob dieses Versprechen hält, ist eine Eigenschaft Ihrer Dokumente, nicht Ihrer Software.
Wenn Sie das Formular drucken, liegt es an Ihnen, das Versprechen zu halten, und eine Zone ist ein guter Weg, es zu halten. Wenn es jemand anderes druckt, war das Versprechen nie Ihres, es zu geben. In diesem Fall ersetzt das Eingeben der gewünschten Spaltennamen und das Findenlassen durch das Modell – egal, wo sie stehen – eine Warteschlange durch eine Tabellenkalkulation.
Bringen Sie das Layout, das immer wieder bricht. Sehen Sie, was zurückkommt.