Wie funktioniert OCR?
Eine Schritt-für-Schritt-Anleitung (ohne Fachjargon)
Optische Zeichenerkennung (OCR) ist die Technologie, die Bilder von Text in maschinenlesbare Zeichen umwandelt – durch einen sequenziellen Prozess aus Bildbereinigung, Texterkennung, Zeichenerkennung und Ausgabeoptimierung. Wenn Sie schon einmal ein Dokument gescannt haben und sich gefragt haben, wie der Computer die gedruckten Wörter magisch „liest" – oder warum er sie manchmal urkomisch falsch liest – dann ist dies der Artikel, der genau erklärt, was Schritt für Schritt in einfacher Sprache passiert.
Die wichtigsten Erkenntnisse
- OCR liest nicht – es spielt ein präzises Zuordnungsspiel und vergleicht unbekannte Pixelblobs mit einer Bibliothek gespeicherter Buchstabenformen. Es kennt „T" an seinen Strichen, nicht weil es der erste Buchstabe von „Total" ist.
- Die gefährlichsten OCR-Fehler sind unsichtbar – wenn benachbarte Zeichen zu einem verschmelzen („rn" wird zu „m"), sieht die Ausgabe immer noch wie ein gültiges englisches Wort aus, und jeder nachgelagerte Schritt behandelt die Verfälschung als Wahrheit.
- Eine Zeichengenauigkeit von 99 % bedeutet immer noch, dass 15–40 % Ihrer Datenfelder Fehler enthalten – denn OCR beantwortet die Frage „Welche Zeichen sind auf dieser Seite?", nicht „Welche dieser Zahlen ist die Rechnungssumme?"
Was OCR tatsächlich leistet (und was nicht)
OCR ist kein einzelner magischer Schritt – es ist ein vierteiliges Fließband, das Pixel in Text verwandelt. Stellen Sie sich vor, Sie müssten jemandem das Lesen beibringen, der noch nie eine geschriebene Sprache gesehen hat. Sie würden zunächst helfen zu erkennen, dass einige Markierungen auf der Seite Buchstaben sind und andere nur Flecken oder Papierstruktur. Dann würden Sie lehren, dass jeder Buchstabe eine erkennbare Form hat – ein großes A hat immer ungefähr eine Dreiecksform mit einem Querbalken, egal in welcher Schriftart. Erst danach könnten sie beginnen, Buchstaben zu Wörtern und Wörter zu Sätzen zu kombinieren. Genau so funktioniert eine OCR-Engine: Sie verarbeitet ein Dokument in Schichten und baut Verständnis von Grund auf auf, Schritt für Schritt.
Aber es gibt einen entscheidenden Haken: OCR liest Formen, nicht Bedeutung. Die Engine weiß, dass eine Folge von Strichen den Buchstaben „T“ bildet, aber sie hat keine Ahnung, dass „T“ der erste Buchstabe von „Total“ oder „Tax“ ist. Sie digitalisiert Ihr Dokument – sie versteht es nicht. Diese Unterscheidung ist der Grund, warum OCR-Ausgabe für durchsuchbare PDFs nützlich ist, aber an Grenzen stößt, wenn Sie strukturierte Daten in einer Tabellenkalkulation benötigen. Für einen vollständigen Überblick darüber, was OCR ist und wie seine drei technologischen Generationen aussehen, lesen Sie unseren Leitfaden zu was OCR ist und wie es sich entwickelt hat.
Die vierteilige OCR-Pipeline im Überblick
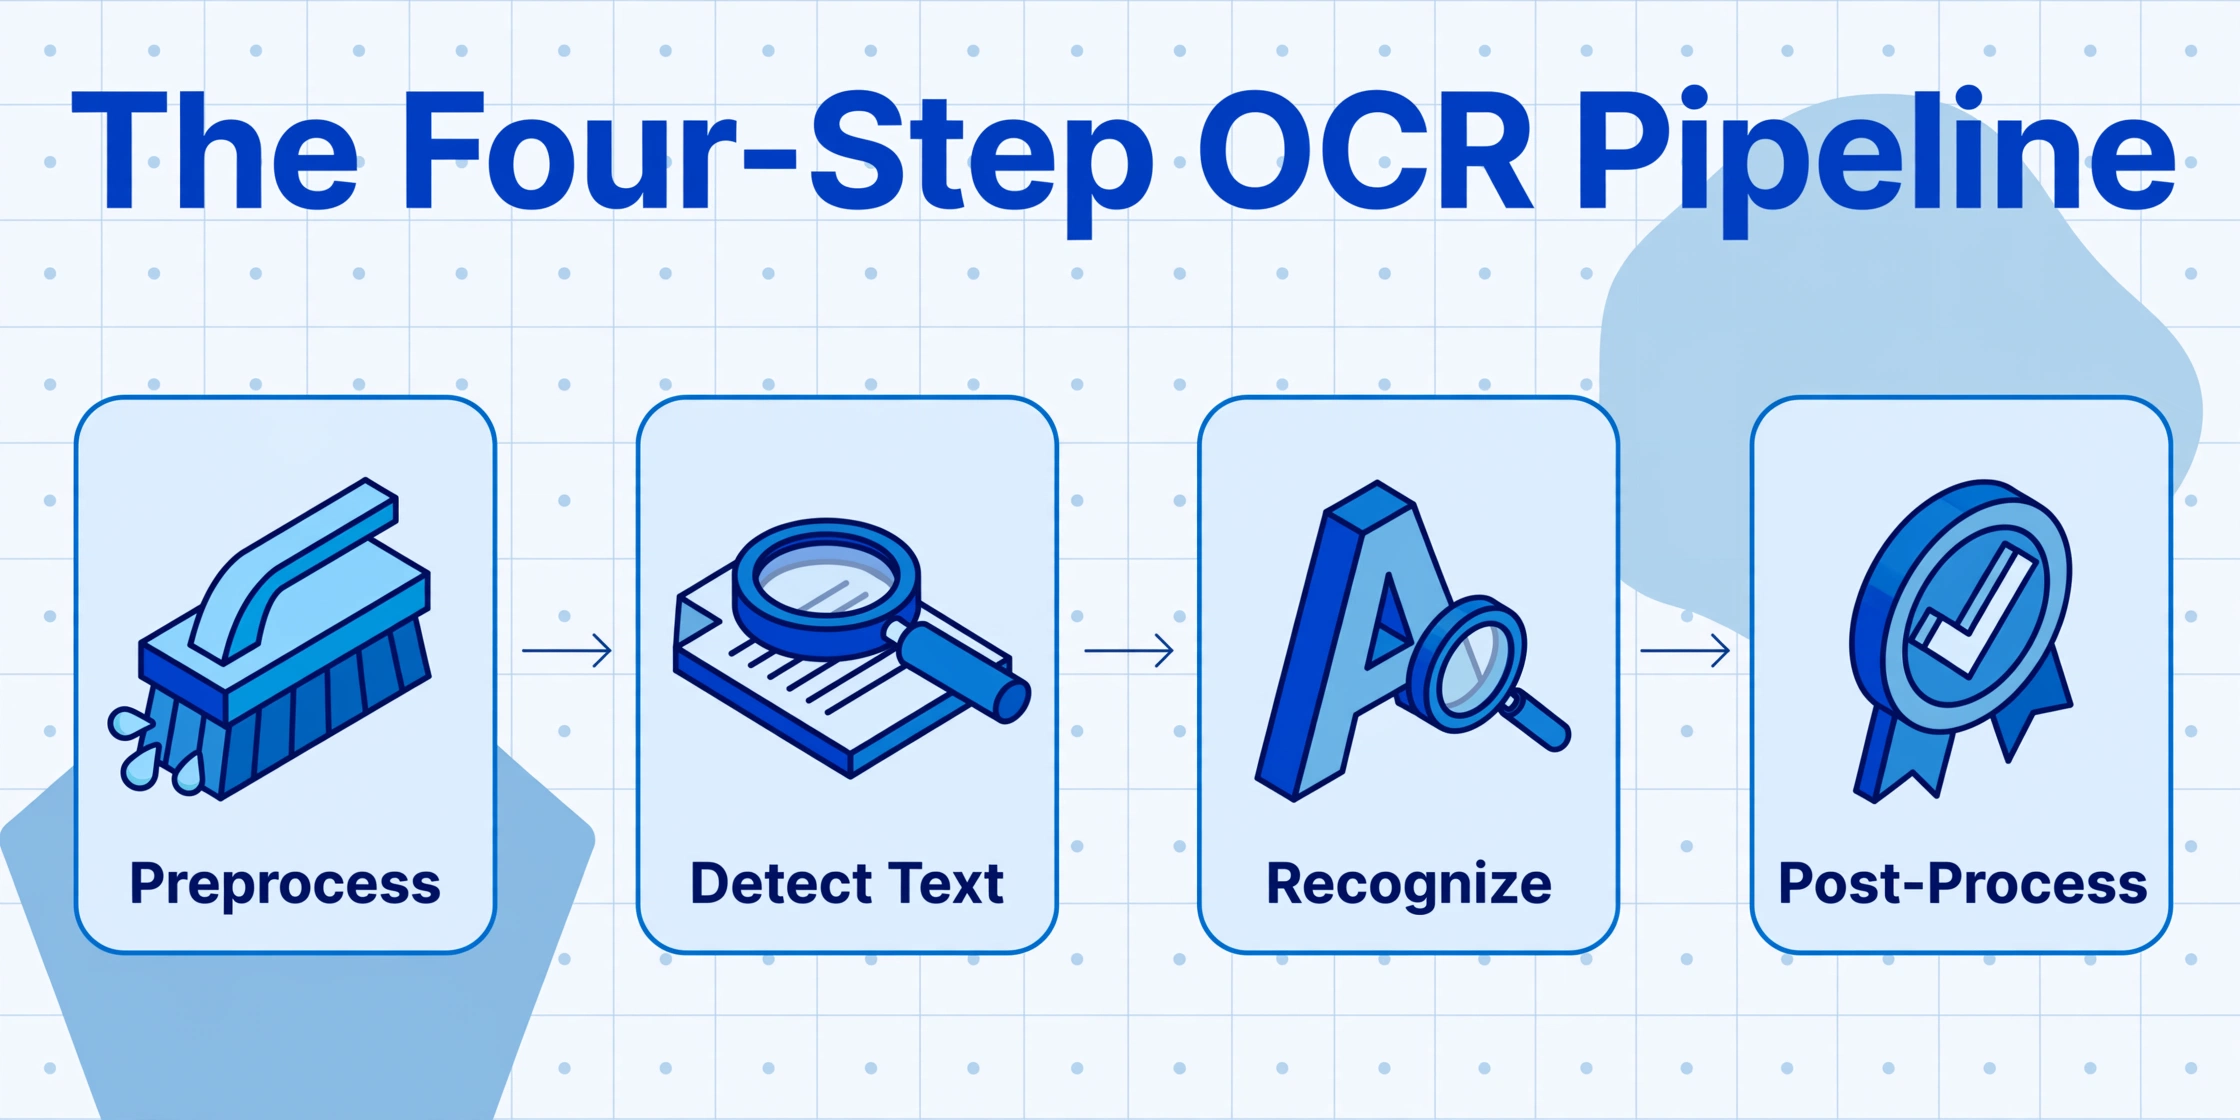
Jede OCR-Engine – von der kostenlosen Tesseract bis zu kommerziellen Systemen – folgt demselben vierteiligen Arbeitsablauf. Stellen Sie es sich wie ein Fabrikfließband vor, bei dem jede Station eine bestimmte Aufgabe hat. Die Ausgabe einer Station wird zur Eingabe der nächsten. Wenn eine Station ihre Arbeit schlecht macht, liefern alle nachgelagerten Stationen schlechtere Ergebnisse.
Vorverarbeitung
Bereinigen Sie das Bild. Entfernen Sie Rauschen, korrigieren Sie die Schräglage, passen Sie den Kontrast an. Die Engine kann nicht lesen, was sie nicht klar sehen kann.
Texterkennung
Finden Sie den Text. Identifizieren Sie, welche Teile des Bildes Zeichen enthalten und welche Fotos, Logos oder leere Flächen. Zerlegen Sie den Text dann in Zeilen, Wörter und einzelne Zeichen.
Zeichenerkennung
Identifizieren Sie jedes Zeichen, indem Sie seine Form mit einer bekannten Bibliothek aus Buchstaben, Zahlen und Symbolen abgleichen. Dies ist der Kernschritt der OCR – alles andere unterstützt ihn.
Nachbearbeitung
Verfeinern Sie die Ausgabe. Prüfen Sie Wörter gegen Wörterbücher, lösen Sie mehrdeutige Zeichen mithilfe des Kontexts auf und formatieren Sie den Text für die Ausgabedatei.
Lassen Sie uns nun jeden Schritt im Detail durchgehen – mit dem, was die Engine tatsächlich tut, warum es wichtig ist, und einer konkreten Analogie, um es einprägsam zu machen.
Schritt 1 – Vorverarbeitung: Das Bild vor dem Lesen bereinigen
Bevor die Engine einen einzigen Buchstaben erkennen kann, muss sie das Bild bereinigen, um alles zu eliminieren, was den Erkennungsschritt verwirren könnte. Das ist wie das Putzen Ihrer Brille, bevor Sie ein Buch lesen – Sie können Wörter nicht klar lesen, wenn die Linse verschmiert, gekippt oder zerkratzt ist.
Ein gescanntes Dokument, das bei der OCR-Engine ankommt, ist selten in perfektem Zustand. Die Seite könnte leicht schief auf dem Scanner liegen (ein Problem namens Schräglage). Der Scan könnte Staubpartikel, Fax-Artefakte oder den Schatten einer Buchfalz enthalten. Der Kontrast zwischen Tinte und Papier könnte gering sein – besonders bei alten Dokumenten, Durchschlägen oder verblassten Belegen. Die Vorverarbeitungsstufe behebt all dies, bevor das eigentliche Lesen beginnt.
Der wichtigste Vorverarbeitungsschritt ist die Binarisierung – die Umwandlung des Bildes in reines Schwarzweiß mithilfe eines Schwellenwerts, der Text vom Hintergrund trennt. Eine gängige Technik namens Otsu's method analysiert das Histogramm der Pixelintensitäten und wählt automatisch den optimalen Schwellenwert. Wenn Sie jemals ein gescanntes Dokument gesehen haben, das wie kräftiger schwarzer Text auf einer hellweißen Seite aussieht, haben Sie das Ergebnis der Binarisierung gesehen.
Weitere Vorverarbeitungsoperationen umfassen Deskewing (Drehen des Bildes, um schiefen Text zu begradigen), Rauschunterdrückung (Herausfiltern von Staubpartikeln und Scanner-Artefakten), Entsprenkeln (Entfernen von Streumarkierungen, die mit Satzzeichen oder diakritischen Zeichen verwechselt werden könnten) und Kontrastnormalisierung (Anpassen der Helligkeit, damit blasser Text lesbar wird).
Dieser Schritt ist der Punkt, an dem viele OCR-Fehler bereits vorprogrammiert sind. Wenn die Binarisierung die Unterlängen von Kleinbuchstaben abschneidet oder benachbarte Zeichen zu Klecksen verschmilzt, hat die Erkennungsstufe keine Chance, sie korrekt zu erfassen – egal wie ausgefeilt ihr Algorithmus ist. Müll rein, Müll raus – und bei OCR gilt diese Redewendung für jedes einzelne Pixel.
Eine schlechte Vorverarbeitung garantiert eine schlechte Erkennung – selbst die beste Zeichenabgleich-Engine kann nicht beheben, was in der Reinigungsstufe verloren ging.
Schritt 2 – Texterkennung: Wo die Wörter sind
Jetzt, wo das Bild sauber ist, muss die Engine herausfinden, welche Teile der Seite tatsächlich Text enthalten. Dies ist die Layout-Analyse-Phase. Stellen Sie es sich wie den Blick auf eine Zeitungsseite vor: Sie können sofort den Unterschied zwischen einer Schlagzeile, einer Bildunterschrift, einer Randspalte und einem Zitat erkennen – aber die OCR-Engine muss diese Unterscheidung Pixel für Pixel lernen.
Die Engine scannt das vorverarbeitete Bild, um Textregionen zu identifizieren – Bereiche mit hoher Zeichendichte – und sie von Bildern, Logos, dekorativen Rahmen und leerem Raum zu trennen. Anschließend zerlegt sie jede Textregion in immer kleinere Einheiten:
1. Blöcke – Große rechteckige Bereiche, die wahrscheinlich zusammengehörigen Inhalt enthalten (eine Textspalte, eine Tabelle, eine Kopfzeile).
2. Zeilen – Innerhalb jedes Blocks identifiziert die Engine einzelne Textzeilen, indem sie horizontale Pixelbänder mit Zeichen findet.
3. Wörter – Innerhalb jeder Zeile gruppiert sie Zeichen zu Wörtern, indem sie den Abstand zwischen Zeichenformen misst.
4. Zeichen – Schließlich wird jedes Wort in einzelne Zeichensegmente aufgeteilt, die an die Erkennungs-Engine übergeben werden.
Dieser scheinbar einfache Schritt verbirgt eine erhebliche Herausforderung: proportionale Schriften. Bei einer proportionalen Schrift kann der Abstand zwischen zwei Buchstaben (wie „r“ und „n“) breiter sein als der Abstand zwischen zwei Wörtern in einer komprimierten Schriftart. Die Engine muss entscheiden, ob eine Lücke zwei Buchstaben innerhalb desselben Wortes oder zwei Wörter trennt. Sie verwendet Heuristiken – typische Zeichenbreite, Weißraum-Schwellenwerte, sprachspezifische Muster – aber diese Heuristiken sind nicht immer richtig. Wenn sie falsch raten, werden Wörter falsch zusammengeführt oder getrennt, und jeder nachgelagerte Schritt erbt den Fehler.
Erkennungsfehler sind die heimtückischste Art von OCR-Fehlern, weil sie nicht wie Fehler aussehen. Ein zusammengeführtes Wort sieht für einen menschlichen Prüfer wie ein legitimes (wenn auch ungewohntes) Wort aus. Die Engine liest „rn“ als „m“, und plötzlich wird aus „commercial“ „commeicial“ – ein Fehler, den eine Rechtschreibprüfung erkennt, aber nur, wenn die Ausgabe durch eine solche läuft.
Schritt 3 — Zeichenerkennung: Das Herzstück der OCR
Das ist der Schritt, den die Leute meinen, wenn sie „OCR" sagen. Die Engine nimmt jedes einzelne Zeichenbild und entscheidet, welchen Buchstaben, welche Ziffer oder welches Symbol es darstellt. Stellen Sie sich ein Kind vor, das mit einem Kartenstapel das Alphabet lernt: Sie zeigen ihm ein Bild des Buchstabens A in verschiedenen Schriftarten — Arial-A, Times-New-Roman-A, handgeschriebenes A — bis es lernt, ihn unabhängig vom Stil zu erkennen. OCR-Engines machen dasselbe, nur haben sie Millionen von Karten und verarbeiten sie in Millisekunden.
Es gibt zwei grundlegende Ansätze zur Zeichenerkennung:
Musterabgleich (OCR mit Vorlagen) — Die Engine hält eine Datenbank mit Zeichenbildern (Glyphen) in bekannten Schriftarten und Größen bereit. Wenn sie auf ein neues Zeichen trifft, vergleicht sie das Pixelmuster mit jeder gespeicherten Glyphe und wählt die nächste Übereinstimmung. Dieser Ansatz war jahrzehntelang der Standard und treibt Engines wie Tesseract an, die Open-Source-OCR-Engine, die ursprünglich 1974 bei HP Labs entwickelt und heute von Google gepflegt wird. Der Musterabgleich funktioniert gut, wenn das Dokument eine Schriftart verwendet, die die Engine schon gesehen hat. Er versagt, wenn die Schriftart ungewöhnlich ist, der Text handschriftlich ist oder die Bildqualität nachlässt — weil die Eingabe keiner gespeicherten Vorlage mehr ähnelt.
Merkmalsextraktion (intelligente OCR) — Statt ganzer Pixelmuster zerlegt die Engine jedes Zeichen in seine Bestandteile: Linien, Kurven, Schleifen, Kreuzungen, Endpunkte und Winkel. Der Buchstabe „A" hat zwei diagonale Linien, die sich in einem Punkt treffen, und einen horizontalen Querbalken. Der Buchstabe „O" hat eine einzige geschlossene Schleife. Indem die Engine diese Merkmale unabhängig von Schriftart und Größe erkennt, kann sie Zeichen identifizieren, die sie noch nie gesehen hat. Die meisten modernen OCR-Engines verwenden diesen Ansatz, oft erweitert durch neuronale Netze, die mit Datensätzen wie EMNIST (Extended MNIST) trainiert wurden — einer Sammlung von 814.255 beschrifteten Zeichenbildern mit Ziffern sowie Groß- und Kleinbuchstaben.
Die entscheidende Einschränkung beider Ansätze ist dieselbe: Sie erkennen Formen, nicht Bedeutung. Die Engine kann Ihnen mit 99 % Sicherheit sagen, dass eine Pixelgruppe das Zeichen „5" ist — aber sie kann Ihnen nicht sagen, ob diese „5" eine Menge, ein Preis, ein Datum, eine Raumnummer oder ein Modellcode ist. Sie liest Zeichen als isolierte Symbole, nicht als Teile eines zusammenhängenden Dokuments. Deshalb kann eine traditionelle OCR-Engine bei einer sauberen Rechnung eine Zeichengenauigkeit von 99 % erreichen und trotzdem eine Ausgabe liefern, in der Sie die Rechnungssumme nicht finden — jedes Zeichen ist korrekt, aber keines ist beschriftet.
Für einen detaillierten Vergleich, wie sich dieser Schritt zwischen traditioneller OCR und modernen KI-basierten Ansätzen unterscheidet, einschließlich Genauigkeits-Benchmarks über Dokumenttypen hinweg, lesen Sie unsere Aufschlüsselung zu wie KI-OCR im Vergleich zu klassischer OCR abschneidet.
Schritt 4 — Nachbearbeitung: Die Ausgabe lesbar machen
Die Rohausgabe der Zeichenerkennung ist eine Zeichenkette erratener Buchstaben – manche richtig, manche nicht, alle ohne Kontext. In der Nachbearbeitung versucht die Engine, ihre eigenen Fehler zu korrigieren. Stellen Sie sich das wie ein sehr aggressives Autokorrektursystem vor – eines, das den Unterschied zwischen „ihr", „ihre" und „Ihre" anhand des umgebenden Kontexts erkennt, nicht nur durch Wörterbuchsuche.
Zu den gängigsten Nachbearbeitungstechniken gehören:
Wörterbuchkorrektur
Die Engine prüft jedes erkannte Wort gegen ein Sprachwörterbuch. Erscheint „Empfang", wird es zu „Empfang" korrigiert. Ist die Engine unsicher, ob ein mittleres Zeichen „O" oder „0" im Wort „M0dell" ist, bestätigt das Wörterbuch, dass es „Modell" heißen muss.
Kontextbasierte Disambiguierung
Ist ein Zeichen mehrdeutig – wie die Ziffer „1" versus Kleinbuchstabe „l" – untersucht die Engine die umgebenden Zeichen. „Klient" wird zu „Klient" korrigiert (weil „Klient" kein Wort ist), während „Seite 1" die Ziffer behält (da „Seite l" sinnlos wäre).
Konfidenzbewertung
Jedes erkannte Zeichen erhält eine Konfidenzbewertung. Bereiche mit niedriger Konfidenz können zur manuellen Prüfung markiert, mit anderen Erkennungsparametern neu verarbeitet oder mit einem anderen Algorithmus einer zweiten Erkennungsrunde unterzogen werden.
Formatwiederherstellung
Die Engine setzt den erkannten Text wieder in das ursprüngliche Layout des Dokuments zusammen – unter Beibehaltung von Zeilenumbrüchen, Absatzabständen, Tabellenausrichtung und Lesereihenfolge. Dieser Schritt erzeugt ein durchsuchbares PDF, das wie die ursprüngliche gescannte Seite aussieht.
Trotz all dieser Intelligenz hat die Nachbearbeitung eine grundlegende Grenze: Sie kann Rechtschreibfehler korrigieren, aber keine semantische Bedeutung hinzufügen. Die Ausgabe $1.234,56 ist nun als gültiger Geldbetrag bekannt – aber die Engine weiß immer noch nicht, ob es sich um den Rechnungsendbetrag, eine Positionszwischensumme, den Steuerbetrag oder eine Referenznummer handelt. Die Nachbearbeitung macht den Text lesbar, nicht als Daten nutzbar.
Der Unterschied, der alles verändert — Traditionelle OCR vs. KI-Extraktion
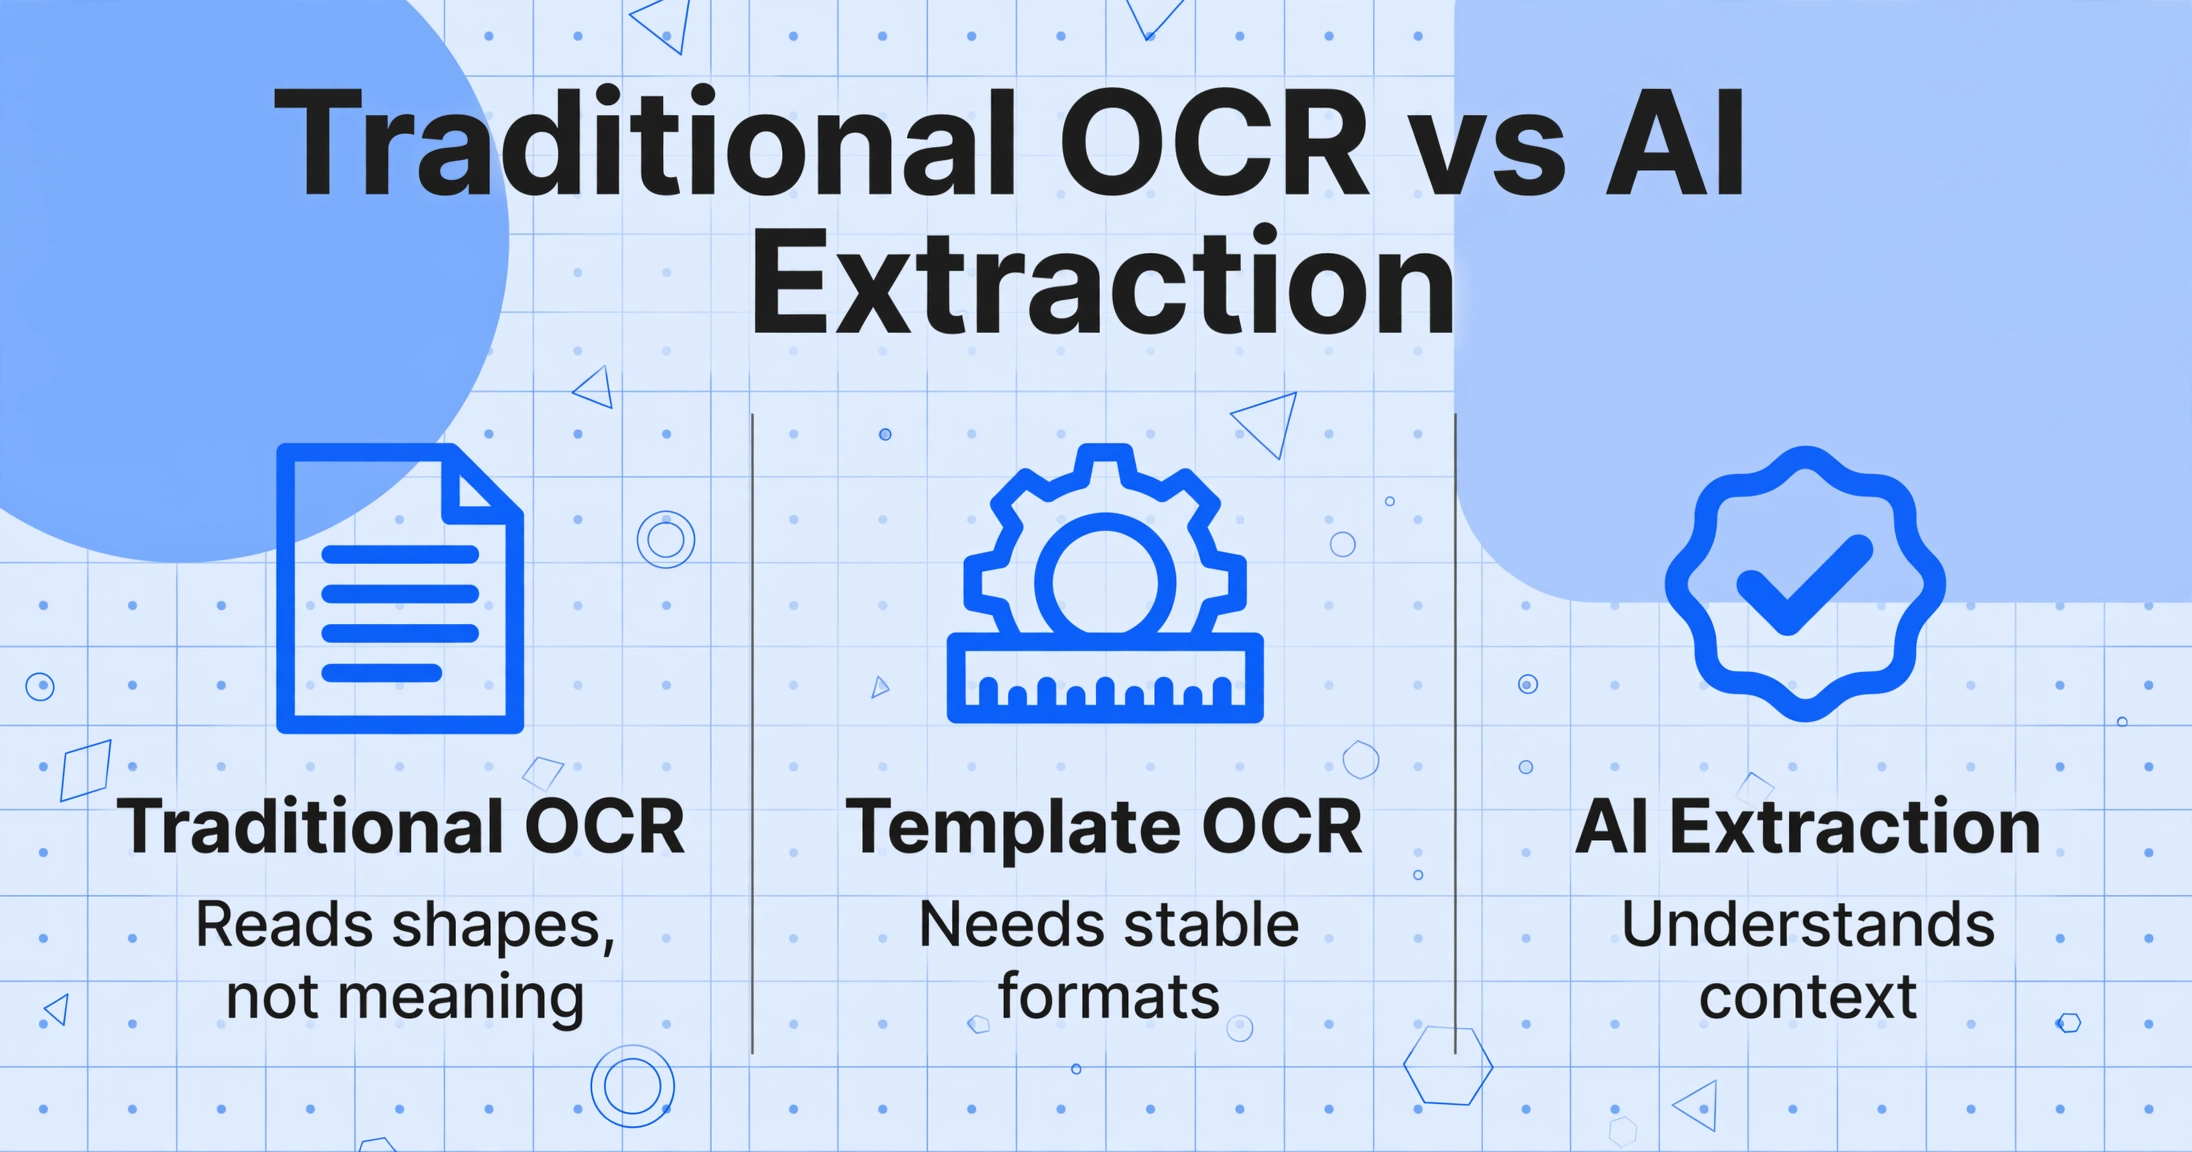
Die oben beschriebene Vier-Schritte-Pipeline ist der traditionelle OCR-Ansatz — und er hat sich seit den 1990er-Jahren grundlegend nicht verändert. Moderne KI-basierte Extraktion funktioniert in jedem einzelnen Schritt anders.
Den Unterschied zu verstehen hilft zu klären, warum traditionelle OCR für manche Aufgaben das richtige Werkzeug ist (durchsuchbare PDFs, Textarchive), aber an Grenzen stößt, wenn Sie strukturierte Daten benötigen (Tabellenkalkulationen, Datenbanken, Buchhaltungssysteme). Die folgende Tabelle zeigt, wie sich jeder Pipeline-Schritt zwischen dem alten Ansatz und einem modernen KI-Extraktionstool wie ImageToTable.ai unterscheidet.
| Pipeline-Schritt | Traditionelle OCR | KI-Extraktion (Vision-Modell) |
|---|---|---|
| Vorverarbeitung | Kritisch — schlechte Bereinigung garantiert Erkennungsfehler. Umfangreiche algorithmische Vorverarbeitung (Binarisierung, Entzerrung, Entrauschen) ist zwingend erforderlich. | Weniger kritisch — das Vision-Modell kann durch mäßiges Rauschen, geringen Kontrast und schiefe Winkel lesen. Grundlegende Bereinigung hilft weiterhin, ist aber keine harte Voraussetzung. |
| Texterkennung | Regelbasierte Heuristiken für Zeilen-, Wort- und Zeichensegmentierung. Scheitert bei komplexen Layouts, mehrspaltigen Dokumenten und gemischten Inhalten (Text + Tabellen + Bilder). | Ganzheitliches Seitenverständnis — das Modell identifiziert Kopfzeilen, Tabellen, Fußzeilen und Feldbeschriftungen anhand des visuellen Kontexts, nicht durch die Erkennung von Zeichengrenzen. |
| Zeichenerkennung | Musterabgleich oder Merkmalsextraktion gegen eine feste Zeichendatenbank. Jedes Zeichen wird isoliert identifiziert. | Das Modell liest ganze Wörter, Phrasen und Werte im visuellen Kontext. Es erkennt „INV-2026-001" als Rechnungsnummer, weil es auf die Position und die Umgebung achtet — nicht weil es einer Glyphenvorlage entspricht. |
| Nachbearbeitung | Wörterbuchkorrektur + Formatwiederherstellung. Das Ergebnis ist ein Klartext- oder formatiertes Dokument ohne Feldbeschriftungen oder Datenstruktur. | Semantische Feldzuordnung — das Modell gibt jeden Wert zusammen mit seinem Feldnamen aus (z. B. „Rechnungsnummer: INV-2026-001"). Keine manuelle Beschriftung oder Umstrukturierung erforderlich. |
| Endergebnis | Eine Textdatei oder ein durchsuchbares PDF. Jedes Zeichen ist vorhanden — aber Sie müssen jedes Feld trotzdem lesen, kopieren und in die richtige Tabellenspalte einfügen. | Eine strukturierte Tabelle oder ein JSON-Objekt. Werte sind bereits beschriftet, organisiert und bereit für Ihre Tabellenkalkulation oder Ihr Buchhaltungssystem. Kein Kopieren und Einfügen erforderlich. |
Der grundlegende Unterschied ist, dass traditionelle OCR Pixel in Zeichen umwandelt. KI-Extraktion wandelt Pixel in Bedeutung um. Das eine liefert Ihnen ein durchsuchbares Dokument. Das andere liefert Ihnen nutzbare Daten. Eine vollständige Aufschlüsselung der Kategorie KI-Extraktion – wie sie funktioniert, wann sie sinnvoll ist und wie sie im Vergleich zu anderen Ansätzen abschneidet – finden Sie in unserem Hub-Artikel zu Was ist KI-Dokumentenextraktion.
Und wenn Sie genau verstehen möchten, wie die KI-Version den Leseschritt bewältigt – mit Vision-Language-Modellen, die die gesamte Seite auf einmal verarbeiten statt Zeichen für Zeichen –, behandelt unser Artikel Was ist KI-OCR die Technologie im Detail.
Häufig gestellte Fragen
Kann OCR Handschrift lesen?
Traditionelle OCR tut sich schwer mit Handschrift – die Genauigkeit liegt typischerweise zwischen 50 % und 70 % bei Druckschrift und unter 50 % bei Schreibschrift. Der Grund ist architektonischer Natur: Der Zeichenerkennungsschritt identifiziert Buchstaben, indem er Formen mit einer Datenbank bekannter Glyphen abgleicht, und Handschrift weist weit mehr Variation auf, als jede Vorlagenbibliothek abdecken kann. Moderne KI-gestützte OCR schneidet deutlich besser ab (75–93 % bei Druckschrift-Handschrift), weil sie Wörter im Kontext liest, statt einzelne Zeichenformen abzugleichen. Vollständig freie Schreibschrift bleibt jedoch für alle Systeme eine Herausforderung.
Wie genau ist OCR bei gedrucktem Text?
Bei sauberen, getippten Dokumenten, die mit 300 DPI gescannt werden, erreichen moderne OCR-Engines eine Zeichengenauigkeit von 95–99 %. Dieser Wert sinkt bei minderwertigen Scans, ungewöhnlichen Schriftarten, kontrastarmen Originalen oder Dokumenten mit komplexen Layouts. Wichtig ist: Zeichengenauigkeit ist nicht Feldgenauigkeit – eine Zeichengenauigkeit von 99 % kann dennoch Ergebnisse liefern, bei denen 15–40 % der einzelnen Datenfelder, die Sie benötigen, Fehler enthalten, da die auftretenden Zeichenfehler dazu neigen, sich in numerischen Feldern zu häufen (wo eine falsche Ziffer den gesamten Wert verändert) und an Feldgrenzen (wo Zeichen benachbarter Felder zusammengeführt werden).
Ist OCR dasselbe wie Dokumentenextraktion?
Nein. OCR wandelt Bilder von Text in maschinenlesbare Zeichen um – es digitalisiert den Text. Dokumentenextraktion geht einen Schritt weiter: Sie identifiziert, welche Zeichen zu welchem Datenfeld gehören (Rechnungsnummer, Datum, Gesamtsumme, Lieferantenname) und gibt sie als strukturierte Daten in beschrifteten Spalten aus. OCR beantwortet die Frage „Welche Zeichen sind auf dieser Seite?“ Dokumentenextraktion beantwortet die Frage „Welche Daten enthält dieses Dokument?“ Der Unterschied zwischen diesen beiden Fragen ist der Unterschied zwischen einer Textdatei, die Sie noch durchsuchen müssen, und einer Tabelle, die Sie sofort nutzen können.
Funktioniert OCR mit PDFs oder nur mit Bildern?
OCR funktioniert mit jeder bildbasierten Eingabe: gescannten PDFs (die im Wesentlichen Bilder in einem PDF-Container sind), digital erstellten PDFs (wenn sie als Bilder verarbeitet werden), JPGs, PNGs und TIFFs. Der entscheidende Unterschied liegt zwischen gescannten PDFs (Seitenbildern ohne zugrunde liegende Textebene) und nativen PDFs (die auswählbaren Text enthalten). Gescannte PDFs müssen durch OCR durchsuchbar gemacht werden. Native PDFs enthalten bereits Text und benötigen keine OCR – aber sie müssen möglicherweise dennoch extrahiert werden, wenn Sie bestimmte Datenfelder in eine Tabelle übernehmen möchten.
Was ist der Unterschied zwischen OCR und OMR?
OCR (Optical Character Recognition) liest Text – Buchstaben, Zahlen, Satzzeichen – aus Bildern. OMR (Optical Mark Recognition) liest Markierungen auf einer Seite – ausgefüllte Kästchen in einer Umfrage, Kontrollkästchen in einem Formular, Häkchen auf einem Stimmzettel. OMR ist einfacher, weil es nur erkennen muss, ob eine Markierung an einer vordefinierten Stelle vorhanden ist oder nicht, und nicht, welches Zeichen die Markierung darstellt. Viele moderne Dokumentenverarbeitungstools kombinieren beides: OCR für Textfelder, OMR für Kontrollkästchen und Auswahlmarkierungen.
Zu verstehen, wie OCR funktioniert, ist der erste Schritt, um zu wissen, wann es ausreicht – und wann Sie etwas mehr benötigen. Die vierstufige Pipeline hat die Dokumentendigitalisierung seit Jahrzehnten gut bedient, aber die Lücke zwischen „lesbarem Text" und „nutzbaren Daten" ist eine Lücke, die traditionelle OCR nie überbrücken sollte. Erfahren Sie, wie KI-Dokumentextraktion diese Lücke überbrückt, indem sie Bedeutung liest, nicht nur Zeichen.