OCRの仕組みとは?
初心者向けステップバイステップガイド
光学文字認識(OCR)とは、画像内のテキストを機械が読み取れる文字に変換する技術で、画像のクリーニング、テキスト検出、文字認識、出力の精緻化という一連のプロセスを通じて行われます。スキャンした文書をコンピュータがどうやって「読んでいる」のか不思議に思ったことや、時々おかしな誤読をすることに驚いたことがあるなら、この記事がまさにその仕組みを、難しい専門用語を使わずに一つずつ丁寧に解説します。
重要なポイント
- OCRは「読んでいる」のではなく、正確なマッチングゲームをしているのです。未知のピクセルの塊を、保存された文字形状のライブラリと比較します。「T」をその画数で認識するのであって、「Total」の最初の文字だから認識するわけではありません。
- OCRの最も危険なエラーは目に見えません。隣接する文字が1つに融合すると(「rn」が「m」になるなど)、出力は依然として有効な英単語のように見え、後続のすべての処理ステップがその破損を真実として扱ってしまいます。
- 文字精度99%でも、データフィールドの15〜40%にエラーが含まれる可能性があります。なぜならOCRは「このページにどの文字があるか?」に答えるのであって、「これらの数字のうちどれが請求書の合計か?」には答えないからです。
OCRが実際に行うこと(そして行わないこと)
OCRは単一の魔法のようなステップではなく、ピクセルをテキストに変換する4段階の組み立てラインです。かつて文字言語を見たことがない人に読むことを教えなければならない状況を想像してみてください。まず、ページ上のいくつかの印が文字であり、他はただの汚れや紙の質感であることを彼らが認識できるように助けることから始めるでしょう。次に、各文字には認識可能な形があることを教えます — 大文字のAは、どのフォントで表示されても、常におおよそ三角形の形に横棒がある、といった具合です。その後に初めて、文字を単語に、単語を文章に組み合わせることを始められます。これはまさにOCRエンジンの仕組みです。ドキュメントをレイヤーごとに処理し、一歩ずつ下から理解を構築していきます。
しかし重要な落とし穴があります:OCRは形を読み取るのであって、意味を読み取るのではありません。エンジンは一連のストロークが「T」という文字を形成することを知っていますが、「T」が「Total」や「Tax」の最初の文字であるということはまったく理解していません。ドキュメントをデジタル化しますが、理解しているわけではないのです。この違いこそが、OCR出力が検索可能なPDFには役立つ一方、スプレッドシートで構造化データが必要な場合には不十分である理由です。OCRとは何か、その3つの技術世代がどのようなものかについての完全な概要は、OCRとは何か、そしてその進化に関するガイドをご覧ください。
4ステップのOCRパイプラインの概要
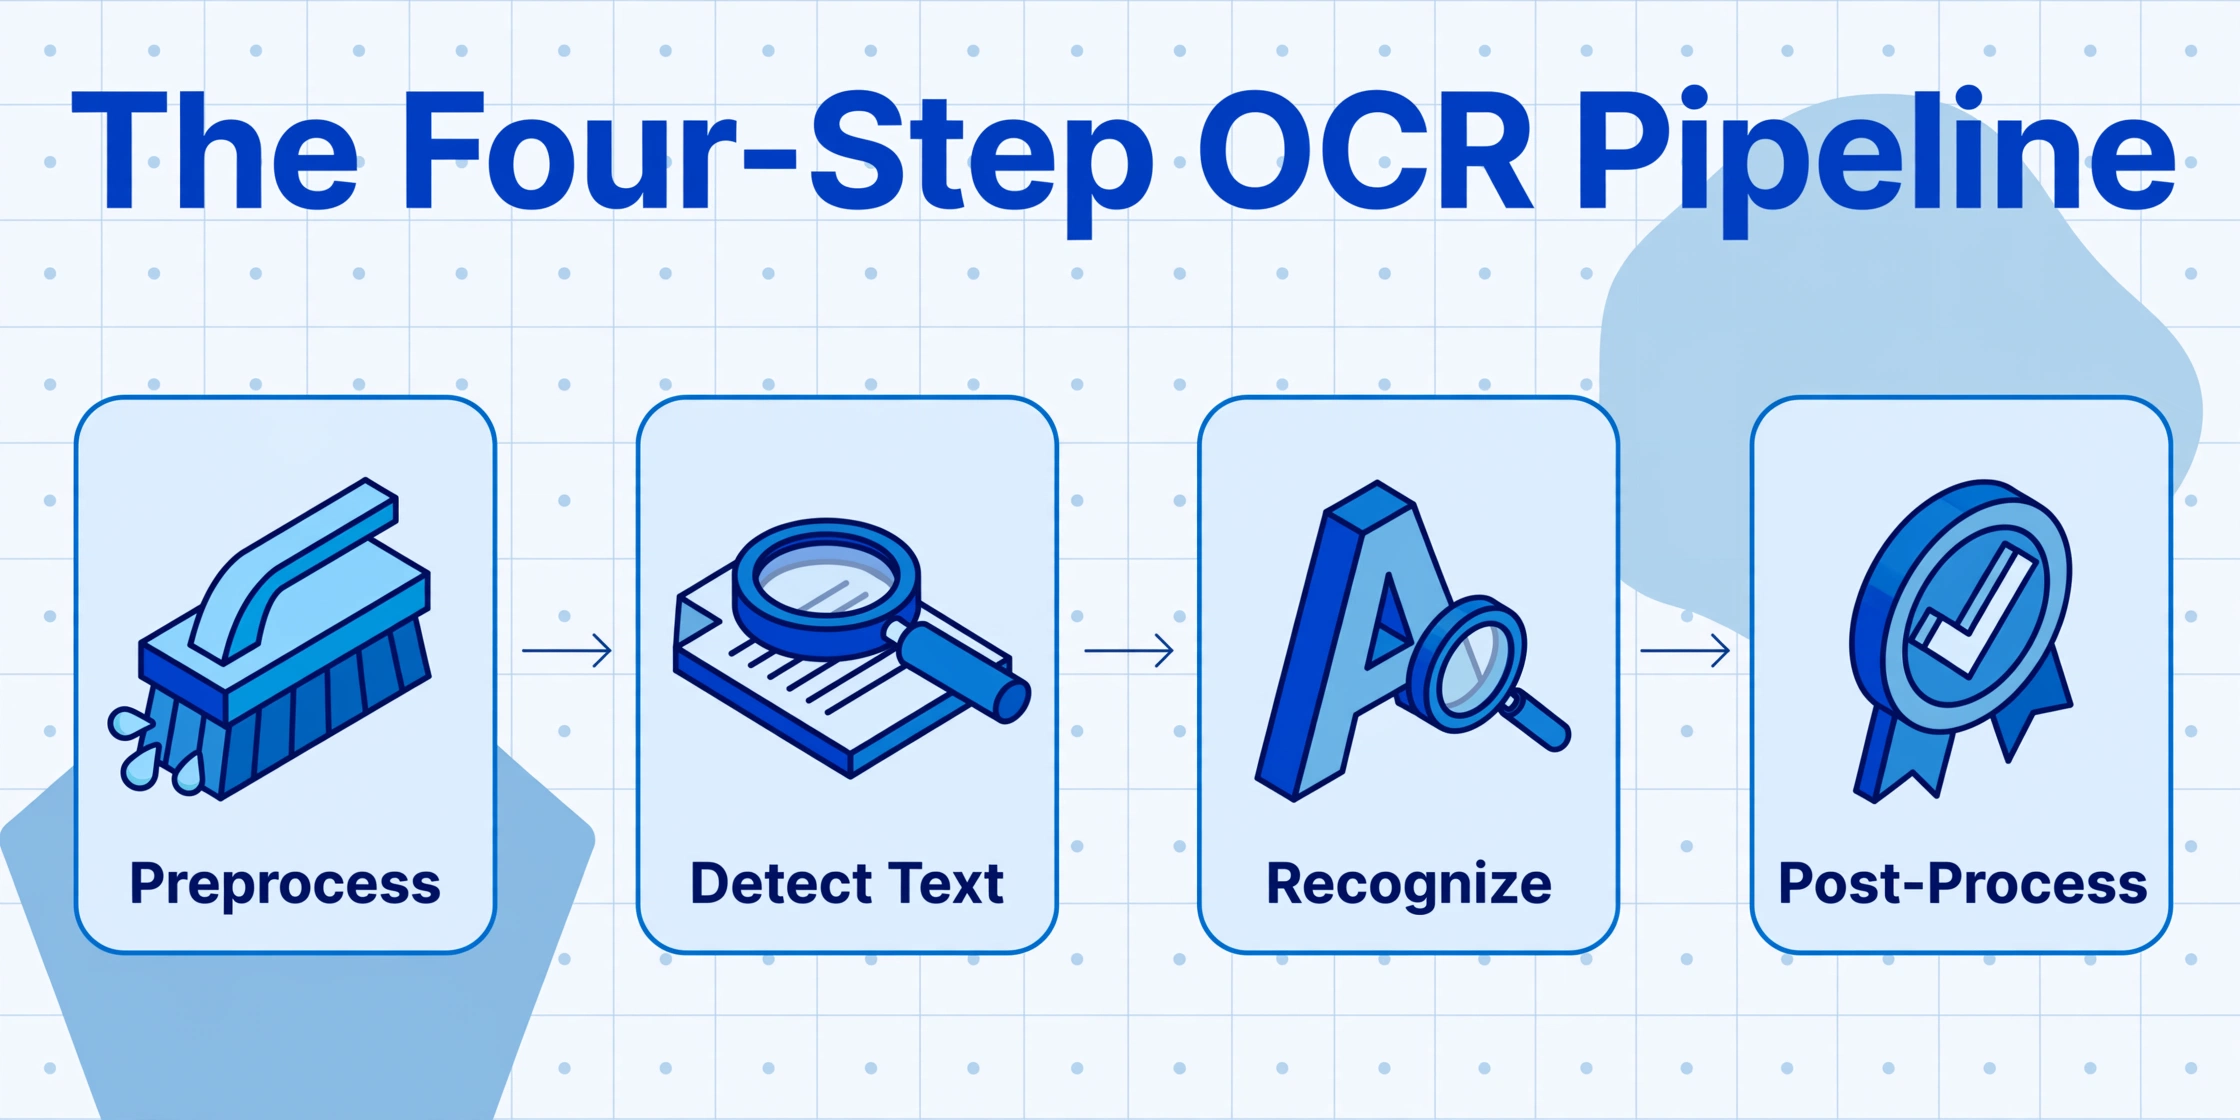
無料のTesseractから商用システムまで、すべてのOCRエンジンは同じ4ステップのワークフローに従います。これを、各ステーションに1つの特定の仕事がある工場の組み立てラインと考えてください。あるステーションの出力が次のステーションの入力になります。どのステーションでも仕事が不十分であれば、下流のすべてのステーションで結果が悪化します。
前処理
画像をクリーニングします。ノイズを除去し、傾きを補正し、コントラストを調整します。エンジンは、はっきり見えないものは読み取れません。
テキスト検出
テキストを見つけます。画像のどの部分に文字が含まれ、どの部分が写真、ロゴ、または空白かを特定します。次に、テキストを行、単語、個々の文字に分割します。
文字認識
既知の文字、数字、記号のライブラリと形状を照合して、各文字を識別します。これがOCRの中核ステップであり、他のすべてはこれを支えています。
後処理
出力を洗練させます。辞書と照合して単語をチェックし、文脈を使用して曖昧な文字を解決し、出力ファイル用にテキストを整形します。
それでは、各ステップを詳しく見ていきましょう。エンジンが実際に行うこと、それが重要な理由、そして理解を深めるための具体的な例えを用いて説明します。
ステップ1 — 前処理: 読み取り前の画像クリーニング
エンジンが1文字でも認識する前に、認識ステップを妨げるものを排除するために画像をクリーニングする必要があります。 これは、本を読む前に眼鏡を拭くようなものです。レンズが曇っていたり、傾いていたり、傷が付いていたりすると、文字をはっきり読むことはできません。
OCRエンジンに届くスキャン文書が完璧な状態であることはほとんどありません。ページがスキャナーに少し斜めに置かれている場合があります(スキューと呼ばれる問題)。スキャンには、ほこりの斑点、ファックスのアーティファクト、または本の背表紙の影が含まれている場合があります。インクと用紙のコントラストが低い場合もあります。特に、古い文書、カーボンコピー、色あせたレシートなどで顕著です。前処理ステップでは、実際の読み取りを開始する前に、これらすべてを修正します。
最も重要な前処理ステップは2値化です。これは、テキストを背景から分離するしきい値を使用して、画像を純粋な白黒に変換することです。 Otsu's methodと呼ばれる一般的な手法は、ピクセル強度のヒストグラムを分析し、最適なしきい値を自動的に選択します。スキャンした文書が、明るい白いページにくっきりとした黒いテキストのように見えるのを見たことがあれば、それは2値化の結果です。
その他の前処理操作には、傾き補正(傾いたテキストをまっすぐにするために画像を回転させる)、ノイズ除去(ほこりの斑点やスキャナーアーティファクトを除去する)、斑点除去(句読点や発音記号と間違われる可能性のある不要なマークを除去する)、およびコントラスト正規化(かすんだテキストが読み取れるように明るさを調整する)が含まれます。
この段階で、多くのOCR失敗の原因がすでに作り込まれています。二値化処理で小文字の尾部が切り落とされたり、隣接する文字が塊に融合したりすると、認識段階でどんなに高度なアルゴリズムを使っても正しく認識するチャンスはありません。ゴミを入れればゴミが出る——OCRでは、この格言はすべてのピクセルに当てはまります。
前処理の品質が低ければ認識品質も低くなります——どんなに優れた文字照合エンジンでも、クリーニング段階で失われた情報を修復することはできません。
ステップ2 — テキスト検出:単語の位置を見つける
画像がきれいになったら、次にエンジンはページのどの部分に実際にテキストが含まれているかを特定しなければなりません。 これがレイアウト解析の段階です。新聞のページを見ることを想像してみてください。見出し、写真のキャプション、サイドバー、引き出し引用の違いは一目でわかりますが、OCRエンジンはこの区別をピクセル単位で学習する必要があります。
エンジンは前処理済みの画像をスキャンして、テキスト領域(文字が密集した領域)を特定し、画像、ロゴ、装飾的な枠線、空白スペースから分離します。次に、各テキスト領域を徐々に小さな単位に分割していきます:
1. ブロック — 関連するコンテンツ(テキストの列、表、ヘッダーなど)を含む可能性が高い大きな長方形領域。
2. 行 — 各ブロック内で、エンジンは文字を含む水平方向のピクセルの帯を見つけることで、個々のテキスト行を特定します。
3. 単語 — 各行内で、文字形状間の間隔を測定することで、文字を単語にグループ化します。
4. 文字 — 最後に、各単語は認識エンジンに渡される個々の文字セグメントに分割されます。
この一見単純なステップには、大きな課題が隠されています:プロポーショナルフォントです。プロポーショナルフォントでは、2つの文字(「r」と「n」など)の間のスペースが、圧縮された書体で設定された2つの単語の間のスペースよりも広くなることがあります。エンジンは、ギャップが同じ単語内の2つの文字を分離しているのか、それとも2つの単語を分離しているのかを判断しなければなりません。エンジンはヒューリスティック(典型的な文字幅、空白のしきい値、言語固有のパターン)を使用しますが、これらのヒューリスティックが常に正しいとは限りません。誤って判断すると、単語が誤って結合または分割され、後続のすべてのステップがそのエラーを受け継ぐことになります。
検出エラーは、エラーに見えないため、最も厄介なタイプのOCR障害です。結合された単語は、人間のレビュー担当者には正当な(馴染みがなくても)単語に見えます。 エンジンが「rn」を「m」として読み取ると、「commercial」が突然「commeicial」になります——スペルチェッカーなら検出できる間違いですが、出力がスペルチェッカーを通過する場合に限ります。
ステップ3 — 文字認識:OCRの核心
これは、人々が「OCR」と言うときに実際に意味しているステップです。エンジンは、切り出された個々の文字画像を受け取り、それがどの文字、数字、記号を表しているかを判断します。 子どもがフラッシュカードでアルファベットを学ぶ様子を想像してください。ArialのA、Times New RomanのA、手書きのAなど、さまざまなフォントの文字Aの絵を見せて、スタイルに関係なく認識できるように学習させます。OCRエンジンも同じことを行いますが、数百万枚のフラッシュカードを持ち、それをミリ秒単位で処理します。
文字認識には、2つの基本的なアプローチがあります。
パターンマッチング(テンプレートOCR) — エンジンは、既知のフォントとサイズの文字画像(グリフ)のデータベースを保持します。新しい文字に遭遇すると、ピクセルパターンを保存されている各グリフと比較し、最も近い一致を選びます。このアプローチは数十年にわたって標準であり、1974年にHP Labsで開発され、現在はGoogleがメンテナンスしているオープンソースのOCRエンジンであるTesseractなどのエンジンを支えています。パターンマッチングは、ドキュメントがエンジンが以前に見たことのあるフォントを使用している場合にうまく機能します。フォントが珍しい場合、テキストが手書きの場合、または画像品質が低下した場合には失敗します。入力が保存されているテンプレートのいずれにも似なくなるためです。
特徴抽出(インテリジェントOCR) — エンジンはピクセルパターン全体を比較する代わりに、各文字を構成する特徴(線、曲線、ループ、交差点、端点、角度)に分解します。文字「A」には、一点で交わる2本の対角線と水平なクロスバーがあります。文字「O」には、単一の閉じたループがあります。フォントやサイズに関係なくこれらの特徴を識別することで、エンジンはこれまで見たことのない文字も認識できます。最新のOCRエンジンのほとんどはこのアプローチを使用しており、多くの場合、EMNIST(Extended MNIST)などのデータセットでトレーニングされたニューラルネットワークによって強化されています。EMNISTは、数字と大文字・小文字にわたる814,255枚のラベル付き文字画像のコレクションです。
両方のアプローチの重大な制限は同じです。それは、形状を識別するだけで、意味を識別しないということです。エンジンは、ピクセルグループが文字「5」であると99%の信頼度で伝えることはできますが、その「5」が数量、価格、日付、部屋番号、モデルコードのいずれであるかを伝えることはできません。 文字を、一貫性のあるドキュメントの一部としてではなく、孤立した記号として読み取ります。これが、従来のOCRエンジンがきれいな請求書で99%の文字精度を達成しながらも、請求書の合計金額を見つけられない出力を生成する理由です。すべての文字は正しいのに、どれもラベル付けされていないからです。
このステップが従来のOCRと最新のAIベースのアプローチでどのように異なるか、ドキュメントタイプ別の精度ベンチマークを含む詳細な比較については、AI OCRと従来のOCRの比較に関する解説をご覧ください。
ステップ4 — 後処理:出力を読みやすくする
文字認識ステップの生の出力は、推測された文字列です。正しいものもあれば、そうでないものもあり、すべて文脈が欠けています。後処理では、エンジンが自身の誤りを修正しようとします。 これは非常に強力な自動修正システムと考えてください。単なる辞書検索ではなく、周囲の文脈に基づいて「there」「their」「they're」の違いを認識します。
最も一般的な後処理技術は次のとおりです。
辞書による修正
エンジンは認識された各単語を言語辞書と照合します。「reciept」があれば「receipt」に修正されます。単語「m0del」の中間文字が「O」か「0」か不明な場合、辞書によって「model」であることが確認されます。
文脈に基づく曖昧性の解消
数字の「1」と小文字の「l」のように文字が曖昧な場合、エンジンは周囲の文字を調べて判断します。「C1ient」は「Client」に修正されます(「C1ient」は単語ではないため)。一方、「Page 1」では数字が維持されます(「Page l」は意味をなさないため)。
信頼度スコアリング
認識されたすべての文字に信頼度スコアが割り当てられます。信頼度の低い領域は、人間による確認のためにフラグを立てたり、異なる認識パラメータで再処理したり、別のアルゴリズムを使用した二次認識パスに渡したりできます。
フォーマット再構築
エンジンは認識されたテキストを元の文書レイアウトに再構成します。改行、段落間隔、表の配置、読み取り順序を保持します。このステップにより、元のスキャンされたページのように見える検索可能なPDFが生成されます。
これらすべてのインテリジェンスにもかかわらず、後処理には根本的な限界があります。スペルミスは修正できますが、意味を追加することはできません。出力 $1,234.56 が有効な通貨額であることはわかりますが、エンジンはそれが請求書の合計なのか、明細の小計なのか、税額なのか、参照番号なのかをまだ認識していません。後処理によってテキストは読みやすくなりますが、データとして使用可能になるわけではありません。
すべてを変える違い — 従来のOCRとAI抽出
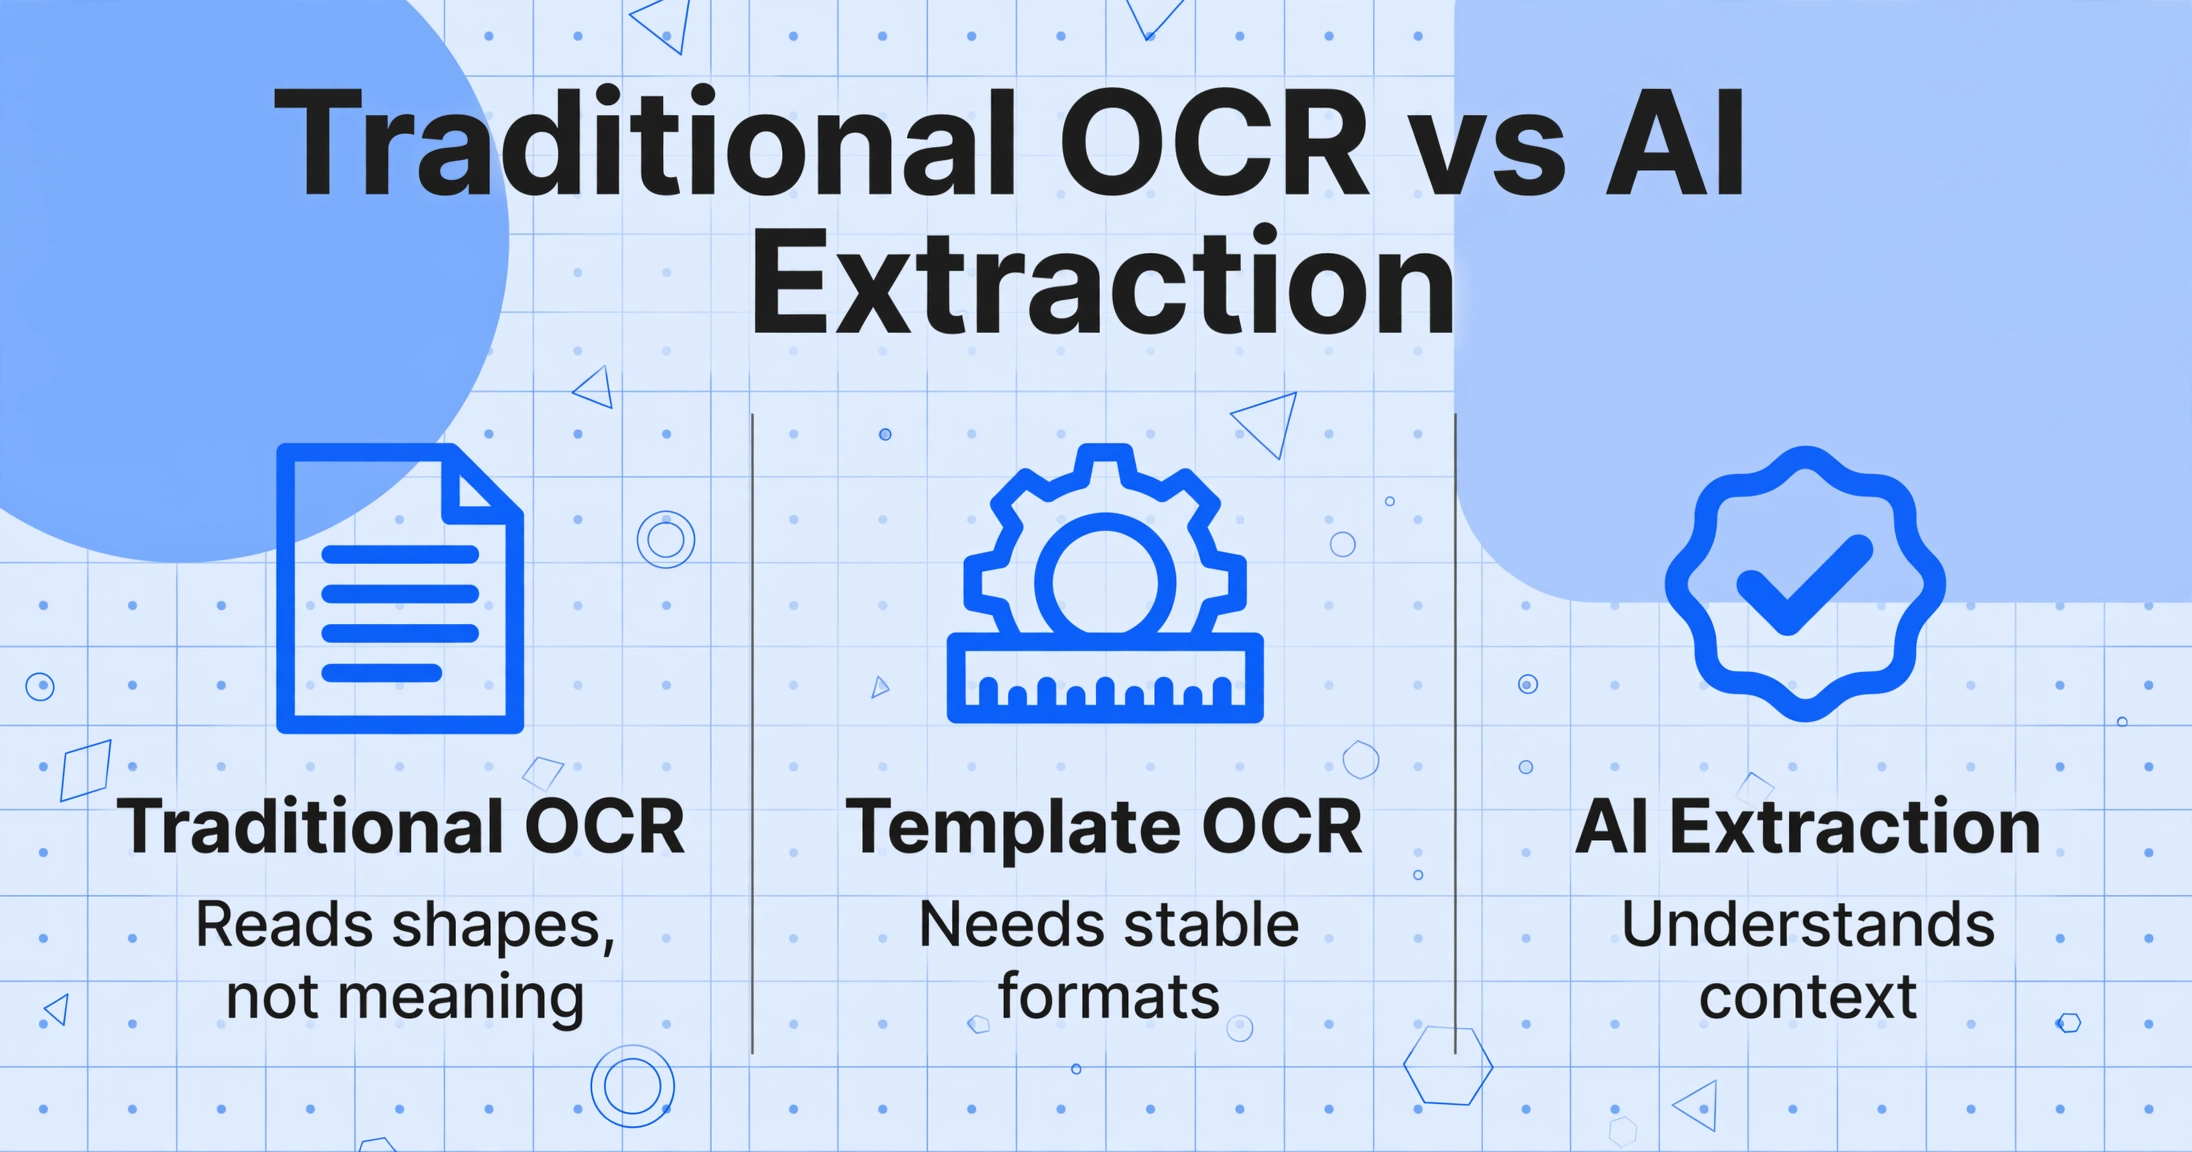
上記の4段階パイプラインは従来のOCRアプローチであり、1990年代から根本的には変わっていません。現代のAIベースの抽出は、すべての段階で異なる方法で機能します。
この対比を理解すると、従来のOCRが検索可能なPDFやテキストアーカイブなどの一部の作業には適したツールである一方、スプレッドシート、データベース、会計システムなどの構造化データが必要な場合には不十分である理由が明確になります。以下の表は、従来のアプローチとImageToTable.aiのような最新のAI抽出ツールで、各パイプライン段階がどのように異なるかを示しています。
| パイプライン段階 | 従来のOCR | AI抽出(ビジョンモデル) |
|---|---|---|
| 前処理 | 重要 — 前処理が不十分だと認識失敗が確実になります。二値化、傾き補正、ノイズ除去などの高度なアルゴリズム処理が必須です。 | 重要度は低め — ビジョンモデルは中程度のノイズ、低コントラスト、傾きのある角度でも読み取れます。基本的なクレンジングは役立ちますが、必須の前提条件ではありません。 |
| テキスト検出 | 行・単語・文字のセグメンテーションにルールベースのヒューリスティックを使用。複雑なレイアウト、複数カラムの文書、混在コンテンツ(テキスト+表+画像)では機能しません。 | ページ全体を理解 — モデルは文字の境界を検出するのではなく、視覚的な文脈から見出し、表、フッター、フィールドラベルを識別します。 |
| 文字認識 | 固定の文字データベースに対するパターンマッチングまたは特徴抽出。各文字は単独で識別されます。 | モデルは視覚的な文脈で単語、フレーズ、値全体を読み取ります。「INV-2026-001」が請求書番号であることを、グリフテンプレートに一致したからではなく、その位置と周囲の情報から認識します。 |
| 後処理 | 辞書補正+形式再構築。出力はフィールドラベルやデータ構造のないプレーンテキストまたは整形済み文書です。 | 意味的フィールドマッピング — モデルは各値をフィールド名とペアで出力します(例:「請求書番号:INV-2026-001」)。手動でのラベル付けや再構築は不要です。 |
| 最終結果 | テキストファイルまたは検索可能なPDF。すべての文字は含まれていますが、各フィールドを読み取ってコピー&ペーストし、正しいスプレッドシートの列に入力する必要があります。 | 構造化されたテーブルまたはJSONオブジェクト。値はすでにラベル付けされ、整理されており、スプレッドシートや会計システムですぐに使用できます。コピー&ペーストの手順は不要です。 |
根本的な違いは、従来のOCRがピクセルを文字に変換するのに対し、AI抽出はピクセルを意味に変換することです。前者は検索可能なドキュメントを、後者はすぐに使えるデータを提供します。 AI抽出カテゴリの完全な解説(仕組み、適した場面、他のアプローチとの比較)については、AIドキュメント抽出とは何かに関するハブ記事をご覧ください。
また、AI版が文字単位ではなくページ全体を一度に処理するビジョン言語モデルで読み取りステップをどう処理するかを正確に理解したい場合は、AI OCRとは何かの記事で技術を詳しく解説しています。
よくある質問
OCRは手書き文字を読めますか?
従来のOCRは手書き文字が苦手で、ブロック体で50〜70%、筆記体では50%未満の精度にとどまることが一般的です。その理由は構造にあります。文字認識ステップでは、既知のグリフのデータベースと形状を照合して文字を識別しますが、手書き文字はどのテンプレートライブラリでもカバーできないほど多様なバリエーションを生み出します。最新のAI搭載OCRは、個々の文字形状を照合するのではなく文脈で単語を読むため、大幅に優れた性能(ブロック体手書きで75〜93%)を発揮します。ただし、完全に自由な筆記体は、すべてのシステムにとって依然として困難です。
印刷テキストに対するOCRの精度はどのくらいですか?
300 DPIでスキャンされた鮮明なタイプ文書では、最新のOCRエンジンは95〜99%の文字精度を達成します。この数値は、劣化したスキャン、特殊なフォント、低コントラストの原本、複雑なレイアウトの文書では低下します。重要なのは、文字精度はフィールド精度ではないということです。99%の文字精度でも、対象となる個々のデータフィールドの15〜40%にエラーが含まれる出力になる可能性があります。これは、発生する文字エラーが数値フィールド(1桁の誤りで値全体が変わる)とフィールド境界(隣接フィールドの文字が結合される)に集中する傾向があるためです。
OCRとドキュメント抽出は同じものですか?
いいえ。OCRはテキストの画像を機械可読な文字に変換します。つまりテキストをデジタル化します。ドキュメント抽出はさらに一歩進んで、どの文字がどのデータフィールド(請求書番号、日付、合計、ベンダー名)に属するかを識別し、ラベル付きの列を持つ構造化データとして出力します。OCRは「このページにどの文字があるか?」に答え、ドキュメント抽出は「このドキュメントにはどのデータが含まれているか?」に答えます。この2つの質問の違いは、整理が必要なテキストファイルと、すぐに使えるスプレッドシートの違いです。
OCRは画像だけでなくPDFでも機能しますか?
OCRはあらゆる画像ベースの入力で機能します。スキャンされたPDF(本質的にはPDFコンテナに包まれた画像)、生まれながらのデジタルPDF(画像として処理される場合)、JPG、PNG、TIFFなどです。重要な区別は、スキャンPDF(テキストレイヤーのないページ画像)とネイティブPDF(選択可能なテキストを含む)の間にあります。スキャンPDFは検索可能にするためにOCRを経由する必要があります。ネイティブPDFにはすでにテキストが含まれておりOCRは不要ですが、特定のデータフィールドをスプレッドシートに取り出したい場合は抽出が必要な場合があります。
OCRとOMRの違いは何ですか?
OCR(光学式文字認識)は、画像から文字(英字、数字、句読点)を読み取ります。OMR(光学式マーク認識)は、ページ上のマーク(アンケートの塗りつぶし、フォームのチェックボックス、投票用紙のチェックマーク)を読み取ります。OMRは、マークが事前定義された位置に存在するかどうかを検出するだけでよく、マークが表す文字を識別する必要がないため、よりシンプルです。最新の文書処理ツールの多くは、テキストフィールドにはOCR、チェックボックスや選択マークにはOMRというように、両方を組み合わせています。
OCRの仕組みを理解することは、いつOCRで十分なのか、そしていつもっと高度なものが必要なのかを見極めるための第一歩です。この4段階のパイプラインは、数十年にわたり文書のデジタル化に貢献してきましたが、「読み取り可能なテキスト」と「利用可能なデータ」の間には、従来のOCRが決して埋めるように設計されていなかったギャップがあります。AI文書抽出が、文字だけでなく意味を読み取ることで、そのギャップをどのように埋めるかをご覧ください。