Comment fonctionne l'OCR ?
Un guide pas à pas (sans jargon)
La reconnaissance optique de caractères (OCR) est la technologie qui convertit des images de texte en caractères lisibles par machine grâce à un processus séquentiel de nettoyage d'image, de détection de texte, de reconnaissance de caractères et d'affinage de la sortie. Si vous avez déjà scanné un document en vous demandant comment l'ordinateur « lit » comme par magie les mots imprimés — ou pourquoi il les lit parfois mal de façon hilarante — cet article explique exactement ce qui se passe, étape par étape, en langage simple.
Points clés à retenir
- L'OCR ne lit pas — il joue à un jeu de correspondance précis, comparant des blobs de pixels inconnus à une bibliothèque de formes de lettres stockées. Il reconnaît le « T » par ses traits, pas parce que c'est la première lettre de « Total ».
- Les erreurs les plus dangereuses de l'OCR sont invisibles — lorsque des caractères adjacents fusionnent en un seul (« rn » devient « m »), le résultat ressemble toujours à un mot anglais valide, et chaque étape en aval traite la corruption comme la vérité.
- Un taux de précision de 99 % au niveau des caractères signifie quand même que 15 à 40 % de vos champs de données contiennent des erreurs — car l'OCR répond à la question « quels caractères figurent sur cette page ? » et non « lequel de ces nombres est le total de la facture ? »
Ce que fait réellement l'OCR (et ce qu'il ne fait pas)
L'OCR n'est pas une étape magique unique — c'est une chaîne de montage en quatre étapes qui transforme les pixels en texte. Imaginez que vous deviez apprendre à lire à quelqu'un qui n'a jamais vu de langue écrite. Vous commenceriez par l'aider à voir que certaines marques sur la page sont des lettres et que d'autres ne sont que des taches ou la texture du papier. Ensuite, vous lui apprendriez que chaque lettre a une forme reconnaissable — un A majuscule a toujours une forme approximativement triangulaire avec une barre transversale, quel que soit le police de caractères. Ce n'est qu'après cela qu'il pourrait commencer à combiner des lettres en mots, puis des mots en phrases. C'est exactement ainsi que fonctionne un moteur d'OCR : il traite un document en couches, construisant la compréhension de bas en haut, étape par étape.
Mais il y a un piège crucial : l'OCR lit les formes, pas le sens. Le moteur sait qu'une séquence de traits forme la lettre « T », mais il n'a aucune idée que « T » est la première lettre de « Total » ou « Taxe ». Il numérise votre document — il ne le comprend pas. Cette distinction explique pourquoi la sortie de l'OCR est utile pour les PDF consultables, mais insuffisante lorsque vous avez besoin de données structurées dans un tableur. Pour un aperçu complet de ce qu'est l'OCR et de ses trois générations technologiques, consultez notre guide sur ce qu'est l'OCR et comment il a évolué.
Le pipeline OCR en quatre étapes en un coup d'œil
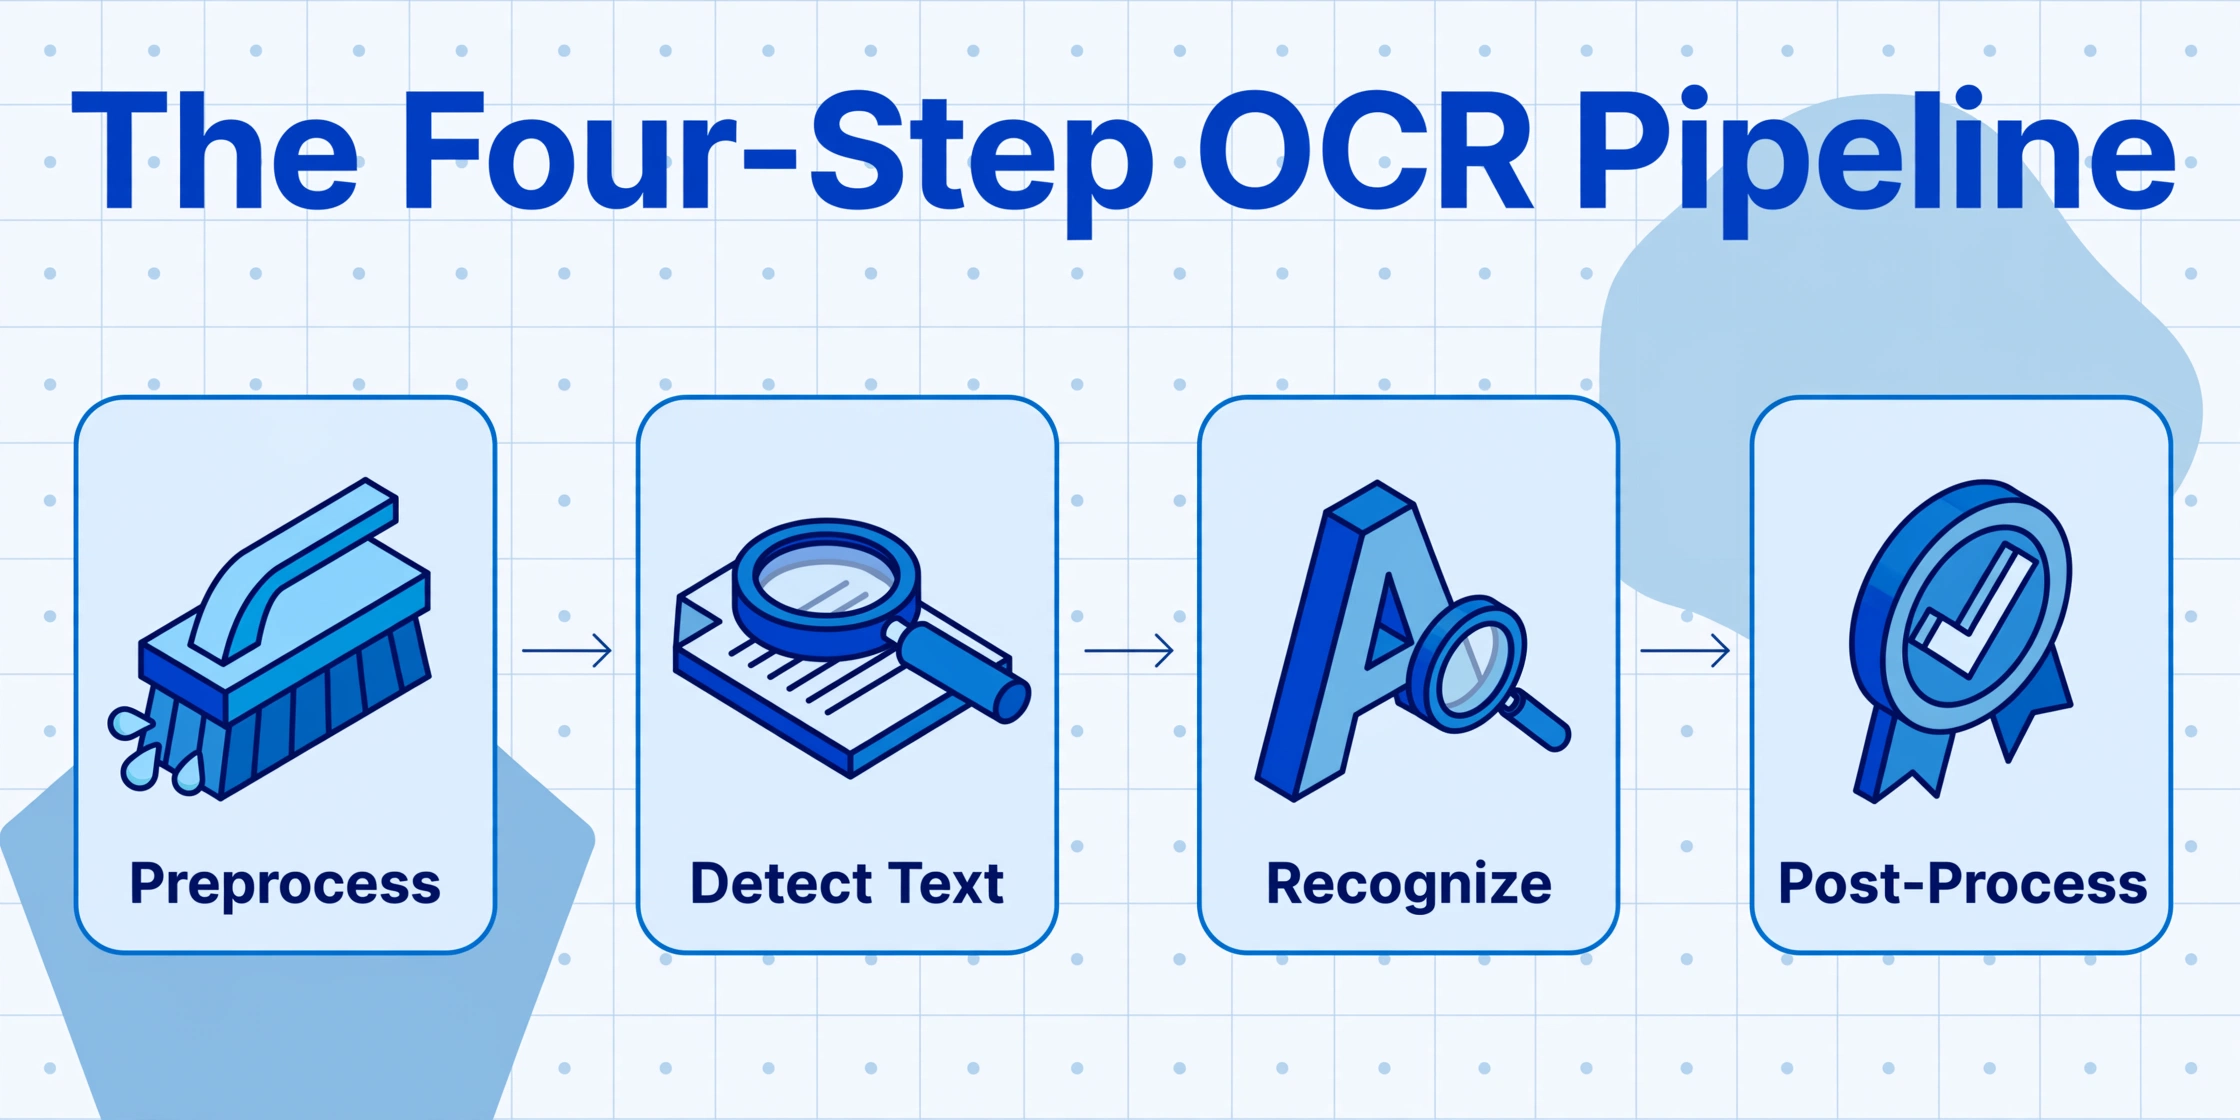
Chaque moteur d'OCR — du Tesseract gratuit aux systèmes commerciaux — suit le même flux de travail en quatre étapes. Pensez-y comme à une chaîne de montage d'usine où chaque poste a une tâche spécifique. La sortie d'un poste devient l'entrée du suivant. Si un poste fait mal son travail, tous les postes en aval produisent de moins bons résultats.
Prétraitement
Nettoyez l'image. Supprimez le bruit, corrigez l'inclinaison, ajustez le contraste. Le moteur ne peut pas lire ce qu'il ne voit pas clairement.
Détection du texte
Trouvez le texte. Identifiez les parties de l'image qui contiennent des caractères et celles qui contiennent des photos, des logos ou des espaces vides. Puis divisez le texte en lignes, mots et caractères individuels.
Reconnaissance des caractères
Identifiez chaque caractère en comparant sa forme à une bibliothèque connue de lettres, chiffres et symboles. C'est l'étape centrale de l'OCR — tout le reste la soutient.
Post-traitement
Affinez la sortie. Vérifiez les mots par rapport aux dictionnaires, résolvez les caractères ambigus à l'aide du contexte et formatez le texte pour le fichier de sortie.
Parcourons maintenant chaque étape en détail — avec ce que le moteur fait réellement, pourquoi c'est important, et une analogie concrète pour bien retenir.
Étape 1 — Prétraitement : nettoyer l'image avant la lecture
Avant que le moteur puisse reconnaître une seule lettre, il doit nettoyer l'image pour éliminer tout ce qui pourrait perturber l'étape de reconnaissance. C'est comme nettoyer vos lunettes avant de lire un livre — vous ne pouvez pas lire les mots clairement si la lentille est tachée, inclinée ou rayée.
Un document scanné qui arrive au moteur OCR est rarement en parfait état. La page peut avoir été placée légèrement de travers sur le scanner (un problème appelé inclinaison). Le scan peut contenir des grains de poussière, des artefacts de télécopie ou l'ombre de la reliure d'un livre. Le contraste entre l'encre et le papier peut être faible — surtout avec les documents anciens, les copies carbone ou les reçus délavés. L'étape de prétraitement corrige tout cela avant que la lecture ne commence.
L'étape de prétraitement la plus importante est la binarisation — la conversion de l'image en noir et blanc pur à l'aide d'un seuil qui sépare le texte de l'arrière-plan. Une technique courante appelée Otsu's method analyse l'histogramme des intensités de pixels et choisit automatiquement la valeur de seuil optimale. Si vous avez déjà vu un document scanné qui ressemble à du texte noir net sur une page blanche éclatante, vous avez vu le résultat de la binarisation.
Les autres opérations de prétraitement incluent le redressement (rotation de l'image pour redresser le texte incliné), la suppression du bruit (filtrage des grains de poussière et des artefacts du scanner), le débruitage (suppression des marques parasites qui pourraient être confondues avec de la ponctuation ou des signes diacritiques) et la normalisation du contraste (ajustement de la luminosité pour rendre le texte faible lisible).
Cette étape est celle où de nombreux échecs d'OCR sont déjà intégrés. Si la binarisation coupe les extrémités des lettres minuscules ou fusionne des caractères adjacents en blobs, l'étape de reconnaissance n'a aucune chance de les corriger, quelle que soit la sophistication de son algorithme. Garbage in, garbage out — et en OCR, cet adage s'applique à chaque pixel.
Un prétraitement médiocre garantit une reconnaissance médiocre — même le meilleur moteur de correspondance de caractères ne peut pas corriger ce qui a été perdu lors du nettoyage.
Étape 2 — Détection du texte : trouver où se trouvent les mots
Maintenant que l'image est propre, le moteur doit déterminer quelles parties de la page contiennent réellement du texte. C'est la phase d'analyse de mise en page. Pensez-y comme à la lecture d'un journal : vous pouvez instantanément distinguer un titre, une légende de photo, une colonne latérale et une citation détachée — mais le moteur d'OCR doit apprendre cette distinction pixel par pixel.
Le moteur analyse l'image prétraitée pour identifier les régions de texte — des zones denses en caractères — et les séparer des images, logos, bordures décoratives et espaces vides. Il divise ensuite chaque région de texte en unités de plus en plus petites :
1. Blocs — De grandes régions rectangulaires contenant probablement du contenu connexe (une colonne de texte, un tableau, un en-tête).
2. Lignes — Dans chaque bloc, le moteur identifie des lignes de texte individuelles en trouvant des bandes horizontales de pixels contenant des caractères.
3. Mots — Dans chaque ligne, il regroupe les caractères en mots en mesurant l'espacement entre les formes de caractères.
4. Caractères — Enfin, chaque mot est divisé en segments de caractères individuels qui seront transmis au moteur de reconnaissance.
Cette étape apparemment simple cache un défi important : les polices proportionnelles. Dans une police proportionnelle, l'espace entre deux lettres (comme « r » et « n ») peut être plus large que l'espace entre deux mots composés dans une police condensée. Le moteur doit décider si un espace sépare deux lettres du même mot ou deux mots. Il utilise des heuristiques — largeur typique des caractères, seuils d'espace blanc, modèles spécifiques à la langue — mais ces heuristiques ne sont pas toujours exactes. Lorsqu'elles se trompent, les mots sont fusionnés ou divisés incorrectement, et chaque étape en aval hérite de l'erreur.
Les erreurs de détection sont le type d'échec d'OCR le plus insidieux car elles ne ressemblent pas à des erreurs. Un mot fusionné ressemble à un mot légitime (bien qu'inhabituel) pour un réviseur humain. Le moteur lit « rn » comme « m », et soudain « commercial » devient « commeicial » — une erreur qu'un correcteur orthographique détectera, mais seulement si la sortie passe par un tel correcteur.
Étape 3 — Reconnaissance des caractères : le cœur de l'OCR
C'est l'étape que les gens désignent réellement quand ils disent « OCR ». Le moteur prend chaque image de caractère isolé et détermine quelle lettre, quel chiffre ou quel symbole elle représente. Imaginez un enfant apprenant l'alphabet avec un jeu de cartes mémoire : vous lui montrez une image de la lettre A dans différentes polices — Arial A, Times New Roman A, A manuscrit — jusqu'à ce qu'il apprenne à la reconnaître quel que soit le style. Les moteurs d'OCR font la même chose, sauf qu'ils ont des millions de cartes mémoire et les traitent en quelques millisecondes.
Il existe deux approches fondamentales pour la reconnaissance des caractères :
Correspondance de motifs (OCR par modèle) — Le moteur conserve une base de données d'images de caractères (glyphes) dans des polices et tailles connues. Lorsqu'il rencontre un nouveau caractère, il compare le motif de pixels à chaque glyphe stocké et sélectionne la correspondance la plus proche. Cette approche a été la norme pendant des décennies et alimente des moteurs comme Tesseract, le moteur d'OCR open source développé à l'origine chez HP Labs en 1974 et désormais maintenu par Google. La correspondance de motifs fonctionne bien lorsque le document utilise une police que le moteur a déjà vue. Elle échoue lorsque la police est inhabituelle, que le texte est manuscrit ou que la qualité de l'image se dégrade — car l'entrée ne ressemble plus à aucun modèle stocké.
Extraction de caractéristiques (OCR intelligent) — Au lieu de comparer des motifs de pixels entiers, le moteur décompose chaque caractère en ses caractéristiques constitutives : lignes, courbes, boucles, intersections, points d'extrémité et angles. La lettre « A » a deux lignes diagonales qui se rejoignent en un point et une barre transversale horizontale. La lettre « O » a une seule boucle fermée. En identifiant ces caractéristiques indépendamment de la police ou de la taille, le moteur peut reconnaître des caractères qu'il n'a jamais vus auparavant. La plupart des moteurs d'OCR modernes utilisent cette approche, souvent améliorée par des réseaux neuronaux entraînés sur des ensembles de données comme EMNIST (Extended MNIST) — une collection de 814 255 images de caractères étiquetées couvrant les chiffres et les lettres majuscules et minuscules.
La limitation critique des deux approches est la même : elles identifient des formes, pas du sens. Le moteur peut vous dire avec 99 % de confiance qu'un groupe de pixels est le caractère « 5 » — mais il ne peut pas vous dire si ce « 5 » est une quantité, un prix, une date, un numéro de chambre ou un code de modèle. Il lit les caractères comme des symboles isolés, et non comme des parties d'un document cohérent. C'est pourquoi un moteur d'OCR traditionnel peut atteindre 99 % de précision au niveau des caractères sur une facture propre et produire néanmoins un résultat où vous ne trouvez pas le total de la facture — chaque caractère est correct, mais aucun n'est étiqueté.
Pour une comparaison détaillée de la façon dont cette étape diffère entre l'OCR traditionnel et les approches modernes basées sur l'IA, y compris les références de précision selon les types de documents, consultez notre analyse de comment l'OCR par IA se compare à l'OCR classique.
Étape 4 — Post-traitement : rendre la sortie lisible
Le résultat brut de l'étape de reconnaissance des caractères est une chaîne de caractères devinés — certains corrects, d'autres non, tous sans contexte. Le post-traitement est l'étape où le moteur tente de corriger ses propres erreurs. Considérez-le comme un correcteur automatique très agressif — qui sait faire la différence entre « sa », « ça » et « çà » selon le contexte environnant, et pas seulement par recherche dans un dictionnaire.
Les techniques de post-traitement les plus courantes incluent :
Correction par dictionnaire
Le moteur vérifie chaque mot reconnu dans un dictionnaire de la langue. Si « recu » apparaît, il est corrigé en « reçu ». Si le moteur hésite entre « O » et « 0 » dans le mot « m0dele », le dictionnaire confirme qu'il doit s'agir de « modele ».
Désambiguïsation contextuelle
Lorsqu'un caractère est ambigu — comme le chiffre « 1 » par rapport à la lettre minuscule « l » — le moteur examine les caractères environnants pour décider. « C1ient » sera corrigé en « Client » (car « C1ient » n'est pas un mot), tandis que « Page 1 » conserve le chiffre (car « Page l » n'aurait aucun sens).
Score de confiance
Chaque caractère reconnu reçoit un score de confiance. Les zones à faible confiance peuvent être signalées pour révision humaine, retraitées avec des paramètres de reconnaissance différents, ou soumises à un second passage de reconnaissance utilisant un algorithme différent.
Reconstruction de la mise en forme
Le moteur réassemble le texte reconnu dans la mise en page originale du document — en préservant les sauts de ligne, l'espacement des paragraphes, l'alignement des tableaux et l'ordre de lecture. C'est l'étape qui produit un PDF consultable ressemblant à la page numérisée d'origine.
Malgré toute cette intelligence, le post-traitement a une limite fondamentale : il peut corriger les fautes d'orthographe, mais il ne peut pas ajouter de sens sémantique. La sortie 1 234,56 € est désormais reconnue comme un montant monétaire valide — mais le moteur ne sait toujours pas s'il s'agit du total de la facture, d'un sous-total d'article, du montant de la taxe ou d'un numéro de référence. Le post-traitement rend le texte lisible, pas exploitable en tant que donnée.
La différence qui change tout — OCR traditionnel vs extraction par IA
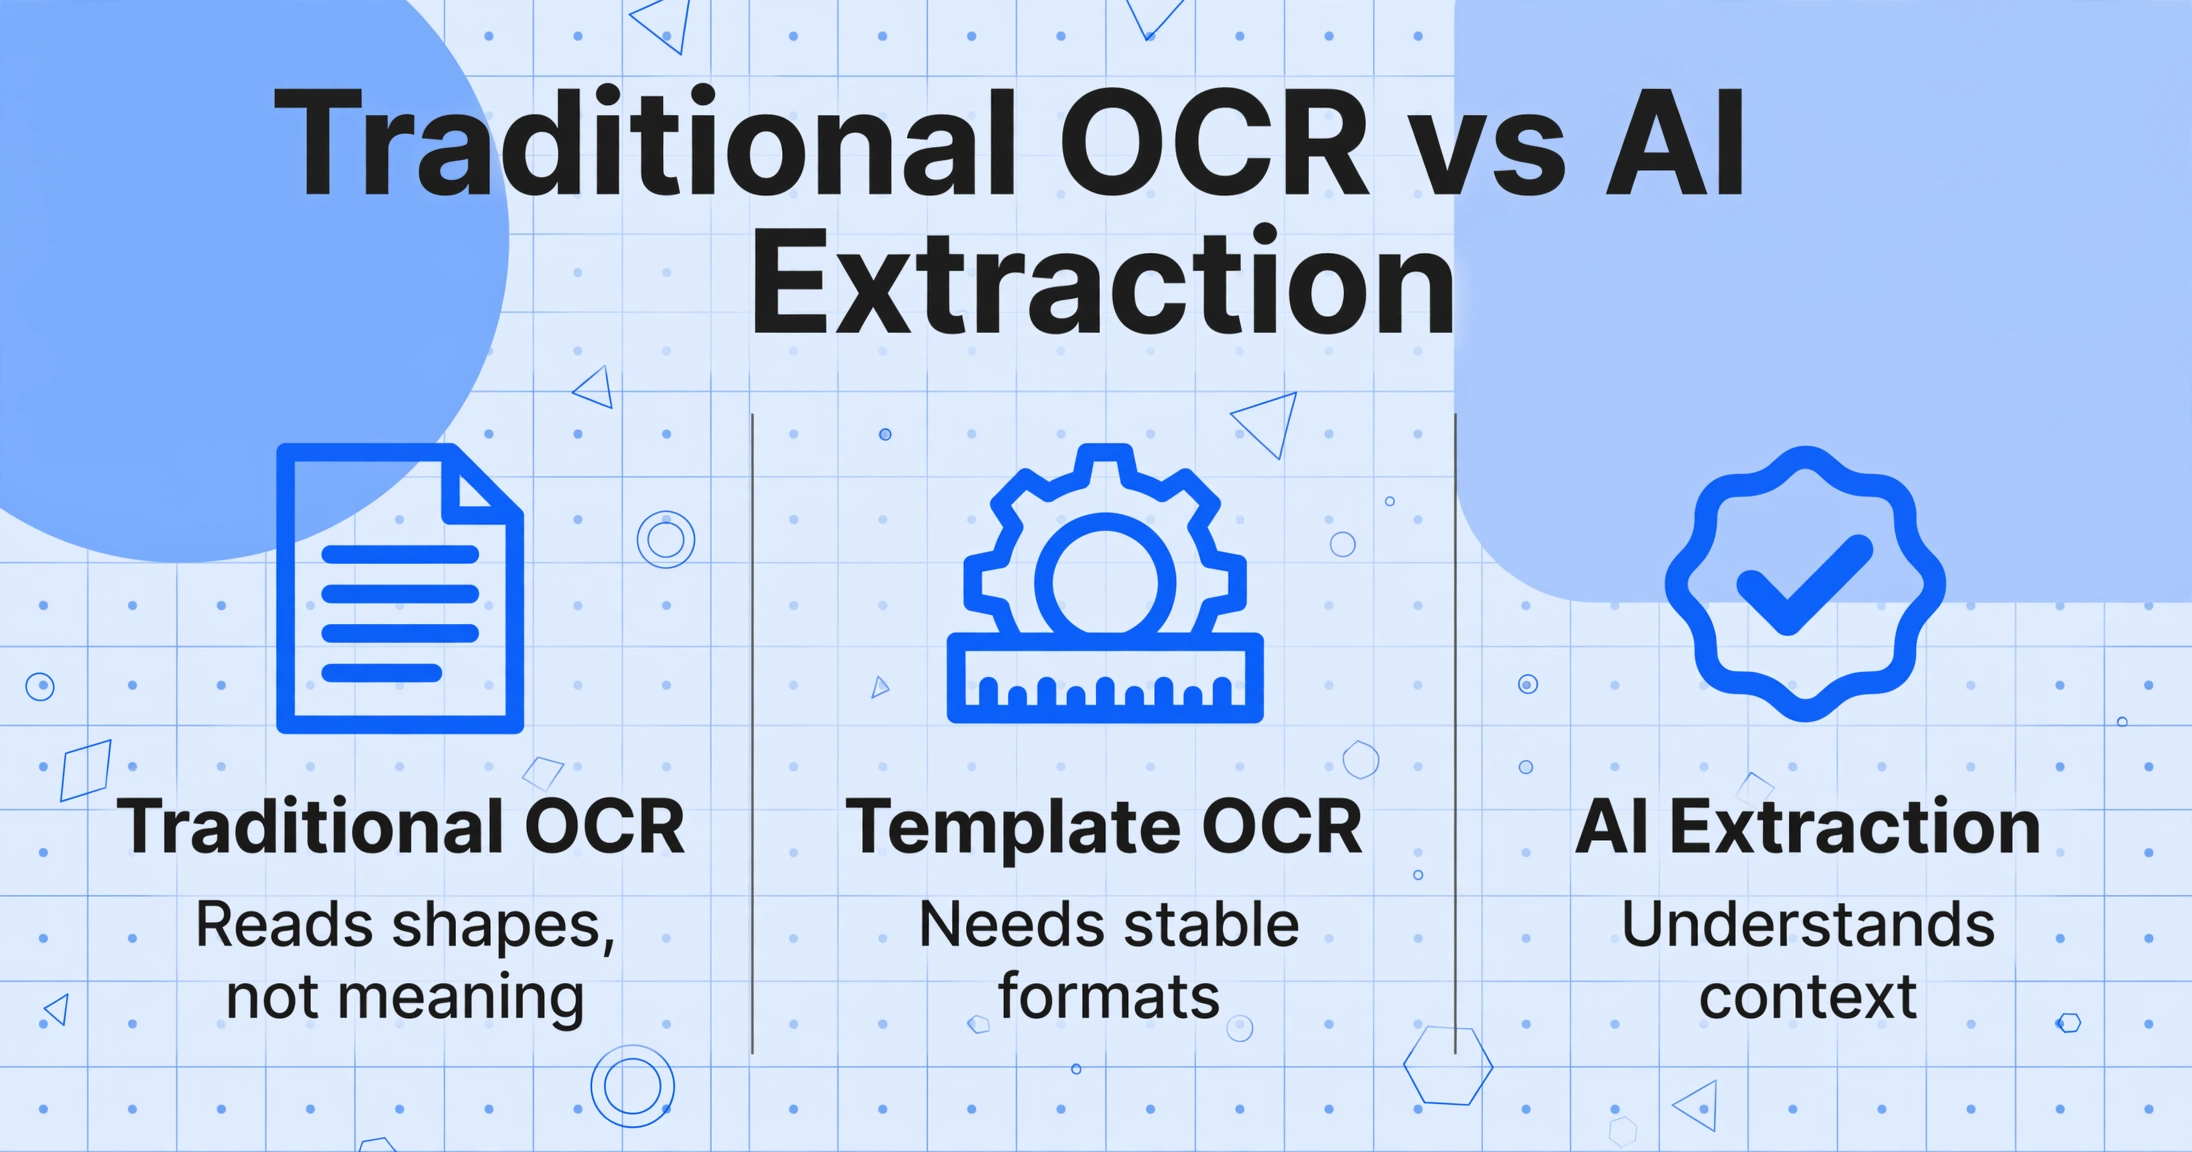
Le processus en quatre étapes décrit ci-dessus est l'approche OCR traditionnelle — et elle n'a pas fondamentalement changé depuis les années 1990. L'extraction moderne basée sur l'IA fonctionne différemment à chaque étape.
Comprendre le contraste aide à clarifier pourquoi l'OCR traditionnel est le bon outil pour certaines tâches (PDF consultables, archives textuelles) mais insuffisant lorsque vous avez besoin de données structurées (feuilles de calcul, bases de données, systèmes comptables). Le tableau ci-dessous montre comment chaque étape du processus diffère entre l'ancienne approche et un outil d'extraction par IA moderne comme ImageToTable.ai.
| Étape du processus | OCR traditionnel | Extraction par IA (modèle de vision) |
|---|---|---|
| Prétraitement | Critique — un nettoyage insuffisant garantit un échec de reconnaissance. Un prétraitement algorithmique lourd (binarisation, redressement, suppression du bruit) est obligatoire. | Moins critique — le modèle de vision peut lire à travers un bruit modéré, un faible contraste et des angles inclinés. Un nettoyage de base aide toujours, mais n'est pas un prérequis strict. |
| Détection du texte | Heuristiques basées sur des règles pour la segmentation des lignes, mots et caractères. Échoue sur les mises en page complexes, les documents multi-colonnes et le contenu mixte (texte + tableaux + images). | Compréhension holistique de la page — le modèle identifie les en-têtes, tableaux, pieds de page et libellés de champs par le contexte visuel, sans détecter d'abord les limites des caractères. |
| Reconnaissance des caractères | Correspondance de motifs ou extraction de caractéristiques par rapport à une base de caractères fixe. Chaque caractère est identifié isolément. | Le modèle lit des mots entiers, des phrases et des valeurs dans leur contexte visuel. Il reconnaît « INV-2026-001 » comme un numéro de facture grâce à sa position et son environnement, et non parce qu'il a correspondu à un modèle de glyphe. |
| Post-traitement | Correction par dictionnaire + reconstruction du format. Le résultat est un document texte brut ou formaté, sans libellés de champs ni structure de données. | Mappage sémantique des champs — le modèle génère chaque valeur associée à son nom de champ (par ex., « Numéro de facture : INV-2026-001 »). Aucun étiquetage manuel ni restructuration nécessaire. |
| Résultat final | Un fichier texte ou un PDF consultable. Chaque caractère est présent — mais vous devez encore lire, copier et coller chaque champ dans la bonne colonne de votre feuille de calcul. | Un tableau structuré ou un objet JSON. Les valeurs sont déjà étiquetées, organisées et prêtes pour votre feuille de calcul ou votre système comptable. Aucune étape de copier-coller requise. |
La différence fondamentale est que l'OCR traditionnel convertit les pixels en caractères. L'extraction par IA convertit les pixels en sens. L'un vous donne un document consultable. L'autre vous donne des données exploitables. Pour une analyse complète de la catégorie de l'extraction par IA — comment elle fonctionne, quand elle est pertinente et comment elle se compare aux autres approches — consultez notre article de référence sur ce qu'est l'extraction de documents par IA.
Et si vous voulez comprendre exactement comment la version IA gère l'étape de lecture — avec des modèles vision-langage qui traitent la page entière d'un coup au lieu de caractère par caractère — notre article qu'est-ce que l'OCR par IA couvre la technologie en profondeur.
Questions fréquentes
L'OCR peut-il lire l'écriture manuscrite ?
L'OCR traditionnel a du mal avec l'écriture manuscrite — la précision se situe généralement entre 50 % et 70 % pour l'écriture en caractères d'imprimerie et en dessous de 50 % pour l'écriture cursive. La raison est d'ordre architectural : l'étape de reconnaissance des caractères identifie les lettres en comparant les formes à une base de glyphes connus, et l'écriture manuscrite introduit bien plus de variations qu'une bibliothèque de modèles ne peut en couvrir. L'OCR moderne basé sur l'IA fonctionne nettement mieux (75–93 % pour l'écriture manuscrite en caractères d'imprimerie) car il lit les mots en contexte plutôt que de comparer des formes de caractères individuelles. Cependant, la cursive entièrement libre reste difficile pour tous les systèmes.
Quelle est la précision de l'OCR pour le texte imprimé ?
Sur des documents propres et dactylographiés numérisés à 300 DPI, les moteurs OCR modernes atteignent une précision de caractères de 95 à 99 %. Ce chiffre chute sur les numérisations dégradées, les polices inhabituelles, les originaux à faible contraste ou les documents à mise en page complexe. Il est important de noter que la précision des caractères n'est pas la précision des champs — un taux de précision de caractères de 99 % peut encore produire un résultat où 15 à 40 % des champs de données individuels qui vous intéressent contiennent des erreurs, car les erreurs de caractères qui se produisent ont tendance à se concentrer dans les champs numériques (où un seul chiffre erroné change toute la valeur) et aux limites des champs (où les caractères des champs adjacents sont fusionnés).
L'OCR est-il la même chose que l'extraction de documents ?
Non. L'OCR convertit les images de texte en caractères lisibles par machine — il numérise le texte. L'extraction de documents va plus loin : elle identifie quels caractères appartiennent à quel champ de données (numéro de facture, date, total, nom du fournisseur) et les produit sous forme de données structurées dans des colonnes étiquetées. L'OCR répond à la question « quels caractères se trouvent sur cette page ? » L'extraction de documents répond à la question « quelles données ce document contient-il ? » La différence entre ces deux questions est la différence entre un fichier texte que vous devez encore trier et une feuille de calcul que vous pouvez utiliser immédiatement.
L'OCR fonctionne-t-il sur les PDF, ou uniquement sur les images ?
L'OCR fonctionne sur toute entrée basée sur une image : les PDF numérisés (qui sont essentiellement des images dans un conteneur PDF), les PDF natifs numériques (lorsqu'ils sont traités comme des images), les JPG, les PNG et les TIFF. La distinction cruciale est entre les PDF numérisés (images de pages sans couche de texte sous-jacente) et les PDF natifs (qui contiennent du texte sélectionnable). Les PDF numérisés doivent passer par l'OCR pour devenir consultables. Les PDF natifs contiennent déjà du texte et n'ont pas besoin d'OCR — mais ils peuvent encore nécessiter une extraction si vous souhaitez extraire des champs de données spécifiques dans une feuille de calcul.
Quelle est la différence entre l'OCR et l'OMR ?
L'OCR (reconnaissance optique de caractères) lit le texte — lettres, chiffres, ponctuation — à partir d'images. L'OMR (reconnaissance optique de marques) lit les marques sur une page — cases à cocher remplies dans un sondage, cases à cocher sur un formulaire, coches sur un bulletin de vote. L'OMR est plus simple car il ne doit que détecter si une marque est présente ou absente à un emplacement prédéfini, et non identifier quel caractère la marque représente. De nombreux outils modernes de traitement de documents combinent les deux : l'OCR pour les champs de texte, l'OMR pour les cases à cocher et les marques de sélection.
Comprendre comment fonctionne l'OCR est la première étape pour savoir quand il suffit — et quand vous avez besoin de quelque chose de plus. Le pipeline en quatre étapes a bien servi la numérisation de documents pendant des décennies, mais l'écart entre « texte lisible » et « données exploitables » est un écart que l'OCR traditionnel n'a jamais été conçu pour combler. Découvrez comment l'extraction de documents par IA comble cet écart en lisant le sens, et pas seulement les caractères.