Ce qu'est le Zonal OCR et les
quatre formes qui le mettent en échec
Le Zonal OCR a rendu l'automatisation documentaire possible des décennies avant que quiconque s'attende à ce qu'une machine comprenne une page. Il y est parvenu en refusant de comprendre quoi que ce soit. Vous tracez un rectangle autour du total de la facture, le logiciel ne lit que ce rectangle, et la valeur atterrit dans un champ nommé.
Ce compromis a acheté de la vitesse, du déterminisme et un type de fragilité très particulier. Ce qui suit couvre ce qu'est une zone au niveau des pixels et des appels OCR, les quatre formes de documents où les zones se brisent, et la question qui décide si vous devez les conserver : qui contrôle la mise en page.
Points clés
- Le Zonal OCR ne lit que les cases que vous tracez sur un formulaire, de sorte que son pire échec est un nombre erroné bien formé plutôt qu'une erreur.
- Deux degrés de rotation du scan suffisent pour placer le sous-total, 1 065,00, dans le champ total sans qu'aucun validateur ne s'y oppose.
- Faites pivoter une page de deux degrés et relancez-la pour voir si votre outil détecte le décalage ou le publie silencieusement.
Une zone est un rectangle de pixels, et le modèle est le programme
Une zone est un rectangle de coordonnées sur une page, associé à un nom de champ. Un modèle est un ensemble de ces rectangles, appliqué à chaque document censé être identique.
La technique circule sous plusieurs noms. Zone OCR, Zonal OCR, OCR par modèle et OCR au niveau du champ désignent tous la même technique, si bien que les éditeurs emploient ces termes indifféremment. Si la configuration d'un outil commence par « importez un exemple et tracez des rectangles », il s'agit de Zonal OCR, quel que soit le nom inscrit sur la brochure.
La différence entre le Zonal OCR et l'OCR pleine page réside dans le résultat produit. L'OCR pleine page convertit toute la page en texte et conserve l'ordre de lecture, ce qu'il vous faut pour la recherche, l'archivage ou un PDF interrogeable. Le Zonal OCR renvoie des valeurs nommées, ce qu'il vous faut pour une colonne de tableur. Ni l'un ni l'autre n'interprète ce qu'il lit. L'un produit un document, l'autre produit un enregistrement.
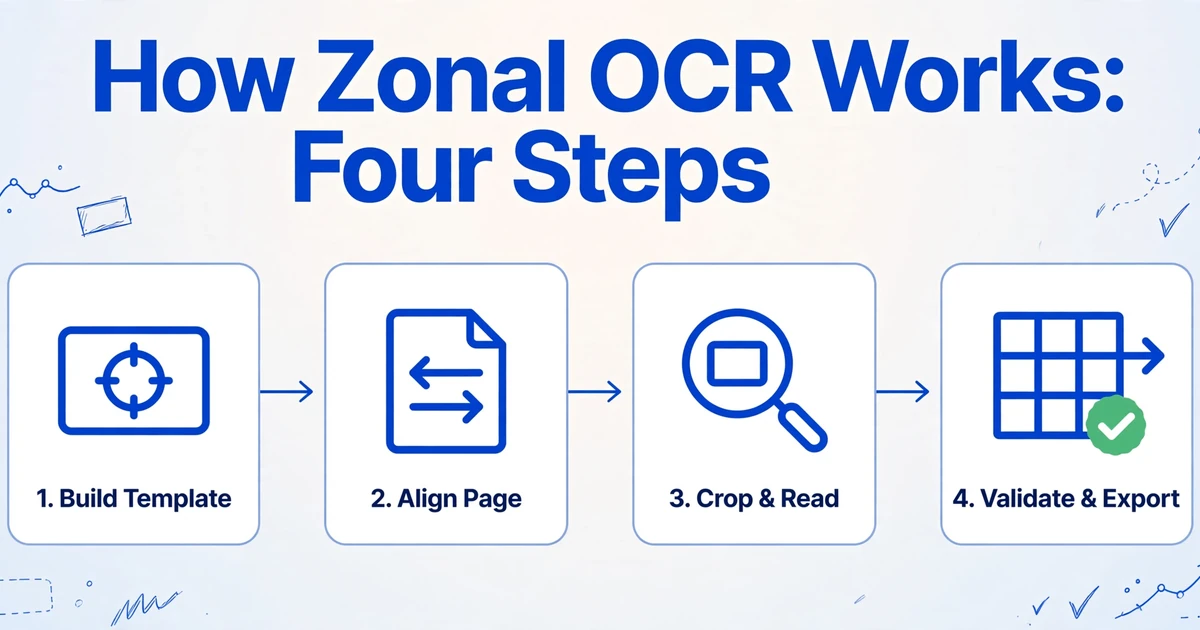
Le travail se déroule en quatre étapes, et c'est la troisième qui révèle l'architecture.
Créer le modèle
Numérisez un document représentatif, tracez un rectangle autour de chaque champ et donnez-lui un nom. L'outil enregistre les coordonnées, souvent relatives à la largeur et à la hauteur de la page pour qu'un redimensionnement ne les invalide pas.
Aligner la page entrante
Redressement, remise à l'échelle et parfois correspondance avec un repère d'alignement ou un mot d'ancrage, afin que les coordonnées enregistrées se posent sur le même contenu que dans l'exemple.
Découper et lire
Chaque zone est extraite de l'image de la page et transmise au moteur OCR comme une petite image à part. Le moteur ne voit jamais le reste de la page.
Valider et exporter
Un motif ou un type de données vérifie la forme de chaque valeur, puis les résultats étiquetés partent vers un tableur, une base de données ou un ERP.
La troisième étape explique une défaillance qui ressemble à une erreur de configuration sans en être une. La documentation de Tesseract indique que le moteur attend par défaut une page de texte, et que l'OCR d'une petite région nécessite un mode de segmentation différent, par exemple en traitant l'entrée comme une seule ligne. Une zone n'est pas un pointeur vers une page. C'est une nouvelle image, et il faut indiquer au moteur quel type d'image il examine.
Le gain de toutes ces contraintes, c'est le coût. Lire cinq bandes étroites coûte une fraction de la lecture d'une page entière, et sur un moteur local, le coût marginal par page est proche de zéro. C'est cette économie, plus que la précision, qui explique pourquoi le Zonal OCR tourne encore dans les logiciels de numérisation, les suites de capture et une longue traîne de scripts internes.
Là où les zones restent imbattables
Le Zonal OCR reste le bon choix lorsque la mise en page est sous votre contrôle. Ce n'est pas de la nostalgie. C'est l'option déterministe la moins chère disponible pour une page qui ne change pas.
Le créneau est étroit et reconnaissable : les formulaires internes que vous concevez et imprimez (notes de frais, listes de contrôle d'inspection, dossiers d'intégration), les formulaires gouvernementaux standardisés dont une seule version officielle circule, la production d'un seul expéditeur en volume (les relevés d'une banque, les rapports d'un laboratoire), les documents d'identité et les feuilles de test. Dans une zone, les mêmes moteurs peuvent aussi exécuter l'ICR pour les caractères manuscrits imprimés et l'OMR pour les cases à cocher, si bien qu'un formulaire interne rempli à la main est un cas d'usage légitime.
Le modèle de coût est la partie que la plupart des comparaisons oublient. Un moteur de zones local traite une page en une seconde environ, voire moins, et ne facture rien à la page. Un modèle de vision prend plusieurs secondes par page et facture l'inférence. Sur cinquante mille pages d'un même formulaire inchangé, cet écart décide du projet avant même que la précision n'entre en jeu.
La technique est aussi moins rigide que sa réputation. Les outils de production ajoutent des ancres (trouver les mots « Invoice No. » et lire à leur droite), des motifs (chercher dans une zone plus large quelque chose qui ressemble à un numéro de facture) et des zones dynamiques qui s'étendent vers le bas de la page jusqu'à un mot d'arrêt. Chaque ajout apporte de la tolérance. Aucun ne supprime la configuration par mise en page, qui est la partie qui coûte de l'argent.
Si un formulaire, imprimé par un système, dans une version, se lit déjà correctement, ajouter un modèle de vision n'apporte rien que vous n'ayez déjà.
Les quatre formes de document où les zones échouent
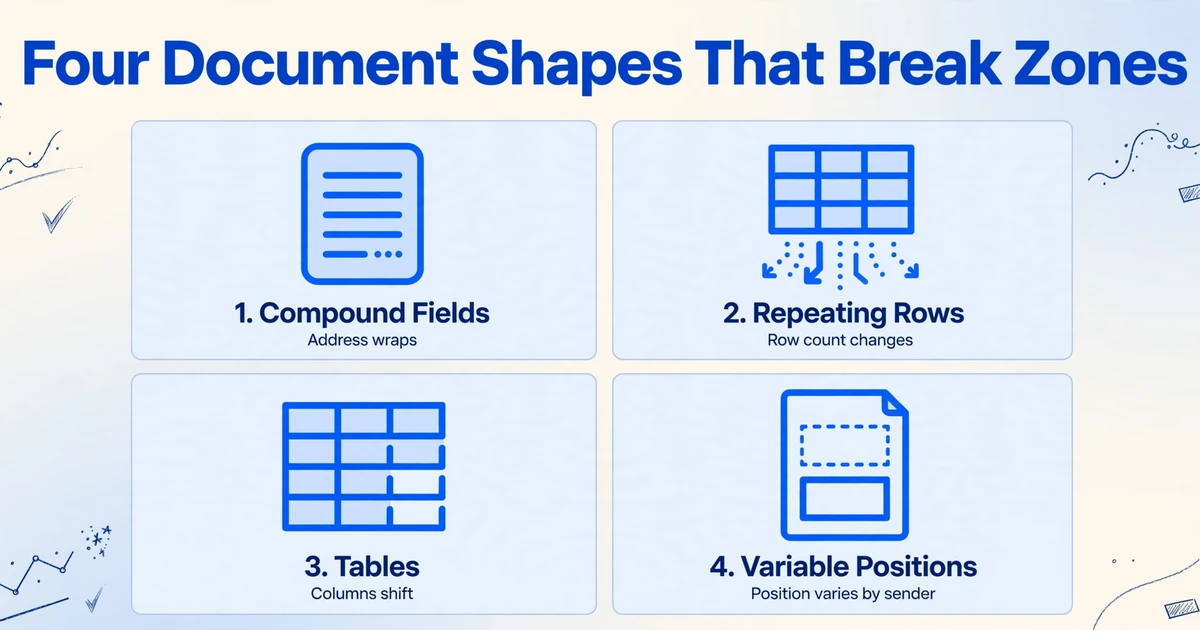
Les zones échouent sur quatre formes de document, et chacune échoue pour une raison mécanique différente. Savoir quelle forme vous avez sous les yeux est plus utile qu'un avertissement générique sur les mises en page qui changent.
1. Champs composés
Un champ composé contient une valeur qui n'est pas une seule ligne dans un rectangle fixe. Une adresse de facturation occupe deux à cinq lignes selon le client. Un montant apparaît une fois en chiffres et une fois en lettres. Un nom de fournisseur passe à la ligne. « Invoice No. » et « Date » partagent une même bande horizontale avec un espace qui varie selon la longueur du numéro.
Une zone doit être assez haute pour l'adresse la plus longue et assez étroite pour ne pas capter le numéro de téléphone imprimé en dessous. Ces deux exigences se contredisent, et le modèle ne peut en satisfaire qu'une. Le résultat est une adresse tronquée ou un numéro de téléphone classé comme ville.
2. Lignes répétées
Chaque ligne d'article que vous ajoutez repousse tout ce qui se trouve en dessous vers le bas de la page. Un modèle conçu sur une facture à six lignes place le total à une hauteur fixe. Envoyez au même fournisseur une facture à neuf lignes et la zone du total tombe sur une ligne d'article.
Une grille fixe encode un nombre de lignes que l'émetteur n'a jamais accepté. Les commandes longues ajoutent une seconde défaillance : le total passe en page deux, et un modèle défini pour la page une renvoie la dernière ligne d'article à la place.
3. Tableaux
Une zone par colonne suppose que les colonnes conservent leurs positions horizontales et que les lignes conservent leur hauteur. Ni l'un ni l'autre ne tient sur un vrai tableau de lignes d'articles. Une description passe sur une deuxième ligne, une quantité est alignée à droite dans une cellule de largeur variable, une ligne de totaux s'étend sur les colonnes, et une cellule fusionnée décale tout ce qui se trouve à sa droite.
La documentation de Tesseract note que le moteur a du mal avec les tableaux sans segmentation personnalisée ni analyse de mise en page. Un modèle zonal est un substitut construit à la main pour exactement cette analyse, et il doit être reconstruit chaque fois que le tableau change de forme.
4. Positions variables
Le même champ se trouve à des coordonnées différentes sur les documents de différents expéditeurs. Une ligne de remise, un détail de taxe ou une référence de bon de commande apparaît sur certaines factures et pas sur d'autres, et chaque bloc facultatif repousse vers le bas les champs situés en dessous. Un changement d'échelle du scanner décale tout d'un coup.
C'est la configuration qui transforme un modèle en deux cents. ABBYY, qui commercialise la capture zonale, indique dans sa propre entrée de glossaire que cette approche ne convient pas aux factures fournisseurs ni à aucun type de document dont la mise en page varie selon l'expéditeur. Quand l'éditeur de la technique lui-même trace cette limite, cela mérite d'être pris au sérieux.
Ce qu'une inclinaison de deux degrés fait à une zone
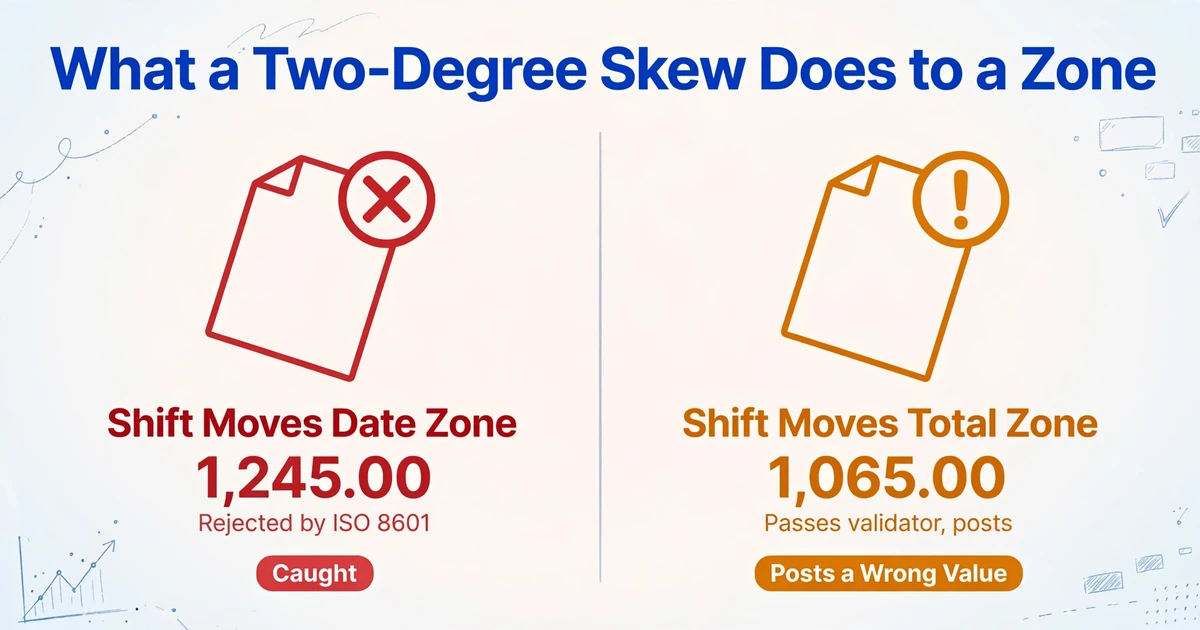
Une rotation de deux degrés suffit à faire sortir une valeur d'une zone étroite. La direction du décalage détermine si vous vous en apercevrez un jour.
Faire pivoter une page Letter de deux degrés déplace un point situé à quatre pouces du centre de la page d'environ 0,14 pouce. À 300 DPI, cela représente environ 42 pixels, soit près d'une ligne de texte en 10 points. Une zone tracée jusqu'au bord d'une valeur lit désormais sa voisine.
Si le décalage amène la zone de date sur le total, le champ reçoit quelque chose comme 1,245.00. Une règle de date fondée sur ISO 8601 la rejette, le document part dans une file d'exceptions, et quelqu'un corrige le scan. Pénible, visible, sans danger.
Si le décalage remonte la zone de total d'une ligne, le champ total reçoit le sous-total, 1,065.00. Rien dans cette valeur n'est mal formé. Elle passe le validateur de montant, elle est comptabilisée, et l'écart de $180 n'apparaît qu'à la réconciliation, des semaines plus tard. L'étape d'extraction a signalé un succès.
Les échecs que l'on corrige sont ceux qui déclenchent une erreur. Les échecs qui coûtent de l'argent sont ceux qui renvoient un nombre parfaitement bien formé mais faux.
Les tests utilisent des échantillons propres et bien alignés. La production inclut la page passée dans le scanner avec une légère inclinaison, et le validateur n'a aucun avis sur la question de savoir si le nombre qu'il vient d'accepter appartient bien au champ auquel il a été attribué.
Qui maintient les modèles, et qui trouve les lignes erronées
Le modèle a un propriétaire, et la personne qui trouve la ligne erronée est généralement quelqu'un d'autre. C'est dans cette séparation que réside le véritable coût opérationnel.
Les modèles sont généralement créés par celui qui a configuré l'outil : un analyste opérationnel, un membre du service informatique, parfois la personne qui a signé le contrat. La raison pour laquelle une zone a été tracée quelques pixels plus large que le texte, ou commence au-dessus du filet plutôt qu'en dessous, vit dans la mémoire de cette personne, pas dans l'outil. Quand elle change de poste, la bibliothèque de modèles devient de l'archéologie.
La ligne erronée est trouvée plus tard et ailleurs. Un commis AP rapproche un relevé fournisseur et ne parvient pas à faire correspondre un montant. Un contrôleur de gestion remarque un écart en fin de mois. Un fournisseur écrit pour demander pourquoi une facture n'est toujours pas payée. Dans chaque cas, l'erreur a été créée à l'extraction, découverte en aval, et retracée jusqu'à un changement de mise en page que personne n'a consigné.
L'intégration des nouveaux formats constitue l'autre moitié de la facture. Un praticien sur r/dataengineering a résumé la différence sans détour : « Nous sommes passés d'environ 4 heures pour créer un modèle pour une nouvelle mise en page fournisseur à 0 seconde. » Le même commentaire précise où ce temps est parti à la place : dans la validation des résultats plutôt que dans l'écriture de modèles. Les heures ne disparaissent pas. Elles se déplacent.
La couverture est binaire. Une mise en page est soit dans la bibliothèque, soit elle n'y est pas, et le périmètre de la bibliothèque bouge chaque fois qu'un expéditeur redessine un formulaire, change un logo ou ajoute un champ. Il n'existe pas d'état intermédiaire où l'outil traite 80 % d'une nouvelle mise en page et vous indique les 20 % qu'il a manqués.
Ce qui change quand l'extraction cesse de dépendre des coordonnées
L'extraction sémantique fait passer la question de « où se trouve la valeur » à « quelle est la valeur ». La page compte toujours. Ses coordonnées cessent d'être l'adresse.
ImageToTable.ai fonctionne via Custom Column Extraction : vous saisissez les noms de colonnes souhaités, tels que « Invoice Number », « Due Date » et « Total », et un modèle de vision lit la page entière et localise chaque valeur par ce qu'elle signifie. Les noms de colonnes que vous saisissez deviennent les en-têtes du tableau de sortie. C'est la même idée que extraire des champs spécifiques d'un document par nom plutôt que par emplacement, sans zones à tracer ni coordonnées stockées. C'est ce que signifie indépendant du format ici : la mise en page peut changer et l'extraction ne change pas.
La mise en page reste un indice. Un nombre placé sous un filet, à côté du mot « Total », dans le coin inférieur droit, a plus de chances d'être le total que le même nombre en en-tête. La différence est que cet indice est interprété au moment de l'extraction plutôt que figé dans un modèle des mois plus tôt. Rien ne devient obsolète, car rien n'a été mémorisé.
Les conséquences pratiques en découlent directement. La première facture d'un nouveau fournisseur ne nécessite aucune configuration. Un tableau de soixante lignes est lu en entier plutôt que tronqué aux six lignes qu'un modèle attendait. Un scan pivoté de deux degrés n'a aucune étape d'alignement susceptible d'échouer, car il n'y a pas de repère de coordonnées auquel s'aligner.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Ce que cette approche ne corrige pas mérite d'être dit tout aussi clairement. Lorsqu'un document contient deux candidats plausibles, un sous-total et un montant dû, le modèle doit tout de même choisir, et le nom de la colonne doit être assez précis pour trancher. Les erreurs arithmétiques imprimées dans la source sont copiées fidèlement. Une écriture manuscrite pâle limite encore ce que tout modèle peut lire. Et un modèle de vision peut se tromper avec assurance, c'est pourquoi l'écran de révision met en évidence la région d'où provient chaque cellule, afin qu'une valeur suspecte puisse être retracée jusqu'à la page en une seconde ou deux.
Les données de tableaux imprimées sont reconnues avec une précision allant jusqu'à 99 %, à raison d'environ 5 à 10 secondes par page. C'est assez rapide pour le travail par lots et ce n'est pas une raison pour sauter la révision des champs qui alimentent un grand livre. Les modes de défaillance diffèrent d'une manière qui compte : une zone décalée renvoie la même valeur erronée pour chaque document partageant la mise en page, tandis qu'un raté occasionnel du modèle est propre à un document et ne se répète pas au suivant.
Comment décider ce dont vos documents ont besoin
Comptez les mises en page, pas les documents, et demandez-vous qui les contrôle. Dix mille factures provenant de trois fournisseurs constituent un problème que les zones résolvent bien. Deux cents factures provenant de deux cents fournisseurs, non.
Une règle applicable : si les mises en page sont les vôtres, stables et peu nombreuses, les zones sont moins chères, plus rapides et plus exactes. Si les mises en page appartiennent à d'autres, arrivent dans de nouvelles versions sans préavis ou atteignent une douzaine de formats distincts ou plus, le coût de maintenance des zones dépasse le coût par page d'un modèle. Le juste milieu délicat, quelques centaines de pages par mois provenant de huit ou dix expéditeurs, se résume généralement au temps dont votre personnel dispose pour réparer les modèles.
Trois vérifications tranchent plus vite qu'une démo fournisseur.
- Testez le champ qui bouge. Prenez le total, le montant de la taxe et la date d'échéance sur vingt documents que vous n'avez jamais modélisés. Comptez les échecs. Ne faites pas de moyenne de précision sur l'ensemble des champs.
- Faites pivoter une page de deux degrés et relancez-la. Observez si l'outil renvoie une erreur ou un chiffre faux mais plausible. C'est le second comportement qui atteint vos livres.
- Demandez qui remarquerait un total erroné, et quand. Si la réponse est « au rapprochement le mois prochain », ajoutez une étape de révision quel que soit le moteur choisi.
| Dimension | Zonal OCR | Extraction sémantique |
|---|---|---|
| Configuration par mise en page | Dessinez des zones sur un échantillon, nommez chaque champ | Saisissez les noms de colonnes souhaités |
| Premier document d'un nouvel expéditeur | Attend un modèle | Traité comme n'importe quel autre |
| Changement de mise en page | Réparation du modèle, souvent découverte tardivement | Aucun modèle à réparer |
| Tableaux de lignes d'article | Grille de lignes fixe ; les tableaux longs débordent | Lecture intégrale, quel que soit le nombre de lignes |
| Scan pivoté ou redimensionné | Réaligner, sinon lecture des mauvais pixels | Aucune étape d'alignement |
| Coût par page | Proche de zéro sur un moteur local | Inférence du modèle, quelques secondes par page |
| Échec typique | Une valeur d'apparence valide issue du mauvais endroit, répétée sur chaque page ayant cette mise en page | Une erreur occasionnelle par document, détectée en révision |
| Idéal pour | Formulaires fixes que vous imprimez et contrôlez | Documents provenant de nombreux expéditeurs ou versions changeantes |
Si vous comparez des outils plutôt que des techniques, la différence apparaît dans la façon dont chacun gère un fournisseur qu'il n'a jamais vu. Un produit basé sur des modèles comme Docparser a besoin d'une règle d'analyse pour la mise en page avant de pouvoir lire quoi que ce soit, tandis qu'un outil sémantique demande des noms de colonnes et démarre dès le premier document. Des comparaisons plus larges des logiciels OCR et de leurs tarifs figurent dans notre comparatif des logiciels OCR, et si ce dont vous avez réellement besoin est un logiciel qui transforme les pages scannées en lignes de tableau plutôt qu'en texte, la page logiciel OCR pour la saisie de données couvre ce parcours.
FAQ
Qu'est-ce que l'OCR zonal en termes simples ?
C'est de l'OCR limité aux zones que vous dessinez sur une page exemple. Chaque zone est liée à un nom de champ, de sorte que le résultat est un ensemble de valeurs étiquetées plutôt qu'un bloc de texte. Le logiciel ne lit que ce qui se trouve à l'intérieur des zones.
L'OCR zonal est-il identique à l'OCR par modèle ?
Oui. OCR par zone, OCR zonal, OCR par modèle et OCR au niveau du champ désignent la même technique. L'indice révélateur est la configuration : si cela commence par le téléversement d'un exemple et le tracé de rectangles, il s'agit d'OCR zonal.
Quelle est la différence entre l'OCR zonal et l'OCR plein texte ?
L'OCR plein texte lit chaque caractère de la page et les restitue dans l'ordre de lecture, généralement sous forme de couche de texte interrogeable. L'OCR zonal ne lit que les régions que vous avez définies et renvoie des champs nommés. L'OCR plein texte est conçu pour la recherche et l'archivage ; l'OCR zonal est conçu pour la capture de données. Ni l'un ni l'autre ne comprend le sens du texte, et c'est là que commencent les limites de précision de l'OCR traditionnel.
Quelles sont les principales limites de l'OCR zonal ?
Positions fixes, tailles de champs fixes, nombre de lignes variable, inclinaison du scan et un modèle par mise en page. La limite la plus coûteuse est qu'une défaillance renvoie souvent une valeur d'apparence valide provenant du mauvais endroit plutôt qu'une erreur, ce qui ne se découvre qu'en aval.
L'OCR zonal fonctionne-t-il avec l'écriture manuscrite ?
À l'intérieur d'une zone, l'ICR peut lire des caractères manuscrits imprimés dans des champs contraints tels qu'une case de date ou une grille numérique. La cursive et l'écriture manuscrite non contrainte restent peu fiables, et une zone ne peut rien faire pour une valeur dont la longueur ou la position change d'un formulaire à l'autre.
Faut-il remplacer entièrement l'OCR zonal ?
Non. Conservez-le lorsque la mise en page vous appartient, que le volume est élevé et que le formulaire ne change pas. Remplacez-le lorsque les mises en page appartiennent à des expéditeurs que vous ne contrôlez pas. La question décisive est la propriété de la page, non l'ancienneté de la technique.
Une zone est une promesse que la page aura le même aspect la prochaine fois. Que cette promesse soit tenue est une propriété de vos documents, non de votre logiciel.
Si vous imprimez le formulaire, la promesse vous appartient, et une zone est un bon moyen de la tenir. Si quelqu'un d'autre l'imprime, la promesse n'a jamais été la vôtre. C'est le cas où le fait de saisir les noms de colonnes souhaités, et de laisser le modèle les trouver où qu'elles se trouvent, remplace une file de maintenance par un tableur.
Apportez la mise en page qui ne cesse de casser. Voyez ce qui en ressort.