Qu'est-ce que l'OCR de reçus ?
Extraire les reçus de magasin vers des feuilles de calcul
L'OCR de reçus est le processus automatisé d'extraction des informations clés — nom du magasin, date, articles achetés, prix, taxes et total — à partir d'une photo ou d'un scan de reçu papier, puis de leur conversion en données structurées dans une feuille de calcul. Au lieu de saisir chaque champ manuellement, le logiciel lit l'image du reçu, comprend quel texte est le nom du marchand et quel nombre est le total, puis remplit des colonnes dans un fichier Excel ou une feuille Google Sheets.
Points clés à retenir
- La photo de votre reçu n'est pas un enregistrement permanent — le papier thermique s'estompe chimiquement en quelques semaines, vous ne pouvez pas l'arrêter, et l'IRS (service des impôts des États-Unis) s'attend à ce que vous conserviez des reçus lisibles pendant 3 ans.
- La capture de reçus intégrée à QuickBooks et Xero extrait 3 champs — fournisseur, date, total — mais ignore chaque ligne d'article, ce qui vous empêche de répartir un seul trajet dans un grand magasin entre catégories déductibles et non déductibles.
- L'OCR de reçus sans modèle lit par sens sémantique plutôt que par positions fixes — téléchargez un reçu de n'importe quel magasin qu'il n'a jamais vu, définissez les colonnes souhaitées et obtenez des données structurées au niveau des articles en une seule passe.
Ce qu'est vraiment la ROC de tickets de caisse
La ROC de tickets de caisse ne consiste pas à prendre une photo d'un ticket et à l'enregistrer en PDF — cela donne une image. Ce n'est pas non plus la même chose que d'exécuter un moteur de ROC générique sur l'image d'un ticket — cela produit un mur de texte indifférencié. La ROC de tickets de caisse vous donne des données structurées : le nom du magasin dans une colonne de tableur, la date dans une autre, chaque article dans sa propre ligne, la taxe et le total dans des cellules que vous pouvez additionner et filtrer.
Cette distinction est importante car les tickets de caisse posent un problème d'extraction plus difficile que la plupart des gens ne le pensent. Un ticket de restaurant liste les articles verticalement avec les prix alignés à droite. Un ticket de vente au détail utilise des codes produits abrégés dans des colonnes denses. Et presque tous sont imprimés sur du papier thermique, qui s'efface en quelques semaines à cause du revêtement chimique qui produit l'image — vous ne pouvez pas l'arrêter, et vous ne pouvez pas récupérer un ticket vierge.
Les champs généralement extraits se répartissent en deux catégories :
En-tête de transaction
- Nom du commerçant / magasin
- Date et heure de la transaction
- Numéro de ticket / transaction
- Mode de paiement
- Sous-total, Taxe, Pourboire, Total
Lignes d'articles (par produit)
- Description de l'article ou SKU
- Quantité
- Prix unitaire
- Total de la ligne
- Code de taxe (le cas échéant)
Le détail des lignes d'articles est ce qui distingue la ROC de tickets de caisse des outils plus simples. Une extraction uniquement de l'en-tête — « ce ticket était de 47,83 $ chez Walmart le 12 juin » — est utile pour la saisie des dépenses. Mais si vous avez besoin de savoir quels articles sont des fournitures de bureau déductibles et lesquels sont des courses personnelles, vous avez besoin des lignes d'articles — et leurs mises en page varient encore plus que les en-têtes, allant de listes à une seule colonne à des grilles multi-colonnes avec des sous-totaux entre les sections.
OCR de reçus vs applications de numérisation de dépenses vs saisie manuelle
| Saisie manuelle | Application de numérisation de dépenses | Extraction par OCR de reçus | |
|---|---|---|---|
| Ce que ça fait | Vous saisissez chaque champ dans un tableur | Capture une photo, extrait 3 à 4 champs d'en-tête | Extrait l'en-tête et les lignes d'articles en colonnes structurées |
| Temps par reçu | 2 à 5 minutes | ~30 secondes | 5 à 10 secondes (par lots) |
| Détail des lignes d'articles | Disponible si vous le saisissez | Rarement extrait | Extrait automatiquement, une ligne par article |
| Gestion des formats | L'humain s'adapte à tout format | Mises en page courantes uniquement | Indépendant du format — lit par le sens |
| Documentation IRS | Registre manuel, sujet aux erreurs | Photo stockée, 3 champs capturés | Registre structuré + image originale conservée |
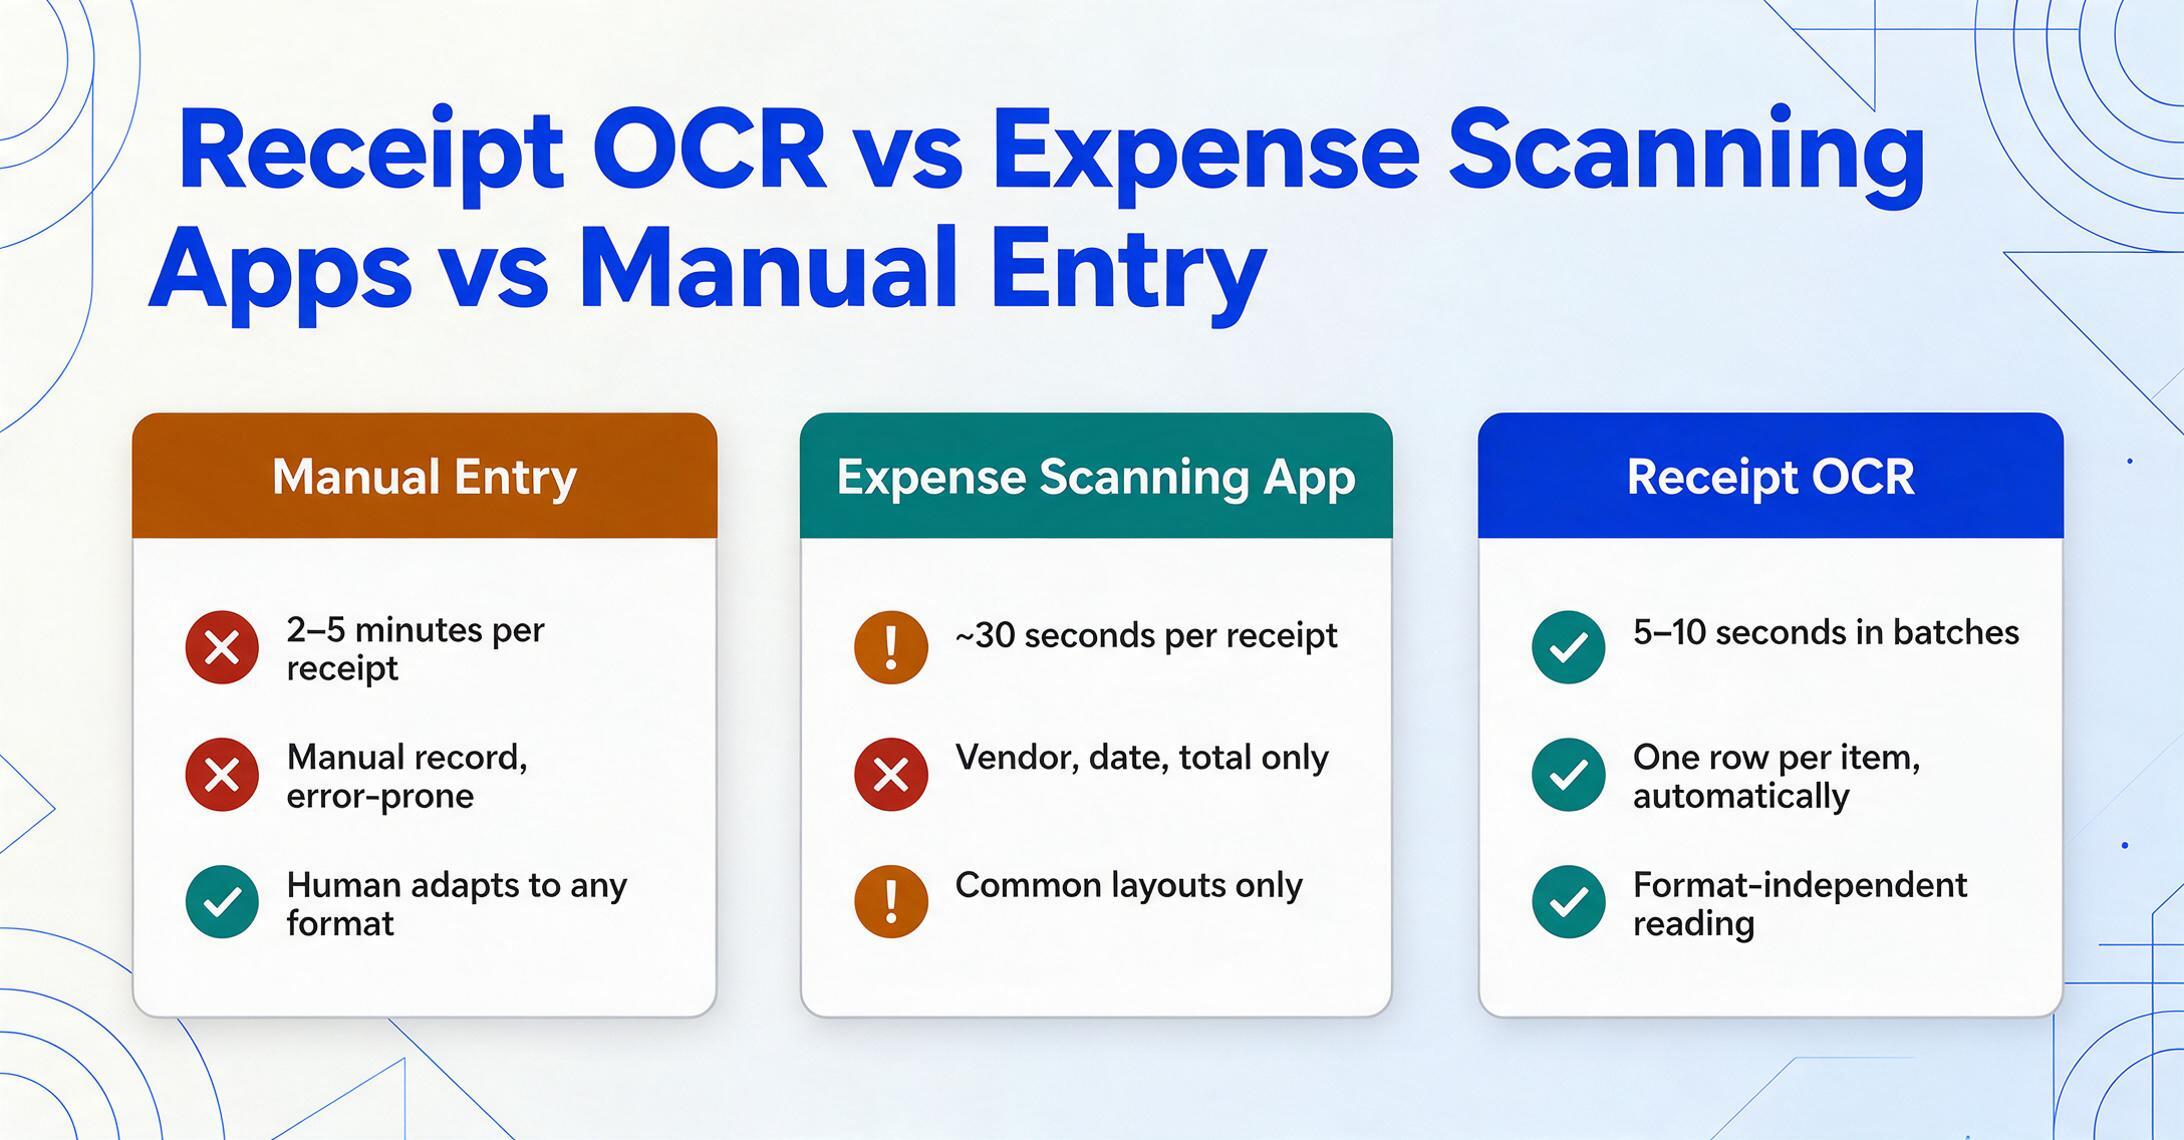
Les applications de numérisation de dépenses — comme la capture de reçus dans QuickBooks Online ou Xero — occupent une position intermédiaire. Elles enregistrent une transaction et joignent une photo, en extrayant le fournisseur, la date et le total. Pour un travailleur indépendant qui déclare une déduction Schedule C (annexe du formulaire 1040), ces trois champs satisfont à l'exigence minimale de justification de l'IRS (service des impôts des États-Unis) en vertu de la Treasury Regulation §1.274-5. Mais elles ne vous aident pas si vous devez répartir des lignes d'articles entre catégories ou rapprocher une note de restaurant d'une politique d'indemnité journalière.
L'OCR de reçus ne remplace pas QuickBooks ou Xero — c'est une couche de saisie de données qui alimente ces systèmes avec des données structurées. Cette distinction est importante car de nombreux propriétaires de petites entreprises supposent que la capture photo intégrée de leur logiciel comptable fait la même chose. Ce n'est pas le cas.
Comment fonctionne l'OCR de reçus
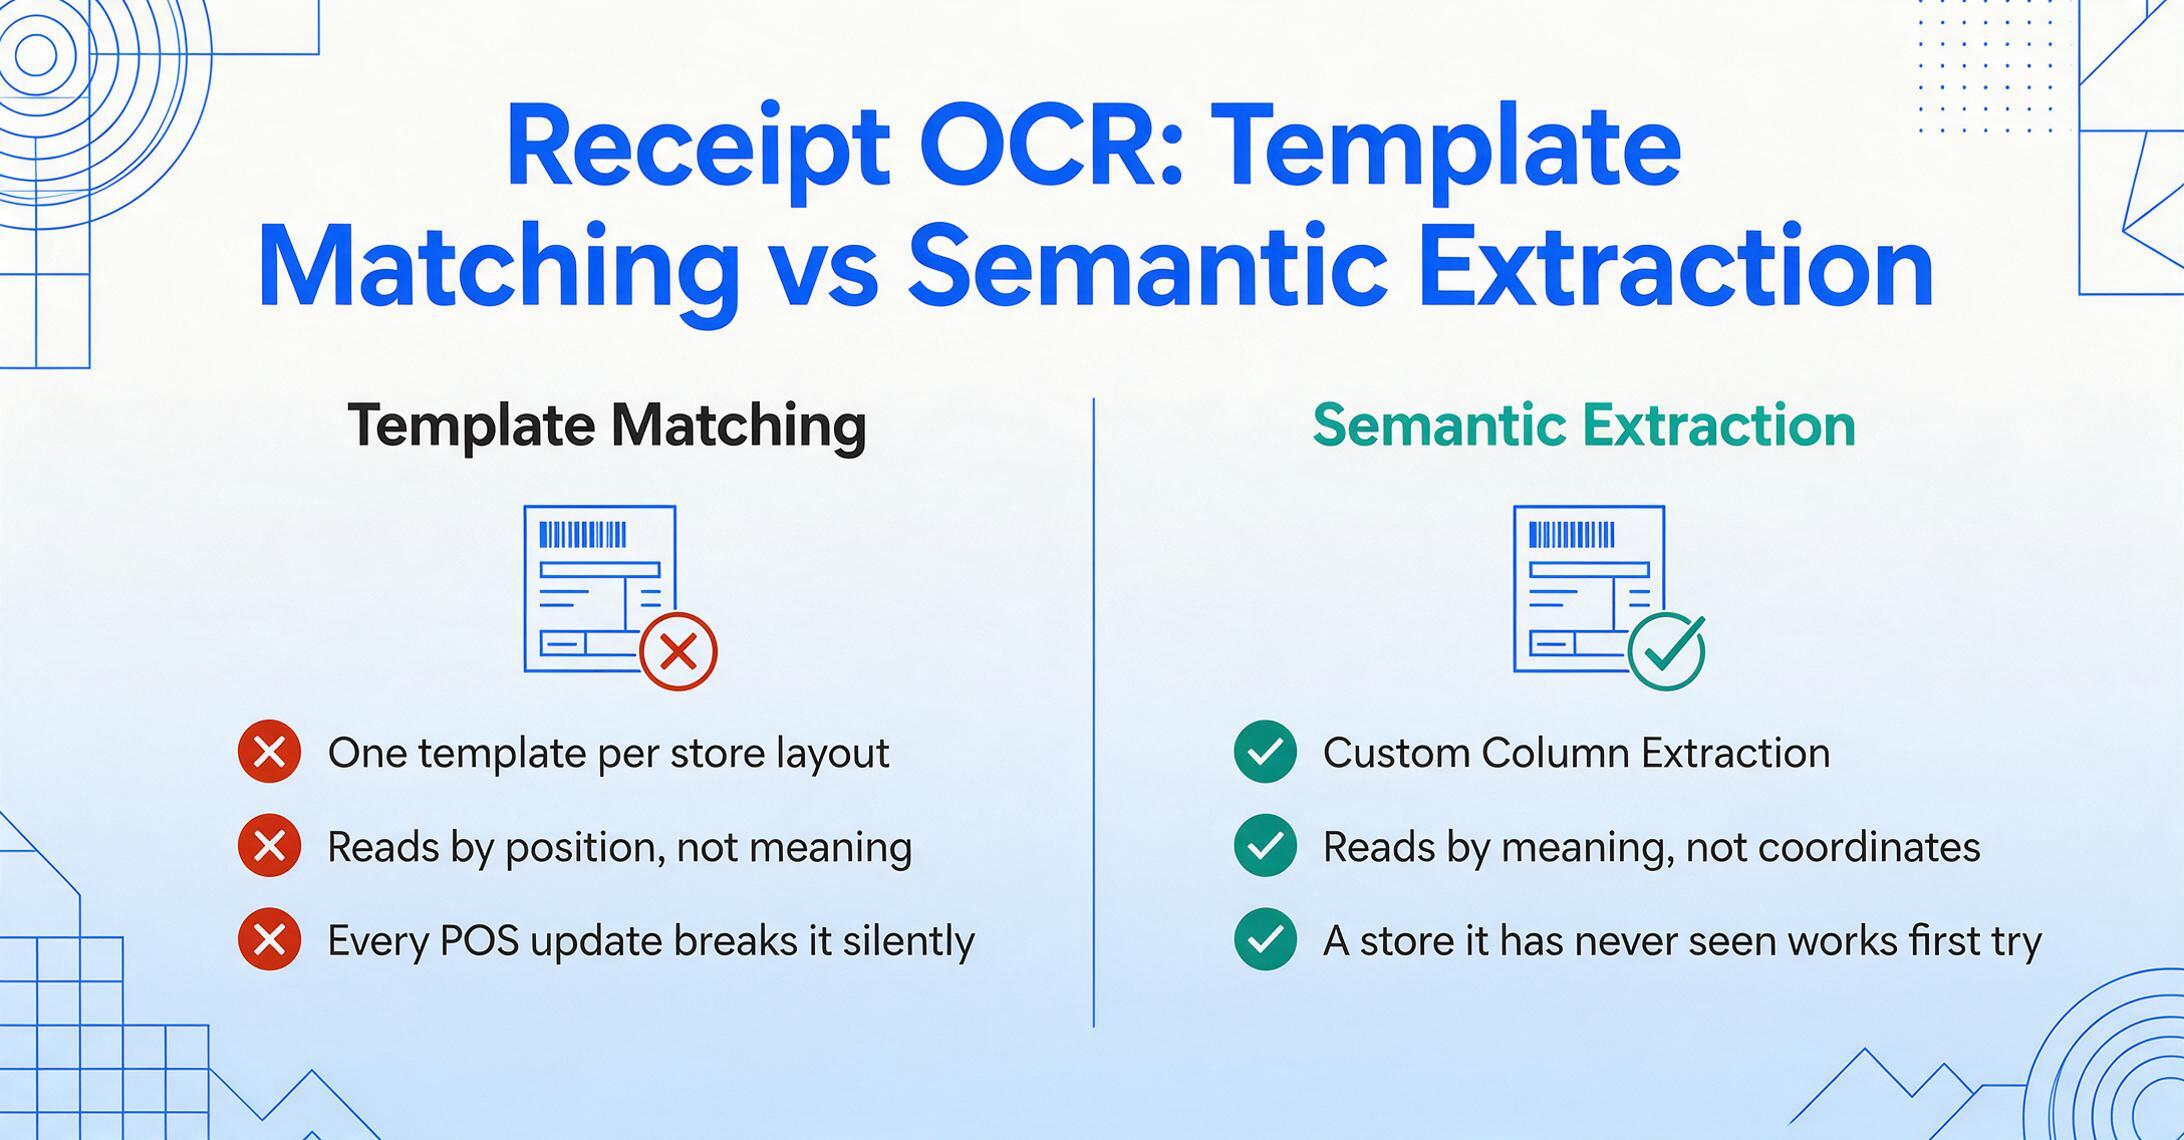
L'ancienne méthode : la correspondance de modèles. L'OCR de reçus traditionnel fonctionne par position. Vous créez un modèle pour chaque format de reçu de magasin — « Les reçus Walmart ont le total en bas à droite » — et l'outil recherche dans cette zone. Chaque magasin imprime différemment. Même la même chaîne utilise différents systèmes POS (point de vente) selon les emplacements. Un modèle pour un magasin est inutile pour un autre, et chaque mise à jour du POS casse silencieusement les modèles existants.
La méthode moderne : l'extraction sémantique. L'OCR de reçus basé sur l'IA fonctionne en comprenant ce que chaque morceau de texte signifie, et non où il se trouve. C'est l'Extraction de colonnes personnalisées : vous saisissez les noms de colonnes souhaités — « Nom du magasin », « Date », « Description de l'article », « Total de la ligne » — et l'IA lit l'intégralité du reçu, identifie quels blocs de texte correspondent à quels champs selon leur rôle sémantique, et les mappe aux bonnes colonnes de sortie. Un reçu provenant d'un magasin jamais vu fonctionne du premier coup, car l'IA ne regarde pas les coordonnées — elle regarde le sens.
Le processus se déroule en quatre étapes :
Téléversement
Déposez des photos, des scans ou des PDF — en un seul ou par lots. Fonctionne avec des photos de papier froissé ou plié prises au téléphone.
Définir les colonnes
Saisissez les champs souhaités — « Nom du magasin », « Date de transaction », « Article », « Prix », « Catégorie ». Ceux-ci deviennent vos en-têtes de feuille de calcul. Aucune configuration de modèle, aucune formation requise.
L'IA lit et mappe
Le modèle de vision identifie chaque bloc de texte selon son rôle sémantique — « cela ressemble à une date », « ce sont des articles de ligne » — et le mappe à la colonne que vous avez définie, indépendamment de la position.
Exporter les données structurées
Téléchargez en Excel (XLSX), CSV, ou écrivez directement dans Google Sheets. Chaque reçu devient une ligne — ou plusieurs lignes avec les articles de ligne extraits individuellement.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Quand vous avez besoin d'un OCR de reçus
Toutes les situations ne nécessitent pas un logiciel d'extraction. L'OCR de reçus passe de « pratique » à « indispensable » à ces seuils :
1. La saison des impôts cesse d'être un projet de week-end. Le NFIB a constaté que 42 % des petites entreprises consacrent quatre heures ou plus par mois à la paperasse de conformité fiscale. SCORE rapporte que la majorité consacre plus de 41 heures par an à la préparation des impôts, l'organisation des reçus étant le plus gros poste. Lorsque le tri des reçus devient une perte de temps récurrente chaque week-end, les outils d'extraction font passer l'équation de plusieurs heures de saisie à quelques minutes de vérification.
2. Le seuil de l'IRS (service des impôts des États-Unis) vous rattrape. En vertu de la publication 463 de l'IRS, les dépenses professionnelles de 75 $ ou plus exigent une preuve documentaire (§1.274-5(c)(2)(iii)) — un reçu, pas seulement un relevé bancaire. Ce seuil couvre un plein d'essence, un abonnement logiciel, un dîner client. Pour l'hébergement, les reçus sont exigés quel que soit le montant. Un travailleur indépendant qui peut produire des reçus propres, datés et catégorisés pour chaque transaction au-dessus de ce seuil arrive préparé à un contrôle fiscal. Celui qui ne le peut pas se retrouve à défendre des dépenses qu'il ne peut pas prouver.
3. Les reçus s'estompent avant que vous puissiez les enregistrer. Le papier thermique commence à s'estomper en quelques semaines. Vous ne pouvez pas récupérer les données d'un ticket vierge. La seule solution fiable est de capturer et d'extraire les données pendant que le reçu est encore lisible. Pour les documents que l'IRS recommande de conserver trois ans, l'écart entre « le reçu est lisible » et « le reçu est une preuve » se creuse chaque mois où les données restent sur papier.
4. Vous devez répartir les reçus entre les catégories de dépenses. Un seul passage dans un grand magasin peut inclure des fournitures de bureau (déductibles) et une collation personnelle (non déductible). Les colonnes inférées vous permettent de définir une règle de catégorisation — « classer chaque article comme fourniture de bureau, repas ou coût des marchandises vendues » — et l'IA l'applique lors de l'extraction, transformant un jugement manuel ligne par ligne en un seul passage. Pour un aperçu de la façon dont cela s'intègre dans un flux de travail fiscal, consultez notre guide sur la préparation des reçus pour la saison des impôts.
Pour une vue plus large de la technologie, consultez notre guide sur l'extraction de documents par IA. Et pour la ventilation financière, notre analyse de ce que coûte le suivi manuel des reçus au moment des impôts quantifie le travail et les pertes de déductions.
Que rechercher dans un outil d'OCR de reçus
Les outils d'OCR de reçus vont des applications pour smartphone qui extraient trois champs aux plateformes natives basées sur l'IA qui gèrent le traitement par lots et les colonnes personnalisées. Quelques critères distinguent les outils qui réduisent la charge de travail de ceux qui ne font que la renommer.
Fonctionnement sans modèle. Le différenciateur le plus important. Un outil qui exige un modèle par disposition de magasin n'est pas de l'extraction — c'est de la gestion de modèles. L'extraction sans modèle fonctionne par compréhension sémantique : un reçu provenant d'un magasin jamais vu fonctionne dès le premier téléchargement. Demandez : « Si je télécharge un reçu d'un magasin que je n'ai jamais traité auparavant, est-ce que ça fonctionne ? » Si la réponse implique « définir un modèle », vous achetez de la maintenance.
Qualité d'extraction des lignes d'article. Les champs d'en-tête sont la partie facile. Les lignes d'article sont le vrai test — l'outil peut-il extraire de manière fiable les descriptions d'articles, les quantités et les prix d'un reçu de vente au détail densément imprimé avec des noms tronqués et des prix alignés à droite ? Testez sur vos reçus les plus chaotiques, pas vos plus propres. Pour une comparaison côte à côte, consultez notre tour d'horizon des outils de numérisation de reçus.
Traitement par lots. Traiter 50 reçus un par un n'est pas significativement plus rapide que la saisie manuelle une fois que vous tenez compte des frais généraux d'interaction avec l'outil. Le traitement par lots — télécharger 50 d'un coup, obtenir une feuille de calcul unifiée — c'est là que les économies de temps se cumulent.
Cas limites spécifiques aux reçus. Reçus multi-devises provenant de voyages internationaux. Pourboires manuscrits sur reçus imprimés. Papier thermique déjà partiellement fané. Reçus froissés sortis d'un portefeuille. Un outil qui gère les reçus propres et plats mais échoue sur ces cas réels crée un flux de travail à deux niveaux : automatisé pour les cas faciles, manuel pour les cas difficiles.
Pour un aperçu plus approfondi de l'indépendance du format appliquée aux reçus, consultez notre guide sur l'extraction de données de reçus dans n'importe quel format.
Questions fréquemment posées
L'OCR de reçus fonctionne-t-il avec les reçus décolorés ou froissés ?
Oui, avec des limites. Les outils basés sur l'IA gèrent une décoloration, un pliage et un froissement modérés, car ils lisent le contexte et la forme, pas seulement des caractères individuels. Un reçu partiellement décoloré mais encore lisible par un humain est généralement lisible par l'IA. Mais une fois que le papier thermique est complètement décoloré, aucun outil ne peut récupérer les données. Capturez et extrayez les données des reçus dès que possible — attendre la saison des impôts, c'est courir contre la chimie.
L'IRS (service des impôts des États-Unis) accepte-t-il les scans numériques de reçus comme documents valides ?
Oui. Selon la publication 583 de l'IRS, les pièces justificatives comprennent les « bandes de caisse », les « relevés de compte » et les « reçus de carte de crédit » — tous acceptés sous forme numérique s'ils sont lisibles et indiquent le montant, la date et l'objet professionnel. L'IRS n'exige pas d'originaux papier.
L'OCR de reçus peut-il gérer les notes ou pourboires manuscrits sur les reçus imprimés ?
Oui. Les modèles de vision modernes lisent l'écriture manuscrite — y compris les pourboires griffonnés sur les tickets de restaurant et les ajustements manuels — en même temps que le texte imprimé. La précision dépend de la lisibilité : une écriture claire et en capitales est extraite de manière fiable, une cursive dense l'est moins. L'IA utilise le contexte pour lever l'ambiguïté : si elle voit un « 12,00 $ » manuscrit près d'une étiquette « Pourboire : » imprimée, elle comprend qu'il s'agit du montant du pourboire.
Quel est le taux de précision de l'OCR de reçus ?
L'OCR de reçus moderne basé sur l'IA atteint une précision de 95 à 99 % au niveau des champs sur les reçus imprimés et lisibles. Les taux d'erreur de saisie manuelle vont de 1 à 3 % par champ — ce qui signifie qu'un reçu comportant 15 champs a environ 14 à 36 % de risques de contenir au moins une faute de frappe. La différence clé : les erreurs d'OCR sont visibles dans un tableur pour examen ; une erreur saisie manuellement est invisible, sauf si vous vérifiez chaque cellule.
L'OCR de reçus peut-il gérer plusieurs devises ?
Oui, si l'outil utilise une compréhension sémantique. Un reçu international peut indiquer des montants dans une devise étrangère avec une note de conversion. Un outil basé sur la position pourrait saisir le nombre qui se trouve à l'endroit habituel. Un outil sémantique lit les symboles et les libellés de devise pour distinguer le « total en THB » de la « référence en USD ».
En quoi l'OCR de reçus diffère-t-il de l'extraction de données de factures ?
Ils partagent la même technologie — l'extraction sémantique basée sur l'IA — mais ciblent des structures de documents différentes. Les factures sont des documents commerciaux formels avec des étiquettes de champs relativement cohérentes. Les reçus sont destinés aux consommateurs et présentent des étiquettes très incohérentes : un total peut apparaître comme « TOTAL », « MONTANT DÛ », « SOLDE » ou simplement un nombre en bas sans étiquette. L'extraction de reçus est le problème le plus difficile. Consultez notre guide sur l'extraction de données de factures.
Ai-je besoin d'un OCR de reçus si j'utilise déjà QuickBooks ou Xero ?
QuickBooks et Xero incluent la capture photo de reçus qui extrait le vendeur, la date et le total — utile pour la saisie de dépenses de base. Mais ils n'extraient pas les lignes d'articles, donc vous ne pouvez pas répartir un reçu entre plusieurs catégories, et ils ne vous fournissent pas de feuille de calcul autonome contenant toutes les données des reçus. L'OCR de reçus complète les logiciels comptables en leur fournissant des données plus riches, au niveau des lignes d'articles. Pour le flux de travail, consultez notre guide sur la création d'un pipeline de reçus vers Schedule C.
Où aller à partir d'ici
L'OCR de reçus comble l'écart entre le moment où un reçu est imprimé et celui où ses données entrent dans vos livres comptables. Le papier thermique s'estompe. Les règles de l'IRS (service des impôts des États-Unis) exigent des preuves documentaires. La saisie manuelle coûte du temps à 32,23 $ de l'heure selon le Bureau of Labor Statistics. Les outils pour combler cet écart existent — et contrairement à il y a encore deux ans, ils fonctionnent sans modèle, sans formation, et avec n'importe quel format de reçu.
La meilleure façon d'évaluer si l'OCR de reçus convient à votre flux de travail est de le tester sur vos propres reçus — surtout les plus difficiles : le rouleau thermique estompé, le reçu de restaurant froissé avec un pourboire manuscrit, le ticket de duty-free international. Téléchargez un reçu d'exemple et voyez quelles données structurées vous obtenez — ou commencez par notre guide étape par étape pour l'extraction de données de reçus.