영수증 OCR이란?
매장 영수증을 스프레드시트로 추출하기
영수증 OCR은 종이 영수증의 사진이나 스캔본에서 매장명, 날짜, 구매 항목, 가격, 세금, 합계 등 핵심 정보를 자동으로 추출하여 스프레드시트의 구조화된 데이터로 변환하는 프로세스다. 각 필드를 수동으로 입력하는 대신, 소프트웨어가 영수증 이미지를 읽고 어느 텍스트가 판매자명이고 어느 숫자가 합계인지 파악한 뒤 Excel 파일이나 Google Sheets의 열을 채운다.
핵심 요약
- 영수증 사진은 영구 기록이 아니다. 감열지는 화학적으로 몇 주 안에 희미해지며 이를 막을 수 없고, IRS는 영수증을 3년간 판독 가능한 상태로 보관할 것을 요구한다.
- QuickBooks와 Xero에 내장된 영수증 캡처 기능은 판매자, 날짜, 합계 등 3개 필드만 추출하고 모든 품목을 건너뛰므로, 대형 매장에서의 한 번의 구매를 공제 가능 항목과 불가 항목으로 나눌 수 없다.
- 템플릿 불필요 영수증 OCR은 고정된 위치가 아닌 의미를 기준으로 읽는다. 한 번도 본 적 없는 매장의 영수증을 업로드하고 원하는 열을 정의하면 한 번에 품목 수준의 구조화된 데이터를 얻을 수 있다.
영수증 OCR의 실제 정의
영수증 OCR은 영수증을 촬영해 PDF로 저장하는 것과 다르다. 그것은 단지 사진일 뿐이다. 또한 영수증 이미지에 범용 OCR 엔진을 돌리는 것과도 다르다. 그것은 구분되지 않은 텍스트의 벽을 만들어낼 뿐이다. 영수증 OCR은 구조화된 데이터를 제공한다. 상점 이름은 스프레드시트의 한 열에, 날짜는 다른 열에, 각 품목은 각자의 행에, 세금과 합계는 합산하고 필터링할 수 있는 셀에 들어간다.
이 차이가 중요한 이유는 영수증이 대부분의 사람들이 생각하는 것보다 훨씬 어려운 추출 문제를 제기하기 때문이다. 식당 영수증은 품목을 세로로 나열하고 가격을 오른쪽 정렬한다. 소매 영수증은 축약된 제품 코드를 빽빽한 열에 사용한다. 그리고 거의 모든 영수증은 감열지에 인쇄되는데, 이미지를 생성하는 화학 코팅 때문에 몇 주 안에 빈 종이가 되어버린다. 막을 수도 없고, 빈 영수증을 복구할 수도 없다.
일반적으로 추출되는 필드는 두 가지 범주로 나뉜다.
거래 헤더
- 가맹점 / 상점 이름
- 거래 날짜 및 시간
- 영수증 / 거래 번호
- 결제 수단
- 소계, 세금, 팁, 합계
품목별 내역 (제품당)
- 품목 설명 또는 SKU
- 수량
- 단가
- 품목 합계
- 세금 코드 (표시된 경우)
품목별 내역은 영수증 OCR이 단순한 도구와 차별화되는 지점이다. 헤더만 추출하는 것 — "이 영수증은 6월 12일 Walmart에서 $47.83이었다" — 은 경비 기록에는 유용하다. 하지만 어떤 품목이 공제 가능한 사무용품이고 어떤 것이 개인 식료품인지 알아야 한다면 품목별 내역이 필요하다. 그리고 그 레이아웃은 헤더보다 훨씬 다양해서, 단일 열 목록부터 섹션 사이에 소계가 있는 다중 열 그리드까지 존재한다.
영수증 OCR vs 경비 스캔 앱 vs 수동 입력
| 수동 입력 | 경비 스캔 앱 | 영수증 OCR 추출 | |
|---|---|---|---|
| 기능 | 각 필드를 스프레드시트에 직접 입력 | 사진을 캡처하고 헤더 필드 3~4개 추출 | 헤더와 품목을 구조화된 열로 추출 |
| 영수증당 소요 시간 | 2~5분 | 약 30초 | 5~10초 (배치) |
| 품목 세부 정보 | 입력하면 사용 가능 | 거의 추출되지 않음 | 자동 추출, 품목당 한 행 |
| 형식 처리 | 사람이 모든 형식에 대응 | 일반적인 레이아웃만 | 형식 독립적 — 의미로 읽음 |
| IRS 문서 | 수동 기록, 오류 발생 가능 | 사진 저장, 필드 3개 캡처 | 구조화된 기록 + 원본 이미지 보존 |
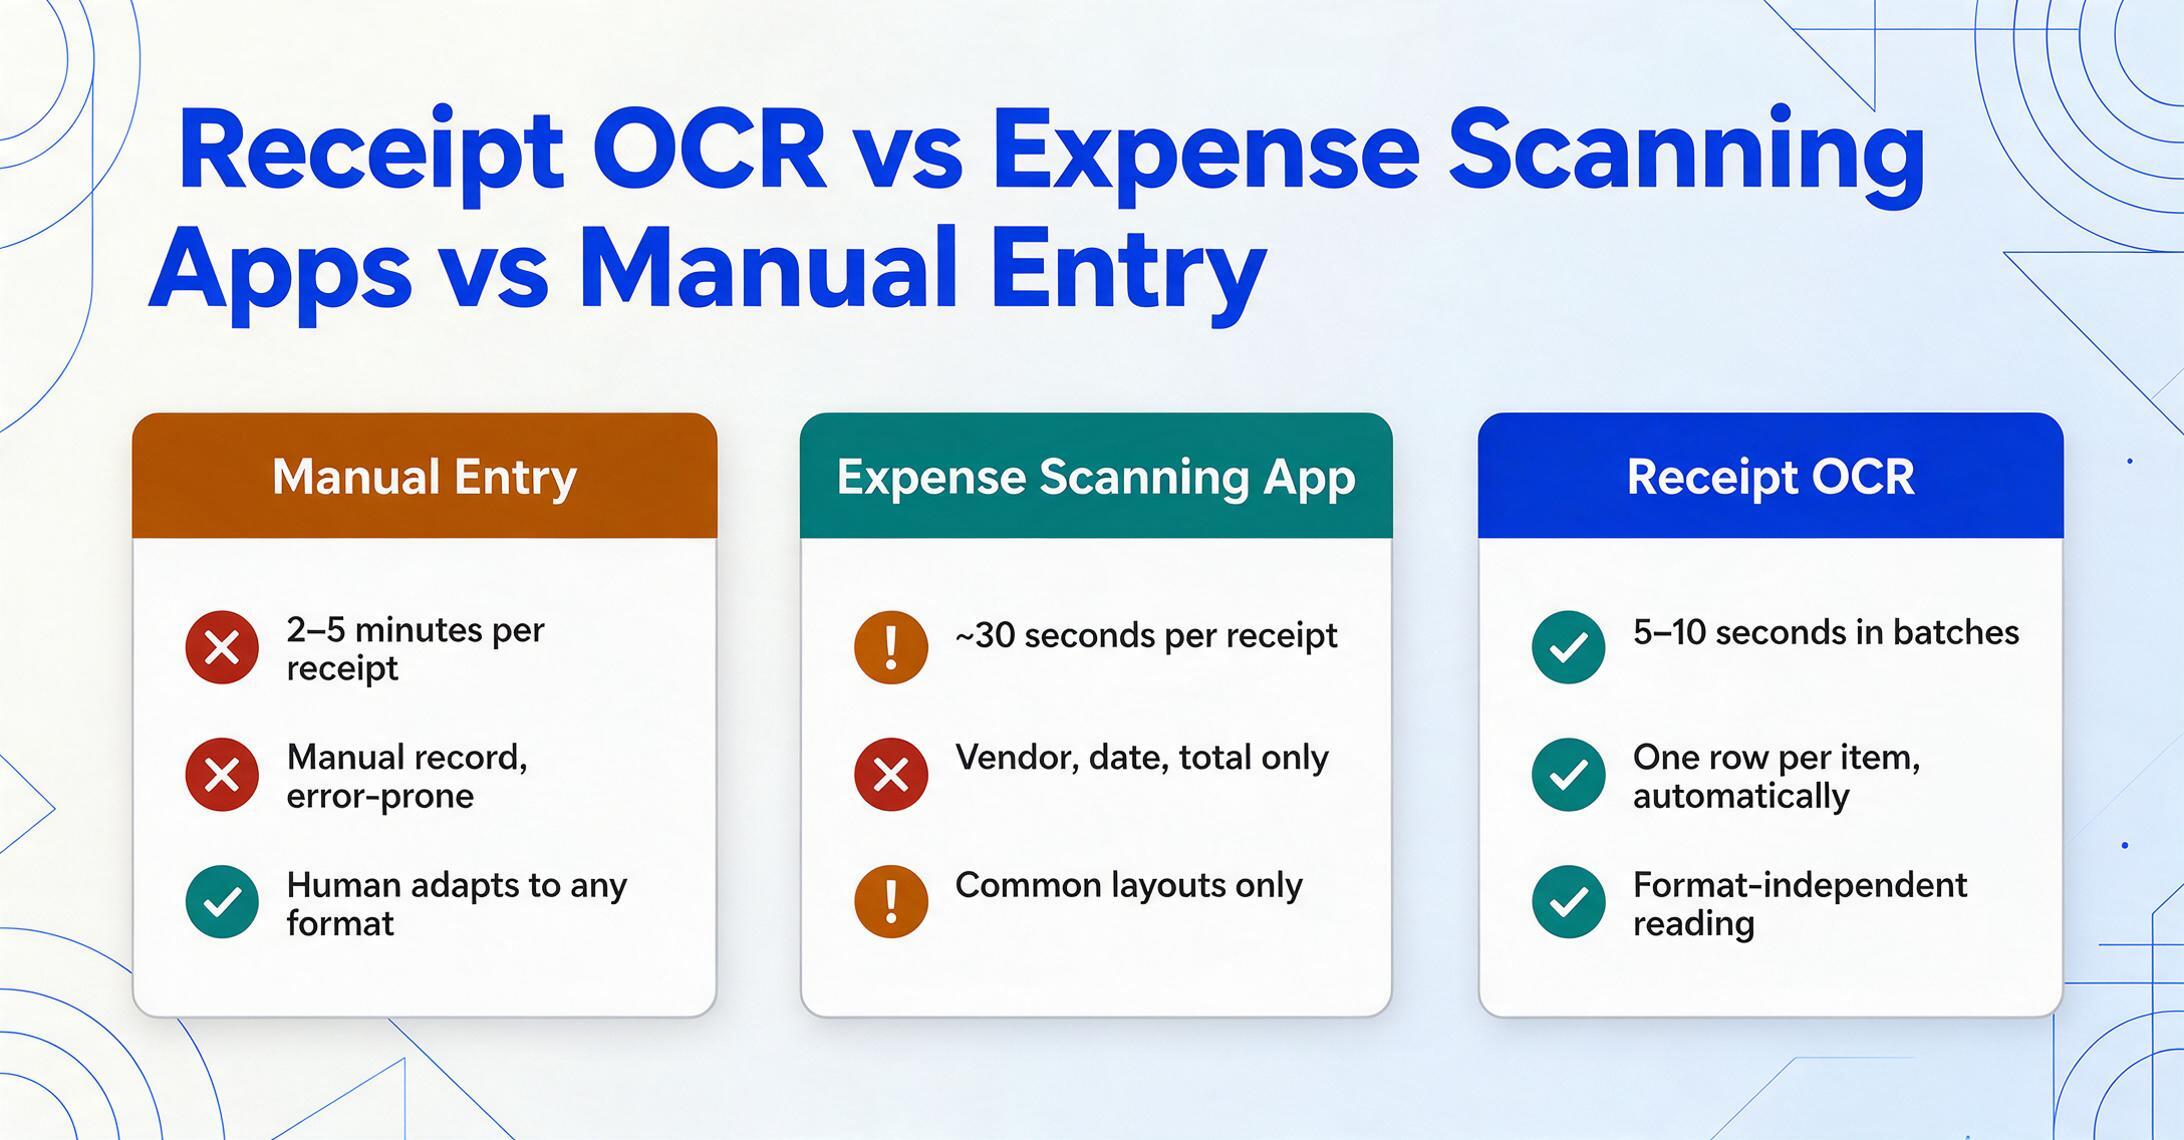
QuickBooks Online이나 Xero의 영수증 캡처 같은 경비 스캔 앱은 중간 지점에 위치한다. 거래를 기록하고 사진을 첨부하며, 공급업체, 날짜, 총액을 추출한다. Schedule C(양식 1040 부속) 공제를 신청하는 프리랜서에게 이 세 필드는 Treasury Regulation §1.274-5에 따른 최소 IRS 입증 요건을 충족한다. 하지만 품목을 여러 카테고리로 나누거나 식당 청구서를 일당 정책과 대조해야 할 때는 도움이 되지 않는다.
영수증 OCR은 QuickBooks나 Xero를 대체하는 것이 아니라, 구조화된 데이터를 해당 시스템에 공급하는 데이터 입력 계층이다. 많은 소규모 사업주가 회계 소프트웨어에 내장된 사진 캡처가 같은 역할을 한다고 가정하기 때문에 이 구분이 중요하다. 그렇지 않다.
영수증 OCR 작동 방식
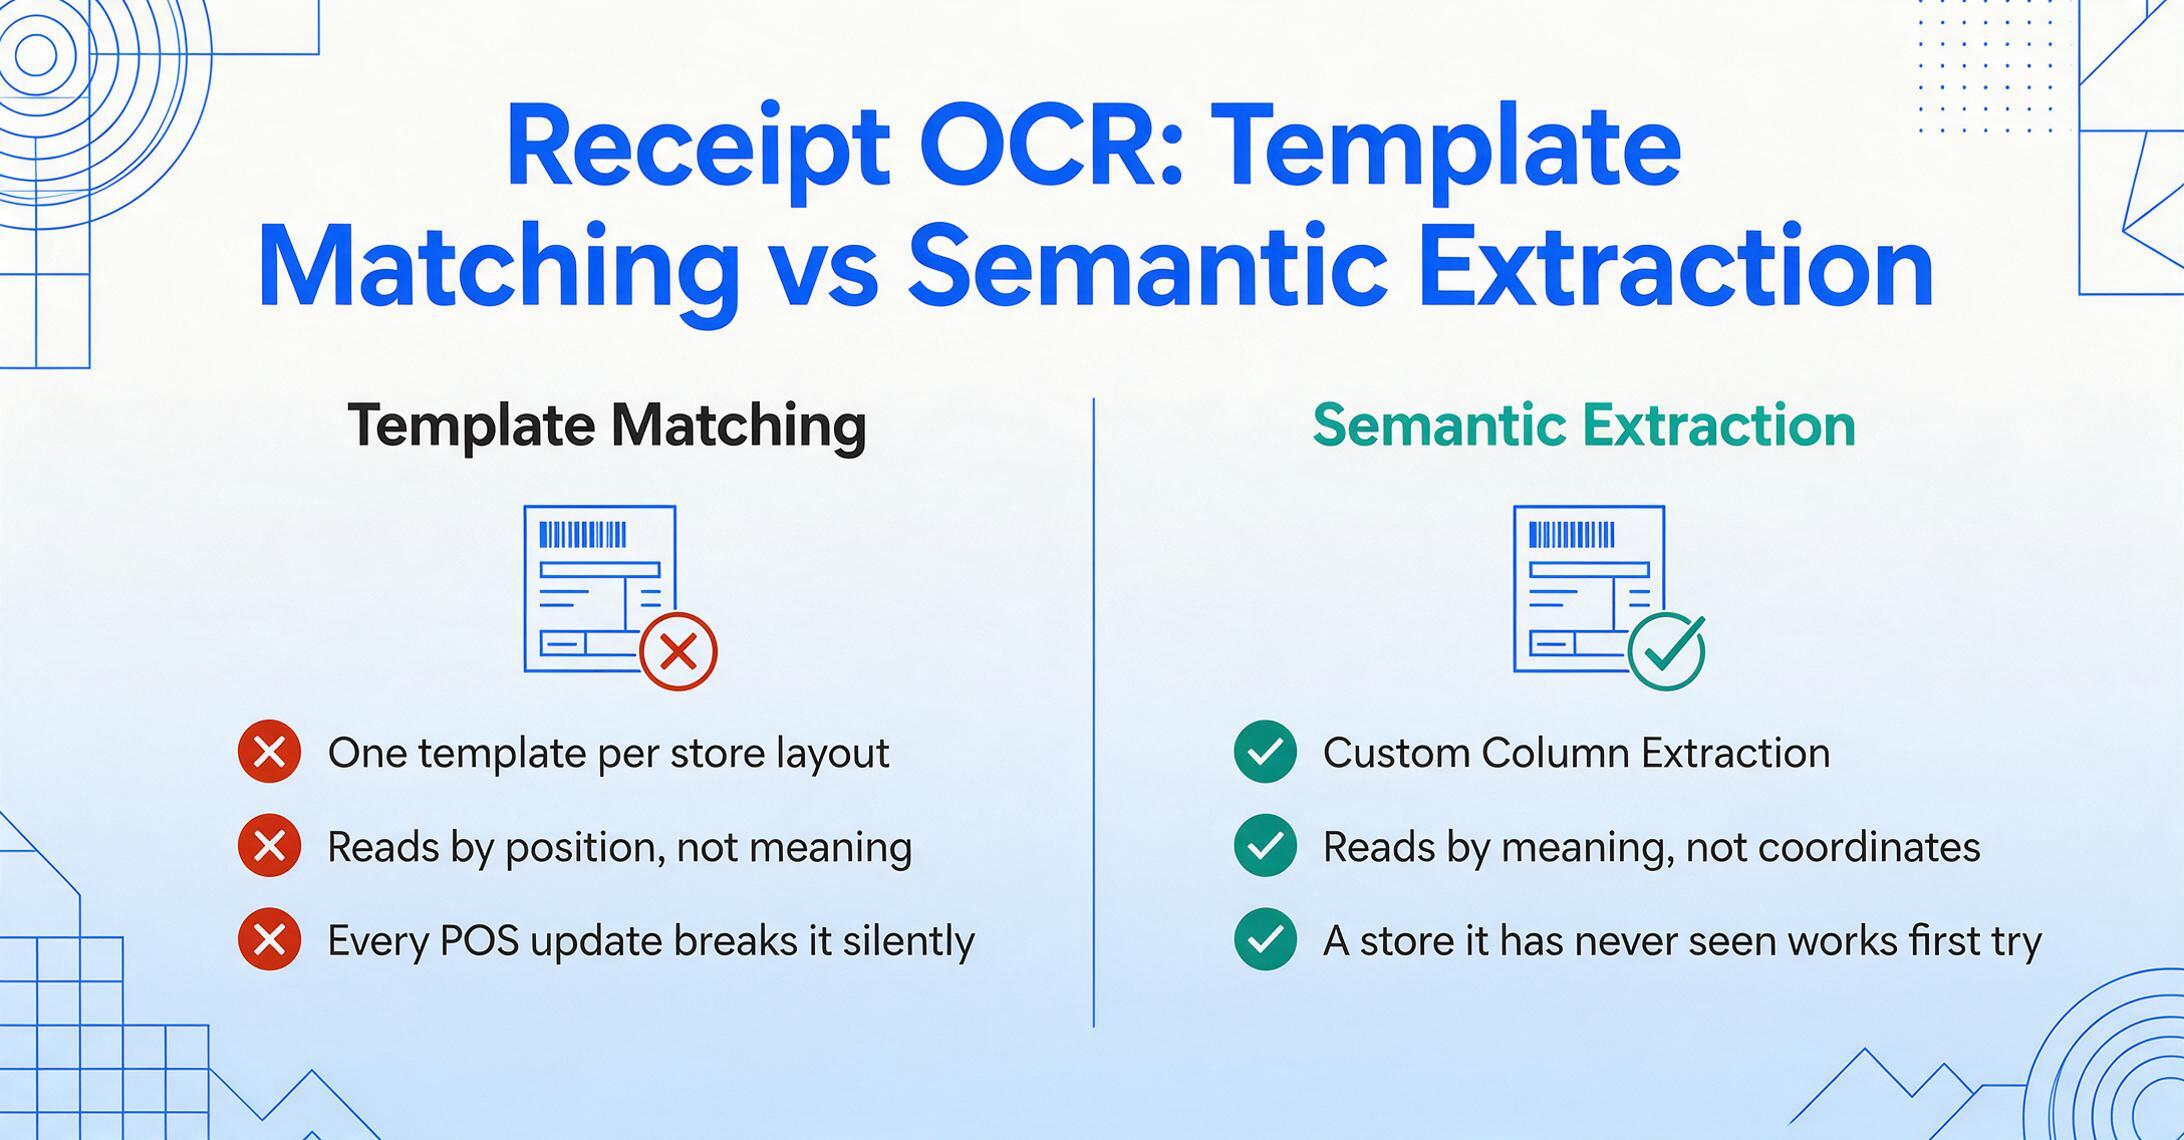
기존 방식: 템플릿 매칭. 전통적인 영수증 OCR은 위치를 기준으로 작동한다. 각 매장의 영수증 레이아웃마다 템플릿을 만든다 — "Walmart 영수증은 합계가 오른쪽 하단에 있다" — 그리고 도구는 그 영역을 찾는다. 매장마다 인쇄 방식이 다르다. 같은 체인이라도 지점마다 다른 POS(판매 시점 정보 관리) 시스템을 사용한다. 한 매장의 템플릿은 다른 매장에서는 쓸모가 없고, POS가 업데이트될 때마다 기존 템플릿은 조용히 깨진다.
현대적 방식: 시맨틱 추출. AI 기반 영수증 OCR은 각 텍스트가 어디에 있는지가 아니라 무엇을 의미하는지를 이해한다. 이것이 맞춤 열 추출이다. 원하는 열 이름을 입력하면 — "Store Name," "Date," "Item Description," "Line Total" — AI가 영수증 전체를 읽고, 어떤 텍스트 블록이 어떤 필드에 해당하는지 의미적 역할로 식별하여 올바른 출력 열에 매핑한다. 한 번도 본 적 없는 매장의 영수증도 첫 시도에 처리된다. AI는 좌표를 보는 것이 아니라 의미를 보기 때문이다.
파이프라인은 네 단계로 실행된다:
업로드
사진, 스캔본, PDF를 넣는다 — 단일 또는 배치로. 구겨지거나 접힌 종이를 찍은 휴대폰 사진도 작동한다.
열 정의
원하는 필드를 입력한다 — "Store Name," "Transaction Date," "Item," "Price," "Category." 이것이 스프레드시트 헤더가 된다. 템플릿 설정도, 학습도 필요 없다.
AI 읽기 및 매핑
비전 모델이 각 텍스트 블록을 의미적 역할로 식별한다 — "이것은 날짜처럼 보인다," "이것들은 품목 항목이다" — 그리고 위치에 관계없이 정의한 열에 각각 매핑한다.
구조화된 데이터 내보내기
Excel(XLSX), CSV로 다운로드하거나 Google Sheets에 직접 작성한다. 각 영수증은 하나의 행이 된다 — 또는 품목 항목을 개별 추출하면 여러 행이 된다.
파일은 안전하게 처리되며 저장되지 않는다.
영수증 OCR이 필요한 경우
모든 상황에 추출 소프트웨어가 필요한 것은 아니다. 영수증 OCR은 다음 기준점에서 "있으면 좋은 것"에서 "필수"로 바뀐다:
1. 세금 신고 시즌이 더 이상 주말 작업이 아니게 될 때. NFIB는 소규모 사업주의 42%가 세금 규정 준수 서류 작업에 매달 4시간 이상을 쓴다고 밝혔다. SCORE는 대다수가 세금 준비에 연간 41시간 이상을 쓰며, 그중 영수증 정리가 가장 큰 비중을 차지한다고 보고한다. 영수증 분류가 매주 주말을 잡아먹는 반복 작업이 되면, 추출 도구는 몇 시간의 입력을 몇 분의 검토로 바꿔준다.
2. IRS(미국 국세청) 기준에 걸릴 때. IRS Publication 463에 따르면 $75 이상의 사업 경비는 증빙 서류(§1.274-5(c)(2)(iii))가 필요하다 — 은행 명세서가 아닌 영수증이어야 한다. 이 기준은 주유 한 번, 소프트웨어 구독, 거래처 식사에도 적용된다. 숙박의 경우 금액과 관계없이 영수증이 필요하다. 해당 기준을 넘는 모든 거래에 대해 깔끔하고 날짜가 표시된 분류된 영수증을 제출할 수 있는 프리랜서는 세무 조사를 준비된 상태로 맞는다. 그렇지 못한 사람은 증명할 수 없는 경비를 두고 다투게 된다.
3. 기록하기 전에 영수증이 흐려질 때. 감열지는 몇 주 안에 흐려지기 시작한다. 빈 종이에서 데이터를 복구할 수는 없다. 유일하게 신뢰할 수 있는 해결책은 영수증을 읽을 수 있을 때 데이터를 캡처하고 추출하는 것이다. IRS가 3년 보관을 권장하는 기록의 경우, "영수증을 읽을 수 있는 상태"와 "영수증이 증거가 되는 상태" 사이의 간격은 데이터가 종이에 남아 있는 매달 벌어진다.
4. 영수증을 여러 경비 항목으로 나눠야 할 때. 대형 마트 한 번 방문에 사무용품(공제 가능)과 개인 간식(공제 불가)이 섞여 있을 수 있다. 추론 열을 사용하면 분류 규칙을 정의할 수 있다 — "각 항목을 사무용품, 식비, 매출원가로 분류" — 그리고 AI가 추출 중에 이를 적용해, 수작업으로 한 줄씩 판단하던 것을 한 번의 처리로 바꾼다. 이것이 세금 업무 흐름에 어떻게 맞는지 알아보려면 세금 신고 시즌을 위한 영수증 준비 가이드를 참고한다.
이 기술에 대한 더 넓은 개요는 AI 문서 추출 가이드를 참고한다. 그리고 비용 분석은 세금 신고 시즌에 수동 영수증 추적이 드는 비용 분석에서 노동력과 공제 손실을 수치로 보여준다.
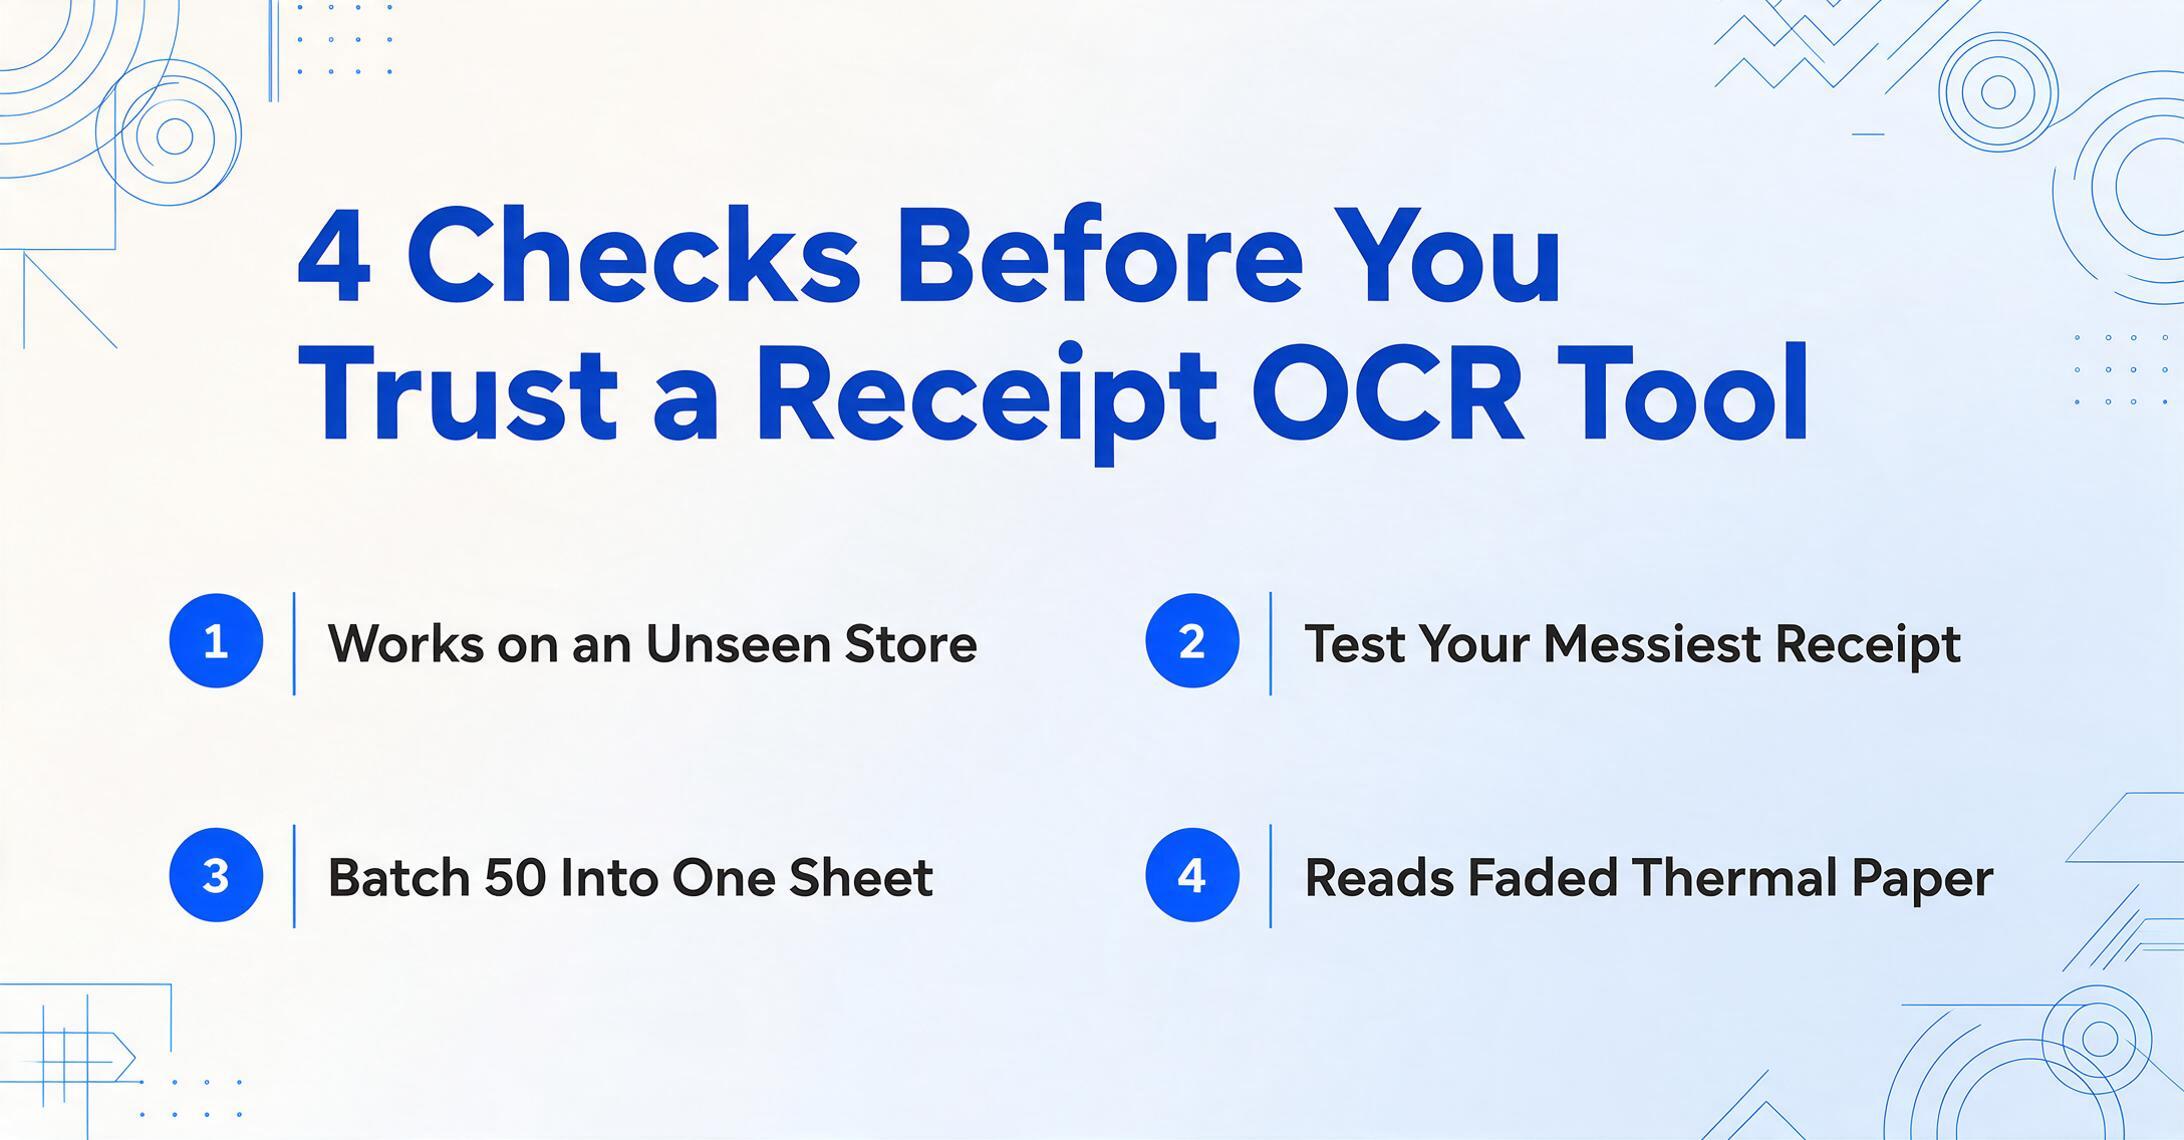
영수증 OCR 도구 선택 시 확인할 사항
영수증 OCR 도구는 세 개의 필드만 추출하는 스마트폰 앱부터 배치 처리와 맞춤 열을 처리하는 AI 네이티브 플랫폼까지 다양하다. 몇 가지 기준으로 업무량을 줄여주는 도구와 이름만 바꾸는 도구를 구분할 수 있다.
템플릿 불필요 운영. 가장 중요한 차별점이다. 매장 레이아웃마다 템플릿을 요구하는 도구는 추출이 아니라 템플릿 관리다. 템플릿 불필요 추출은 의미론적 이해로 읽는다. 한 번도 본 적 없는 매장의 영수증도 첫 업로드에서 작동한다. 물어보라. "한 번도 처리한 적 없는 매장의 영수증을 업로드하면 작동하는가?" 답에 "템플릿을 정의하세요"가 포함된다면 유지보수를 사는 것이다.
품목별 추출 품질. 헤더 필드는 쉬운 부분이다. 품목별 항목이 진짜 시험대다. 이름이 잘리고 가격이 오른쪽 정렬된 빽빽한 인쇄 소매 영수증에서 품목 설명, 수량, 가격을 안정적으로 추출할 수 있는가? 가장 깔끔한 영수증이 아니라 가장 혼란스러운 영수증으로 테스트하라. 나란히 비교하려면 영수증 스캔 도구 모음을 참고하라.
배치 처리. 영수증 50장을 한 장씩 처리하는 것은 도구 조작 오버헤드를 고려하면 수동 입력보다 실질적으로 빠르지 않다. 배치 처리, 즉 50장을 한 번에 업로드하고 하나의 통합 스프레드시트를 얻는 방식에서 시간 절약이 누적된다.
영수증 특유의 예외 상황. 해외 여행의 다중 통화 영수증. 인쇄 영수증에 손으로 쓴 팁. 이미 부분적으로 흐려진 감열지. 지갑에서 구겨진 영수증. 깔끔하고 평평한 영수증은 처리하지만 이런 실제 사례에서 막히는 도구는 이중 워크플로를 만든다. 쉬운 것은 자동, 어려운 것은 수동.
영수증에 적용된 형식 독립적 처리에 대한 자세한 내용은 모든 형식의 영수증 데이터 추출 가이드를 참고하라.
자주 묻는 질문
영수증 OCR은 흐리거나 구겨진 영수증도 처리할 수 있나?
가능하지만 한계가 있다. AI 기반 도구는 개별 문자만이 아니라 맥락과 형태를 읽기 때문에 적당한 흐림, 접힘, 구김을 처리한다. 사람이 읽을 수 있을 정도로 부분적으로 흐려진 영수증은 일반적으로 AI도 읽을 수 있다. 그러나 감열지가 완전히 희미해져 백지가 되면 어떤 도구도 데이터를 복구할 수 없다. 영수증 데이터는 가능한 한 빨리 캡처하고 추출해야 한다. 세금 신고 시즌까지 기다리는 것은 화학과의 경주다.
IRS(미국 국세청)는 디지털 영수증 스캔을 유효한 기록으로 인정하나?
그렇다. IRS Publication 583에 따르면 증빙 서류에는 "금전 등록기 테이프", "계좌 명세서", "신용카드 매출 전표"가 포함되며, 판독 가능하고 금액, 날짜, 사업 목적이 표시되어 있으면 모두 디지털 형태로 인정된다. IRS는 종이 원본을 요구하지 않는다.
영수증 OCR은 인쇄된 영수증에 손으로 쓴 팁이나 메모를 처리할 수 있나?
그렇다. 최신 비전 모델은 식당 영수증에 휘갈겨 쓴 팁과 수동 조정을 포함한 필기체를 동일한 처리 과정에서 인쇄된 텍스트와 함께 읽는다. 정확도는 판독 가능성에 달려 있다. 또렷한 블록체 인쇄는 안정적으로 추출되지만, 빽빽한 필기체는 덜 안정적이다. AI는 맥락을 활용해 모호함을 해소한다. 인쇄된 "Tip:" 레이블 근처에 손으로 쓴 "$12.00"이 보이면 그것이 팁 금액임을 이해한다.
영수증 OCR의 정확도는 어느 정도인가?
최신 AI 기반 영수증 OCR은 인쇄된 판독 가능한 영수증에서 필드 수준 정확도 95~99%를 달성한다. 수동 데이터 입력 오류율은 필드당 1~3%로, 15개 필드가 있는 영수증은 약 14~36% 확률로 최소 하나의 오타를 포함한다. 핵심 차이는 OCR 오류는 검토를 위해 스프레드시트에서 눈에 띄지만, 수동으로 입력한 오류는 모든 셀을 다시 확인하지 않는 한 보이지 않는다는 점이다.
영수증 OCR은 여러 통화를 처리할 수 있나?
도구가 의미론적 이해를 사용한다면 가능하다. 국제 영수증은 환율 변환 메모와 함께 외화 금액을 표시할 수 있다. 위치 기반 도구는 일반적인 위치에 있는 숫자를 그대로 가져올 수 있다. 의미론적 도구는 통화 기호와 레이블을 읽어 "THB 기준 합계"와 "USD 기준 참조"를 구분한다.
영수증 OCR은 인보이스 데이터 추출과 어떻게 다른가?
동일한 기술(AI 기반 의미론적 추출)을 공유하지만 대상 문서 구조가 다르다. 인보이스는 필드 레이블이 비교적 일관된 공식 비즈니스 문서다. 영수증은 레이블이 매우 불규칙한 소비자용 문서로, 합계가 "TOTAL", "AMOUNT DUE", "BALANCE"로 표시되거나 레이블 없이 하단에 숫자만 있을 수 있다. 영수증 추출이 더 어려운 문제다. 인보이스 데이터 추출 가이드를 참조하라.
QuickBooks나 Xero를 이미 사용 중이라면 영수증 OCR이 필요한가?
QuickBooks와 Xero에는 공급업체, 날짜, 합계를 추출하는 영수증 사진 캡처 기능이 있어 기본적인 지출 기록에는 유용하다. 하지만 품목별 내역을 추출하지 않으므로 영수증을 여러 카테고리로 나눌 수 없고, 모든 영수증 데이터를 담은 독립형 스프레드시트도 제공하지 않는다. 영수증 OCR은 더 풍부한 품목별 데이터를 회계 소프트웨어에 제공함으로써 이를 보완한다. 워크플로에 대해서는 영수증에서 Schedule C(양식 1040 부속)까지 파이프라인 구축 가이드를 참고한다.
다음 단계
영수증 OCR은 영수증이 출력된 시점과 그 데이터가 장부에 입력되는 시점 사이의 간극을 메운다. 감열 용지의 글자는 흐려진다. IRS(미국 국세청) 규정은 증빙 자료를 요구한다. Bureau of Labor Statistics(미국 노동통계국)에 따르면 수동 입력은 시간당 $32.23의 시간 비용을 발생시킨다. 그 간극을 메울 도구는 이미 존재하며, 불과 2년 전과 달리 템플릿도, 학습도 필요 없이 모든 영수증 형식에서 작동한다.
영수증 OCR이 사용자의 워크플로에 맞는지 평가하는 가장 좋은 방법은 실제 영수증으로 테스트하는 것이다. 특히 까다로운 영수증 — 흐려진 감열 영수증, 손으로 쓴 팁이 적힌 구겨진 식당 영수증, 해외 면세점 영수증 — 으로 말이다. 샘플 영수증을 업로드하고 어떤 구조화 데이터가 반환되는지 확인해 보라 — 또는 영수증 데이터 추출 단계별 가이드부터 시작하라.