Was ist Beleg-OCR?
Kassenzettel in Tabellen extrahieren
Beleg-OCR ist der automatisierte Prozess, bei dem wichtige Informationen – Geschäftsname, Datum, gekaufte Artikel, Preise, Steuern und Gesamtsumme – aus einem Foto oder Scan eines Papierbelegs extrahiert und in strukturierte Daten in einer Tabelle umgewandelt werden. Statt jedes Feld manuell einzutippen, liest die Software das Belegbild, erkennt, welcher Text der Händlername und welche Zahl die Gesamtsumme ist, und füllt dann Spalten in einer Excel-Datei oder Google Sheets aus.
Die wichtigsten Erkenntnisse
- Ihr Belegfoto ist keine dauerhafte Aufzeichnung – Thermopapier verblasst chemisch innerhalb weniger Wochen, Sie können das nicht verhindern, und der IRS (US-Steuerbehörde) erwartet, dass Sie Belege 3 Jahre lang lesbar aufbewahren.
- Die in QuickBooks und Xero integrierte Belegerfassung extrahiert 3 Felder – Anbieter, Datum, Gesamtsumme – überspringt jedoch jede einzelne Position, sodass Sie einen einzigen Big-Box-Store-Einkauf nicht auf abzugsfähige und nicht abzugsfähige Kategorien aufteilen können.
- Beleg-OCR ohne Vorlage liest nach semantischer Bedeutung statt nach festen Positionen – laden Sie einen Beleg von einem beliebigen Geschäft hoch, das es noch nie gesehen hat, definieren Sie die gewünschten Spalten und erhalten Sie in einem Durchgang strukturierte Daten auf Positionsebene.
Was Receipt OCR eigentlich ist
Receipt OCR ist nicht dasselbe wie ein Foto von einem Kassenbon zu machen und als PDF zu speichern – das ergibt nur ein Bild. Es ist auch nicht dasselbe wie eine generische OCR-Engine über ein Belegbild laufen zu lassen – das liefert eine unstrukturierte Textwand. Receipt OCR liefert strukturierte Daten: den Ladenname in einer Tabellenspalte, das Datum in einer anderen, jeden Artikel in einer eigenen Zeile, Steuer und Gesamtsumme in Zellen, die Sie summieren und filtern können.
Diese Unterscheidung ist wichtig, weil Belege ein schwierigeres Extraktionsproblem darstellen, als die meisten annehmen. Ein Restaurantbeleg listet Artikel vertikal mit rechtsbündigen Preisen. Ein Einzelhandelsbeleg verwendet abgekürzte Produktcodes in dichten Spalten. Und fast alle werden auf Thermopapier gedruckt, das innerhalb von Wochen verblasst – aufgrund der chemischen Beschichtung, die das Bild erzeugt – das lässt sich nicht verhindern, und ein verblasster Beleg ist nicht wiederherstellbar.
Die typischerweise extrahierten Felder fallen in zwei Kategorien:
Transaktionskopf
- Händler / Ladenname
- Transaktionsdatum & -uhrzeit
- Beleg / Transaktionsnummer
- Zahlungsmethode
- Zwischensumme, Steuer, Trinkgeld, Gesamtsumme
Einzelposten (pro Produkt)
- Artikelbeschreibung oder SKU
- Menge
- Einzelpreis
- Positionssumme
- Steuercode (falls angegeben)
Die Einzelposten-Ebene ist es, die Receipt OCR von einfacheren Werkzeugen abhebt. Eine reine Kopfdaten-Extraktion – „dieser Beleg war 47,83 € bei Walmart am 12. Juni“ – ist nützlich für die Spesenabrechnung. Aber wenn Sie wissen müssen, welche Artikel abzugsfähige Büromaterialien und welche private Lebensmittel sind, brauchen Sie die Einzelposten – und deren Layouts variieren noch stärker als die Kopfdaten, von einspaltigen Listen bis zu mehrspaltigen Gittern mit Zwischensummen zwischen Abschnitten.
Beleg-OCR vs. Spesen-Scan-Apps vs. manuelle Erfassung
| Manuelle Erfassung | Spesen-Scan-App | Beleg-OCR-Erfassung | |
|---|---|---|---|
| Funktion | Sie tippen jedes Feld in eine Tabelle | Erfasst ein Foto, extrahiert 3–4 Kopffelder | Extrahiert Kopffelder + Positionen in strukturierte Spalten |
| Zeit pro Beleg | 2–5 Minuten | ~30 Sekunden | 5–10 Sekunden (Stapel) |
| Positionsdetails | Verfügbar, wenn Sie sie eintippen | Selten extrahiert | Automatisch extrahiert, eine Zeile pro Position |
| Formatverarbeitung | Mensch passt sich jedem Format an | Nur gängige Layouts | Formatunabhängig – liest nach Bedeutung |
| IRS-Dokumentation | Manuelle Aufzeichnung, fehleranfällig | Foto gespeichert, 3 Felder erfasst | Strukturierter Datensatz + Originalbild erhalten |
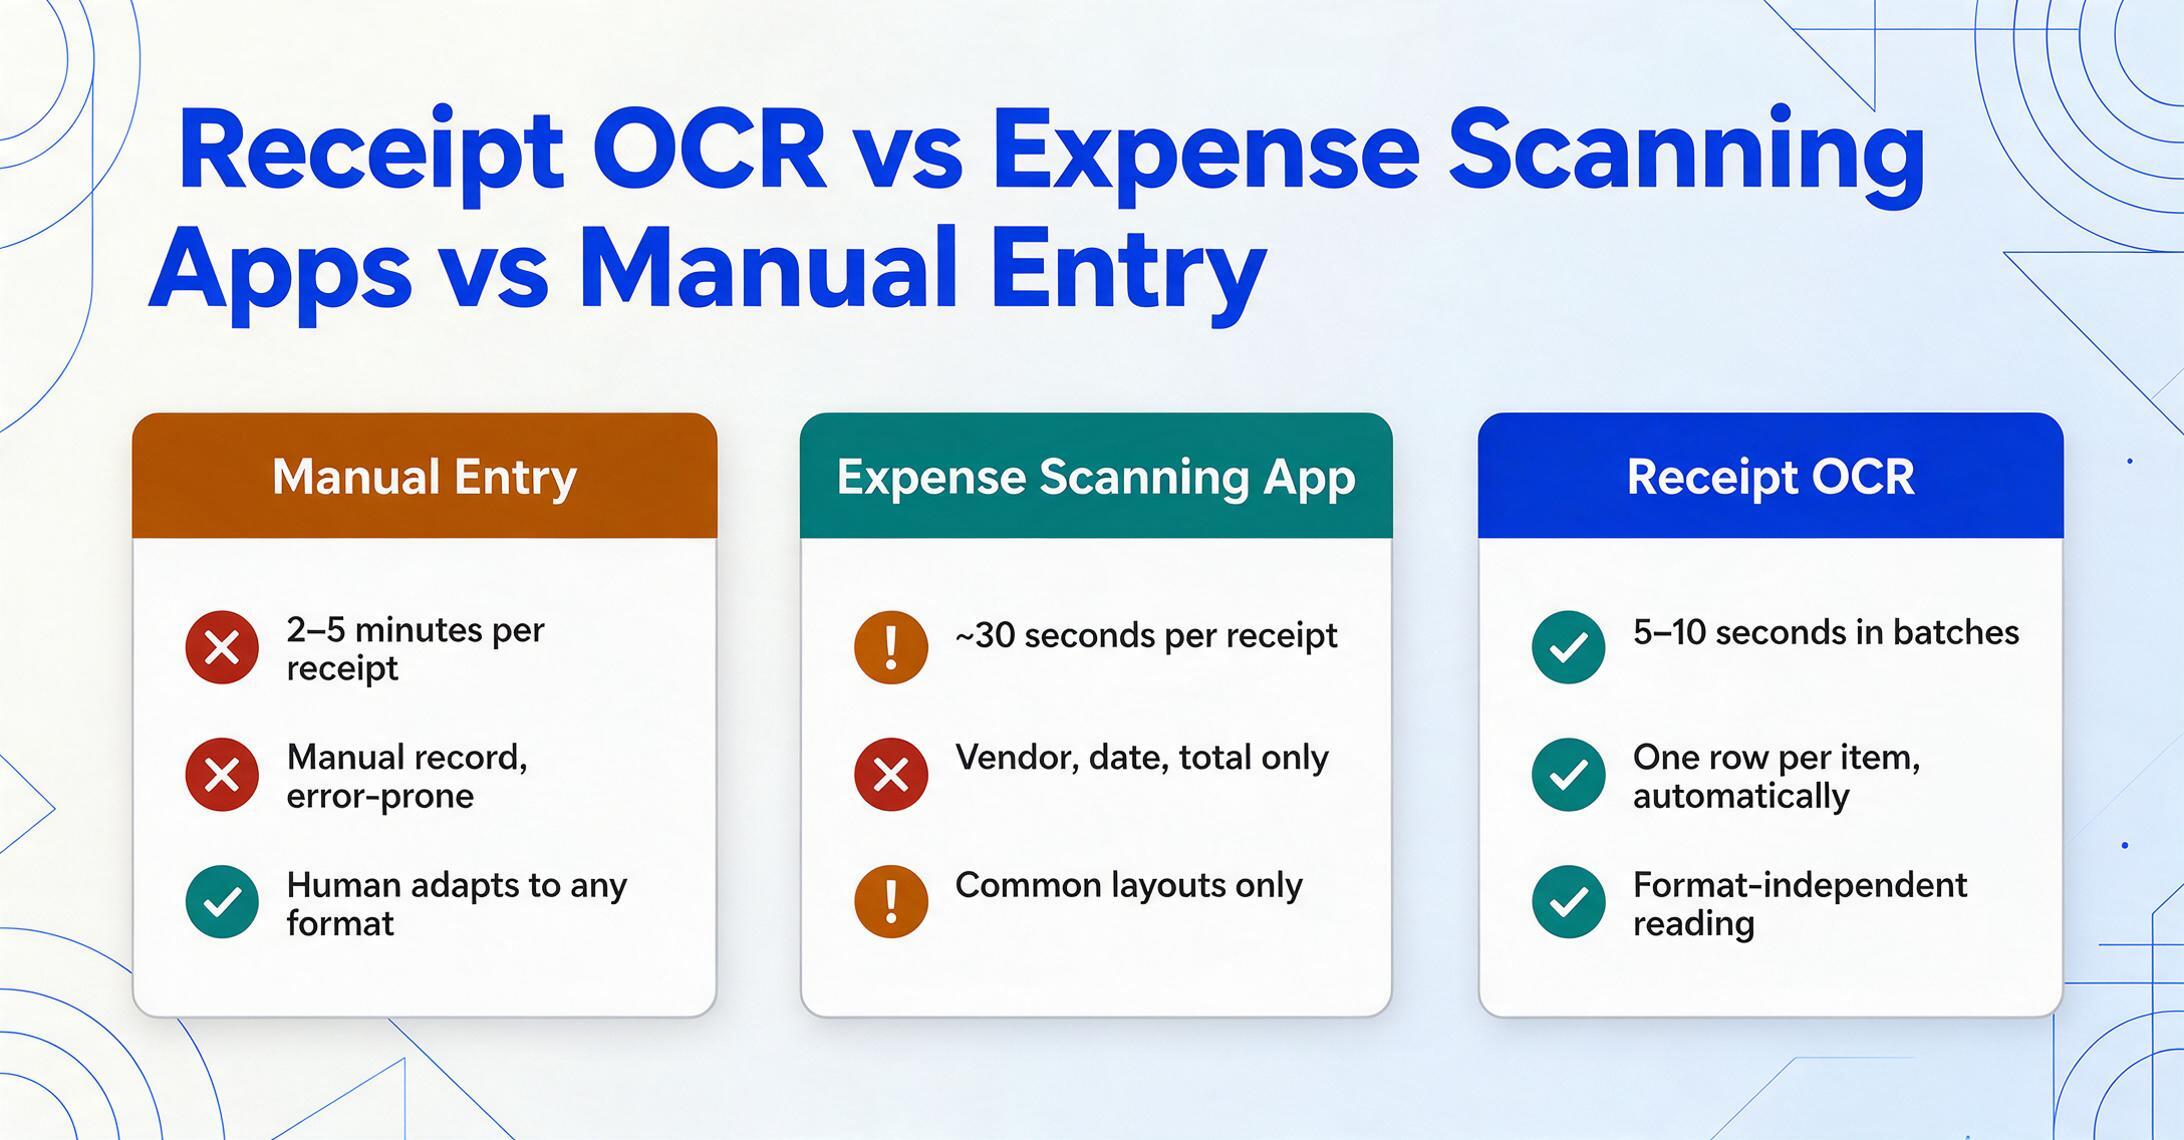
Spesen-Scan-Apps – wie die Belegerfassung in QuickBooks Online oder Xero – nehmen die Mittelposition ein. Sie protokollieren eine Transaktion und hängen ein Foto an, wobei Händler, Datum und Gesamtbetrag extrahiert werden. Für einen Freiberufler, der eine Schedule C (Anlage zu Formular 1040)-Abzug geltend macht, erfüllen diese drei Felder die Mindestanforderung der IRS (US-Steuerbehörde) zur Belegführung gemäß Treasury Regulation §1.274-5. Sie helfen jedoch nicht, wenn Sie Positionen auf Kategorien aufteilen oder eine Restaurantrechnung mit einer Tagegeldregelung abgleichen müssen.
Beleg-OCR ist kein Ersatz für QuickBooks oder Xero – es ist eine Dateneingabeschicht, die strukturierte Daten in diese Systeme einspeist. Dieser Unterschied ist wichtig, weil viele Kleinunternehmer annehmen, dass die integrierte Fotoerfassung ihrer Buchhaltungssoftware dasselbe leistet. Tut sie nicht.
So funktioniert Beleg-OCR
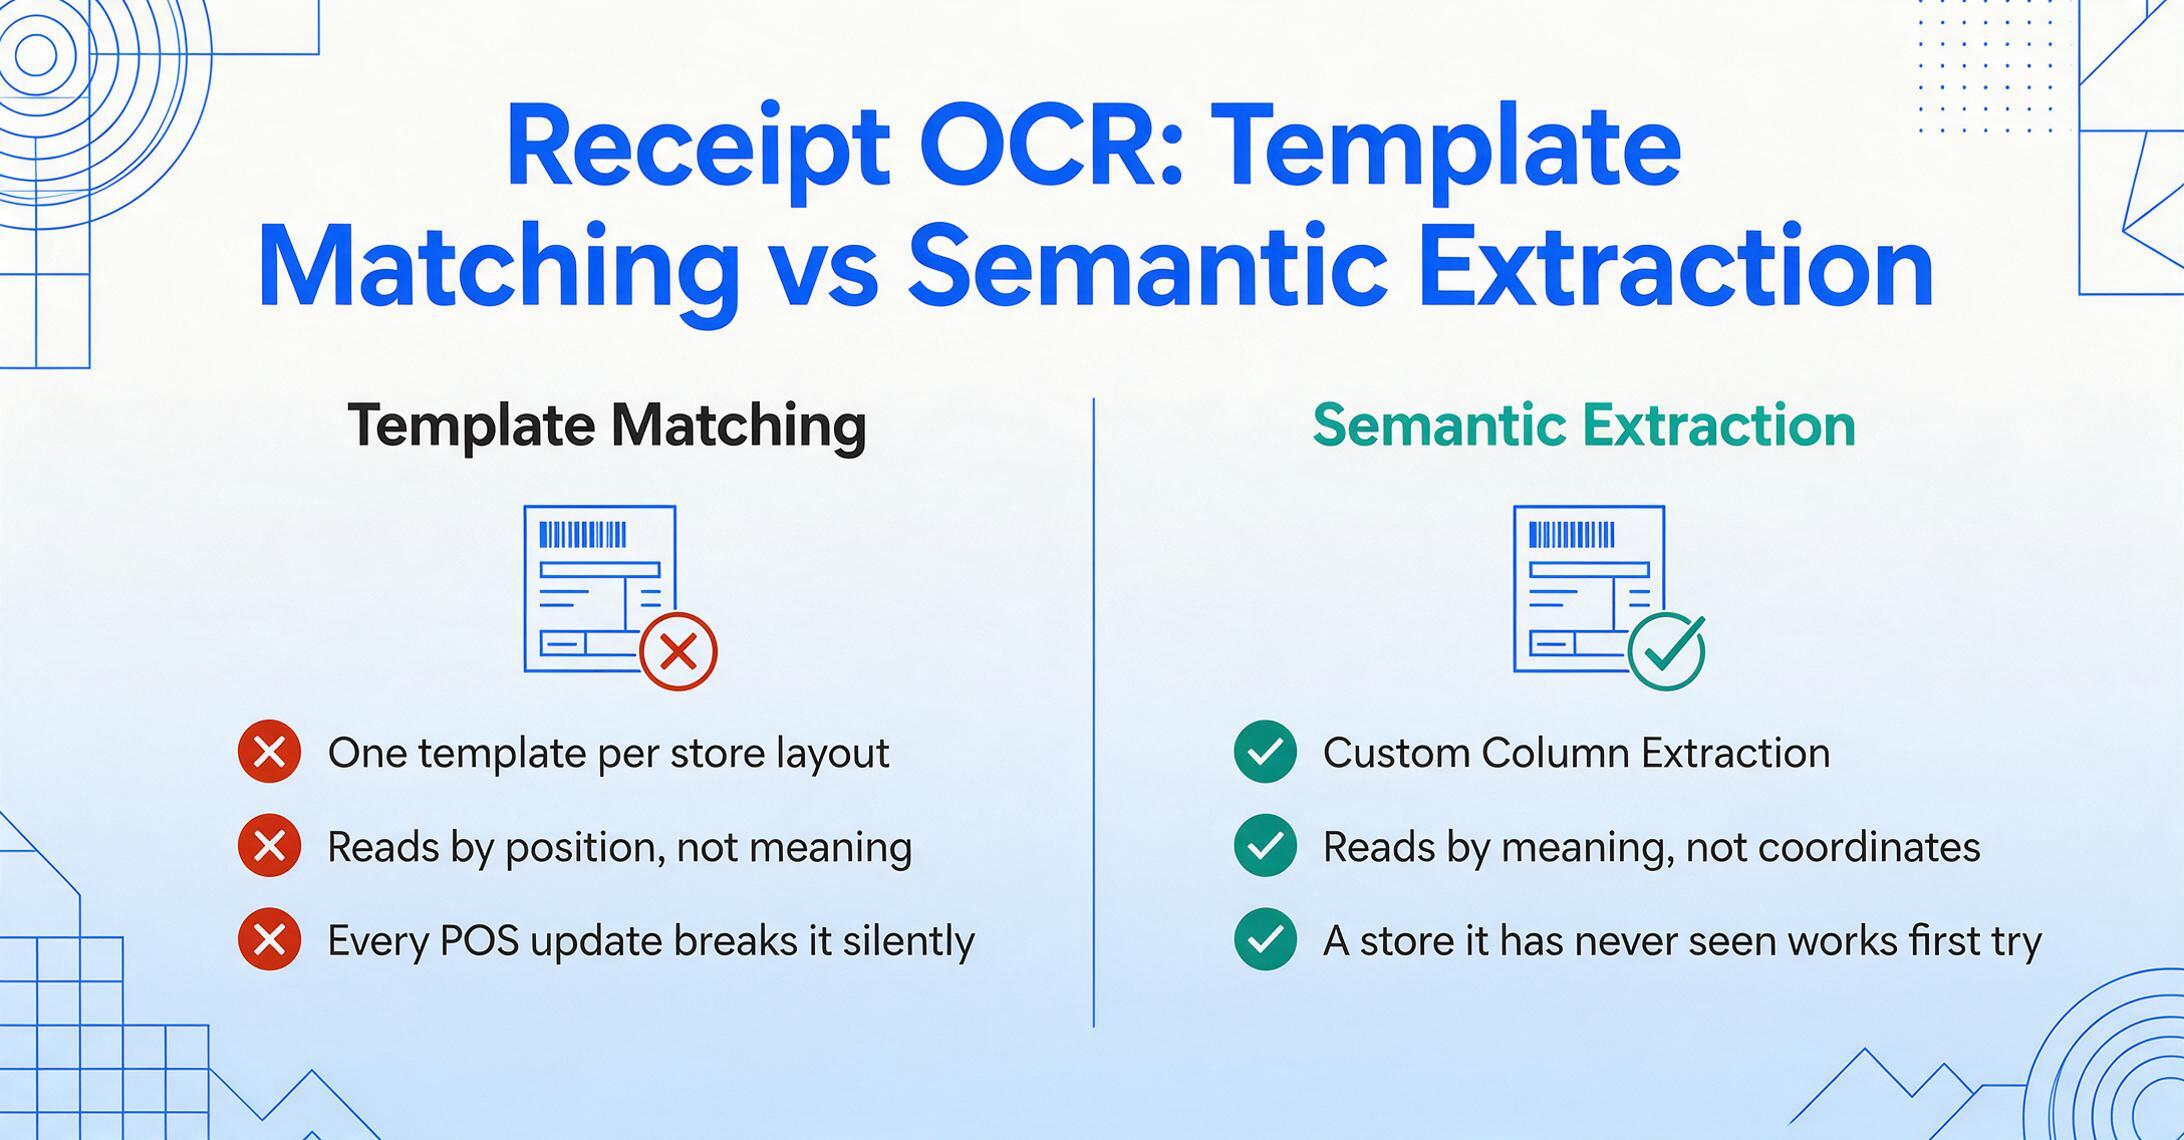
Die alte Methode: Vorlagenabgleich. Traditionelle Beleg-OCR arbeitet positionsbasiert. Sie erstellen für jedes Geschäft eine Vorlage für das Beleglayout – „Walmart-Belege haben die Summe unten rechts" – und das Tool sucht in diesem Bereich. Jedes Geschäft druckt anders. Selbst dieselbe Kette verwendet an verschiedenen Standorten unterschiedliche POS-Systeme. Eine Vorlage für ein Geschäft ist für ein anderes nutzlos, und jedes POS-Update bricht bestehende Vorlagen stillschweigend.
Die moderne Methode: semantische Extraktion. KI-basierte Beleg-OCR funktioniert, indem sie versteht, was jeder Textabschnitt bedeutet, nicht wo er steht. Das ist Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Spaltennamen ein – „Geschäftsname", „Datum", „Artikelbeschreibung", „Positionssumme" – und die KI liest den gesamten Beleg, erkennt anhand ihrer semantischen Rolle, welche Textblöcke zu welchen Feldern gehören, und ordnet sie den richtigen Ausgabespalten zu. Ein Beleg aus einem Geschäft, das sie noch nie gesehen hat, funktioniert beim ersten Versuch, weil die KI nicht auf Koordinaten schaut – sie schaut auf die Bedeutung.
Die Pipeline läuft in vier Schritten ab:
Hochladen
Fotos, Scans oder PDFs ablegen – einzeln oder in Stapeln. Funktioniert mit Handyfotos von zerknittertem oder gefaltetem Papier.
Spalten definieren
Geben Sie die gewünschten Felder ein – „Geschäftsname", „Transaktionsdatum", „Artikel", „Preis", „Kategorie". Diese werden zu Ihren Tabellenkopfzeilen. Keine Vorlageneinrichtung, kein Training.
KI liest und ordnet zu
Das Vision-Modell identifiziert jeden Textblock anhand seiner semantischen Rolle – „das sieht nach einem Datum aus", „das sind Positionszeilen" – und ordnet jeden der von Ihnen definierten Spalte zu, unabhängig von der Position.
Strukturierte Daten exportieren
Als Excel (XLSX), CSV herunterladen oder direkt in Google Sheets schreiben. Jeder Beleg wird zu einer Zeile – oder mehreren Zeilen, wenn Positionszeilen einzeln extrahiert werden.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wann Sie Beleg-OCR benötigen
Nicht jede Situation erfordert Extraktionssoftware. Beleg-OCR wird ab diesen Schwellenwerten von „nice to have" zu „notwendig":
1. Die Steuersaison wird kein Wochenendprojekt mehr. Die NFIB hat herausgefunden, dass 42 % der kleinen Arbeitgeber vier oder mehr Stunden pro Monat für Steuer-Compliance-Papierkram aufwenden. SCORE berichtet, dass die Mehrheit mehr als 41 Stunden jährlich für die Steuervorbereitung aufwendet, wobei die Belegorganisation den größten Anteil ausmacht. Wenn das Sortieren von Belegen zu einer wiederkehrenden Belastung jedes Wochenende wird, verändern Extraktionstools die Gleichung von Stunden des Tippens zu Minuten der Überprüfung.
2. Die IRS (US-Steuerbehörde)-Schwelle holt Sie ein. Gemäß IRS Publication 463 erfordern Geschäftsausgaben von $75 oder mehr einen Belegnachweis (§1.274-5(c)(2)(iii)) – eine Quittung, nicht nur ein Kontoauszug. Diese Schwelle erfasst eine Tankfüllung, ein Software-Abonnement, ein Kundenessen. Bei Unterkünften sind Belege unabhängig vom Betrag erforderlich. Ein Freiberufler, der für jede Transaktion über dieser Schwelle saubere, datierte, kategorisierte Belege vorlegen kann, geht vorbereitet in eine Prüfung. Wer das nicht kann, streitet über Ausgaben, die er nicht belegen kann.
3. Belege verblassen, bevor Sie sie erfassen können. Thermopapier beginnt innerhalb von Wochen zu verblassen. Aus einem leeren Zettel können Sie keine Daten wiederherstellen. Die einzige zuverlässige Lösung besteht darin, die Daten zu erfassen und zu extrahieren, solange der Beleg noch lesbar ist. Für Aufzeichnungen, die die IRS (US-Steuerbehörde) empfiehlt, drei Jahre aufzubewahren, vergrößert sich die Lücke zwischen „Beleg ist lesbar" und „Beleg ist Beweis" mit jedem Monat, in dem die Daten auf Papier bleiben.
4. Sie müssen Belege auf Ausgabenkategorien aufteilen. Ein einziger Einkauf im großen Einzelhandelsgeschäft kann Büromaterial (absetzbar) und einen persönlichen Snack (nicht absetzbar) umfassen. Abgeleitete Spalten ermöglichen es Ihnen, eine Kategorisierungsregel zu definieren – „klassifizieren Sie jeden Artikel als Büromaterial, Mahlzeiten oder Kosten der verkauften Waren" – und die KI wendet sie während der Extraktion an, wodurch eine manuelle zeilenweise Beurteilung zu einem einzigen Durchgang wird. Für eine Schritt-für-Schritt-Anleitung, wie dies in einen Steuer-Workflow passt, lesen Sie unseren Leitfaden zur Belegvorbereitung für die Steuersaison.
Für einen breiteren Blick auf die Technologie lesen Sie unseren Leitfaden zur KI-Dokumentextraktion. Und für die finanzielle Aufschlüsselung quantifiziert unsere Analyse der Kosten manueller Belegverfolgung zur Steuerzeit die Arbeits- und Abzugsverluste.
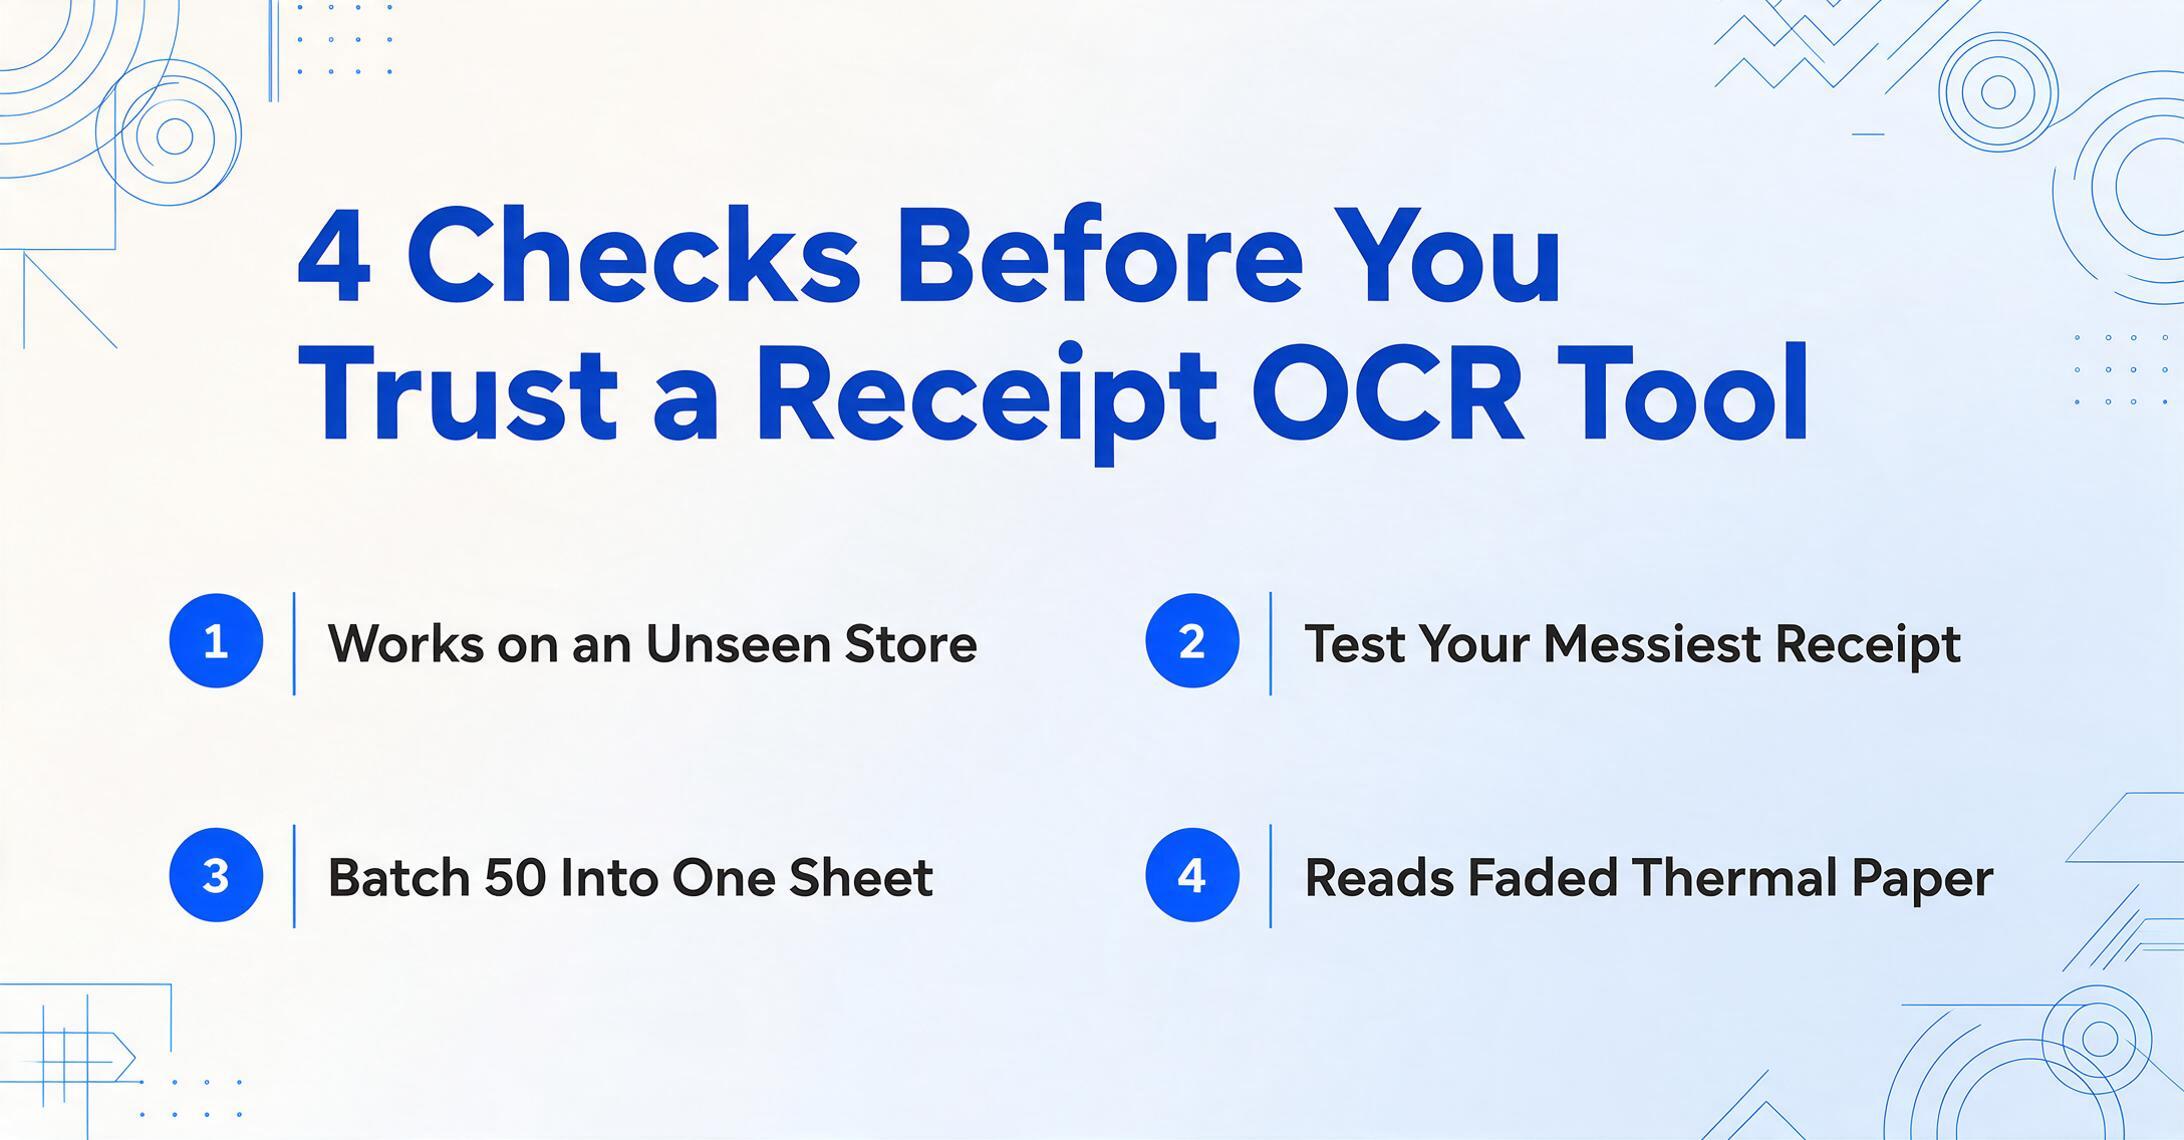
Worauf Sie bei einem Beleg-OCR-Tool achten sollten
Beleg-OCR-Tools reichen von Smartphone-Apps, die drei Felder extrahieren, bis hin zu KI-nativen Plattformen, die Batch-Verarbeitung und benutzerdefinierte Spalten unterstützen. Einige Kriterien trennen Tools, die die Arbeitslast reduzieren, von Tools, die sie nur umbenennen.
Ohne Vorlage. Das mit Abstand wichtigste Unterscheidungsmerkmal. Ein Tool, das für jedes Geschäftslayout eine Vorlage benötigt, ist keine Extraktion – es ist Vorlagenverwaltung. Ohne Vorlage funktioniert die Extraktion durch semantisches Verständnis: Ein Beleg von einem Geschäft, das das Tool noch nie gesehen hat, funktioniert beim ersten Hochladen. Fragen Sie: „Wenn ich einen Beleg von einem Geschäft hochlade, das ich noch nie verarbeitet habe, funktioniert das?“ Wenn die Antwort „eine Vorlage definieren“ beinhaltet, kaufen Sie Wartung.
Qualität der Positionsextraktion. Kopffelder sind der einfache Teil. Positionen sind der eigentliche Test – kann das Tool Artikellbeschreibungen, Mengen und Preise zuverlässig aus einem dicht bedruckten Einzelhandelsbeleg mit abgeschnittenen Namen und rechtsbündigen Preisen extrahieren? Testen Sie mit Ihren chaotischsten Belegen, nicht mit Ihren saubersten. Für einen direkten Vergleich sehen Sie sich unsere Übersicht der Belegscan-Tools an.
Batch-Verarbeitung. 50 Belege einzeln zu verarbeiten ist nicht wesentlich schneller als manuelle Eingabe, wenn man den Interaktionsaufwand mit dem Tool berücksichtigt. Batch-Verarbeitung – 50 auf einmal hochladen, eine einheitliche Tabelle erhalten – ist der Punkt, an dem sich Zeitersparnisse summieren.
Belegspezifische Sonderfälle. Belege in mehreren Währungen von internationalen Reisen. Handschriftliche Trinkgelder auf gedruckten Belegen. Thermopapier, das bereits teilweise verblasst ist. Zerknitterte Belege aus der Brieftasche. Ein Tool, das saubere, flache Belege verarbeitet, aber bei diesen realen Fällen versagt, erzeugt einen zweistufigen Workflow: automatisiert für die einfachen, manuell für die schwierigen.
Für einen tieferen Einblick in die Formatunabhängigkeit bei Belegen lesen Sie unseren Leitfaden zum Extrahieren von Belegdaten aus jedem Format.
Häufig gestellte Fragen
Funktioniert die Beleg-OCR mit verblassten oder zerknitterten Belegen?
Ja, mit Einschränkungen. KI-gestützte Tools verarbeiten mäßige Verblassungen, Knicke und Falten, da sie Kontext und Form lesen, nicht nur einzelne Zeichen. Ein teilweise verblasster Beleg, der für einen Menschen noch lesbar ist, ist in der Regel auch für die KI lesbar. Aber sobald Thermopapier vollständig verblasst ist, kann kein Tool die Daten wiederherstellen. Erfassen und extrahieren Sie Belegdaten so schnell wie möglich – das Warten bis zur Steuersaison ist ein Wettlauf gegen die Chemie.
Akzeptiert der IRS (US-Steuerbehörde) digitale Belegscans als gültige Aufzeichnungen?
Ja. Gemäß IRS Publication 583 umfassen Belege "Kassenbons", "Kontoauszüge" und "Kreditkartenbelege" – alle in digitaler Form akzeptiert, sofern lesbar und mit Betrag, Datum und geschäftlichem Zweck. Der IRS verlangt keine physischen Papieroriginale.
Kann die Beleg-OCR handschriftliche Trinkgelder oder Notizen auf gedruckten Belegen verarbeiten?
Ja. Moderne Vision-Modelle lesen Handschrift – einschließlich Trinkgeldern auf Restaurantbelegen und manueller Anpassungen – im selben Durchgang wie gedruckten Text. Die Genauigkeit hängt von der Lesbarkeit ab: Klare Druckschrift wird zuverlässig extrahiert, dichte Schreibschrift weniger. Die KI nutzt den Kontext zur Disambiguierung: Wenn sie ein handschriftliches "$12.00" in der Nähe eines gedruckten "Trinkgeld:"-Labels sieht, versteht sie, dass dies der Trinkgeldbetrag ist.
Wie hoch ist die Genauigkeitsrate der Beleg-OCR?
Moderne KI-basierte Beleg-OCR erreicht eine Feldgenauigkeit von 95–99 % bei gedruckten, lesbaren Belegen. Manuelle Dateneingabefehler liegen bei 1–3 % pro Feld – das bedeutet, dass ein Beleg mit 15 Feldern eine Wahrscheinlichkeit von etwa 14–36 % hat, mindestens einen Tippfehler zu enthalten. Der entscheidende Unterschied: OCR-Fehler sind in einer Tabelle zur Überprüfung sichtbar; ein manuell eingegebener Fehler ist unsichtbar, es sei denn, Sie überprüfen jede Zelle doppelt.
Kann die Beleg-OCR mehrere Währungen verarbeiten?
Ja, wenn das Tool semantisches Verständnis nutzt. Ein internationaler Beleg kann Beträge in einer Fremdwährung mit einem Umrechnungshinweis zeigen. Ein positionsbasiertes Tool könnte die Zahl an der üblichen Stelle greifen. Ein semantisches Tool liest Währungssymbole und -beschriftungen, um "Summe in THB" von "Referenz in USD" zu unterscheiden.
Wie unterscheidet sich die Beleg-OCR von der Rechnungsdatenextraktion?
Sie nutzen dieselbe Technologie – KI-basierte semantische Extraktion –, zielen aber auf unterschiedliche Dokumentstrukturen ab. Rechnungen sind formelle Geschäftsdokumente mit relativ konsistenten Feldbezeichnungen. Belege sind verbraucherorientiert mit stark inkonsistenten Bezeichnungen: Eine Summe kann als "TOTAL", "AMOUNT DUE", "BALANCE" oder nur als Zahl unten ohne Label erscheinen. Die Belegextraktion ist das schwierigere Problem. Siehe unseren Leitfaden zur Rechnungsdatenextraktion.
Brauche ich Beleg-OCR, wenn ich bereits QuickBooks oder Xero nutze?
QuickBooks und Xero bieten eine Belegfoto-Erfassung, die Händler, Datum und Gesamtbetrag extrahiert – nützlich für die einfache Ausgabenerfassung. Sie extrahieren jedoch keine Positionen, sodass Sie einen Beleg nicht auf mehrere Kategorien aufteilen können, und sie liefern keine eigenständige Tabelle mit allen Belegdaten. Beleg-OCR ergänzt Buchhaltungssoftware, indem es detailliertere Daten auf Positionsebene in sie einspeist. Den Workflow finden Sie in unserem Leitfaden zum Aufbau einer Beleg-zu-Schedule-C-Pipeline.
So geht es weiter
Beleg-OCR schließt die Lücke zwischen dem Druck eines Belegs und der Erfassung seiner Daten in Ihrer Buchhaltung. Thermopapier verblasst. Die IRS (US-Steuerbehörde) verlangt Belege als Nachweis. Manuelle Eingabe kostet Zeit – $32.23 pro Stunde laut Bureau of Labor Statistics. Die Werkzeuge, um diese Lücke zu schließen, existieren – und anders als noch vor zwei Jahren funktionieren sie ohne Vorlagen, ohne Training und bei jedem Belegformat.
Der beste Weg, um zu prüfen, ob Beleg-OCR zu Ihrem Arbeitsablauf passt, ist ein Test mit Ihren echten Belegen – besonders mit den schwierigen: dem verblassten Thermobeleg, dem zerknitterten Restaurantbeleg mit handschriftlichem Trinkgeld, dem internationalen Duty-Free-Bon. Laden Sie einen Beispielbeleg hoch und sehen Sie, welche strukturierten Daten Sie zurückerhalten – oder starten Sie mit unserer Schritt-für-Schritt-Anleitung zur Belegdatenextraktion.