Como Extrair Campos Específicos de Qualquer Documento —
Foto, Digitalização ou PDF
A pergunta quase nunca é "um computador consegue ler este documento." O OCR lê documentos de forma confiável há décadas. A pergunta que realmente importa — e que a maioria das ferramentas ainda não responde bem — é: ele consegue me dar apenas os campos que preciso, estruturados do jeito que preciso, independentemente de como o documento é formatado? Esse é um problema diferente, e exige uma abordagem diferente.
Principais Conclusões
- 99% de precisão em um único modelo de fatura parece impressionante — mas o gargalo real não é a precisão em um layout, é se a ferramenta funciona no próximo layout sem que você diga onde cada campo se moveu.
- Digite "Data de Vencimento" e a IA encontra "Pagamento Devido", "Pagar Até" ou até "Net 30" (e calcula a data real) — porque ela entende o significado, não apenas a correspondência de texto.
- Transforme 50 faturas de 15 fornecedores diferentes — PDFs, digitalizações e fotos de celular misturados — em um único arquivo Excel limpo em menos de 10 minutos com ImageToTable.ai, sem configuração por fornecedor.
OCR vs. Extração de Campos: Qual é a Diferença Real
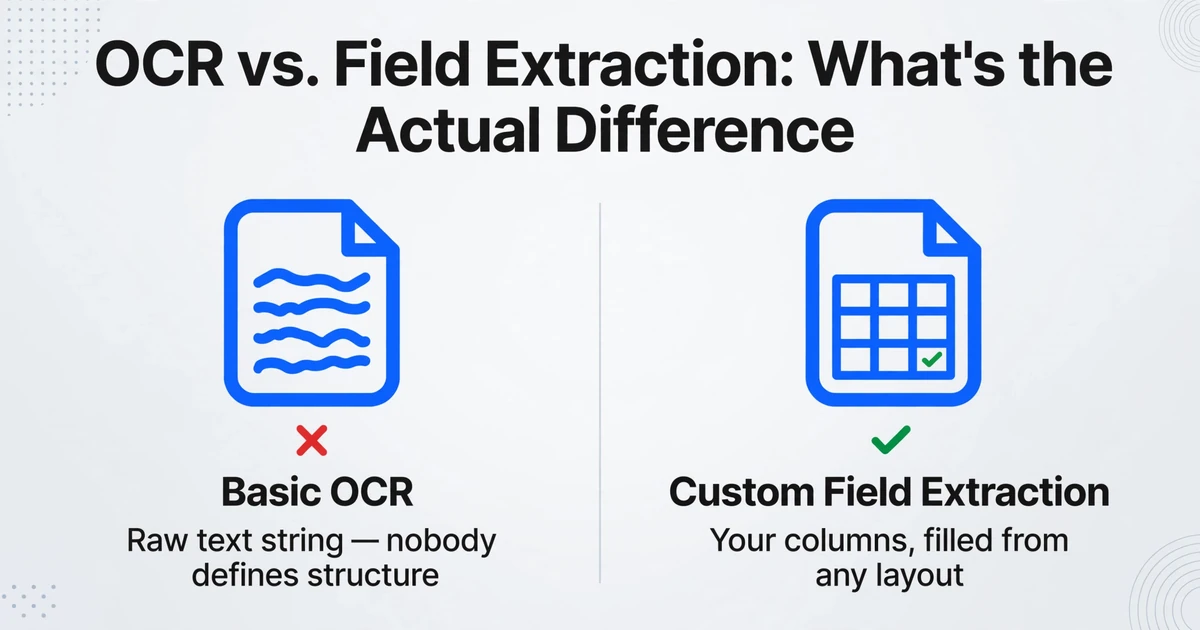
OCR — reconhecimento óptico de caracteres — converte uma imagem de texto em caracteres legíveis por máquina. Dê a ele uma foto de um recibo e ele retorna uma string de texto que espelha o que está impresso no papel. Essa saída é genuinamente útil: é pesquisável, copiável e pode ser alimentada em outros sistemas. Mas não tem consciência do que o texto significa ou de quais partes você se importa.
Extração de campos específicos parte de uma premissa diferente. Em vez de perguntar "que texto está neste documento", você pergunta "que valores este documento tem para os campos que defini". A saída não é uma transcrição — é um conjunto de dados estruturado onde seus nomes de coluna são os cabeçalhos e o conteúdo do documento preenche as linhas.
| Abordagem | Entrada | Saída | Quem define a estrutura |
|---|---|---|---|
| OCR básico | Imagem / PDF | String de texto bruto | Ninguém — despejo de texto plano |
| Conversor de PDF para Excel | Tabela espelhando o layout original | O próprio documento | |
| Extrator baseado em modelo | PDF / imagem | Campos predefinidos (Nº da Nota, Data, Total…) | O fornecedor do software |
| Extração de campos personalizados | Qualquer formato | Suas colunas, preenchidas a partir de qualquer layout | Você |
Os nomes das colunas que você digita se tornam os cabeçalhos da sua tabela de saída. O trabalho da IA é localizar o valor correspondente em cada documento — independentemente de onde ele apareça, de como o documento o chame ou do formato do arquivo.
O que conta como "qualquer documento"
A abordagem funciona com uma gama mais ampla de tipos de entrada do que a maioria das ferramentas de documento suporta, porque a tecnologia subjacente é um modelo de visão de grande escala, e não um parser de formato. Ela lê imagens como um humano — entendendo o conteúdo, não decodificando a estrutura do arquivo.
Formatos de entrada compatíveis
PDFs digitais
PDFs com camada de texto de qualquer software — sistemas contábeis, exportações de ERP, Word para PDF, etc.
Documentos digitalizados
Saída de scanner de escritório, arquivos digitalizados, documentos enviados por fax salvos como PDF ou imagem.
Fotos de documentos
Fotos de recibos, notas fiscais, formulários, quadros brancos e tabelas impressas tiradas pelo celular. É necessária iluminação adequada.
Capturas de tela
Capturas de tela de páginas da web, painéis, interfaces de sistemas, confirmações de pagamento e resumos de pedidos.
Documentos manuscritos
Formulários manuscritos, anotações de campo, documentos em papel assinados. A precisão varia conforme a caligrafia e a qualidade da digitalização.
Tipos de documentos compatíveis
Como funciona a nomeação de colunas na prática
Os nomes de colunas que você fornece funcionam como instruções semânticas para a IA. Você não precisa saber onde um campo aparece na página, como o documento o rotula ou se a informação é explícita ou implícita. Nomes de campos em linguagem simples são suficientes.
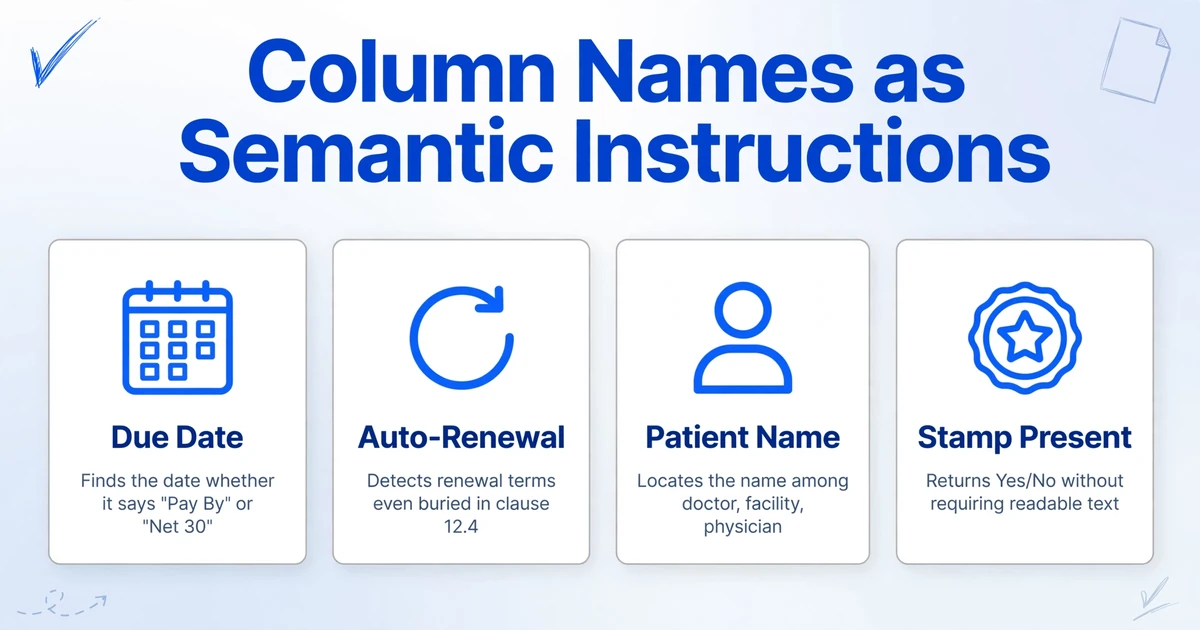
Alguns exemplos de como a IA interpreta os nomes das colunas:
Encontra a data de vencimento do pagamento, quer a fatura diga "Due Date", "Payment Due", "Pay By" ou a declare implicitamente como "Net 30 from invoice date" (caso em que calcula a data).
Identifica se um contrato renova automaticamente — independentemente de isso estar em uma cláusula de "Renewal", em uma seção de "Term" ou escondido na cláusula 12.4 da página 18.
Localiza o nome do paciente em um relatório de laboratório ou resumo de alta, mesmo quando cercado por outros nomes (médico, instituição, médico encaminhador).
Detecta se um selo ou carimbo oficial está visível no documento — retorna Sim/Não sem exigir que o carimbo contenha texto específico.
Se um campo não estiver presente em um documento, a célula fica em branco. A IA não substitui por um campo relacionado nem inventa um valor. Uma célula vazia é uma informação precisa — ela indica que o documento não contém esses dados.
Documento Único vs. Lote: Mesmas Colunas, Muitos Arquivos
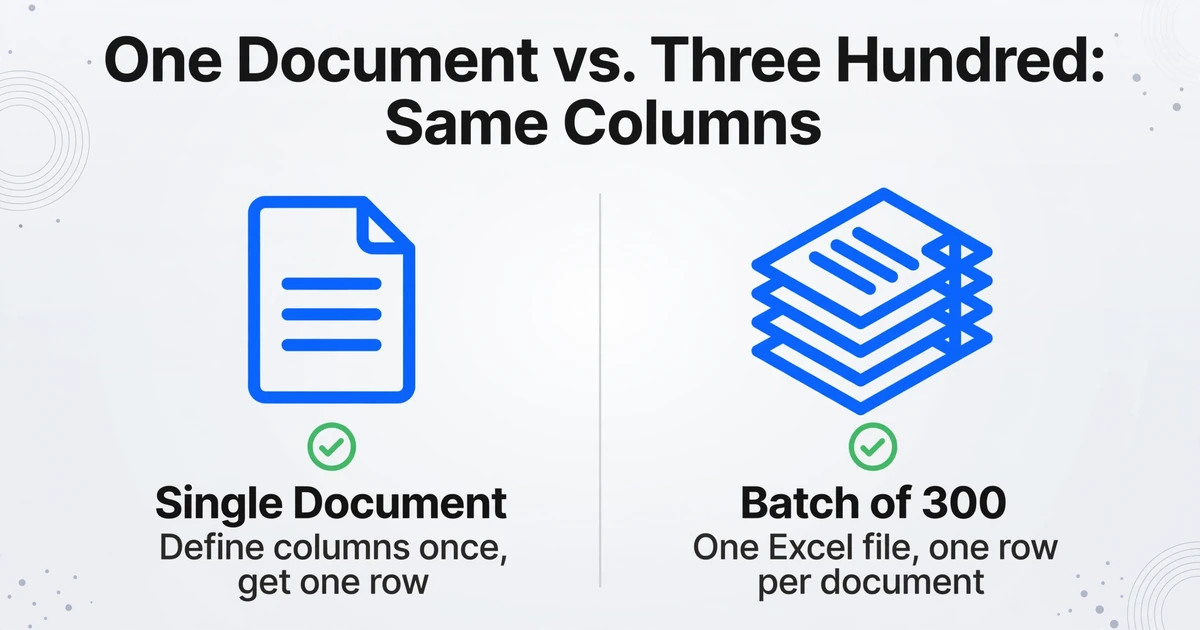
A mesma abordagem de nomes de colunas funciona tanto para processar um documento quanto trezentos. No modo lote, você envia todos os arquivos juntos, define suas colunas uma vez e recebe um único arquivo Excel em que cada linha é um documento e cada coluna é um dos campos especificados.
É aqui que a flexibilidade entre formatos se torna praticamente significativa. Um lote do mundo real raramente consiste em documentos idênticos. Um mês de faturas de fornecedores inclui PDFs digitais de grandes fornecedores, faturas em papel escaneadas de menores e fotos de recibos de equipes de campo. Uma rodada de coleta de dados de pacientes inclui laudos de laboratório impressos, formulários de admissão preenchidos à mão e capturas de tela exportadas do sistema. Enviar tudo junto e obter uma tabela consistente do outro lado é o objetivo.
Velocidade de processamento: 5–10 segundos por página. Um lote de 50 documentos de uma página termina em menos de 10 minutos. Documentos de várias páginas (contratos, relatórios) levam proporcionalmente mais tempo com base no número de páginas.
Casos de Uso Comuns por Tipo de Documento
A seguir estão os cenários mais comuns em que a extração de campos personalizados substitui a entrada manual de dados. Cada um leva a um guia de fluxo de trabalho mais detalhado para aquele tipo de documento.
Faturas e Recibos
Extraiga Nome do Fornecedor, Nº de Fatura, Data, Referência PO, Impostos, Total — de qualquer formato de fornecedor, qualquer layout. Uma linha por fatura.
Contratos e Acordos
Extraiga Partes, Valor do Contrato, Data de Vigência, Vencimento, termos de Renovação Automática, Legislação Aplicable de um lote de acordos de fornecedores.
Cotações de Fornecedores e RFQs
Converta PDFs de cotações de fornecedores em uma tabela de comparação — Preço Unitário, MOQ, Prazo de Entrega, Condições de Pagamento — de todos os fornecedores em um único lote.
Processamento de AP/Gastos em Lote
Processe 40–200 faturas ou recibos de gastos em uma única execução. Uma planilha, uma linha por documento, pronta para colar no seu rastreador de AP.
Direto ao Google Sheets
Use o add-on da barra lateral do Google Sheets para enviar, especificar campos e anexar os dados extraídos diretamente — sem baixar um arquivo.
Formulários Manuscritos e Listas de Verificação
Extraia campos de formulários de admissão manuscritos, listas de verificação de inspeção e pesquisas em papel — incluindo detecção de caixas de seleção e assinaturas.
Precisão e Limitações Honestas
Para texto impresso em documentos claros — PDFs digitais, digitalizações de boa qualidade, fotos bem iluminadas — a precisão do reconhecimento chega a até 99%. Isso cobre a maioria dos fluxos de trabalho profissionais. Alguns cenários merecem atenção antes de você depender disso em produção:
Alta precisão
- PDFs digitais de qualquer fonte
- Digitalizações de escritório a 300 DPI ou mais
- Fotos de celular com boa iluminação e desfoque mínimo
- Capturas de tela em resolução padrão
- Documentos multilíngues — em qualquer idioma
- Campos claramente declarados com significado padrão
Precisão reduzida ou fora do escopo
- Caligrafia densa ou letra ilegível
- Digitalizações de baixa resolução, sombras fortes, inclinação extrema
- Campos definidos por referências cruzadas ou cronogramas complexos
- Interpretação jurídica de linguagem contratual ambígua
- Tarefas de raciocínio ("isso é um bom negócio?")
Perguntas Frequentes
Preciso configurar algo antes de enviar um novo tipo de documento?
Não. Não há modelos para configurar nem preparação específica por tipo de documento. Envie qualquer documento, digite os nomes das suas colunas em linguagem simples, e a IA cuida do resto. A mesma interface funciona para faturas, contratos, formulários e fotos de anotações manuscritas.
Posso misturar diferentes tipos de documento no mesmo lote?
Sim. Um único lote pode conter faturas junto com recibos, ou contratos junto com PDFs de orçamentos. Cada arquivo gera uma linha. Se uma coluna não se aplica a um determinado tipo de documento, essa célula fica em branco. Lotes com formatos mistos (PDFs, digitalizações, imagens) também funcionam no mesmo envio.
Quais formatos de arquivo são aceitos?
PDF, JPG, PNG, WebP e AVIF. Isso cobre PDFs digitais, documentos digitalizados salvos em qualquer um desses formatos de imagem, fotos de celular e capturas de tela. Não é necessário converter arquivos para um formato específico antes do envio.
Quão específicos podem ser os nomes das minhas colunas?
Bastante específicos. "Preço Unitário do Item A (por kg, sem IVA)" é um nome de coluna válido, e a IA tentará corresponder a esse nível de especificidade. Nomes de coluna mais específicos geralmente produzem resultados mais limpos, pois a IA tem um alvo mais claro. Nomes ambíguos como "Valor" podem capturar coisas diferentes entre tipos de documento distintos — nomes mais específicos como "Total da Fatura (com impostos)" são melhores.
Quais formatos de saída estão disponíveis?
Excel (XLSX), CSV e JSON. Para a maioria dos fluxos de trabalho com planilhas, XLSX é o padrão. CSV funciona para importar em bancos de dados ou outros sistemas. JSON está disponível para desenvolvedores que integram a extração em pipelines automatizados.
Existe uma forma de coletar documentos de outras pessoas antes de extrair?
Sim. Você pode gerar um Link de Coleta — uma URL compartilhável — e enviá-lo para equipe de campo, clientes ou membros do time. Eles abrem o link, inserem um código de verificação curto e enviam os arquivos diretamente. Sem necessidade de conta para eles. Os arquivos chegam automaticamente à sua fila de processamento. Útil para reunir recibos de despesas, fotos de inspeção ou documentos de clientes antes de executar uma extração em lote.
Qualquer documento. Suas colunas. Saída estruturada.
Envie uma foto, digitalização ou PDF — digite os campos que você precisa — baixe um arquivo Excel limpo. Sem configuração, sem modelos, sem restrições de formato.