Por que a IA lê sua escrita manual perfeitamente
Mas ainda não detecta uma caixa marcada
Um desenvolvedor no forum da OpenAI passou três semanas construindo um pipeline de processamento de solicitudes de empréstito. A IA extraiu todos os campos manuscritos — nomes de prestatários, endereços de propriedades, montos de empréstitos — com precisão quase perfeita. Então chegou a sección de caixas de selección: "Ocupación: Residencia Principal / Segunda Vivienda / Propiedad de Inversión." O modelo não devolvió nada. Tres botones de opción, claramente visibles, uno marcado. GPT-4 Vision os olhou e não viu ninguna selección. Un hilo que documenta esta lucha exacta atrajo a decenas de desarrolladores enfrentando la misma pared: su IA podía leer la letra de un médico pero no podía decir si una caja tenía una marca de verificación.
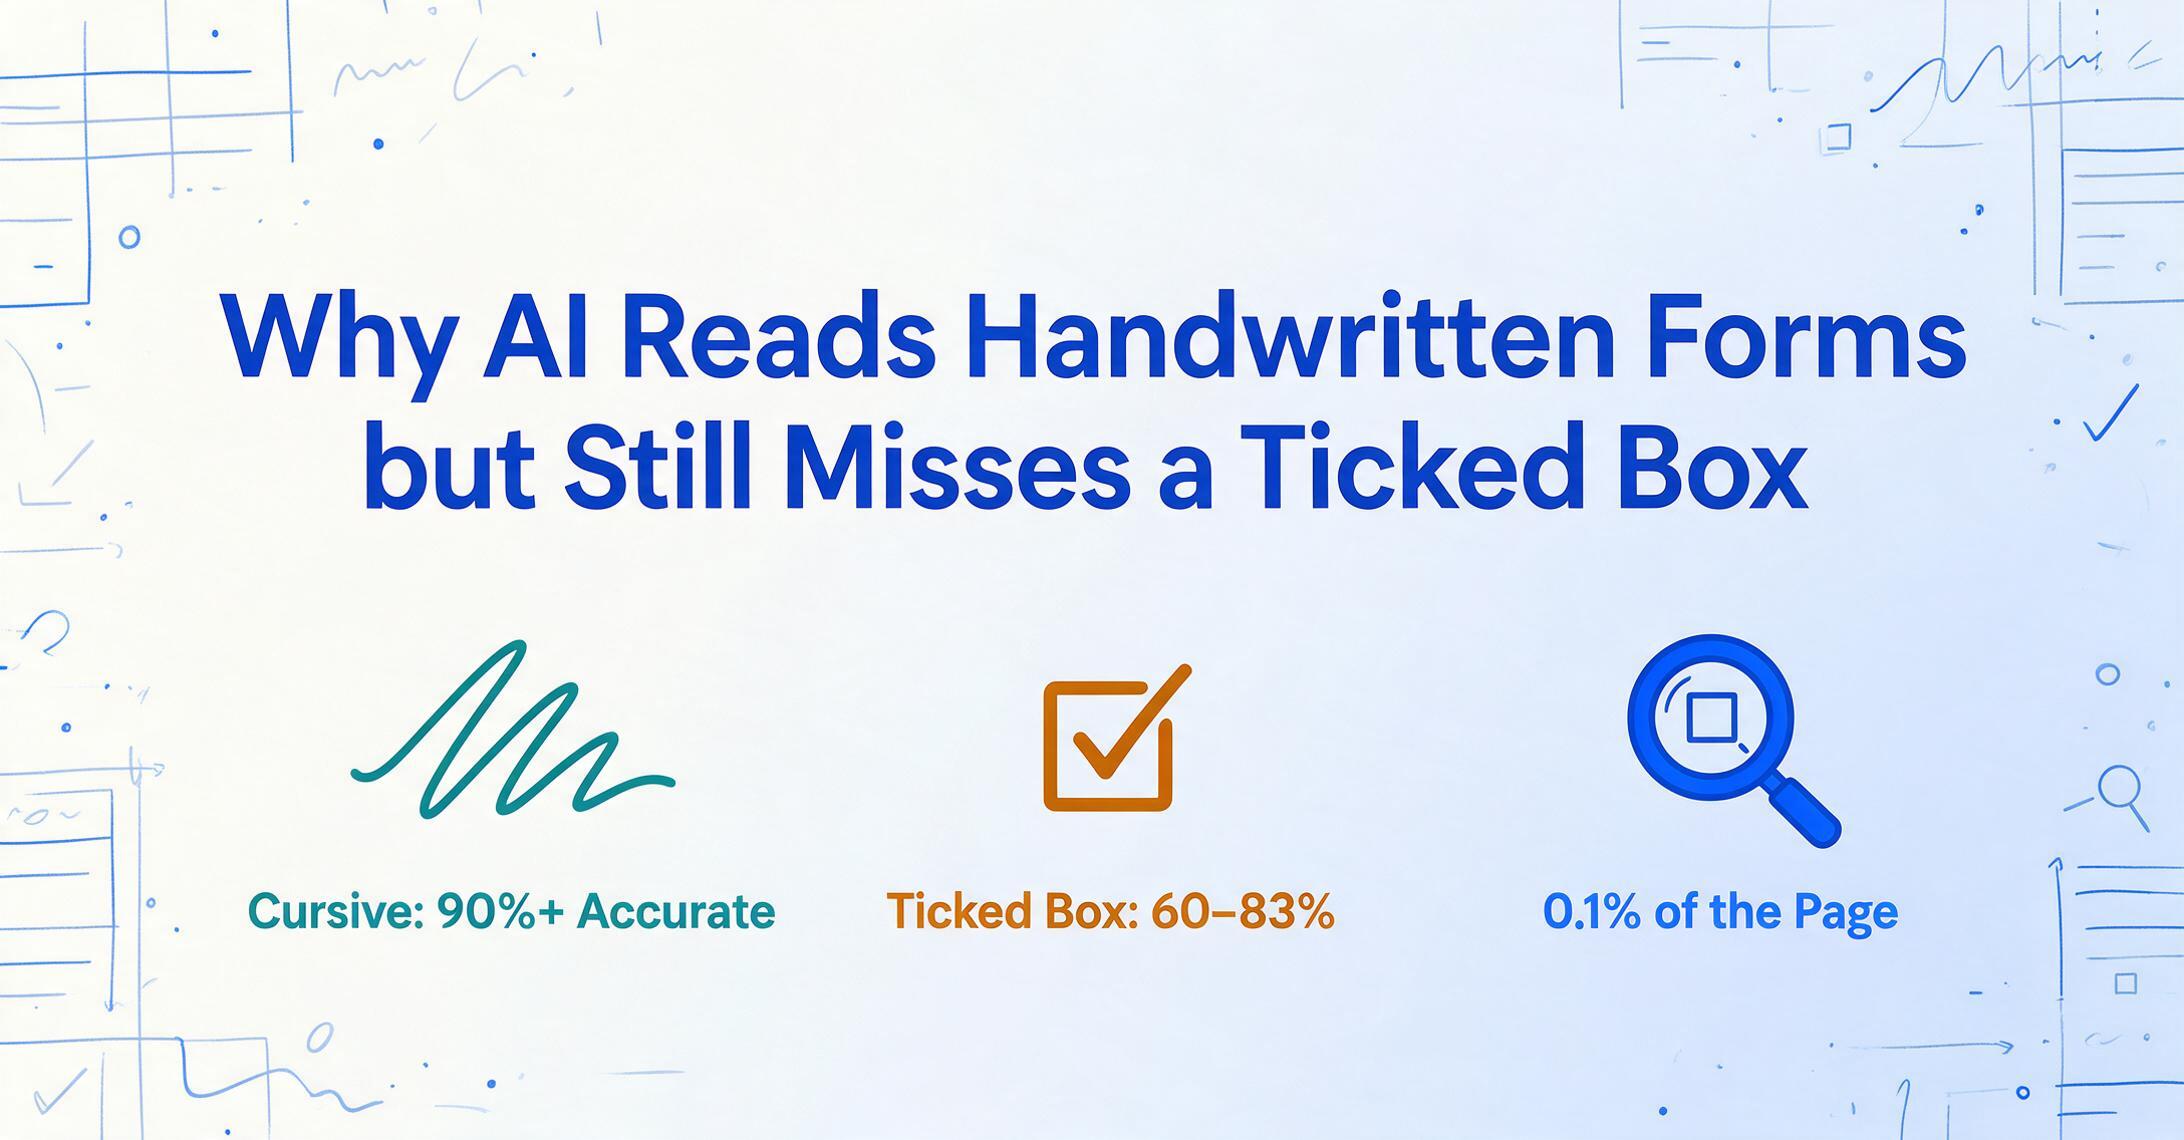
Esse paradoxo — texto é fácil, marcas são difíceis — define o estado atual da IA de processamento de formulários. E entender por que ele existe é a chave para escolher ferramentas que realmente funcionam nos formulários que você precisa processar, não apenas nas demonstrações que elas mostram.
Por que seu OCR lê cada palavra — e ignora cada caixa de seleção
Para entender o problema das caixas de seleção, você precisa entender o que acontece dentro de um pipeline de OCR tradicional — e onde a informação visual se perde.
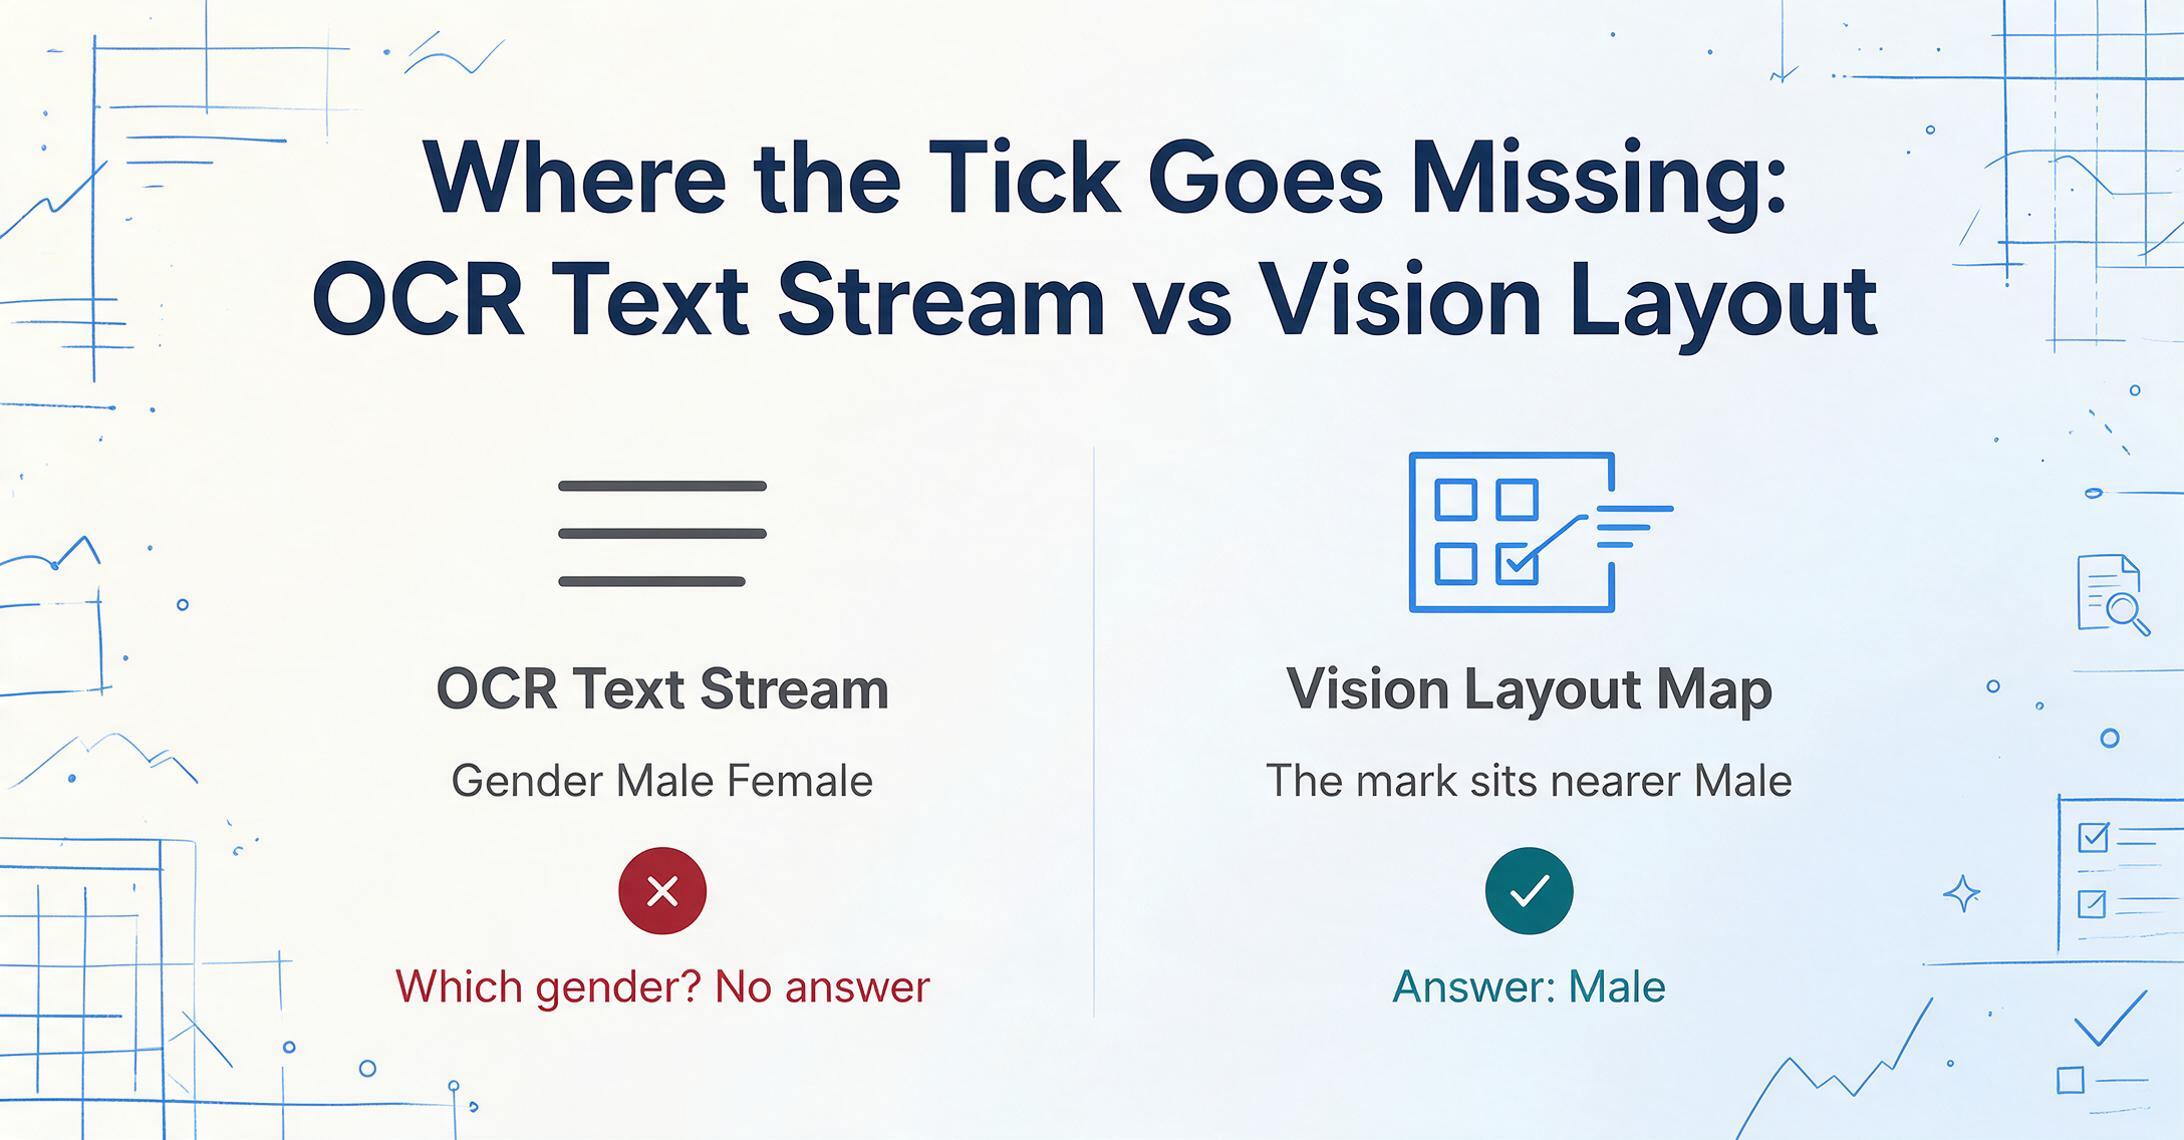
O reconhecimento óptico de caracteres funciona digitalizando uma página, detectando regiões de texto e convertendo padrões de pixels em códigos de caracteres. Um "W" em um documento digitalizado é um arranjo específico de pixels claros e escuros; o mecanismo de OCR corresponde esse padrão a um formato de letra conhecido. Isso funciona razoavelmente bem para texto impresso e, com mecanismos de OCR modernos baseados em aprendizado profundo, cada vez melhor para escrita manual.
Mas aqui está a falha crítica: o OCR vê uma caixa de seleção com uma marca — e não tem nenhum caractere para mapear. Uma marca de visto não é um "V" e não é um "✓" em nenhum conjunto de caracteres que o mecanismo reconheça. O OCR ou a ignora completamente ou gera lixo: um símbolo aleatório, uma string vazia, um caractere mal interpretado.
Mesmo quando o OCR captura a marca como algo, a relação espacial entre a marca e seu rótulo se perde. O pipeline gera um fluxo de texto plano: "Gênero Masculino Feminino Idade 34 Tipo Sanguíneo A+." Qual gênero foi selecionado? O fluxo não dá nenhuma indicação. O layout visual — o fato de uma marca estar mais próxima de "Masculino" do que de "Feminino" — foi descartado no momento em que o OCR converteu a página em texto. É por isso que uma abordagem baseada em OCR para processamento de formulários falha consistentemente em caixas de seleção, botões de opção e qualquer formato de dados onde a posição carrega significado.
Como a IA de Visão Le a Página Inteira — Não Só o Texto Escrito Nela
Os modelos de linguagem visual (VLMs) — a classe de IA que impulsiona as ferramentas modernas de extração de documentos — mudam a abordagem fundamentalmente. Em vez de converter imagem em texto e depois raciocinar sobre o texto, um VLM processa a imagem do documento diretamente. Ele vê o layout, as relações espaciais, os gestos visuais. Quando você perguntar "qual caixa de seleção está marcada?", ele olha a página do mesmo modo que uma pessoa faria: localizando cada caixa, examinando se contém uma marca e associando essa marca ao texto do rótulo mais próximo.
Essa abordagem visual em primeiro lugar é o que torna possível processar formulários manuscritos. Um VLM não precisa que a marca de verificação seja um caractere — só precisa reconhecer "há tinta dentro desta região retangular" versus "esta região está vazia". O modelo aprende essa distinção a partir de dados de treinamento que incluem milhões de imagens de documentos com anotações sobre quais campos estão preenchidos e quais não.
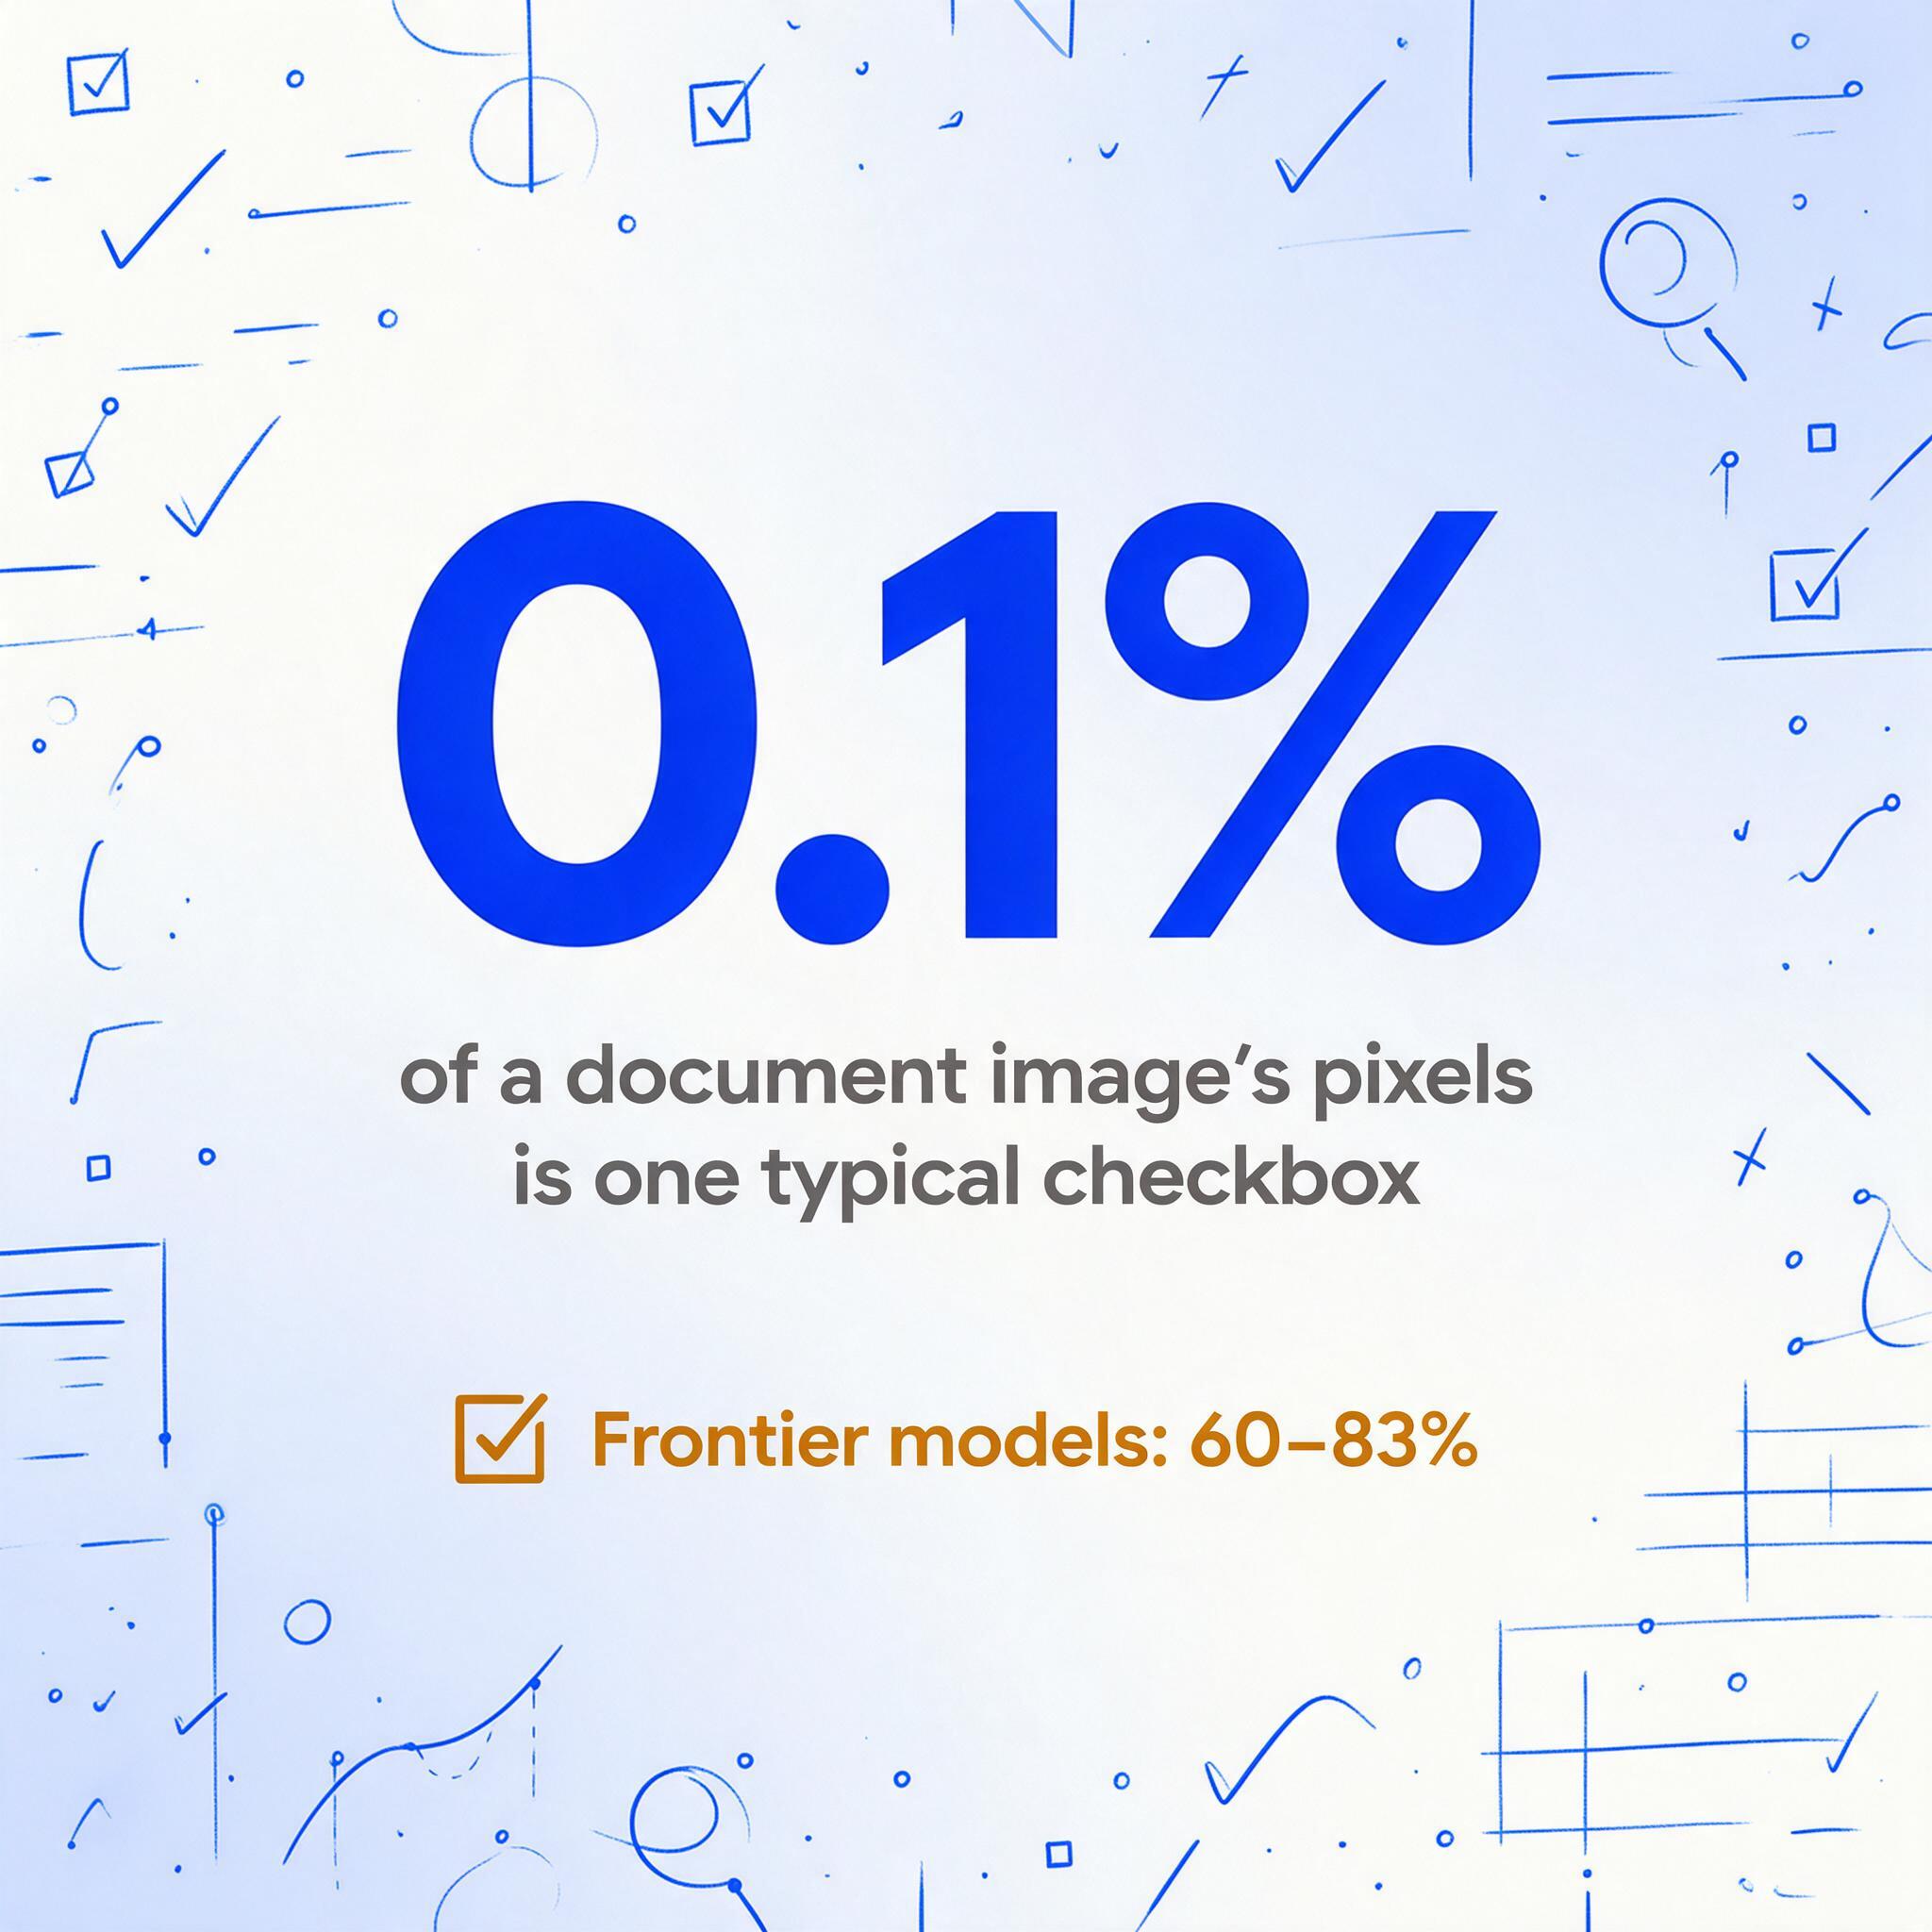
Mas — e esta é a parte que a maioria das páginas de produto omite — os VLMs não são tão bons nisso como você esperaria. Os modelos de fronteira que leem cursiva com precisão superior a 90% obtienen rutinariamente entre 60-83% na interpretação pura de caixas de seleção, e até o melhor modelo testado no benchmark CheckboxQA ainda fica 14 pontos atrás do desempeño humano.
A dificuldade central não é que os VLMs não possam ver caixas de seleção. É que o sinal visual é extremamente sutil comparado a tudo o demás na página. Uma caixa de seleção típica ocupa aproximadamente 0,1% dos pixels de uma imagem de documento. A diferença entre "marcada" e "desmarcada" pode ser uma linha fina de tinta através de um quadrado de 12 pixels. Quando o modelo também está processando parágrafos de texto denso, estruturas de tabela, logotipos e rótulos de formulário, esse sinal minúsculo compete por atenção — e às vezes perde.
Cinco formas em que a IA erra com caixas de seleção — mesmo quando tudo o resto está correto
Os pesquisadores do CheckboxQA catalogaram padrões de falha específicos que se repetem em todos os modelos que testaram. Entender isso não é algo acadêmico — ajuda você a saber o que observar ao avaliar qualquer ferramenta de processamento de formulários.
Falha nº 1: Confundir a caixa de seleção com o rótulo
Em muitos formulários, a caixa de seleção fica à esquerda do texto do rótulo. Em outros, fica à direita. O modelo às vezes atribuye uma caixa à esquerda ao rótulo à sua direita, e uma caixa à direita ao rótulo seguinte — efetivamente trocando qual opção está marcada. Este é um erro de associação espacial, não de detección: o modelo viu a marca, mas a associou ao texto errado.
Falha nº 2: Confiar no texto em vez da visão
Quando um formulário pregunta "É necessário trabalho adicional?" com caixas de seleção Sí/No, alguns modelos respondem com base no contexto textual circundante em vez de verificar qual caixa está realmente marcada. Eles recorrem ao raciocinio linguístico — "esta descrição de tarefa parece complexa, então provavelmente Sí" — em vez de realizar a inspeção visual que a pregunta exige. Isso é particularmente perigoso porque a resposta parece plausível mesmo quando está errada.
Falha nº 3: Listar todas as opções
Em cenários de seleção múltipla — "Quais categorias de veículos estão indicadas como aplicáveis?" — os modelos às vezes retornam todas as opções como marcadas, mesmo quando apenas um subconjunto está marcado. O modelo reconhece o conjunto de respostas possíveis a partir do texto, mas não consegue filtrar pelo estado visual.
Falha nº 4: Perder caixas de seleção em tabelas
Quando as caixas de seleção aparecem dentro de células de tabela — comum em listas de verificação de inspeção e formulários de conformidade — a estrutura tabular circundante pode distraer o modelo. As linhas da grade, os valores das células adjacentes e os cabeçalhos de columna competem pela atenção, e o estado da caixa se perde no ruido visual.
Falha nº 5: Devolver símbolos em vez de respostas
Alguns modelos respondem a preguntas de caixa de seleção com marcas literales — emitindo "✓" ou "X" em lugar de uma resposta textual como "Marcado" ou o texto do rótulo. Isso pode parecer menor, mas quando você está canalizando os resultados da extração a uma base de dados ou planilha, um carácter ✓ onde esperava "Residencia principal" rompe o pipeline de datos.
Estas falhas não estão distribuídas de forma uniforme. Formulários com caixas de seleção limpias, bem espaçadas e layouts simples apresentam melhor precisão que formulários densos de várias colunas com caixas pequenas. Mas o hallazgo consistente em toda a pesquisa é que nenhum modelo é suficientemente confiable para executar a extração de caixas de seleção sem verificação — e os modelos que têm melhor desempeño em tarefas de documentos generales não são necessariamente os melhores em tarefas específicas de caixas de seleção. A composición dos datos de entrenamiento importa más que el tamaño del modelo.
A Reviravolta da Caligrafia: Por Que Texto Rabiscado se Tornou o Problema Mais Fácil
Se você perguntasse a um engenheiro de processamento de documentos em 2018 qual era o elemento mais difícil de extrair de um formulário, ele diria caligrafia — sem hesitar. Estilos variáveis, conexões cursivas, espaçamento inconsistente, maiúsculas e minúsculas misturadas. O reconhecimento de caligrafia era o desafio principal.
Em 2026, essa hierarquia se inverteu. VLMs modernos são notavelmente bons em ler caligrafia porque a caligrafia, no fundo, ainda é um problema de texto. Até a cursiva mais bagunçada segue os padrões estatísticos da linguagem escrita — probabilidades de sequência de letras, limites de palavras, expectativas contextuais. Um VLM pode usar sua compreensão de linguagem para preencher lacunas: se ele lê "P_ciente N_me" em um formulário médico sob "Nome do Paciente", ele pode inferir as letras faltantes pelo contexto.
Caixas de seleção não têm essa rede de segurança contextual. O estado de uma caixa de seleção — marcada ou desmarcada — é puramente visual. Não há sinal linguístico para recorrer quando o componente de visão está incerto. Se o modelo não consegue ver claramente se há tinta em um pequeno retângulo, ele tem que adivinhar. E em modelos de linguagem, um palpite tende a seguir o padrão mais comum nos dados de treinamento — geralmente "desmarcada", que é estatisticamente mais frequente na maioria dos formulários — levando a falsos negativos sistemáticos.
Um usuário do Stack Overflow que revisitou sua pergunta de uma década atrás sobre digitalização de caixas de seleção capturou a frustração: sua IA lia palavras escritas com precisão, mas as caixas de seleção só vinham corretas cerca de 80% das vezes — e ninguém conseguia explicar os outros 20%. Esse número de 80% parece aceitável até você processar 200 formulários. Quarenta formulários com pelo menos um erro. Quarenta formulários que você precisa verificar manualmente.
Como Processar Formulários com Caixas de Seleção no Excel — Sem Perder as Marcações
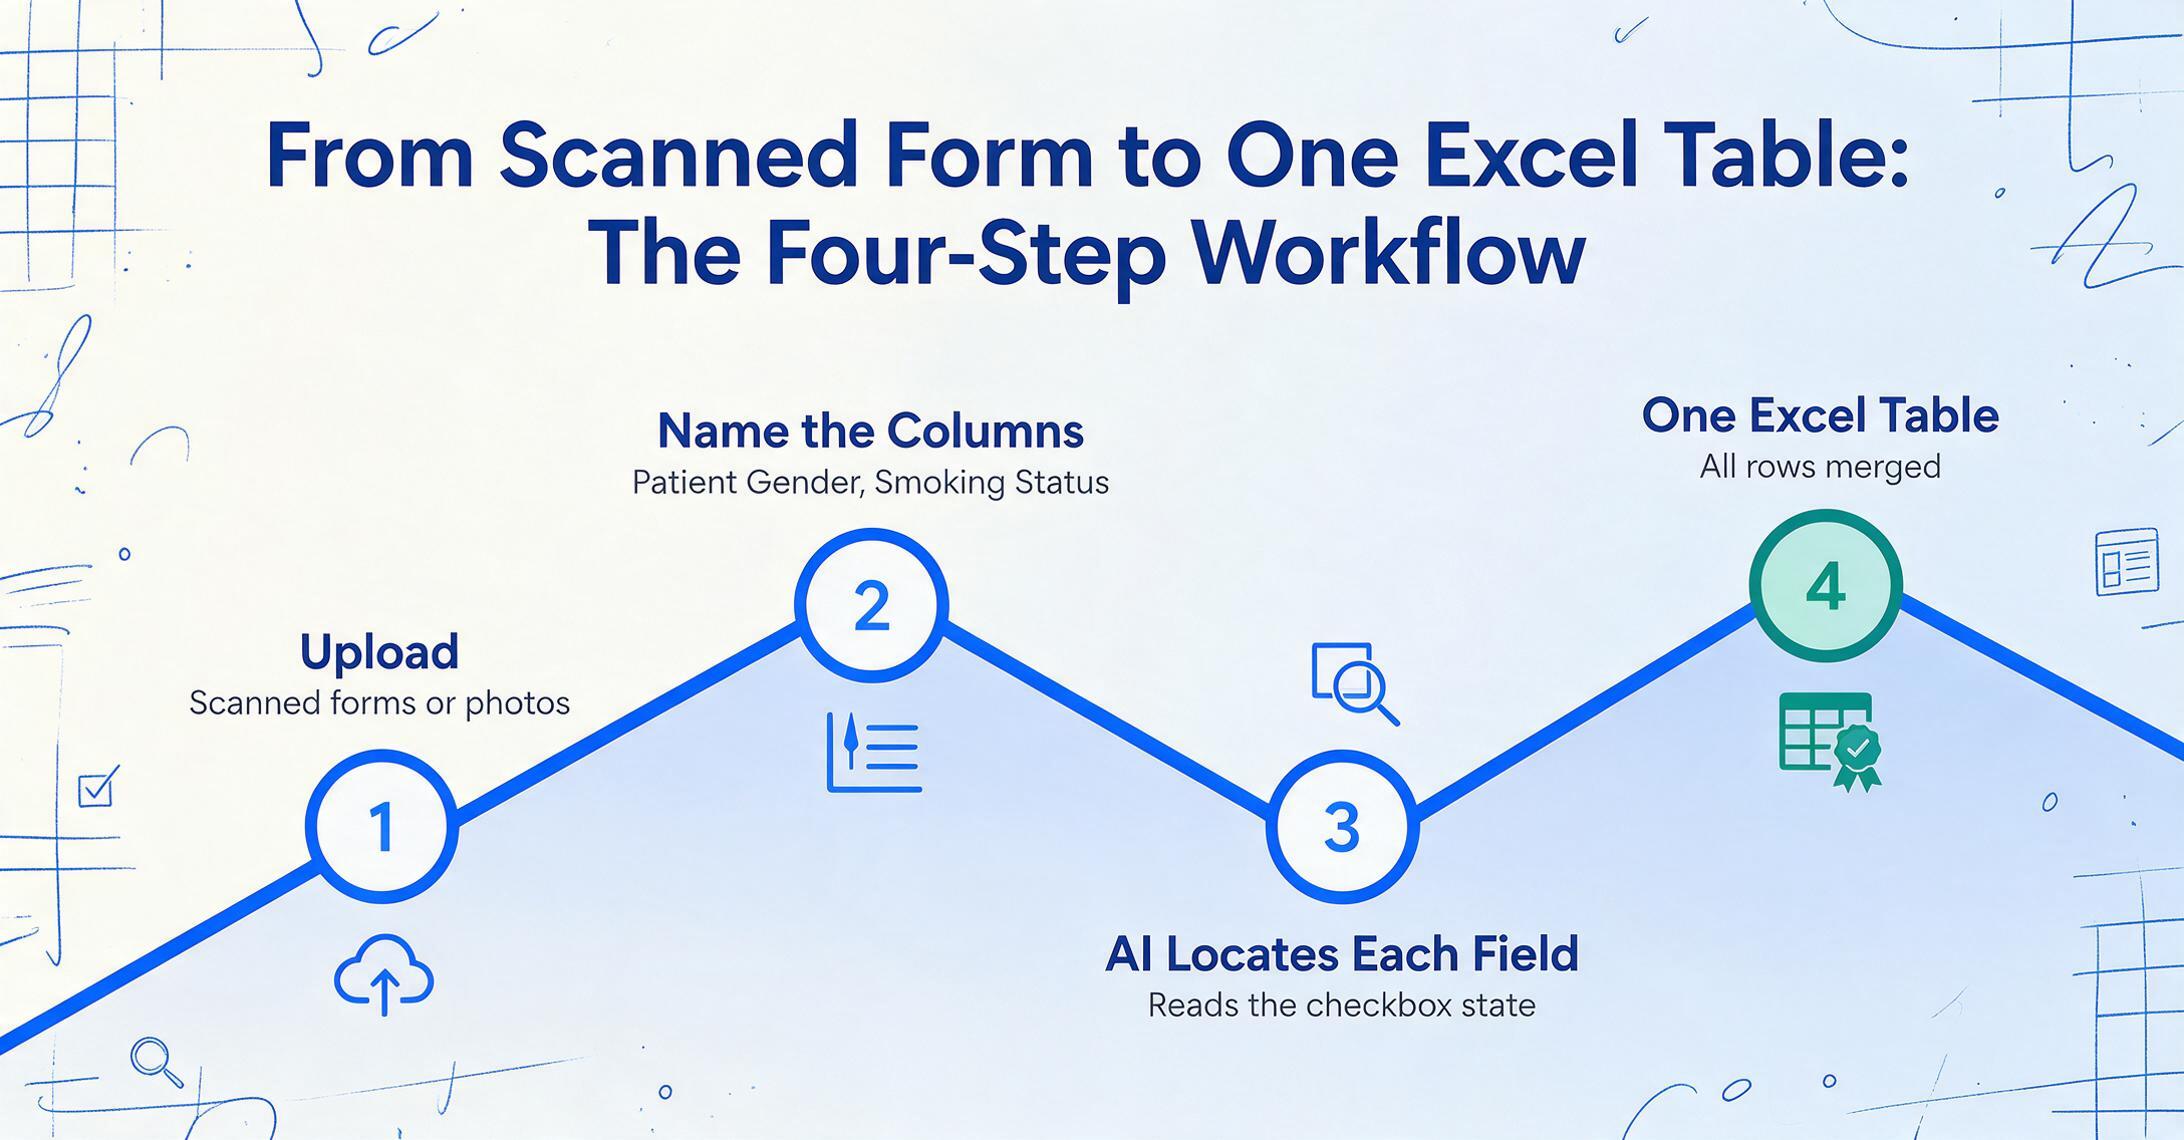
A pesquisa deixa uma coisa clara: você não pode jogar uma imagem de formulário bruta em uma IA genérica e esperar extração perfeita de caixas de seleção. Mas você pode construir um fluxo de trabalho que chegue lá. A diferença está em como a IA é instruída — e no que acontece ao redor dela.
A abordagem moderna mais eficaz usa Extração de Colunas Personalizadas: em vez de pedir para a IA "ler tudo neste formulário", você define exatamente quais campos quer. Você digita os nomes das colunas — "Gênero do Paciente", "Status de Tabagismo", "Alergias (Marcadas)" — e a IA procura no documento por cada campo, localiza sua caixa de seleção ou valor de texto, e retorna o resultado. Isso é fundamentalmente diferente das ferramentas baseadas em modelo, onde você desenha caixas ao redor de cada campo em um formulário mestre. Você define a saída que quer; a IA descobre onde os dados estão em qualquer layout.
A abordagem de "definir sua saída" é importante especificamente para caixas de seleção porque dá à IA um alvo claro. Em vez de perguntar de forma aberta "o que está marcado?", você pergunta "para o campo rotulado como 'Método de Contato Preferido', está marcado Telefone, E-mail ou Correio?" O modelo não precisa descobrir quais elementos na página são campos de caixa de seleção — ele procura o texto do rótulo que você especificou e examina a região visual ao redor em busca de uma caixa marcada ou desmarcada.
Para um único formulário, isso economiza minutos. Para um lote de formulários processados juntos, o processamento em lote mescla todos os resultados em uma única planilha — cada linha é um formulário, cada coluna é um campo. Uma pilha de 200 formulários de admissão de pacientes se torna uma tabela com 200 linhas, pronta para análise, em aproximadamente o mesmo tempo que leva para processar alguns formulários individualmente.
Três Lugares Onde a Extração de Caixas de Seleção Muda Como o Trabalho é Feito
A diferença entre ler texto e ler caixas de seleção não é teórica — ela se manifesta em fluxos de trabalho específicos onde formulários misturam entradas manuscritas com campos marcáveis. Esses são os ambientes onde a diferença entre uma ferramenta capaz de lidar com caixas de seleção e um OCR apenas de texto é a diferença entre automação completa e ainda precisar de um humano no processo.
Formulários de Reclamações de Seguros
Formulários de reclamação padronizados, como o CMS-1500 e o UB-04, contêm dezenas de campos de caixa de seleção e botão de opção: códigos de serviço, indicadores de local de atendimento, sinalizadores de aceitação de cessão, ponteiros de diagnóstico. Uma pesquisa do setor de 2025 feita pela Parseur descobriu que a entrada manual de dados custa às empresas dos EUA uma média de $28.500 por funcionário por ano, com trabalhadores gastando mais de nove horas por semana em transferência repetitiva de dados de documentos para sistemas. Para processadores de reclamações de seguros, grande parte desse tempo é gasta em campos de caixa de seleção — pequenas entradas que, juntas, consomem horas porque aparecem em todos os formulários.
O mercado de IA em reclamações de seguros atingiu $514 milhões em 2024 e deve crescer a uma CAGR de 18,3% para $2,76 bilhões até 2034. O crescimento é impulsionado em parte pelo reconhecimento de que a automação de caixas de seleção e marcas de seleção — não apenas o OCR de campos impressos — é o gargalo que mantém as taxas de processamento direto abaixo do que as seguradoras desejam.
Formulários de Admissão Médica e Histórico do Paciente
Formulários de admissão de pacientes são densos em caixas de seleção por design. Listas de verificação de sintomas ("Marque todas as opções aplicáveis"), declarações de medicamentos, grades de sim/não de histórico familiar, confirmações de consentimento — um único pacote de novo paciente pode conter mais de 50 campos de caixa de seleção ao lado de entradas manuscritas para instruções de dosagem, notas de alergia e linhas de assinatura. O problema é que as caixas de seleção são onde os modos de falha da detecção de caixas de seleção atingem mais forte: um paciente que circula "Nenhuma das opções acima" em uma lista de alergias, ou uma marca de lápis fraca em um formulário de consentimento, produz um campo que uma IA genérica pode retornar como desmarcado — descartando silenciosamente uma resposta clinicamente relevante na coluna "não". A caligrafia nas seções de texto livre geralmente é extraída corretamente; são as seleções binárias que precisam de um fluxo de trabalho projetado em torno da verificação.
Listas de Verificação de Inspeção e Conformidade
Inspeções de segurança em canteiros de obras, relatórios de condições de propriedades, listas de verificação de controle de qualidade, registros de manutenção de equipamentos — estes são fundamentalmente documentos de caixas de seleção. Um inspetor de campo percorre um local, marca itens em um formulário de papel e anota observações ao lado de qualquer problema. Os dados das caixas de seleção (quais itens passaram? quais falharam?) são a saída principal. As anotações manuscritas são contexto. Mas o processamento manual trata ambos igualmente: alguém precisa olhar cada caixa, cada anotação e digitá-las em uma planilha.
O volume aumenta rapidamente — um programa de inspeção semanal em alguns locais gera centenas de campos de caixas de seleção por semana, e cada um deles é uma decisão binária da qual o relatório de conformidade depende. Automatizar isso com uma ferramenta de extração de formulários que consiga distinguir marcado de não marcado enquanto também captura as anotações manuscritas transforma uma tarefa semanal de várias horas em um trabalho em lote de poucos minutos — mas só funciona se o manuseio de caixas de seleção da ferramenta for verificado, porque uma leitura incorreta de "inseguro" é pior do que nenhum dado.
Perguntas Frequentes
A IA consegue distinguir de forma confiável entre uma marca de verificação (✓), um X e um círculo preenchido?
VLMs modernos conseguem distinguir esses tipos de marca com precisão razoável — o maior desafio não é a classificação do tipo de marca, mas a detecção da presença da marca. Um traço leve de lápis, uma marca parcial que ultrapassa o limite da caixa ou uma caixa levemente sombreada em vez de explicitamente marcada criam sinais visuais ambíguos. O modelo pode classificar com confiança um "✓" claramente visível como "marcado", mas pode perder um traço leve de lápis que um humano interpretaria como marca. Se seus formulários tiverem estilos de marcação inconsistentes, espere alguns casos extremos que precisam de revisão humana.
Qual é a diferença entre detecção de caixas de seleção e interpretação de caixas de seleção?
Detecção é "há uma marca nesta caixa?" Interpretação é "o que esta marca significa no contexto deste formulário?" Uma caixa marcada ao lado de "Recusar Cobertura" significa algo muito diferente de uma caixa marcada ao lado de "Aceitar Termos." Detecção é uma tarefa visual; interpretação exige ler e entender o texto do rótulo, as instruções do formulário e, às vezes, a relação entre múltiplas caixas de seleção (por exemplo, botões de opção mutuamente exclusivos vs. caixas de seleção múltipla). Boas ferramentas de processamento de formulários lidam com ambas as camadas — e a camada de interpretação é onde a compreensão de linguagem se torna essencial.
A extração de caixas de seleção funciona em formulários manuscritos ou apenas em impressos?
Funciona em ambos, mas a precisão varia. Formulários impressos com caixas bem delimitadas e marcas escuras são o caso mais fácil. Formulários manuscritos introduzem duas variáveis adicionais: a caligrafia que preenche os campos de texto (que os VLMs lidam bem hoje) e as marcas manuscritas dentro das caixas de seleção — que podem ser rabiscadas, riscadas, circuladas ou parcialmente preenchidas. Um VLM que lê o documento de forma holística pode lidar melhor com formulários mistos de manuscrito e caixas de seleção do que um pipeline que separa OCR e detecção de caixas em etapas desconectadas, porque o VLM não perde informações espaciais entre as etapas.
Quantos formulários posso processar de uma vez?
O processamento em lote permite que você envie vários formulários simultaneamente e receba uma tabela de saída mesclada. O limite prático depende da arquitetura da ferramenta — algumas suportam dezenas, outras centenas por lote. No ImageToTable.ai, a extração de colunas personalizada funciona em lotes inteiros: você define suas colunas uma vez, envia todos os formulários, e os estados das caixas de seleção e valores de campo de cada formulário preenchem as linhas correspondentes de uma única planilha. Sem configuração por formulário, sem modelo por fornecedor.
Qual precisão devo esperar na extração de caixas de seleção?
Na interpretação pura de caixas de seleção — isolada do restante do formulário — os melhores modelos de linguagem visual testados no benchmark CheckboxQA variaram de 60% a 83%, com nível humano em 97,5%. Mas em formulários reais, a precisão depende mais do design do formulário e da qualidade das marcas do que do modelo: caixas grandes e bem separadas em digitalizações limpas têm desempenho muito melhor do que caixas minúsculas em fotos de baixa resolução. Para a análise detalhada por tipo de marca (caixas digitais, marcas de caneta, lápis, marcas ambíguas), consulte nosso guia de precisão de caixas de seleção. O fluxo de trabalho mais confiável é a extração automatizada com verificação por amostragem — a IA cuida da maior parte do trabalho, e você verifica uma amostra para identificar casos extremos, em vez de verificar cada formulário individualmente.
A Conclusão Real Não É Sobre Caixas de Seleção
O problema das caixas de seleção expõe uma verdade mais profunda sobre a IA para documentos: o reconhecimento de texto não é extração de dados. Uma ferramenta que lê palavras bem pode ainda assim perder as informações não textuais que carregam metade do significado dos seus formulários — as marcas de verificação, as seleções de botões de opção, as assinaturas, os carimbos, os campos riscados. O benchmark que importa não é a precisão de caracteres do OCR. É se a tabela de saída — o que você realmente usa — está correta sem que você tenha que verificar novamente cada célula.
Essa distinção é o que separa as ferramentas projetadas para digitalizar documentos daquelas construídas para extração de dados. A caixa de seleção é o canário. Se uma ferramenta a manusea de forma confiável — em vários layouts de formulários, misturada com escrita manual, em escala de lote — é provável que esteja manuseando corretamente o resto dos dados do seu formulário também. Se não, você ainda está fazendo entrada manual de dados. Só que com um software de melhor aparência.
Os arquivos são processados de forma segura e não são armazenados.