Warum KI Ihre Handschrift fehlerfrei liest
– aber ein angekreuztes Kästchen übersieht
Ein Entwickler im OpenAI-Forum verbrachte drei Wochen mit dem Aufbau einer Pipeline zur Verarbeitung von Kreditanträgen. Die KI extrahierte jedes handschriftliche Feld – Namen der Kreditnehmer, Objektadressen, Kreditbeträge – mit nahezu perfekter Genauigkeit. Dann kam der Abschnitt mit den Kästchen: „Belegung: Hauptwohnsitz / Zweitwohnsitz / Anlageobjekt.“ Das Modell lieferte nichts zurück. Drei Optionsfelder, deutlich sichtbar, eines ausgefüllt. GPT-4 Vision betrachtete sie und erkannte keine Auswahl. Ein Thread, der genau diesen Kampf dokumentiert, zog Dutzende Entwickler an, die vor derselben Wand standen: Ihre KI konnte die Handschrift eines Arztes lesen, aber nicht erkennen, ob ein Kästchen ein Häkchen enthielt.
Das ist kein Zufall. Eine Benchmark-Studie von Snowflake Research aus dem Jahr 2025 testete acht führende Vision-Language-Modelle bei der Interpretation von Kontrollkästchen. Das beste Modell erreichte 83,2 %, während Menschen auf 97,5 % kamen – eine Lücke, die groß genug ist, dass selbst die besten Modelle bei formularen mit vielen Kontrollkästchen das Straight-Through-Processing verfehlen. (Eine vollständige Genauigkeitsaufschlüsselung nach Markierungstyp – Kugelschreiber vs. Bleistift vs. unklare Markierungen – finden Sie in unserem Leitfaden zur Kontrollkästchen-Genauigkeit.) Die Kluft zwischen „Handschrift gut lesen“ und „Kontrollkästchen zuverlässig lesen“ ist nicht klein – es ist der Unterschied zwischen dem Vertrauen in Ihre Automatisierung und dem manuellen Überprüfen jeder Ausgabe.
Dieses Paradoxon – Text ist einfach, Häkchen sind schwer – prägt den aktuellen Stand der KI-Formularverarbeitung. Und zu verstehen, warum es existiert, ist der Schlüssel zur Auswahl von Tools, die tatsächlich mit Ihren Formularen funktionieren, nicht nur mit den Demos, die sie Ihnen zeigen.
Warum Ihre OCR jedes Wort liest – und jedes Kontrollkästchen ignoriert
Um das Kontrollkästchen-Problem zu verstehen, müssen Sie verstehen, was in einer herkömmlichen OCR-Pipeline passiert – und wo die visuellen Informationen verloren gehen.
Die optische Zeichenerkennung funktioniert, indem sie eine Seite scannt, Textbereiche erkennt und Pixelmuster in Zeichencodes umwandelt. Ein „W“ in einem gescannten Dokument ist eine bestimmte Anordnung von dunklen und hellen Pixeln; die OCR-Engine gleicht dieses Muster mit einer bekannten Buchstabenform ab. Dies funktioniert bei gedrucktem Text einigermaßen gut und, mit modernen OCR-Engines auf Deep-Learning-Basis, zunehmend auch bei Handschrift.
Aber hier liegt das kritische Versagen: OCR sieht ein Kontrollkästchen mit einem Häkchen – und hat kein Zeichen, dem es das zuordnen kann. Ein Häkchen ist kein „V“ und kein „✓“ in einem Zeichensatz, den die Engine erkennt. Die OCR überspringt es entweder vollständig oder gibt Unsinn aus: ein zufälliges Symbol, eine leere Zeichenfolge, ein falsch interpretiertes Zeichen.
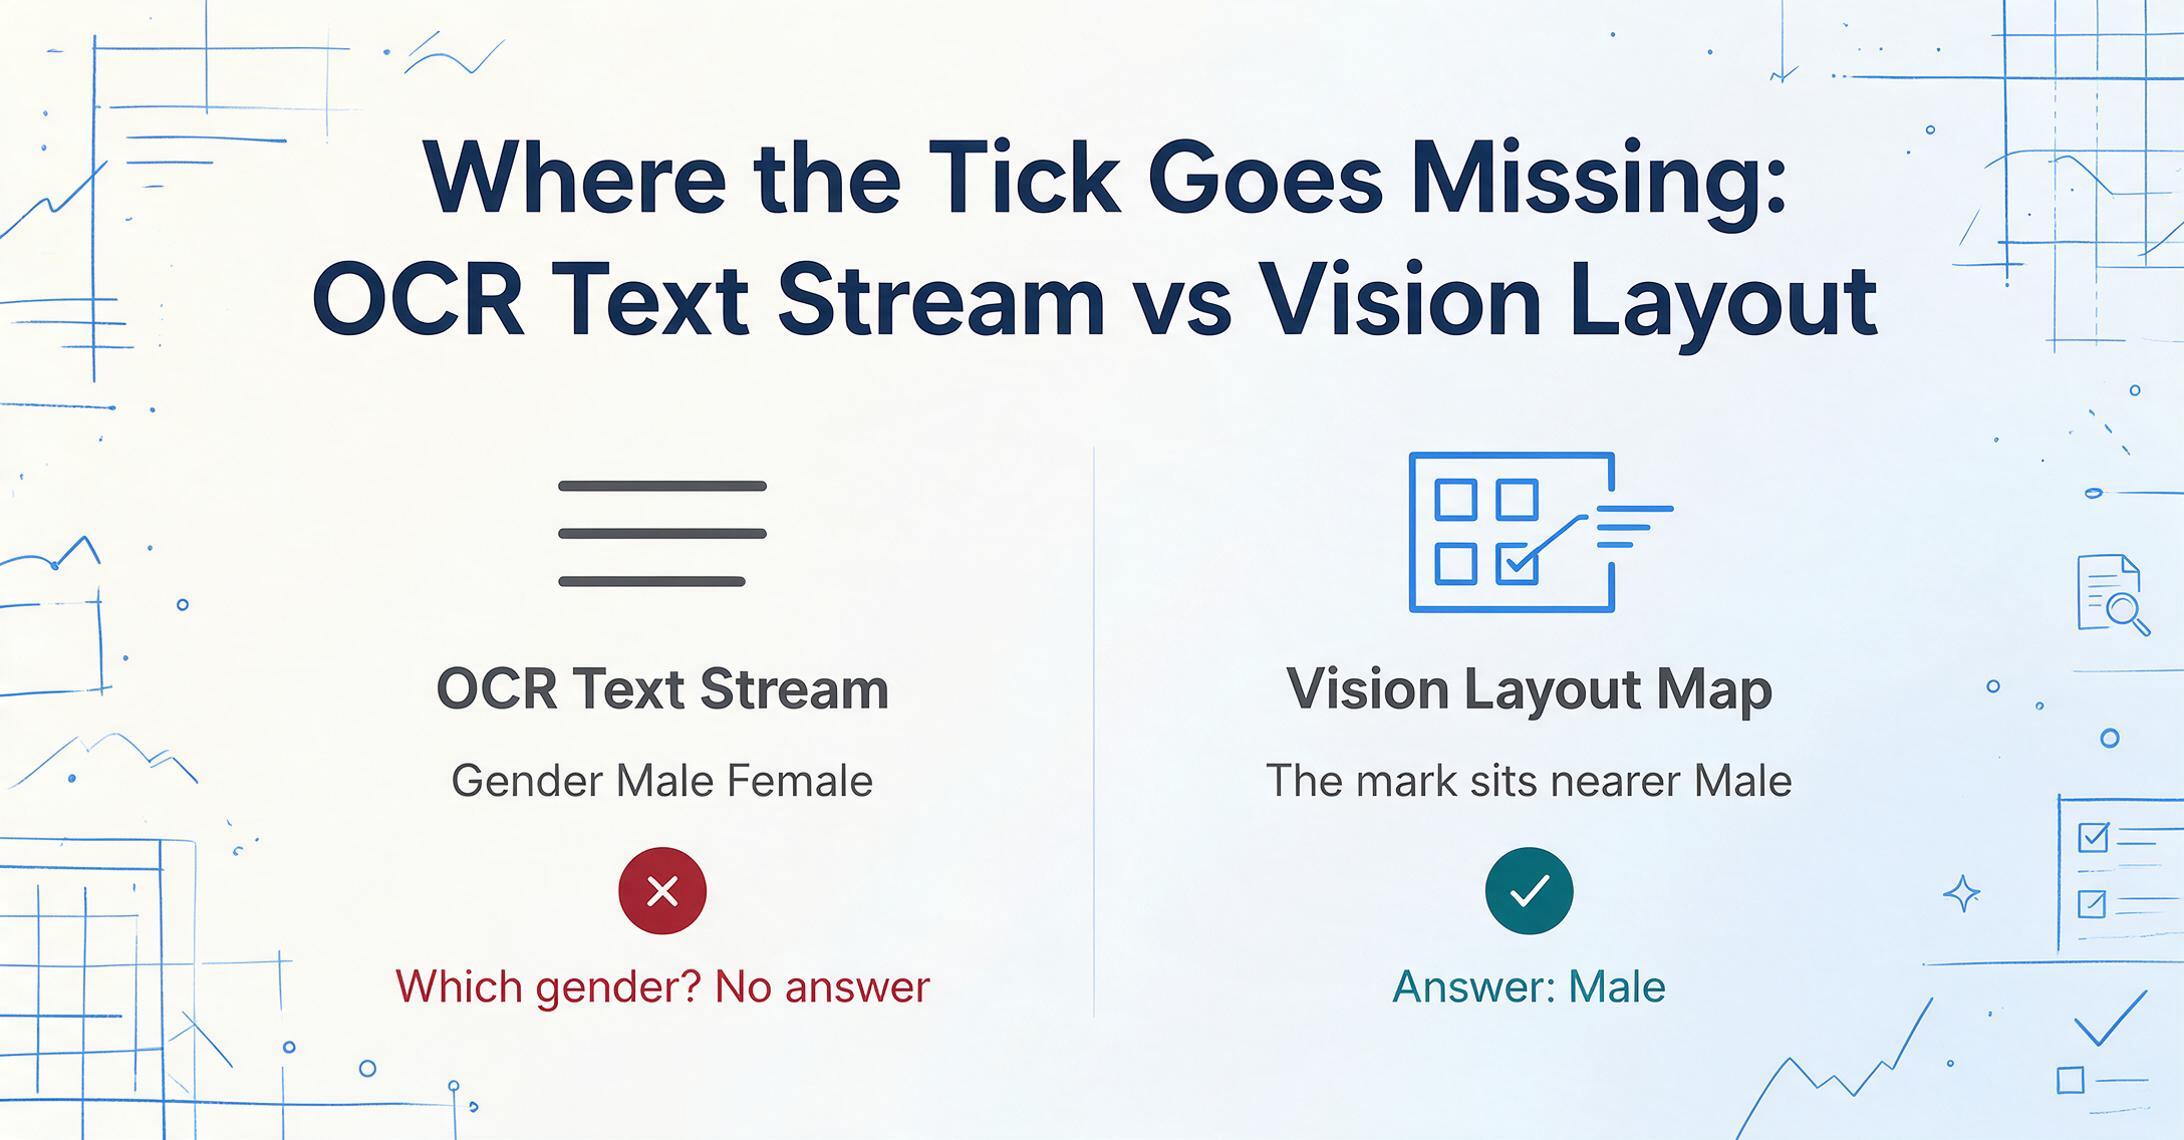
Selbst wenn die OCR das Häkchen als etwas erfasst, geht die räumliche Beziehung zwischen der Markierung und ihrer Beschriftung verloren. Die Pipeline gibt einen flachen Textstrom aus: „Geschlecht Männlich Weiblich Alter 34 Blutgruppe A+.“ Welches Geschlecht wurde ausgewählt? Der Strom gibt keinen Hinweis. Das visuelle Layout – die Tatsache, dass eine Markierung näher an „Männlich“ als an „Weiblich“ liegt – wurde verworfen, sobald die OCR die Seite in Text umwandelte. Deshalb scheitert ein OCR-First-Ansatz bei der Formularverarbeitung konsequent an Kontrollkästchen, Optionsfeldern und jedem Datenformat, bei dem die Position Bedeutung trägt.
Wie Vision-KI die ganze Seite liest – nicht nur den Text darauf
Vision-Language-Modelle (VLMs) – die KI-Klasse, die moderne Dokumentextraktions-Tools antreibt – ändern den Ansatz grundlegend. Statt Bild in Text umzuwandeln und dann über den Text nachzudenken, verarbeitet ein VLM das Dokumentbild direkt. Es sieht das Layout, die räumlichen Beziehungen, die visuellen Hinweise. Wenn Sie fragen: „Welches Kontrollkästchen ist markiert?“, betrachtet es die Seite so, wie ein Mensch es tun würde: Es lokalisiert jedes Kästchen, prüft, ob es eine Markierung enthält, und ordnet diese Markierung dem nächstgelegenen Beschriftungstext zu.
Dieser visuell orientierte Ansatz macht es überhaupt erst möglich, handschriftliche Formulare zu verarbeiten. Ein VLM braucht nicht, dass das Häkchen ein Zeichen ist – es muss nur erkennen: „In diesem rechteckigen Bereich ist Tinte“ versus „Dieser Bereich ist leer.“ Das Modell lernt diese Unterscheidung aus Trainingsdaten, die Millionen von Dokumentbildern mit Annotationen darüber enthalten, welche Felder ausgefüllt sind und welche nicht.
Aber – und das ist der Teil, den die meisten Produktseiten auslassen – VLMs sind darin nicht so gut, wie man erwarten würde. Die Frontmodelle, die Schreibschrift mit über 90 % Genauigkeit lesen, erzielen bei der reinen Kontrollkästchen-Interpretation routinemäßig nur 60–83 %, und selbst das beste im CheckboxQA-Benchmark getestete Modell bleibt 14 Punkte hinter der menschlichen Leistung zurück.
Die Kernschwierigkeit ist nicht, dass VLMs Kontrollkästchen nicht sehen können. Es ist, dass das visuelle Signal im Vergleich zu allem anderen auf der Seite extrem subtil ist. Ein typisches Kontrollkästchen nimmt etwa 0,1 % der Pixel eines Dokumentbilds ein. Der Unterschied zwischen „markiert“ und „nicht markiert“ kann eine dünne Tintenlinie über einem 12-Pixel-Quadrat sein. Wenn das Modell gleichzeitig Absätze mit dichtem Text, Tabellenstrukturen, Logos und Formularbeschriftungen verarbeitet, konkurriert dieses winzige Signal um Aufmerksamkeit – und verliert manchmal.
Fünf Wege, wie KI Kontrollkästchen falsch erkennt – selbst wenn alles andere stimmt
Die CheckboxQA-Forscher haben spezifische Fehlermuster katalogisiert, die bei jedem von ihnen getesteten Modell wiederkehren. Diese zu verstehen ist nicht akademisch – es zeigt Ihnen, worauf Sie achten müssen, wenn Sie ein Formularverarbeitungstool bewerten.
Fehler Nr. 1: Kontrollkästchen und Beschriftung werden vertauscht
Bei vielen Formularen befindet sich das Kontrollkästchen links von seinem Beschriftungstext. Bei anderen liegt es rechts. Das Modell ordnet manchmal ein linksseitiges Kontrollkästchen der Beschriftung rechts daneben zu und ein rechtsseitiges Kontrollkästchen der nächsten Beschriftung – wodurch effektiv vertauscht wird, welche Option markiert ist. Dies ist ein räumlicher Zuordnungsfehler, kein Erkennungsfehler: Das Modell hat die Markierung gesehen, sie aber dem falschen Text zugeordnet.
Fehler Nr. 2: Dem Text mehr vertrauen als der Bilderkennung
Wenn ein Formular „Ist zusätzliche Aufgabenstellung erforderlich?“ mit Ja/Nein-Kontrollkästchen fragt, antworten einige Modelle basierend auf dem umgebenden Textkontext, anstatt zu prüfen, welches Kästchen tatsächlich markiert ist. Sie greifen auf sprachliche Schlussfolgerungen zurück – „diese Aufgabenbeschreibung klingt komplex, also wahrscheinlich Ja“ – anstatt die visuelle Prüfung durchzuführen, die die Frage erfordert. Das ist besonders gefährlich, weil die Antwort plausibel aussieht, selbst wenn sie falsch ist.
Fehler Nr. 3: Jede Option auflisten
Bei Mehrfachauswahl-Szenarien – „Welche Fahrzeugkategorien sind als zutreffend angegeben?“ – geben Modelle manchmal alle Optionen als angekreuzt zurück, selbst wenn nur eine Teilmenge markiert ist. Das Modell erkennt die Menge möglicher Antworten aus dem Text, filtert aber nicht nach dem visuellen Zustand.
Fehler Nr. 4: Kontrollkästchen in Tabellen gehen verloren
Wenn Kontrollkästchen in Tabellenzellen erscheinen – üblich bei Inspektions-Checklisten und Compliance-Formularen – kann die umgebende Tabellenstruktur das Modell ablenken. Die Gitterlinien, benachbarten Zellenwerte und Spaltenüberschriften konkurrieren um Aufmerksamkeit, und der Zustand des Kontrollkästchens geht im visuellen Rauschen verloren.
Fehler Nr. 5: Symbole statt Antworten zurückgeben
Einige Modelle antworten auf Kontrollkästchen-Fragen mit wörtlichen Markierungen – sie geben „✓“ oder „X“ aus, anstatt einer textuellen Antwort wie „Angekreuzt“ oder dem Beschriftungstext. Das mag nebensächlich erscheinen, aber wenn Sie Extraktionsergebnisse in eine Datenbank oder Tabellenkalkulation einspeisen, unterbricht ein ✓-Zeichen, wo Sie „Hauptwohnsitz“ erwartet haben, die Datenpipeline.
Diese Fehler sind nicht gleichmäßig verteilt. Formulare mit sauberen, weit auseinanderliegenden Kontrollkästchen und einfachen Layouts erzielen eine bessere Genauigkeit als dichte, mehrspaltige Formulare mit kleinen Kästchen. Aber die durchgängige Erkenntnis aus der Forschung ist, dass kein Modell zuverlässig genug ist, um die Kontrollkästchen-Extraktion ohne Verifizierung durchzuführen – und die Modelle, die bei allgemeinen Dokumentaufgaben am besten abschneiden, sind nicht unbedingt die besten bei kontrollkästchenspezifischen Aufgaben. Die Zusammensetzung der Trainingsdaten ist wichtiger als die Modellgröße.
Die Handschrift-Wendung: Warum Gekritzel zum einfacheren Problem wurde
Hätte man 2018 einen Dokumentverarbeitungs-Ingenieur gefragt, was das Schwierigste beim Extrahieren aus einem Formular sei, hätte er ohne Zögern „Handschrift" gesagt. Unterschiedliche Stile, verbundene Schreibschrift, inkonsistente Abstände, gemischte Groß- und Kleinschreibung. Handschrifterkennung war die Herausforderung Nummer eins.
2026 hat sich diese Rangfolge umgekehrt. Moderne VLMs sind bemerkenswert gut im Lesen von Handschrift, weil Handschrift im Kern immer noch ein Textproblem ist. Selbst unleserliche Schreibschrift folgt den statistischen Mustern geschriebener Sprache – Buchstabenfolge-Wahrscheinlichkeiten, Wortgrenzen, kontextuelle Erwartungen. Ein VLM kann sein Sprachverständnis nutzen, um Lücken zu füllen: Liest es auf einem medizinischen Formular unter „Patientenname" „P_tient N_me", kann es die fehlenden Buchstaben aus dem Kontext ableiten.
Optionsfelder haben kein solches kontextuelles Sicherheitsnetz. Der Zustand eines Optionsfelds – aktiviert oder nicht – ist rein visuell. Es gibt kein sprachliches Signal, auf das man zurückgreifen kann, wenn die Bilderkennung unsicher ist. Wenn das Modell nicht klar erkennen kann, ob sich Tinte in einem kleinen Rechteck befindet, muss es raten. Und bei Sprachmodellen tendiert eine Vermutung zum häufigsten Muster in den Trainingsdaten – oft „nicht aktiviert", was statistisch auf den meisten Formularen häufiger vorkommt –, was zu systematischen falsch-negativen Ergebnissen führt.
Ein Stack-Overflow-Nutzer, der seine zehn Jahre alte Frage erneut aufgriff, brachte die Frustration beim Scannen von Optionsfeldern auf den Punkt: Seine KI las geschriebene Wörter genau, aber Optionsfelder kamen nur in etwa 80 % der Fälle korrekt durch – und niemand konnte die anderen 20 % erklären. Diese 80 % klingen akzeptabel, bis man 200 Formulare verarbeitet. Vierzig Formulare mit mindestens einem Fehler. Vierzig Formulare, die man manuell überprüfen muss.
So verarbeiten Sie Formulare mit Optionsfeldern in Excel – ohne die Häkchen zu verlieren
Die Forschung macht eines deutlich: Man kann ein rohes Formularbild nicht einfach einer generischen KI übergeben und perfekte Optionsfelder-Extraktion erwarten. Aber man kann einen Workflow aufbauen, der dorthin führt. Der Unterschied liegt darin, wie die KI angewiesen wird – und was darum herum passiert.
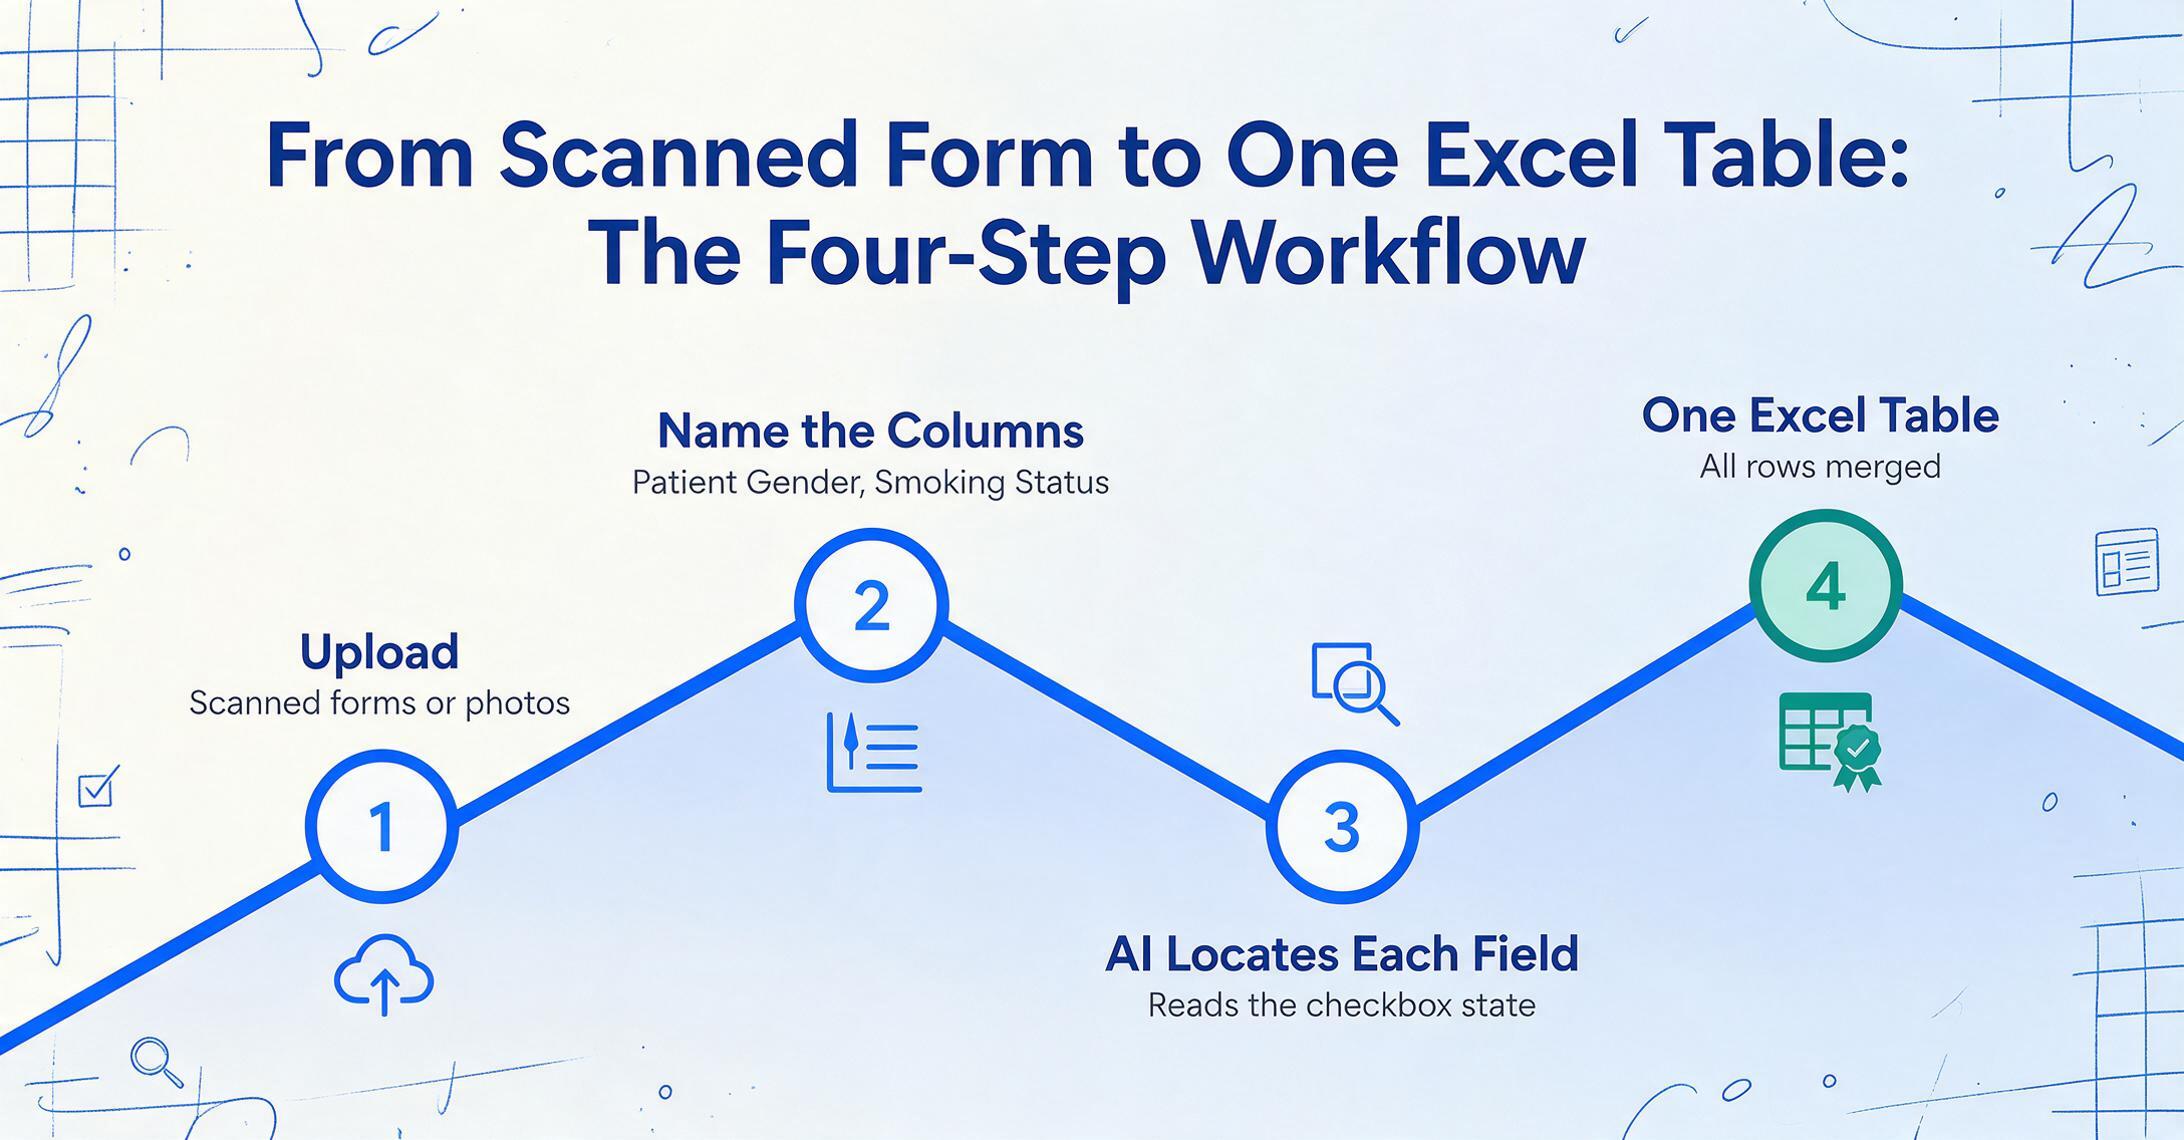
Der effektivste moderne Ansatz nutzt die benutzerdefinierte Spaltenextraktion: Statt die KI zu bitten, „alles auf diesem Formular zu lesen", definieren Sie genau, welche Felder Sie möchten. Sie geben die Spaltennamen ein – „Patientengeschlecht", „Raucherstatus", „Allergien" – und die KI durchsucht das Dokument nach jedem Feld, lokalisiert dessen Optionsfeld oder Textwert und liefert das Ergebnis. Das unterscheidet sich grundlegend von vorlagenbasierten Tools, bei denen Sie auf einem Masterformular Kästchen um jedes Feld zeichnen. Sie definieren die gewünschte Ausgabe; die KI findet heraus, wo die Daten in jedem Layout liegen.
Der Ansatz „Ausgabe definieren“ ist speziell bei Kontrollkästchen wichtig, weil er der KI ein klares Ziel vorgibt. Statt der offenen Frage „Was ist angekreuzt?“ fragen Sie: „Ist beim Feld ‚Bevorzugte Kontaktmethode‘ Telefon, E-Mail oder Post angekreuzt?“ Das Modell muss nicht herausfinden, welche Elemente auf der Seite Kontrollkästchenfelder sind – es sucht nach dem von Ihnen angegebenen Beschriftungstext und untersucht dann den visuellen Bereich darum herum auf ein markiertes oder unmarkiertes Kästchen.
Bei einem einzelnen Formular spart das Minuten. Bei einem Stapel gemeinsam verarbeiteter Formulare führt die Stapelverarbeitung alle Ergebnisse in einer Tabelle zusammen – jede Zeile ist ein Formular, jede Spalte ein Feld. Ein Stapel von 200 Patientenaufnahmeformularen wird zu einer Tabelle mit 200 Zeilen, bereit für die Analyse, in etwa der Zeit, die für die Verarbeitung einiger weniger Formulare einzeln benötigt wird.
Drei Bereiche, in denen die Kontrollkästchen-Extraktion die Arbeitsweise verändert
Der Unterschied zwischen dem Lesen von Text und dem Lesen von Kontrollkästchen ist nicht theoretisch – er zeigt sich in konkreten Arbeitsabläufen, in denen handschriftliche Einträge mit ankreuzbaren Feldern kombiniert werden. In diesen Umgebungen ist der Unterschied zwischen einem Werkzeug mit Kontrollkästchen-Fähigkeit und einer reinen Text-OCR der Unterschied zwischen vollständiger Automatisierung und einem weiterhin benötigten Menschen in der Schleife.
Formulare für Versicherungsansprüche
Standardisierte Anspruchsformulare wie das CMS-1500 und UB-04 enthalten Dutzende von Kontrollkästchen- und Optionsfeldern: Leistungscodes, Angaben zum Behandlungsort, Kennzeichen für die Annahme der Abtretung, Diagnoseverweise. Eine Branchenumfrage von Parseur aus dem Jahr 2025 ergab, dass die manuelle Dateneingabe US-Unternehmen durchschnittlich 28.500 $ pro Mitarbeiter und Jahr kostet, wobei Mitarbeiter mehr als neun Stunden pro Woche mit der wiederholten Übertragung von Daten aus Dokumenten in Systeme verbringen. Für Sachbearbeiter von Versicherungsansprüchen entfällt ein großer Teil dieser Zeit auf Kontrollkästchenfelder – kleine Eingaben, die zusammen Stunden verschlingen, weil sie auf jedem einzelnen Formular vorkommen.
Der Markt für KI in der Versicherungsanspruchsbearbeitung erreichte 2024 ein Volumen von 514 Millionen $ und wird voraussichtlich mit einer CAGR von 18,3 % auf 2,76 Milliarden $ bis 2034 wachsen. Dieses Wachstum wird teilweise durch die Erkenntnis vorangetrieben, dass die Automatisierung von Kontrollkästchen und Auswahlmarkierungen – nicht nur die optische Zeichenerkennung (OCR) gedruckter Felder – der Engpass ist, der die Straight-Through-Processing-Raten unter dem Niveau hält, das sich Versicherer wünschen.
Medizinische Aufnahme- und Patientengeschichtsformulare
Patientenaufnahmeformulare sind von Natur aus kontrollkästchenlastig. Symptom-Checklisten („Alles Zutreffende ankreuzen"), Medikamentenerklärungen, Ja/Nein-Raster zur Familiengeschichte, Einwilligungsbestätigungen – ein einziges Paket für neue Patienten kann über 50 Kontrollkästchenfelder enthalten, neben handschriftlichen Einträgen für Dosierungsanweisungen, Allergiehinweise und Unterschriftenzeilen. Das Problem ist, dass die Kontrollkästchen genau dort sind, wo die Fehlermodi der Kontrollkästchenerkennung am härtesten zuschlagen: Ein Patient, der „Keines der oben genannten" auf einer Allergieliste einkreist, oder ein schwaches Bleistift-Häkchen auf einem Einwilligungsformular erzeugt ein Feld, das eine generische KI als nicht angekreuzt zurückgeben könnte – wodurch eine klinisch relevante Antwort stillschweigend in die „Nein"-Spalte fällt. Die Handschrift in den Freitextabschnitten wird normalerweise problemlos extrahiert; es sind die binären Auswahlen, die einen Arbeitsablauf benötigen, der auf Verifizierung ausgelegt ist.
Inspektions- und Compliance-Checklisten
Sicherheitsinspektionen auf Baustellen, Zustandsberichte von Immobilien, Qualitätskontroll-Checklisten, Wartungsprotokolle für Geräte – das sind im Kern Dokumente mit Kontrollkästchen. Ein Außendienstinspektor geht durch eine Baustelle, hakt Punkte auf einem Papierformular ab und notiert Anmerkungen neben etwaigen Problemen. Die Kontrollkästchendaten (welche Punkte bestanden? welche nicht?) sind das primäre Ergebnis. Die handschriftlichen Notizen sind Kontext. Aber die manuelle Verarbeitung behandelt beides gleich: Jemand muss sich jedes Kästchen und jede Notiz ansehen und sie in eine Tabelle übertragen.
Das Volumen wächst schnell – ein wöchentliches Inspektionsprogramm über mehrere Standorte erzeugt Hunderte von Kontrollkästchenfeldern pro Woche, und jedes davon ist eine binäre Entscheidung, von der der Compliance-Bericht abhängt. Die Automatisierung mit einem Formularextraktionstool, das angekreuzte von nicht angekreuzten Feldern unterscheiden und gleichzeitig die handschriftlichen Notizen erfassen kann, verwandelt eine mehrstündige wöchentliche Aufgabe in einen Stapelverarbeitungsjob von wenigen Minuten – aber das funktioniert nur, wenn die Kontrollkästchenverarbeitung des Tools verifiziert ist, denn ein falsch gelesenes „unsicher“ ist schlimmer als gar keine Daten.
Häufig gestellte Fragen
Kann KI zuverlässig zwischen einem Häkchen (✓), einem Kreuz (X) und einem ausgefüllten Kreis unterscheiden?
Moderne Vision-Language-Modelle (VLM) können diese Markierungstypen mit angemessener Genauigkeit unterscheiden – die größere Herausforderung ist nicht die Klassifizierung des Markierungstyps, sondern die Erkennung des Vorhandenseins einer Markierung. Ein schwacher Bleistifthaken, eine teilweise Markierung, die über die Feldgrenze hinausgeht, oder ein Feld, das leicht schattiert statt explizit angekreuzt ist, erzeugen alle mehrdeutige visuelle Signale. Das Modell kann ein deutlich sichtbares „✓“ sicher als „angekreuzt“ klassifizieren, aber einen leichten Bleistiftstrich übersehen, den ein Mensch als Markierung interpretieren würde. Wenn Ihre Formulare inkonsistente Markierungsstile aufweisen, sollten Sie mit einigen Grenzfällen rechnen, die eine manuelle Überprüfung erfordern.
Was ist der Unterschied zwischen Kontrollkästchenerkennung und Kontrollkästcheninterpretation?
Erkennung bedeutet „Gibt es eine Markierung in diesem Feld?“ Interpretation bedeutet „Was bedeutet diese Markierung im Kontext dieses Formulars?“ Ein angekreuztes Feld neben „Deckung ablehnen“ bedeutet etwas ganz anderes als ein angekreuztes Feld neben „Bedingungen akzeptieren“. Erkennung ist eine visuelle Aufgabe; Interpretation erfordert das Lesen und Verstehen des Beschriftungstexts, der Formularanweisungen und manchmal der Beziehung zwischen mehreren Kontrollkästchen (z. B. sich gegenseitig ausschließende Optionsfelder vs. Kontrollkästchen mit Mehrfachauswahl). Gute Formularverarbeitungstools handhaben beide Ebenen – und die Interpretationsebene ist der Punkt, an dem Sprachverständnis entscheidend wird.
Funktioniert die Checkbox-Erkennung auch bei handschriftlichen Formularen oder nur bei gedruckten?
Sie funktioniert bei beiden, aber die Genauigkeit unterscheidet sich. Gedruckte Formulare mit klar abgegrenzten Kästchen und dunklen Häkchen sind der einfachste Fall. Handschriftliche Formulare bringen zwei zusätzliche Variablen mit sich: die Handschrift, die die Textfelder ausfüllt (die VLMs heute gut verarbeiten), und die handschriftlichen Markierungen in den Checkboxen – die gekritzelt, durchgestrichen, eingekreist oder teilweise ausgefüllt sein können. Ein VLM, das das Dokument ganzheitlich liest, kann gemischte Formulare mit Handschrift und Checkboxen besser verarbeiten als eine Pipeline, die OCR und Checkbox-Erkennung in getrennte Schritte aufteilt, weil das VLM keine räumlichen Informationen zwischen den Stufen verliert.
Wie viele Formulare kann ich gleichzeitig verarbeiten?
Die Stapelverarbeitung ermöglicht es Ihnen, mehrere Formulare gleichzeitig hochzuladen und eine einzige zusammengeführte Ausgabetabelle zu erhalten. Die praktische Grenze hängt von der Architektur des Tools ab – einige unterstützen Dutzende, andere Hunderte pro Stapel. Auf ImageToTable.ai funktioniert die benutzerdefinierte Spaltenextraktion über ganze Stapel hinweg: Sie definieren Ihre Spalten einmal, laden alle Ihre Formulare hoch, und die Checkbox-Zustände und Feldwerte jedes Formulars werden in die entsprechenden Zeilen einer einzigen Tabelle eingetragen. Keine Einrichtung pro Formular, keine Vorlage pro Anbieter.
Welche Genauigkeit kann ich bei der Checkbox-Erkennung erwarten?
Bei der reinen Checkbox-Interpretation – isoliert vom Rest des Formulars – lagen die besten im CheckboxQA-Benchmark getesteten Vision-Language-Modelle zwischen 60 % und 83 %, während Menschen 97,5 % erreichen. Bei echten Formularen hängt die Genauigkeit jedoch mehr von der Formulargestaltung und der Markierungsqualität ab als vom Modell: Große, klar getrennte Kästchen auf sauberen Scans schneiden deutlich besser ab als winzige Kästchen auf Fotos mit niedriger Auflösung. Für die Aufschlüsselung nach Markierungstyp (digitale Kästchen, Kugelschreiber-Häkchen, Bleistift, mehrdeutige Markierungen) finden Sie in unserem Leitfaden zur Checkbox-Genauigkeit. Der zuverlässigste Arbeitsablauf ist die automatisierte Extraktion mit Stichprobenprüfung – die KI übernimmt den Großteil der Arbeit, und Sie prüfen eine Stichprobe, um Grenzfälle zu erkennen, statt jedes einzelne Formular zu überprüfen.
Die eigentliche Erkenntnis dreht sich nicht um Checkboxen
Das Checkbox-Problem offenbart eine tiefere Wahrheit über Dokumenten-KI: Texterkennung ist keine Datenextraktion. Ein Tool, das Wörter gut liest, übersieht möglicherweise dennoch die nicht-textuellen Informationen, die auf Ihren Formularen die Hälfte der Bedeutung ausmachen – die Häkchen, die Optionsfeld-Auswahlen, die Unterschriften, die Stempel, die durchgestrichenen Felder. Der Maßstab, der zählt, ist nicht die OCR-Zeichengenauigkeit. Es ist die Frage, ob die Ausgabetabelle – das, was Sie tatsächlich verwenden – korrekt ist, ohne dass Sie jede Zelle erneut prüfen müssen.
Diese Unterscheidung trennt Tools, die für das Scannen von Dokumenten entwickelt wurden, von Tools, die für die Datenextraktion gebaut sind. Die Checkbox ist der Kanarienvogel. Wenn ein Tool sie zuverlässig verarbeitet – über verschiedene Formularlayouts hinweg, gemischt mit Handschrift, im Stapelbetrieb –, verarbeitet es wahrscheinlich auch den Rest Ihrer Formulardaten korrekt. Wenn nicht, betreiben Sie immer noch manuelle Dateneingabe. Nur mit besser aussehender Software.
Dateien werden sicher verarbeitet und nicht gespeichert.